
Alibaba e ByteDance offrono ora due sistemi di video IA da 30 secondi insolitamente completi. Uno privilegia una pipeline all-in-one capace di trasformare documenti e pagine web in video; l’altro privilegia la narrazione long-form, il controllo denso dei riferimenti e un editing audiovisivo chirurgico. Questa guida separa le specifiche verificate dalle evidenze di benchmark indipendenti per consentire agli sviluppatori di scegliere in base all’idoneità alla produzione, non alle affermazioni di lancio.
TL;DR
In sintesi: Wan 3.0 è la scelta predefinita più solida quando servono un segnale di qualità indipendente il più chiaro possibile, output a 1080p, input da documenti/pagine web e un costo API iniziale attualmente più basso. Seedance 2.5 è l’opzione più specializzata per la produzione creativa quando servono fino a 50 riferimenti, continuazione multi-round, editing a livello di timestamp, workflow con green screen o previsualizzazione white-model.
Non esiste ancora un benchmark pubblico pulito testa a testa. Artificial Analysis attualmente classifica il modello di Alibaba al primo posto nella sua arena text-to-video con audio, mentre il rilascio di ByteDance non è ancora elencato nella stessa valutazione. Poiché Seedance 2.5 non è ancora stato valutato nella stessa arena, questa classifica non può supportare un confronto diretto della qualità tra i due modelli.
Wan 3.0 vs Seedance 2.5: Confronto rapido
| Categoria | Wan 3.0 | Seedance 2.5 |
|---|---|---|
| Sviluppatore | Alibaba Tongyi / Wan | ByteDance Seed |
| Rilascio / disponibilità | Public API release: Aug 24, 2026 | Official launch: Jul 31; CometAPI route: Aug 6, 2026 |
| Progettazione core | Produzione video multimodale all-in-one | Generazione audio-video congiunta per storytelling controllato |
| Durata massima nativa | 2-30 secondi | 4–30 secondi. |
| Risoluzione in output | 480p, 720p, 1080p | CometAPI documenta attualmente route a 480p e 720p |
| Capacità di riferimento | Fino a 10 immagini + 5 clip video + 5 clip audio; più 1 documento o 1 pagina web pubblica. | 30 immagini + 10 video + 10 clip audio |
| Tipi di input | Testo, immagine, video, audio, documenti, pagine web | Testo, immagine, video, audio |
| Audio nativo | Dialoghi, BGM, effetti sonori | Generazione audio-video congiunta con suono sincronizzato |
| Editing | Editing via istruzioni, estensione, controllo del primo/ultimo fotogramma | Modifiche a timestamp, green screen, editing di camera e riferimenti |
| Benchmark indipendente | #1 T2V con audio; 1.241 Elo | Non ancora elencato nello stesso benchmark |
| Prezzo iniziale CometAPI | $0.04 per secondo generato | $0.0824 per secondo generato |
| Miglior caso d’uso iniziale | Demo di prodotto, explainers, da documento a video, default guidato dalla qualità | Narrativa con molti riferimenti, controllo film/advertising, edit mirati |
Che cos’è Wan 3.0?
L’ultimo modello video hosted di Alibaba unifica text-to-video, image-to-video, generazione condizionata da riferimenti, editing, estensione e audio nativo in un unico sistema. La sua caratteristica distintiva non è solo il tetto dei 30 secondi: accetta contesto creativo da immagini, video, audio, documenti d’ufficio e pagine web pubbliche, permettendo a un product brief o a una presentazione di entrare nelle istruzioni di generazione.
La guida ufficiale API di Wan 3.0 specifica fino a 30 secondi a 30 fps, output 480p/720p/1080p e dialoghi/BGM/effetti sonori nativi. I limiti per richiesta documentati sono fino a 10 immagini di riferimento, 5 video di riferimento e 5 clip audio di riferimento; la richiesta può anche includere un documento supportato oppure una pagina web pubblica. Documenta inoltre il controllo del primo fotogramma e del primo-e-ultimo fotogramma, la continuazione del video e l’editing in linguaggio naturale.
Fonte: Alibaba Tongyi Wan official showcase
Specifiche del modello Alibaba
| Specifica | Valore verificato |
|---|---|
| Stato del modello | Modello commerciale hosted; API disponibile |
| Modalità di generazione | Text-to-video, image-to-video, reference-to-video, editing, continuazione |
| Durata massima | 30 secondi per generazione; documentati 2-30 secondi |
| Frame rate | 30 fps |
| Risoluzione | 480p, 720p, 1080p |
| Formati di aspetto | Adattivo, 16:9, 4:3, 1:1, 3:4, 9:16 |
| Riferimenti | Fino a 10 immagini di riferimento, 5 video di riferimento e 5 clip audio di riferimento; una richiesta può anche usare 1 documento o 1 pagina web pubblica. |
| Documenti | DOC, XLS, PPT, PDF, TXT, KEY, PAGES, NUMBERS, MD |
| Limiti documenti | Fino a 100 MB e 50 pagine |
| Audio | Voce/dialoghi nativi, BGM ed effetti sonori |
| CometAPI model ID | wan3.0 |
| Endpoint CometAPI | POST /v1/videos; workflow asincrono crea-e-polling |
Dove il modello di Alibaba si distingue
- Da documento a video e da pagina web a video eliminano una fase di pre-processing per presentazioni, report, pagine prodotto, materiale formativo e explainers aziendali.
- Una route a 1080p e output a 30 fps forniscono un percorso di consegna finale chiaramente documentato.
- Lo stesso modello copre generazione, condizionamento da riferimenti, editing ed estensione, riducendo l’orchestrazione specifica dei modelli.
- I risultati indipendenti attuali su T2V ed editing video offrono una prova pubblica più forte delle sole demo del fornitore.
Che cos’è Seedance 2.5?
Il modello audio-video di nuova generazione di ByteDance è costruito attorno a storie complete da 30 secondi, ampi insiemi multimodali di riferimenti e editing di produzione. Il modello può organizzare più inquadrature correlate in una singola generazione, continuare un output esistente su round aggiuntivi e mantenere un linguaggio audiovisivo coerente su narrazioni più lunghe.
Nell’annuncio ufficiale di lancio, ByteDance documenta fino a 30 immagini, 10 clip video e 10 clip audio in un’unica passata. Descrive anche modifiche audiovisive a livello di timestamp, sostituzione con green screen, editing della prospettiva di camera, riferimenti di movimento e creativi, e controllo clay-render per composizione, blocking, illuminazione e pianificazione camera.

Fonte: ByteDance Seedance 2.5 official showcase
Specifiche del modello ByteDance
| Specifica | Valore verificato |
|---|---|
| Stato del modello | Lanciato ufficialmente; piattaforma commerciale e accesso API |
| Modalità di generazione | Text-to-video, image-to-video, reference-to-video, estensione, editing |
| Durata massima | ByteDance conferma ufficialmente fino a 30 secondi per generazione; la route CometAPI attualmente documentata accetta 4–30 secondi. |
| Continuazione | Estensione multi-round; la pagina prodotto descrive fino a due estensioni |
| Risoluzione | CometAPI documenta attualmente route prezzate a 480p e 720p |
| Riferimenti | Fino a 30 immagini, 10 clip video e 10 clip audio |
| Tipi di input | Testo, immagine, video, audio |
| Documenti | Non elencati come input di riferimento nativo nei materiali ufficiali di Seedance 2.5. |
| Limiti documenti | Non applicabile / non documentato per la route Seedance 2.5 corrente. |
| Audio | Generazione audio-video congiunta e audio di riferimento |
| Editing | Controllo a livello di timestamp, green screen, prospettiva di camera, editing basato su riferimenti |
| Previsualizzazione | Controllo clay-render / white-model |
| CometAPI model ID | seedance-2-5 |
| Endpoint CometAPI | POST /v1/videos; workflow asincrono crea-e-polling |
Dove il modello di ByteDance si distingue
- Cinquanta riferimenti totali offrono ai creatori più margine per vincoli su più personaggi, più location, brand, oggetti di scena, voci e movimenti.
- Le modifiche a livello di timestamp consentono di rivedere un beat, un’azione, un suono o un segmento di camera specifico senza trattare l’intero video come una bozza usa e getta.
- I workflow con green screen e clay-render collegano il video generativo con pratiche convenzionali di previsualizzazione e compositing.
- La continuazione multi-round è pensata per estendere un linguaggio visivo e sonoro coerente oltre i 30 secondi iniziali.
Wan 3.0 vs Seedance 2.5: Risultati di benchmark
Regola del benchmark: solo i risultati prodotti sotto la stessa classifica, lo stesso task, la stessa modalità audio e lo stesso metodo di voto sono direttamente comparabili. Le dimostrazioni dei vendor e i punteggi dei modelli più vecchi sono contesto utile, ma non sostituiscono un risultato testa a testa mancante.
L’attuale Artificial Analysis Text to Video Leaderboard colloca il modello di Alibaba al primo posto nell’arena con audio a 1.241 Elo, con intervallo di confidenza al 95% di +/-9 e 6.195 confronti alla cieca. Lo stesso valutatore lo colloca al primo posto anche nell’editing video con audio a 1.189 Elo, con intervallo +/-7 e 5.231 campioni.
Il rilascio di ByteDance non è ancora elencato in quelle due tabelle. Artificial Analysis elenca una generazione Seedance più vecchia, ma usare quel punteggio come se rappresentasse il nuovo modello sarebbe metodologicamente errato. Pertanto, la conclusione più corretta è che Alibaba dispone attualmente di evidenze indipendenti più forti, non che ByteDance sia stato dimostrato indipendentemente come più debole.
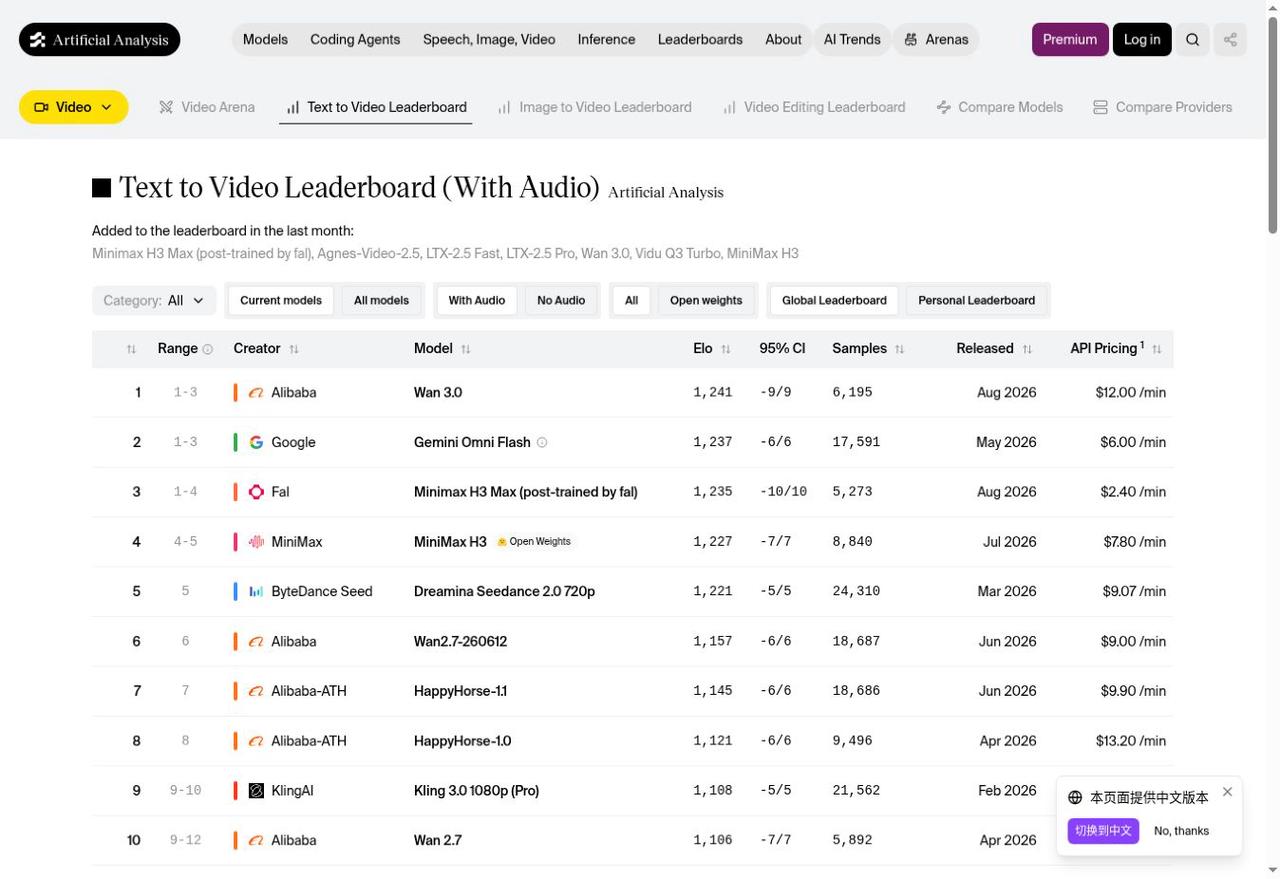
Fonte: Artificial Analysis Text to Video Leaderboard
| Tipo di evidenza | Modello Alibaba | Modello ByteDance | Interpretazione |
|---|---|---|---|
| Text-to-video con audio | 1.241 Elo; rank #1; +/-9; 6.195 campioni | Non elencato | Confronto diretto indipendente non disponibile |
| Video editing con audio | 1.189 Elo; rank #1; +/-7; 5.231 campioni | Non elencato | Confronto diretto indipendente non disponibile |
| Evidenza qualitativa ufficiale | Rendering a livello realistico, coerenza long-form, omni-reference | Storytelling long-form, controllo denso dei riferimenti, editing a timestamp | Demo e claim differenti; non valutati direttamente |
Wan 3.0 vs Seedance 2.5: Differenze chiave a confronto
1. Storytelling long-form e coerenza temporale
Entrambi i modelli possono generare fino a 30 secondi in una passata. L’intervallo ufficiale API di Wan 3.0 è 2–30 secondi, mentre la documentazione ufficiale API di BytePlus specifica 4–30 secondi per Seedance 2.5; la route Seedance corrente su CometAPI documenta anch’essa 4–30 secondi. Wan è quindi l’opzione documentata per clip native da 2–3 secondi su queste route. L’approccio di Alibaba è più incisivo quando la clip deve assorbire materiali sorgente eterogenei e trasformarli in un output coerente. L’approccio di ByteDance è più forte quando i 30 secondi devono contenere un arco narrativo pianificato, più inquadrature collegate e una continuazione successiva con personaggi, ambienti, ritmo e suono coerenti.
Risultato: scegli Alibaba per una richiesta di produzione multimodale autocontenuta; scegli ByteDance per costruzioni narrative episodiche o multi-round.
2. Qualità visiva, movimento e plausibilità fisica
Alibaba ha il segnale di qualità pubblica più chiaro perché il suo output guida attualmente l’arena T2V-con-audio a preferenza cieca. I materiali di prodotto enfatizzano anche volti, micro-espressioni, dettagli di prodotto, testo, layout spaziale e interazioni fisiche. ByteDance enfatizza transizioni più fluide, stabilità del soggetto tra i tagli, texture e illuminazione più realistiche e movimento che segue la struttura spaziale dei riferimenti clay-render.
Risultato: Alibaba è il primo test basato su evidenze per la preferenza visiva generale. ByteDance resta altamente convincente per blocking diretto, coreografia di camera e scene pianificate da asset di previsualizzazione.
3. Controllo dei riferimenti e coerenza dei personaggi
Wan 3.0 accetta fino a 10 immagini di riferimento, 5 video di riferimento e 5 clip audio di riferimento, oltre a un documento supportato o una pagina web pubblica. Seedance 2.5 accetta il set convenzionale più ampio: fino a 30 immagini, 10 video e 10 clip audio, ma i suoi materiali ufficiali non elencano documenti o pagine web come input di riferimento nativi. Questo tetto più alto sui riferimenti convenzionali conta quando il brief include un cast, ambienti multipli, varianti di prodotto, guardaroba, oggetti di scena, campioni di voce, riferimenti camera e di movimento.
Risultato: ByteDance vince sulla densità dei riferimenti; Alibaba vince sull’ampiezza dei riferimenti.
4. Audio nativo, dialoghi e sound design
Entrambi generano suono insieme all’immagine invece di richiedere un doppiaggio separato. Alibaba documenta esplicitamente dialoghi, musica di sottofondo e effetti sonori. ByteDance si basa su un’architettura audio-video unificata e supporta riferimenti audio, coerenza della voce e modifiche audiovisive mirate.
Risultato: la gara a livello di specifiche è equilibrata. Testa intelligibilità dei dialoghi, sincronizzazione labiale, identità del parlante, stabilità della musica di fondo e tempi degli effetti sonori con lo stesso script prima di scegliere una route di produzione.
5. Editing e iterazione
Alibaba copre editing in linguaggio naturale, estensione e workflow condizionati ai fotogrammi all’interno del suo modello all-in-one. ByteDance va più in profondità in un workflow da editor: i prompt possono mirare a timestamp specifici, sostituire sfondi tramite green screen, regolare la prospettiva della camera e rivedere personaggi, azioni, trama o audio preservando la continuità circostante.
Risultato: ByteDance ha una superficie di controllo documentata più forte per revisioni creative chirurgiche; Alibaba offre una pipeline unificata più semplice.
6. Documenti, pagine web e contenuti business
Questo è il vantaggio più chiaro e incontestato di Alibaba. Un PDF, una presentazione, un foglio di calcolo, un documento di testo, un file della suite Apple, un documento Markdown o una pagina web possono diventare materiale sorgente per un explainer generato, un video prodotto, un clip formativo o un executive summary. La panoramica del modello di ByteDance si concentra su testo, immagini, video e audio piuttosto che sul parsing di documenti.
Risultato: scegli Alibaba per da documento a video, da pagina web a video, knowledge aziendale e pipeline di riproposizione automatizzata dei contenuti.
7. Risoluzione e workflow di consegna
Alibaba documenta route a 480p, 720p e 1080p. Questo supporta una scala pulita: iterare a 480p, rivedere a 720p e generare le inquadrature approvate a 1080p. CometAPI documenta attualmente prezzi a 480p e 720p per la route ByteDance; l’articolo ufficiale di lancio ByteDance non fornisce una tabella equivalente per route e risoluzione.
Risultato: Alibaba ha il percorso di consegna ad alta risoluzione più chiaramente documentato. Conferma la route attiva di ByteDance prima di fare promesse di prodotto sulla risoluzione.
Confronto prezzi
Le schede modello live su CometAPI mostrano un prezzo iniziale di $0.04 per secondo generato per Alibaba e $0.0824 per secondo per ByteDance. Le sezioni di pricing dettagliate mostrano anche i prezzi delle route a monte: Alibaba elenca $0.05/$0.10/$0.20 per secondo per 480p/720p/1080p, mentre ByteDance elenca $0.103 e $0.231 per secondo per 480p e 720p. Poiché le pagine dei modelli e gli sconti di route possono cambiare indipendentemente, le stime di produzione dovrebbero usare la route esatta selezionata al momento dell’invio.
| Voce di costo | Wan 3.0 | Seedance 2.5 | Note |
|---|---|---|---|
| Prezzo iniziale a listino CometAPI | $0.04/s | $0.0824/s | Alibaba è circa il 51% più basso al floor mostrato |
| Clip da 10 secondi al prezzo iniziale | $0.40 | $0.824 | Prima dei retry |
| Clip da 30 secondi al prezzo iniziale | $1.20 | $2.472 | Prima dei retry |
| Prezzo route 480p pubblicato | $0.05/s | $0.103/s | Route a monte/elencata |
| Prezzo route 720p pubblicato | $0.10/s | $0.231/s | Route a monte/elencata |
| Prezzo route 1080p pubblicato | $0.20/s | Non mostrato nella tabella CometAPI corrente | Verificare disponibilità della route |
Regola sui costi di produzione: confronta il costo per clip accettata, non il prezzo per secondo. Includi output respinti, retry, upscaling, storage, tempo di editing e la revisione umana necessaria per rendere pubblicabile una clip.
Wan 3.0 vs Seedance 2.5: Punti di forza e compromessi
| Modello | Punti di forza | Compromessi |
|---|---|---|
| Modello Alibaba | Segnale indipendente #1 T2V-con-audio; segnale #1 per l’editing; input da documenti/web; 1080p; prezzo iniziale più basso; workflow unificato | Tetto a 20 riferimenti; pesi chiusi hosted; clip più lunghe possono ancora deragliare; audio/testo potrebbero richiedere post-produzione |
| Modello ByteDance | 50 riferimenti; estensione multi-round; edit a timestamp; green screen; editing di camera; previsualizzazione clay-render | Nessun Elo indipendente sotto lo stesso framework per ora; tabella risoluzioni CometAPI si ferma a 720p; i materiali ufficiali riconoscono limiti su moto complesso e interazione multi-soggetto |
Quale modello scegliere?
| Caso d’uso | Scelta iniziale | Perché |
|---|---|---|
| Miglior default per una nuova feature video | Modello Alibaba | Evidenze indipendenti più forti e prezzo iniziale attualmente più basso |
| Spot prodotto da 30 secondi | Modello Alibaba | Input da documenti/prodotto, route 1080p, floor di iterazione più basso |
| Da PDF o pagina web a video esplicativo | Modello Alibaba | Parsing nativo di documenti e pagine web |
| Campagna di brand ricca di riferimenti | Modello ByteDance | Fino a 50 riferimenti creativi |
| Corto drammatico multi-personaggio | Modello ByteDance | Continuità narrativa, riferimenti densi, estensione |
| Revisione precisa di un intervallo temporale | Modello ByteDance | Editing audiovisivo a livello di timestamp |
| Workflow con green screen o clay-render | Modello ByteDance | Controlli professionali espliciti di produzione |
| Benchmark qualità guidato da evidenze | Modello Alibaba | Leadership attuale a preferenza cieca e nell’editing |
| Decisione finale di deployment | Testa entrambi | Usa gli stessi asset, durata, rubric e soglia di accettazione |
Come eseguire un A/B test equo
- Crea una suite di 20–40 prompt che copra inquadrature di prodotto, dialoghi umani, scene multi-personaggio, movimento di camera, fisica, testo/UI e generazione ricca di riferimenti.
- Usa durata, risoluzione, formato di aspetto, requisito audio e asset di origine allineati ovunque entrambe le route supportino impostazioni equivalenti.
- Mantieni i revisori all’oscuro dell’identità del modello e valuta separatamente qualità visiva, aderenza al prompt, coerenza dei soggetti, movimento, tempi dell’audio, qualità dei dialoghi e sforzo di editing.
- Registra fallimenti, retry, rifiuti di safety, latenza di generazione e minuti di post-produzione oltre all’output riuscito.
- Scegli la route con il costo per clip accettata più basso per ciascun carico di lavoro, invece di forzare un unico vincitore universale.
Come accedere a entrambi i modelli tramite CometAPI
Entrambe le route sono disponibili tramite CometAPI, che consente ai team di mantenere un unico account, chiave API, livello di billing e ciclo di vita video asincrono mentre valutano provider diversi. Gli attuali ID modello lato cliente sono wan3.0 e seedance-2-5.
- Crea un account e genera una chiave API. Conservala in una variabile d’ambiente lato server.
- Apri la documentazione dell’API video e conferma i campi esatti supportati dalla route del modello selezionata.
- Invia POST /v1/videos, salva l’ID attività del video restituito e interroga GET /v1/videos/{id} finché l’attività non raggiunge uno stato terminale.
- Scarica l’asset completato e archivia ID modello, route, durata, risoluzione, latenza, prezzo ed esito della revisione insieme al risultato.
Linguaggio: Bash
export COMETAPI_KEY="your_api_key"

curl -X POST "https://api.cometapi.com/v1/videos" \
  -H "Authorization: Bearer $COMETAPI_KEY" \
  -F 'model=wan3.0' \
  -F 'prompt=Una presentazione di prodotto cinematografica con audio ambientale sincronizzato.' \
  -F 'seconds=10' \
  -F 'size=1280x720'

# Per un A/B test, invia un payload Seedance convalidato con:
# -F 'model=seedance-2-5'
Non dare per scontato che ogni parametro multimediale sia portabile solo perché entrambi i modelli condividono un endpoint. I campi di riferimento, le risoluzioni supportate, i controlli di editing e il comportamento dei callback possono restare specifici per route. Convalida ogni payload prima di spostare il traffico di produzione.
Wan 3.0 vs Seedance 2.5: Limitazioni e avvertenze
- I benchmark indipendenti cambiano man mano che arrivano nuovi voti; l’Elo è un segnale di preferenza relativa, non una misura assoluta di aderenza fattuale al prompt o di usabilità commerciale.
- L’assenza di un punteggio ByteDance sotto l’attuale framework indipendente impedisce una classifica diretta della qualità con validità statistica.
- Le dimostrazioni ufficiali usano prompt e asset curati. I risultati reali possono variare con complessità del soggetto, filtri di sicurezza, lingua, formato di aspetto e qualità dei riferimenti.
- Il post di lancio di ByteDance riconosce margini di miglioramento nella plausibilità fisica di movimenti complessi e nella stabilità di interazioni multi-soggetto.
- Gli output più lunghi di Alibaba possono ancora mostrare drift di identità, deformazioni di oggetti, errori di testo o difetti audio; 30 secondi è un limite di capacità, non una garanzia di qualità.
- Prezzi e disponibilità delle route possono cambiare. Ricontrolla la pagina modello live su CometAPI prima di pubblicare claim di prezzo fissi o impegnare l’economia unitaria.
Conclusione
La risposta più difendibile è specifica per il carico di lavoro. Alibaba offre attualmente il pacchetto predefinito più forte: leadership a preferenza cieca indipendente, primo posto nell’editing, input da documenti e pagine web, una route 1080p documentata e un prezzo iniziale visualizzato più basso. È il primo test logico per video di prodotto, explainers, conversione automatizzata di contenuti business e deployment API general-purpose.
ByteDance offre il sistema di controllo creativo più specializzato. Il tetto di 50 riferimenti, la continuazione multi-round, le modifiche a livello di timestamp, il workflow con green screen, l’editing di camera e la previsualizzazione clay-render possono compensare il benchmark mancante quando la costruzione professionale della storia e l’iterazione chirurgica sono i veri criteri di accettazione.
In produzione, non scegliere solo dal titolo. Esegui lo stesso brief su entrambi i modelli, misura gli output accettati invece dei primi tentativi e instrada ogni job al sistema che fornisce la qualità richiesta con meno retry e meno editing.
FAQ
Wan 3.0 è migliore di Seedance 2.5?
Alibaba dispone attualmente di evidenze di benchmark indipendenti più forti e di un supporto più ampio per input business. ByteDance può essere migliore per riferimenti densi, storytelling esteso e editing creativo preciso. Non esiste ancora un confronto Elo diretto nello stesso framework.
Quale modello è più economico?
Le pagine attuali di CometAPI mostrano prezzi iniziali di $0.04 al secondo per Alibaba e $0.0824 al secondo per ByteDance. Il costo finale dipende da route, risoluzione, retry e tasso di accettazione.
Quale modello supporta più riferimenti?
Seedance 2.5 supporta il set di riferimenti convenzionale più grande: fino a 30 immagini, 10 video e 10 clip audio. Wan 3.0 supporta fino a 10 immagini, 5 video e 5 clip audio e può inoltre usare un documento supportato o una pagina web pubblica.
Quale modello è migliore per l’editing video?
Alibaba guida attualmente l’arena indipendente per l’editing video con audio. ByteDance documenta un workflow creativo più granulare con editing a livello di timestamp, sostituzione con green screen, cambi di prospettiva di camera e editing basato su riferimenti. La scelta migliore dipende dal fatto che conti di più la qualità a preferenza o la profondità di controllo.
Entrambi i modelli possono generare audio nativo?
Sì. Entrambi sono progettati per generare audio e video sincronizzati. Valuta chiarezza dei dialoghi, sincronizzazione labiale, effetti sonori, stabilità della musica e coerenza della voce sui tuoi prompt.
Posso accedervi entrambi con una sola chiave API?
Sì. Entrambi sono attualmente elencati su CometAPI e utilizzano il suo workflow asincrono di generazione video, anche se i campi di richiesta validi vanno comunque verificati per route.