
TL;DR
Claude Haiku 5.5 è il modello piccolo più veloce di Anthropic alla velocità standard per attività ad alto volume e sensibili alla latenza. Combina una finestra di contesto da 1 milione di token, un limite di output standard di 128K, ragionamento adattivo e un prezzo base a partire da $0.10 per milione di token in input e $0.50 per milione di token in output. Le tariffe aumentano quando un prompt supera i 100,000 token. Per coding complesso e lavoro agentico esteso, Sonnet 5.5 e Opus 5.5 restano scelte più forti. I prezzi Standard di CometAPI sono inferiori del 20% alle tariffe ufficiali, a partire da $0.08 per milione di token in input e $0.40 per milione di token in output. La pagina del modello su CometAPI è attiva e indica l’accesso API in produzione.
Key Takeaways
- Rilascio ufficiale: 7 ottobre 2026; ID del modello Claude API: claude-haiku-5-5.
- Tariffe API iniziali: $0.10 input e $0.50 output per milione di token per prompt fino a 100K token. CometAPI: $0.08 input e $0.40 output per milione di token all’80% dei prezzi Standard ufficiali.
- Contesto e output: 1M token di contesto e 128K token di output standard.
- Focus: classificazione, estrazione di documenti, instradamento, supporto e attività di agent delegati.
- Il tokenizzatore più recente può conteggiare circa il 30% di token in più per lo stesso testo; valutare il costo per task accettato piuttosto che il solo prezzo per token.
What Is Claude Haiku 5.5?
Claude Haiku 5.5 è il membro leggero dell’attuale famiglia Claude di Anthropic, sviluppato per volumi di richieste elevati in cui reattività ed economia operativa sono centrali. Le sue applicazioni principali includono l’elaborazione di documenti, il supporto conversazionale, l’estrazione di informazioni e i job compatti di sotto-agent. La panoramica del modello di Anthropic conferma data di lancio, funzionalità e identificatori di piattaforma.
Claude Haiku 5.5 è il primo modello Haiku a supportare livelli di effort configurabili, consentendo agli sviluppatori di bilanciare profondità del ragionamento, latenza e uso di token all’interno dello stesso modello.
What Are the Key Features of Claude Haiku 5.5?
Ragionamento adattivo ed effort regolabile
Haiku 5.5 può decidere quando e quanto ragionare, mentre il parametro di effort offre agli sviluppatori un modo per bilanciare qualità della risposta, latenza e uso di token. L’effort predefinito è medio. Per classificazioni semplici, un effort basso può essere preferibile; per estrazioni ambigue o passaggi di pianificazione degli strumenti, un’impostazione più alta può essere giustificata.
Elaborazione a contesto ampio
Una finestra di contesto da 1M token consente di includere documenti lunghi e storici conversazionali sostanziosi in una singola richiesta. Gli sviluppatori dovrebbero comunque usare retrieval, troncamento e caching dove opportuno: contesti lunghi possono introdurre costi non necessari e compromessi di accuratezza, specialmente oltre la soglia di prezzo a 100K.
Elaborazione a basso costo e alto throughput
Le nuove tariffe iniziali di $0.10/$0.50 rendono molto meno costose, su base per-token, le richieste brevi ripetute rispetto alla generazione precedente di Haiku. Tuttavia Anthropic documenta un tokenizzatore cambiato: testo identico produce circa il 30% di token in più rispetto a Haiku 4.5. Pertanto i risparmi effettivi a livello di task possono essere inferiori alle riduzioni tariffarie “di cartellone”.
Uso del computer e attività di agent delegati
Valutazioni pubblicate indicano prestazioni più forti in compiti di interazione con il computer e attività assistite da strumenti rispetto al modello Haiku precedente. Questo rende Haiku 5.5 utile per passi di agent limitati, ma un’automazione di successo dipende comunque da permessi solidi degli strumenti, recupero dagli errori e approvazione umana per azioni rischiose.
How Does Claude Haiku 5.5 Perform on Benchmarks?
Anthropic riporta guadagni marcati in compiti di conoscenza professionale, uso del computer, coding e ragionamento. I risultati sotto usano le impostazioni di valutazione riportate; i punteggi di benchmark diversi non dovrebbero essere combinati in un unico “punteggio di intelligenza”.
| Benchmark | Haiku 4.5 | Haiku 5.5 | Sonnet 5.5 |
|---|---|---|---|
| GDPval-AA v2.1 (Elo) | 735 | 1,620 | 1,840 |
| AA-Briefcase v1.1 (Elo) | 614 | 1,578 | 1,824 |
| OSWorld 2.1, sottoinsieme offline, credito parziale | 15.7% | 72.4% | 83.9% |
| Humanity's Last Exam, senza strumenti | 10.2% | 45.9% | 56.9% |
| Humanity's Last Exam, con strumenti | 18.7% | 57.4% | 64.5% |
| Terminal-Bench 4.0 | 0.0% | 39.2% | 70.6% |
| Chartography, senza strumenti | 6.4% | 46.4% | 61.6% |
La configurazione standard di valutazione di Haiku 5.5 nella system card usa ragionamento adattivo al massimo effort, campionamento predefinito e cinque tentativi salvo diversa indicazione; l’impostazione predefinita del prodotto è media, quindi i punteggi di test in evidenza non sono garanzie alle impostazioni predefinite. OSWorld usa 82 task offline, nessun accesso a Internet, 1080p e un limite di 500 azioni. Il 72.4% è un punteggio a credito parziale; il tasso di superamento rigoroso è 37.1%. GDPval-AA e AA-Briefcase sono riportati da Anthropic da valutazioni Artificial Analysis eseguite indipendentemente.
Terminal-Bench 4.0 usa Claude Code in modalità --bare con salvaguardie abilitate. Haiku 5.5 usa effort massimo, nessun modello di fallback e nessuna uscita verso Internet, con 10 tentativi per task; Sonnet 5.5 usa cinque tentativi e un fallback per alcune richieste segnalate. Haiku 4.5 usa un budget di thinking fisso di 63,999 token. Queste differenze di configurazione contano quando si interpretano 39.2% rispetto a 70.6%.
I risultati di benchmark pubblicati da Anthropic forniscono i punteggi sopra. OSWorld usa il suo sottoinsieme offline; Humanity's Last Exam separa esecuzioni con strumenti e senza strumenti, e Chartography è senza strumenti. Questi sono risultati riportati dal fornitore, non misurazioni indipendenti sotto una configurazione universale. Anthropic fornisce dettagli di valutazione nella sua system card di Haiku 5.5; riprodurre i relativi livelli di effort, strumenti, scaffold e budget prima di confrontare i propri risultati. Il riepilogo di lancio non specifica un ambiente di test comune completo per ogni riga.
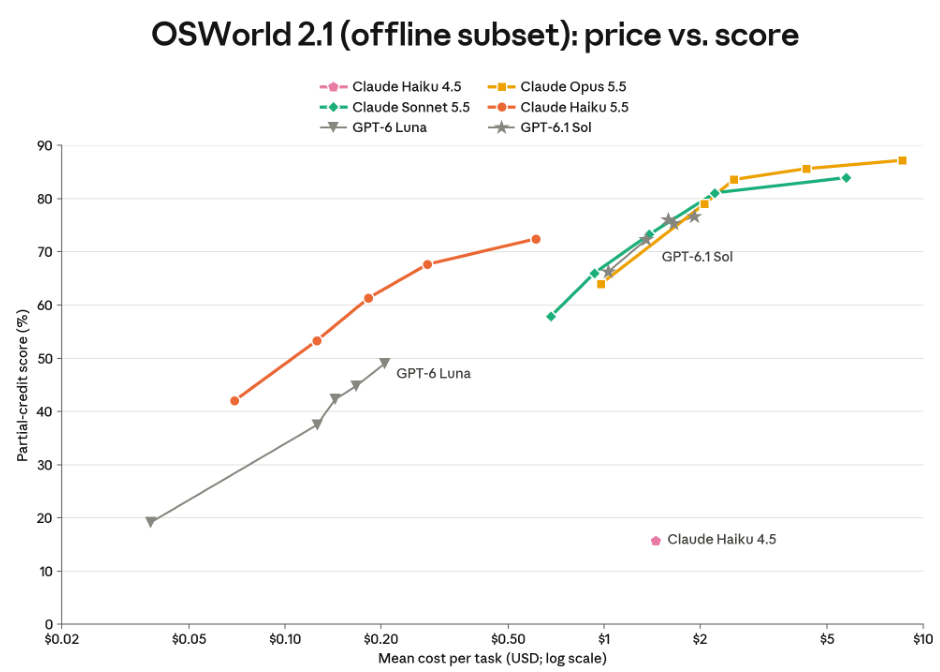
Il grafico ufficiale di valutazione di Anthropic sopra è riprodotto dalla sua system card. Fornisce ulteriori evidenze sulle configurazioni valutate; non è un nuovo benchmark prodotto per questo articolo.
Interpretazione dei benchmark
Il miglioramento su OSWorld suggerisce che Haiku 5.5 è diventato significativamente più utile per compiti grafici strutturati. Tuttavia, il 70.6% di Sonnet 5.5 rispetto al 39.2% di Haiku 5.5 in Terminal-Bench indica un vantaggio continuo del coding agentico su modelli più grandi. Selezionare i modelli in base al costo di fallimento e alla difficoltà del workflow reale.
Claude Haiku 5.5 vs Haiku 4.5 vs Sonnet 5.5
| Dimensione | Haiku 4.5 | Haiku 5.5 | Sonnet 5.5 |
|---|---|---|---|
| Contesto | 200K | 1M | 1M |
| Output standard max | 64K | 128K | 128K |
| Input standard / MTok | $1 | $0.10 fino a 100K; $0.50 oltre | $2 |
| Output standard / MTok | $5 | $0.50 fino a 100K; $2.50 oltre | $10 |
| Ragionamento | Thinking esteso con budget di token fisso | Adattivo; predefinito medio | Adattivo; predefinito alto |
| Latenza relativa | Veloce | Il più veloce alla velocità standard | Veloce |
| Profondità di coding | Task limitati | Sotto-agent più forti | Coding più complesso |
| Uso tipico | Deployment legacy di modelli piccoli | Workflow ad alto volume | Workflow di produzione complessi |
Specifiche condivise: tutti e tre i modelli accettano input di testo e immagine e producono output testuale. Possono essere accessibili tramite la Claude API e piattaforme partner supportate; gli identificatori del modello e l’accesso all’account dipendono dal provider. La documentazione di prodotto citata non stabilisce il numero di parametri o dettagli di architettura.
Haiku 5.5 è una scelta sensata per compiti verificabili e ripetitivi. Sonnet 5.5 diventa più attraente dove un giudizio più forte evita chiamate fallite ripetute, retry degli strumenti o correzioni umane. Opus 5.5 è un’opzione per incarichi multi-step particolarmente impegnativi.
Le etichette comparative di latenza si riferiscono alle modalità a velocità standard. La qualificazione di velocità di Anthropic esclude Opus Fast Mode dall’affermazione del modello più veloce. Dettagli di architettura come il numero di parametri non sono stabiliti da questi livelli di prodotto. Input di testo e immagini con output di testo è distinto dalla generazione di immagini.
Il confronto di capacità segue le specifiche del modello di Anthropic. L’accesso alla piattaforma dipende dal provider selezionato e dall’account; nessun livello di modello implica un conteggio dei parametri pubblicato.
Selezione dei carichi di lavoro
| Carico di lavoro | Default pratico | Motivo |
|---|---|---|
| Classificazione email | Haiku 5.5 | Decisioni brevi, ripetute e verificabili |
| Estrazione di campi da documenti | Haiku 5.5 | Elaborazione strutturata economica |
| Triage del supporto | Haiku 5.5 | Risposte rapide ed escalation |
| Sotto-agent per coding | Haiku 5.5 | Ricerca file a basso costo ed edit contenuti |
| Debugging complesso | Sonnet 5.5 | Prestazioni di benchmark di coding più forti |
| Ragionamento multi-step ad alto rischio | Opus 5.5 | Modello upper-tier più capace |
| Carico misto | Haiku + Sonnet | Instradare per complessità e confidenza |
How Much Does Claude Haiku 5.5 Cost?
Perché Haiku 5.5 è pubblicizzato come “circa il 75% più economico” se il prezzo per token è inferiore del 90%?
La cifra del 90% descrive la riduzione delle tariffe Standard di input e output per prompt fino a 100,000 token; i prompt più lunghi ricevono una riduzione del 50%. Anthropic riporta che in media Haiku 5.5 costa circa il 75% in meno da eseguire, considerando il mix di lunghezza delle richieste del modello precedente e i cambiamenti nell’uso di token per task. La tokenizzazione è un fattore: lo stesso testo in input può contare circa il 30% di token in più, quindi le stime di costo dovrebbero usare conteggi misurati con il nuovo modello.
Le tariffe ufficiali di Anthropic hanno due fasce in base alla lunghezza del prompt. Le tariffe nella prima tabella sono prezzi ufficiali in USD per milione di token; il confronto con CometAPI sotto applica uno sconto del 20% alle tariffe Standard ufficiali di input e output.
| Categoria tariffa | Prompt fino a 100K | Prompt oltre 100K |
|---|---|---|
| Input | $0.10 | $0.50 |
| Output | $0.50 | $2.50 |
| Scrittura in cache 5 minuti | $0.125 | $0.625 |
| Scrittura in cache 1 ora | $0.20 | $1.00 |
| Lettura dalla cache | $0.01 | $0.05 |
| Input in batch (sconto 50%) | $0.05 | $0.25 |
| Output in batch (sconto 50%) | $0.25 | $1.25 |
Tariffe Standard ufficiali, cache e Batch sono mostrate sopra, verificate l’8 ottobre 2026. La lunghezza del prompt seleziona la fascia di prezzo; la fascia più alta si applica alla richiesta, non solo ai token oltre i 100K. Le tariffe Standard di CometAPI sotto corrispondono alle tariffe Standard ufficiali corrispondenti moltiplicate per 0.8. Questo confronto non presume che lo sconto del gateway si cumuli con sconti Batch o di caching.
| Lunghezza del prompt | Categoria di token | Standard ufficiale / MTok | CometAPI / MTok |
|---|---|---|---|
| Fino a 100K token | Input | $0.10 | $0.08 |
| Fino a 100K token | Output | $0.50 | $0.40 |
| Oltre 100K token | Input | $0.50 | $0.40 |
| Oltre 100K token | Output | $2.50 | $2.00 |
Esempio: 100,000 richieste brevi al mese
Si supponga che ogni richiesta usi 2,000 token in input e 500 token in output; ogni richiesta rimane sotto la soglia di 100K. Ignorare la cache del prompt, gli strumenti e i retry, e assumere conteggi di token identici tra i modelli a scopo illustrativo.
| Modello / provider | Input/mese | Output/mese | Totale/mese |
|---|---|---|---|
| Haiku 4.5 — Standard ufficiale | $200 | $250 | $450 |
| Haiku 5.5 — Standard ufficiale | $20 | $25 | $45 |
| Sonnet 5.5 — Standard ufficiale | $400 | $500 | $900 |
| Haiku 5.5 — CometAPI | $16 | $20 | $36 |
In questo esempio, 100,000 richieste usano 200 milioni di token in input e 50 milioni di token in output. L’input di CometAPI costa 200 × $0.08 = $16 e l’output costa 50 × $0.40 = $20, per $36 al mese contro $45 ufficiali: un risparmio di $9, ovvero il 20%. Lo scenario esclude caching, strumenti e retry e usa conteggi di token fissi; misurare il costo per task accettato su input rappresentativi perché il tokenizzatore più recente cambia i conteggi di token.
Il confronto $450-a-$45 è un’illustrazione a token fissi di una riduzione del 90% delle tariffe, non una promessa di risparmi del 90% per workload reali equivalenti. Nel comunicato di lancio, Anthropic riporta un costo medio di esercizio inferiore di circa il 75% dopo aver considerato lunghezze delle richieste e cambiamenti nell’uso di token. Ricontare gli input rappresentativi e misurare il costo per task completato prima di stimare i propri risparmi.
Where Can You Access Claude Haiku 5.5?
Accesso ufficiale e piattaforme cloud
Haiku 5.5 è disponibile tramite la Claude API e piattaforme supportate su Amazon Web Services, Google Cloud e Microsoft Azure, secondo l’annuncio di disponibilità di Anthropic. L’ID del modello diretto della Claude API è claude-haiku-5-5; Amazon Bedrock usa anthropic.claude-haiku-5-5. Usare credenziali rilasciate dal provider scelto e verificare i requisiti di accesso all’account correnti.
Accesso di terze parti tramite CometAPI
La pagina del modello CometAPI elenca claude-haiku-5-5 come disponibile, con tariffe Standard a partire da $0.08 per milione di token in input e $0.40 per milione di token in output per prompt fino a 100K, il 20% sotto le corrispondenti tariffe ufficiali. Usare una chiave rilasciata da CometAPI con l’endpoint e il formato di richiesta di CometAPI; è un canale di accesso separato rispetto all’accesso diretto alla Claude API. Verificare la pagina live per disponibilità, fasce di prezzo e dettagli di integrazione.
Quando si cambiano provider o si aggiorna da Haiku 4.5, verificare gli ID dei modelli, ricontare i token e testare i limiti di risposta e la gestione delle conversazioni. Per dettagli di implementazione e breaking change, consultare la guida alla migrazione di Anthropic.
Validazione della migrazione
- Aggiornare l’ID del modello e convalidare i campi di richiesta specifici dell’endpoint.
- Ricalcolare i token con il tokenizzatore aggiornato, inclusi prefissi stabili e definizioni degli strumenti.
- Testare le impostazioni di ragionamento adattivo, le distribuzioni di latenza e il parsing dei blocchi di risposta.
- Verificare le chiamate agli strumenti, il recupero dagli errori e eventuali restrizioni di account sui blocchi di ragionamento memorizzati.
- Confrontare latenza p50/p95, tasso di task accettati e token fatturabili totali.
- Usare un rollout graduale e un percorso di rollback per workflow critici per il business.
- Il prefill dell’assistente è vietato
La guida alla migrazione di Haiku 5.5 spiega il comportamento del tokenizzatore, gli ID e la compatibilità delle richieste. Omettere temperature, top_p e top_k. Se fornita esplicitamente, temperature deve essere 1 e top_p deve essere 0.99; qualsiasi valore di top_k, o fornire sia temperature sia top_p, restituisce un errore 400.
What Are the Limitations of Claude Haiku 5.5?
Haiku 5.5 non è un sostituto universale dei modelli più grandi. Coding complesso e ragionamento a lungo orizzonte rimangono differenziatori significativi per Sonnet e Opus. I prompt più lunghi costano anche di più, quindi la finestra da 1M token va usata selettivamente. Il ragionamento adattivo introduce varianza nei token generati e nella latenza; i benchmark non stabiliscono garanzie per un singolo workflow aziendale.
L’automazione sensibile al rischio dovrebbe convalidare output strutturati, limitare i permessi degli strumenti esterni, mantenere log di audit e richiedere revisione prima di azioni conseguenti. Instradare i task incerti verso modelli più forti invece di affidarsi solo al prezzo base per token inferiore di Haiku.
Conclusion
Per l’elaborazione ad alto volume con criteri di accettazione misurabili, Claude Haiku 5.5 è un aggiornamento interessante: prezzi di ingresso più bassi, contesto più ampio, ragionamento adattivo e valutazioni pubblicate più forti. Per programmazione complessa e decisioni ambigue, Sonnet 5.5 o Opus 5.5 possono offrire un’economia complessiva migliore riducendo retry e correzioni. La strategia vincente è testare l’intero workflow e instradare le richieste in base alla difficoltà.
FAQ
In che modo il limite di prezzo a 100K di Haiku 5.5 influisce su un workflow con cache?
La lunghezza del prompt determina quale fascia di prezzo si applica; non stimare l’addebito solo dal nuovo testo né assumere che solo i token in eccesso usino la tariffa più alta. Contare la richiesta per il modello selezionato, includendo cronologia e definizioni degli strumenti, quindi riconciliare input, scrittura in cache, lettura dalla cache e uso di output con la fascia pertinente. Confrontare le fatture su richieste in cache rappresentative prima di definire un budget di produzione.
I blocchi di ragionamento di Haiku 5.5 possono essere riutilizzati tra account?
Funzionano solo nell’account che li ha prodotti o in un account ad esso collegato. Se un account non correlato invia un blocco di ragionamento memorizzato, l’API lo scarta prima che il modello lo veda; la richiesta può comunque riuscire senza quel ragionamento. Vedere la guida ufficiale alla migrazione. Conservare i blocchi di conversazione e usare l’account di origine o collegato quando si continua un workflow con strumenti. Un cambio di gateway o account va testato esplicitamente; un nome di modello corrispondente non garantisce che i blocchi di ragionamento memorizzati restino utilizzabili.
Perché Haiku 5.5 può troncare una risposta che Haiku 4.5 completava?
Il tokenizzatore più recente può contare più token per lo stesso testo, quindi un limite max_tokens invariato può contenere meno output equivalente. Il ragionamento adattivo può anche consumare budget di output. Ispezionare stop_reason e usage, ricontare i prompt con il nuovo modello e ritoccare le quote di output su task reali invece di copiare limiti legacy.
Come selezionare le soglie di instradamento di Haiku 5.5?
Usare un campione etichettato dal workload reale per misurare tasso di task accettati, costo di correzione e latenza. Instradare le richieste che falliscono la validazione esplicita o superano l’ambito del task testato verso un modello più forte. Tarare la soglia rispetto al costo complessivo del workflow, inclusi retry ed escalation, e monitorarla dopo cambi a prompt, strumenti o effort.