Crea con CometAPITi serve una sola API per più modelli?Testa il flusso di lavoro in Playground, poi crea una chiave API quando modello e costo sono adatti al tuo caso d'uso.
Che cos'è Gemini 4 Carbon? Benchmark, caratteristiche & prezzi
Scopri Gemini 4 Carbon, il nuovo modello di IA di frontiera di Google. Esplora i benchmark di sicurezza informatica, le funzionalità, i prezzi, i confronti e la disponibilità.
Gemini 4 Carbon è il modello di frontiera di Google DeepMind per esigenze ingegneristiche impegnative e cybersecurity difensiva. Annunciato il 28 ottobre 2026, migliora rispetto a Argon nelle valutazioni pubblicate su coding, sicurezza e contesti lunghi. Le tariffe introduttive sono di $2 per milione di token di input e $10 per milione di token di output, ma l’accesso è inizialmente limitato a difensori cyber selezionati e partner fidati. Per gli sviluppatori, l’opportunità è un lavoro autonomo più solido; il vincolo immediato è l’accesso.
Punti chiave
Gemini 4 Carbon è il successivo modello di frontiera di Google dopo Argon, ottimizzato per ingegneria agentica prolungata su più giorni e difesa di cybersecurity.
Gemini 4 Carbon è al #1 su Artificial Analysis Intelligence Index v5.0 (punteggio 59), davanti a Claude Opus 5.5 (58) e GPT-6 Astra (57). Forti miglioramenti nel coding, nello sviluppo web full‑stack (+89 Elo su WebDev Arena fino al #4), nel ragionamento scientifico, nella comprensione multimodale e nell’allineamento (0.0% di successo su Gray Swan Indirect Prompt Injection Benchmark).
Revisionato per chiarezza, attribuzione delle fonti e terminologia API aggiornata.
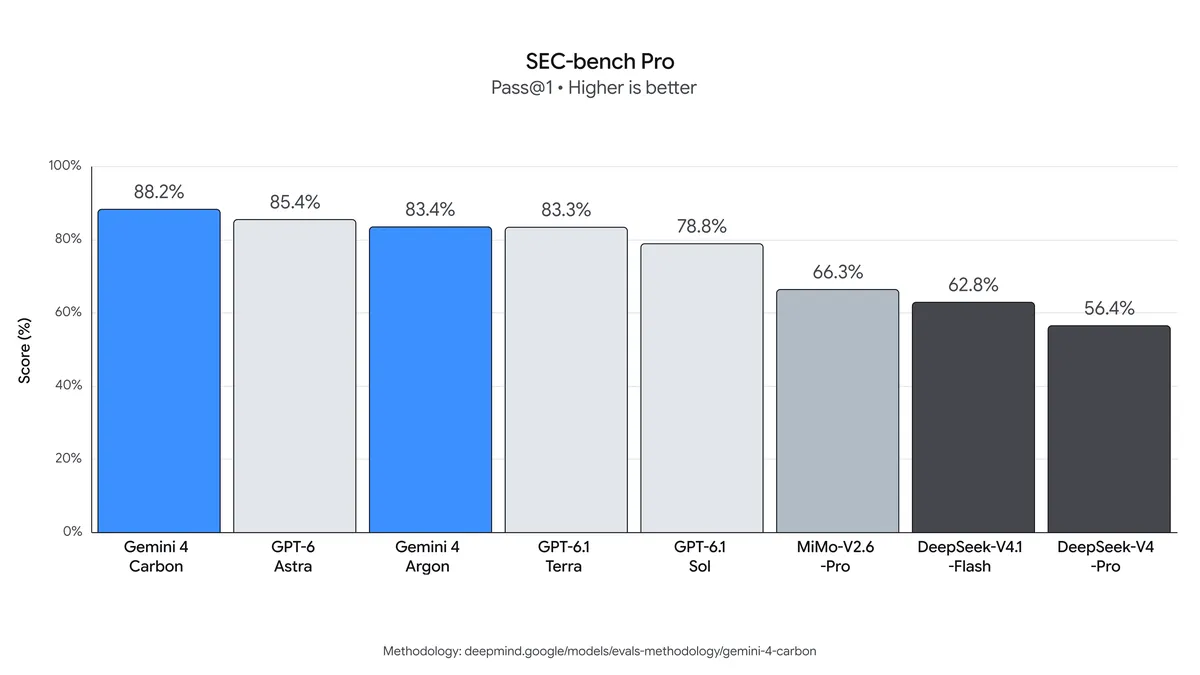
Punteggi di cybersecurity di rilievo (senza guardrail): 88.2% su SEC-bench Pro (individuazione di vulnerabilità), 54.8% su ExploitGym (sfruttamento) e 71.0% su CWE-bench (patching).
Accesso iniziale limitato tramite Fairwind Program per i difensori cyber; API pubblica e rollout più ampio in arrivo più avanti.
Stessa tariffazione introduttiva di Argon; dopo il periodo introduttivo si applicano le tariffe standard.
Piattaforme come CometAPI supportano già la famiglia Gemini più ampia (incluso Argon) tramite una API unificata compatibile con OpenAI, semplificando il cambio di modello e la preparazione al rilascio più ampio di Carbon. I dettagli dell’API pubblica e una data di rilascio ampia non sono annunciati al 29 ottobre 2026.
Che cos’è Gemini 4 Carbon?
Gemini 4 Carbon è il più recente modello AI di frontiera di punta di Google, progettato per gestire ingegneria software complessa, ricerca in cybersecurity e flussi di lavoro autonomi.
In base all’annuncio ufficiale, Carbon si basa sulle fondamenta stabilite da Gemini 4 Argon, con miglioramenti sostanziali nel coding, nel ragionamento agentico e nelle attività focalizzate sulla sicurezza.
Carbon è progettato per lavori che implicano investigazione, esecuzione e verifica su più fasi. Un agente di ingegneria difensiva potrebbe ispezionare un repository, convalidare una vulnerabilità sospetta in un ambiente isolato, sviluppare una patch e testare se la modifica risolve il difetto originale.
Google riferisce che i suoi team interni hanno osservato Carbon affrontare attività ingegneristiche complesse nell’arco di più giorni. Si tratta di osservazioni interne, non di una garanzia pubblicata di una specifica durata autonoma. Google non ha rilasciato un report tecnico completo, il conteggio dei parametri o dettagli architetturali approfonditi. Il contesto e i limiti di output si prevedono simili o migliorati rispetto a quelli di Argon (riportati nell’ordine di milioni di token con elevata capacità di output) e supporta input multimodali inclusi testo, immagini, video, audio e PDF.
Quali sono le caratteristiche principali di Gemini 4 Carbon?
Ingegneria software a lungo orizzonte
Carbon è progettato per problemi ingegneristici che non possono essere completati in modo affidabile in un singolo passaggio di ragionamento.
Esempi includono analisi della causa primaria su grandi repository, errori legati a dipendenze, debugging di sistemi a basso livello e refactoring complessi.
I suoi miglioramenti mirano alla capacità di continuare a lavorare dopo un tentativo non riuscito.
Un agente di coding efficace deve riconoscere quando la prima soluzione fallisce, esaminare nuove evidenze e rivedere l’approccio senza deviare dall’attività originale.
Flussi di lavoro di cybersecurity difensiva
I risultati di sicurezza di Carbon coprono l’individuazione di vulnerabilità, la validazione dell’esploitabilità e la correzione dei difetti. La domanda utile per un team di sicurezza è se un agente possa passare da un problema sospetto a un riscontro riproducibile e una correzione testata, rispettando le autorizzazioni e l’ambiente assegnato.
Comprensione di lungo contesto e multimodale
Carbon registra un punteggio BFS F1 di 96.2% su GraphWalks nel sottoinsieme 256K–1M token, in crescita rispetto all’84.2% di Argon. Questo è evidenza sul ragionamento su grafi in contesti lunghi, piuttosto che una garanzia di recupero corretto da qualsiasi documento da un milione di token.
I risultati pubblicati di Chartography e Blueprint-Bench 2 coprono anche la comprensione visiva. Questi test possono aiutare a identificare flussi di lavoro promettenti su documenti e grafici, ma non stabiliscono lo schema completo delle modalità di una futura API pubblica.
Come si comporta Gemini 4 Carbon sui benchmark?
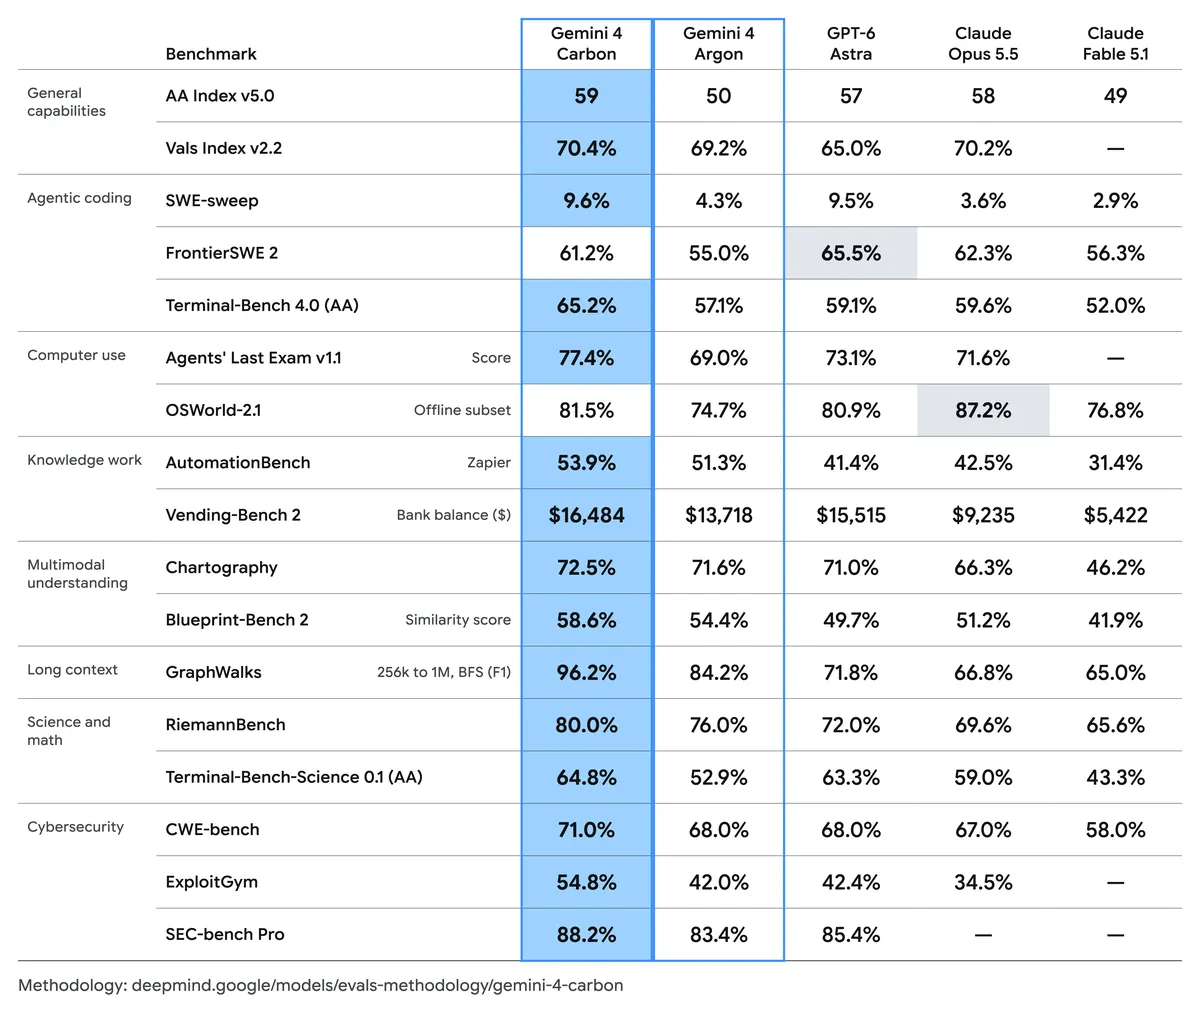
I risultati pubblicati evidenziano tre motivi per valutare Carbon: prestazioni di coding più forti, migliore ragionamento su contesti lunghi e miglioramenti lungo il flusso di lavoro di cybersecurity. L’annuncio ufficiale include il grafico di confronto originale qui sotto; i risultati chiave sono riassunti nella sezione seguente.
Scegli benchmark che assomigliano al tuo carico di lavoro. Un modello che guida un indice di intelligenza generale può comunque essere inferiore a un altro modello su una specifica attività ingegneristica.
Risultati dei benchmark e condizioni di test
Ragionamento complessivo: Carbon ottiene 59 su AA Intelligence Index v5.0, rispetto a 50 per Argon, 57 per GPT-6 Astra e 58 per Claude Opus 5.5.
Coding: Terminal-Bench 4.0 sale dal 57.1% al 65.2%, un miglioramento di 8.1 punti percentuali rispetto ad Argon. SWE-sweep aumenta dal 4.3% al 9.6%.
Ragionamento su contesti lunghi: Carbon ottiene 96.2% sul sottoinsieme BFS F1 256K–1M token di GraphWalks, in aumento rispetto all’84.2% di Argon.
Dove le alternative prevalgono: GPT-6 Astra ottiene 65.5% su FrontierSWE 2 rispetto al 61.2% di Carbon; Claude Opus 5.5 ottiene 87.2% sul sottoinsieme offline di OSWorld rispetto all’81.5% di Carbon. Questi confronti si riferiscono ai modelli e alle impostazioni di valutazione nel grafico pubblicato.
Sui 17 risultati selezionati nel confronto originale, Carbon è in testa in 15. Questa ampiezza lo rende un candidato promettente per flussi di lavoro complessi, ma le due eccezioni mostrano perché il mix di attività specifico è importante. Confronta i modelli su risultati accettati, tempo di completamento e costo piuttosto che mediare punteggi di benchmark non correlati.
La metodologia di valutazione utilizza generalmente l’impostazione di ragionamento più alta e pass@1 salvo diversa indicazione. Combina risultati eseguiti da Google con valutatori esterni e punteggi riportati dai provider, quindi l’impalcatura degli agenti e i budget di ragionamento non sono identici in ogni voce.
GraphWalks: Il sottoinsieme citato utilizza 200 problemi e riporta BFS F1.
Agents’ Last Exam: La valutazione utilizza un set v1.1 da 122 attività, il harness ALE-Claw, una finestra di cinque ore e filtri di sicurezza abilitati.
OSWorld: Il risultato riportato copre un sottoinsieme offline da 82 attività e prende il massimo su tre esecuzioni a tentativo singolo.
Prestazioni di coding nella pratica
Carbon migliora Terminal-Bench 4.0 dal 57.1% al 65.2%, un guadagno di 8.1 punti percentuali. SWE-sweep sale dal 4.3% al 9.6%, più che raddoppiando il punteggio pur rimanendo sotto il 10% in termini assoluti. Questi risultati supportano la valutazione di lavori difficili su repository, mostrando al contempo perché test indipendenti e revisione restano necessari.
Quanto è forte Gemini 4 Carbon nella cybersecurity?
Benchmark e attività di sicurezza
Gemini 4 Carbon
Gemini 4 Argon
Differenza
SEC-bench Pro — individuazione di vulnerabilità
88.2%
83.4%
+4.8 punti percentuali
ExploitGym — validazione degli exploit
54.8%
42.0%
+12.8 punti percentuali
CWE-bench — remediation delle vulnerabilità
71.0%
68.0%
+3.0 punti percentuali
Il guadagno maggiore è nella validazione degli exploit. Per un team difensivo autorizzato, prove riproducibili che una vulnerabilità sia sfruttabile possono migliorare la prioritizzazione; un riscontro plausibile da solo non basta. Le patch richiedono comunque test che confermino che il difetto originale è risolto e che la funzionalità esistente sia preservata.
Google riporta le valutazioni di sicurezza esterne senza guardrail di deployment. SEC-bench Pro utilizza uno specifico split da 183 attività su motore JavaScript; ExploitGym usa un setup offline a tentativo singolo con mitigazioni disattivate. Queste condizioni non stabiliscono un comportamento di produzione senza restrizioni né un tasso di rilevamento per software reale arbitrario.
Gemini 4 Carbon è più sicuro e affidabile di Argon?
Le affermazioni non supportate sono diminuite di circa il 50% rispetto ad Argon nei test interni.
L’overreach degli agenti è diminuito del 26%.
L’under-service è diminuuito del 29%.
Gli alert di misallineamento ad alta severità sono diminuiti di quasi l’80% negli ambienti di coding interni.
Il cheating riuscito su Terminal-Bench 4.0 è sceso allo 0.0% nella valutazione di Google.
Nel benchmark valutato Gray Swan di prompt injection indiretta, il tasso di successo degli attacchi di Carbon è 0.0% contro lo 0.7% di Argon. Ciò significa che gli attacchi valutati non sono riusciti in quell’assetto; non stabilisce immunità a nuovi attacchi o a diversi ambienti di strumenti.
Questi dati provengono da valutazioni diverse e non dovrebbero essere combinati in un unico punteggio di affidabilità.
Per un agente in produzione, mantieni controlli di autorizzazione indipendenti, log di esecuzione e validazione dei risultati dichiarati. Il miglioramento del comportamento del modello aiuta, ma è l’applicazione che deve ancora controllare quali file, servizi e azioni può accedere.
Quanto costa l’API di Gemini 4 Carbon?
Google ha annunciato le tariffe dei token introduttive e successive di Carbon. Le cifre di input memorizzato nella cache riportate di seguito sono calcolate dallo sconto annunciato del 95%; l’implementazione dell’API pubblica e i dettagli di idoneità restano in sospeso.
Categoria di fatturazione, USD per 1M token
Tariffa introduttiva
Tariffa successiva
Token di input
$2.00
$4.00
Token di output
$10.00
$20.00
Token di input in cache idonei
$0.10
$0.20
Il periodo introduttivo di Carbon non ha una data di fine annunciata. La tariffazione introduttiva pubblicata di Argon termina il 30 novembre 2026; quella scadenza non dovrebbe essere applicata a Carbon. Prezzi batch, costi aggiuntivi per strumenti e un livello gratuito non sono stati annunciati per Carbon.
Esempio di costo per richiesta
Supponi che una richiesta utilizzi 200,000 token di input non in cache e 10,000 token di output totali fatturabili. Alle tariffe introduttive annunciate, l’input costa $0.40 e l’output costa $0.10, per un totale di $0.50. Lo stesso uso di token costerebbe $1.00 alle tariffe successive.
Se tutti i 200,000 token di input qualificano per lo sconto annunciato sugli input in cache, la stima introduttiva diventa $0.12 includendo l’output. Si tratta di un’illustrazione condizionale, non di una promessa che ogni input ripetuto sia idoneo.
L’allocazione di output deve includere eventuali token di pensiero fatturati come output secondo le regole finali applicabili. Se 10,000 si riferisce solo alla risposta visibile, ulteriori token di pensiero fatturabili aumenterebbero la stima. Strumenti, retry e altri servizi sono esclusi.
Come possono gli sviluppatori prepararsi all’API di Gemini 4 Carbon?
Disponibilità attuale dell’API di Gemini 4 Carbon
Al 29 ottobre 2026, l’accesso inizia con difensori di cybersecurity selezionati e si espande gradualmente ai partner fidati. Il Fairwind Program di Google descrive un percorso di accesso controllato. Una data di rilascio ampia per gli sviluppatori e l’identificatore pubblico del modello Carbon non sono stati annunciati.
La tariffazione annunciata quindi non significa che un’applicazione possa chiamare oggi una API Carbon generalmente disponibile. Il suo limite di contesto pubblico finale, l’output massimo, lo schema di modalità, la compatibilità degli strumenti e i limiti operativi necessitano ancora di specifiche di produzione documentate.
Al 29 ottobre 2026, Google non ha ancora lanciato una API Carbon generalmente disponibile, quindi Carbon non è ancora disponibile tramite CometAPI. Nel frattempo, puoi usare Gemini 4 Argon per una valutazione iniziale. Controlla la pagina Carbon di CometAPI per disponibilità e prezzi del provider quando l’accesso si aprirà.
Alternative in attesa dell’API Carbon
Puoi iniziare a valutare il tuo flusso di lavoro di coding prima che Carbon diventi ampiamente disponibile. Costruisci una baseline con un modello accessibile oggi, quindi confronta Carbon sugli stessi compiti quando la sua API si aprirà. Tre opzioni da considerare sono Gemini 4 Argon, GPT-6.1 Astra e Claude Opus 5.5; conferma il nome esatto del modello, l’accesso e il prezzo con il tuo provider prima di scegliere una strada.
Gemini 4 Argon: Inizia qui se già usi Gemini o desideri una baseline diretta per Carbon. Prova modifiche rappresentative al repository, code review e bug fix, e registra quali output superano i tuoi test di accettazione.
**GPT-6.1 Astra:** Includilo come confronto cross‑provider per le stesse attività ingegneristiche. Misura le correzioni accettate, il tempo di completamento e il costo totale. I risultati di GPT-6 Astra discussi in precedenza si applicano a quella versione valutata e non vanno trattati come punteggi di GPT-6.1 Astra.
**Claude Opus 5.5:** Aggiungilo come altro candidato per analisi del repository, refactoring e review. Usa le stesse descrizioni dei compiti e criteri di validazione per poter confrontare il valore pratico di ciascun risultato.
Mantieni la selezione del modello configurabile e salva prompt, casi di test e risultati di ogni esecuzione. Questo ti offre un punto di partenza utile per valutare Carbon senza vincolare il tuo flusso di lavoro a un formato di API non annunciato.
Benchmark
Gemini 4 Carbon
Gemini 4 Argon
GPT-6 Astra
Claude Opus 5.5
AA Intelligence Index v5.0
59
50
57
58
Vals Index v2.2
70.4%
69.2%
65.0%
70.2%
SWE-sweep
9.6%
4.3%
9.5%
3.6%
FrontierSWE 2
61.2%
55.0%
65.5%
62.3%
Terminal-Bench 4.0 (AA)
65.2%
57.1%
59.1%
59.6%
Agents' Last Exam v1.1
77.4%
69.0%
73.1%
71.6%
OSWorld-2.1, offline subset
81.5%
74.7%
80.9%
87.2%
AutomationBench, Zapier
53.9%
51.3%
41.4%
42.5%
Prepara un flusso di valutazione del modello
Un framework di valutazione pratico dovrebbe misurare più della qualità generale delle risposte.
Per flussi di lavoro di coding e sicurezza, metriche utili includono:
Tasso di completamento dei compiti: con quale frequenza l’agente soddisfa test di accettazione predefiniti?
Correttezza della patch: la modifica proposta affronta il difetto originale senza compromettere il comportamento esistente?
Tasso di falsi positivi: con quale frequenza un problema segnalato non supera la validazione?
Latenza end‑to‑end: quanto tempo impiega l’intero flusso di lavoro, inclusa l’esecuzione degli strumenti?
Costo totale del compito: quanto costa ciascun risultato accettato dopo retry e uso di strumenti?
Conformità alle istruzioni: l’agente rimane entro file, strumenti e azioni autorizzati?
Usa un set fisso di compiti reali e conserva un record di ogni modello, delle sue impostazioni, dell’uso di token e dei risultati dei test. Includi retry e correzioni manuali nel costo. Una volta che Carbon sarà disponibile, esegui la stessa valutazione per vedere se offre più lavoro accettato per il tuo tempo e budget.
Conclusione
Gemini 4 Carbon è un upgrade promettente per coding impegnativo, ragionamento su contesti lunghi e lavoro di sicurezza difensiva. I risultati pubblicati mostrano chiari guadagni rispetto ad Argon, mentre l’accesso iniziale resta limitato al 29 ottobre 2026. Per ora, stabilisci una baseline con un modello disponibile e mantieni l’integrazione flessibile. Quando l’API pubblica di Carbon si aprirà, confronta qualità del lavoro completato, tempo risparmiato e costo totale prima di decidere se passare.
FAQ
Gemini 4 Carbon può operare senza supervisione umana?
Le segnalazioni di lavoro ingegneristico interno su più giorni non stabiliscono affidabilità non supervisionata per compiti arbitrari. Un team che considera l’esecuzione autonoma dovrebbe definire azioni consentite, condizioni di arresto e test di accettazione, quindi misurare con quale frequenza l’agente completa il lavoro senza correzioni. La sola durata di esecuzione non dimostra che l’output di un agente sia corretto.
Un’integrazione esistente di Argon può passare direttamente a Carbon?
Non sulla base delle evidenze disponibili qui. Mantieni la selezione del provider configurabile, ma verifica l’effettivo identificatore del modello Carbon, lo schema supportato, gli strumenti, i limiti e l’accesso all’account prima di modificare una distribuzione. Riutilizzare un prompt può aiutare in un confronto controllato; non dimostra compatibilità dell’API.
Quali test di Gemini 4 Carbon contano per una codebase privata?
Includi bug rappresentativi, modifiche al repository e riscontri di sicurezza con criteri di accettazione noti. Verifica se le patch superano i test pertinenti, se i riscontri sono riproducibili e se si evitano cambiamenti di comportamento non correlati. Includi tentativi falliti e correzione manuale nell’analisi dei costi affinché un punteggio pubblico forte non nasconda il lavoro operativo.