
TL;DR
Kimi K3.1 Pro porta prestazioni più solide nel coding, nel CAD e nella ricerca finanziaria sulla base K3 di Moonshot AI, con una finestra di contesto da un milione di token. Il punteggio pubblicato su Terminal-Bench 4.0 del 65,7% lo colloca vicino a Claude Opus 5.5 nel confronto di Moonshot. Il modello standard è adatto a carichi di lavoro sensibili ai costi; Highspeed offre un output circa 2–3× più rapido con le stesse capacità dichiarate.
Entrambi sono disponibili tramite l’API Kimi K3.1 Pro di CometAPI. La tariffazione standard di CometAPI è di $1,60 per milione di token di input e $8,00 per milione di token di output. Questa guida spiega i benchmark, confronta i costi e mostra come chiamare entrambe le versioni. Dati e prezzi sono stati verificati il 24 ottobre 2026.
Key Takeaways
- Kimi K3.1 Pro è un aggiornamento post-training: si basa sulla fondazione MoE di K3 e supporta una finestra di contesto da 1.048.576 token.
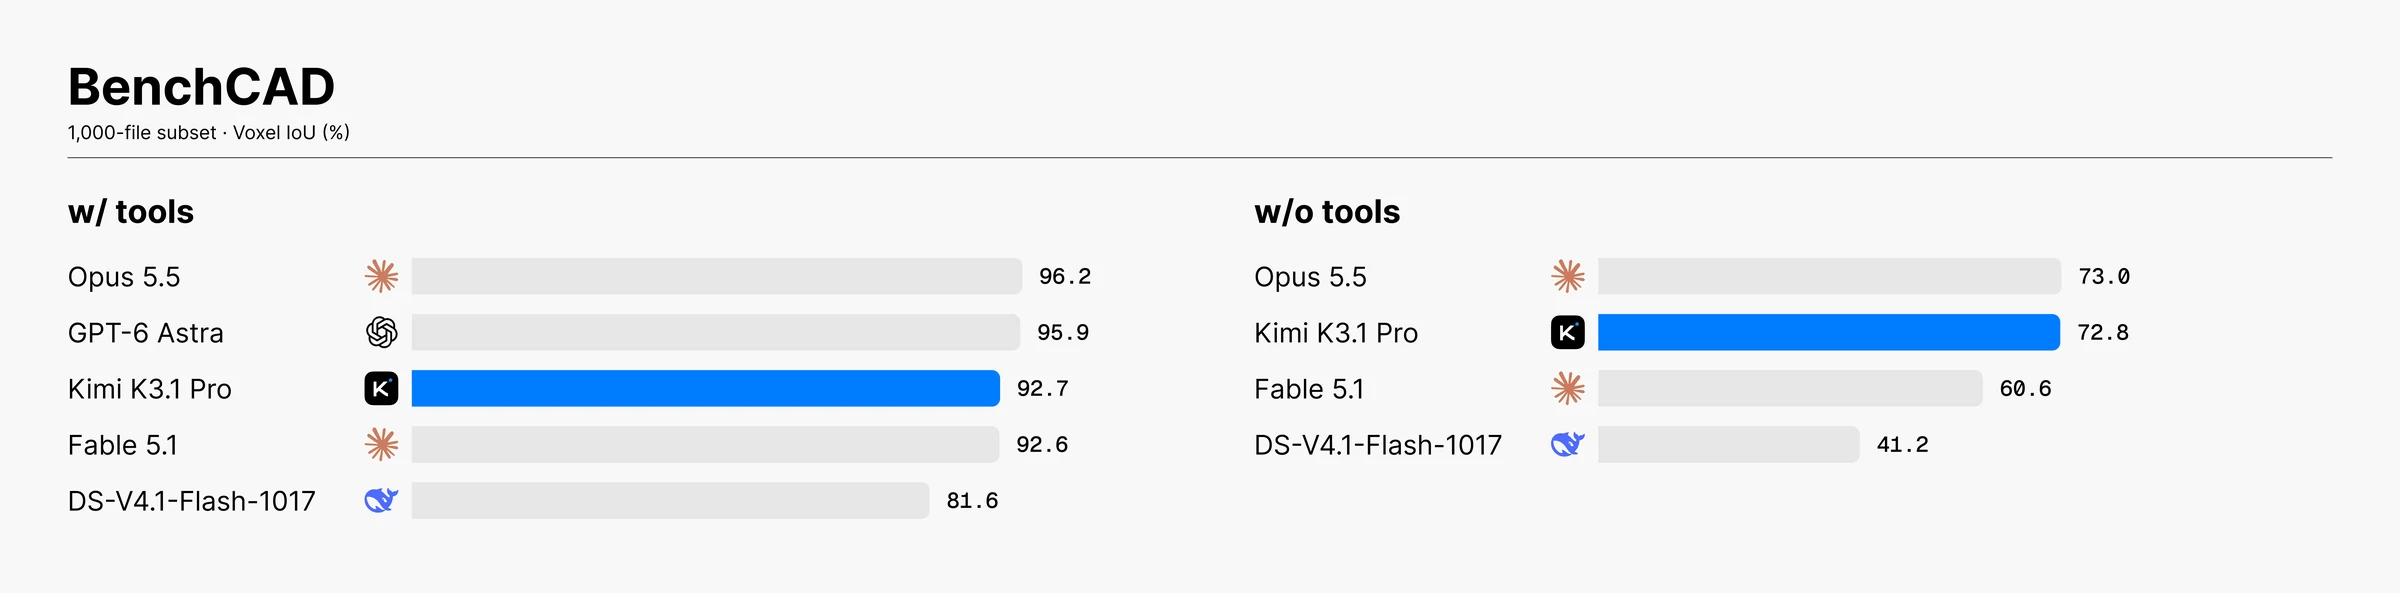
- Kimi K3.1 Pro rafforza i workflow degli agent: Moonshot riporta 65,7% su Terminal-Bench 4.0 e 92,7% di Voxel IoU su BenchCAD con strumenti.
- Kimi K3.1 Pro Highspeed privilegia la velocità di risposta: la velocità di output dichiarata è circa 2–3× rispetto alla versione standard, con le stesse capacità del modello.
- L’accesso all’API di Kimi K3.1 Pro è disponibile tramite CometAPI: le tariffe di input e output standard sono inferiori del 20% rispetto alle tariffe ufficiali in USD pubblicate; la tariffazione Highspeed richiede una verifica separata dell’account.
- L’accesso hosted a Kimi K3.1 Pro precede il rilascio completo dei pesi: Moonshot prevede di pubblicare i pesi completi entro il 4 novembre 2026.
What Exactly Is Kimi K3.1 Pro?
Kimi K3.1 Pro è il modello linguistico di punta di Moonshot AI (月之暗面) con sede a Pechino, rilasciato il 23 ottobre 2026. Non è un nuovo modello di base completo. È invece una versione ampiamente post-addestrata del precedente Kimi K3 (lanciato a luglio 2026), usando un compute di post-training significativamente maggiore, focalizzato su reinforcement learning congiunto su centinaia di domini downstream.
Moonshot lo descrive come “il nostro modello open-weight di classe 3T più capace fino ad oggi”. Il modello mantiene la stessa architettura core di K3:
- 2,8 trilioni di parametri totali
- 104 miliardi di parametri attivi per token (design MoE sparso)
- Finestra di contesto nativa da 1 milione di token
- Supporto multimodale (input di testo, immagini e video)
- Ragionamento sempre attivo (nessuna modalità senza ragionamento)
Una variante complementare, Kimi K3.1 Pro Highspeed, offre una velocità di inferenza 2–3× rispetto alla versione Pro standard al doppio del prezzo, rendendola adatta ad applicazioni più interattive o sensibili alla latenza.
Il rilascio pubblico dei pesi completi del modello è programmato per il 4 novembre 2026, il che renderebbe K3.1 Pro uno dei modelli open-weight più potenti disponibili.
Kimi 3.1 Pro Technical Specifications
| Specification | Details |
|---|---|
| Model Family | serie Kimi K3.1 (primo modello) |
| Base | Kimi K3 con post-training |
| Total Parameters | 2,8 trilioni |
| Active Parameters | 104 miliardi (MoE) |
| Context Window | 1.048.576 token |
| Max Output | Fino a ~944K–1M token (configurabile) |
| Input Modalities | Testo, Immagine, Video |
| Output | Testo |
| Reasoning | Sempre attivo (livelli di impegno basso/alto/massimo) |
| Tool Calling | Supportato |
| Structured Output (JSON) | Supportato |
| API Model IDs | kimi-k3.1-pro, kimi-k3.1-pro-highspeed |
| Open Weights | Entro il 4 novembre 2026 |
imi K3.1 Pro Benchmarks: Coding, CAD, and Finance
La tabella seguente utilizza le valutazioni di rilascio di Moonshot. Si tratta di risultati di benchmark riportati dal provider, non di un test riprodotto in modo indipendente tra provider.
I tassi di allucinazione sono diminuiti drasticamente: Moonshot riporta che le affermazioni false sono scese dal 23,4% su K3 a circa l’8,3% (o inferiore nei test interni). Anche la modellizzazione e la ricerca in ambito finance sono migliorate significativamente.
| Benchmark | Kimi K3.1 Pro | Claude Opus 5.5 | GPT-6 Astra | Nota |
|---|---|---|---|---|
| Terminal-Bench 4.0 | 65.7% | 66.4% | 58.2% | Agenti di coding su task terminal realistici |
| BenchCAD, with tools (Voxel IoU) | 92.7% | 96.2% | 95.9% | Ricostruzione 3D / CAD |
| OfficeQA Pro v2 | 64.4 | 62.2 | 54.4 | Attività su documenti e office |
| Frontier Finance | 58.6 | 56.7 | 45.0 | Finanza |
| SWE-Marathon | 51.7% | 46.3% | 42.5% | Ingegneria del software a lungo orizzonte |
| Humanity’s Last Exam (with tools) | 70.0% | 67.7% | 57.2% | Conoscenza generale e ragionamento |
| Kimi Hallu Bench Hard, with tools (lower is better) | 8.3% | 15.0% | 5.5% | più basso è meglio |
I benchmark di coding mostrano prestazioni da frontiera per gli agent
Su Terminal-Bench 4.0, il divario con Claude Opus 5.5 è di 0,7 punti percentuali; il vantaggio su GPT-6 Astra è di 7,5 punti. Questo rende K3.1 Pro un candidato rilevante per agent di ingegneria basati su terminale, ma l’impostazione della valutazione conta tanto quanto il punteggio di testata.
Nota che alcuni test indipendenti sugli agent di coding mostrano risultati più misti a seconda dell’esatto harness e della lunghezza della sessione, con K3.1 Pro che talvolta produce tracce di ragionamento più lunghe e verbose.
Kimi K3.1 Pro migliora la creazione 3D e la visione
BenchCAD misura la qualità della ricostruzione da render multi-view tramite codice CAD generato. Il punteggio di Voxel IoU misura la sovrapposizione geometrica, quindi 92,7% non deve essere interpretato come un tasso di superamento del compito del 92,7%. Il confronto con strumenti di Moonshot usa un sottoinsieme da 1.000 casi e colloca K3.1 Pro sotto Opus 5.5 e GPT-6 Astra su questa metrica.
Mostra anche ampi incrementi rispetto a Kimi K3 nelle attività visione-linguaggio (ad es., +0.11 mAP50 sulla leaderboard di auto-annotazione di Ultralytics) e negli esami di data analytics (42/43 domande superate).
What’s New in Kimi K3.1 Pro Compared With Kimi K3?
Il motivo più chiaro per considerare un upgrade è il miglior completamento del lavoro multi-step. La tabella seguente confronta K3 e K3.1 Pro all’interno delle valutazioni riportate da Moonshot.
| Evaluation | Kimi K3 | Kimi K3.1 Pro | Improvement |
|---|---|---|---|
| Kimi Code Bench 3.0 Long-horizon | 55.95% | 61.2% | +5.25 punti |
| Internal Financial Modeling | 50.4 | 57.6 | +7.2 punti |
| Internal Financial Research | 58.8 | 70.4 | +11.6 punti |
| Internal Business Operation | 8.9 | 37.0 | ~4.2× prestazioni |
| Kimi Hallu Bench Hard with tools, claim-level errors | 23.4% | 8.3% | ~64.5% riduzione |
Tuttavia, questi sono confronti su singoli benchmark. Non devono essere interpretati come un miglioramento universale di 4,2× nelle prestazioni degli agent.
Kimi K3.1 Pro riduce gli errori fattuali
Il grafico separa i risultati senza strumenti dalla valutazione più difficile con strumenti; l’8,3% appartiene a quest’ultima.
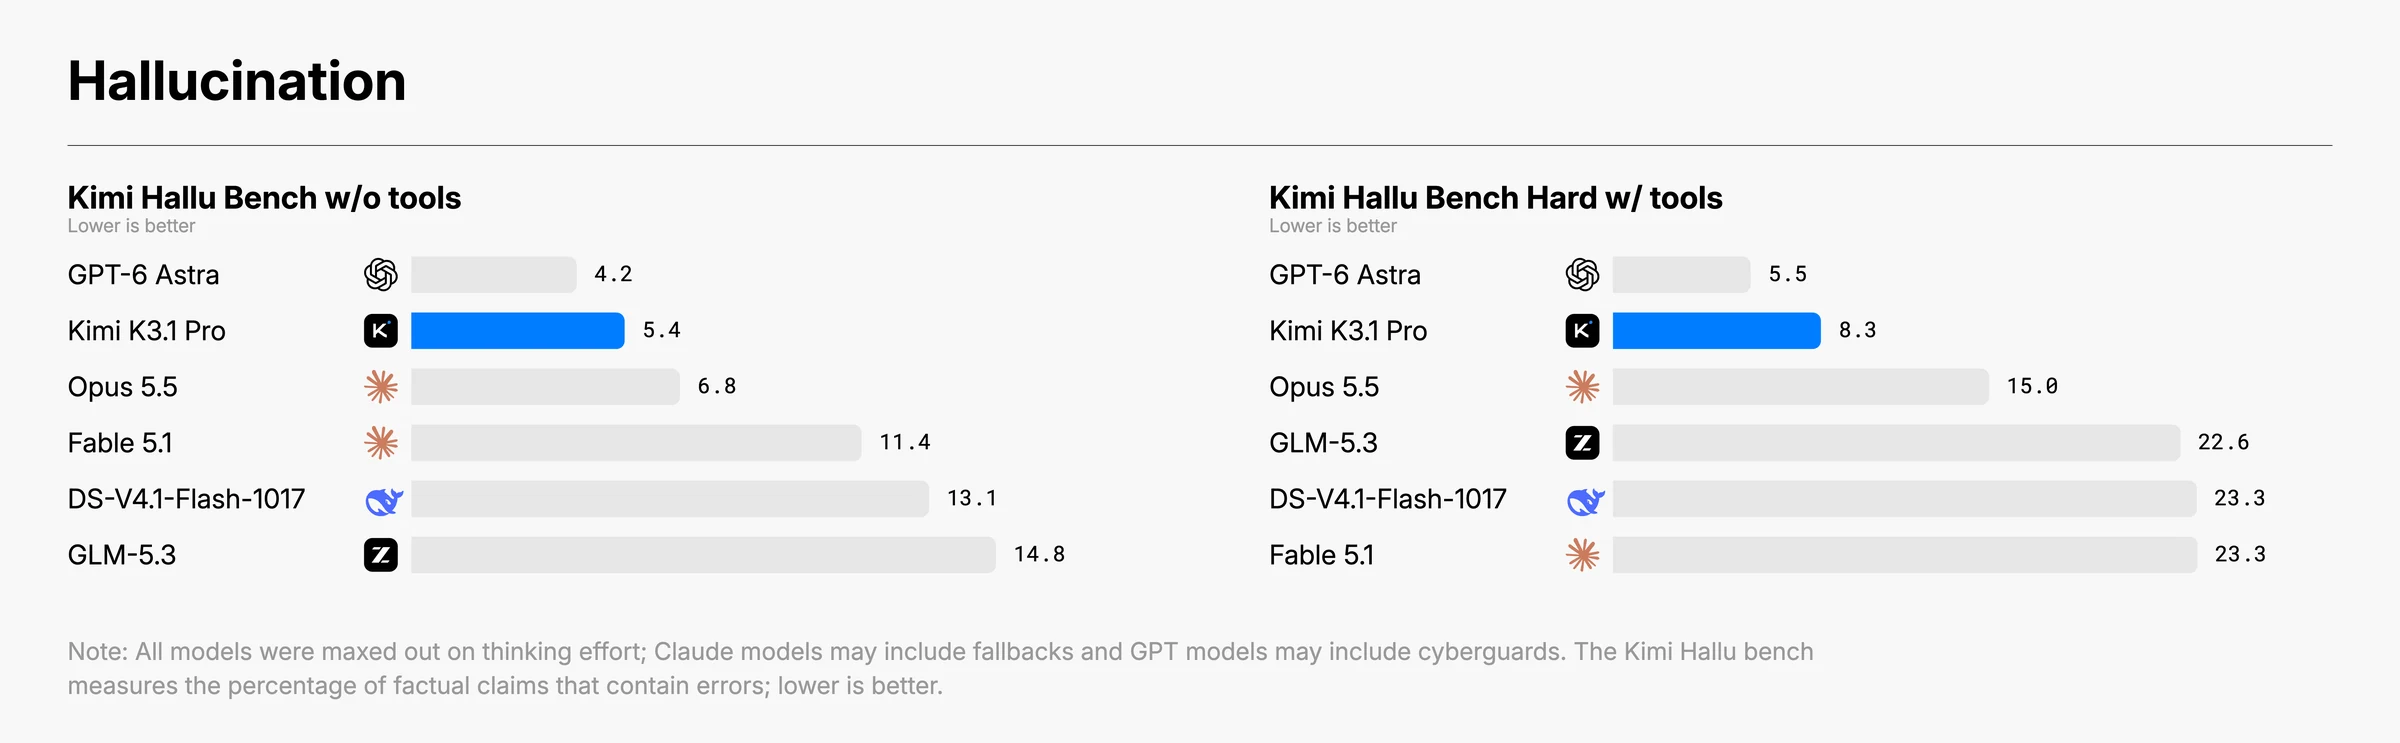
La distinzione tra accuratezza nei benchmark e affidabilità nel mondo reale è importante. Questa valutazione utilizza deliberatamente prompt difficili che probabilmente mettono in evidenza errori fattuali. I risultati non rappresentano il tasso medio di allucinazione del modello nelle conversazioni quotidiane.
Kimi K3.1 Pro introduce un compromesso deliberato in cybersecurity
Moonshot AI ha rimosso selezionati dati di training e task di reinforcement learning relativi alla cybersecurity offensiva per ridurre tali capacità, preservando al contempo le prestazioni di coding generico.
Nella valutazione interna xdev-bench-hard di Moonshot a pass@3, il checkpoint non ristretto ha ottenuto il 90.5% e il modello di rilascio l’81.0%. Questa differenza riflette una scelta di training deliberata, non una garanzia che il modello rilasciato non possa essere usato in modo improprio. Vedi la valutazione ufficiale di cybersecurity per le condizioni e i limiti.
Kimi K3.1 Pro vs Highspeed: Which Version Should You Choose?
| Decision factor | Kimi K3.1 Pro | Kimi K3.1 Pro Highspeed |
|---|---|---|
| Model capabilities | Capacità standard di punta | Stesse capacità dichiarate |
| Output speed | Standard | Circa 2–3× più veloce |
| Best starting workload | Analisi batch, report lunghi, attività in background | Coding interattivo e assistenti di ricerca |
| CometAPI model ID | kimi-k3.1-pro | kimi-k3.1-pro-highspeed |
Usa la versione standard quando il costo conta più dell’immediatezza dell’output. Scegli Highspeed quando gli utenti attendono la generazione, quindi misura l’effetto sui task completati invece di assumere che la velocità di output si traduca direttamente nello stesso risparmio di tempo complessivo.
Ad esempio, se un agent di coding impiega la maggior parte del tempo a eseguire test, installare dipendenze o attendere strumenti esterni, accelerare l’output del modello può produrre un miglioramento end-to-end relativamente ridotto.
Accedi a entrambe le versioni di Kimi K3.1 Pro tramite CometAPI
CometAPI offre accesso a Kimi K3.1 Pro e Kimi K3.1 Pro Highspeed tramite l’endpoint Chat Completions compatibile con OpenAI. L’integrazione resta la stessa quando passi da una versione all’altra; cambia l’ID modello per selezionare la variante.
- Crea una API key nel tuo account CometAPI e rendila disponibile alla tua applicazione come variabile d’ambiente COMETAPI_API_KEY.
- Installa l’SDK Python di OpenAI, quindi imposta la base URL del client su
https://api.cometapi.com/v1. - Usa kimi-k3.1-pro per il modello standard o kimi-k3.1-pro-highspeed per Highspeed.
python -m pip install --upgrade openaiimport osfrom openai import OpenAIclient = OpenAI( api_key=os.environ["COMETAPI_API_KEY"], base_url="https://api.cometapi.com/v1",)response = client.chat.completions.create( model="kimi-k3.1-pro", # Oppure "kimi-k3.1-pro-highspeed" messages=[ { "role": "user", "content": "Suggerisci tre test per una funzionalità di importazione CSV.", } ],)print(response.choices[0].message.content)
Il seguente esempio da shell chiama direttamente Highspeed. Usa la stessa variabile d’ambiente COMETAPI_API_KEY.
Kimi K3.1 Pro API Pricing: Official Rates vs CometAPI
La tabella confronta le tariffe pubblicate in USD per un milione di token per input non in cache e output generato, verificate il 24 ottobre 2026. Le tariffe standard di CometAPI per K3.1 Pro sono inferiori del 20% rispetto a quelle ufficiali. Verifica le tariffe correnti del tuo account per Highspeed prima di scegliere quella versione.
| Model | Official input | Official output | CometAPI input | CometAPI output |
|---|---|---|---|---|
| Kimi K3.1 Pro | $2.00 | $10.00 | $1.60 | $8.00 |
| Kimi K3.1 Pro Highspeed | $4.00 | $20.00 | Check account pricing | Check account pricing |
Lo sconto della versione standard non deve essere dato per scontato per Highspeed. Letture e scritture di cache, costi degli strumenti, tasse e retry sono esclusi da questo confronto.
Alle tariffe API ufficiali, K3.1 Pro è circa il 33,3% più economico di K3 per token di input e output non in cache.
Per richieste senza caching o servizi aggiuntivi a pagamento, il costo è:
Costo = (Token di input × Tariffa input + Token di output × Tariffa output) / 1.000.000
Ad esempio, elaborare 100.000 token di input non in cache e generare 10.000 token di output costa circa $0,24 tramite l’API standard K3.1 Pro di CometAPI, rispetto a $0,30 alla tariffa del provider ufficiale.
Stima la spesa di produzione a partire dai task riusciti, includendo eventuali retry o token di ragionamento indicati nei tuoi record di fatturazione. Una tariffa per token più bassa non garantisce un costo totale inferiore se un workflow produce più token o richiede tentativi aggiuntivi.
Put Kimi K3.1 Pro to Work: Four Practical Starting Points
Scegli un piccolo workflow con un output che puoi ispezionare.
| Workflow | A practical first project | Acceptance checks |
|---|---|---|
| Software engineering | Correggi un bug riproducibile in un repository e aggiungi un controllo di regressione. | I test rilevanti passano; la patch risolve il problema senza modifiche non correlate. |
| CAD and 3D creation | Genera una parte parametrica da un brief con quote. | Verifica le dimensioni, la validità della geometria, la modificabilità e la compatibilità di export. |
| Financial research | Riconcilia cifre selezionate tra relazioni annuali e un workbook. | Verifica ogni cifra rispetto alla fonte e controlla le formule in modo indipendente. |
| Long-context research | Confronta i requisiti in una raccolta di documenti tecnici. | Controlla le posizioni delle evidenze, le versioni dei documenti e la copertura di affermazioni in conflitto. |
Per la valutazione, il successo dei task completati è più informativo del numero di righe di codice generate.
What Are the Limitations of Kimi K3.1 Pro?
- Reasoning sempre abilitato. K3.1 Pro supporta livelli di impegno basso, alto e massimo, con “max” come default documentato. Non dare per scontata l’esistenza di una modalità senza ragionamento.
- Gli input lunghi hanno costi operativi. Una grande finestra di contesto può aumentare il tempo di elaborazione dell’input e il consumo di token. Seleziona materiale rilevante e valuta la cache invece di inviare un intero archivio per default.
- Una risposta API non completa un workflow esterno. La tua applicazione fornisce esecuzione degli strumenti, stato salvato e validazione dell’output; un risultato di benchmark con strumenti non significa che tali capacità siano incluse in una semplice chiamata API.
- L’accesso hosted e i pesi scaricabili sono traguardi diversi. Al 24 ottobre, il rilascio completo dei pesi di K3.1 Pro è ancora pianificato per il 4 novembre 2026; esamina il rilascio e la licenza prima di pianificare l’auto-hosting.
Il comportamento dell’API è descritto nella guida API Kimi; la disponibilità dei pesi è trattata nell’annuncio di rilascio.
Conclusion
Kimi K3.1 Pro vale la pena di essere valutato quando la tua applicazione dipende da coding multi-step, ricerca documentale o lavoro assistito da strumenti. I guadagni riportati rispetto a K3 e le tariffe API standard più basse creano un motivo concreto per testare l’upgrade. Inizia con il modello standard, misura qualità e costo dei task accettati e scegli Highspeed laddove una generazione più rapida migliori in modo sostanziale l’esperienza utente. Usa il modello CometAPI per verificare accesso e prezzi correnti prima di integrare gli esempi sopra.