
TL;DR
Step 5 Preview è il modello di punta di StepFun per l’ingegneria del software, la ricerca finanziaria e i workflow agentici complessi. Combina prestazioni competitive sui task con inferenza a costo efficiente, sebbene i risultati varino a seconda dei benchmark. Gli sviluppatori possono accedervi tramite un’API hosted oppure distribuire i pesi aperti, in base a budget, infrastruttura e requisiti di performance.
Key Takeaways
- Architettura: Step 5 Preview utilizza un’architettura MoE sparsa con 600B di parametri totali e 27B attivi per token, bilanciando capacità del modello ed efficienza di inferenza.
- Contesto e supporto multimodale: Il modello supporta una finestra di contesto da 1M token, input di testo, immagini e video, e fino a 64K token di output tramite la sua API hosted.
- Prestazioni sui benchmark: Step 5 Preview ottiene 67,7% su DeepSWE v1.1 e 66,4% su FrontierFinance, ma è dietro a diversi competitor su Terminal-Bench v4.
- Prezzi API: StepFun addebita $1,00 per input non in cache, $0,10 per input in cache e $2,70 per output per milione di token.
- Flessibilità di deployment: Gli sviluppatori possono accedere a Step 5 Preview tramite l’API hosted di StepFun o eseguire in self-hosting i pesi rilasciati usando framework compatibili come vLLM, SGLang e Transformers.
What Is Step 5 Preview?
Step 5 Preview è un grande modello di ragionamento multimodale sviluppato da StepFun (阶跃星辰). È rivolto a carichi di lavoro che richiedono ragionamento esteso, esecuzione ripetuta di tool e analisi su ampie collezioni di informazioni. StepFun fornisce accesso via API hosted e pubblica i pesi del modello scaricabili.
A differenza degli assistenti generalisti ottimizzati principalmente per risposte conversazionali, Step 5 Preview enfatizza l’esecuzione agentica: la capacità di pianificare, usare strumenti, ispezionare risultati intermedi, correggere errori e proseguire verso un obiettivo complesso.
Key Specifications
La scheda modello ufficiale documenta l’architettura sparsa, il conteggio dei parametri e le configurazioni di deployment. Le specifiche dell’API hosted definiscono separatamente gli input supportati, i limiti di generazione e le funzionalità di serving. Sono livelli diversi del contratto di distribuzione.
L’API hosted documenta un output massimo di 64k token, mentre la scheda modello indica una capacità di generazione di sequenze fino a 1M token. Quest’ultima non implica che l’endpoint hosted accetti una completion da 1M token. Negli esempi self-hosted con vLLM, il budget di sequenza da 1M token copre input e output insieme; memoria KV-cache disponibile e concorrenza possono ridurre la capacità utilizzabile.
How the 600B/27B MoE Architecture Works
Un transformer denso convenzionale attiva la maggior parte dei suoi parametri durante l’inferenza. Step 5 Preview invece usa un instradamento sparso per selezionare gli esperti rilevanti. Con circa 27B di parametri attivi su 600B, circa il 4,5% del conteggio totale dei parametri partecipa al calcolo di un tipico token.
Questa distinzione spiega la strategia di efficienza dei costi del modello. Tuttavia, 27B attivi non significa un footprint di deployment da 27B. I pesi di tutti gli esperti devono comunque essere archiviati e accessibili, rendendo fondamentali la capacità di memoria GPU, il parallelismo degli esperti e la banda dell’interconnessione.
Supported Inputs and Output Limits
L’API hosted accetta testo, immagini e video, con una finestra di contesto fino a 1M token e un output massimo di 64k token. Questi input supportano attività come l’analisi di repository, la ricerca sui documenti finanziari e l’interpretazione visiva. Nel self-hosting, la lunghezza di sequenza utilizzabile dipende dalla configurazione di runtime, dalla memoria disponibile e dalla concorrenza.
Il supporto multimodale e le capacità dell’API possono differire tra configurazioni hosted e self-hosted.
How Does Step 5 Preview Perform on Benchmarks?
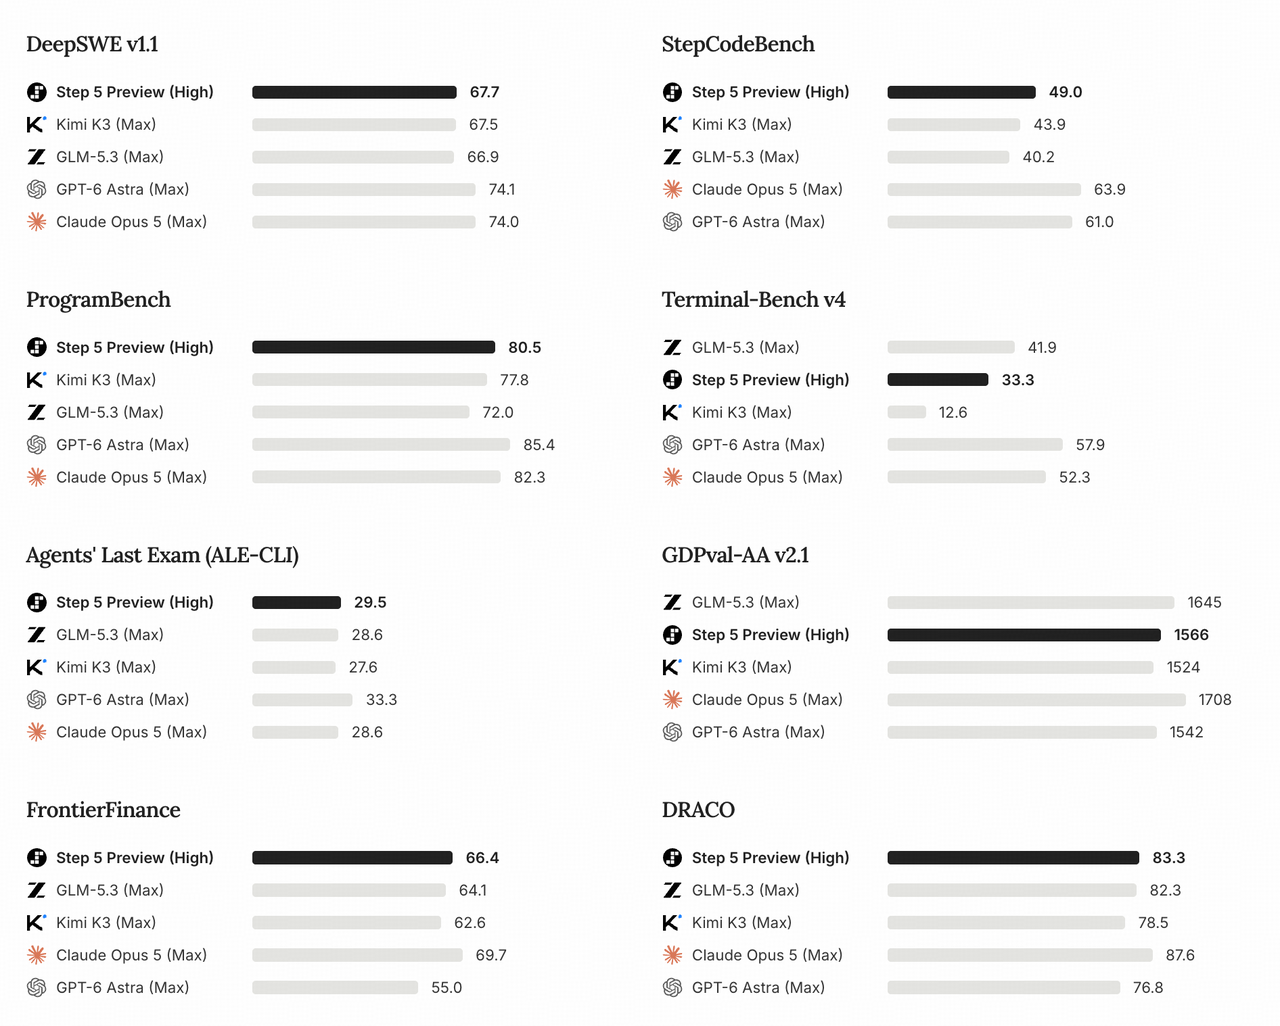
Di seguito sono riportati i risultati dichiarati da StepFun. Step 5 Preview usa l’impostazione High di reasoning; i modelli di confronto usano Max. Allineare i nomi delle etichette non stabilisce una parità di calcolo, e questi punteggi pubblicati non misurano la latenza applicativa né il costo per task riuscito.
Il grafico ufficiale originale riassume i risultati di valutazione del publisher. Le tabelle seguenti estraggono i punteggi di coding, ragionamento e finanza rilevanti per questa analisi.
Coding and Agentic Performance
I punteggi sono percentuali, con valori più alti che indicano prestazioni migliori su ciascun benchmark. DeepSWE v1.1 usa l’harness SWE-agent con temperature=1.0 e top_p=0.95; StepCodeBench riporta avg@4, mentre ProgramBench riporta il pass rate. Ogni benchmark misura un task diverso con il proprio setup di valutazione, quindi le percentuali non sono misure di accuratezza intercambiabili. Il confronto pubblicato non stabilisce hardware o budget di esecuzione identici tra i modelli.
Su DeepSWE v1.1, Step 5 Preview ottiene il 67,7%, superando di poco Kimi K3 e GLM-5.3. Ciò suggerisce prestazioni competitive per agenti di coding che lavorano con repository e attività di ingegneria del software automatizzata.
ProgramBench fornisce un ulteriore segnale positivo. Step 5 Preview raggiunge l’80,5%, rispetto al 77,8% di Kimi K3 e al 72,0% di GLM-5.3.
Tuttavia, Terminal-Bench v4 evidenzia una limitazione significativa: il 33,3% di Step 5 Preview è inferiore al 41,9% di GLM-5.3, mentre GPT-6 Astra raggiunge il 57,9%. L’implicazione è che Step 5 Preview è competitivo nell’ingegneria del software orientata ai repository, ma il suo vantaggio relativo non si estende in modo uniforme all’esecuzione da terminale e al debugging complesso.
Reasoning and Knowledge Performance
Step 5 Preview ottiene il 93,5% su GPQA Diamond, eguagliando Kimi K3 e rimanendo dietro a GPT-6 Astra al 96,1%. Su AA-LCR v1.1, il suo 88,3% è leggermente sotto l’88,7% di Kimi K3 e sopra l’80,7% di GPT-6 Astra. È inoltre dietro a Kimi K3 e GPT-6 Astra su Humanity’s Last Exam e CritPt. I risultati indicano conoscenza e ragionamento su contesti lunghi competitivi, con punti di forza relativi che variano per task.
Financial Research and Valuation Performance
La ricerca finanziaria è uno degli ambiti applicativi più distintivi di Step 5 Preview. Il modello è progettato per combinare ragionamento quantitativo, recupero di evidenze e analisi strutturata. Queste capacità sono particolarmente rilevanti per valutazioni, interpretazione di documenti finanziari e ricerca d’investimento.
StepFun ha introdotto FinStepBench per valutare la ricerca finanziaria in più fasi, dalla raccolta di informazioni alla produzione di conclusioni difendibili.
Punteggi più alti indicano prestazioni migliori sul benchmark. FinStepBench è sviluppato da StepFun, quindi la validazione indipendente è particolarmente importante.
Step 5 Preview raggiunge il 66,4% su FrontierFinance, superando Kimi K3, GLM-5.3 e GPT-6 Astra nelle configurazioni riportate. Tuttavia, Claude Opus 5 resta avanti con il 69,7%.
Il risultato su FinStepBench DeepResearch è particolarmente degno di nota. Step 5 Preview arriva al 55,8%, rispetto al 48,9% di Kimi K3 e al 53,3% di GLM-5.3. Ciò suggerisce che il modello possa essere ben adatto a workflow di ricerca finanziaria che richiedono recupero, sintesi e analisi estesa.
Il punteggio su CorporateValuation racconta una storia più sfumata. Al 60,6%, Step 5 Preview è molto lontano dal 77,3% di GPT-6 Astra. Pertanto, Step 5 Preview non va considerato universalmente superiore per l’analisi finanziaria. Il suo posizionamento relativo è più forte su DeepResearch che su CorporateValuation, a sostegno di una valutazione specifica per task anziché di un’affermazione ampia di superiorità finanziaria.
Per applicazioni in produzione, gli output finanziari richiedono ancora calcoli validati in modo indipendente, assunzioni documentate e evidenze di supporto tracciabili.
Step 5 Preview vs Other AI Models
Step 5 Preview compete sia con alternative hosted sia con servizi frontier proprietari. I risultati sui benchmark aiutano a identificare i modelli candidati; accesso API, supporto agli input, controllo del deployment e costo reale del carico determinano quale candidato si adatti a un’applicazione di produzione.
CometAPI offre accesso a Kimi K3, GLM-5.3, GPT-6 Astra, e Claude Opus 5. Queste alternative forniscono utili termini di paragone per qualità del carico, latenza e costi.
Step 5 Preview offre un checkpoint MoE sparso 600B/27B documentato e un’opzione di self-hosting. Per le alternative, disponibilità dei pesi, conteggio dei parametri, limiti di contesto e input accettati dipendono dal modello e dall’endpoint. I benchmark pubblicati possono aiutare a costruire una shortlist; task rappresentativi di coding e ricerca rivelano come ciascun servizio si comporta in pratica.
Step 5 Preview vs Kimi K3
Step 5 Preview performa leggermente meglio su DeepSWE v1.1, ProgramBench e FrontierFinance. Kimi K3 rimane competitivo nel ragionamento e in alcune altre valutazioni tecniche. La distinzione pratica riguarda meno un vantaggio decisivo di “intelligenza” e più i costi, le condizioni di serving e l’affidabilità specifica per task a disposizione degli sviluppatori.
Step 5 Preview vs GLM-5.3
Step 5 Preview guida GLM-5.3 in diverse valutazioni di finanza e sviluppo software. Tuttavia, il punteggio superiore di GLM-5.3 su Terminal-Bench v4 suggerisce un vantaggio nei task riportati orientati al terminale. Per agenti di coding, confrontate modifiche a repository riuscite, errori di tool-call, tempo di esecuzione e correttezza delle patch invece di affidarvi a un singolo punteggio aggregato.
Step 5 Preview vs GPT-6 Astra and Claude Opus 5
I modelli frontier proprietari generalmente performano meglio sui benchmark di ingegneria del software più difficili. L’attrazione principale di Step 5 Preview è che si avvicina a capacità competitive su carichi selezionati offrendo al contempo un’opzione a pesi aperti e prezzi API relativamente accessibili.
Scegliete un modello premium quando il costo del fallimento è alto e un’accuratezza incrementale del task giustifica la spesa aggiuntiva. Considerate Step 5 Preview quando prezzo, controllo del deployment ed esecuzione agentica ripetuta pesano di più.
How Much Does Step 5 Preview API Cost?
Il valore di Step 5 Preview dipende sia dalla capacità sul task sia dal costo operativo. I workflow agentici possono coinvolgere dozzine di chiamate, recupero ripetuto di documenti e retry, quindi un prezzo per token più basso aiuta solo quando il modello completa il task in modo affidabile. Il costo per task completato con successo è un utile complemento alle tariffe riportate di seguito.
API Availability and Token Pricing
Questo snapshot del 19 ottobre 2026 confronta le tariffe native dell’API StepFun con le tariffe CometAPI collegate nella sezione di confronto dei modelli. Tutti i prezzi sono in dollari USA per milione di token. I servizi hanno condizioni diverse per fatturazione, cache ed endpoint; “not listed” indica che lo snapshot di origine di questo articolo non fornisce una tariffa per input in cache.
Il tier short-context di GPT-6 Astra si applica fino a 272.000 token; le tariffe long-context indicate sono $16 per l’input e $60 per l’output per milione di token. Le tariffe elencate escludono tool, retry e infrastruttura. La disponibilità di Step 5 Preview tramite CometAPI non è stabilita da questo confronto; l’esempio su Step 5 Preview qui sotto usa l’endpoint nativo di StepFun.
La tariffa per input con cache-hit è inferiore del 90% rispetto a quella per input non in cache. Il prezzo non in cache include la scrittura di nuovo contenuto nella cache, mentre la fatturazione dell’output include sia i token di ragionamento sia quelli della risposta finale. Testo del prompt ripetuto ottiene la tariffa più bassa solo quando il servizio riporta una cache hit qualificata; la sola lunghezza visibile della risposta sottostima l’output fatturabile.
Example Cost Calculations
Cost formula: C = (Tu × Pu + Tc × Pc + To × Po) / 1,000,000, dove Tu/Tc/To rappresentano rispettivamente i token di input non in cache, in cache e di output fatturabili, e Pu/Pc/Po sono i relativi prezzi per milione di token.
Considerate due richieste StepFun con gli stessi 100.000 token di input e 20.000 token di output fatturabili:
- Cache miss: tutti i 100.000 token di input sono non in cache. Cost = (100,000 × $1.00 + 20,000 × $2.70) / 1,000,000 = $0.154.
- Cache hit: 90.000 token di input hanno diritto alla tariffa in cache e 10.000 restano non in cache. Cost = (10,000 × $1.00 + 90,000 × $0.10 + 20,000 × $2.70) / 1,000,000 = $0.073.
L’esempio con cache-hit risparmia $0.081, ovvero circa il 52,6%, con gli stessi volumi di input e output. Il risparmio dipende da una cache hit qualificata riportata dal servizio. Entrambi gli esempi escludono costi di tool esterni, retry e infrastruttura.
I prezzi per token da soli non determinano il modello con il miglior valore. Un agente che richiede diversi retry può risultare più costoso di un modello a prezzo più alto che riesce al primo tentativo. Per un confronto di costo affidabile, usate il costo per task completato con successo insieme alla tariffazione per token.
Is Step 5 Preview Open Source, and Can It Run Locally?
StepFun pubblica pesi scaricabili tramite i repository ufficiali su Hugging Face, con varianti FP8, BF16 e NVFP4 disponibili al 19 ottobre 2026. L’accesso ai pesi abilita il self-deployment, ma non rende il modello equivalente a un piccolo denso in termini di requisiti di memoria.
I file disponibili includono il checkpoint di Step 5 Preview, la versione BF16 e la versione NVFP4.
La terminologia conta: Step 5 Preview fornisce pesi aperti sotto la StepFun Model License 1.0. La licenza include attribuzione specifica del modello e condizioni per la licenza commerciale. Valutate tali termini per l’uso e la distribuzione previsti prima del deployment.
Local Deployment Requirements
La scheda modello ufficiale elenca queste configurazioni di riferimento:
- FP8 con vLLM: 4 × NVIDIA B300 o 8 × NVIDIA H200, servendo un’API compatibile con OpenAI.
- BF16 con vLLM: 8 × NVIDIA B300 o 16 × NVIDIA H200, servendo un’API compatibile con OpenAI.
- FP8 con SGLang: 4 × NVIDIA B300, servendo un’API compatibile con OpenAI; FP8 con Transformers: 8 × NVIDIA H200 per generazione offline.
Si tratta di configurazioni di riferimento, non di garanzie minime per ogni checkpoint, runtime, lunghezza di contesto o impostazione di concorrenza. L’attivazione sparsa riduce il computo, ma l’archiviazione dei pesi degli esperti e la memoria della KV cache restano considerazioni principali.
Un modello da 600B presenta anche sfide oltre la capacità di memoria, tra cui comunicazione multi-GPU, compatibilità dei framework, caricamento del checkpoint e throughput su contesti lunghi. Per i team senza grandi cluster GPU, un’API hosted è di solito il punto di partenza più pratico.
How Can Developers Use the Step 5 Preview API?
StepFun supporta un’interfaccia Chat Completions compatibile con OpenAI. Impostate STEPFUN_API_KEY nell’ambiente prima di eseguire il seguente esempio Python; max_tokens limita l’output generato dalla richiesta. Usate la chiave API e i termini di fatturazione per la piattaforma regionale selezionata: questo esempio mantiene l’endpoint api.stepfun.ai, mentre i prezzi in dollari sopra provengono dalla piattaforma internazionale di StepFun.
Esempio Python: inviare una richiesta di testo con limite all’API StepFun e stampare la risposta restituita.
import os
from openai import OpenAI
client = OpenAI(
    api_key=os.environ["STEPFUN_API_KEY"],
    base_url="https://api.stepfun.ai/v1",
)
response = client.chat.completions.create(
    model="step-5-preview",
    messages=[{
        "role": "user",
        "content": (
            "Analyze the architectural risks of migrating "
            "a monolithic application into microservices."
        ),
    }],
    max_tokens=4000,
)
print(response.choices[0].message.content)
Prima dell’uso in produzione, confermate i parametri accettati e i limiti di generazione dell’endpoint StepFun selezionato. Reasoning effort, prompt caching, schemi dei tool e budget di output possono influenzare affidabilità, latenza e conto finale.
Step 5 Preview in Agent Workflows
- Leggere la documentazione del repository e i file rilevanti.
- Identificare la modifica richiesta e proporre un piano.
- Modificare il codice selezionato ed eseguire i test tramite tool esterni.
- Ispezionare i fallimenti e rivedere l’implementazione.
- Produrre una spiegazione finale delle modifiche validate.
Il modello genera ragionamenti e richieste ai tool; l’applicazione fornisce accesso reale ai file, ambienti di esecuzione, permessi e controlli di sicurezza. La sola capacità del modello non garantisce l’esecuzione autonoma.
Alternative Model APIs in CometAPI
CometAPI fornisce accesso ai modelli alternativi sopra collegati tramite un servizio di integrazione condiviso. Selezionate l’endpoint documentato e il formato di richiesta di ciascun modello, quindi confrontate tassi di successo, uso di token, retry e latenza end-to-end sullo stesso carico.
L’esempio sopra usa l’endpoint nativo di StepFun. Passare a un gateway richiede la conferma della disponibilità di Step 5 Preview e l’identificatore del modello, l’endpoint e i termini di fatturazione documentati dal gateway.
When Should You Choose Step 5 Preview?
- Sceglietelo per coding su repository e ricerca ricca di documenti quando test rappresentativi confermano risultati affidabili. Il suo lungo contesto e i punteggi pubblicati su coding e finanza lo rendono un candidato, mentre i risultati su Terminal-Bench v4 e CorporateValuation mostrano perché i test specifici per carico sono importanti.
- Scegliete l’API hosted quando volete iniziare senza gestire un grande cluster GPU. Confrontate costo per task accettato, tasso di cache-hit, retry e latenza; una finestra di contesto ampia non garantisce risposte rapide o un costo totale inferiore.
- Scegliete il self-hosting quando il controllo del deployment giustifica l’onere hardware e operativo. Mettete a budget l’archiviazione dei pesi di tutti gli esperti, la KV cache, la comunicazione multi-GPU e i requisiti di licenza. Per lavori finanziari o ingegneristici consequenziali, includete verifiche delle fonti, rilevamento degli errori e revisione umana.
FAQ
How should you choose Step 5 Preview’s reasoning effort?
Iniziate con un piccolo set di task rappresentativi e confrontate low, medium e high usando gli stessi criteri di accettazione. Registrate correttezza, output fatturabile, latenza e failure dei tool. Usate l’impostazione più bassa che soddisfa costantemente la soglia di qualità; i punteggi High pubblicati non predicono il comportamento di low o medium. Seguite la guida di configurazione del reasoning e impostate esplicitamente reasoning_effort su Chat Completions quando confrontate le configurazioni.
Why can a Step 5 Preview request stop before 64k output tokens?
Il massimo documentato è un tetto, non una lunghezza target. Una richiesta può fermarsi prima perché ha raggiunto il budget di max_tokens, ha restituito uno stop naturale o ha prodotto una tool call che l’applicazione deve gestire. Ispezionate la finish reason restituita e le eventuali richieste di tool prima di effettuare retry automatici. Una risposta più corta completata non indica un fallimento della finestra di contesto.
How should you test Step 5 Preview video inputs?
Iniziate con una clip breve e rappresentativa e una domanda la cui risposta sia verificabile. La specifica dell’API hosted per input video accetta video via URL, Base64 o un riferimento stepfile; i formati documentati includono MP4, QuickTime e Matroska. Per input via URL, la documentazione specifica singoli file MP4 sotto 128 MB e raccomanda meno di cinque minuti. Confermate limiti di formato e dimensione prima del batching e testate domande temporali oltre al riconoscimento del singolo frame.
Which metrics reveal Step 5 Preview’s real agent cost?
Misurate task accettati, totale dei token di input e output su tutte le turnazioni, cache hit, retry, costi dei tool esterni e tempo trascorso. Dividete il costo totale di esecuzione per i completamenti riusciti, mantenendo fisso il criterio di successo tra i modelli. Questo cattura l’effetto economico di una chiamata più economica che richiede più tentativi o di un run a effort più alto che riduce i fallimenti successivi.
Conclusion
Step 5 Preview vale la pena di essere valutato quando un’applicazione richiede elaborazione a lungo contesto, uso ripetuto di tool o controllo sul deployment del modello. I risultati pubblicati da StepFun lo rendono un candidato per coding su repository e ricerca finanziaria, mentre Terminal-Bench v4 e CorporateValuation evidenziano aree in cui le alternative elencate ottengono punteggi più alti. Confrontate i modelli usando criteri di accettazione fissi, costo totale per task accettato e latenza end-to-end. Per il self-hosting, includete i costi di infrastruttura e i requisiti di licenza nella decisione.