TL;DR
MiMo-V2.6 è la nuova famiglia di modelli di ragionamento a pesi aperti, nativamente multimodale e orientata agli agenti di Xiaomi. MiMo-V2.6-Pro adotta un design MoE sparso con 1,02 trilioni di parametri totali e circa 42 miliardi di parametri attivati per token, mentre MiMo-V2.6-Flash usa 309 miliardi di parametri totali e circa 15 miliardi di parametri attivi. Entrambi supportano una finestra di contesto da 1M token e input multimodali, inclusi testo, immagini, video e audio.
Punti chiave
- MiMo-V2.6-Pro è un modello MoE sparso da 1,02T parametri con circa 42B di parametri attivati per token; Flash usa 309B totali e circa 15B di parametri attivi.
- Entrambi i modelli supportano una finestra di contesto da 1M token, input multimodale e fino a 128K token in output tramite l’API di Xiaomi.
- La famiglia è progettata per ragionamento, uso di strumenti, ricerca sul web, output strutturato e workflow agentici a lungo orizzonte.
- Xiaomi ha addestrato la V2.6 con RL mista su coding, agenti generali, task visivi e ambienti di cybersecurity.
- I risultati ufficiali posizionano Pro come l’opzione con capacità superiori e Flash come opzione a basso costo e alto volume; restano necessari test specifici per workload.
Che cos’è Xiaomi MiMo-V2.6?
MiMo-V2.6 è l’ultima generazione della famiglia di modelli MiMo di Xiaomi. L’enfasi non è solo generare risposte migliori, ma eseguire lunghe sequenze di azioni: ispezionare un ambiente, chiamare strumenti, osservare i risultati, correggere errori e continuare fino al completamento dell’obiettivo. Xiaomi inquadra il rilascio attorno al Recursive Self-Improvement (RSI), cioè un ciclo di addestramento RL in cui il modello esplora ripetutamente ambienti, riceve segnali di ricompensa più ricchi, confronta traiettorie e apprende strategie più efficaci. Questo non va interpretato come il modello che riscrive autonomamente e addestra il proprio successore.
Pro vs Flash vs UltraSpeed: Qual è la differenza
| Caratteristica | MiMo-V2.6-Pro | MiMo-V2.6-Flash | MiMo-V2.6-Pro-UltraSpeed |
|---|---|---|---|
| Posizionamento | Ragionamento di punta | Alti volumi/valore | Top di gamma a bassa latenza |
| Parametri totali | 1.02T | 309B | Stesso modello Pro |
| Parametri attivi | 42B | 15B | Stessa capacità del Pro |
| Architettura | Sparse MoE | Sparse MoE | Modalità di serving del Pro |
| Contesto | 1M | 1M | 1M |
| Output massimo | 128K | 128K | 128K |
| Input testo/immagine/video/audio | Sì | Sì | Sì |
| Ragionamento profondo/chiamata di strumenti | Sì | Sì | Sì |
| Output strutturato/cache del contesto | Sì | Sì | Sì |
| Vantaggio principale | Massima capacità | Efficienza dei costi | Fino a 20 volte più veloce nel serving |
MiMo-V2.6-Pro o Flash: quale dovresti usare?
Scelta pratica: scegli MiMo-V2.6-Pro per ingegneria difficile a lungo orizzonte, ricerca, cybersecurity e lavoro agentico ad alto valore; scegli MiMo-V2.6-Flash per automazione ad alto volume, elaborazione di documenti e multimodale, e chiamate ripetute sensibili ai costi; scegli MiMo-V2.6-Pro-UltraSpeed quando serve ragionamento di livello Pro ma la latenza è dominante. UltraSpeed è un livello di serving piuttosto che un modello con capacità diverse ed è pubblicizzato fino a 20× la velocità di output del Pro standard.
Come funziona Xiaomi MiMo-V2.6?
Architettura Sparse Mixture-of-Experts
MiMo-V2.6 non attiva l’intero set di parametri per ogni token. Il checkpoint di punta Pro contiene 1,02 trilioni di parametri totali, ma solo circa 42 miliardi sono attivi per ciascun token. La model card di Xiaomi descrive 70 strati Transformer, 384 esperti instradati e otto esperti attivati alla volta. Flash è sostanzialmente più piccolo con 309B totali / 15B attivi, 48 strati Transformer e 256 esperti instradati.
| Specifiche dell’architettura | MiMo-V2.6-Pro | MiMo-V2.6-Flash |
|---|---|---|
| Parametri totali | 1.02T | 309B |
| Parametri attivati | 42B | 15B |
| Strati Transformer | 70 | 48 |
| Dimensione nascosta | 6,144 | 4,096 |
| Esperti instradati | 384 | 256 |
| Esperti attivati | 8 | 8 |
| Contesto massimo | 1M | 1M |
| MiMo ViT | 681M parametri | 681M parametri |
| AudioTokenizer | 308M parametri | 308M parametri |
| Encoder di patch audio | 127M parametri | 127M parametri |
| Decoder speculativo | 5 strati | 5 strati |
L’architettura combina attenzione a finestra scorrevole con strati di attenzione globale e include un decoder speculativo a predizione multi-token di cinque strati. L’implicazione pratica è che il conteggio di parametri “di facciata” e il calcolo per token sono quantità molto diverse: l’instradamento sparso consente a Xiaomi di mantenere un ampio pool di esperti senza eseguire inferenza densa su tutti i pesi per ogni token.
Comprensione multimodale nativa
MiMo-V2.6 utilizza il MiMo ViT da 681M parametri di Xiaomi per la codifica visiva insieme a componenti audio dedicati. Questo dà allo stesso agente la capacità di elaborare istruzioni testuali, screenshot, fotografie, video e audio. Per gli agenti di uso del computer, la multimodalità nativa è importante perché percezione e decisione possono avvenire nello stesso ciclo di ragionamento invece di essere separate in modelli disgiunti rivolti all’utente.
Perché l’apprendimento per rinforzo è così importante per MiMo-V2.6?
Xiaomi riporta che sia Flash sia Pro hanno attraversato circa 30 step di RL e circa 750.000 traiettorie in un esperimento pubblico di addestramento durato sei giorni. I costi di addestramento riportati sono stati circa 850.000$ per Flash e 2,62 milioni di $ per Pro. Ogni aggiornamento ha utilizzato 1.568 campioni di addestramento, con singoli step che hanno raggiunto circa 3,5–3,7 miliardi di token. Il mix di task ha coperto codice, agenti generali, task visivi, cybersecurity e molteplici harness per agenti.
Durante questo processo di RL, Xiaomi riporta che il punteggio DeepSWE v1.1 out-of-sample è salito da 48,8 a 65,7 per Flash e da 58,4 a 72,6 per Pro. Questi numeri descrivono l’esperimento RL live e non vanno confusi con ogni punteggio finale di benchmark per i checkpoint rilasciati, perché la configurazione di valutazione può differire.
Valutazione agentica per gruppi
Per l’addestramento di agenti, una ricompensa binaria pass/fail può nascondere differenze significative tra due traiettorie di successo. Una soluzione può finire rapidamente con poche chiamate di strumenti, mentre un’altra può sprecare dozzine di step. Xiaomi descrive quindi Groupwise Reward Synthesis and Groupwise Advantage Redistribution come meccanismi per confrontare le traiettorie all’interno di un gruppo e redistribuire il segnale di apprendimento verso soluzioni più pulite. L’obiettivo è migliorare non solo il completamento del task ma anche l’efficienza del percorso intrapreso.
Quanto è valido Xiaomi MiMo-V2.6 nei benchmark per agenti?
Le evidenze pubbliche più forti per V2.6 si concentrano su benchmark agentici piuttosto che su test convenzionali a scelta multipla. Il grafico ufficiale di Xiaomi confronta Pro e Flash con MiMo-V2.5-Pro, Claude Opus 5, GPT-5.6 Sol e Fable 5 su task di coding, agenti generali, cybersecurity e agenti visivi.
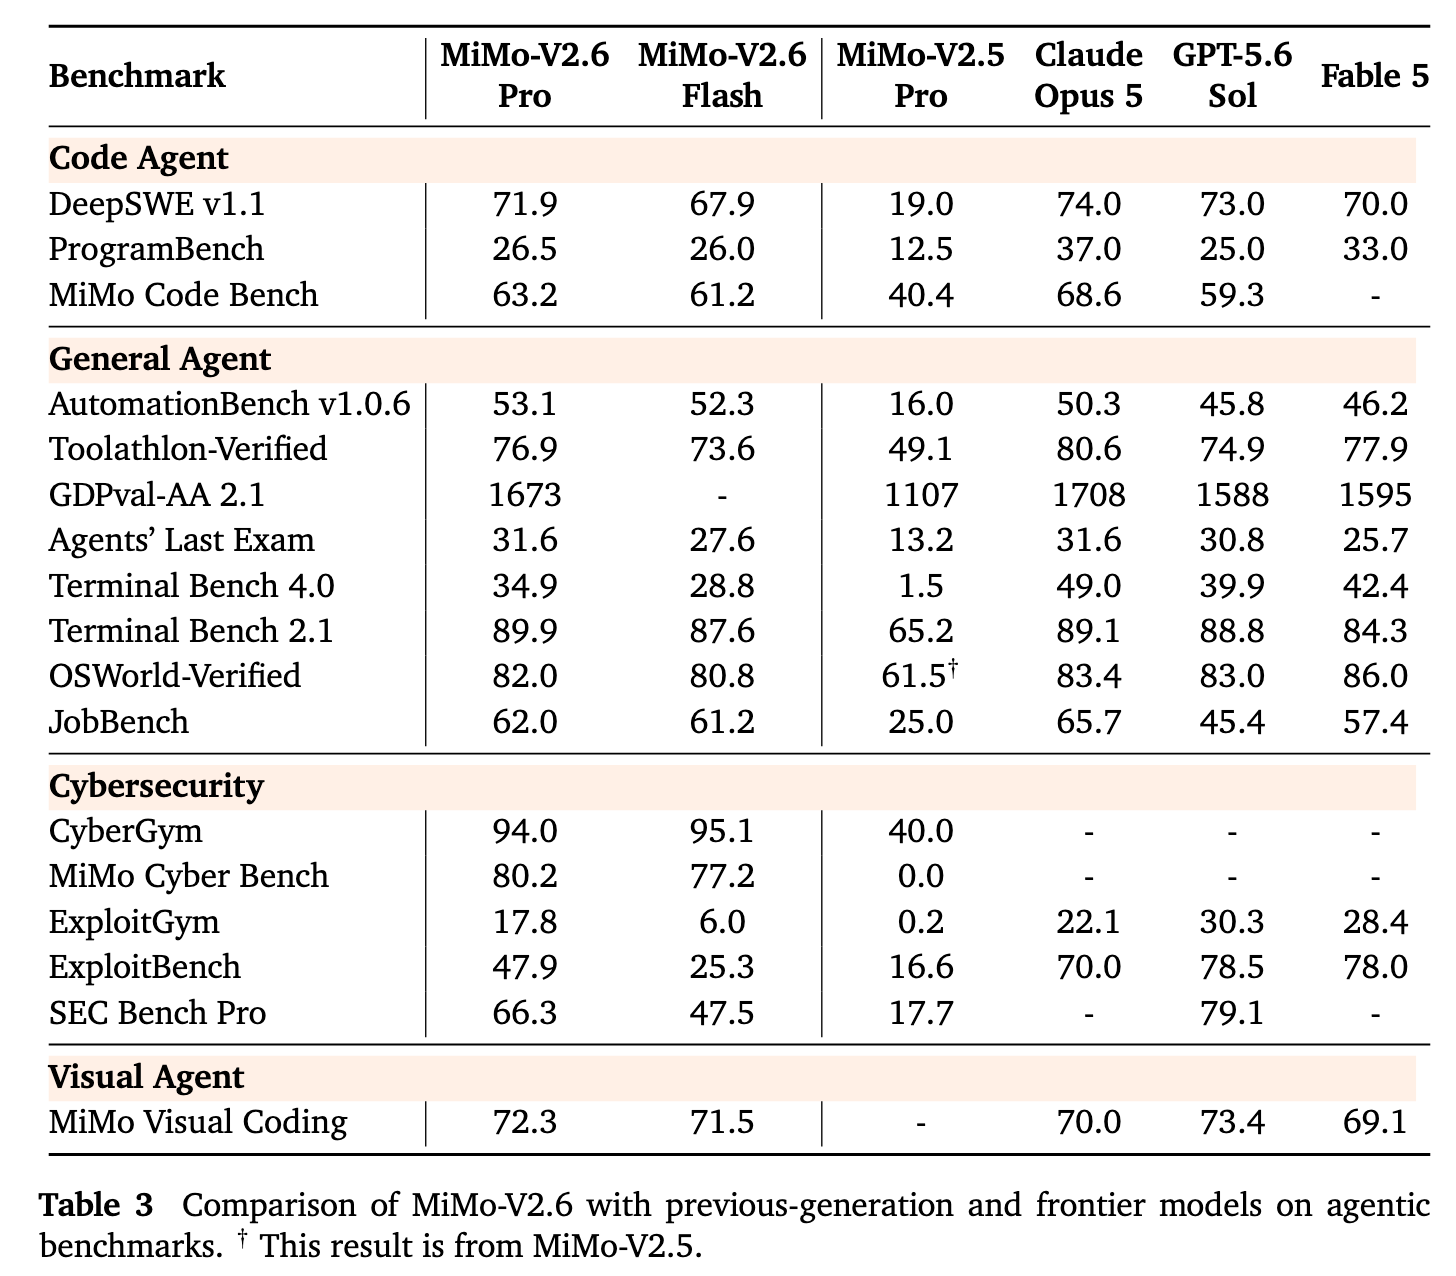
| Benchmark | MiMo-V2.6-Pro | MiMo-V2.6-Flash | Claude Opus 5 | GPT-5.6 Sol |
|---|---|---|---|---|
| DeepSWE v1.1 | 71.9 | 67.9 | 74.0 | 73.0 |
| ProgramBench | 26.5 | 26.0 | 37.0 | 25.0 |
| MiMo Code Bench | 63.2 | 61.2 | 68.6 | 59.3 |
| AutomationBench v1.0.6 | 53.1 | 52.3 | 50.3 | 45.8 |
| Toolathlon-Verified | 76.9 | 73.6 | 80.6 | 74.9 |
| Agents' Last Exam | 31.6 | 27.6 | 31.6 | 30.8 |
| Terminal Bench 2.1 | 89.9 | 87.6 | 89.1 | 88.8 |
| OSWorld-Verified | 82.0 | 80.8 | 83.4 | 83.0 |
| JobBench | 62.0 | 61.2 | 65.7 | 45.4 |
| MiMo Visual Coding | 72.3 | 71.5 | 70.0 | 73.4 |
Progressi nel coding
I guadagni nel coding sono più evidenti nell’esecuzione a lungo orizzonte. Durante il run RL live, Xiaomi riporta che DeepSWE v1.1 out-of-sample è migliorato da 48,8 a 65,7 per Flash e da 58,4 a 72,6 per Pro. Nella tabella cross-modello rilasciata, Pro raggiunge 71,9 su DeepSWE v1.1 e 63,2 su MiMo Code Bench, mentre Flash raggiunge 67,9 e 61,2. Pro non vince ogni test di coding — Claude Opus 5 resta avanti su DeepSWE, ProgramBench e MiMo Code Bench — ma V2.6 combina prestazioni competitive su scala repository con pesi aperti e prezzi API sensibilmente inferiori.
Progressi nel ragionamento e nelle capacità degli agenti
L’avanzamento nel ragionamento è meglio inteso come miglioramento di pianificazione, uso di strumenti e recupero, più che come singolo punteggio astratto di intelligenza. Pro registra 89,9 su Terminal Bench 2.1, 53,1 su AutomationBench e 76,9 su Toolathlon-Verified; Flash registra 87,6, 52,3 e 73,6. Pro supera leggermente i risultati elencati di Claude Opus 5 e GPT-5.6 Sol su Terminal Bench 2.1, mentre entrambi i modelli V2.6 superano quei comparatori su AutomationBench. Xiaomi attribuisce il miglioramento al confronto tra traiettorie per gruppi, valutatori più ricchi, addestramento multi-harness e segnali di ricompensa che favoriscono percorsi di soluzione più brevi e puliti.
Progressi nella conoscenza e nella ricerca
I progressi intensivi sulla conoscenza sono supportati più da valutazioni agentiche e dimostrazioni che da una suite convenzionale di esami di conoscenza. Pro eguaglia Claude Opus 5 a 31,6 su Agents' Last Exam e raggiunge 62,0 su JobBench. Xiaomi riporta anche workflow di ricerca sui materiali che coinvolgono recupero di letteratura e brevetti, generazione di ipotesi e screening computazionale, oltre a un progetto di formalizzazione in Lean 4 che supera le 6.000 righe verificate. Questi esempi suggeriscono capacità più forti di recupero, sintesi, ragionamento formale e lavoro conoscitivo basato su strumenti, ma non vanno trattati come prova indipendente di superiorità universale della conoscenza.
In sintesi: i progressi di V2.6 sono ampi ma non uniformi. Sono più forti come evidenza di miglioramenti nel coding a lungo orizzonte e nell’esecuzione agentica, mentre le affermazioni sul ragionamento generale e sulla conoscenza dovrebbero restare legate a specifici benchmark, harness e dimostrazioni.
Nota sui benchmark: salvo diversa indicazione, i risultati cross-modello riportati di seguito sono forniti da Xiaomi nella model card di MiMo-V2.6. I punteggi possono dipendere da versioni dei benchmark, harness per agenti, configurazioni degli strumenti, budget di inferenza e protocolli di valutazione, quindi non vanno interpretati come una classifica riprodotta in modo indipendente.
MiMo-V2.6 vs MiMo-V2.5: cosa è cambiato?
| Dimensione | Generazione V2.5 | Innovazione V2.6 |
|---|---|---|
| Focus di training | Solidi agenti multimodali, lungo contesto ed efficienza token | Programma RL misto molto più ampio su codice, agenti generali, visione, cybersecurity e molteplici harness |
| Capacità degli agenti | V2.5-Pro mirava a lavoro difficile a lungo orizzonte | Xiaomi riporta che V2.6-Flash supera in modo completo V2.5-Pro sulla sua suite di benchmark per agenti |
| Efficienza di apprendimento | Precedente checkpoint di produzione | Circa 750.000 traiettorie su 30 step di RL; guadagni DeepSWE su hold-out di circa 17 punti per Flash e 14 per Pro durante l’addestramento |
| Apertura | Pesi aperti e supporto dell’ecosistema | Aggiunge codice RL, oltre 7.000 ambienti di task, framework di training, harness leggeri e un checkpoint di distillazione da 9B |
| Economia | Livello di prezzo API di V2.5 | Intelligenza riportata più alta agli stessi prezzi API ufficiali, spostando in avanti la frontiera capacità-costo |
Coding ed esecuzione degli agenti
Rispetto a V2.5, il cambiamento più evidente è una politica di agente più forte piuttosto che una finestra di contesto più lunga. Xiaomi riporta che V2.6-Flash supera V2.5-Pro sulla sua suite di benchmark per agenti. Durante il run di training V2.6, DeepSWE v1.1 su hold-out è migliorato da 48,8 a 65,7 per Flash e da 58,4 a 72,6 per Pro; questi punteggi del run di training non sono direttamente interscambiabili con la tabella di benchmark del modello rilasciato sopra.
Ragionamento, conoscenza e ampiezza dell’addestramento
V2.6 estende l’apprendimento per rinforzo su coding, agenti generali, visione, cybersecurity e molteplici harness. Xiaomi riporta circa 750.000 traiettorie su circa 30 step di RL. Questo supporta una pianificazione più ampia, uso di strumenti e recupero, ma non stabilisce di per sé un guadagno universale su ogni benchmark di conoscenza o ragionamento; confrontare task e impostazioni di valutazione corrispondenti.
Migrazione e apertura
Il rilascio aggiunge anche codice RL, più di 7.000 ambienti di task, infrastruttura di training e un checkpoint di distillazione da 9B. Il contesto da 1M token e gli input multimodali sono continuità dalla V2.5, non novità della V2.6.
Il cambiamento pratico non è quindi un nuovo involucro di contesto — il contesto da 1M e la piena multimodalità esistevano già in V2.5 — ma una politica di agente più forte addestrata con un quantitativo di compute per RL sostanzialmente maggiore e ambienti verificabili più ampi. Xiaomi ha annunciato che i nomi dei modelli V2.5 e V2.5-Pro smetteranno di funzionare il 21 ottobre 2026, quindi i nuovi deployment dovrebbero puntare a V2.6 e quelli esistenti dovrebbero pianificare test di migrazione.
Come V2.6 si confronta con altri modelli di frontiera
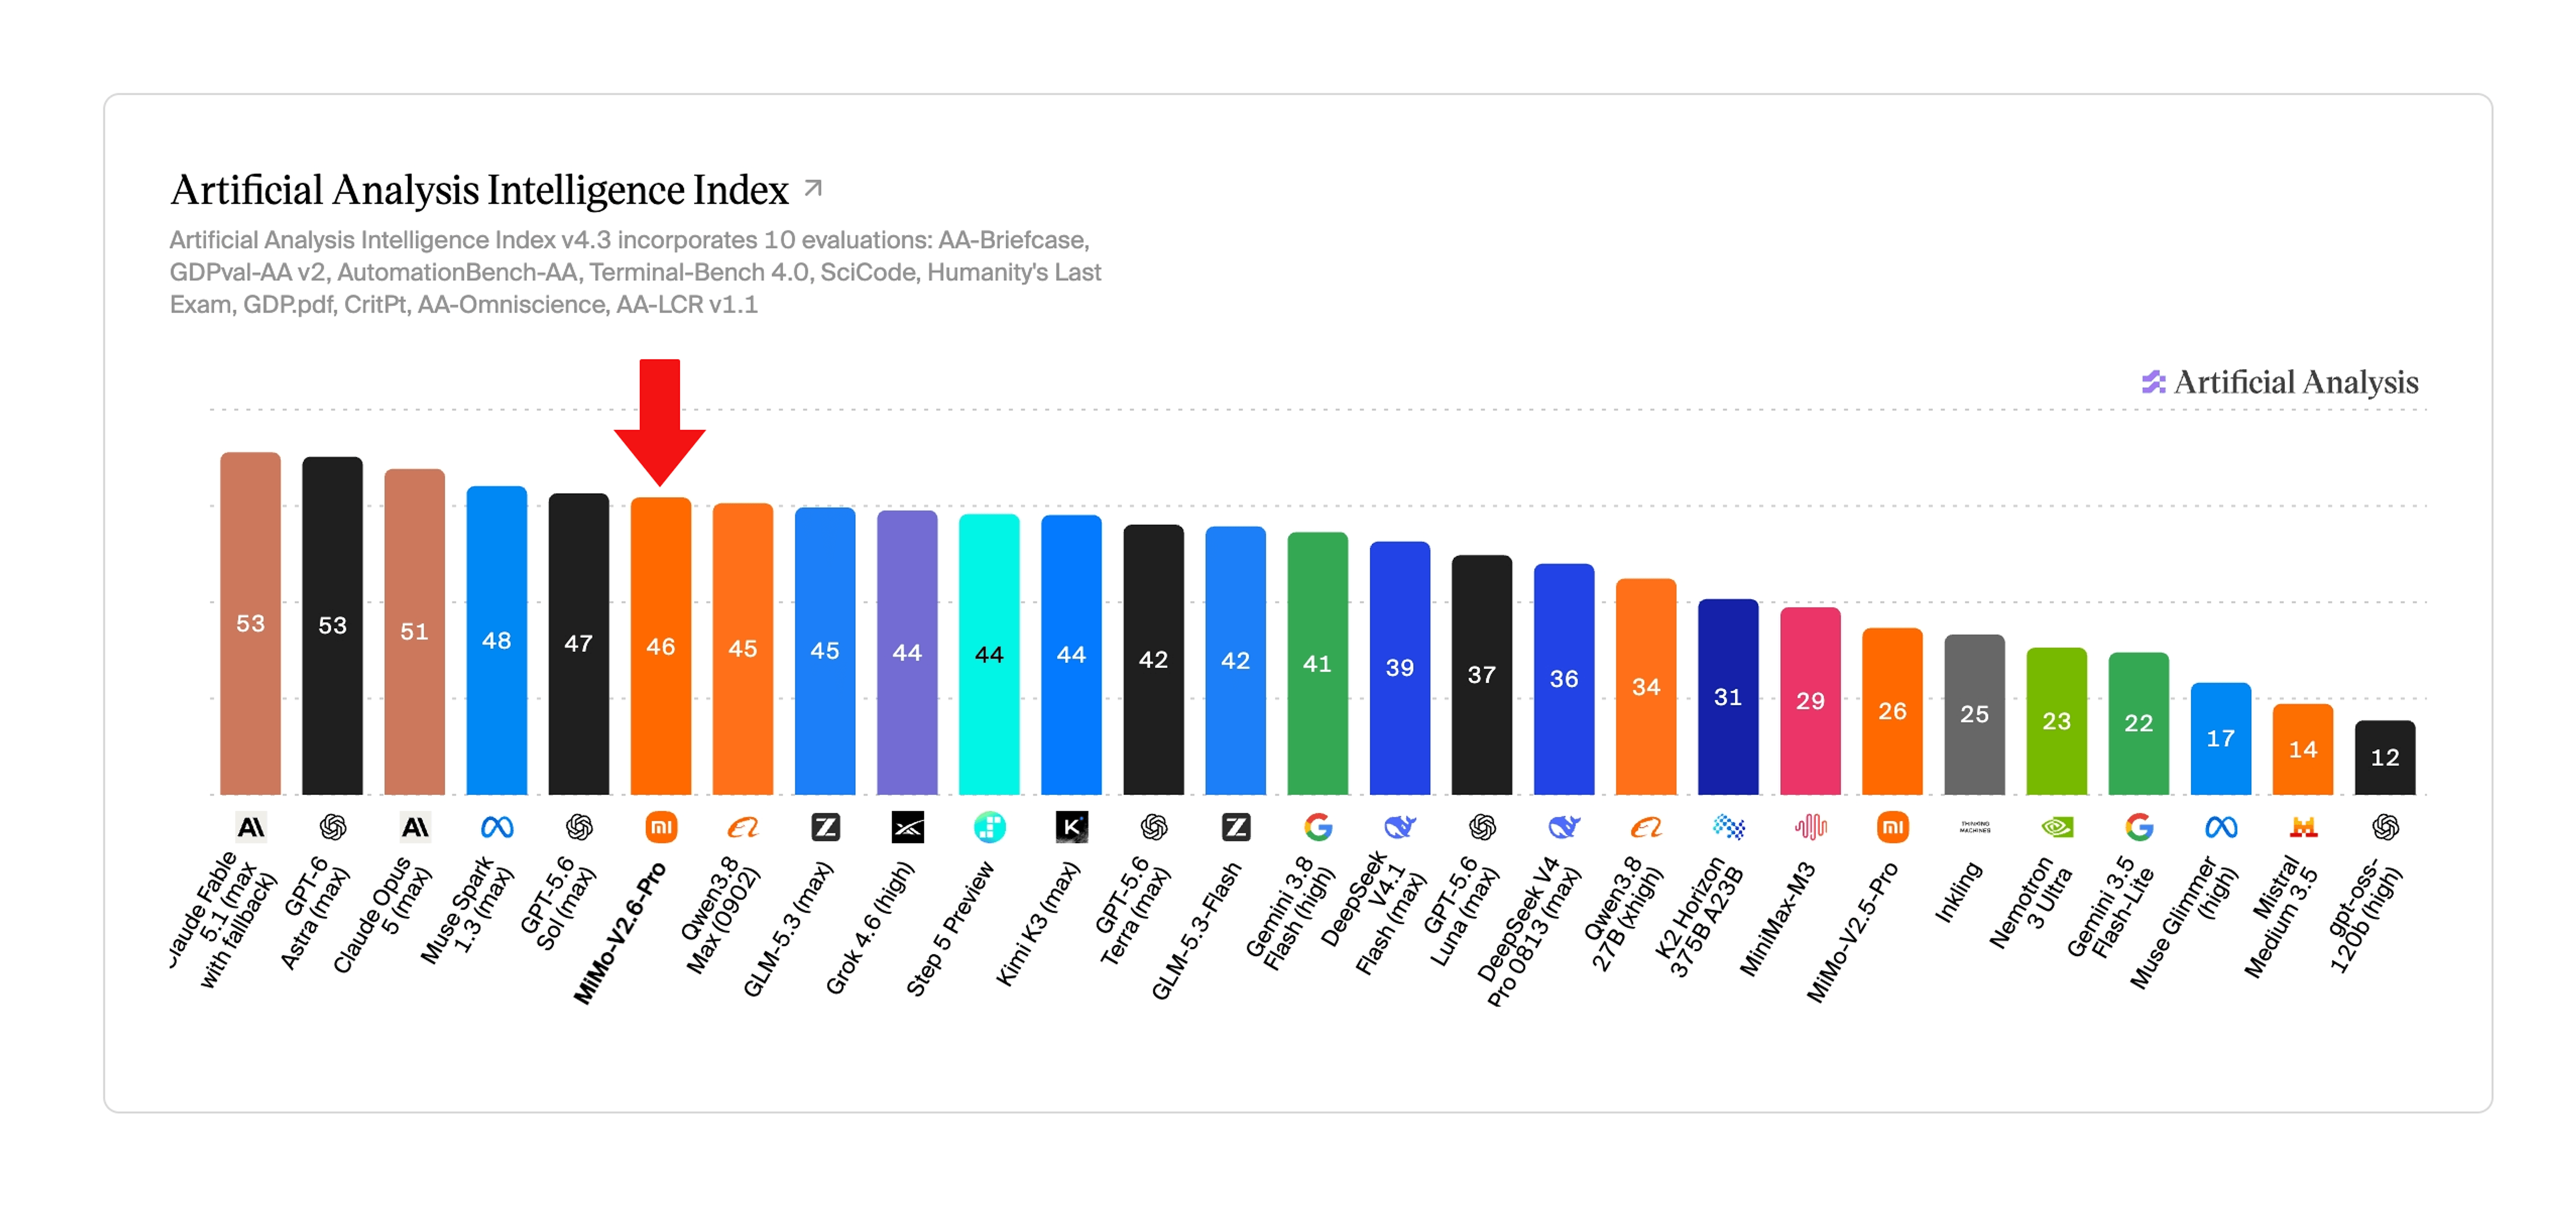
| Dimensione | MiMo-V2.6-Pro | Modelli di frontiera chiusi | Altri modelli a pesi aperti |
|---|---|---|---|
| Pesi | Pesi aperti | Tipicamente chiusi | Dipende dal modello |
| Contesto MiMo verificato | 1M token | Verificare ogni pagina ufficiale | Verificare ogni model card |
| Modalità MiMo verificate | Testo, immagine, video, audio | Dipende dal provider | Dipende dal modello |
| RL focalizzata sugli agenti | Forte enfasi nel rilascio | Dipende da modello e sistema | Dipende da modello e checkpoint |
| Self-hosting | Sì, con infrastruttura sostanziale | Generalmente no | Spesso possibile per i checkpoint aperti |
| Vantaggio principale di MiMo | Pesi aperti, multimodalità nativa, basso costo API | Ecosistema del provider e tooling gestito | Varia per licenza, dimensione e stack di deployment |
Per un set di confronto aggiornato, valuta MiMo-V2.6 rispetto a Claude Opus 5.5 per coding agentico a lunga esecuzione, Claude Fable 5.1 per il lavoro autonomo più difficile, GPT-6 Sol e Gemini 4 Pro. La disponibilità dei modelli e i prezzi sono dinamici, quindi i confronti in produzione dovrebbero usare il catalogo live e prompt, strumenti, budget di sforzo e criteri di accettazione allineati.
Cosa può fare concretamente Xiaomi MiMo-V2.6?
Agenti per coding e ingegneria del software
MiMo-V2.6 è progettato per traiettorie lunghe di ingegneria del software: ispezione di repository, modifica del codice, uso di strumenti da terminale, esecuzione di test, diagnosi dei fallimenti e prosecuzione fino al soddisfacimento di un obiettivo. I risultati su DeepSWE, Terminal Bench, AutomationBench e Toolathlon indicano che Xiaomi sta ottimizzando per l’esecuzione, non solo per il completamento del codice. I workload pratici includono agenti di coding, debug automatizzato, refactoring di repository, risoluzione di problemi CI e workflow ingegneristici multi-strumento.
Uso del computer
Xiaomi dimostra esplicitamente un Computer Use Agent (CUA). Il modello può interpretare interfacce grafiche, recuperare informazioni, modificare contenuti, elaborare dati, ispezionare risultati, diagnosticare problemi e cambiare le azioni successive in base al feedback visivo. In questo workflow, l’output del modello spesso non è il prodotto finale; può invece determinare la prossima azione software o browser.
Mondi 3D e workflow in Blender
Sotto il concetto di "Vibe World", MiMo-V2.6 può prendere riferimenti testuali, di immagini o video e scomporre una richiesta 3D in costruzione della scena, programmazione dell’interazione e task di verifica visiva. Xiaomi dimostra anche il modello che controlla Blender per creare oggetti e scene 3D da descrizioni o immagini di riferimento. Questo estende il vibe coding oltre il codice applicativo verso ambienti interattivi.
Robotica e agenti incarnati
Xiaomi dimostra MiMo-V2.6 in un ambiente di simulazione incarnata usando immagini da camere multi-vista e un braccio robotico Franka Panda. Esempi di task includono afferrare oggetti, abbinamento dei colori e posizionamento preciso. Questo non stabilisce V2.6 come modello di fondazione universale per la robotica, ma mostra come visione nativa e decisioni a lungo orizzonte possano essere collegate a loop di controllo incarnati.
Ricerca scientifica e ragionamento formale
Xiaomi riporta un caso di scienza dei materiali in cui MiMo-V2.6-Pro ha assistito i ricercatori con strutture metallo-organiche per l’adsorbimento di PFAS, includendo ricerca su letteratura e brevetti, formulazione di candidati e chiamate a strumenti computazionali. In un altro esperimento, il modello ha aiutato a formalizzare il teorema principale da "Period Three Implies Chaos" in Lean 4. Xiaomi riporta un progetto completato che supera le 6.000 righe di codice Lean, verificate dal kernel di Lean senza placeholder non provati. Questi esempi sono meglio interpretati come dimostrazioni di workflow di ricerca agentici, non come prova di scoperta scientifica autonoma.
Siti web, presentazioni, video e musica
MiMo-V2.6 può coordinare coding front-end, workflow di design, slide, asset SVG, pipeline video e strumenti di produzione musicale. Xiaomi dimostra l’orchestrazione con sistemi multimediali specializzati, inclusa la narrazione tramite MiMo-V2.5-TTS, senza affermare che la V2.6 sostituisca da sola ogni generatore di immagini, video o audio. Il modello si adatta quindi naturalmente come orchestratore della produzione creativa.
I casi d’uso in questa sezione sono dimostrazioni di Xiaomi, non evidenza indipendente che ogni deployment riprodurrà gli stessi risultati. I team di produzione dovrebbero testare il modello con i propri strumenti, permessi, recupero da errori e criteri di valutazione.
Quanto costa Xiaomi MiMo-V2.6?
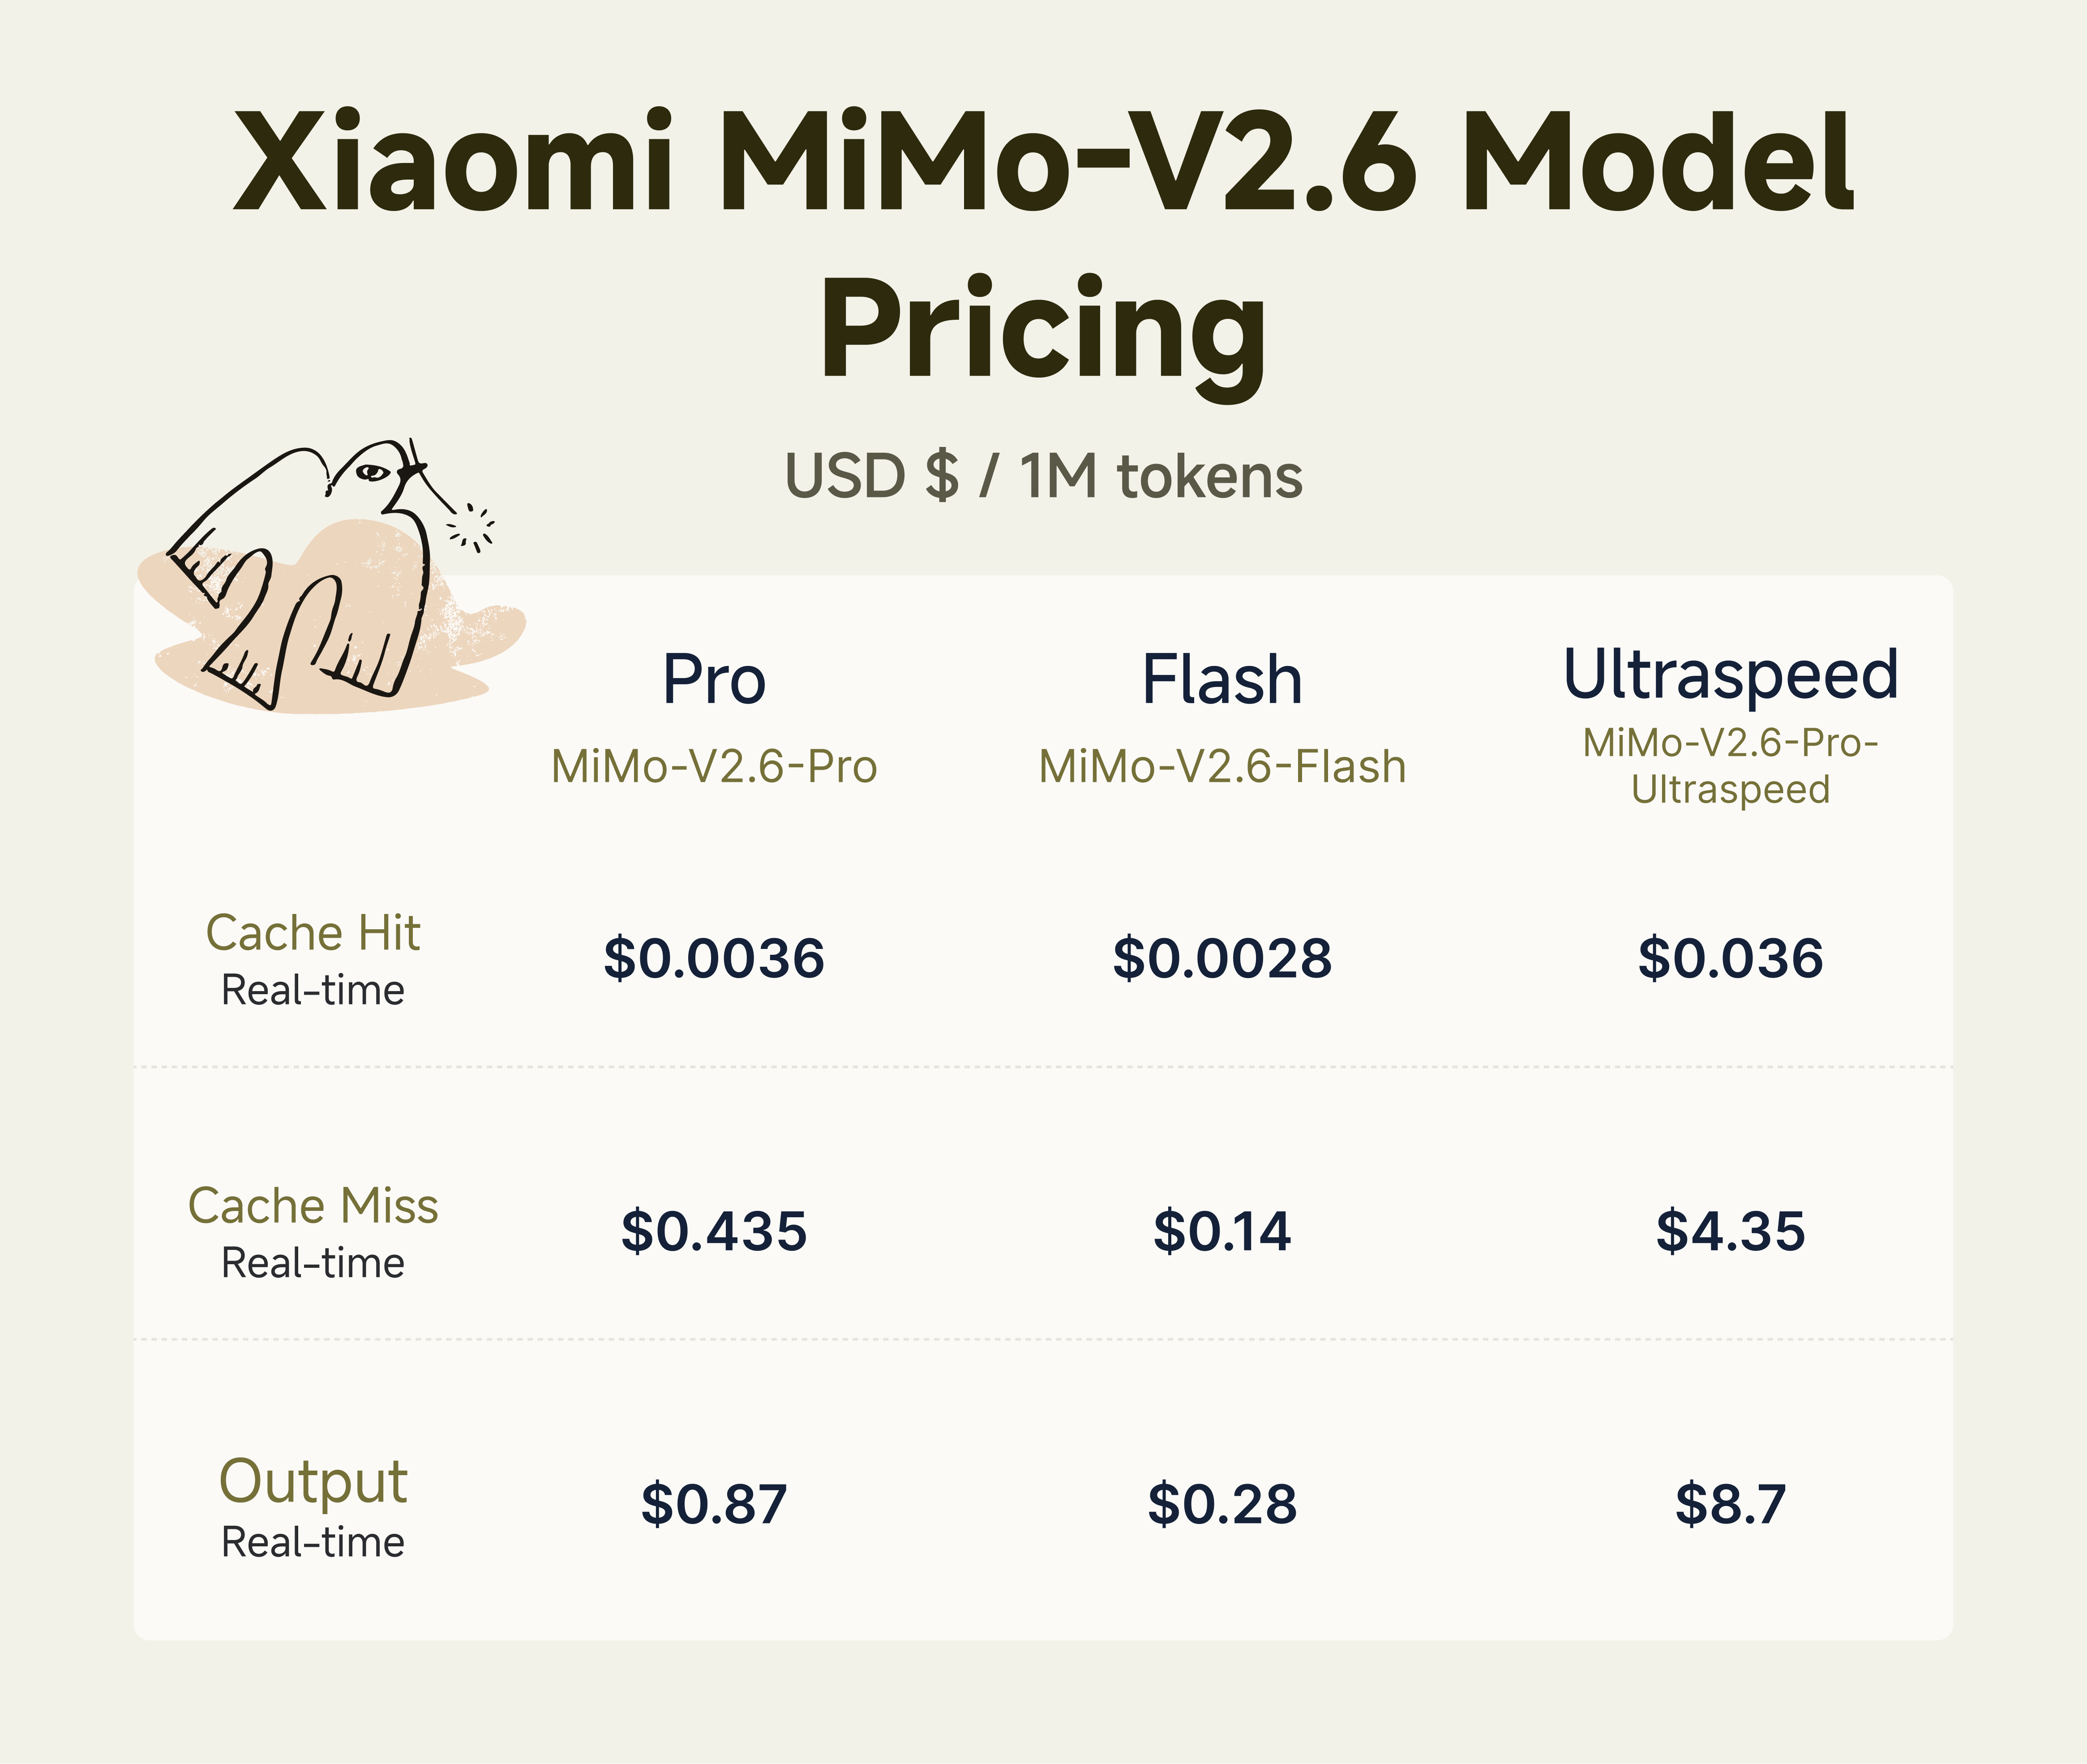
| Prezzi | MiMo-V2.6-Pro | MiMo-V2.6-Flash | Pro UltraSpeed |
|---|---|---|---|
| Input in cache / 1M token | $0.0036 | $0.0028 | $0.036 |
| Input non in cache / 1M token | $0.435 | $0.14 | $4.35 |
| Output / 1M token | $0.87 | $0.28 | $8.70 |
Xiaomi mantiene i prezzi API di V2.6 allo stesso livello generale della generazione V2.5. Flash è particolarmente notevole per workload ad alto volume: il prezzo ufficiale Xiaomi mostra $0,14 per milione di token di input non in cache e $0,28 per milione di token in output.
Prezzi e disponibilità su CometAPI
| Route CometAPI | Input / 1M | Output / 1M | Stato nel catalogo |
|---|---|---|---|
| mimo-v2.6-pro-ultraspeed | $3.48 | $6.96 | Disponibile; 20% al di sotto delle tariffe ufficiali non in cache elencate |
| mimo-v2.6-pro | $0.348 | $0.6960 | Disponibile; 20% al di sotto delle tariffe ufficiali non in cache elencate |
| mimo-v2.6-flash | $0.112 | $0.2240 | Disponibile; 20% al di sotto delle tariffe ufficiali non in cache elencate |
Come possono gli sviluppatori accedere a Xiaomi MiMo-V2.6?
Xiaomi espone i modelli tramite un’API compatibile con OpenAI e documenta la compatibilità con il protocollo Anthropic sulle pagine ufficiali dei modelli. Gli identificatori ufficiali sono mimo-v2.6-pro, mimo-v2.6-flash e mimo-v2.6-pro-ultraspeed. Xiaomi documenta chiamata di strumenti, output strutturato, streaming, controlli di ragionamento, cache del contesto e ricerca sul web. L’interfaccia compatibile con OpenAI usa valori thinking.type come enabled o disabled, con il deep thinking abilitato per impostazione predefinita per i modelli V2.6.
Gli sviluppatori hanno tre percorsi pratici di accesso. Primo, scaricare i checkpoint a pesi aperti Pro o Flash per un’integrazione self-hosted, soggetta a requisiti di serving sostanziali. Secondo, usare l’API gestita di Xiaomi con una chiave Xiaomi e il relativo endpoint documentato. Terzo, usare una route CometAPI supportata con una chiave CometAPI e base URL; questo può semplificare la valutazione multi-modello e la fatturazione. Gli assistenti di coding come Claude Code possono usare una route compatibile con Anthropic quando quella route e quel modello sono supportati, ma la compatibilità deve essere testata e non data per scontata.
Accesso a MiMo-V2.6 tramite CometAPI
CometAPI fornisce un endpoint unificato e un livello di fatturazione per i modelli supportati. Il principale vantaggio operativo è la semplicità di migrazione: i team possono mantenere un SDK familiare, cambiare la base URL e l’ID modello, confrontare MiMo con altri modelli di frontiera nello stesso account e centralizzare controlli di utilizzo, prezzi e disponibilità. Questo è utile per routing multi-modello, strategie di fallback, fatture consolidate e valutazioni che richiedono prompt identici tra provider.
CometAPI documenta tre formati di richiesta testuale a livello di piattaforma: OpenAI Chat Completions, Anthropic Messages e OpenAI Responses. Per un SDK compatibile, la migrazione in genere significa cambiare base URL, chiave API e ID modello invece di riscrivere tutta l’applicazione. Il supporto per endpoint e parametri può variare per modello, quindi testa l’esatto variante MiMo-V2.6 e il formato di richiesta prima di affermare che tutte e tre le route funzionano per esso.
Verificato il 23 settembre 2026, MiMo-V2.6-Pro-UltraSpeed ha una route di catalogo disponibile con prezzi di input e output elencati. Le pagine dedicate Pro e Flash mostrano Coming soon negli snapshot di catalogo nonostante i pannelli di stato API indichino Available. Tratta questo come un segnale incoerente della pagina, non come disponibilità o prezzi di produzione confermati. Controlla il catalogo live, la dashboard e una richiesta di test prima del deployment.
Il seguente esempio segue il pattern Anthropic-SDK pubblicato da CometAPI e chiama la route UltraSpeed attualmente elencata. Archivia la chiave API in una variabile d’ambiente.
import Anthropic from '@anthropic-ai/sdk';

const client = new Anthropic({
  apiKey: process.env.COMETAPI_KEY,
  baseURL: 'https://api.cometapi.com',
});

const message = await client.messages.create({
  model: 'mimo-v2.6-pro-ultraspeed',
  max_tokens: 4096,
  messages: [{ role: 'user', content: 'Analyze this project and propose the next implementation steps.' }],
});
Xiaomi MiMo-V2.6 è open source?
Xiaomi ha rilasciato pesi del modello, materiale tecnico, risorse RL, ambienti di training e infrastrutture correlate. Il rilascio include oltre 7.000 ambienti di task RL che spaziano da ingegneria del software a riproduzione di vulnerabilità, lavoro intensivo di conoscenza e web design/sviluppo. Xiaomi ha rilasciato anche MiMo-V2.6-Distill-Qwen-9B per consentire ai ricercatori di studiare la pipeline RL su scala molto più piccola.
Schede modello ufficiali: MiMo-V2.6-Pro-RL | MiMo-V2.6-Flash-RL
Quali sono i limiti di Xiaomi MiMo-V2.6?
Il dato di un trilione di parametri non va trattato come prova che V2.6 sia universalmente più forte dei sistemi di frontiera chiusi. La stessa tabella di benchmark di Xiaomi mostra un quadro misto: Claude Opus 5 resta avanti su alcuni test di coding, uso di strumenti e OS, mentre GPT-5.6 Sol guida anche su test selezionati. Una valutazione specifica per workload è quindi più significativa di un’etichetta di vincitore generica.
L’hosting autonomo del checkpoint Pro completo è anche un compito pesante a livello di infrastruttura. Pesi aperti non significano deployment facile su workstation. Inoltre, diverse dimostrazioni di punta — ricerca, controllo incarnato, mondi 3D e produzione video — dipendono da strumenti esterni e harness per agenti. MiMo-V2.6 va valutato come un modello dentro un sistema, non solo come un semplice modello di chat standalone.
Perché Xiaomi MiMo-V2.6 è importante?
MiMo-V2.6 combina tre direzioni importanti: modelli MoE sparsi molto grandi, multimodalità nativa e apprendimento per rinforzo su ambienti agentici reali. La cifra di 1,02T parametri attira l’attenzione, ma la scelta progettuale più conseguente è l’investimento di Xiaomi in interazione ripetuta con l’ambiente, valutazione delle traiettorie, uso di strumenti e auto-correzione.
Se questo approccio continuerà a scalare, i modelli aperti potrebbero differenziarsi sempre più non solo per la quantità di conoscenza statica che contengono, ma per l’efficacia con cui agiscono, valutano, recuperano e completano compiti lunghi. MiMo-V2.6 va quindi inteso come un modello di fondazione orientato agli agenti e aperto, più che come un altro chatbot da un trilione di parametri.
Conclusione
MiMo-V2.6 è un rilascio a pesi aperti sostanziale perché combina input nativi di testo, immagine, video e audio con contesto lungo, inferenza MoE sparsa e apprendimento per rinforzo su ambienti agentici reali. Pro è più adatto per compiti difficili a lungo orizzonte, Flash punta a workload ad alto volume e sensibili ai costi, e UltraSpeed scambia un prezzo API significativamente più alto per una latenza inferiore.
La famiglia di modelli è competitiva su diversi benchmark agentici riportati dal vendor, ma non guida ogni valutazione e non va trattata come sostituta universale dei modelli di frontiera chiusi. Il percorso di adozione più affidabile è testare MiMo-V2.6 rispetto agli strumenti, obiettivi di latenza, modalità di failure e profilo di costo esatti del workflow di produzione previsto.
FAQ
Cosa dovrebbero testare i team prima di portare MiMo-V2.6 in produzione?
Testare il sistema completo, non solo il modello. Misurare completamento del task, accuratezza delle chiamate di strumenti, recupero da azioni fallite, latenza, consumo di token, gestione del contesto e confini dei permessi. I benchmark per agenti offrono orientamento, ma le valutazioni interne dovrebbero rispecchiare il repository, il browser, il documento o il workflow di ricerca effettivo.
Perché il self-hosting di MiMo-V2.6-Pro può essere difficile nonostante l’architettura sparsa?
L’attivazione sparsa riduce il calcolo per token rispetto a un modello denso da un trilione di parametri, ma il checkpoint completo ha comunque un ingente footprint di memoria e di serving distribuito. Il deployment in produzione può richiedere inferenza multi-nodo, parallelismo degli esperti, kernel specializzati e un’attenta pianificazione della capacità.
Come dovrebbero interpretare gli sviluppatori la tabella di benchmark inter-modello di Xiaomi?
Trattarla come evidenza riportata dal vendor, non come classifica universale riprodotta in modo indipendente. I risultati possono cambiare con l’harness per agenti, il budget di inferenza, gli strumenti, l’immagine dell’ambiente, il metodo di campionamento e la versione del benchmark. Confrontare le tendenze su più task e riprodurre internamente i workload più rilevanti.
Quando MiMo-V2.6-Flash è una scelta migliore rispetto a Pro?
Flash è la scelta più forte quando dominano volume di chiamate e costo, specialmente per elaborazione di documenti, analisi multimodale e step agentici ripetuti. Pro è più appropriato quando il ragionamento difficile o l’esecuzione a lungo orizzonte forniscono valore di business sufficiente a giustificare il prezzo più alto.
Una finestra di contesto da 1M token elimina la necessità di retrieval o gestione dei prompt?
No. Una finestra più grande aumenta la capacità, ma inviare cronologia non necessaria può aumentare latenza e costo e diluire le evidenze rilevanti. Retrieval, sintesi, memoria strutturata e potatura del contesto restano importanti per agenti affidabili in produzione.