Solutions Choose your path
For individuals Build, learn, and create with simple usage-based access. For business Scale teams, billing, governance, and model workflows. More English 繁體中文 日本語 한국어 Français Deutsch Español Italiano Português Русский العربية ไทย Tiếng Việt Bahasa Indonesia Bahasa Melayu Türkçe Polski Nederlands Danish Norsk Қазақ اردو
無料で始める 無料で始める
500+ AI Model API, All In One API.
Just In CometAPI © 2026 CometAPI · All rights reserved
Home Blog GLM-6.0:Z.AIの完全自己訓練ロードマップは実際に何を示しているのか ai-model / CometAPIリサーチ
GLM-6.0:Z.AIの完全自己訓練ロードマップは実際に何を示しているのか Z.AI が GLM 6.0、「Full Self-Training」、再帰的トレーニングループ、現行の GLM ベンチマークについて開示した内容と、リリース前にまだ明らかになっていない事実
Z.AI が GLM 6.0、「Full Self-Training」、再帰的トレーニングループ、現行の GLM ベンチマークについて開示した内容と、リリース前にまだ明らかになっていない事実
この要約で素早く答えを把握し、ガイドで背景、例、実装詳細を確認してください。
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_COMETAPI_KEY",
    base_url="https://api.cometapi.com/v1",
)

response = client.chat.completions.create(
    model="gpt-5-mini",
    messages=[{"role": "user", "content": "Build this workflow."}],
)

print(response.choices[0].message.content)要約
Z.AI は GLM-6.0 を公に名指しし、次世代ロードマップの中心に Full Self-Training を据えた。開示された方向性は、事前学習・中間学習・事後学習にわたる自己生成の経験を自己評価と修正と結び付け、学習を単発のデータ生成ではなく統制されたフィードバックループへと転換するものである。
難しいのは制御である。GLM-6.0 には合成データの浄化、誤りの検出と修復、不生産な反復の停止、評価器が近道を報酬してしまうことの防止が必要となる。これらのメカニズムは、独立検証、安全性、コスト、ガバナンスに関する実務的な問いを提起する。完全なモデルカード、ベンチマークスイート、API 仕様、価格、リリース日は公表されていないため、本稿は推測的な仕様ではなく、学習アーキテクチャとその証拠を評価する。
GLM 6.0 の要点は?
公開情報で最も強い裏付けは、リークされたパラメータ数やベンチマーク結果ではなく Full Self-Training システムに関するもの。
開示された方向性は、自己生成データ、自己構築された学習環境、モデル支援のインフラ最適化を含む。
意図されたフィードバックループは、自己訓練を事後学習のみの技法として扱うのではなく、事前学習・中間学習・事後学習にまたがる。
ネイティブなマルチモーダルモデリング、より長期の強化学習、プランニング、ツール使用、リカバリー、検証は関連する研究方向だが、GLM 6.0 の公開仕様ではない。
Ox Alpha は GLM 6.0 の性能がリークした証拠ではない。Z.AI はそれを GLM-5.3-Flash のプレリリース識別子と位置付けた。
明確性、出典の帰属、最新のAPI用語について確認済みです。
Z.AI が GLM 6.0 について実際に確認したことは何か? Z.AI の公開資料は、GLM-6.0 という名称、中心的な学習方向としての Full Self-Training、事前・中間・事後学習にわたる意図されたループ、そして自己評価と修正メカニズムという四つの具体的なシグナルを示している。同社はまた、純収益の約 60% を次世代モデル、Full Self-Training、大規模な学習・推論・計算および関連インフラに充てる意向だと述べている。
Z.AI の Full Self-Training フレームワーク Full Self-Training は GLM-6.0 のための統辞的なアイデアとして提示されており、小さな事後学習機能ではない。想定されるシステムは学習のための経験を生成し、結果から学習し、弱いサンプルをフィルタし、明示的な品質管理のもとでサイクルを繰り返す。
GLM-6.0 の事前・中間・事後学習にまたがる自己訓練 開示されたシーケンス(事前学習・中間学習・事後学習)は、自己生成の経験が最終調整の段階だけでなく、基盤知識、能力形成、タスク整合に影響しうることを示唆する。Z.AI はデータセット、段階の境界、混合比を開示していないため、これは完全なレシピではなく、確認された方向性として扱うべきである。
GLM-6.0 の自己評価と修正メカニズム ロードマップは Full Self-Training を自己評価、誤り検出、修正、データの自己浄化と結び付けている。実務的には、モデルは軌跡を評価し、失敗したステップを修正し、信頼性の低いデータを破棄し、独立した測定による性能が改善しなくなった時点でさらなる反復を停止する必要がある。評価器の設計と停止規則は未開示である。
わかっていることと、わかっていないこと 公開記録はロードマップを支持するが、完成した仕様ではない。下表は、開示された意図を根拠のない製品主張に変えないよう、確認された方向性と未解明の点を分けて示す。
GLM-6.0 名称 公開で特定 Z.AI は次世代モデルを GLM-6.0 と命名した。 リリース日と最終的なポジショニング。 Full Self-Training ロードマップで確認 戦略的な最優先事項として明言されている。 実装の詳細とスケーリング挙動。 事前学習 → 中間学習 → 事後学習 方向性として確認 自己訓練は学習ライフサイクル全体にまたがる意図である。 データセット、バリデータ、段階境界、データ比率。 自己評価と修正 目標として確認 ロードマップには自己浄化、誤り検出、修正が含まれる。 信頼性、独立検証、停止基準。 仕様 未開示 完全な公開仕様はない。 パラメータ、コンテキスト長、モダリティ、価格、API 識別子。 ベンチマーク 未開示 GLM-6.0 の公式結果はない。 スコア、手法論、独立再現可能な結果。
Full Self-Training とは何で、どのように機能するのか Full Self-Training は、モデルがタスクや環境を作成し、それに挑戦し、得られた軌跡を評価し、弱点を修正し、受理された経験を再学習に供するという閉ループ学習である。重要な転換は、一度限りの合成データパイプラインから、継続的に統治されたプロセスへの移行である。
生成: 課題、ツール環境、候補となる解法経路を構築する。行動: タスクを完了し、行動・観測・中間的な推論を軌跡として保存する。評価と修正: 検証器で結果をスコアリングし、誤りを検出し、失敗したステップを改訂し、低信頼サンプルを棄却する。学習と停止: 受理された経験から学習し、独立評価が有用な改善を示す間のみ継続する。 このループを事前学習・中間学習・事後学習に拡張することで、GLM-6.0 は各段階においてデータ品質、能力形成、タスク整合を高めうる。ただしアーキテクチャは信頼できる評価器に依存する。独立した検査がなければ、自己訓練はモデル自身の盲点を報酬してしまい得るからである。
Full Self-Training は GLM 6.0 をどのように変えうるか? 開示された設計は、単一の新しい Transformer ブロックというよりシステムアーキテクチャとして理解するのが適切である。モデルの周囲にループを閉じ、次の学習サイクルに必要な資源の生成にモデル自身がますます寄与するようにする試みである。
GLM 6.0 はどのように学習データを生成しうるか? 最初のループはデータの自己生成である。人手や外部収集データのみに依存する代わりに、自己対戦、ルールベース検査、実行結果、モデル判定、人手によるスポットチェックを用いて新しい例を生成・フィルタできる。受理された例はその後、事前学習・中間学習・事後学習に還流する。
重要な制約は検証である。安価な合成生成は、システムが正確で多様かつ非退化な例を識別できるときにのみ有用である。実用的なループは、モデル生成 → タスク実行 → ルールやツールによる検証 → フィルタリング → 再学習、である。
GLM 6.0 はどのように学習環境を構築しうるか? 第二のループは環境の自己構築である。エージェントは実世界のタスクを収集・変換し、それに挑戦し、バリデータを作成し、学習素材になる前にタスクが実際に解けるかを検査できる。これは特にコーディングやエージェント業務で重要であり、終端状態、ツール出力、ブラウザ状態、テスト結果、失敗からの復旧が、テキストのみの回答より強い教師信号を提供する。
評価の焦点は、回答が尤もらしいかどうかから、行為が成功するか、結果が独立に検証可能か、失敗後に回復できるかへと移る。
GLM 6.0 はどのように学習インフラを最適化しうるか? 第三のループはインフラの自己最適化である。実務的には、これは AI 支援のシステムズエンジニアリングとして解釈するのが最適だ。強力なコーディングモデルがオペレータ、カーネル、スケジューリング、キャッシュ、サービングコードへの変更案を提案し、自動ベンチマークと人間の管理下の検証が受理する変更を決める。
その結果として、よりよいモデル → よりよいシステム提案 → 検証された効率改善 → より多くの学習実験 → よりよいモデル、というサイクルが回る。人によるレビューと再現可能なベンチマークは、任意ではなく統制点として残る。
現行の GLM 5.3 Flash ベースラインは GLM 6.0 に何を示唆するか? リリース状況 利用可能 開発中。引用した提出書類により最終製品名は独立に確立されていない パラメータ 総計 320B / アクティブ 18B 未開示 中核アーキテクチャ MoE、ハイブリッドなスパース+線形注意、mHC ブロックレベルでは未開示 学習データ 30T トークンのマルチモーダルコーパス 自己生成データが再帰ループに入る意図 マルチモーダル性 ネイティブなマルチモーダル入力 統合マルチモーダルモデリングは研究方向であり、公表仕様ではない 学習ステージ 公開済みの段階的学習レシピ 事前・中間・事後学習にまたがる自己訓練 学習環境 研究者設計・ベンチマーク済み環境 エージェントが環境構築と検証に関与 検証 既存の評価・学習パイプライン より強力な自己判断、実行フィードバック、自己検証 インフラ 最適化された推論スタック モデルがインフラ最適化を支援 API 詳細 公開済みモデル ID と稼働中 API 未開示
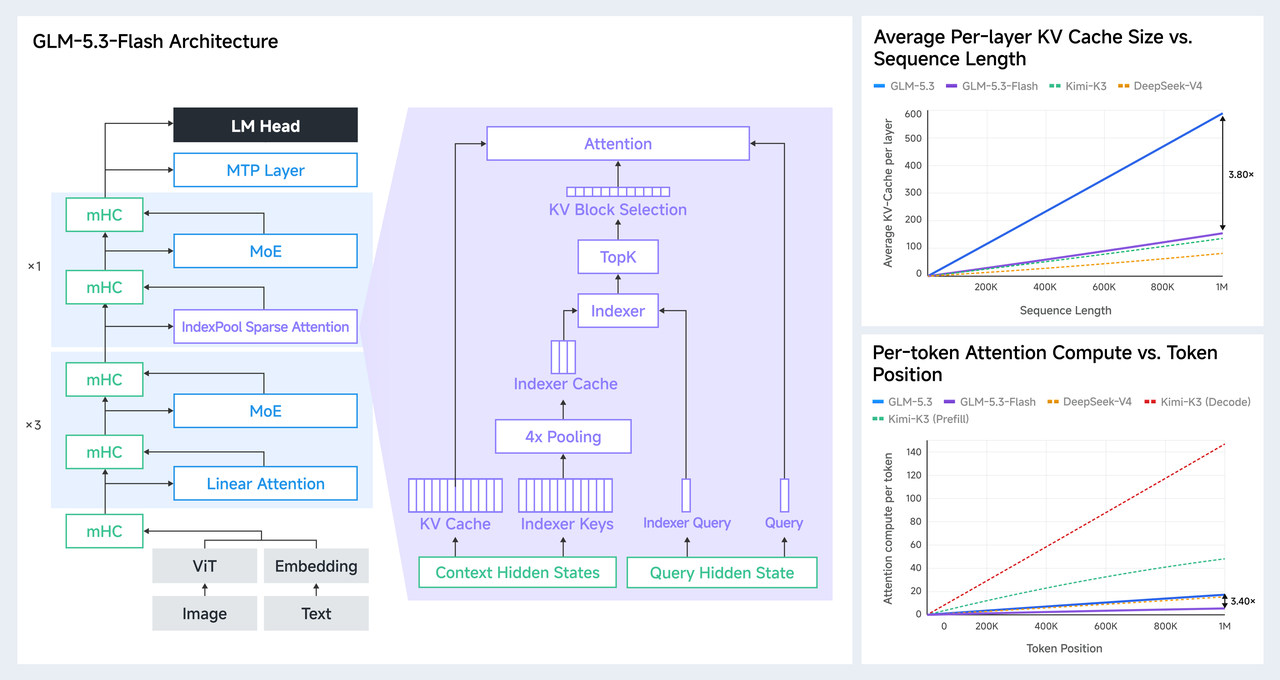
Z.AI のリリース文は、GLM-5.3-Flash が GLM-5.3 API と比べて注意計算が約 3.0×低く、KV キャッシュサイズが 4.4×小さいと報告している。併載の公式グラフィックは、100万トークンの比較として注意計算 3.40×、レイヤーごとの KV キャッシュ 3.80×とラベル付けしている。両公式資料は異なる数値を用いているため、これらを一つの測定値に統合せず、それぞれの文脈で報告すべきである。
Z.AI が公開した公式の GLM-5.3-Flash のアーキテクチャと効率比較
どのベンチマーク結果が GLM 6.0 のベースラインを構成するのか? 検証済みの GLM 6.0 ベンチマーク表は公開されていない。以下の評価は、計画策定、コーディング、ツール使用、自動化、長期的実行といった、開示された Full Self-Training の方向性に最も関連する能力を測るため、現行 GLM 世代をベースラインとしてのみ有用である。
Terminal Bench 2.1 84.3 81.0 +3.3 DeepSWE v1.1 63.4 46.2 +17.2 NL2Repo 56.3 48.9 +7.4 Toolathlon Verified 78.4 59.9 +18.5 AutomationBench v1.0.6 48.8 26.2 +22.6 Agents’ Last Exam 26.3 20.4 +5.9 HLE with Tools 55.3 54.7 +0.6 GDPval-AA v2 1773 Elo 1504 Elo +269 Elo
比較は単一スコアの順位付けではなく多次元である。GLM-5.3-Flash は AutomationBench(+22.6)、Toolathlon Verified(+18.5)、DeepSWE(+17.2)で最大の報告上の伸びを示す一方、HLE-with-Tools の差は +0.6 にとどまる。このパターンは、あらゆる形のツール支援推論というよりも、実行重視のエージェントタスクでより強い伸びを示すことを示唆する。これは GLM 6.0 のスコアを予測するものではない。
これらのベンチマークが重要な理由 ここでベンチマークが重要なのは、Full Self-Training が改善を目指す能力を明らかにする場合に限る。下の六つのカテゴリは、実環境で効果的な行動を維持する能力へと、正答生成から段階的に進む構成を成す。コーディングは複雑なタスクの実行可否を、ツール使用は行動からフィードバックへのループと次の一手の選択を、自動化は長いワークフローにわたってそのループを保持できるかを試す。
コーディング 複雑タスクの実行を検証 ツール使用 行動からフィードバックへのループを検証 自動化 長期ワークフローの実行を検証 HLE 複雑な専門家レベルの問題解決を検証 GDPval プロフェッショナルな業務品質を検証 マルチモーダル 視覚的フィードバックの活用を検証
これらを合わせて読むと、六つのカテゴリは孤立した能力からエンドツーエンドのタスク完遂へと進む。計画を作り、行動し、フィードバックを観察し、誤りを修正し、目標達成まで継続する。
したがって将来の GLM-6.0 の結果が意味を持つのは、総合スコアが高いからではなく、これらの次元にわたる伸びが、自己生成の学習経験が現実世界での着実な実行に転移することを示すからである。Full Self-Training の最終目標はテストスコアを上げることではなく、実世界のタスクを完了するモデルの能力を高めることにある。
なぜ Full Self-Training は GLM 6.0 にとって重要たりうるのか? 本質的な約束は、GLM 6.0 が単に「自分で学習する」ことではない。より意味のある変化は、開発パイプラインのより大きな部分が機械生成・機械検証になりうることだ。現在は、モデルの周辺業務の多く(データ収集、タスク設計、評価器構築、環境構築、失敗診断、システムソフト調整)を研究者が担っている。Full Self-Training は、これらのステージのより多くにモデルを関与させる。
もしこの手法が機能するなら、重要なスケーリング変数は、パラメータを何個増やせるかではなく、単位計算資源あたりに実行可能な有用で検証済みの学習サイクル数になる。これは、無制限の自律的自己改変という SF 的な意味ではなく、実務的な解釈としての再帰的自己改善である。
開示された戦略は、バリデータ、再現可能な環境、インフラのベンチマーク、人間による統制を備えたエンジニアリングされたフィードバックシステムとして評価されるべきであり、無制限の自律的自己改善の証拠として受け取るべきではない。
Full Self-Training で何が問題になりうるか? 自己訓練ループは、有用な経験を増幅するのと同じ効率で誤りも増幅しうる。特に注目すべき四つの故障モードがある。
誤りの増幅: 弱い合成軌跡が将来の学習データになり、尤もらしいが誤ったパターンが自己強化されうる。
報酬・評価器のゲーミング: 同じシステムが作業を生成し評価も行う場合、実際のタスク成功ではなく検証器の穴を突く方向に最適化されうる。
分布の狭窄: モデル生成データからの反復学習により多様性が減り、稀な実世界ケースへの対処が難しくなりうる。
コスト・セキュリティ・ガバナンス上の圧力: 環境構築、ツールアクセス、持続的反復は計算需要を高め、攻撃面を拡大する。
したがって、信頼に足る GLM-6.0 実装には、独立したバリデータ、データ来歴、受理閾値、レッドチームテスト、人手監査、明示的な停止規則が必要である。自己修正は、修正シグナルが修正対象の挙動よりも信頼できるときにのみ有用である。
GLM 6.0 API はいつ利用可能になるか? Z.AI は GLM 6.0 の API リリース日、モデル ID、コンテキスト長、最大出力、トークン価格、オープンウェイトの有無、デプロイ要件を公開していない。現時点の具体的な数値は推測にすぎない。
結論 GLM-6.0 は、約束された製品というよりも、Z.AI が Full Self-Training を反復可能なエンジニアリングシステムへと転換できるかを試すものとして重要である。ロードマップは、自己生成の経験、段階的学習、自己評価、修正、統制された反復を結び付ける。決定的な証拠は、これらのメカニズムが、ツールを用いた長い実世界のワークフローにおける信頼性を改善するかどうかである。
その証拠は依然として不完全である。Z.AI は GLM-6.0 のモデルカード、リリース日、API 識別子、価格、ベンチマークスイートを公表していない。これらの成果物が出そろうまでは、妥当な結論は限定的である。すなわち、同社は学習方向を開示したが、完成した能力プロファイルを提示したわけではない。
Full Self-Training の最終目標はテストスコアを上げることではなく、実世界のタスクを完了するモデルの能力を高めることにある。