
TL;DR
すでに OpenAI Responses ツールを使っている場合、または明示的な推論エフォート段階が必要な場合は GPT-6.1 Sol から始め、よくスコープされたコーディング反復やテンプレート駆動のプロフェッショナルな成果物には Claude Sonnet 5.5 を試してみてください。これは評価の優先順位であり、確立された品質ランキングではありません。両者とも入力 $2/M、出力 $10/M、およびベースのキャッシュ読み取り $0.10/M から始まります。約 1M のコンテキストと 128K の標準最大出力において、実務上の違いは、統合、タスク挙動、キャッシュ保持、そしてベースのキャッシュ読み取り割引ではなく長コンテキスト課金にあります。
主要なトレードオフはタスク挙動と課金条件です。GPT-6.1 Sol は 5 段階のエフォートを持ち、ツール呼び出しには Responses を要します。Sonnet 5.5 はアダプティブ思考を用います。272K 入力トークンを超えると、GPT-6.1 Sol はリクエスト全体に対して高いレートを適用します。ここで参照したソースは一致した同一バージョンのベンチマーク勝者を確立していないため、受け入れ基準を満たしつつ総ワークフローコストが最も低いモデルを選択してください。
Key Takeaways
- ベース価格は同じ: 両モデルとも入力 $2/M、出力 $10/M、キャッシュ読み取り $0.10/M。キャッシュ書き込み、保持、長コンテキスト階層、実際の課金使用量を比較。
- コンテキストは近い: 1.05M 対 1M トークン。ともに 128K の標準最大出力をサポート。
- 統合が異なる: GPT-6.1 Sol はツール呼び出しに Responses を要し、none や minimal は受け付けない。Sonnet 5.5 はアダプティブ思考とモデル固有のツール制約。
- 証拠はバージョン別に維持: GPT-6 Sol のスコアを GPT-6.1 Sol の結果として再ラベルしないこと。
- 完了した作業で選ぶ: 品質、レイテンシ、リトライ、キャッシュ書き込み・読み取り、ツール料金、人間の修正を計測。
GPT-6.1 Sol vs Claude Sonnet 5.5 at a Glance
| 意思決定要因 / 仕様 | GPT-6.1 Sol | Claude Sonnet 5.5 |
|---|---|---|
| 提供者 | OpenAI | Anthropic |
| リリース日 | September 29, 2026 | September 28, 2026 |
| モデル ID | gpt-6.1-sol | claude-sonnet-5-5 |
| コンテキスト / 標準最大出力 | 1,050,000 / 128,000 tokens | 1,000,000 / 128,000 tokens |
| 入力 → 出力 | Text and images → text | Text and images → text |
| 推論コントロール | low, medium, high, xhigh, max; medium デフォルト | アダプティブ思考; Claude Platform では high デフォルト |
| デフォルトエフォート | medium | Claude Platform では high |
| ナレッジカットオフ | April 30, 2026 | June 2026 |
| 公式ベース 入力 / 出力(1M トークンあたり) | $2 / $10; Standard リクエストで最大 272K 入力トークン | $2 / $10 |
| 公式ベース キャッシュ読み取り(1M あたり) | $0.10 | $0.10 |
| 公式ベース キャッシュ書き込み(1M あたり) | $2.50 | 5 分で $2.50; 1 時間で $4.00 |
| 長コンテキスト課金 | 272K 入力超過: 入力 $4、キャッシュ読み取り $0.20、キャッシュ書き込み $5、出力 $15(1M あたり)。Standard リクエスト全体に適用 | 引用モデル概要には同等のサーチャージ記載なし |
| 主なポジショニング | 複雑なコーディング、コンピュータ使用、プロフェッショナル業務 | 高速なコーディング反復とプロフェッショナルワークフロー |
| 優先テストの状況 | Responses ツールをすでに使う、または明示的なエフォートコントロールが必要な場合 | 作業の中心がコーディング、ドキュメント、スライド、スプレッドシートの場合 |
| 証拠と意思決定の限界 | 文書化された能力。ここでは一致した同一バージョンの数値的勝者は未確立 | 公開されたコーディングとナレッジワーク結果。GPT-6.1 Sol に対する統制比較ではない |
GPT-6.1 Sol Overview
GPT-6.1 Sol は、複雑なコーディング、コンピュータ使用、プロフェッショナル業務向けの OpenAI による 2026 年 9 月 29 日の Sol リリースです。OpenAI はこれを低コストで Astra に近い性能と説明していますが、そのポジショニングはあなたのタスクで検証すべきです。大きなコンテキストと調整可能な推論により、リポジトリアジェントや多段のプロフェッショナルワークフローに適した候補となります。
運用上の制約はポジショニングと同じくらい重要です。デフォルトは medium、最低は low で、ツール呼び出しには Responses を要します。無推論パスや Chat Completions のツールに基づくワークフローは、このモデルを信頼して使う前に移行作業が必要です。
Claude Sonnet 5.5 Overview
Claude Sonnet 5.5 は、よくスコープされた日常のコーディング、エージェント、プロフェッショナル業務向けの Anthropic による 2026 年 9 月 28 日のリリースです。モデル概要はアダプティブ思考、Claude Platform における高いデフォルトエフォート、テキストと画像入力、128K の標準最大出力を記載しています。Anthropic はバグ修正、明瞭なドキュメント、洗練されたスライド、効率的な反復を強調しています。
開発チームにとっては、Sonnet は実装とレビューの反復に有用な候補です。オフィスワークフローでは、初稿品質とテンプレート遵守を評価してください。プロバイダの速度主張は Sonnet 5.5 を Sonnet 5 と比較したもので、GPT-6.1 Sol に対する速度優位を確立するものではありません。
GPT-6.1 Sol vs Claude Sonnet 5.5: Performance
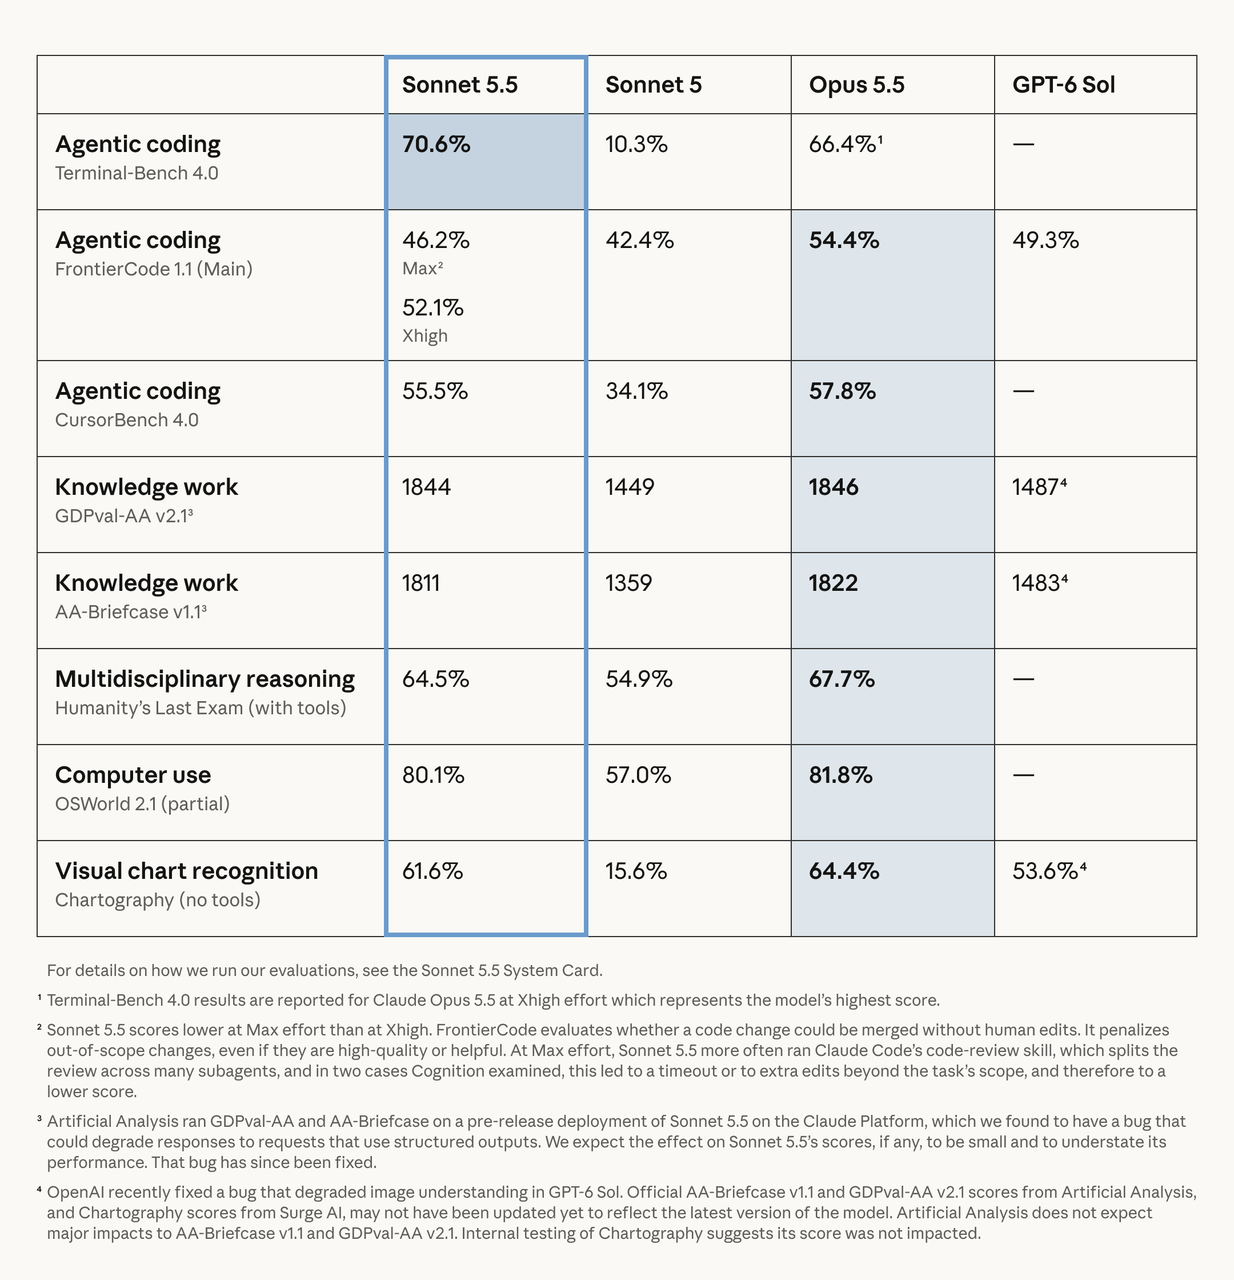
Anthropic の Sonnet 5.5 ローンチ結果は有用な作業負荷のシグナルを提供します。その比較には旧い GPT-6 Sol が含まれるため、その OpenAI 列の値は現行モデル表から除外しています。「未確立」は、ここで引用したソースがこの比較に対する同一バージョンの正確なスコアを支持しないことを意味し、性能がゼロという意味ではありません。
| ベンチマーク / 条件 | GPT-6.1 Sol | Claude Sonnet 5.5 | 測定内容 |
|---|---|---|---|
| Terminal-Bench 4.0 | Not established here | 70.6% | ターミナルでのコーディングタスク |
| FrontierCode 1.1 Main | Not established here | 52.1% Xhigh; 46.2% Max | マージ可能なリポジトリ変更 |
| CursorBench 4.0 | Not established here | 55.5% | Cursor タスクでのエージェント開発 |
| GDPval-AA v2.1 | Not established here | 1844 | プロフェッショナルなナレッジワーク |
| AA-Briefcase v1.1 | Not established here | 1811 | 長期地平のナレッジワーク |
| Humanity’s Last Exam, tools | Not established here | 64.5% | 学際的推論 |
| OSWorld 2.1, partial | Not established here | 80.1% | コンピュータ使用の部分報酬 |
| Chartography, no tools | Not established here | 61.6% | 視覚チャート認識 |
テスト条件: エフォートとエージェントハーネスはコーディング結果に影響します。GDPval-AA と AA-Briefcase は Artificial Analysis の評価であり、Chartography の結果は Surge AI によるものです。Anthropic は、プレリリースの Sonnet デプロイにおける構造化出力のバグが修正されており、それがプロフェッショナルワークの結果をわずかに過小評価した可能性があると述べています。アナウンスの System Card リンクでテスト環境と完全な方法論を確認し、異なる指標を 1 つの総合ランキングにまとめないでください。
以下の Anthropic の元画像には評価の脚注が含まれます。GPT-6 Sol 列は歴史的文脈のみであり、GPT-6.1 Sol の性能を報告するものではありません。
エージェント的コーディングとソフトウェア工学
Sonnet 5.5 はターミナルコーディング、マージ可能なコード変更、IDE スタイルのエージェントタスクに関する証拠を報告しています。GPT-6.1 Sol は複雑なコーディングに対応し、OpenAI のツールエコシステムと統合されています。製品ポジショニングや前任モデルのスコアだけでは、現行のコーディング勝者は確立されません。有用な評価のためには、回帰テスト付きの実際の変更を選び、レビュアーにスコープ、保守性、マージ準備性を評価してもらってください。
ナレッジワーク、推論、数学、科学
Sonnet の GDPval-AA と AA-Briefcase の結果は、レポート、分析、オフィス成果物を妥当な評価対象とします。GPT-6.1 Sol もプロフェッショナル業務を対象としていますが、ここで用いたソースはこれらのモデル間の一致した比較を提供していません。あなた自身のドキュメント、スプレッドシート、プレゼンテンプレートを用いてください。高度な数学や科学に関する主張は、一般的な推論コントロールからの外挿ではなく、タスク固有の証拠を必要とします。
コンピュータ使用、ブラウザ自動化、マルチモーダルワークフロー
両モデルとも画像を受け付けるため、スクリーンショットのデバッグや視覚分析をサポートします。Sonnet の OSWorld と Chartography の結果は、その特定の評価に対する証拠です。GPT-6.1 Sol は Responses ツールを通じてコンピュータ使用を文書化しています。ワークフロー全体をテストしてください: ナビゲーション精度、失敗したツール呼び出し後の復旧、出力の正確性、完了までの時間。テキストと画像の入力自体は、同一のコンピュータ使用統合を保証しません。
独立評価と証拠の質
プロバイダが公開する表は、第三者の結果を含みうるものの、単一の統制実験にはなりません。独立比較のためには、正確なモデル ID、デプロイ日、エフォート、ツール、セーフガード、タイムアウト、リトライポリシー、停止規則を記録してください。総合知能指数、コーディング成功率、部分報酬のコンピュータ使用スコアは、それぞれ異なる問いに答えます。ここでレビューしたソースは、この正確なペアに対する完全一致の独立結果セットを確立していません。
GPT-6.1 Sol vs Claude Sonnet 5.5: Cost
公式 API 価格
| 価格メトリクス | GPT-6.1 Sol 公式レート | Claude Sonnet 5.5 公式レート |
|---|---|---|
| 入力 / 1M トークン(ベース Standard) | $2.00 | $2.00 |
| 出力 / 1M トークン(ベース Standard) | $10.00 | $10.00 |
| キャッシュ読み取り / 1M(ベース) | $0.10 | $0.10 |
| キャッシュ書き込み / 1M(ベース) | $2.50 | 5m で $2.50; 1h で $4.00 |
| バッチ処理 | Standard より 50% 低い | 入出力 50% 割引 |
| 272K 超の入力(Standard リクエスト全体) | 入力 $4 / 読み取り $0.20 / 書き込み $5 / 出力 $15(1M あたり) | 引用概要には同等のサーチャージ記載なし |
すべてのレートは USD/百万トークンです。GPT-6.1 Sol のベースキャッシュ読み取りは $0.10/M であり、Sonnet 5.5 のキャッシュ読み取りも $0.10/M です。Sol の 272K 超入力条件は、超過分だけでなく Standard リクエスト全体のレートを引き上げます。キャッシュ書き込み、保持、長コンテキスト階層、地域処理、サービス階層を比較してください。ベースの読み取り価格だけでは、どちらのモデルにも優位性はありません。
タスク完了あたりのコスト
受け入れられた結果あたりのコスト = 全試行タスクの総コスト / 受け入れられた結果数。総コストには、課金される新規入力、キャッシュ読み取りと書き込み、出力(該当する場合は課金される推論トークンを含む)、有料ツール呼び出し、人間によるレビューや修正が含まれます。リトライコストは、二重計上ではなく実際の使用を通じて計上します。
100 万のキャッシュ読み取りトークンが完全にベースレートで課金された場合、どちらのモデルでも $0.10 です。これはレートの例示であり、100 万入力トークンの Sol リクエストがベース階層で価格設定されることを意味しません。実際のセッションコストには、新規入力、キャッシュ書き込み、出力、ツール、リトライも含まれます。適用されるコンテキスト階層の下でのコールド/ウォームセッションを比較し、受け入れ結果率と課金使用量を併記してください。
CometAPI 価格
| 公開 CometAPI 階層 | CometAPI の GPT-6.1 Sol API | CometAPI の Claude Sonnet 5.5 API |
|---|---|---|
| ベース 入力 / 出力(1M あたり) | $1.60 / $8.00 | $1.60 / $8.00 |
| プロバイダ比のベース割引 | 20% | 20% |
| GPT 長コンテキスト 入力 / 出力 | $3.20 / $12.00 | 選択ルートの最新条件を確認 |
| GPT キャッシュ読(ベース/長) | $0.08 / $0.16 | 基本表では未記載 |
これらは、この改訂時点で確認した公開モデルルート価格であり、プロバイダのレートとは別です。GPT-6.1 Sol の CometAPI 価格は短・長コンテキストを区別しています。引用した Sonnet の基本表は入出力を掲載していますが、同一のゲートウェイキャッシュ方針を仮定できる根拠にはなりません。選択したルートの最新の課金条件を、本番見積もり前に確認してください。
コンテキスト、速度、技術仕様はどう比較できるか?
GPT-6.1 Sol は 1.05M トークン、Claude Sonnet 5.5 は 1M トークンをサポートします。名目上の差は約 5% に過ぎず、コンテキスト容量だけで大半のデプロイを決定づける可能性は低いでしょう。
GPT-6.1 Sol のエフォートラダーは low、medium、high、xhigh、max(デフォルトは medium)です。Sonnet 5.5 はアダプティブ思考で、Claude Platform では high がデフォルトです。名称は等しい推論予算を意味しません。同等の品質要件では、最初のトークンまでの時間、出力スループット、ツールループのレイテンシ、エンドツーエンドの完了時間を個別に測定してください。
Anthropic は Sonnet 5.5 が Sonnet 5 比で 30% 超の出力生成高速化を報告しています。これは前任モデル比較として扱ってください。本記事の証拠は、GPT-6.1 Sol の普遍的レイテンシ数値も、現行モデル間の直接的な速度勝者も確立していません。対話型ワークロードでは、最大設定が最適と仮定せず、同一の受け入れ基準で低いエフォート設定も試験してください。
セーフティ、アラインメント、デプロイで重要なことは?
デプロイ判断は、文書化されたモデル挙動とアプリケーション制御を区別すべきです。モデル比較だけでは、組織のデータ処理やアクセス要件を満たすデプロイを確立できません。実際に使用するプロバイダまたはゲートウェイを評価し、リクエストログ、データレジデンシ、ツール権限、失敗時のハンドリングを確認してください。
- 推論移行: GPT-6.1 Sol は none や minimal をサポートしません。OpenAI の移行ガイダンスは、ツール呼び出しワークフローを Responses に誘導します。
- Claude のツール挙動: Sonnet 5.5 の互換性変更には、未サポートの強制ツールモードや会話に束縛された思考ブロックが含まれます。これらの経路は展開前にテストしてください。
- 運用制御: エージェントにはタスクに必要なツールのみを与え、失敗した呼び出しを記録し、重大な外部アクションには人間のレビューを維持してください。これはアプリケーション設計の選択であり、どちらのモデルの優位性でもありません。
GPT-6.1 Sol vs Claude Sonnet 5.5: どちらを選ぶべきか?
既に Responses ツールを使っている、または予測可能なエフォートラダーが必要な場合は GPT-6.1 Sol を優先的に試験してください。よくスコープされたコーディング反復、スライド、スプレッドシート、ドキュメントワークフローでは、報告された証拠がタスクに一致する Sonnet 5.5 を試してください。キャッシュ重視のセッションでは両方を試験してください。ベースのキャッシュ読み取りレートは同じですが、書き込みコスト、保持、長コンテキスト階層、タスク成功が総コストを変えます。代表的な評価が品質、コスト、またはレイテンシの有意差を示すまで、ルートの選定は保留してください。
ワークロード別の選定
| ワークロード | 出発点 | 検証すべきこと |
|---|---|---|
| 既存の OpenAI Responses エージェント | GPT-6.1 Sol | ツール互換性とエフォート変更 |
| コーディング反復 / バグ修正 | Sonnet 5.5、その後 Sol と比較 | マージ準備性、レイテンシとリトライ |
| スライド / スプレッドシート / レポート | Sonnet 5.5、その後 Sol と比較 | テンプレート遵守と人間の編集時間 |
| 安定したキャッシュ接頭セッション | 両方。ベースのキャッシュ読レートは同じ | ヒット率、書き込み、コンテキスト階層、受け入れ品質 |
| 272K 超のフルリクエスト | 両方 | 実際の長コンテキスト課金とリトリーバル品質 |
| コンピュータ / ブラウザ自動化 | 両方 | 復旧、タスク完了、権限 |
| 数学 / 科学的分析 | タスク固有テストで両方 | 検証可能な答えの正確性 |
| コスト重視の本番 | 両方 | 受け入れ結果あたりの総コスト |
本番比較では、周辺システムを一定に保つべきです。同じプロンプト、リポジトリまたはドキュメント、ツール権限、タイムアウト、リトライポリシー、出力受け入れ基準を使用してください。
新規入力、キャッシュ書き込みと読み取り、出力使用量、有料ツール呼び出し、リトライ、人間レビュー時間、タスク成功、エンドツーエンドのレイテンシを記録してください。安い最初の応答が、より高価な受け入れ結果につながる場合もあります。
GPT-6.1 Sol と Claude Sonnet 5.5 へのアクセス方法
開発者は、文書化されたモデルルートを通じて CometAPI の GPT-6.1 Sol API と CometAPI の Claude Sonnet 5.5 API にアクセスできます。API キーを作成し安全に保存し、本番使用前にモデルアクセスとルート固有の課金を検証してください。
GPT-6.1 Sol アクセス
Sol では、ツール呼び出しが必要な場合は文書化された Responses ルートを使用してください。gpt-6.1-sol とサポートされるエフォートレベルを選択し、デフォルトは medium です。タスク入力を渡し、必要なツールだけを構成し、返却されたテキスト、ツール呼び出し、エラー、使用量を検証してください。すべての OpenAI オプションが利用可能と仮定するのではなく、プロバイダ固有機能に対するゲートウェイのサポートを確認してください。
Claude Sonnet 5.5 アクセス
Sonnet では、互換インターフェースで claude-sonnet-5-5 を選択し、適切な出力予算で会話メッセージとしてタスクを送信してください。そのルートがネイティブ思考とツールパラメータをどのように扱うかを確認してください。OpenAI の推論フィールドは Claude のオプションと自動的に互換ではありません。エージェント展開前に、会話継続とエラーハンドリングを検証してください。
エンドポイントチェックは接続性を検証するものであり、比較性能ではありません。評価のためには、プロンプト、実効出力/推論予算、ツール、リトライ、タイムアウト、受け入れ基準を整合させ、受け入れられた作業、レイテンシ、総課金コストを比較してください。
Conclusion
GPT-6.1 Sol と Claude Sonnet 5.5 は、ベースの入力、出力、キャッシュ読み取りレートが同一で、コンテキスト容量も類似しています。Sol は既存の Responses エージェントや明示的なエフォートコントロールに適した自然な候補です。Sonnet のアダプティブ思考と報告されたコーディング/プロフェッショナルワークの結果は、日常的な成果物に有用な候補とします。キャッシュ重視のワークフローではセッション全体を比較してください。ベースの読み取りレートが同じでも、書き込み、保持、長コンテキスト、完了タスクのコストは同一とは限りません。
品質、レイテンシ、コスト要件の範囲で実際の作業を完了できるモデルを選択してください。前任スコアを現行モデルの証拠と混同せず、あなたのワークロードが使うコンテキスト階層で価格を見積もり、採用前に両ルートを比較してください。
FAQ
GPT-6.1 Sol と Sonnet 5.5 は 1 つのツールスキーマを共有できるか?
共通の JSON ツール定義は出発点になり得ますが、エンドポイントのサポート、強制ツール動作、思考ブロック、応答処理は異なります。各モデルのツール呼び出しを、引数、失敗経路、会話継続の契約テストで検証してください。テキストリクエストの成功をもってエージェント互換性を仮定せず、未サポートのオプションにはモデル固有のアダプタを維持してください。
両モデル間で推論エフォートをどう一致させるべきか?
同名の設定を同一の計算予算とみなさないでください。受け入れ基準と、コスト上限またはレイテンシ目標を定義し、各モデルでエフォート設定をスイープしてください。同じ運用制約を満たす最適構成(リトライと人間の修正を含む)を比較し、両モデルの最高設定だけを比較するのは避けてください。
1M コンテキストのワークフローはいつリトリーバルを使うべきか?
タスクが大きなコーパスの中の小さく特定可能な部分を必要とし、リトリーバルテストで関連素材が一貫して取得されると示される場合は、リトリーバルを使用してください。証拠が分散している、またはファイル間関係が重要な場合は、フルコンテキストリクエストを試験してください。回答の正確性、引用のカバレッジ、入力コスト、レイテンシを比較してください。大きなコンテキスト上限だけでは、ウィンドウを満たすことが経済的または信頼できると確立されません。
誤解を招くキャッシュコスト比較を避けるには?
コールドキャッシュとウォームキャッシュを別々に測定し、キャッシュ書き込みだけでなく読み取りも記録し、正しい保持ウィンドウと長コンテキスト階層を適用してください。共有プレフィックスを安定させ、単一の割引リクエストではなく、現実的な繰り返しセッションで比較してください。ヒット率と総課金使用量を報告し、見かけ上の節約を再現可能にしてください。
GPT-6.1 Sol と Sonnet 5.5 の再評価は何をトリガーにすべきか?
デプロイ更新、プロバイダのバグ修正、ルーティング変更、ツールやプロンプトの変更、または重要な価格改定の後に、影響を受けるタスク群を再実行してください。評価日、モデル ID、エンドポイント、エフォート、ハーネスバージョンを記録します。以前の実行をベースラインとして保持し、品質やレイテンシの変化を、周辺システムの変化と混同しないようにしてください。