
概要
GPT-6 Astra は見出し級のスコアで卓越した結果を示しています。最大の向上は、推論を行動に変換しなければならない場面で顕著です。具体的には、ターミナル操作、ソフトウェア利用、自動化、長文脈の検索、科学的ワークフロー、サイバーセキュリティです。既に飽和状態にある学術系テストでは、前世代の OpenAI モデルからの改善幅はしばしば小さくなります。
本モデルは 1,050,000 トークンのコンテキストウィンドウ と幅広いツールサポートを組み合わせています。OpenAI が公開した実行ベンチマークによれば、実務上のアップグレードは長期的な作業で最も強力ですが、ハーネス設計、推論努力、レイテンシ、ツールアクセスが結果に大きく影響します。
重要なポイント
- Astra の最も明確な伸びはエージェント的実行にあり、あらゆる形式の質問応答ではありません。
- Terminal-Bench、AutomationBench、コンピュータ操作、データベース移行の結果は、GPQA や DeepSWE よりも大幅に改善しています。
- ARC-AGI-3 の結果は、モデル状態・コンテキスト管理・評価ハーネスが最終スコアを支配し得ることを示しています。
- 大きなコンテキストウィンドウの価値は、限界付近でも情報を再取得できる場合にのみ意味があります。広告される容量そのものより MRCR の方が情報量の多い指標です。
- トークン単価が高くても、必要トークン数・ターン数・リトライ・人間による修正が減れば、タスクの総コストは必ずしも高くなりません。
- 本番判断では、成功率・経過時間・総コスト・ツールの信頼性・修正負担を合わせて比較すべきです。
GPT-6 Astra の概要
OpenAI は最大 128,000 出力トークン、テキストと画像の入力、テキスト出力、そして low から max までの推論努力を仕様として掲げています。これらの仕様は大規模で多段のワークフローを可能にしますが、モデルが適切な証拠を再取得し、タスクを確実に完了することを保証するものではありません。
| 公式仕様 | CometAPI における GPT-6 Astra | 実務上の意味 |
|---|---|---|
| Model ID | gpt-6-astra | API ルーティングのための安定した識別子 |
| Context window | 1,050,000 tokens | 大規模リポジトリ、アーカイブ、エージェント履歴の取り込みに対応 |
| Maximum output | 128,000 tokens | 大規模なレポート、パッチ、構造化成果物の生成が可能 |
| Knowledge cutoff | April 30, 2026 | 以降の事実はツールか提供ソースが必要 |
| Input | Text and images | 文書、スクリーンショット、図表、混在証拠を扱える |
| Output | Text | 散文、コード、構造化テキストを生成 |
| Reasoning effort | low, medium, high, xhigh, max | レイテンシとコストを深い探索とトレードオフ |
| Agent capabilities | Function calling, structured outputs, computer use, web/file search, hosted shell, Apply Patch, MCP | 孤立した回答ではなくエンドツーエンドのワークフローを実現 |
| OpenAI Standard input | $10 per million tokens | 入力サイズとキャッシュ再利用が総コストに影響 |
| OpenAI cached input | $1 per million tokens | キャッシュ済みのプロンプトプレフィックス再利用時に適用 |
| OpenAI cache writes | $12.50 per million tokens | 非キャッシュ入力の 1.25× で課金 |
| OpenAI Standard output | $50 per million tokens | 冗長な出力はタスクコストを支配し得る |
| Requests above 272K input tokens | Input と cache のレートは ×2、output のレートは ×1.5 | 高いレートはリクエスト全体に適用される |
コンテキスト上限は容量を測るもので、利用可能な想起を保証するものではありません。ツール一覧は利用可能性を示すに過ぎず、実行成功を保証しません。これらの仕様が完了した作業に繋がるかどうかを検証するには、ベンチマークが必要です。
GPT-6 Astra のベンチマーク結果は何を示すか?
総合的な結果は一様ではありません。Astra は一部の学術・ソフトウェア推論テストでは Sol をわずかに上回る程度ですが、ターミナル作業、自動化、データベース移行、視覚的インタラクション、長文脈検索、高度数学では二桁台の改善を示しています。
| 公開ベンチマーク | GPT-6 Astra | GPT-5.6 Sol | Claude Fable 5.1 | Astra vs. Sol |
|---|---|---|---|---|
| Terminal-Bench 4.0 | 57.9% | 37.3% | 55.8% | +20.6 pp |
| DeepSWE v1.1 | 74.1% | 72.7% | 67.4% | +1.4 pp |
| Database Migration Tasks | 63.9% | 42.7% | 57.8% | +21.2 pp |
| OSWorld 2.0 | 72.6% | 65.7% | — | +6.9 pp |
| ScreenSpot-Pro | 92.7% | 76.9% | — | +15.8 pp |
| AutomationBench | 41.4% | 18.1% | 31.4% | +23.3 pp |
| BenchCAD | 95.9% | 83.3% | 84.3% | +12.6 pp |
| FrontierMath Tier 4 v2 | 97.6% | 83.0% | 87.8% | +14.6 pp |
| GPQA Diamond | 96.0% | 94.6% | 93.7% | +1.4 pp |
| MRCR v2, 512K–1M | 96.3% | 73.8% | — | +22.5 pp |
| AA Intelligence Index v4.1.1 | 61.2 | 60.9 | 65.7 | +0.3 |
| ARC-AGI-3, Provider Adapter | 99.9% | 7.8% | — | +92.1 pp |
3 つのクラスターが見えます。第一に、DeepSWE と GPQA での 1.4 ポイント差は、既に強いモデルが高得点を出すタスクでの増分的な前進が限定的であることを示します。第二に、Terminal-Bench、AutomationBench、データベース移行、100 万トークン級の検索で 20 ポイント超の向上は、実行能力のより大きな変化を示します。第三に、ARC-AGI-3 はハーネスへの依存が解釈を左右する外れ値です。
独立検証結果
Artificial Analysis は、Astra と Sol が Intelligence Index で概ね 61 付近に並ぶ一方、Coding Agent Index ではより明確な向上を報告しています。これは OpenAI のデータにあるパターンを独立に補強します。すなわち、最大の改善はエージェント的実行に集中しているということです。
Codex ハーネスの max effort では、Astra は Coding Agent Index において Sol の約 3 分の 1 のトークン数 で動作すると報告されています。一方、Intelligence Index でのトークン使用は約 10% 減に留まります。Astra のトークン単価が高いため、この二つの効率プロファイルは異なる経済性をもたらします。
| 独立評価 | 観測された結果 | 本番運用での解釈 |
|---|---|---|
| Intelligence Index | Sol と大差なし | 広範な推論で高い価格差を正当化しにくい可能性 |
| Coding Agent Index | 明確なエージェント能力の改善 | トークン数削減が高い単価を相殺し得る |
| AA-Omniscience | max effort で幻覚率が 92% から 51% に低下 | 研究・検索システムでの棄却判断の改善が重要になる可能性 |
| 長期的な知識労働 | タスク間で進捗はまちまち | ローカル評価が依然として必要 |
独立ベンチマークは本番でのファクト性や安全性を保証しません。チームは正答、正当化された不確実性、根拠のない主張、ソース制約違反を別途採点すべきです。
なぜ Astra は長期的なエージェント的作業に向いているのか?
GPT-6 Astra は、実行中に状況が変わる作業向けに 3 つの制御機構を追加しています。長時間の信頼性はコンテキスト全体の仕組みにも依存します。コンテキストウィンドウは容量を決め、圧縮は古い材料の要約方法を制御し、永続化された推論は関連するモデル状態を持ち越し、検索は過去の証拠を探せるようにし、アプリケーションは重要なツール出力、テスト結果、失敗したアプローチ、ユーザー要件を保存し続ける必要があります。これらの仕組みはエージェントハーネスと合わせて検証すべきです。
- 非同期ツール呼び出し: Astra はアプリケーションが長時間実行するツールを動かしている間も、独立した推論を続けたり他のツールを呼び出せます。
- ターン途中の舵取り: アプリケーションは WebSocket 経由で修正や新要件を送信し、完了済みの作業を破棄せずに調整できます。
- 会話途中の推論調整: 設定更新により、キャッシュされたプロンプトプレフィックスを保持したまま推論努力を上下できます。
実際に向上している領域
エージェント型コーディング: ターミナル作業がより大きなアップグレード
Terminal-Bench 4.0 は、エージェントが単独のコード回答を生成するだけでなく、難しいターミナルタスクをやり遂げられるかを測定します。Astra は 57.9% に達し、Sol を 20.6 ポイント、Fable を 2.1 ポイント上回りました。OpenAI の世代間としては大幅な向上ですが、他のフロンティアエージェントシステムとの差はより接戦です。
一方の DeepSWE は 74.1%(Astra)と 72.7%(Sol)。1.4 ポイント差は、一つのコーディングベンチマークから一般化すべきでないことを示唆します。環境との相互作用、反復、状態保持、検証を要するコーディングで、Astra は最も得点を伸ばすように見えます。
Database Migration Tasks はこの解釈を補強します。63.9% は Sol を 21.2 ポイント、Fable を 6.1 ポイント上回ります。移行業務はコード理解、ツール使用、シーケンス設計、運用判断を組み合わせる——小さな推論改善が積み重なって、より大きな完遂率の向上に繋がる複合ワークフローです。
コーディングエージェントでは、モデルとハーネスを合わせて評価してください。リポジトリの手順、ターミナルツール、リトライの挙動、コンテキスト保存、テスト実行はいずれも計測結果に寄与します。
コンピュータ操作: 成功率と実行時間の両方が重要
Agents’ Last Exam では、GPT-6 Astra は 59.3%、GPT-5.6 Sol は 53.6% と、5.7 ポイントの差です。これは上の概要にある OSWorld 2.0 と ScreenSpot-Pro のスコアに、より広いエージェントタスクの結果を加えるものです。
正確性を超えて、OSWorld の実行時間比較は実務的な次元を加えます。Astra はタスクあたり約 40 分、Sol は約 75 分と報告され、成功率の向上に加えて経過時間は約 47% 短縮されています。
わずかに成功率が高く、かつ大幅に速く完了するエージェントは、スループットで大きな改善をもたらします。調達テストでは、成功率、経過時間、ツール呼び出し、リトライ、人手介入を、正確性だけでなく併せて報告すべきです。
自動化とプロフェッショナル業務
AutomationBench は 18.1% から 41.4% へと 23.3 ポイントの上昇です。絶対スコアはまだ完璧から遠いものの、飽和近傍の 1 ポイント上昇よりも、失敗プロファイルの変化の方が意味があります。BenchCAD では Astra が 95.9% に達し、Sol に 12.6 ポイント、Fable に 11.6 ポイントの差を付けました。
これらは特定の主張を支持します。Astra は指示を検証済みの行動の連鎖に変換するのが上手くなっています。ただし、あらゆる業務ワークフローで同等の向上があると証明するものではありません。本番プロセスには、認証ステップ、プロプライエタリなインターフェース、曖昧なポリシー、ベンチマークにはないデータ形式が加わる場合があります。
科学
科学は Astra の最も明確な能力向上の一つです。FrontierMath Tier 4 v2 で、Astra は 97.6%、Sol は 83.0%、Fable は 87.8%。Sol に対する 14.6 ポイントのリードは大きいですが、評価は選択的なタスク分布であり、科学的ワークフローの全工程を網羅するものではありません。
サイバーセキュリティ
サイバーセキュリティは二つ目の大きな向上領域で、単なるリーダーボードの変動以上の重みを持ちます。2026 年 6–8 月を対象とする ExploitBench で、Astra は 39.0%、Sol は 5.5%。OpenAI はこの新しいセットが直近 3 か月の脆弱性を対象にしており、過去の露出影響を減らす構成であると報告しています。OpenAI の評価では、Astra は統制されたテスト中に、以前は未知だった 2 件のゼロデイ脆弱性を発見・悪用する能力を示しました。重要なのは、長く知られた問題ではなく最近公表された脆弱性を中心に設計された評価であったため、ベンチマーク性能が単なる記憶によるものではない可能性が高い点です。この結果により Astra は OpenAI の「Critical」サイバーセキュリティ能力閾値に到達し、展開に必要なセーフガードが変わりました。重要なのは、Astra が無制限のサイバー作戦を自律的に遂行できるという意味ではなく、能力レベルの変化が展開時のセーフガード要件を変えるという点です。脆弱性の発見と悪用能力が強いシステムには、より厳格なアクセス制御、監視、サンドボックス、人間によるレビューが必要です。
長時間タスク: コンテキストウィンドウだけが全てではない
Astra の 1,050,000 トークンのコンテキストウィンドウは容量を示しますが、継続性ではありません。長時間の性能は、圧縮、永続状態、過去の検索可能性、推論状態の保持、ツール出力の保存にも依存します。MRCR v2 では、Astra は 256K–512K で 100.0%、512K–1M で 96.3%、一方 Sol は 91.5% と 73.8% です。最長レンジでの 22.5 ポイント差は、限界付近での利用可能な再取得が、広告される容量以上に重要であることを示します。
MRCR は依然として合成的な検索テストです。したがって本番評価では、要約で失われがちな証拠を保持すべきです。例えば、なぜ以前の修正が失敗したか、特定コンポーネントの挙動、テスト結果、歴史的要件、ツール出力に埋もれた詳細です。リポジトリや研究アーカイブは、重複名、相互参照、古いポリシー、矛盾するソース、長い撹乱スパンを含めて試験するべきです。これにより、生のコンテキスト容量と、長期エージェントに実際に必要なコンテキスト保持と再取得挙動を切り分けられます。
コンテキストの保持: Astra が従来の長コンテキストシステムと違う理由
従来の長コンテキストワークフローは通常、以下のパターンに従います。
context → compaction → summary → continue
この方法はトークン使用量を削減しますが、重大なリスクを伴います。重要な中間情報が要約で失われ得ることです。
失われるのは最終解答そのものではなく、将来の意思決定に必要な運用上の詳細です。
- なぜ以前の修正が失敗したのか;
- どのコンポーネントが異常挙動を示したのか;
- どのテスト結果が実装方針を変えたのか;
- どのユーザー要件が後から追加されたのか;
- どのツール出力に重要な証拠が含まれていたのか。
GPT-6 Astra は、長時間エージェントワークフロー内でコンテキスト保持と再取得機構を組み合わせることで、この制限に対処します。
圧縮済み要約だけに頼るのではなく、重要なメモを保持し、必要に応じて過去情報を再取得し、複数のツールインタラクション間で連続性を維持できます。
Codex のようなコーディングエージェントでは、長いデバッグ作業で次を保持できます。
- 以前の失敗実験;
- リポジトリの変更;
- テスト出力;
- アーキテクチャ上の決定;
- 未解決の問題。
したがって、Astra の 100 万トークンのコンテキストウィンドウの価値は、投入できる情報量だけでなく、数時間の対話後に適切な情報を保持・再取得できるかどうかにあります。
推論と解釈
ARC-AGI-3: ハーネスは結果の一部
ARC-AGI-3 は、フロンティアベンチマークが独立したモデルではなく「システム」を測ることを最も明確に示します。ARC Prize は、max effort の Standard ハーネスで 62.7%、high effort の Provider Adapter で 99.9% を報告しています。
| ARC Prize の評価 | Standard Harness | Provider Adapter | Adapter Gain |
|---|---|---|---|
| max | 62.7% | 98.6% | +35.9 pp |
| xhigh | 59.3% | 98.4% | +39.1 pp |
| high | 54.8% | 99.9% | +45.1 pp |
| medium | 38.6% | 98.4% | +59.8 pp |
| low | 17.5% | 98.0% | +80.5 pp |
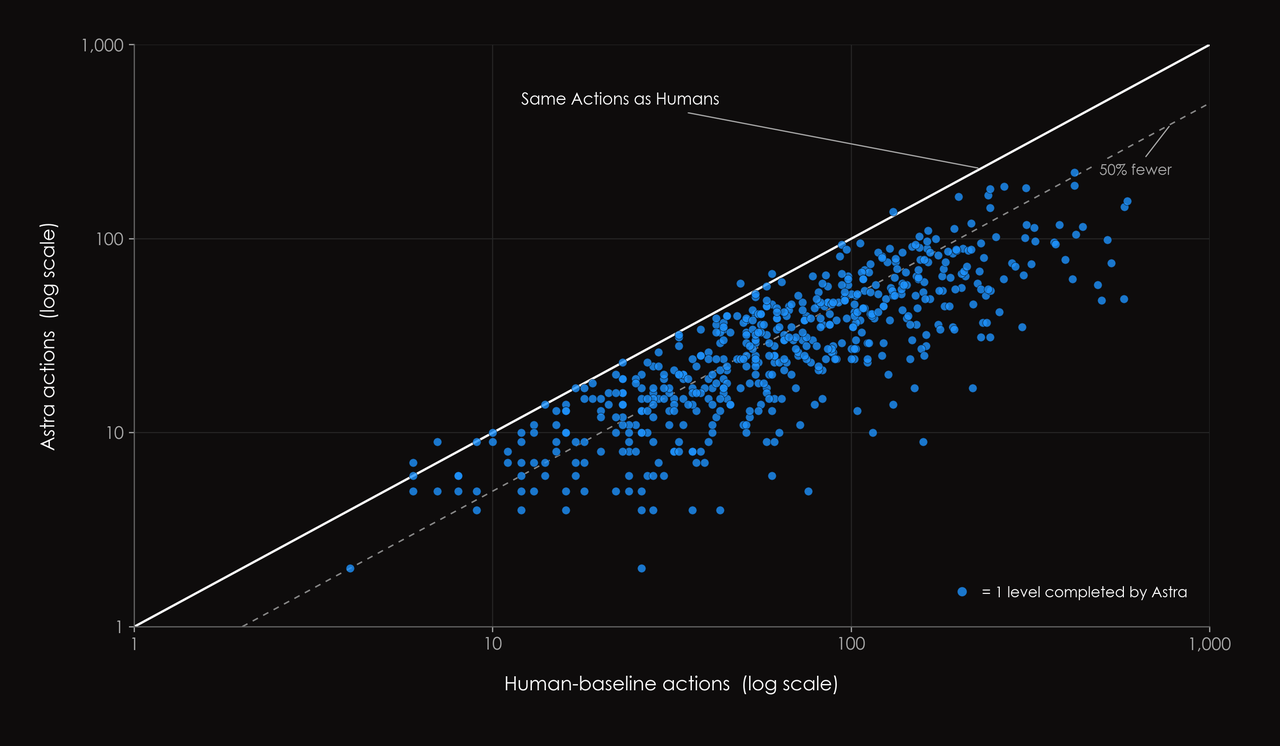
ARC Prize による、評価ハーネス間での Astra のアクション効率比較
プロバイダー中立ハーネスポリシー は、モデルが重要な情報を可視状態に保持することを求めます。Provider Adapter は追加の推論状態を保持し、プロバイダー固有のコンテキスト管理を用います。共有の解法ペアにおいて、ARC Prize はアダプター利用で 3.66 倍の高速化と 49% の総トークン削減を報告しています。
99.9% の結果は、特定のモデル–プロバイダー–アダプターの「システム」を測ったものであり、ハーネスに依存しない生のモデル知能の指標として扱うべきではありません。コンテキストアーキテクチャはベンチマーク対象システムの一部です。
推論努力は線形にはスケールしない
ARC の表は、最大 effort が常に最高スコアを生むわけではないことも示します。Provider Adapter では high effort が 99.9% に達し、max は 98.6%。Standard ハーネスでは max が最良です。
OpenAI は、ローンチ表の数値は概ね 最良の推論設定 に基づくと述べています。これは上限性能の推定には適していますが、最適な本番構成を特定するものではありません。複数の effort レベルを試し、追加の秒・ドルあたりの限界品質改善を計算すべきです。
数学と学術的推論
FrontierMath Tier 4 v2 は 83.0% から 97.6% へ、14.6 ポイントの上昇です。大きなベンチマーク改善ですが、フロンティア数学が解決された証拠ではありません。評価は選択的なタスク分布であり、問題選択、形式的証明検証、長期的な研究計画の進行、対立的な査読など、数学研究の全段階を測るものではありません。
GPQA Diamond は逆のパターンを示します。Astra 96.0%、Sol 94.6%、Fable 93.7%、Gemini 3.8 Flash 95.3%。モデルは天井付近に密集しています。Astra–Sol の 1.4 ポイント差を報告するのは正確ですが、それを広範な知能革命と呼ぶのは証拠を過大評価します。
クリティカル能力 + セーフガード
| サイバーセキュリティ評価 | Astra | Sol | 絶対差 |
|---|---|---|---|
| ExploitBench | 100.0% | 78.5% | +21.5 pp |
| ExploitGym | 42.4% | 30.3% | +12.1 pp |
| ExploitBench, June–August 2026 | 39.0% | 5.5% | +33.5 pp |
| SRE-Bench | 88.0% | 55.9% | +32.1 pp |
| SEC-Bench Pro | 85.4% | 79.1% | +6.3 pp |
OpenAI は、ExploitBench(2026 年 6–8 月)を直前 3 か月に開示された脆弱性から構成し、過去の露出が結果を水増しする可能性を下げました。Astra はこのセットで 39.0%、Sol は 5.5%。OpenAI は Astra が以前は未知だった 2 件のゼロデイ脆弱性を発見・悪用したと報告しています。これらの結果により、Astra は OpenAI 初の広範展開モデルとして「Critical」サイバーセキュリティ能力閾値に到達し、セーフガードとアクセス方針に直接的な影響が出ました。
天井近くのスコアの読み方
90% を超えるスコアは、中程度のスコアより慎重な言い回しが必要です。50% から 60% では 100 件中 10 件の追加解決です。95% から 96% では 100 件中 1 件の追加解決に過ぎませんが、残りのエラー数は 5 から 4 へと 20% 減少します。どちらも数学的には正しい表現ですが、見出しの印象は大きく異なります。
逆に、低スコアのベンチマークにも注意が必要です。18.1% から 41.4% は依然として信頼できる自律運用には遠いですが、成功ケースを倍以上にし、監督付きワークフローを一変させ得ます。絶対スコアは準備完了の程度を、改善幅は能力の変化速度を示します。本番判断には両方が必要です。
多面的比較
| 次元 | Astra | Sol | Fable | 意思決定のシグナル |
|---|---|---|---|---|
| 一般的学術推論 | 優秀; 多くで天井付近 | すぐ後ろ | 競合 | 小さな差は展開判断を単独では左右しにくい |
| ターミナル実行 | トップ層 | 世代間で大きな差 | 近い競合 | コーディングハーネス全体をテスト |
| コンピュータ操作 | 高い成功率と短い実行時間 | 遅く精度も低め | ローンチ表での十分な比較データなし | 1 時間あたりの成功数を測定 |
| 長文脈検索 | 100 万トークン近辺でも強い | 限界付近での劣化が大きい | 直接比較可能なデータが不足 | 本番形状の検索テストを使用 |
| 推論制御 | low から max | 別の effort エンベロープ | アダプティブ思考アプローチ | モデル名だけでなく設定をチューニング |
| サイバー能力 | 質的に高いリスク階層 | 公開結果は低め | ここでは比較なし | セーフガードとアクセス方針が重要 |
| トークン経済性 | 単価高; ときにトークン数は少ない | 単価低 | ワークロード依存 | 成功タスクあたりのコストを比較 |
結論はワークロード依存です。タスクがツールや環境と持続的に相互作用し、失敗からの回復や非常に大きな文脈での確実な再取得を要する場合、Astra は最も説得力があります。文脈が程々で反復も少ない限定的な作業では、Sol の方が経済的な場合もあります。Fable はターミナル作業で接戦であり、外部の学術評価の一部でリードしています。したがって、プロバイダー単位の結論よりも、アプリケーションレベルのベンチマークの方が有用です。
誰が GPT-6 Astra を使うべきか?
| ユースケース | 推奨 |
|---|---|
| シンプルな分類 | 必ずしも Astra を使う価値はない |
| シンプルな要約 | 必ずしも Astra を使う価値はない |
| 標準的な RAG | コストと性能をまずベンチマーク |
| 長文書の統合・分析 | Astra のテストを検討 |
| エージェント型コーディング | 強くテストを推奨 |
| コンピュータ操作 | 強くテストを推奨 |
| 多段自動化 | 強くテストを推奨 |
| 複雑なリサーチ | テストする価値あり |
| 科学計算 / 特化ソフト | テストする価値あり |
| サイバーセキュリティ | 強力な能力。ただし適切な安全制御が必要 |
| 高スループットで単純なタスク | 低コストモデルの方が費用対効果が高い場合あり |
GPT-6 Astra の性能向上は高価格に見合うか?
GPT-6 Astra は GPT-5.6 Sol より有意に高価ですが、ベンチマーク改善はワークロード全体で均一ではありません。したがって、トークンレートの比較だけでは価格の質問に答えられません。
| シナリオ | 性能向上 | コスト正当化 |
|---|---|---|
| シンプルな Q&A | 小幅 | 通常はプレミアムの価値は小さい |
| コーディングエージェント | 大幅 | プレミアムが正当化され得る |
| 長文脈分析 | かなり | 再取得ニーズに依存 |
| コンピュータ自動化 | 強力 | 多くの場合、テストする価値あり |
| 一般的な推論 | 限定的 | コストを慎重に比較 |
OpenAI Standard のレートでは、GPT-6 Astra は入力 $10/百万トークン、キャッシュ済み入力 $1/百万トークン、キャッシュ書き込み $12.50/百万トークン、出力 $50/百万トークンです。Standard の入力・出力は GPT-5.6 Sol の $4 と $20 の 2.5 倍です。272K 入力トークンを超えるリクエストでは、Astra の入力とキャッシュのレートが 2 倍、出力のレートが 1.5 倍に上がり、リクエスト全体に適用されます。
価格プレミアムは特にエージェント的作業と整合します。Terminal-Bench、AutomationBench、データベース移行、最長レンジ MRCR で 20 ポイント超の改善があり、独立検証でも Coding Agent Index で Sol の約 3 分の 1 のトークン使用が報告されています。広範な推論では一致は弱く、Intelligence Index はほぼ同点でトークン使用は約 10% 減にとどまります。購入判断は、出力、キャッシュ活動、ツール使用、経過時間、リトライ、失敗、人間の修正を含む、成功タスクあたりのコストで比較すべきです。
成功タスクあたりのコスト
成功タスクあたりのコスト = (Input cost + Output cost + Tool cost + Retry cost + Human review cost) / Successful tasks
想定ビジネスコスト
想定ビジネスコスト = API cost + Tool cost + Retry cost + Human-review cost + Failure cost
意思決定の指標は、許容品質閾値での成功タスク数で割った総コストであるべきで、百万トークンあたりの表示価格ではありません。
開発者は Astra をどうベンチマークすべきか
公開リーダーボードは「何を試すべきか」を決める材料であり、最終的な展開判断ではありません。日常ケース、難問、コンテキスト欠落、ツール故障、対立的指示を含む代表的なタスクセットを構築してください。すべてのモデルで同じ本番プロンプト、権限、ソースファイル、時間予算、完了基準を用いてください。
| 評価次元 | 測定指標 | 重要な理由 |
|---|---|---|
| タスク成功 | 受け入れ基準を満たしたか | 説得的だが不完全な回答が成功と採点されるのを防止 |
| 信頼性 | 繰り返し実行での成功分布 | 単発の偶然勝ちを露呈 |
| ツール実行 | 検証された成功アクション | ツール呼び出しと正しい成果を区別 |
| ファクト性 | 根拠のある事実主張 | 証拠の質と棄却判断を測定 |
| レイテンシ | 中央および尾部の完了時間 | 運用スループットを捕捉 |
| コスト | 成功タスクあたりの総コスト | リトライや失敗を含む |
| 人的労力 | 修正とレビューの分数 | 実運用コストで支配的になりがち |
| ステアラビリティ | 要件変更後の回復 | 長時間エージェント挙動をテスト |
CometAPI の Astra API は model ID gpt-6-astra を使用します。マルチモデル API により、同一の評価を Astra、Sol、Fable、Gemini で再設計なしに実行できます。要求の厳しいエージェント的タスクはプレミアムに見合うモデルへルーティングし、優位性が消える領域では低コストモデルを使ってください。
結論
Astra のベンチマークシートは印象的ですが、最も派手なスコアが自動的に最も有用とは限りません。ARC-AGI-3 はプロバイダー固有のエージェントハーネスの可能性を示し、Standard ハーネスのスコアはインフラがどれほど強く結果に寄与するかを示します。GPQA と独立 Intelligence Index は、一般的な推論の向上が穏やかな場合もあることを示します。ターミナル作業、自動化、コンピュータ操作、長文脈検索、科学的ワークフロー、サイバーセキュリティこそが、より重要な物語を語っています。
このリリースの本質は、チャットボットがあらゆる質問で比例的に賢くなることではなく、フロンティア知能が「仕事を完遂する」能力を高めたことにあります。そのアップグレードに支払う価値があるかは、モデル–システム構成全体と、成功した本番タスクの経済性に依存します。