
GLM-5.3 Flash API を最速で使う方法は、CometAPI の OpenAI 互換 chat-completions エンドポイント経由でモデルを呼び出すことです。接続情報は下の API 仕様表に集約されています。API キーはサーバー側に保持してください。
Answer first: CometAPI キーを作成し、OpenAI 互換 SDK を導入し、/v1/chat/completions へ POST を送る。まず基本リクエストが成功してから、ストリーミング・ビジョン・JSON 出力・ツールを段階的に追加する。
GLM-5.3 Flash API とは?
GLM-5.3 Flash は、GLM-5 ファミリーに属する Z.ai の効率重視のネイティブマルチモーダルモデルです。チャット API を通じて、推論、長文コンテキスト、画像理解、エージェント指向の機能を提供します。モデルは総 320B パラメータで、トークンごとに 18B をアクティベートします。このアーキテクチャはコスト面で重要ですが、開発者にとっては、長いプロンプトや繰り返しのツール呼び出しでもアクティブ状態を維持できるモデルとして体感されます。
このガイドでは、アーキテクチャやベンチマークの詳細説明はあえて簡潔に留めます。ハイブリッドアテンション設計、オープンウェイト、ローンチ時の完全なベンチマーク一覧、価格背景、ファミリー比較については、既存のモデル概要記事をご参照ください。ここでは統合時の挙動と本番運用の意思決定に焦点を当てます。
統合に影響する API 仕様
| API specification | Value | Practical meaning |
|---|---|---|
| Base URL | https://api.cometapi.com/v1 | サーバー側クライアントで一度設定して使い回します。 |
| Endpoint | POST /v1/chat/completions | OpenAI 互換の chat-completions ルートを使用します。 |
| Compatible SDKs | OpenAI-compatible Python and JavaScript clients | CometAPI の Base URL を指定して、慣れたクライアントパターンを再利用できます。 |
| Authentication | Bearer API key | API キーはサーバー側の環境変数またはシークレットマネージャに保持します。 |
| Model code | glm-5.3-flash | リクエストボディではこの値を正確に指定します。 |
| Context window | 1,048,576 tokens | 大規模リポジトリ、文書セット、長いエージェント履歴に適しています。 |
| Maximum output | Up to 131,072 tokens | アプリ固有の上限を低めに設定して、コストとレイテンシを制御します。 |
| Native inputs | Text, image, video, file | ホストされたルートでの対応は異なる場合があります。各モダリティを使う前に CometAPI の該当ルートを確認。 |
| Output | Text | モデルはメディアを解釈しますが、画像や動画の生成結果は直接返しません。 |
| Reasoning | low, high, max | レイテンシとトークン消費のトレードオフとして推論努力レベルを使い分けます。 |
| Thinking | Always enabled | Thinking を無効にしようとするパラメータは送らないでください。 |
| Developer features | Streaming, function calling, caching, structured output | 対話アプリ、エージェント、機械可読パイプラインに有用です。 |
モデル能力とゲートウェイ能力は同一ではありません。特に動画、ファイル、厳密な JSON Schema、プロバイダ固有の thinking フィールドは、実際に呼び出す CometAPI のライブモデルページと API スキーマを契約として扱ってください。
簡潔な性能コンテキスト
Z.ai のローンチ時レポートは、API ビルダーに重要なタスク(ターミナル作業、ソフトウェアエンジニアリング、ツール利用、自動化)で強い結果を示しています。これらは特定のハーネスとツールポリシーで取得されたベンダー報告のスコアであり、普遍的な順位付けを確立するものではなく、強みの当たりを付ける助けと捉えるべきです。
| Benchmark | GLM-5.3 Flash | What it suggests for API workloads |
|---|---|---|
| Terminal-Bench 2.1 | 84.3 | ターミナル駆動のコーディングエージェントに適性。 |
| DeepSWE v1.1 | 63.4 | リポジトリ規模のソフトウェアエンジニアリングに有望。 |
| Toolathlon Verified | 78.4 | 強力なツール選択・ツール利用シグナル。 |
| AutomationBench | 48.8 | 先代比での多段自動化の改善。 |
実務的な含意は表よりも狭いものです。GLM-5.3 Flash は、長いコンテキストとツールや視覚フィードバックを組み合わせるワークフローで強力な候補です。完全なモデル比較は、ここで繰り返すのではなく既存のモデル概要をご利用ください。
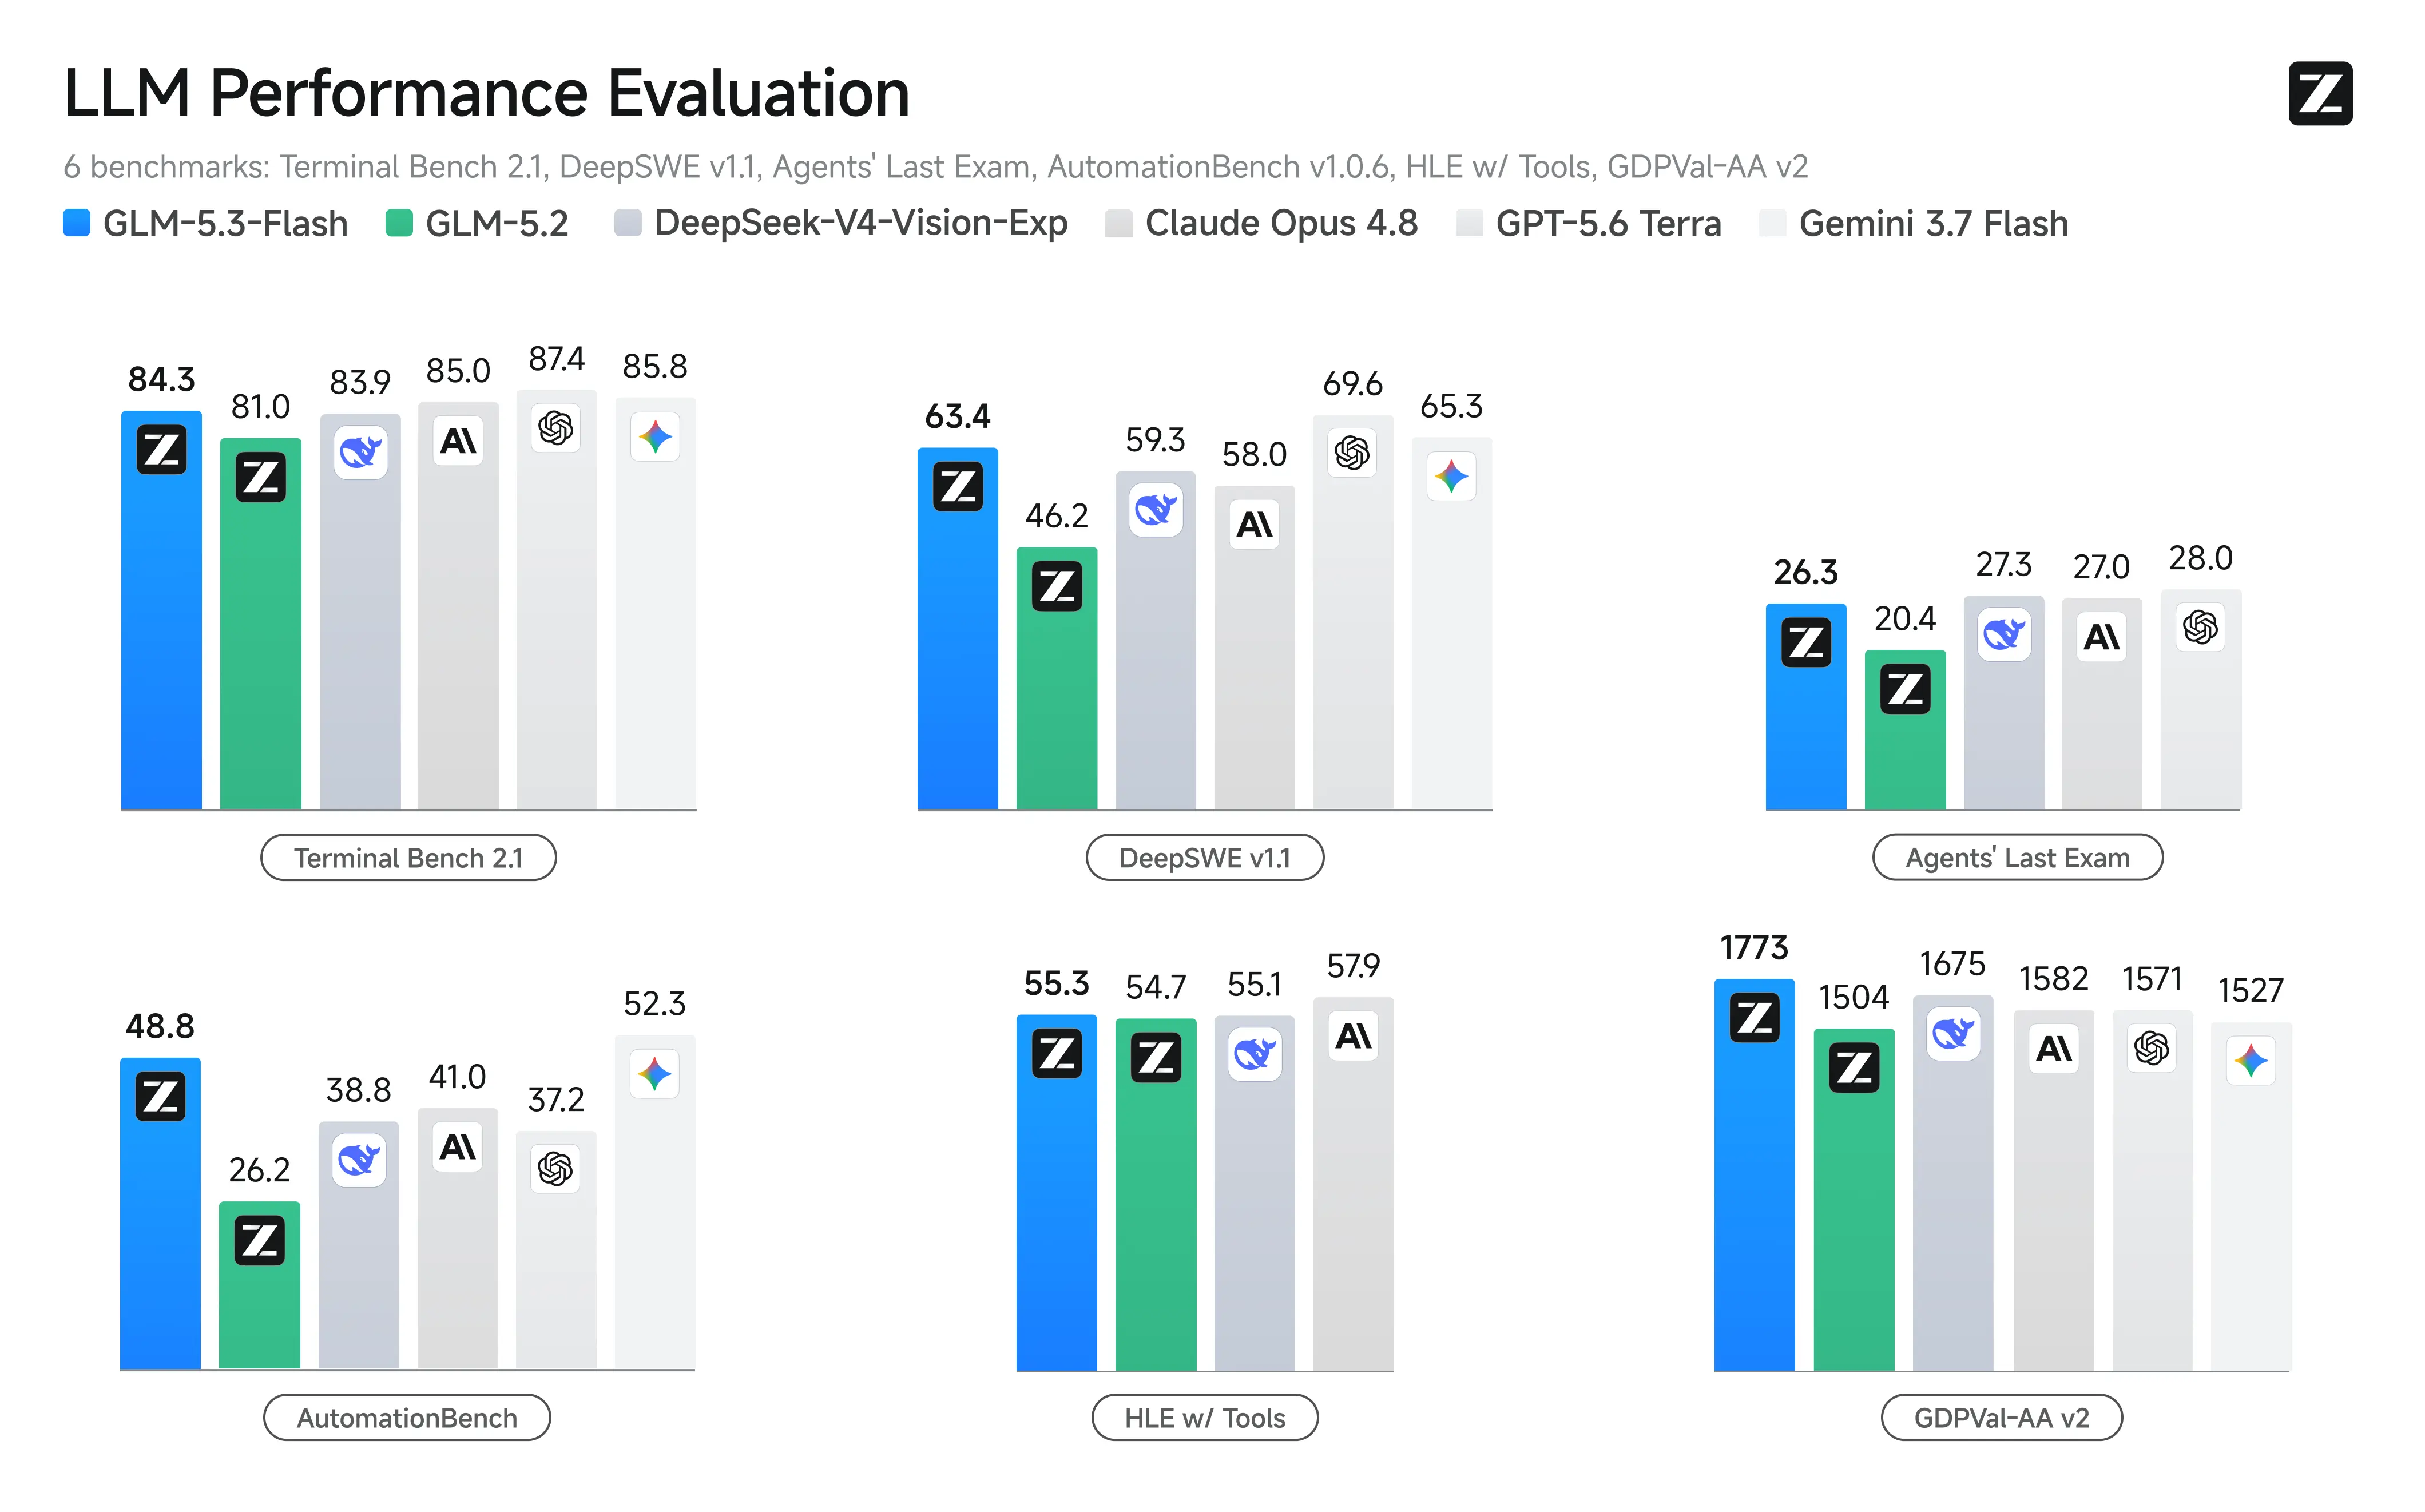
公式ベンチマークグラフィックは、モデルや努力設定ごとの GLM-5.3 Flash の性能を比較しています。本 API ガイドでは、完全なローンチ行列を再掲するのではなく、簡潔な性能コンテキストを提供します。アプリケーションは、実際のプロンプトでタスク成功率、エンドツーエンドのレイテンシ、総トークン使用量を計測してください。
なぜ CometAPI 経由で GLM-5.3 Flash を使うのか?
CometAPI は OpenAI 互換インターフェースで GLM-5.3 Flash を公開しています。これにより、慣れた SDK パターンを再利用し、認証情報と課金を一元化し、リクエスト層を作り直すことなくモデルを切り替えられます。
• 一つの統合パターン。モデル ID を変えるだけで同じベースクライアントから別モデルを呼び出せます。
• 使用状況の一元可視化。各プロバイダごとにダッシュボードを持たずに、チームで使用量とコストを確認できます。
• 評価が速い。単一のリクエストハーネスで候補モデル間の応答品質、レイテンシ、エラーを比較できます。
• フォールバック設計が簡単。アプリケーションのリトライやルーティングロジックを一つのゲートウェイ層に集約できます。
• 掲載ルート価格が低い。現在のモデルページは入力 100 万トークンあたり $0.06、出力 100 万トークンあたり $0.20を掲示。予算化前にライブページで要確認。
開始前の準備
CometAPI アカウント、API キー、そして以下のローカル環境のいずれかが必要です。
• Python 3.9 以降(pip 利用)
• Node.js 18 以降(npm 利用)
• 最小限のコマンドラインテスト用に cURL
本番環境の CometAPI キーを、ブラウザの JavaScript、モバイルアプリ、公開リポジトリ、スクリーンショット、クライアント側ログに置かないでください。信頼できるサーバーから CometAPI を呼び出し、キーは環境変数またはシークレットマネージャに保持します。
CometAPI で GLM-5.3 Flash API を使う方法
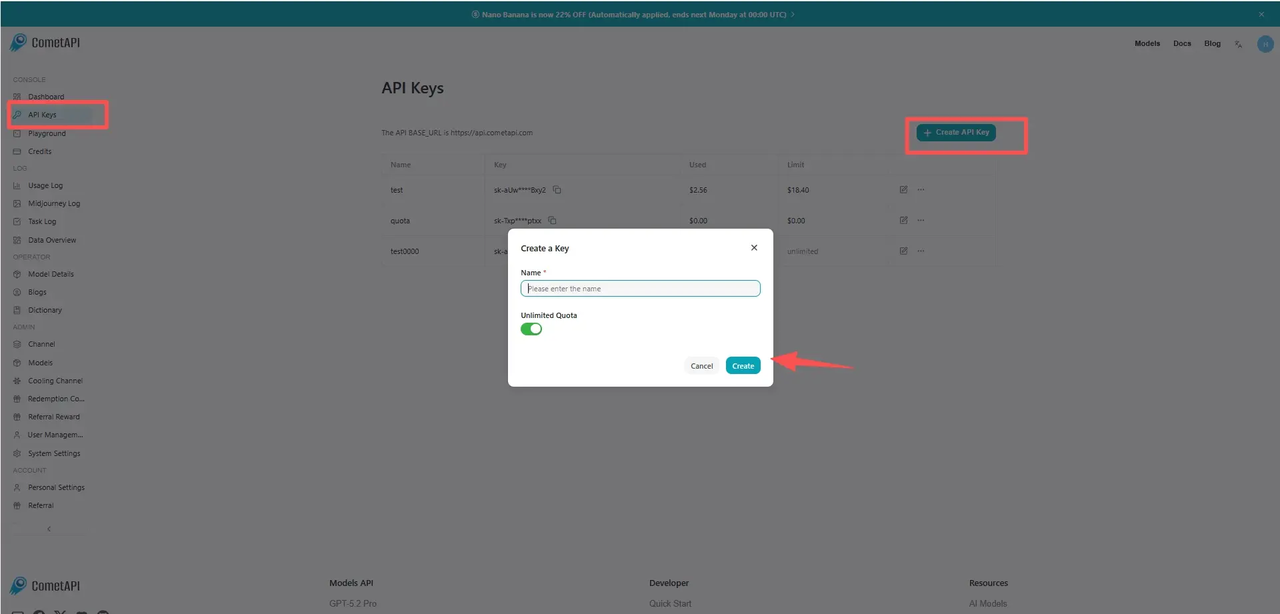
Step 1: CometAPI の API キーを作成
CometAPI にサインインし、API キーコンソールを開いてキーを作成し、シークレット管理ワークフローに一度だけコピーします。開発と本番で別々のキーを使い、片方だけをローテーションまたは失効できるようにします。
Step 2: キーを環境変数として保存
$env:COMETAPI_KEY = "your_cometapi_key_here"
export COMETAPI_KEY="your_cometapi_key_here"
本番では、シェル履歴ではなくデプロイ時のシークレット、コンテナのシークレット、または管理型ボールトを使用してください。

### Step 3: OpenAI 互換 SDK をインストール
python -m pip install --upgrade openai
npm install openai
```

### Step 4: まず cURL で最初のリクエストを送る

```
curl https://api.cometapi.com/v1/chat/completions \
  -H "Authorization: Bearer $COMETAPI_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "glm-5.3-flash",
    "messages": [
      {
        "role": "system",
        "content": "You are a precise technical assistant."
      },
      {
        "role": "user",
        "content": "Explain three practical uses of a one-million-token context window."
      }
    ],
    "max_completion_tokens": 800
  }'
```

成功レスポンスには、choices[0].message.content の下に assistant メッセージが含まれ、ルートが返す場合は usage メタデータも含まれます。オプションパラメータを追加する前に、この小さなリクエストから始めてください。

### Step 5: Python から API を呼び出す

```
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.environ["COMETAPI_KEY"],
    base_url="https://api.cometapi.com/v1",
    timeout=60.0,
    max_retries=2,
)

completion = client.chat.completions.create(
    model="glm-5.3-flash",
    messages=[
        {
            "role": "system",
            "content": "You are a precise technical assistant.",
        },
        {
            "role": "user",
            "content": "Review this migration plan and list the top five risks.",
        },
    ],
    max_completion_tokens=1200,
)

print(completion.choices[0].message.content)
print(completion.usage)
```

### Step 6: JavaScript から API を呼び出す

```
import OpenAI from "openai";

const client = new OpenAI({
  apiKey: process.env.COMETAPI_KEY,
  baseURL: "https://api.cometapi.com/v1",
  timeout: 60_000,
  maxRetries: 2,
});

const completion = await client.chat.completions.create({
  model: "glm-5.3-flash",
  messages: [
    { role: "system", content: "You are a precise technical assistant." },
    { role: "user", content: "Draft a safe rollout checklist for this API." },
  ],
  max_completion_tokens: 1200,
});

console.log(completion.choices[0].message.content);
console.log(completion.usage);
```

## 推論努力の制御方法

[公式モデルドキュメント](https://docs.z.ai/guides/vlm/glm-5.3-flash)は、[low・high・max の推論努力レベル](https://docs.z.ai/guides/vlm/glm-5.3-flash)をサポートしています。[Thinking は常に有効](https://docs.z.ai/guides/vlm/glm-5.3-flash)で、努力設定はモデルが使える推論予算を変えます。

| Effort | Good starting workloads                             | Trade-off                                           |
| ------ | --------------------------------------------------- | --------------------------------------------------- |
| low    | 分類、リライト、短い抽出                            | レイテンシと出力トークンが小さく、深さは控えめ。     |
| high   | コードレビュー、計画、文書分析                      | 多くの本番タスクでバランスが良いデフォルト。        |
| max    | 複雑なデバッグ、ツールエージェント、困難な推論      | 深さ最大。ただしレイテンシとコストが増える可能性。   |

```
completion = client.chat.completions.create(
    model="glm-5.3-flash",
    messages=[
        {
            "role": "user",
            "content": "Find hidden failure modes in this distributed rollout plan.",
        }
    ],
    max_completion_tokens=1800,
    extra_body={"reasoning_effort": "high"},
)

print(completion.choices[0].message.content)
```

インストール済み SDK が reasoning_effort を第一級引数として公開している場合は、直接渡して構いません。CometAPI ルートがプロバイダ固有フィールドを拒否する場合は削除し、ルートのデフォルトを使用してください。Thinking を無効化しようとしないでください。

## レスポンスをストリーミングする方法

ストリーミングは、チャット、コーディングアシスタント、長い分析に有用で、到着した順に出力を表示できます。生成トークン総数は減らないため、出力上限やコスト制御は同じように維持してください。

### Python ストリーミング

**Python**

```
stream = client.chat.completions.create(
    model="glm-5.3-flash",
    messages=[
        {"role": "user", "content": "Create a staged database migration plan."}
    ],
    max_completion_tokens:1600,
    stream=True,
)

for chunk in stream:
    delta = chunk.choices[0].delta
    if delta.content:
        print(delta.content, end="", flush=True)
print()
```

### JavaScript ストリーミング

**JavaScript**

```
const stream = await client.chat.completions.create({
  model: "glm-5.3-flash",
  messages: [
    { role: "user", content: "Create a staged database migration plan." },
  ],
  max_completion_tokens: 1600,
  stream: true,
});

for await (const chunk of stream) {
  const text = chunk.choices[0]?.delta?.content ?? "";
  process.stdout.write(text);
}
```

• キャンセルを扱う。クライアントが切断したらストリームの読み取りを停止し、対応して上流の処理をキャンセルします。

• 安全にバッファする。各チャンクが完全な単語、JSON トークン、あるいはツール呼び出しオブジェクトを必ず含むとは限りません。

• 最終的な使用量を記録する。使用量は最後のイベントやルート固有のメタデータでのみ提供される場合があります。

## 画像を送る方法

[GLM-5.3 Flash](https://www.cometapi.com/models/zhipuai/glm-5-3-flash/) は、messages[].content[] 内の image_url ブロックを通じて視覚コンテンツを受け付けます。公式ドキュメントは、到達可能な画像 URL または Base64 Data URL を推奨しています。CometAPI のモデルページは画像からテキストへの機能を示していますが、フォーマット、ファイルサイズ、ルート挙動は本番前にテストしてください。

### 画像 URL を分析する

**Python**

```
completion = client.chat.completions.create(
    model="glm-5.3-flash",
    messages=[
        {
            "role": "user",
            "content": [
                {
                    "type": "image_url",
                    "image_url": {
                        "url": "https://example.com/dashboard.png"
                    },
                },
                {
                    "type": "text",
                    "text": (
                        "Review this dashboard. Identify usability issues, "
                        "ambiguous metrics, and possible data-quality risks."
                    ),
                },
            ],
        }
    ],
    max_completion_tokens=1500,
)

print(completion.choices[0].message.content)
```

### ローカル画像を Base64 で送る

**Python**

```
import base64
import mimetypes
from pathlib import Path

image_path = Path("dashboard.png")
mime_type = mimetypes.guess_type(image_path.name)[0] or "image/png"
encoded = base64.b64encode(image_path.read_bytes()).decode("utf-8")

completion = client.chat.completions.create(
    model="glm-5.3-flash",
    messages=[
        {
            "role": "user",
            "content": [
                {
                    "type": "image_url",
                    "image_url": {
                        "url": f"data:{mime_type};base64,{encoded}"
                    },
                },
                {
                    "type": "text",
                    "text": "Extract the chart title, axes, and main trend.",
                },
            ],
        }
    ],
    max_completion_tokens=1000,
)

print(completion.choices[0].message.content)
```

• エンコード前に無関係な余白をトリミングします。

• 確認したい情報に比べて極端に大きい画像はダウンサンプルします。

• 一般的な説明ではなく、具体的な視覚タスクを質問します。

• 公開ウェブページの URL が直接の画像 URL であると仮定しないでください。

• 複数画像の順序をテストし、各画像がプロンプトで明確に参照されるようにします。

## 構造化 JSON を要求する方法

次のコンポーネントが人ではなくコードの場合、構造化出力は有用です。スキーマは狭く保ち、結果を検証し、ルートが厳密な JSON Schema を同じ形で公開しない場合に備えたフォールバックを用意してください。

**Python**

```
import json

completion = client.chat.completions.create(
    model="glm-5.3-flash",
    messages=[
        {
            "role": "system",
            "content": "Return valid JSON only.",
        },
        {
            "role": "user",
            "content": (
                "Extract equipment, severity, observed symptom, and next action "
                "from this report: Feeder 12 showed repeated zero-sequence current "
                "spikes after rain; inspect insulation and compare adjacent sections."
            ),
        },
    ],
    response_format={"type": "json_object"},
    max_completion_tokens=800,
)

data = json.loads(completion.choices[0].message.content)
required = {"equipment", "severity", "symptom", "next_action"}
missing = required.difference(data)
if missing:
    raise ValueError(f"Missing fields: {sorted(missing)}")

print(data)
```

JSON モードが検証の必要性を取り除くわけではありません。保存や他システムのトリガー前に、必須項目、型、許容値、最大長を確認してください。

## Function Calling の使い方

Function calling により、モデルは外部データが必要なタイミングを判断できますが、認可と実行はアプリケーションコードの責任です。安全なパターンは、モデルがツール呼び出しを提案し、サーバーが検証し、サーバーがツールを実行し、その結果をモデルに渡す流れです。

**Python**

```
import json

completion = client.chat.completions.create(
    model="glm-5.3-flash",
    messages=[
        {
            "role": "system",
            "content": "Return valid JSON only.",
        },
        {
            "role": "user",
            "content": (
                "Extract equipment, severity, observed symptom, and next action "
                "from this report: Feeder 12 showed repeated zero-sequence current "
                "spikes after rain; inspect insulation and compare adjacent sections."
            ),
        },
    ],
    response_format={"type": "json_object"},
    max_completion_tokens=800,
)

data = json.loads(completion.choices[0].message.content)
required = {"equipment", "severity", "symptom", "next_action"}
missing = required.difference(data)
if missing:
    raise ValueError(f"Missing fields: {sorted(missing)}")

print(data)
```

• 引数を検証する。ツール呼び出しの JSON は信頼できない入力として扱います。

• 認可を強制する。現在のユーザーに許可された操作をモデルが決めるわけではありません。

• 読み取りと書き込みツールを分離する。破壊的または外部に可視な操作には確認を要求します。

• ツールの在庫を絞る。現在のワークフローに関連するツールのみを公開します。

• ループに上限をかける。ツール往復回数、総トークン、経過時間、コストを制限します。

## [GLM-5.3 Flash](https://www.cometapi.com/models/zhipuai/glm-5-3-flash/) の API パラメータ

| Parameter               | Purpose                           | Practical guidance                                     |
| ----------------------- | --------------------------------- | ------------------------------------------------------ |
| model                   | モデルルートの選択                | glm-5.3-flash を使用。                                 |
| messages                | 会話およびマルチモーダル入力      | role の順序を守り、必要なツールメッセージを保持。      |
| max\_completion\_tokens | 生成出力の上限                    | モデル最大値に頼らず、ワークフロー別に設定。           |
| temperature             | サンプリング挙動                  | 公式推奨は 1。                                         |
| top\_p                  | ニュークリアスサンプリング        | 公式推奨は 0.95。                                      |
| reasoning\_effort       | 推論予算                          | low/high/max を使用。ルートでのサポートを要確認。      |
| stream                  | インクリメンタル出力              | インタラクティブ応答には true。                        |
| tools                   | 関数定義                          | スキーマは狭く保ち、各呼び出しを検証。                 |
| tool\_choice            | ツール選択の制御                  | ワークフローで必須でない限り auto から開始。           |
| response\_format        | 機械可読出力の要求                | サポートと返却 JSON の検証を実施。                     |

## Z.ai 直 API と CometAPI の比較

どちらのルートも適切になり得ます。判断は主に統合の主体、モデルの幅、課金、プロバイダネイティブ機能をどれだけ早く必要とするかに依存します。

| Dimension       | Z.ai Direct API                               | CometAPI                                           | Practical result                                                 |
| --------------- | --------------------------------------------- | -------------------------------------------------- | ---------------------------------------------------------------- |
| Account and key | Z.ai のアカウントとキー                        | CometAPI のアカウントとキー                        | キーは相互互換ではありません。                                   |
| SDK pattern     | OpenAI 互換                                    | OpenAI 互換                                        | 多くのクライアントコードを再利用可能。                           |
| Model coverage  | Z.ai モデルファミリー                          | 複数プロバイダとモデルファミリー                    | CometAPI はルーティングと比較に有用。                           |
| Native features | プロバイダ固有機能に最速でアクセス             | ゲートウェイの公開とパススルーに依存                | 高度なフィールドは選択ルート上でテスト。                         |
| Billing         | プロバイダ個別                                 | サポート対象モデル全体で一元化                      | 複数モデル運用の課金を統一できる。                               |
| Fallback design | 別プロバイダ統合が必要                         | 一つのゲートウェイ層内に留められる                  | CometAPI は切替の摩擦を軽減。                                   |
| Best fit        | Z.ai ネイティブ機能に深くコミット              | 統一アクセス、評価、本番ルーティング                 | 汎用の勝ち負けではなく、システム構成に基づいて選択。             |

最新のプロバイダネイティブなパラメータや製品機能が不可欠なら直 API。単一クライアント、統一課金、モデル比較や置換の容易さが重要なら CometAPI。本番では、実際にデプロイ予定のルートに対して同じ代表的テストスイートを実行してください。

## コスト見積とトークン予算

現在の [CometAPI モデルページ](https://www.cometapi.com/models/zhipuai/glm-5-3-flash/)は、[入力 100 万トークンあたり $0.06](https://www.cometapi.com/models/zhipuai/glm-5-3-flash/)、[出力 100 万トークンあたり $0.20](https://www.cometapi.com/models/zhipuai/glm-5-3-flash/)を掲示しています。これらの単価におけるリクエストコストの推定は次式です:

cost \= input\_tokens / 1,000,000 x 0.06 + output\_tokens / 1,000,000 x 0.20

| Workload                | Input tokens | Output tokens | Estimated cost |
| ----------------------- | ------------ | ------------- | -------------- |
| Short question          | 2,000        | 400           | $0.00020       |
| Code review             | 50,000       | 4,000         | $0.00380       |
| Large document analysis | 250,000      | 10,000        | $0.01700       |
| Long agent run          | 800,000      | 30,000        | $0.05400       |

価格は変動します。公開や本番予算化の前に、ライブの入力、キャッシュ入力、出力レートを確認してください。推論やツールループは、課金対象の出力や繰り返し入力を増やす可能性があるため、見える一回の回答ではなく、ワークフロー全体で見積もってください。

## GLM-5.3 Flash API 本番運用のベストプラクティス

### コストとレイテンシの制御

#### 出力上限

ベンチマークの生成設定と本番 API の制限は異なります。引用された HLE 評価は最大生成長 163,840 トークンを使用し、他の評価は 64K 出力を使用しました。これは、すべてのホスト API ルートが 100,000 トークン超を返せることの証明にはなりません。ライブのルートスキーマとワークフロー予算から上限を設定してください。分類や抽出には小さな上限、分析には中程度、長文やエージェントタスクにのみ大きめの上限を使います。

**コンテキスト管理**

100 万トークンのウィンドウは容量であり、目標ではありません。関連ファイルを取得し、重複したログを除去し、安定した指示は冒頭付近に配置し、追加コンテキストがタスク成功に寄与するかを測定してください。

### 状態と信頼性

#### 状態を保持する

次ターンで必要となるツール呼び出しやルート固有フィールドを含む assistant メッセージを完全に保存します。見えるテキストが完全に見えても、構造化履歴が失われると多段ツールループが壊れることがあります。

#### 選択的にリトライ

• 一時的な 429、500、502、503、ネットワークタイムアウトは指数バックオフとジッタで再試行。

• 認証エラー、無効パラメータ、サイズ超過は闇雲に再試行しない。

• 重複作業を認識できるようアプリケーションリクエスト ID を付与。

• モデルリクエスト自体を再試行しても、外部の書き込み操作には冪等性制御を適用。

### セーフティと検証

#### 機械可読出力の検証

スキーマ検証、許容値チェック、長さ制限、ドメインルールを、モデルとあらゆる DB/キュー/外部 API の間に置きます。構文的に正しい JSON オブジェクトでも不完全または安全でない場合があります。

#### ツール呼び出しの認可

モデルが提案するツール呼び出しは信頼できない要求として扱います。引数検証、ユーザー認可の強制、読み取りと書き込みの分離、破壊的操作の確認要求を実施してください。

### 可観測性とフォールバック

#### ワークフローを計測

• タスク成功率または人による受容率

• 最初のトークンまでの時間と総レイテンシ

• 入力・キャッシュ入力・推論・出力トークン

• ツール呼び出し回数とツール失敗率

• リトライ、レート制限、プロバイダエラー

• 単一 API 呼び出しあたりのコストではなく、完了したワークフローあたりのコスト

#### フォールバックを設計

評判ではなくワークロードでフォールバックを選びます。文書抽出にはテキスト専用フォールバックで十分でも、スクリーンショットベースのタスクには失敗することがあります。どの入力やツールスキーマがポータブルか、除去すべきパラメータは何か、挙動を維持できない場合は自動切替ではなくユーザーに回復可能なエラーを見せるべきタイミングを定義してください。

## よくあるエラーとトラブルシューティング

| Symptom                 | Likely cause                                                       | What to check                                                                |
| ----------------------- | ------------------------------------------------------------------ | ---------------------------------------------------------------------------- |
| 401 Unauthorized        | キーが不足、不正、または失効                                        | Authorization ヘッダとサーバー側の環境変数を確認。                           |
| 404 or model not found  | モデル ID の誤りまたはルートが利用不可                             | glm-5.3-flash を使用し、ライブモデルページで提供状況を確認。                 |
| 429 Rate Limit          | リクエストまたはトークンのクォータ超過                              | バックオフ、同時実行の低減、アカウント制限の確認、ジッタ付きリトライ。       |
| Unsupported parameter   | ゲートウェイが公開していないプロバイダ固有フィールド               | オプションフィールドを外し、1 つずつ戻して確認。                             |
| Context length exceeded | プロンプト+要求出力がルート上限を超過                              | 取得・要約・トリミング、または max\_completion\_tokens を下げる。             |
| Invalid image           | URL 到達不可、未サポート形式、Base64 不正                           | 直接の HTTPS 画像 URL をテストし、MIME プレフィクスを修正。                   |
| Broken streamed JSON    | チャンクを完全なオブジェクトとしてパースしてしまった               | ストリームをバッファし、完全な JSON ペイロード到着後にのみパース。           |
| Tool loop never ends    | ステップ予算なし、またはツール結果が曖昧                             | ラウンド回数に上限、ツール説明の改善、明確なツールエラーの返却。              |

## いつ GLM-5.3 Flash API を使うべきか?

### 適したケース

• リポジトリ規模のコード理解と複数ファイルのレビュー

• ビジュアルコーディング、スクリーンショット分析、UI 品質検証

• 長い文書セットと証拠に基づく統合的サマリ

• 計画と検証を繰り返すツール利用型エージェント

• トークンコストが単位経済に効く高ボリュームのワークフロー

• 一つのゲートウェイでモデルの切替や比較の利点があるアプリケーション

### 他ルートや別モデルを使うべき場合

• 出力として画像や動画が必要(テキスト出力では足りない)。

• 小規模・低リスクの分類タスクで、より小さなモデルで十分に安定する。

• 必須のプロバイダネイティブ機能がゲートウェイルートで公開されていない。

• Thinking が常時有効であることや、そのレイテンシ特性を許容できない。

• 自前のツール、データ、失敗ケースでの検証が未実施。

## FAQ

###

### 本番前に、CometAPI のどの点を該当ルートで検証すべきですか?

モデルの提供状況、受け付けるマルチモーダル形式、最大出力、推論関連フィールド、構造化出力の挙動、レート制限、最新価格を、代表的なリクエストで検証してください。

### 本番評価で追跡すべき指標は?

タスク成功率、最初のトークンまでの時間、総レイテンシ、入力と出力トークン、ツール呼び出し失敗、リトライ率、完了したワークフローあたりのコスト(単一 API 呼び出しあたりのコストだけではない)を追跡します。

### Z.ai 直と CometAPI はどう選ぶべき?

プロバイダネイティブ挙動への即時アクセスが不可欠なら Z.ai 直。認証・課金の統一、モデル比較、ゲートウェイレベルのフォールバックが重要なら CometAPI を選びます。

### 安全なフォールバックとは?

同一の入力モダリティを受け付け、必要なツールスキーマを保持し、未対応パラメータを除去し、タスクの認可境界内に留まり、挙動を維持できない場合は自動切替ではなく可視的な失敗を返すフォールバックです。

## 結論

[GLM-5.3 Flash](https://www.cometapi.com/models/zhipuai/glm-5-3-flash/) は、長大なコンテキスト、視覚入力、推論、ツール利用を 1 つのワークフローに組み合わせる場合に、API 経由で最も有用です。基本的な CometAPI 統合は小さく、サーバー側キー 1 つ、OpenAI 互換クライアント 1 つ、[glm-5.3-flash](https://www.cometapi.com/models/zhipuai/glm-5-3-flash/) のモデル ID、chat-completions エンドポイントだけです。本番品質は、そのリクエストの周辺にあるもの(範囲を絞ったプロンプト、出力上限、スキーマ検証、ツール認可、リトライ、可観測性、ワークロード特有の評価)から生まれます。

短いテキスト呼び出しから始め、先進機能は 1 つずつ追加し、スケール前にユーザー体験全体をテストしてください。最新の提供状況、サポートされるルート挙動、価格は、ライブの [GLM-5.3 Flash モデルページ](https://www.cometapi.com/models/zhipuai/glm-5-3-flash/)で確認してください。

## SEO Metadata

Meta title: GLM-5.3 Flash API の使い方: 開発者ガイド

Meta description: CometAPI で GLM-5.3 Flash API を使う方法を解説。Python/JavaScript の例、ビジョン、ストリーミング、ツール、JSON 出力、ベストプラクティスを網羅。

Keywords: GLM-5.3 Flash API, how to use GLM-5.3 Flash, GLM-5.3 Flash Python, GLM-5.3 Flash JavaScript, GLM-5.3 Flash CometAPI, GLM API tutorial, multimodal API, reasoning API, function calling

URL slug: how-to-use-glm-5-3-flash-api