
TLDR: DeepSeek-V4.1-Flash-1017은 2026년 10월 17일에 공개된 V4.1-Flash 모델의 소규모이지만 매우 영향력 있는 업데이트입니다. 추론, 코딩, 에이전트, 비전 벤치마크 전반에서 더 강한 성능을 제공하면서 출력은 더 짧게, 작업 완료는 더 빠르게 수행하여 성능-비용 파레토 프런티어를 전진시킵니다.
Key Takeaways
- DeepSeek-V4.1-Flash-1017 2026년 10월 17일 출시. 기존
deepseek-flashAPI 엔드포인트에 대한 무료 업그레이드로 제공되며, 기존 사용자에게 코드 변경은 필요 없습니다. - 9월 V4.1-Flash 대비 공급업체 보고 기준 모든 11 listed benchmarks vs. the September V4.1-Flash, 중 에이전트 및 코딩 작업에서 가장 큰 향상.
- 아키텍처: Causal Encoder-Decoder 설계의 552B 파라미터 Mixture-of-Experts(입력/프리필 시 활성 파라미터 ≈8B, 디코드/출력 시 16B); 100만 토큰 컨텍스트 윈도우; 최대 384K 출력 토큰; 네이티브 비전 지원.
- 가격 변동 없음: 오프피크 입력(캐시 미스)/출력 각각 100만 토큰당 $0.15 / $0.60(피크 시간에는 2배); 캐시 히트 시 최저 $0.003. CometAPI는 공식 요금 대비 20% 할인.
- 모든 개발자에게 개방된 새로운 Search & Fetch API(1,000회당 $0.75; 2026년 10월 31일까지 일부 서버사이드 도구를 통해 무료).
- 엔드투엔드 프로젝트 생성(게임, 3D 씬, 전체 리포지토리)에 강한 “wish-driven programming” 역량. 대형 폐쇄형 모델 대비 에이전트/코딩 벤치마크에서 경쟁력이 있으며, 많은 프로덕션 워크로드에서 훨씬 저렴하고 빠름.
- Open-source MIT weights on Hugging Face 와 ModelScope를 통해 자체 호스팅 및 파인튜닝 가능.
- 프로덕션 사용 시 CometAPI 같은 플랫폼을 통해 500개 이상의 다른 모델과 함께 DeepSeek 모델에 OpenAI 호환 방식으로 접근할 수 있어, 경쟁력 있는 가격과 간편한 전환이 가능합니다.
DeepSeek는 효율적이면서도 고성능인 오픈 AI 모델의 경계를 계속 넓히고 있습니다. 2026년 10월 17일, 회사는 V4.1-Flash 모델(최초 출시일: 2026년 9월 10일)의 타겟 업데이트인 DeepSeek-V4.1-Flash-1017을 공개했습니다. 추론, 코딩, 에이전트 능력, 시각 이해에서 상당한 향상을 제공하는 동시에 작업 시간과 출력 길이를 줄였다고 홍보되는 이 체크포인트는, 실제 에이전트 및 코딩 워크로드에서 DeepSeek의 가장 강력한 효율형 모델로 자리매김합니다.
이 모델은 DeepSeek 웹사이트, 모바일 앱, 그리고 API(모델 이름은 그대로 deepseek-flash) 전반에서 라이브로 제공됩니다. 가중치는 MIT 라이선스로 공개되어, 프런티어 수준의 에이전트 성능을 프런티어 수준의 비용 없이 원하는 개발자에게 가장 강력한 오픈 웨이트 옵션 중 하나입니다.
What Exactly Is DeepSeek V4.1-Flash-1017?
DeepSeek-V4.1-Flash-1017은 V4.1-Flash 패밀리의 날짜형 체크포인트(“1017”은 10월 17일 릴리스를 의미)입니다. DeepSeek는 이를 “소규모 업데이트”로 설명하지만, 향상 범위는 넓고 의미가 큽니다. 모든 보고된 벤치마크 범주에서 더 높은 점수, 더 빠른 작업 완료, 더 짧은 출력이 이를 입증합니다. 회사는 이를 진정한 파레토 개선—성능과 비용 효율을 동시에 개선—으로 묘사합니다.
이 모델은 V4.1-Flash에서 도입된 혁신적 아키텍처를 계승합니다.
- 총 552B 백본 파라미터의 Mixture-of-Experts 설계(일부 보고서에는 추가 Engram 파라미터 포함). 입력/프리필 처리 중 토큰당 약 ~8B, 디코드/출력 생성 중 약 ~16B 파라미터만 활성화하는 새로운 Causal Encoder-Decoder 아키텍처.
- 고도로 압축된 KV 캐시(이전 세대 대비 HBM 1/4, SSD 1/8 수준으로 저장 요구량 감소 주장)로, 장문맥 및 다회전 에이전트 상호작용 비용을 크게 낮춤.
- 네이티브 멀티모달 지원(텍스트 + 이미지 입력 → 텍스트 출력). 100만 토큰 컨텍스트 윈도우 및 최대 384K 토큰 출력(권장 샘플링은 종종 ≥256K 최대 토큰 사용).
- 생각 모드/비-생각 모드, 도구 호출, JSON 출력, 조절 가능한 추론 노력 지원.
모델은 엔드투엔드 프로젝트 개발 개선을 목표로 하는 자기 피드백 루프를 포함한 강화학습 기법으로 강화되어 학습되었습니다. 이를 통해 고수준 자연어 목표를 웹 게임, 3D 씬, 전체 코드 리포지토리 같은 완전하고 기능적인 프로젝트로 전환하는 보다 신뢰할 수 있는 “wish-driven programming”이 가능해졌습니다.
애플리케이션 개발자 관점에서는 평가 기준이 달라집니다. 모델이 그럴듯한 함수를 만들 수 있는지 확인하는 대신, 기존 코드베이스를 이해하고, 일관된 수정을 수행하며, 검사를 실행하고, 오류를 수정할 수 있는지를 테스트하십시오. 설득력 있는 데모는 검증할 가치가 있는 능력을 보여줄 수 있지만, 임의의 리포지토리 전반에서의 신뢰성을 입증하지는 않습니다.
이번 업데이트는 또한 출력 효율을 답변 품질과 별도로 측정할 가치가 있게 만듭니다. 응답이 더 짧아지면 생성 비용이 줄 수 있지만, 과제에 필요한 구현, 설명, 증거를 유지하는 경우에만 그렇습니다. 유용한 검증을 제거한다면 토큰 비용이 줄더라도 오히려 퇴보입니다.
DeepSeek V4.1-Flash-1017 API Specifications
| Specification | DeepSeek V4.1-Flash-1017 |
|---|---|
| Native API identifier | deepseek-flash |
| Context window | 1M tokens |
| Maximum output | 384K tokens |
| Input support | Text and images |
| Reasoning modes | Thinking and non-thinking |
| Developer features | Tool calls, JSON output, Responses API |
| Architecture | Causal Encoder–Decoder MoE |
| Announced family parameter count | 552B |
| Active parameters | 8B for input; 16B for output |
How Does DeepSeek V4.1-Flash-1017 Perform in Benchmarks?
독립 초기 테스트(예: DeepSeek V4 Pro와의 나란한 비교)에서는, 1017이 실무 과제에서 유사한 품질을 보이면서도 훨씬 빠르고 저렴하며, 일부 구성에서 Pro가 갖추지 못했던 비전 지원을 추가한 것으로 나타났습니다.
선별된 공급업체 보고 결과는 9월 릴리스와 10월 17일 업데이트를 비교한 것입니다.
| Official benchmark results | September release | October 17 update | Absolute score change (points) |
|---|---|---|---|
| HLE without tools | 36.8 | 42.6 | +5.8 |
| Terminal-Bench 4.0 | 31.2 | 42.3 | +11.1 |
| DeepSWE v1.1 | 74.2 | 77.0 | +2.8 |
| ProgramBench | 20.3 | 29.1 | +8.8 |
| NL2Repo-Bench | 65.4 | 68.2 | +2.8 |
| Automation-Bench v1.0.6 | 54.8 | 60.5 | +5.7 |
| Agents’ Last Exam | 31.8 | 35.4 | +3.6 |
| Apex Bench v1.1 | 64.6 | 72.1 | +7.5 |
| Chartography with tools | 78.9 | 83.0 | +4.1 |
이는 공급업체가 보고한 결과로, 독립적 재현은 아닙니다. DeepSeek는 Terminal-Bench 4.0에는 Claude Code를, DeepSWE v1.1에는 Mini-SWE-V2를 사용했습니다. HLE는 도구 없이 실행한 결과이며, 별도로 표기된 텍스트 전용 하위 점수 대신 메인 점수를 사용했습니다. Chartography는 도구를 사용했습니다. 인용된 릴리스 표는 다른 모든 벤치마크에 대해 완전한 행별 구성을 제공하지 않으므로, 동등한 추론 예산, 하드웨어, 정지 조건을 가정할 수 없습니다. 위 변화량은 상대적 퍼센트가 아닌 단순 점수 차이입니다.
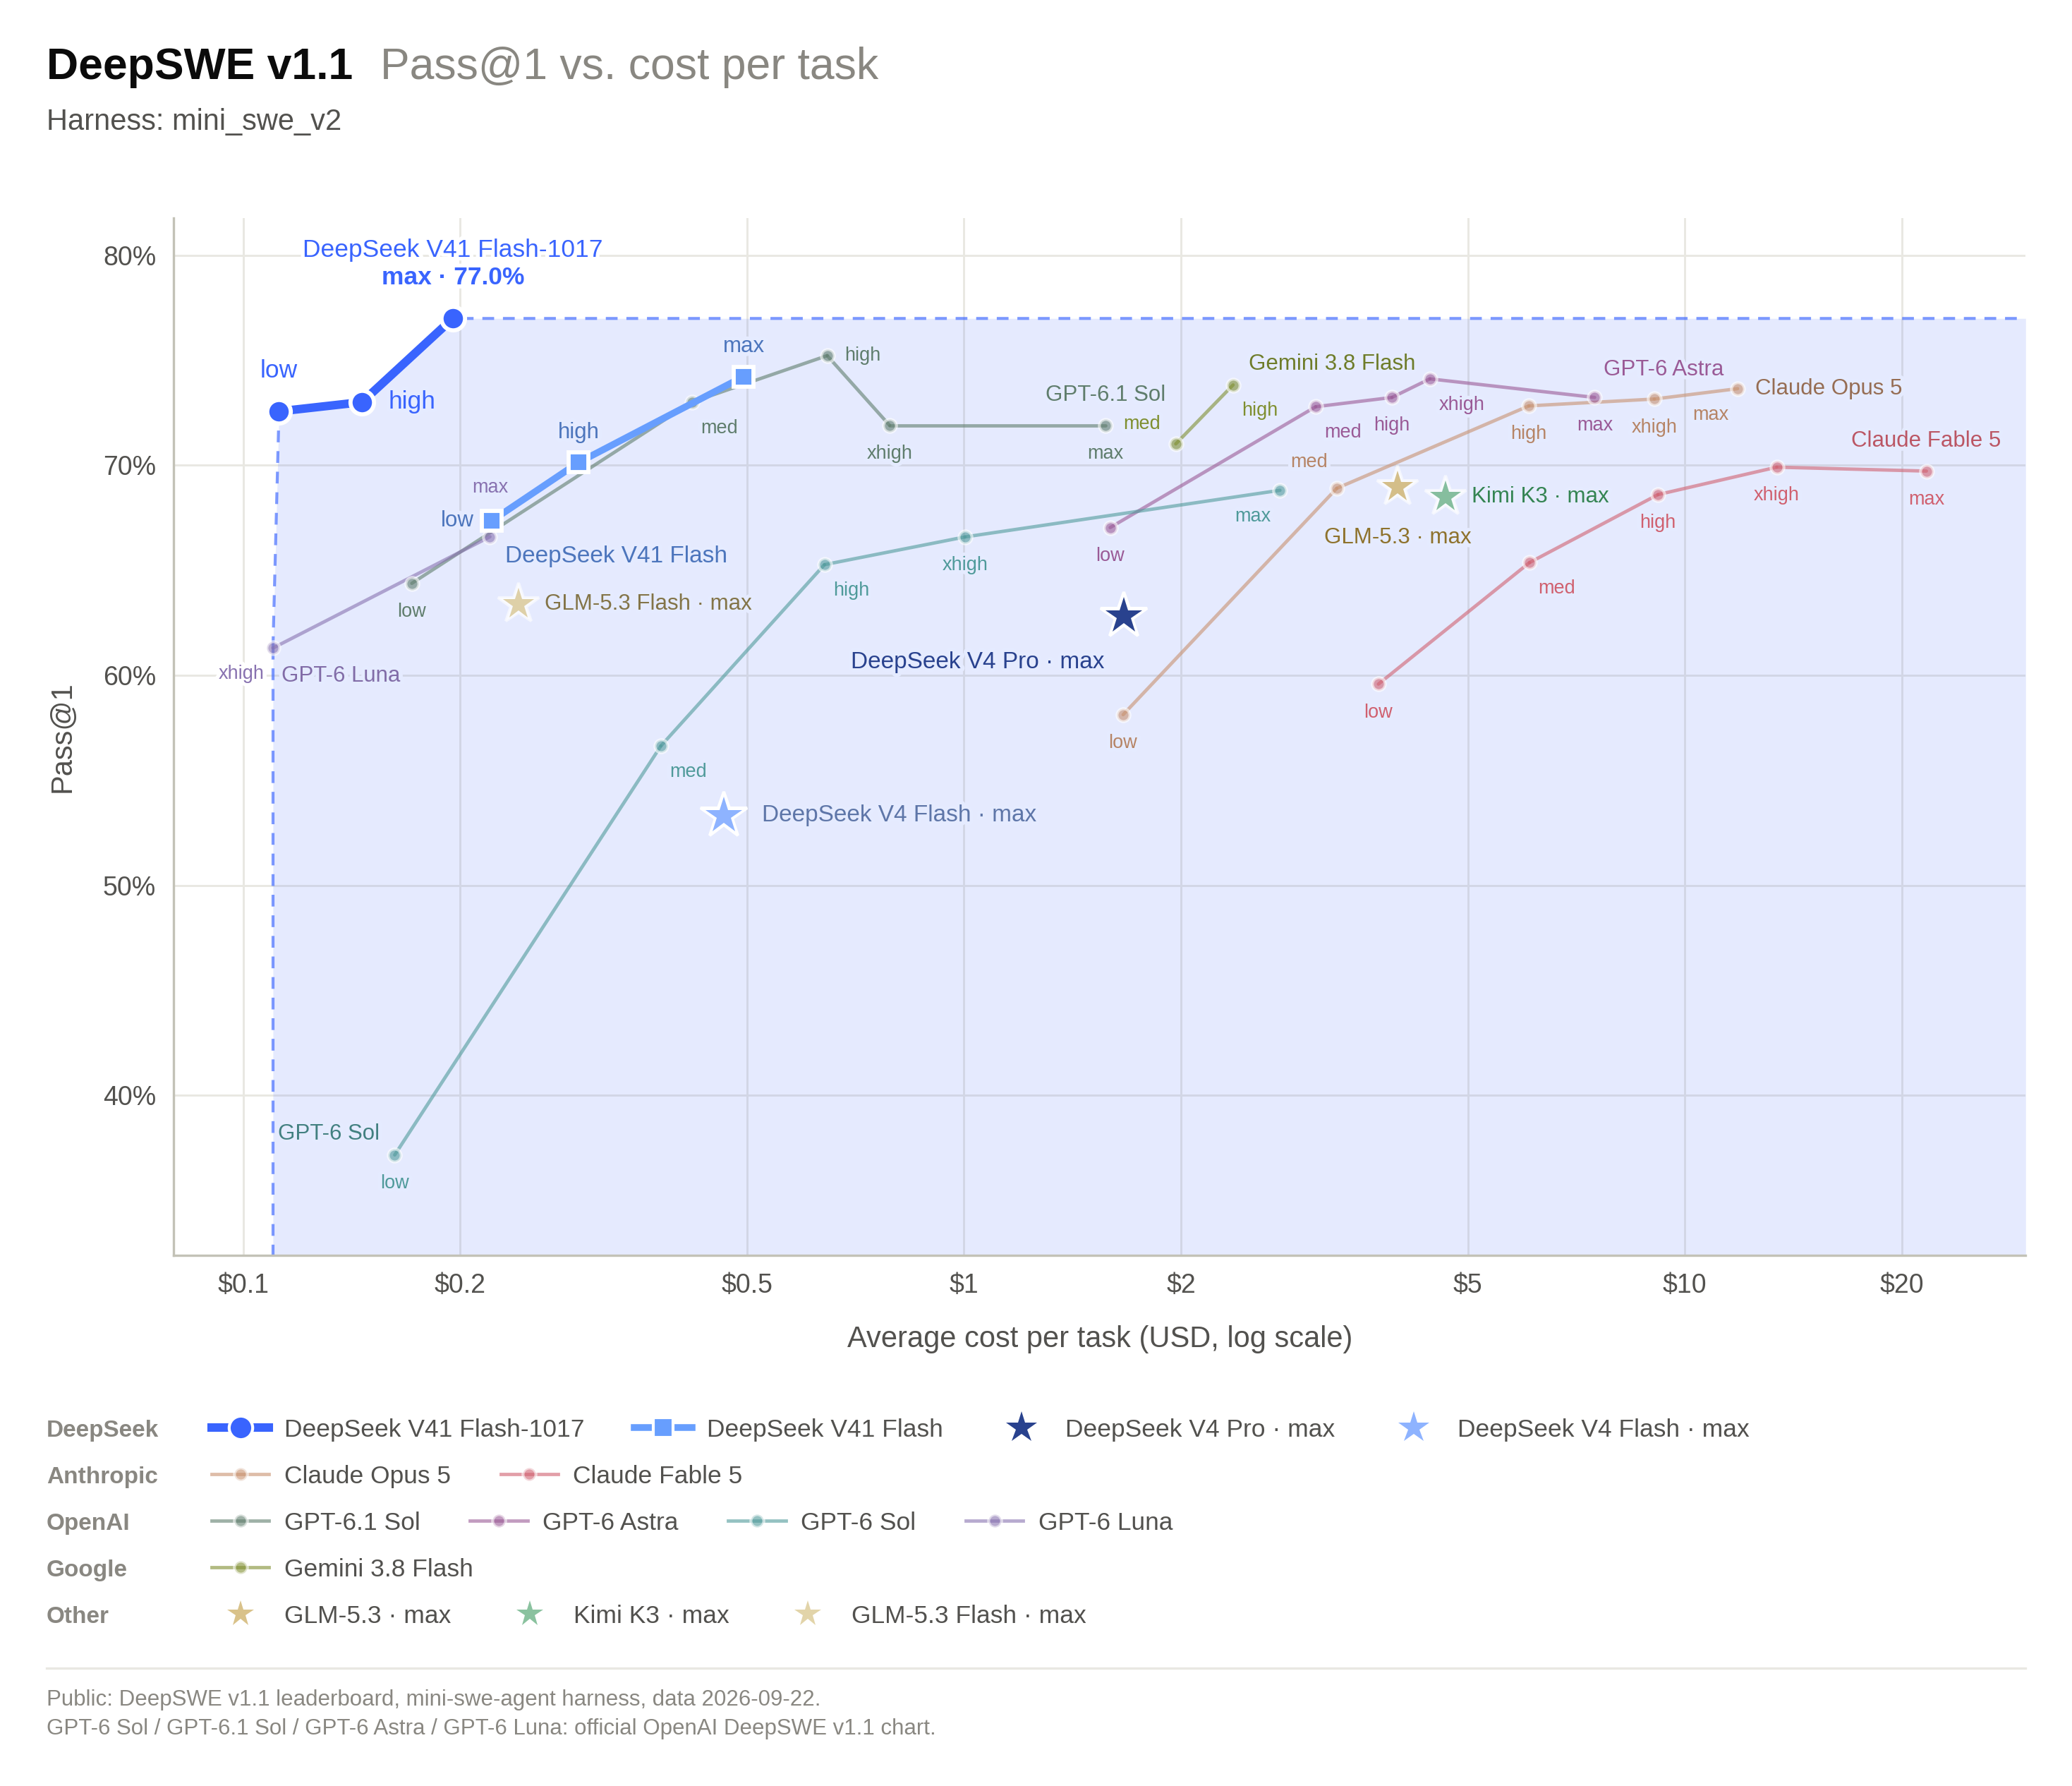
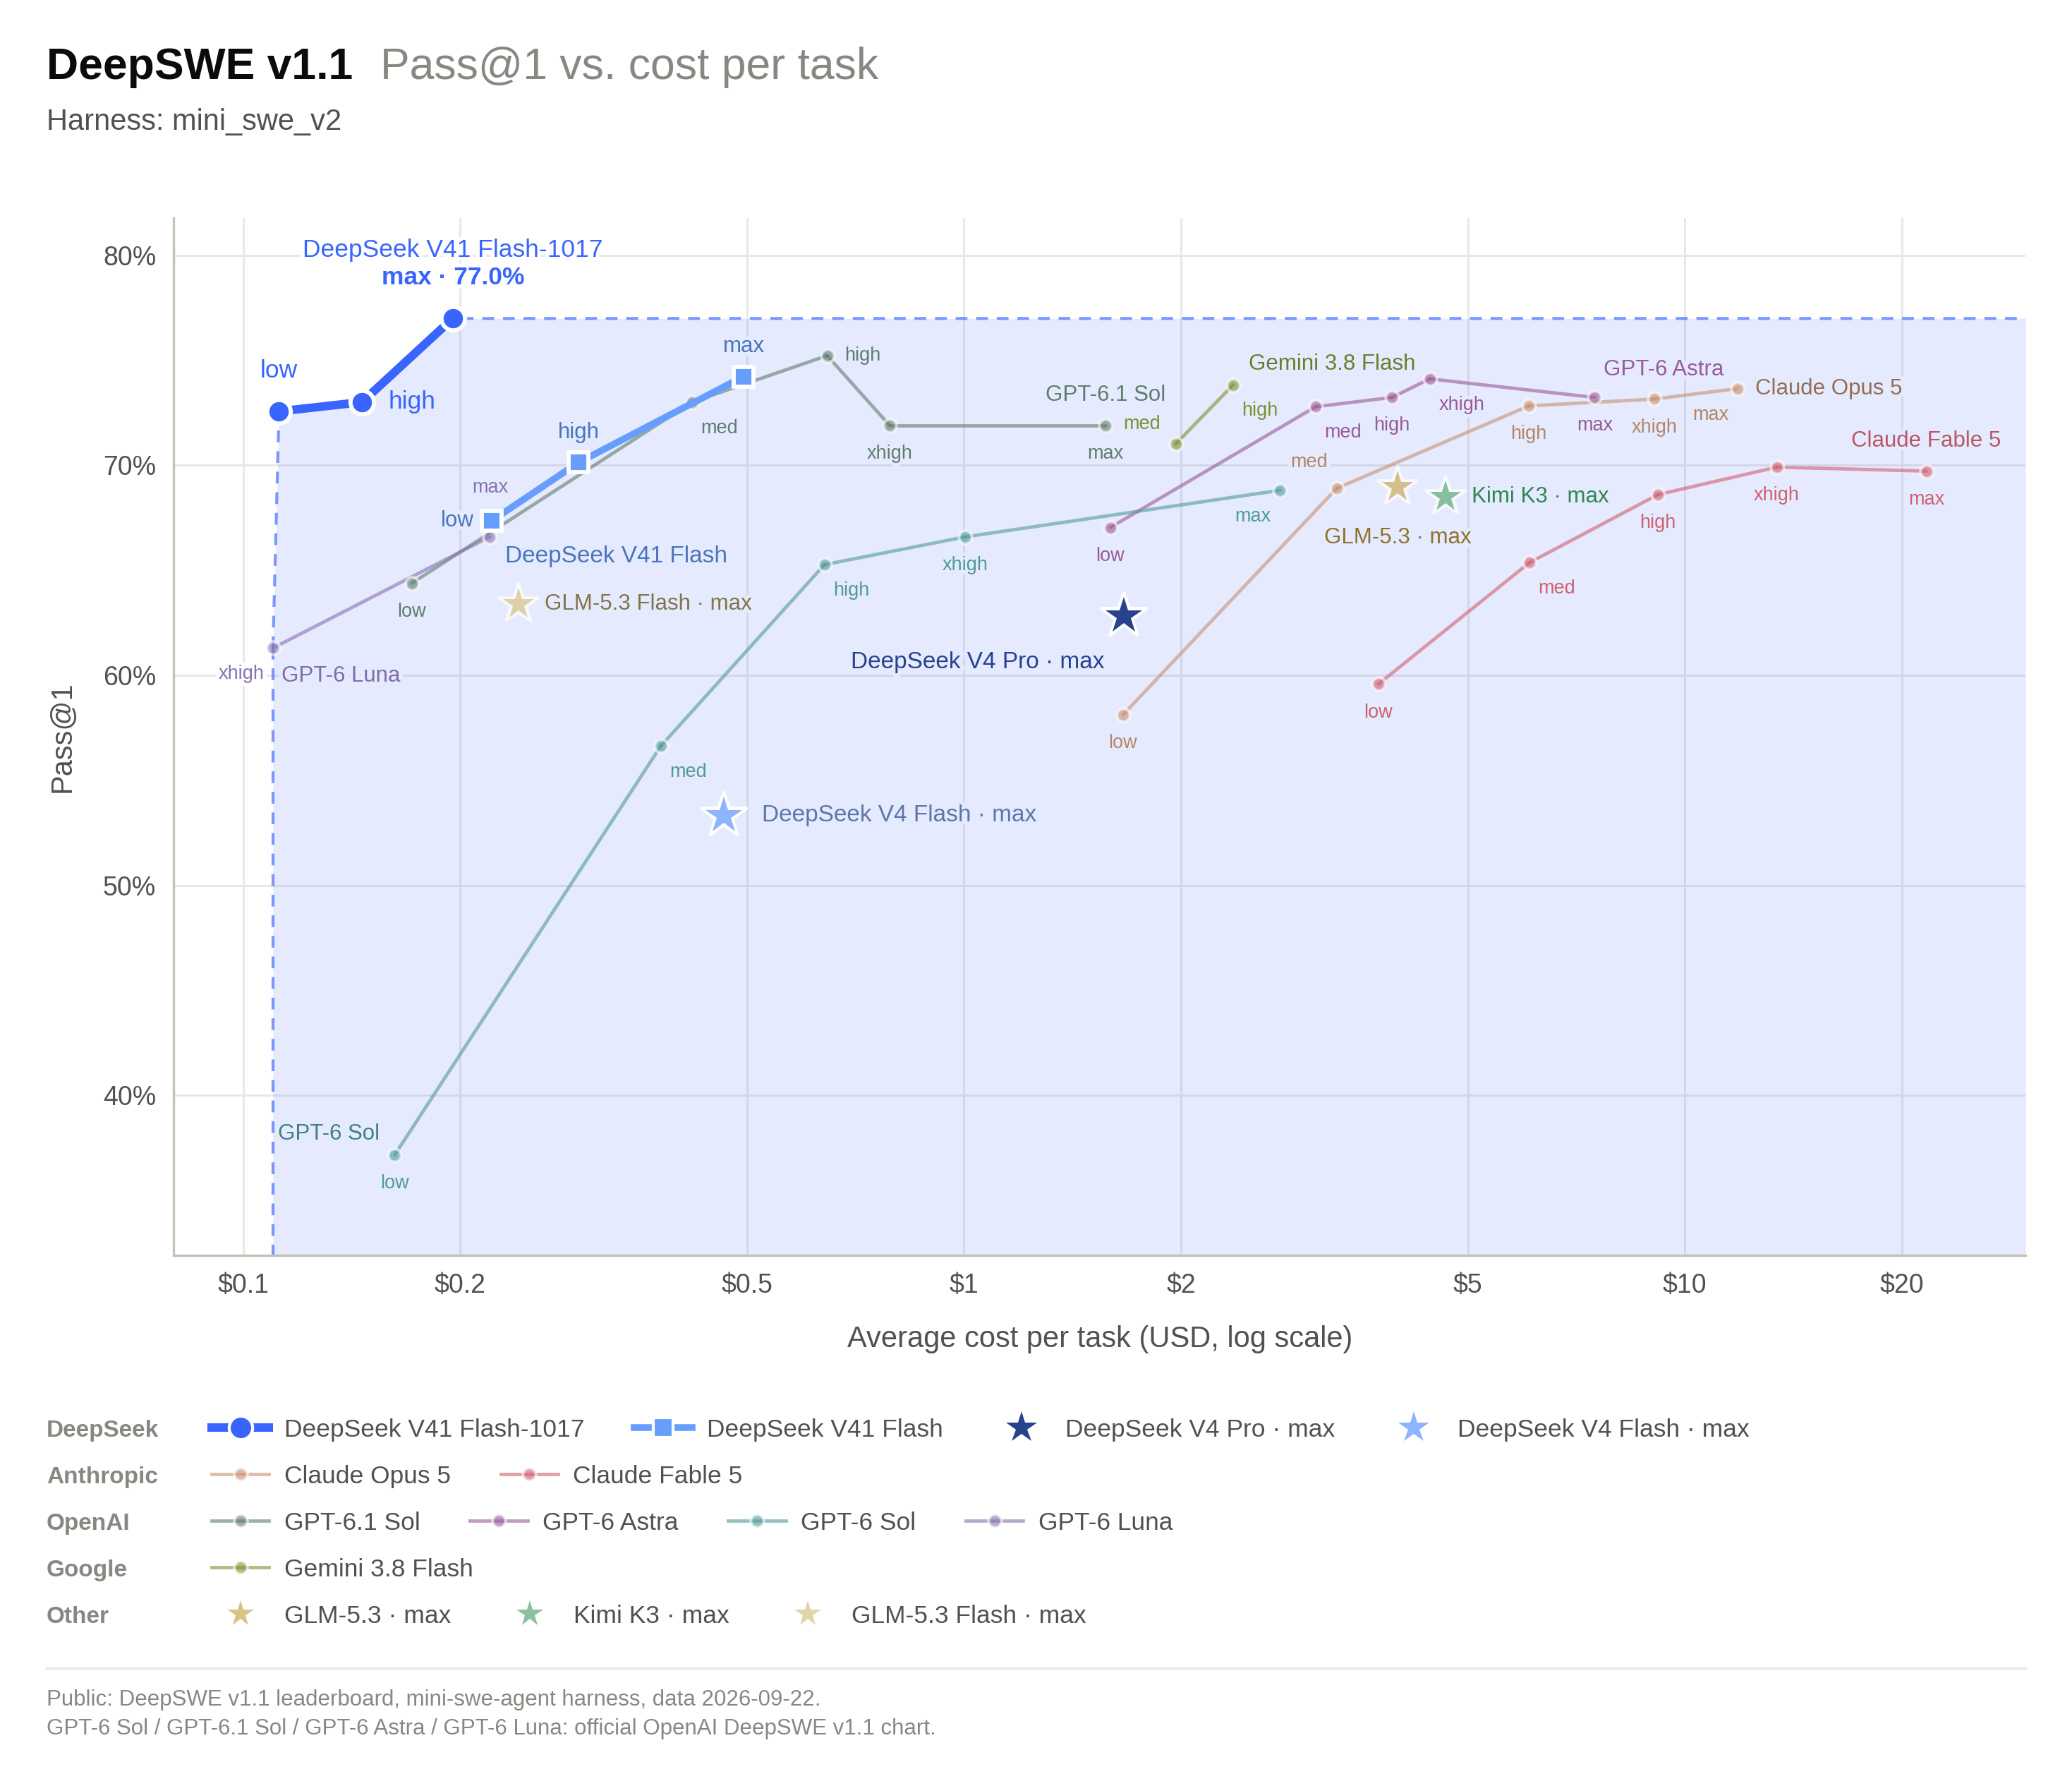
DeepSeek의 DeepSWE v1.1 성능 대 비용 차트는 Mini-SWE-V2 하네스를 사용해 로그 축에서 Pass@1과 평균 과제 비용(USD)을 플롯합니다. 서로 다른 추론 설정은 별도 점으로 나타납니다. 비용 결론을 내리기 전에 적절한 성공률과 구성을 비교하세요.
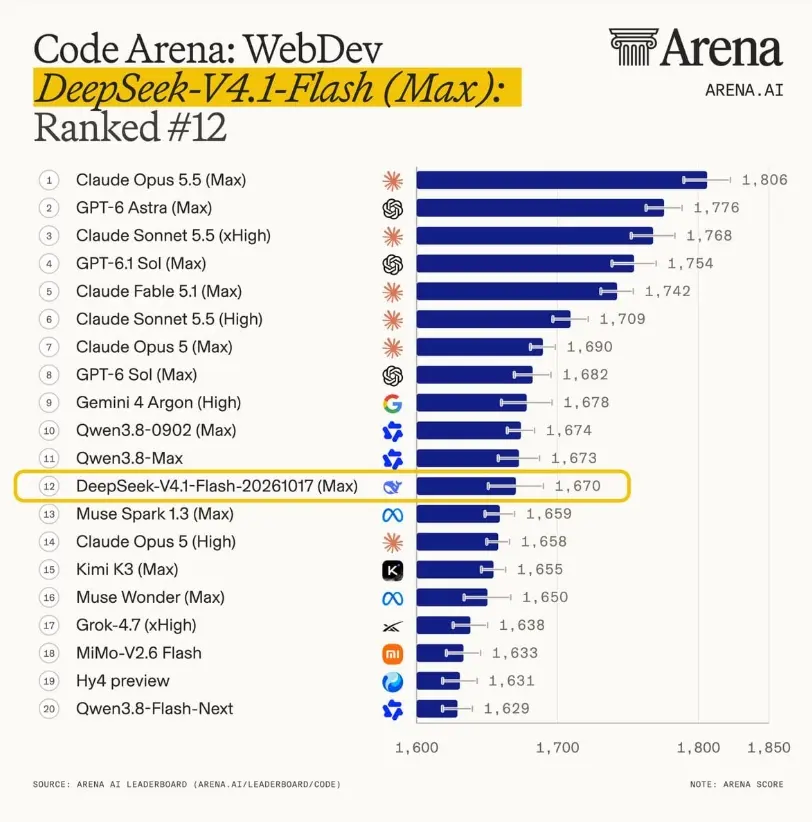
Code Arena: WebDev Leaderboard – Top Open-Source Model
최신 WebDev 프런티어 코딩 및 웹 개발 벤치마크 평가에서 DeepSeek-V4.1-Flash-1017은 평가가 높았던 Kimi K3 (Max)를 뛰어넘었을 뿐 아니라, 추론 비용 효율에서도 자릿수 차이의 개선을 달성했습니다—운영 비용이 상대 모델의 약 10분의 1 수준입니다. DeepSeek-V4.1-Flash-20261017 (Max)는 Code Arena: WebDev 리더보드 정상을 차지하며 “넘버 원 오픈소스 모델” 타이틀을 공식 획득했습니다.
전체 리더보드에서는 1670점으로 12위를 기록했습니다. 이 높은 순위에서, 상위 폐쇄형 모델인 Claude Opus5 (High)를 앞섰고, 최상위 모델 GPT-6Sol (Max)와의 격차도 10점 이내로 좁혔습니다.
How Does the October Update Compare with the September Release?
9월 릴리스와 비교할 때, 10월 17일 업데이트는 선별된 코딩 벤치마크에서 가장 뚜렷한 향상을 보입니다. Terminal-Bench 4.0은 31.2에서 42.3(+11.1포인트)으로 상승했고, ProgramBench는 20.3에서 29.1(+8.8포인트)로 증가했습니다. DeepSWE v1.1은 74.2에서 77.0(+2.8포인트)으로 개선되었습니다. 이 공급업체 보고 결과는 터미널 워크플로와 보다 광범위한 프로그래밍 작업에 대해 이번 업데이트를 평가할 근거를 제공하지만, 모든 코드베이스에서 동등한 생산성 향상을 의미하지는 않습니다.
이번 릴리스는 또한 자기 피드백 강화학습을 통해 완성도 높은 프로젝트 개발을 더욱 강조합니다. 속도와 토큰 절감은 작업에 따라 다르며, 다음 섹션의 두 예시가 이를 보여줍니다. 기존 네이티브 API 통합의 경우 모델 식별자는 계속해서 deepseek-flash입니다. 실용적인 업그레이드 결정은 대표 작업에서의 승인된 과제 완료율, 총비용, 엔드투엔드 시간에 근거해야 합니다.
How Much Does DeepSeek V4.1-Flash-1017 Cost?
비용 우위는 막대합니다. Flash는 일반적으로 최고급 폐쇄형 모델 대비 토큰당 10–40배 저렴하며, 더 짧은 출력은 다단계 에이전트에서 절감을 더욱 증폭합니다. 전작 대비 1017은 보고된 지표에서 엄밀히 더 나아졌으면서도 동일한 가격을 유지—즉 순수한 업그레이드입니다.
2026년 10월 19일 기준 원문 기사에 기록된 100만 토큰당 USD 가격입니다. CometAPI 피크 요금은 공지된 2배 승수를 적용합니다.
| Token category | DeepSeek native: off-peak | DeepSeek native: peak | DeepSeek V4.1 Flash API in CometAPI: base | CometAPI: 2× window |
|---|---|---|---|---|
| Input, cache hit | $0.003 | $0.006 | $0.0024 | $0.0048 |
| Input, cache miss | $0.15 | $0.30 | $0.12 | $0.24 |
| Output | $0.60 | $1.20 | $0.48 | $0.96 |
양사 모두 평일 피크 시간을 UTC 기준 01:00–04:00, 06:00–10:00으로 안내합니다. DeepSeek는 중국 공휴일을 제외하며, CometAPI의 표시 조건에는 그 면제가 명시되어 있지 않습니다. 그 외 시간에는 오프피크/기준 요금이 적용됩니다. CometAPI의 2× 열은 공지된 기준 가격에서 계산했습니다.
네이티브 DeepSeek API에서, 캐시 미스 입력 1,000만 토큰과 출력 200만 토큰의 비용은 다음과 같습니다.
- 오프피크: (10 × $0.15) + (2 × $0.60) = $2.70.
- 피크: (10 × $0.30) + (2 × $1.20) = $5.40.
파일럿 예산을 설정할 때는 승인된 작업당 모든 시도에 걸친 토큰 및 도구 비용을 나누어 산정하세요. 캐시 재사용과 피크 시간대를 포함하고, 인프라 및 휴먼 리뷰 비용은 별도로 보고하세요. 위 예시는 모델 토큰 비용만을 다룹니다.
Search and Fetch charges
DeepSeek의 Search and Fetch API는 각각 성공한 요청 1,000건당 $0.75가 부과됩니다. 과금은 모델 토큰 사용과 별개이며, 실패한 요청, 빈 검색 결과, 타임아웃은 문서상 과금 대상이 아닙니다.
DeepSeek API 사용자에게는 DeepSeek Harness, Claude Code, Codex를 통한 서버사이드 Search 및 Fetch 호출이 공식 과금 정책에 따라 한시적으로 무료입니다. 해당 호출에 대한 과금은 2026년 10월 31일 16:00 UTC(베이징 기준 11월 1일 00:00)부터 시작됩니다. 이 한정 면제는 모든 독립형 Search 및 Fetch API 요청을 무료로 만드는 것이 아닙니다.
Is DeepSeek V4.1-Flash-1017 Always Faster and Cheaper?
아니오. EmpirioLabs의 두 가지 과제 테스트에서는 어항 애니메이션에서 시간과 출력 토큰 사용이 낮았지만, 스카이라인 애니메이션에서는 더 높게 나타났습니다.
| EmpirioLabs’ first-hand coding tests | September release | October 17 update | Observed result |
|---|---|---|---|
| Aquarium completion time | 162 seconds | 124 seconds | October update faster |
| Aquarium output tokens | 41,833 | 33,149 | October update used fewer |
| Skyline completion time | 163 seconds | 177 seconds | October update slower |
| Skyline output tokens | 37,928 | 42,907 | October update used more |
두 버전 모두 2026년 10월 18일 EmpirioLabs의 API 플랫폼에서 작동하는 애니메이션을 생성했습니다. 각 과제는 동일한 프롬프트를 사용하고, 외부 라이브러리나 에셋 없이 CSS와 JavaScript를 인라인으로 포함한 단일 HTML 파일을 요청했습니다. 두 모델 모두 기본 설정으로 실행되었고, 생각 모드는 기본 예산으로 활성화되었으며, 출력 제한은 65,536 토큰이었습니다. 각 과제는 두 모델이 동시에 실행되었고, 모델당 1회 시도했습니다. 시간은 전체 요청을 포괄하며, 추론 토큰을 포함한 출력 토큰 수치는 API 사용 보고서에서 가져왔습니다. 스크린샷은 6초 후 헤드리스 브라우저에서 렌더링했습니다. 이 두 예시는 워크로드 변동성을 보여주는 것이며, 일반 순위를 확정하는 근거가 아닙니다.
How Can You Access DeepSeek V4.1-Flash-1017?
- Official DeepSeek API — https://api.deepseek.com.에서 모델 이름
deepseek-flash사용 - Open weights — 자체 호스팅을 위해 Hugging Face 또는 ModelScope에서 다운로드
- CometAPI — CometAPI Adds DeepSeek-V4.1-Flash-1017 View model details 모델 ID: deepseek-v4.1-flash-1017
Use the native DeepSeek API
DeepSeek의 API quick start와 CometAPI에 따르면 deepseek-flash가 이제 10월 17일 버전을 제공하며, 호출 방식은 변경되지 않았습니다.
Python으로 API를 통해 프로젝트 계획 요청을 보내보세요. 예제를 실행하기 전에 OpenAI Python 패키지를 설치하고 환경 변수에 API_KEY를 설정하십시오.
import os
from openai import OpenAI
client = OpenAI(
    api_key=os.environ["API_KEY"],
    base_url="https://api.deepseek.com",# https://api.cometapi.com/v1
)
response = client.chat.completions.create(
    model="deepseek-v4.1-flash-1017",
    messages=[
        {
            "role": "user",
            "content": (
                "Design a small issue-tracking application. "
                "Give the data model, implementation plan, "
                "and acceptance tests."
            ),
        }
    ],
)
print(response.choices[0].message.content)
이는 모델 응답을 생성합니다. 프로젝트를 자동으로 빌드하고 검증하려면, 에이전트 환경에 파일 접근, 명령 실행, 테스트 피드백, 적절한 권한이 추가로 제공되어야 합니다.
CometAPI Recommendation: CometAPI는 이미 다양한 DeepSeek 모델을 제공하며, 공급업체 종속 없이 V4.1-Flash-1017을 Claude, GPT, Gemini, Grok, 그리고 특화된 코딩/비전 모델과 함께 시도하기에 훌륭한 방법입니다. 가입 후 API 키를 발급받고, 기존 OpenAI SDK의 base URL을 CometAPI로 지정하세요. 이 접근법은 다양한 하위 작업을 가장 비용 효율적이거나 가장 성능이 높은 모델로 라우팅하는 에이전트 프레임워크에서 특히 강력합니다.
Conclusion
DeepSeek-V4.1-Flash-1017은 오픈 AI 역량의 스마트하고 효율적인 도약을 의미합니다. 핵심 에이전트 및 코딩 벤치마크 전반의 성능을 끌어올리면서 동시에 출력 길이와 작업 시간을 줄이고—가격은 낮게 유지함으로써—성능 대 비용 경쟁에서 DeepSeek의 입지를 더욱 공고히 합니다. 자율 소프트웨어 에이전트, 멀티모달 애플리케이션, 비용 최적화된 프로덕션 시스템을 구축 중이라면, 이 모델은 진지한 평가 대상입니다.
CometAPI 같은 편리한 접근 레이어와 결합하면, 개발자는 V4.1-Flash-1017 같은 최첨단 모델을 최소한의 마찰로 강건한 멀티 프로바이더 워크플로에 통합할 수 있습니다. 독립적 평가가 계속되고 도구 생태계(Harness, CodeBuddy 등)가 성숙해짐에 따라, 이 체크포인트는 2026년 말과 그 이후의 대규모·고지능 워크로드에서 많은 팀의 기본 선택지가 될 것으로 예상됩니다.