
TL;DR
GLM 5.4는 Z.ai의 GLM 계열 후속작 가능성을 가리키는 커뮤니티 명칭입니다. 2026년 10월 14일 기준, 본 문서가 검토한 공식 모델 문서와 릴리스 기록에는 GLM-5.4 출시, 스펙 시트, API 식별자가 확인되지 않습니다. Union Alpha는 소문상의 단서일 뿐이며, 10월 출시는 주기 기반의 가능성입니다. 유의미한 질문은 향후 릴리스가 코딩 신뢰성과 작업 단위 비용을 개선하는지 여부이며, 기존 GLM 모델이 그 평가의 기준선이 됩니다.
Key Takeaways
- 출시 상태: 2026년 10월 14일 검토한 공식 소스는 GLM-5.4를 확인하지 않으며, 정확한 출시일도 확정되지 않았습니다.
- 소문 증거: Union Alpha와 GLM-5.4의 연관성은 검증되지 않았고, 인용된 요약글은 원 출처 게시글을 특정하지 않습니다.
- 성능 기준선: 기존 GLM-5.3 결과는 유용한 맥락이지만 GLM-5.4 측정치는 아닙니다.
- 아키텍처: GLM-5.3-Flash는 다른 효율성 및 멀티모달 방향을 보여주며, GLM-5.4가 이를 계승할지는 미정입니다.
- 개발자 액션: 지금 이용 가능한 모델을 평가하고, 업그레이드 전 검증된 모델 ID, 호환성, 작업 단위 측정치를 요구하세요.
Has GLM 5.4 Been Released?
GLM 5.4는 잠재적 GLM 후속작에 대한 비공식 명칭입니다. 2026년 10월 14일 기준 검토한 공식 문서 인덱스와 릴리스 기록은 기존 GLM 모델을 식별하지만 GLM-5.4 제품 출시를 확립하지 않습니다. 이는 특정 시점의 소스 점검일 뿐, 비공개 개발 부재의 증거는 아닙니다.
관심을 모으는 이유를 설명하는 두 가지 문서화된 발전 경로가 있습니다.
Z.ai는 GLM-5.3이 GLM-5.2 베이스 모델을 재사용하고 사후 학습을 통해 향상을 얻었다고 밝힙니다. 반면 GLM-5.3-Flash는 새로운 멀티모달 베이스와 하이브리드 어텐션 아키텍처를 사용합니다. 이는 현존 모델에 대한 사실이며, 공개된 GLM-5.4 설계를 의미하지는 않습니다.
실무적으로 하나는 기존 모델을 추가 학습으로 개선하는 길이고, 다른 하나는 연산 비용을 낮추고 새로운 역량을 지원하기 위해 아키텍처를 재설계하는 길입니다.
향후 GLM-5.4는 어느 방향이든 선택할 수 있으나, 현재로서는 Z.ai가 어떤 접근을 택할지 판단할 충분한 증거가 없습니다.
How Reliable Are the GLM-5.4 Rumors and Leaks?
Confirmed Information
확인된 기술 기준선은 GLM-5.3과 GLM-5.3-Flash에서 비롯되며, GLM-5.4가 아닙니다. GLM-5.4라는 이름, 최종 스펙, 출시일, 벤치마크 결과는 본 문서가 검토한 공식 소스에서 여전히 미확인 상태입니다.
Community Reports / Leaks
2026년 10월 8일 @NFT_Chen의 X 게시물은 GLM-5.4/5.5의 가능 개발 방향을 Tang Jie의 언급에 귀속합니다. 게시물은 세 가지 스케일링 우선순위를 설명합니다: 사전 학습 확장, SFT·RLHF·RLVR를 통한 사후 학습 강화, 더 어렵고 더 긴 작업에서의 추론 및 에이전트 실행 확장.
작성자는 다음 방향을 더 긴 자율 에이전트와 재귀적 자기 개선(RSI)으로 해석합니다. 이는 발표에 대한 커뮤니티의 설명이며, Z.ai의 릴리스 공지가 아닙니다. 버전 이름과 개발 주장들은 해당 게시물에 귀속되며, GLM-5.4의 출시일, 최종 아키텍처, 파라미터 수, 입증된 자기 개선 능력을 확립하지 않습니다.
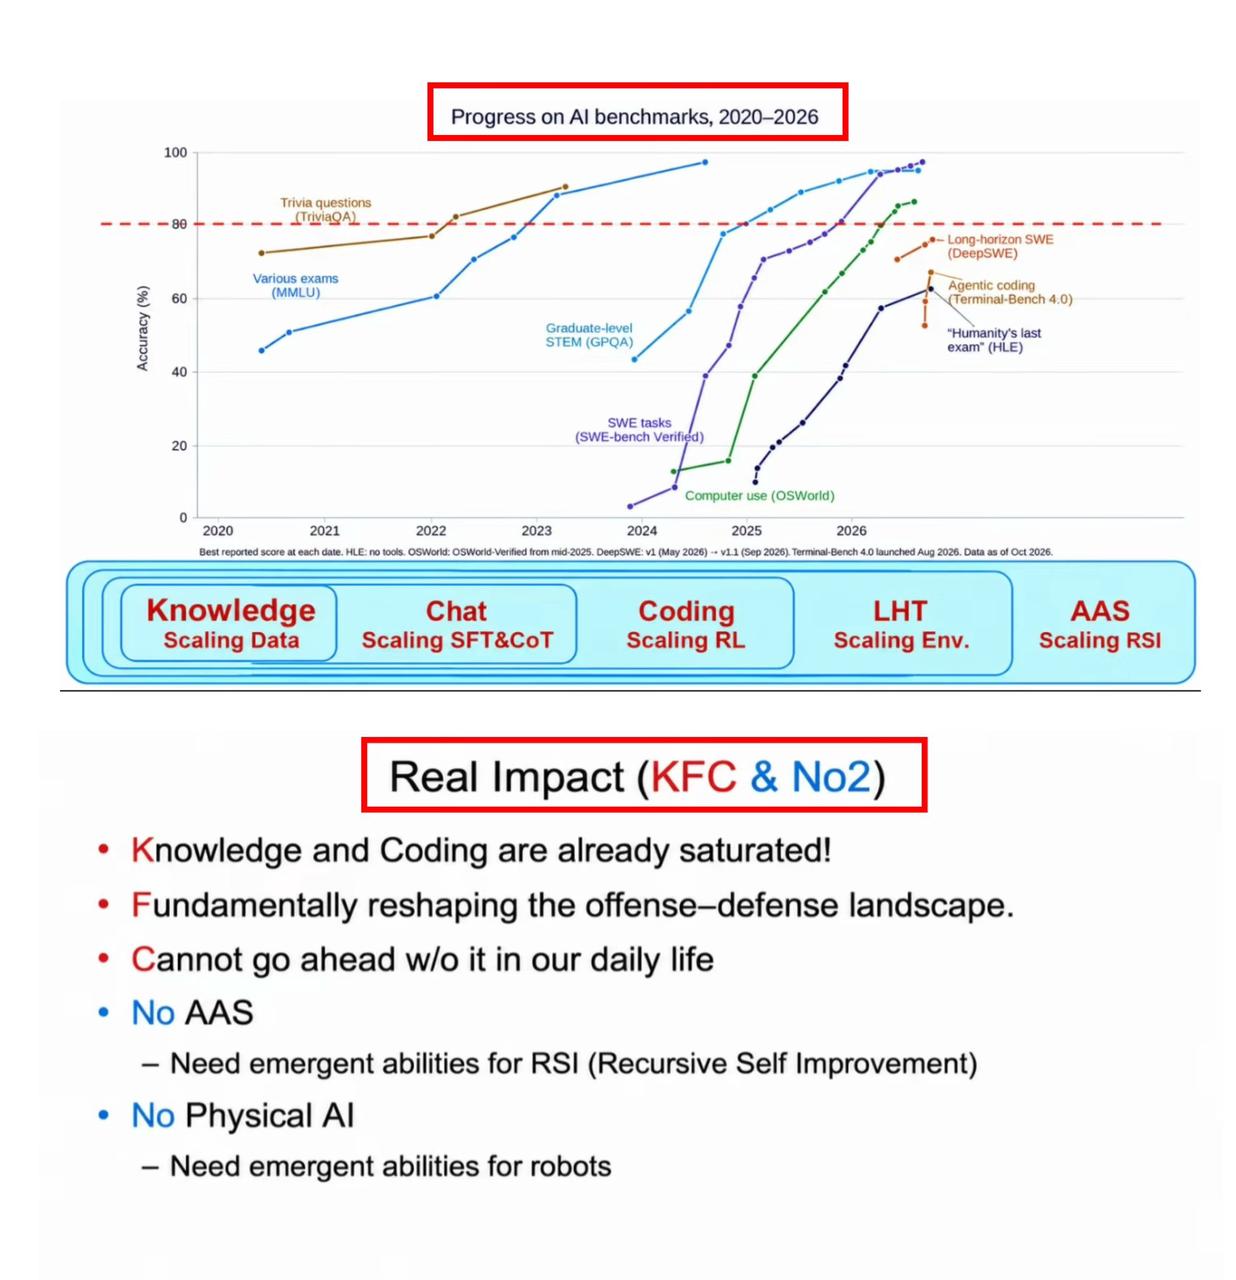
2026년 10월 8일 @NFT_Chen의 원문 X 게시물에 첨부된 발표 슬라이드 이미지. 벤치마크 진행과 RSI를 향후 방향으로 다루지만, GLM-5.4 벤치마크 보고서는 아닙니다.
2026년 10월 8일 @NFT_Chen의 원문 X 게시물에 첨부된 강연 사진.
Analysis
유용한 소문 분석은 어떤 관측이 결론을 바꿀지 묻습니다. 공식 모델 식별자, 출시 공지, 익명 별칭과의 매핑 공개는 주장을 실질적으로 강화합니다. 유사한 작명 패턴이나 릴리스 간격만으로는 충분하지 않습니다. 과거의 다른 GLM 미래 버전에 대한 추측은 GLM-5.4의 스펙을 확립하지 못합니다.
When Could GLM 5.4 Be Released?
Z.ai의 릴리스 노트 타임라인은 GLM-5를 2월 12일, GLM-5.1을 4월 7일, GLM-5.2를 6월 16일, GLM-5.3을 8월 18일, GLM-5.3-Flash를 2026년 8월 26일로 기록합니다. 이는 릴리스 노트에 기록된 날짜로, 모든 연구 발표나 제공자 가용일과 동일시해서는 안 됩니다.
주요 포인트 버전의 대략 두 달 간격 진행은 10월을 관찰할 만한 분석적 창으로 만듭니다. 그러나 이는 10월 출시, 특정 날짜, 다음 버전명조차 확립하지 않습니다. 추적 가능한 예측 출처와 그 방법론 없이 10월 20일 또는 10월 23일 같은 정확한 예측을 제시하는 것은 근거 이상의 정밀도를 암시합니다.
더 늦은 출시, 다른 이름, 별도 제품 변형도 가능합니다. 개발자는 달력 추정보다 현재 이용 가능한 API를 중심으로 계획해야 합니다.
What Are GLM 5.4's Expected Specs?
신뢰할 만한 GLM-5.4 사양서는 없습니다. 출시되지 않은 제품에 소문 속 하드웨어와 모델 파라미터를 할당하기보다, 최신 문서화된 GLM 모델을 비교하고 미확정 사항을 식별하는 것이 더 유익합니다.
| Specification | GLM-5.3 | GLM-5.3-Flash | GLM-5.4 |
|---|---|---|---|
| Release | August 18, 2026 | August 26, 2026 | Unannounced |
| Model foundation | GLM-5.2 base; further post-training | New multimodal base | Unknown |
| Architecture | MoE foundation | MoE; hybrid sparse-linear attention | Unknown |
| Context support | 1M documented API context | 1M | Unknown |
| Native multimodality | Text-only input | Text, image, video, and file inputs | Unknown |
| Primary emphasis | Coding, agents, cybersecurity | Efficiency, coding, multimodality | Unknown |
| Published benchmarks | Available | Available | Not available |
| Model weights | Released | Released | Not available |
이 표는 기존 모델의 문서화된 역량을 보고합니다. GLM-5.4 항목은 전임자 중 어느 쪽의 값을 상속하지 않고 미확정으로 남습니다. 모델의 평가 컨텍스트, API 컨텍스트 윈도우, 최대 출력 길이는 서로 다른 제한입니다.
GLM-5.3-Flash 아키텍처 개요는 총 320B 파라미터, 활성 18B 파라미터, 하이브리드 희소-선형 어텐션을 보고합니다. 이는 공개된 Flash 사양이며 GLM-5.4에 할당되어서는 안 됩니다.
Agentic Coding as a Potential Upgrade Direction
에이전틱 코딩은 주목할 만한 관전 포인트입니다. GLM-5.3은 사후 학습 규모 확장이 다단계 엔지니어링 과제에서 성능을 크게 향상시킬 수 있음을 이미 보여줬습니다. 개발진은 복잡한 리포지토리 작업, 더 긴 실행 지평, 개선된 도구 기반 문제 해결을 강조했습니다.
향후 모델은 더 나은 환경 상호작용, 더 신뢰할 수 있는 계획, 실패한 도구 호출의 감소를 통해 이러한 역량을 확장할 수 있습니다.
가장 유용한 평가는 단순히 코딩 질문 정답률을 측정하는 것이 아니라, 에이전트가 디버깅, 테스트, 수정, 실패 후 복구를 포함해 복잡한 작업을 처음부터 끝까지 완료할 수 있는지를 측정하는 것입니다.
Efficient Multimodal Architecture as a Possible Direction
GLM-5.3-Flash는 향후 개발을 위한 아키텍처적 준거점을 제공하지만, 검토한 어떤 공식 소스도 GLM-5.4에 이의 사용을 확립하지 않습니다.
Z.ai는 GLM-5.3-Flash의 효율성 지향 설계의 일부로 30T 토큰 규모의 멀티모달 사전 학습 말뭉치를 설명합니다. 이는 기존 모델의 학습 데이터 규모를 기술하는 것이며 GLM-5.4에 대한 로드맵 약속이 아닙니다.
공식 Flash 개요는 명시된 비교 하에서 GLM-5.3 대비 주의(attention) 연산 3.01× 감소, KV-캐시 요구량 4.44× 감소를 보고합니다. 이는 구성 요소 수준의 효율성 결과이지, 보장된 애플리케이션 속도 향상이나 API 가격 인하가 아닙니다.
이러한 엔지니어링 개선은 의미가 있으나, GLM-5.4가 동일한 아키텍처를 계승한다는 확인은 없습니다. 더 큰 차세대 모델은 최대 추론 성능을 우선시할 수 있고, 별도의 Flash 변형은 지연시간과 비용 최적화를 계속 추구할 수 있습니다.
GLM 5.4 vs GLM-5.3 vs GLM-5.3-Flash
GLM-5.3 Benchmark Baseline
이용 가능한 벤치마크 데이터는 GLM-5.3의 성능 궤적 분석을 뒷받침하지만 GLM-5.4의 직접 측정은 아닙니다. 아래 값은 기존 모델에 대한 Z.ai의 보고 평가입니다. 본 문서에서 독립 재현되지 않았고 GLM-5.4를 측정하지 않습니다. 각 벤치마크는 고유의 과제 세트와 점수 방식을 사용하므로, 점수 차이를 과제 간 동일한 향상으로 해석해서는 안 됩니다.
| Benchmark and methodology | GLM-5.2 | GLM-5.3 | GLM-5.3-Flash | GLM-5.3 vs GLM-5.2 difference |
|---|---|---|---|---|
| Terminal Bench 3.0 | 4.6 | 28.3 | Not reported in the cited Flash comparison | +23.7 points |
| DeepSWE v1.1 | 46.2 | 66.9 | 63.4 | +20.7 points |
| AutomationBench v1.0.6 | 26.2 | 48.2 | 48.8 | +22.0 points |
| CyberGym | 77.2 | 84.5 | Not reported in the cited Flash comparison | +7.3 points |
| ExploitBench | 24.4 | 54.4 | Not reported in the cited Flash comparison | +30.0 points |
| HLE with Tools | 54.7 | 62.5 | 55.3 | +7.8 points |
| GDPval-AA v2 | 1508 | 1769 | Not reported in the cited Flash comparison | +261 Elo |
| Toolathlon Verified | 59.9 | Not reported in the cited GLM-5.3 comparison | 78.4 | Not available |
결합 표는 기존 모델의 결과를 나란히 배치하며 GLM-5.4 측정치는 포함하지 않습니다. 미보고 값은 0점이 아닙니다. 각 벤치마크의 평가 조건을 염두에 두고, GDPval-AA 차이는 퍼센티지 포인트가 아니라 Elo임을 유의하세요.
방법론: DeepSWE v1.1은 mini-swe-agent, temperature 0.95, top_p 1.0, 6시간 타임아웃, 400K 컨텍스트를 사용합니다. AutomationBench는 v1.0.6을 사용합니다. HLE with Tools는 temperature 1.0, top_p 0.95, 163,840 토큰 생성 한도, 300K 컨텍스트 한도와 컨텍스트 관리 사용을 적용합니다. GDPval-AA v2는 Elo 스케일을 사용하므로, 차이는 퍼센티지 포인트 상승이 아닙니다.
CyberGym과 ExploitBench의 경우, Z.ai는 Claude Code 2.1.207을 최대 reasoning effort, 웹 도구 없음, temperature 1.0, top_p 1.0, 출력 한도 128,000 토큰으로 보고합니다. CyberGym은 1,507개 과제에 대한 단일 실행 pass@1과 무제한 과제별 타임아웃을 보고합니다. ExploitBench는 최대 300회 상호작용 라운드를 사용하고, 세 차례 개정에 걸쳐 41개 과제의 커버리지를 평균합니다. 모델 카드 각주에 벤치마크별 환경 세부사항이 제공됩니다.
Flash 방법론: DeepSWE는 mini-swe-agent, 400K 컨텍스트, 6시간 타임아웃을 사용하고, AutomationBench는 v1.0.6을 사용합니다. Toolathlon Verified는 공식 평가 서비스를 통한 세 차례 독립 실행의 pass@1 평균을 보고합니다. HLE는 위에서 설명한 샘플링 및 컨텍스트 관리 설정을 사용합니다. Flash 모델 카드 방법론을 참조하세요. 이 벤치마크 결과는 프로덕션 지연시간이나 비용을 확립하지 않습니다.
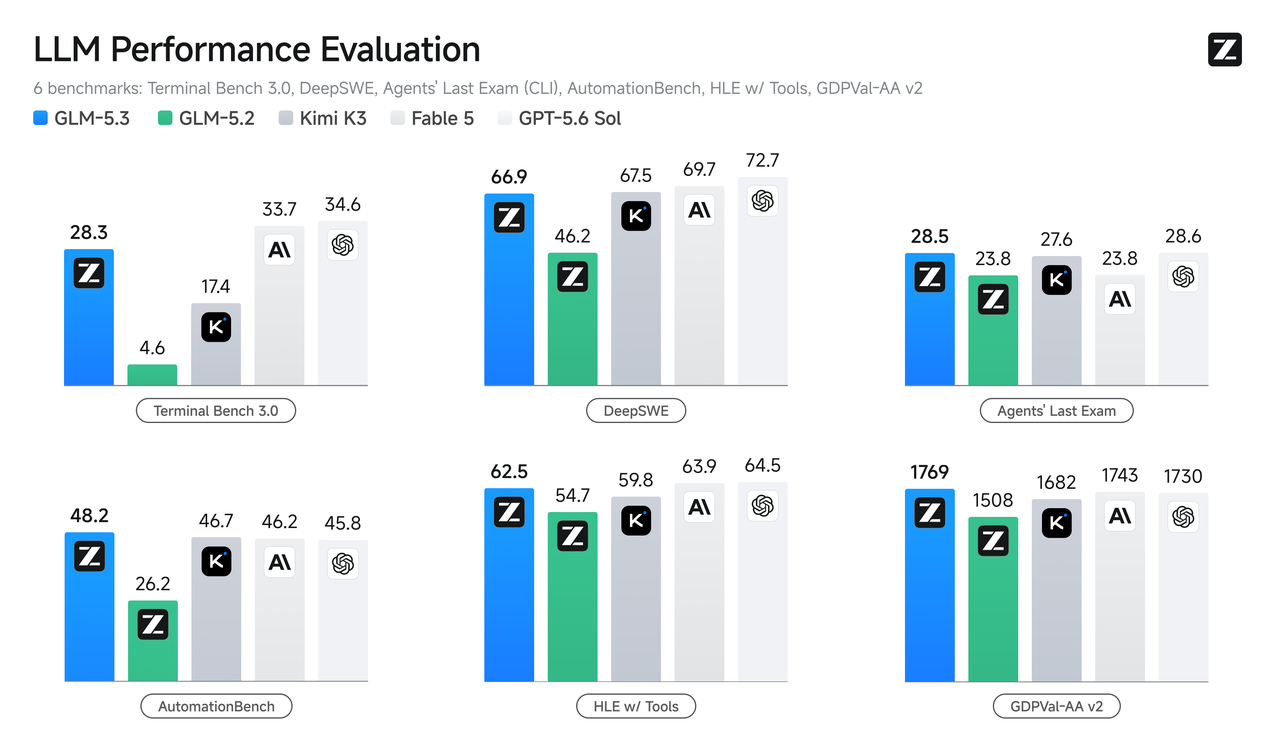
Z.ai의 벤치마크 발표에서 재현된 공식 GLM-5.3 성능 그래픽. 이전 모델 평가를 보여주며, GLM-5.4 결과는 포함하지 않습니다.
가장 큰 향상은 환경과의 지속적 상호작용을 요구하는 과제에서 나타납니다. Terminal Bench 3.0은 4.6에서 28.3으로, ExploitBench는 24.4에서 54.4로 상승했습니다.
이는 베이스 아키텍처를 바꾸지 않고도 사후 학습과 에이전트 지향 환경이 모델의 수행 방식을 극적으로 바꿀 수 있음을 시사합니다. 그러나 이를 GLM-5.4에 대한 수치적 예측으로 외삽해서는 안 됩니다.
Capabilities and Production Fit
프로덕션 관점에서 GLM-5.3은 복잡한 코딩, 장기 지평 엔지니어링, 사이버보안 평가에 더 강력한 기준점입니다. GLM-5.3-Flash는 네이티브 비주얼 입력을 추가하고 효율적 도구 사용을 강조합니다. 기존 GLM-5.2, GLM-5.3, Flash 제공이 기준선을 제공합니다. 본 문서가 검토한 소스에는 GLM-5.4의 동등한 역량이나 가용성이 확립되지 않았습니다.
문서화된 모델은 최대 1M 컨텍스트를 지원하지만, 이 한도가 모든 엔드포인트에서 동일한 사용 가능한 컨텍스트나 작업 성능을 보장하진 않습니다. 대표적 워크로드와 성공적으로 완료된 작업당 비용으로 선택하세요.
향후 GLM-5.4가 마이그레이션을 정당화하려면 측정 가능한 개선을 제공해야 합니다. 벤치마크 정확도는 개선되었으나 작업 완료 비용이 두 배가 된다면 프로덕션 배포에 매력적이지 않을 수 있습니다. 반대로, 정확도가 소폭 상승하면서 도구 호출이 크게 줄어든다면 규모에서 가치가 클 수 있습니다.
동일한 평가 하네스에서 작업 성공, 입력·출력 토큰, 지연시간, 실패한 도구 호출, 성공적 작업당 비용을 비교하세요. 정성적 모델 설명은 통제된 직접 비교가 아닙니다.
What Is the Current GLM-5.4 API Status on CometAPI?
CometAPI는 안정적 모델 식별자 항목을 가진 전용 GLM 5.4 모델 페이지를 만들었습니다. 하지만 해당 페이지는 여전히 모델을 “출시 예정”으로 표시하고 출시 전 모델로 설명합니다. 프로덕션 사용 시도 전 실제 모델 ID, 계정 접근, 엔드포인트 가용성, 지원 파라미터, 컨텍스트 한도, 가격을 검증해야 합니다.
현재 문서화된 통합을 위해서는 GLM-5.2나 GLM-5.3 같은 이용 가능한 GLM 모델을 사용하세요. CometAPI의 GLM-5.4 페이지는 모델 ID와 엔드포인트가 호출 가능함이 확인될 때까지 출시 전 카탈로그 항목으로 취급해야 합니다.
Preparing for GLM 5.4 API Integration
가장 실용적인 준비는 애플리케이션 로직을 단일 모델 버전에 결합하지 않는 것입니다. 구성 가능한 모델 식별자는 요청 파이프라인을 재작성하지 않고도 업그레이드를 평가하기 쉽게 해줍니다.
모델 식별자를 구성 가능하게 유지하고, 이용 가능한 GLM 모델로 작동 기준선을 수립하세요. GLM-5.4로 전환하기 전에는 호출 가능한 모델 ID, 계정 접근, 지원 요청 파라미터, 컨텍스트·출력 한도, 스트리밍 동작, 도구 호출 호환성을 확인하세요. 롤백 옵션을 확보해 두세요.
GLM-5.4가 공식적으로 가용해지면 모델 ID, 지원 파라미터, 컨텍스트 한도, 엔드포인트 호환성을 검증하세요. 동일한 평가 데이터셋으로 구모델과 신모델을 실행하며 성공률, 지연시간, 출력 토큰, 도구 호출 실패, 성공적 실행당 비용을 추적하세요.
What Could GLM 5.4 API Pricing Look Like?
공식 GLM-5.4 API 가격은 발표되지 않았습니다. 그러므로 구체적인 입력·출력 토큰 요율을 실제 유출처럼 게시하는 것은 오해의 소지가 있습니다.
현재 GLM 제품군은 모델 크기만으로 가격을 예측하기 어렵다는 점을 보여줍니다. GLM-5.3-Flash는 상당히 낮은 추론 비용으로 경쟁력 있는 인텔리전스를 제공하도록 설계된 아키텍처 최적화를 도입했습니다.
Z.ai의 Artificial Analysis Intelligence Index v4.1.1 비교는 GLM-5.3-Flash가 작업당 추정 할인 비용 $0.045에서 57점을 기록했다고 보고합니다. 이 평가 비용은 입력/출력 토큰 요금제가 아니며 GLM-5.4 가격을 예측하지도 않습니다.
향후 GLM-5.4 가격은 아키텍처, 추론 노력, 캐시된 토큰 할인, 호스팅 인프라, 변형에 따라 달라질 수 있습니다. 프로덕션 계획에서는 최저 입력 토큰 단가보다 성공적으로 완료된 작업당 비용이 더 가치 있을 때가 많습니다.
Should Developers Wait for GLM 5.4?
대부분의 개발자에게 발표되지 않은 모델을 기다릴 필요는 없습니다. 기존 GLM 모델은 실제 애플리케이션에서 테스트 가능한 문서화된 코딩 및 에이전틱 역량을 제공합니다.
코딩 어시스턴트나 다단계 엔지니어링 에이전트를 구축하는 팀은 GLM-5.3으로 기준선을 수립할 수 있습니다. 시각적 이해, 긴 컨텍스트, 효율적 반복 호출을 강조하는 애플리케이션은 GLM-5.3-Flash를 평가할 수 있습니다.
지금 평가 하네스를 구축하고 GLM-5.4를 위한 향후 비교 슬롯을 비워 두세요. 제공 가능해질 때, 특정 애플리케이션에 중요한 결과를 개선한다면 그 출시가 의미가 있을 것입니다.
연구자는 새로운 베이스 아키텍처, 장기 지평 벤치마크의 변화, 종단간 신뢰도를 주시해야 합니다. 기업은 대표적 프로덕션 데이터에서의 가용성, 비용, 지연시간, 호환성, 품질을 우선해야 합니다.
Conclusion
GLM 5.4는 Z.ai의 빠르게 진화하는 모델 계열에서 개연성 있는 다음 단계이지만, 현재 내러티브는 확인된 사실보다 추정에 가깝습니다.
Union Alpha는 검증되지 않은 정체성 단서이며, 릴리스 주기는 넓은 시계열 가설만을 뒷받침합니다. 둘 다 출시일을 확립하지 못합니다. 2026년 10월 14일 검토한 공식 소스는 기존 모델의 기준선을 제공할 뿐, 확인된 GLM-5.4 출시를 제공하지 않습니다.
검증 가능한 것은 GLM-5.3과 GLM-5.3-Flash가 이미 이룬 진전입니다. 에이전틱 코딩, 사이버보안 평가, 추론 효율에서의 유의미한 향상은 후속작에게 높은 기준선을 제시합니다.
핵심 질문은 Z.ai가 신뢰할 수 있는 자율 실행, 더 강한 추론, 경쟁력 있는 작업 단위 비용을 제공할 수 있는가입니다. 공식 스펙과 벤치마크가 나타나기 전까지 GLM-5.4는 이용 가능한 제품이 아닌 잠재적 릴리스로 취급되어야 합니다.
FAQ
How can I verify a GLM 5.4 API listing?
제공자가 호출 가능한 모델 식별자, 지원 엔드포인트, 접근 조건, 최신 가격을 제공하는지 확인하세요. 그런 다음 이를 Z.ai의 공식 발표나 문서와 대조하세요. 제공자 목록은 그 제공자의 오퍼링을 확립할 수 있지만, 익명 모델의 기반 개발자를 자체적으로 인증하지는 않습니다.
Which compatibility checks matter before a GLM 5.4 migration?
요청 파라미터, 추론 설정, 도구 호출 스키마, 구조화 출력, 스트리밍 동작, 컨텍스트 한도, 최대 출력이 실제 엔드포인트에서 유효한지 검증하세요. 지원되지 않는 파라미터에 대한 네거티브 테스트를 포함하고, 롤백을 위해 기존 모델을 유지하세요. OpenAI 호환성은 인터페이스를 설명할 뿐, 동일한 모델 동작을 보장하지 않습니다.
How should I evaluate GLM 5.4 for coding agents?
동일한 도구, 권한, 타임아웃, 하네스를 사용해 대표적 리포지토리 과제의 고정 세트로 평가하세요. 성공적으로 테스트된 변경, 도구 실패로부터의 복구, 토큰 사용량, 지연시간, 총 비용을 집계하세요. 모든 실행을 기록하고 충분한 반복으로 변동성을 드러내며, 유리한 사례 한 건만을 홍보하지 마세요.
What would justify waiting for GLM 5.4?
이용 가능한 모델로 충족할 수 없는 요구를 다루는 문서화된 향후 역량이 있고, 지연이 일정에 부합할 때만 기다릴 이유가 있습니다. 소문만 있는 상황이라면, 이용 가능한 모델을 기반으로 구축하고 모델 선택을 구성 가능하게 유지하세요. 이후 릴리스가 기준선을 대체하기 위해 충족해야 할 역량 및 비용 임계값을 정의하세요.