MiniMax M3.1 Flash는 까다로운 코딩 및 에이전트 워크플로우에 오픈 가중치 AI를 제공하지만, 로컬 실행에는 상당한 하드웨어가 필요합니다. 428B 파라미터 MoE 아키텍처는 토큰당 23B 파라미터만 활성화하여 연산을 줄이지만, 전체 모델 저장 필요는 제거하지 않습니다. 지원되는 멀티 GPU 시스템을 보유한 개발자는 vLLM 또는 SGLang으로 배포할 수 있습니다. 인프라 관리를 건너뛰고 싶다면 CometAPI의 MiniMax M3.1 Flash API가 더 간단한 시작 경로를 제공합니다.
Key Takeaways
하드웨어가 가장 큰 장벽입니다. 공개된 vLLM 구성은 지원되는 Blackwell 또는 AMD MI355X GPU 4개, 혹은 H100/H200 GPU 8개를 사용합니다.
롱 컨텍스트에는 메모리 비용이 따릅니다. 모델은 최대 100만 토큰을 지원하지만, 실질적인 서빙 한계는 사용 가능한 GPU 메모리와 동시성에 따라 달라집니다.
배포는 하드웨어별입니다. 범용 설치 명령 대신 호환되는 추론 엔진, 양자화 형식, 가속기 구성을 사용해야 합니다.
벤치마크는 출발점일 뿐입니다. 자체 워크로드에서 코딩 정확도, 에이전트 작업 완료율, 지연 시간, 처리량을 평가하세요.
로컬과 호스티드 추론은 서로 다른 니즈를 충족합니다. 셀프 호스팅은 인프라 제어를, API는 초기 설정 복잡성과 유지보수 부담을 줄여줍니다.
What Is MiniMax M3.1 Flash?
MiniMax M3.1 Flash는 텍스트, 이미지, 비디오 입력을 받아 텍스트를 생성합니다. 코딩, 자동화, 컴퓨터 상호작용, 보안 워크플로우를 위해 설계되었습니다. 가중치는 MiniMax Community License로 배포됩니다. 상업적 서비스를 제공하기 전에는 체크포인트에 포함된 라이선스를 읽고, 귀하의 사용에 적용되는 조건을 확인하세요.
MiniMax M3.1 Flash specifications
Specification
MiniMax M3.1 Flash
Developer
MiniMax
Model family
Native multimodal MoE
Total parameters
Approximately 428B
Active parameters
Approximately 23B per token
Maximum context
1,048,576 tokens (model capability)
Input types
Text, images, and video (route dependent)
Output
Text
Attention
MiniMax Sparse Attention in every layer
Quantization
MXFP8 dense layers / NVFP4 experts
Draft decoding
DSpark integrated draft head
Reasoning effort
Low, medium, high, xhigh, max
Reported output speed
200+ tokens/s in favorable conditions; P50 170+ tokens/s
License
MiniMax Community License
Documented inference
vLLM, SGLang
Typical topology
4 supported Blackwell or MI355X GPUs; 8 H100/H200 GPUs
How does MiniMax M3.1 Flash use its 428B/23B architecture?
Mixture-of-Experts(MoE) 모델은 각 토큰을 선택된 전문가로 라우팅합니다. MiniMax M3.1 Flash에서는 토큰당 약 23B 파라미터가 활성화되며, 전체 파라미터 풀은 약 428B입니다. 스파스 활성화는 연산량을 줄이지만 체크포인트를 조밀한 23B 모델로 바꾸지는 않습니다.
What Changed in MiniMax M3.1 Flash?
Sparse attention: 긴 입력에서의 어텐션 작업을 줄이도록 모델 전반에 적용되었습니다. 이점은 서빙 커널과 프롬프트에 따라 달라집니다.
Mixed-precision weights: MXFP8의 조밀 구성요소와 NVFP4 전문가로 저장 및 연산 부담을 낮추지만, 여전히 호환 하드웨어와 커널이 필요합니다.
DSpark decoding: 지원 레시피에서 통합 draft head가 생성 속도를 높일 수 있으나, 토큰 수용률과 워크로드에 따라 달라집니다.
Power-aware serving: 인프라 수준의 스케줄링이 활용도를 높일 수 있지만, 가중치를 다운로드했다고 자동으로 활성화되는 기능은 아닙니다.
What Hardware Is Needed for MiniMax M3.1 Flash?
GPU 메모리는 네 부분으로 예산을 잡으세요: 체크포인트 가중치, 이전 토큰용 KV 캐시, 런타임 버퍼, 워크로드 헤드룸. 아래 추정치는 원시 파라미터 저장만을 다룹니다. 혼합 정밀도, 양자화 스케일, 멀티모달 구성요소, 서빙 오버헤드는 실제 요구량을 변경합니다.
Validated GPU topologies
Accelerators
Published topology
Notes
NVIDIA GB200/GB300/B200/B300
4 GPUs, tensor parallel
Blackwell NVFP4-native path
NVIDIA H100/H200
8 GPUs, tensor parallel
FP8 caches and Marlin MoE path
AMD MI355X
4 GPUs, tensor parallel
Requires supported ROCm and AITER settings
24–32 GB consumer GPU
No full-checkpoint reference recipe
Not sufficient for simple single-GPU loading
CPU-only workstation
No validated practical deployment
Offloading experiments are not production guidance
메모리 추정: 428B 파라미터의 원시 저장 용량은 BF16에서 약 856 GB, 8-bit에서 428 GB, 이상화된 4-bit에서 214 GB입니다. 공식 체크포인트는 형식을 혼합하므로, 이 수치는 런타임 VRAM 요구가 아닙니다. 양자화 스케일, KV 캐시, 런타임 버퍼, 동시성을 고려하고, 시스템 용량 산정에는 실제 체크포인트 파일과 GPU용 레시피를 사용하세요.
체크포인트, 임시 다운로드, 롤백 복사본을 위한 NVMe 공간을 확보하세요.
Which Deployment Method Should You Choose?
지원되는 로컬 클러스터에서는 vLLM이 참고 구성과 익숙한 API 통합을 제공하는 실용적인 출발점입니다. 호환성을 확인한 뒤 서빙 커스터마이징을 탐색하는 팀에는 SGLang이 적합하고, CometAPI는 호스티드 경로로 프로토타이핑과 모델 전환을 간소화합니다.
Requirement
Local vLLM
Local SGLang
CometAPI
Weights and GPUs
가중치 다운로드; 지원 GPU 운영
가중치 다운로드; 지원 GPU 운영
제공자 관리 추론; 로컬 가중치 불필요
Blackwell / AMD MI355X
하드웨어별 레시피
하드웨어별 레시피
하드웨어는 제공자 관리
H100/H200
문서화된 8-GPU 레시피
최신 지원 매트릭스 확인
하드웨어는 제공자 관리
Decoding and parallelism
지원 경로에서 DSpark; 텐서·분산 서빙
하드웨어별 디코딩; 텐서·전문가 병렬화
라우트에서 노출된 옵션으로 제한
Control and data processing
귀하의 환경; 스케일링 직접 관리
귀하의 환경; 스케일링 직접 관리
외부 제공자; 스케일링은 제공자 관리
귀하의 하드웨어에 대해 검증된 레시피가 있는 프레임워크를 선택한 뒤, 동일한 프롬프트·정밀도·동시성으로 지연 시간과 처리량을 비교하세요.
How to Run MiniMax M3.1 Flash Locally With vLLM?
다음 단계는 공식 체크포인트에 접근 가능하며, 호환되는 NVIDIA Blackwell GPU 4개, 지원 드라이버/CUDA 환경이 갖춰진 Linux 호스트를 전제로 합니다. 검증된 vLLM 빌드를 사용하세요. 지원되지 않는 GPU 하드웨어에서 일반 설치는 패키지 설치는 성공하더라도 실행에 실패할 수 있습니다.
서버가 로딩을 마치고 준비 완료를 보고할 때까지 기다렸다가 요청을 보내세요. 위 명령은 초기 스모크 테스트를 위해 컨텍스트를 32,768 토큰, 동시 시퀀스를 4로 제한합니다. 이 축소된 한계는 벤치마크 설정이 아니며, 하드웨어의 메모리 사용량과 요청 동작을 측정한 뒤 조정하세요.
예시는 로컬 테스트를 위해 127.0.0.1에서 수신합니다. 원격 클라이언트를 연결하기 전에 엔드포인트 앞에 접근 제어를 두고, 클라이언트 타임아웃, 제한된 재시도, 모니터링을 구성하세요.
H100/H200 variant: use the eight-GPU Hopper recipe
H100/H200 GPU 8개에서는 Blackwell NVFP4 구성 대신 Hopper 전용 FP8 캐시와 Marlin MoE 경로를 사용하세요. 아래 명령은 공식 vLLM Hopper 레시피를 따르며, 초기 테스트를 위해 컨텍스트와 동시성을 각각 32K와 4 시퀀스로 줄였습니다. 해당 레시피에 맞춰 비디오 입력을 비활성화합니다. 이 엔드포인트는 기존 접근 제어 뒤에 두세요.
SGLang은 하드웨어 전용 M3.1 배포 레시피와 OpenAI 호환 서빙을 제공합니다. 10월 23일 스냅샷 기준으로 문서에는 전용 개발 컨테이너 이미지가 포함되어 있으므로, 일반 SGLang 설치에 모든 모델 전용 지원이 포함되어 있다고 가정하면 안 됩니다.
Pull the dedicated container image
# NVIDIA development image
docker pull lmsysorg/sglang:dev-minimax-m31-flash

# AMD MI350X/MI355X development image
docker pull lmsysorg/sglang:dev-minimax-m31-flash-mi35x
다음으로, 가속기에 맞는 SGLang MiniMax M3.1 쿠크북을 따르세요. 이미지를 풀하면 런타임만 내려받으며, GPU 접근 권한으로 컨테이너를 시작하고 그 안에서 일치하는 서빙 구성을 실행해야 합니다. 쿠크북의 전체 하드웨어 전용 명령을 사용하고 준비 완료를 기다린 다음, 테스트 요청을 보내기 전에 엔드포인트의 모델 목록을 조회하세요. 문서화된 NVIDIA와 AMD 경로는 서로 다른 의존성을 사용하므로 별도로 구성해야 합니다.
How Does MiniMax M3.1 Flash Compare on Benchmarks?
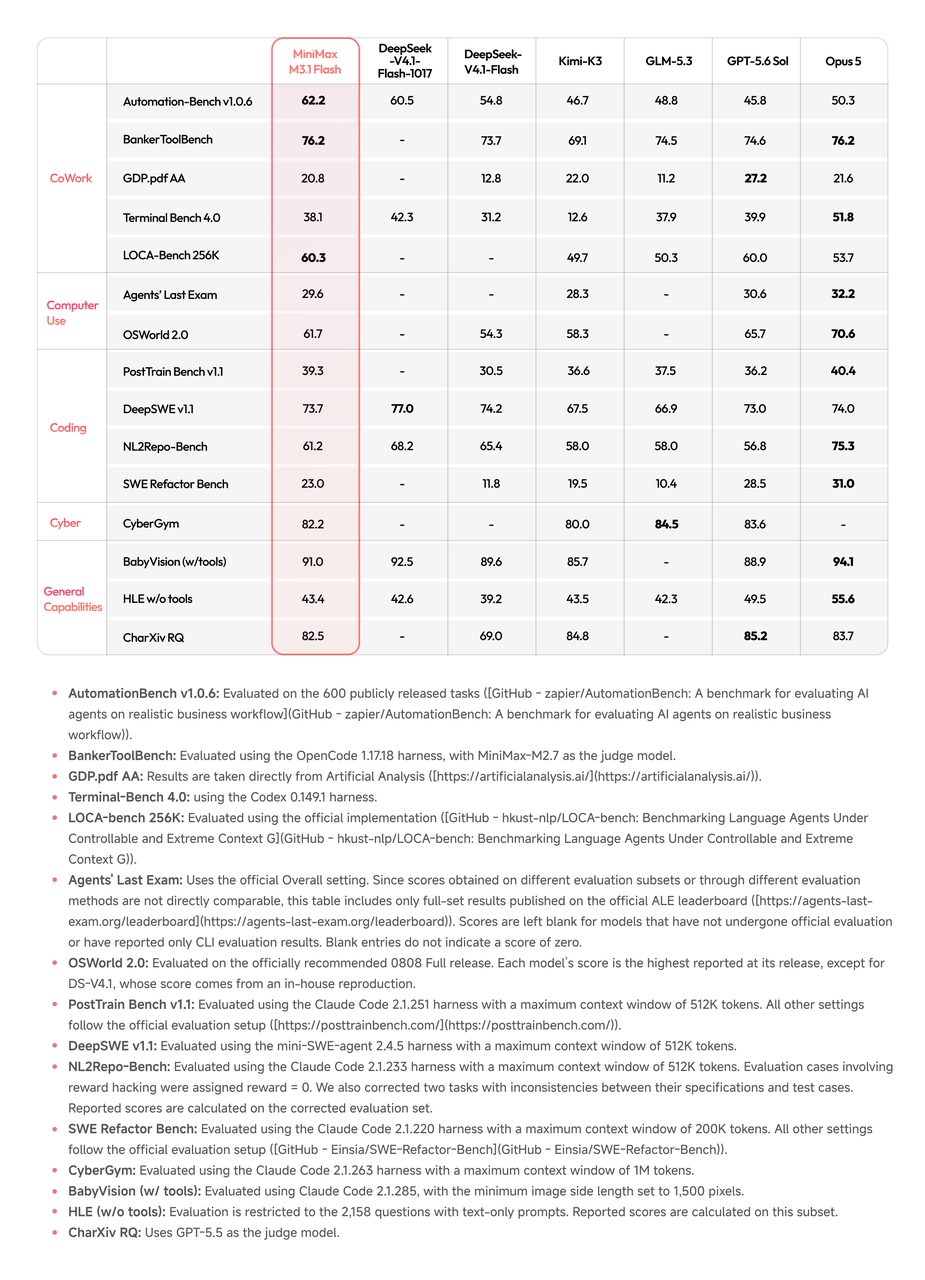
엔드포인트가 기본 점검을 통과하면, 다음에 테스트할 워크로드를 결정하기 위해 공개된 벤치마크를 활용하세요. 아래 수치는 귀하의 로컬 배포 측정이 아닌 벤더 공개 평가입니다.
Benchmark
M3.1 Flash
DeepSeek V4.1 Flash 1017
Kimi K3
Automation-Bench v1.0.6
62.8
60.5
46.7
DeepSWE v1.1
73.7
77.0
67.5
Terminal Bench 4.0
38.1
42.3
12.6
OSWorld 2.0
61.7
N/A
58.3
NL2Repo-Bench
61.2
68.2
58.0
BabyVision with tools
91.0
92.5
85.7
이 비교에서 MiniMax는 Automation-Bench에서, DeepSeek은 여러 코딩 벤치마크에서 앞섭니다. 성급한 결론을 내리기 전에 모델 카드와 평가 설정을 읽고, 실제 애플리케이션이 사용하는 프롬프트와 도구를 테스트하세요. 서로 다른 벤치마크 버전이나 설정의 점수는 직접 비교할 수 없습니다.
How Can You Optimize MiniMax M3.1 Flash Performance?
Control context and concurrency
첫 성공 요청 이후에는 입력 길이, 출력 길이, 동시 요청 중 한 변수씩만 늘리세요. 각 실행의 피크 메모리와 응답 지연을 기록합니다. 실패한 실험이 새로운 기준선이 되지 않도록 마지막으로 안정적인 설정을 롤백 포인트로 유지하세요.
Choose reasoning effort deliberately
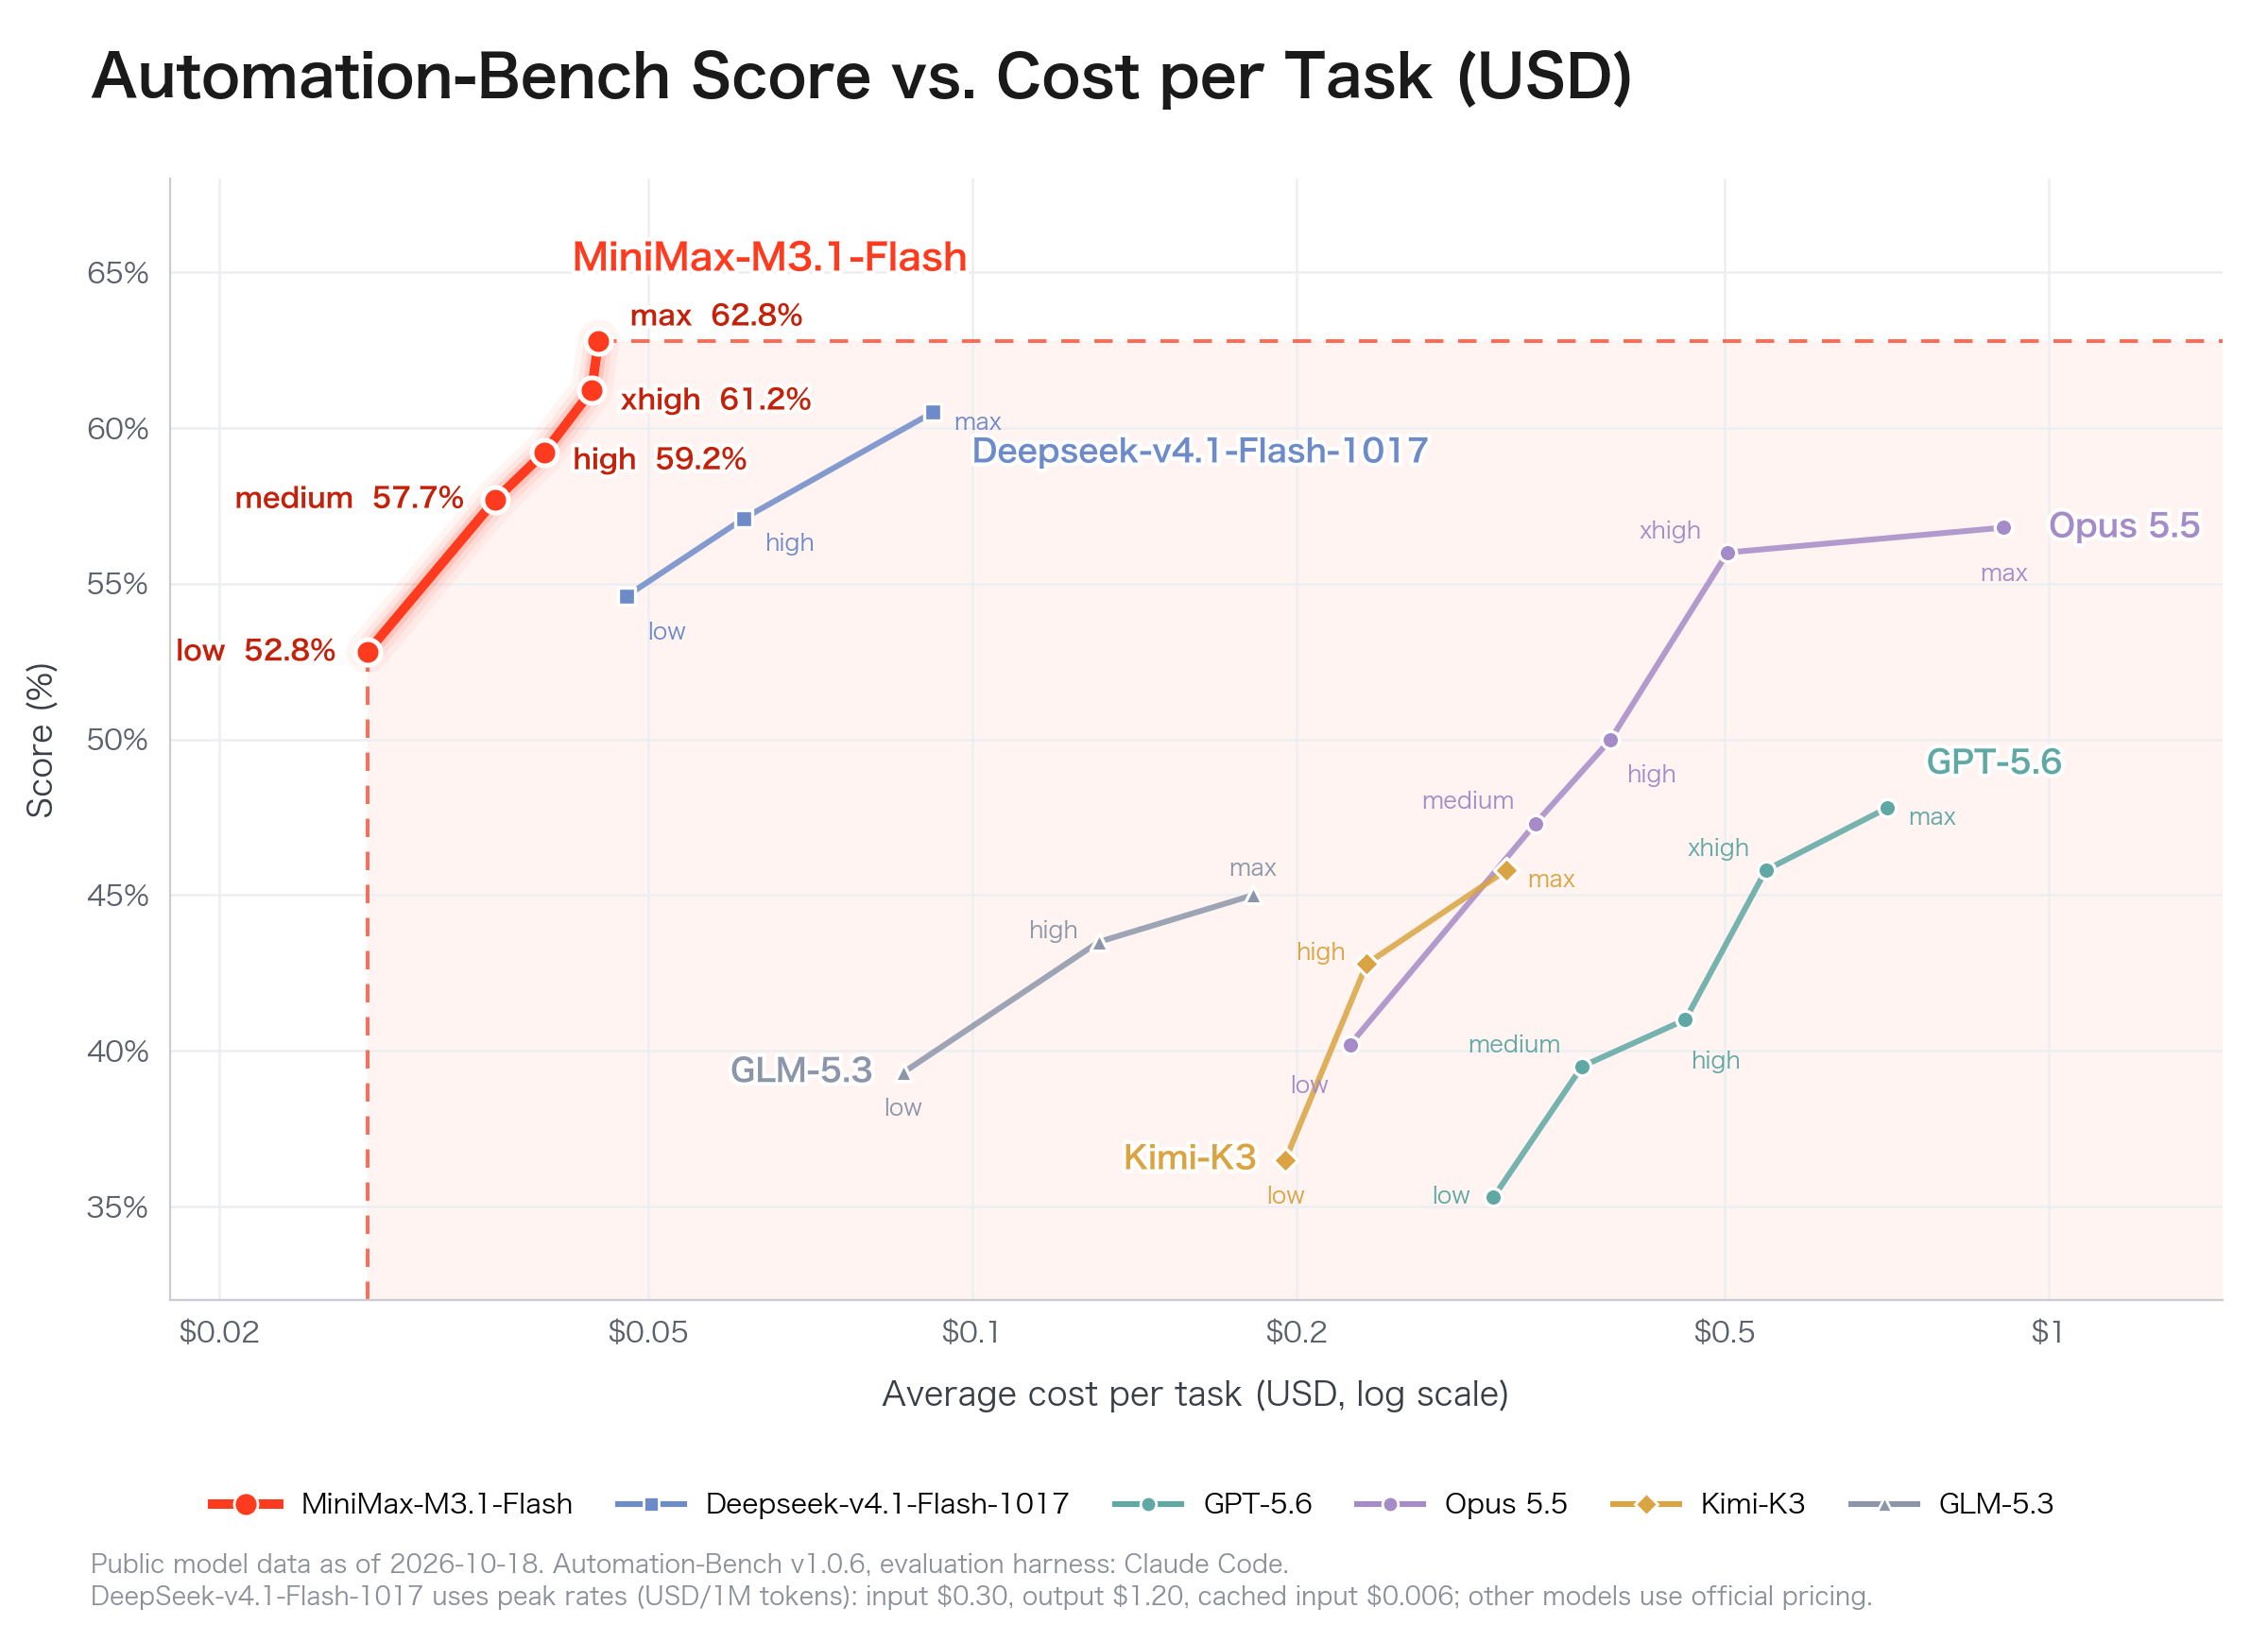
M3.1 Flash는 low, medium, high, xhigh, max를 지원합니다. 더 높은 설정은 까다로운 작업 점수를 향상시킬 수 있지만, 더 많은 추론 토큰과 긴 지연을 요구하는 경우가 많습니다. 작업 완료 품질과 소요된 연산 비용을 함께 보세요.
로컬 vLLM 요청에서는 레시피의 chat_template_kwargs 아래에 reasoning-effort 설정이 표시됩니다. 호스티드와 로컬 엔드포인트가 이러한 필드를 다르게 노출할 수 있으므로, 클라이언트를 검증할 때 최종 답변과 별도로 반환되는 reasoning 필드 모두를 확인하세요.
Track cost per completed task
에이전트의 경우 초당 토큰 수만으로는 충분하지 않습니다. 첫 토큰까지의 시간, 출력 속도, 추론 사전검증 디코딩 수용률, 동시 처리량, 도구 호출 실패율, 메모리 활용도, 완료된 작업당 비용을 기록하세요. 느리더라도 실패한 도구가 적다면 전체 경제성이 더 나을 수 있습니다.
How Can You Use MiniMax M3.1 Flash API in CometAPI?
전용 가속기 인프라가 불필요한 팀은 OpenAI 호환 호스티드 엔드포인트를 사용할 수 있습니다. 이는 체크포인트 다운로드와 GPU 운영을 제거하지만, 요청 처리를 셀프 호스팅 환경 외부로 옮깁니다.
실행 전에 CometAPI 콘솔에서 모델 식별자를 확인하세요. 제공자 간 공통 API가 애플리케이션에 도움이 될 때 게이트웨이를 사용하고, 예상 사용량에 대해 현재 견적을 직접 액세스와 비교하세요.
MiniMax M3.1 Flash API pricing
Price per million tokens
MiniMax official API
CometAPI
Input
$0.15
$0.80
Output
$0.60
$3.20
Cached input
$0.015
현재 라우트 견적 확인
2026년 10월 19일 출시 공지 기준 MiniMax 직통 API 요금은 입력 $0.15, 출력 $0.60, 캐시된 입력 $0.015(백만 토큰당)입니다. CometAPI의 경우 활성 모델 라우트, 입력/출력 요금, 캐싱 규칙, 계정 할인 여부를 확인한 뒤 지출을 추정하세요. 예상 토큰 믹스와 재시도를 고려해 총비용을 비교하세요.
What Problems Might Occur When Running MiniMax M3.1 Flash?
Out of memory during loading or requests
가중치 로딩 실패 시: 시작 로그에서 실패 단계 확인, 체크포인트 완전성 검증, GPU 토폴로지와 양자화 백엔드가 레시피와 일치하는지 점검하세요. 가중치가 사용 가능한 메모리를 초과하면 용량이 충분한 구성이 필요합니다. 요청을 줄여도 가중치 로딩 실패는 해결되지 않습니다.
가중치는 로딩되지만 시작 시 캐시 할당 실패: 캐시 설정과 사용 가능한 메모리를 확인한 뒤, 레시피에 맞춰 컨텍스트나 동시성을 줄이세요.
서버는 시작되지만 요청 중 OOM: 짧은 프롬프트를 단일 요청으로 재시도한 다음, 메모리를 모니터링하며 입력 길이, 출력 길이, 동시성을 각각 늘리세요.
Incompatible quantization or attention kernels
NVFP4 실행은 Blackwell, Hopper, AMD 하드웨어 간에 다릅니다. 추론 엔진 버전, 양자화 백엔드, CUDA/ROCm 버전, 가속기 계열을 일치시키고, 플래그를 무분별하게 재사용하지 마세요.
Sparse-attention cache configuration
시작 시 지원되지 않는 캐시 레이아웃이 보고되면, 하드웨어별 레시피와 전체 캐시 구성을 비교하세요. 현재 vLLM 레시피는 MSA 스파스/인덱스 캐시에 대해 --block-size 128을 요구합니다. 시작 시 캐시 레이아웃이나 블록 크기 오류가 보고되면, 하드웨어별 레시피와 전체 구성을 비교하세요.
Unexpected model identifiers
로컬 경로와 원격 게이트웨이의 모델 이름은 동일하지 않을 수 있습니다. 로컬 /v1/models 응답을 조회하고, 다른 엔드포인트의 가정을 하드코딩하지 마세요.
Poor observed throughput
느린 프롬프트 처리와 느린 토큰 생성을 구분하세요. 동일한 입력 길이·출력 제한으로 비교 실행 후, 배치 크기를 늘리기 전에 GPU 활용도와 인터커넥트 동작을 확인하세요. 제공자 호스팅 속도 수치는 로컬 클러스터의 기준선이 아닙니다.
Conclusion
오늘 운용 가능한 하드웨어에서 첫 배포 경로를 선택하세요. 지원되는 로컬 클러스터에는 vLLM 워크스루를, 대안 서빙 스택에는 하드웨어별 SGLang 쿠크북을, 애플리케이션 통합에 집중하고 싶다면 호스티드 API를 사용하세요. 작업 품질과 지연 목표를 지속 가능한 운영 비용으로 충족하는 구성을 유지하세요.
가장 신뢰할 수 있는 서빙 방법 선택 기준은 최대 토큰/초가 아니라, 달러와 시간당 “정확히 완료된 작업”입니다.
FAQ
How do I make a deployment reproducible after upgrading the runtime?
체크포인트 리비전, 런타임 이미지 또는 패키지 버전, 드라이버 스택, 실행 설정을 고정하세요. 각 업그레이드 전후로 동일한 소규모 인수 테스트를 수행하고, 롤백을 위해 이전의 동작 구성을 유지하세요.
How should I handle retries when an agent calls tools?
모델 재시도와 도구 동작 반복을 분리하세요. 상태 변경 작업에는 멱등성 키를 사용하고, 첫 시도가 성공했는지 확인하며, 실행 전에 도구 인자를 완전하게 검증하세요.
Can I switch between a local endpoint and CometAPI without changing application behavior?
엔드포인트, 자격 증명, 모델 ID를 구성 가능하게 유지하세요. 스트리밍, 도구 호출, reasoning 필드, 멀티모달 입력을 양쪽 라우트에서 테스트하고, 폴백을 활성화하기 전에 데이터 라우팅 요구사항을 확인하세요.
What should I test before accepting multimodal inputs?
대표적인 이미지와 비디오(저품질 및 미지원 파일 포함)를 테스트하세요. 전처리, 크기 한도, 답변 품질, 타임아웃을 각각 확인하세요. 텍스트 요청 성공은 멀티모달 경로를 검증하지 않습니다.
How do I know whether a deployment is ready for real users?
작업 성공률, 유효 도구 호출, 지연, 오류, 비용 목표를 설정하세요. 현실적인 트래픽을 테스트하고, 모니터링과 폴백 동작을 검증한 뒤, 이러한 목표가 유지되는 동안에만 점진적으로 롤아웃을 확대하세요.