
요약
Kimi K3.1 Pro는 Moonshot AI가 2026년 10월 24일에 공개한 Kimi K3 업그레이드입니다. 추가 사후 학습을 통해 약 100만 토큰 수준의 동일한 컨텍스트 용량을 유지하면서 자율 코딩, 금융 리서치, 확장된 도구 사용 워크플로에 대한 성능이 개선되었습니다.
독립 평가에서는 전반적 성능 향상이 확인되었으며, 표준 공식 입출력 토큰 단가는 3분의 1 하락했습니다. 다만 더 깊은 추론은 작업 지연과 총 비용을 높일 수 있으므로 워크로드 테스트가 필요합니다. 또한 K3는 AA-LCR에서 근소한 우위를 유지하며, 자체 호스팅 가능한 가중치는 현재 K3가 즉시 이용 가능합니다.
핵심 요약
- 강점이 가장 뚜렷한 영역은 에이전틱 실행입니다. Artificial Analysis는 Terminal-Bench 4.0 점수가 K3 대비 K3.1 Pro가 약 13%에서 약 67%로 상승했다고 보고합니다. Moonshot의 내부 Financial Research 점수도 58.8에서 70.4로 상승했습니다.
- 더 낮은 토큰 가격이 더 낮은 작업 비용을 보장하지는 않습니다. 표준 공식 입력/출력 단가는 백만 토큰당 $3/$15에서 $2/$10으로 낮아졌지만, 추가 추론, 도구 호출, 재시도가 절감 효과를 상쇄할 수 있습니다.
- 컨텍스트 윈도는 동일합니다. 두 모델 모두 최대 1,048,576 토큰을 지원합니다. 인용된 AA-LCR v1.1 평가에서는 K3가 소폭 앞서므로, 자체 문서로 장문맥 정확도를 테스트하십시오.
- 가중치 제공 여부가 선택을 좌우할 수 있습니다. 2026년 10월 24일 기준으로 K3 가중치는 제공 중이며, K3.1 Pro 가중치는 11월 4일까지 공개 예정입니다. 즉시 자체 호스팅이 필요한 팀은 이 차이를 고려해야 합니다.
Kimi K3.1 Pro vs Kimi K3: 개요와 사양
Kimi K3.1 Pro는 K3를 기반으로 추가 사후 학습을 통해 코딩, 금융 리서치, 확장된 에이전트 워크플로에 초점을 맞춰 개선되었습니다. 두 모델 모두 약 100만 토큰의 컨텍스트를 유지합니다. 주요 차이는 작업 성능, 토큰 가격, 서빙 옵션, 가중치 제공 여부입니다.
| Specification | Kimi K3.1 Pro | Kimi K3 |
|---|---|---|
| Developer | Moonshot AI | Moonshot AI |
| Release date | October 24, 2026 | July 16, 2026 |
| Architecture | K3-derived MoE, further post-trained | MoE with KDA, AttnRes |
| Model size | 3T-class and 104B active parameters | 2.8T total and 104B active parameters |
| Context window | Up to 1,048,576 tokens | Up to 1,048,576 tokens |
| Standard API input / output price | $2 / $10 per million tokens | $3 / $15 per million tokens |
| Highspeed version | Available | No separate K3 Highspeed variant is listed |
| Weight availability | Release planned by November 4, 2026 | Available under the Kimi K3 License |
가중치 제공 여부는 2026년 10월 24일 기준 정보입니다. API 가격은 캐시 쓰기 요금, 세금 및 기타 적용 수수료를 제외한 일반 입력 및 출력에 대한 USD 기준입니다.
아키텍처와 사후 학습
K3는 Kimi Delta Attention, Attention Residuals, Stable LatentMoE를 결합한 2.8조 파라미터 아키텍처를 도입했습니다. 토큰당 약 1,040억 개의 활성 파라미터를 사용합니다.
Moonshot은 K3.1 Pro를 K3에 대해 사후 학습을 대폭 늘려 개발한 버전으로 설명합니다. 이번 업그레이드는 도구 사용, 디버깅, 결과 검증 등 다단계 작업에 모델의 능력을 적용하는 데 초점을 맞춥니다. 별도의 명명된 기반 아키텍처는 발표되지 않았습니다.
공통 기능과 API 요구사항
두 모델 모두 멀티모달 입력, 도구 호출, 구조화된 출력, 컨텍스트 캐싱을 지원합니다. 이미지 및 비디오 입력 형식은 선택한 API 경로에 따라 달라집니다. 두 모델 모두 항상 추론을 수행하며, low, high, max 추론 강도를 지원하고 기본값은 max입니다.
멀티턴 대화와 도구 호출의 경우, 통합에서는 API 요구에 따라 추론 내용과 도구 호출을 포함한 전체 assistant 메시지를 보존해야 합니다. 실제 컨텍스트 한계와 기능 제공 여부는 선택한 공급자, 제품, 구독 등급에 대해 별도로 확인해야 합니다.
Kimi K3.1 Pro vs Kimi K3: 성능
근거는 Moonshot의 내부 테스트와 보고된 비교, 그리고 독립적인 서드파티 평가에서 나옵니다.
벤치마크 하니스, 테스트 세트, 추론 설정, 채점 기준이 다를 수 있으므로 각각 별도로 해석해야 합니다.
Artificial Analysis의 출시 평가는 복합 Intelligence Index에서 11포인트 상승을 보고했으며, 특히 터미널 기반 코딩과 에이전트 워크플로에서 큰 개선이 있었습니다.
| Independent Benchmark (Artificial Analysis) | Kimi K3 | Kimi K3.1 Pro | Difference |
|---|---|---|---|
| Intelligence Index | 44 | 55 | +11 |
| Terminal-Bench 4.0 | ~13% | ~67% | +54 퍼센트포인트 |
| AutomationBench-AA | 58% | 73% | +15 퍼센트포인트 |
| GDPval-AA Elo | 1,534 | 1,846 | +312 |
| AA-Omniscience Index | 20 | 30 | +10 |
| Humanity's Last Exam | ~47% | ~52% | +5 퍼센트포인트 |
| AA-Omniscience hallucination rate | 53% | 44% | −9 퍼센트포인트 |
| AA-LCR v1.1 | 88.7% | 86.3% | −2.4 퍼센트포인트 |
이는 독립 평가 결과입니다. 평가자가 반올림한 점수를 보고하는 경우 반올림된 값을 사용했습니다. 환각률은 낮을수록 좋습니다.
가장 큰 개선은 터미널 기반 코딩에서 나타납니다. K3.1 Pro는 명령 실행, 환경 상호작용, 디버깅, 반복 검증을 요구하는 작업에서 크게 더 뛰어난 성능을 보입니다.
AutomationBench-AA 역시 유의미한 상승을 보여, SaaS 워크플로에서의 실행력이 강화되었음을 시사합니다.
Moonshot의 출시 벤치마크는 코딩, 과학, 3D 재구성, 금융, 지식 작업, 자율 에이전트를 중심으로 합니다.
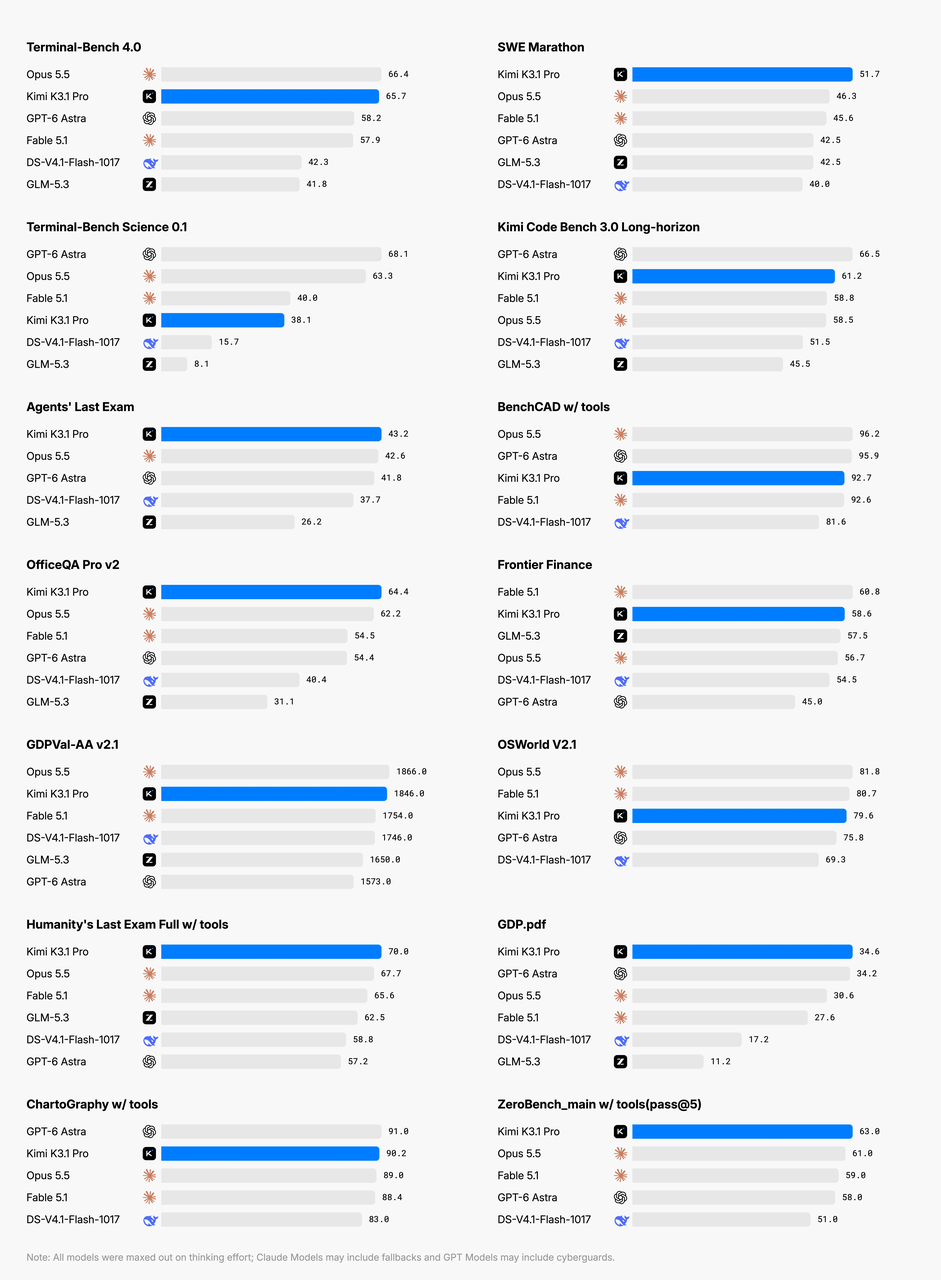
선정된 비교에는 Claude Opus 5.5와 GPT-6 Astra가 포함됩니다. 각 결과는 명시된 벤치마크와 설정 내에서 비교하십시오.
| Benchmark (Moonshot AI) | Kimi K3.1 Pro | Other Model | Comparison Model Score |
|---|---|---|---|
| Terminal-Bench 4.0 | 65.7% | Claude Opus 5.5 | 66.4% |
| Terminal-Bench 4.0 | 65.7% | GPT-6 Astra | 58.2% |
| SWE-Marathon | 51.7% | Claude Opus 5.5 | 46.3% |
| Kimi Code Bench 3.0 | 61.2% | GPT-6 Astra | 66.5% |
| BenchCAD with tools | 92.7% | Claude Opus 5.5 | 96.2% |
| OfficeQA Pro v2 | 64.4 | Claude Opus 5.5 | 62.2 |
| Frontier Finance | 58.6 | Claude Opus 5.5 | 56.7 |
| OSWorld 2.1 | 79.6% | Claude Opus 5.5 | 81.8% |
K3.1 Pro는 선택된 작업에서 여러 선도적 독점 모델에 근접하거나 능가합니다. 하지만 모든 범주에서 우위를 점하는 것은 아닙니다.
예를 들어, 공급업체 보고 BenchCAD와 OSWorld 비교에서는 Claude Opus 5.5에 뒤처며, 공식 차트는 Terminal-Bench Science에서 더 큰 약점을 보여줍니다.
평가 설정은 다릅니다. Artificial Analysis는 Terminal-Bench 4.0에 mini-swe-agent 하니스를 사용하고, Moonshot은 Claude Code를 사용합니다. 동일한 테스트 설정에서 점수를 비교하십시오. 하니스, 추론 강도, 런타임 제한은 결과에 영향을 줄 수 있습니다.
코딩과 소프트웨어 엔지니어링
복잡한 자율 코딩에서는 일반적으로 K3.1 Pro가 더 강력한 선택입니다.
Moonshot의 내부 Kimi Code Bench 3.0 Long-horizon 결과는 K3의 55.95%에서 K3.1 Pro의 61.2%로 약 5.25 퍼센트포인트 상승했습니다.
독립적인 Terminal-Bench 결과 역시 큰 폭의 향상을 보여줍니다. 이 테스트는 저장소 이해, 파일 변경, 명령 실행, 오류 진단, 결과 검증 등 다단계 실행을 평가합니다.
K3.1 Pro는 다수 파일 개발, 자율 터미널 작업, 확장 디버깅에 더 적합한 후보입니다. 단순 코드 생성의 경우, 자체 작업에서 두 모델을 비교하십시오. 자체 호스팅이 즉시 필요할 때는 K3가 여전히 즉시 사용 가능한 옵션입니다.
중요한 차이점 중 하나는 코딩 벤치마크 점수가 에이전트 프레임워크에 크게 의존한다는 점입니다. 도구, 프롬프트, 런타임 한도, 테스트 환경이 결과에 영향을 줍니다.
프로덕션 소프트웨어 개발에서는 여전히 자체 저장소에 대한 정합 비교가 최선의 평가입니다.
금융 리서치와 비즈니스 운영
금융 모델링은 두 모델 간 비교가 가장 직접적으로 드러나는 영역입니다.
Moonshot은 스프레드시트 구성, 리서치 품질, 시뮬레이션 비즈니스 운영을 포함한 내부 평가에서 K3와 K3.1 Pro를 모두 테스트했습니다.
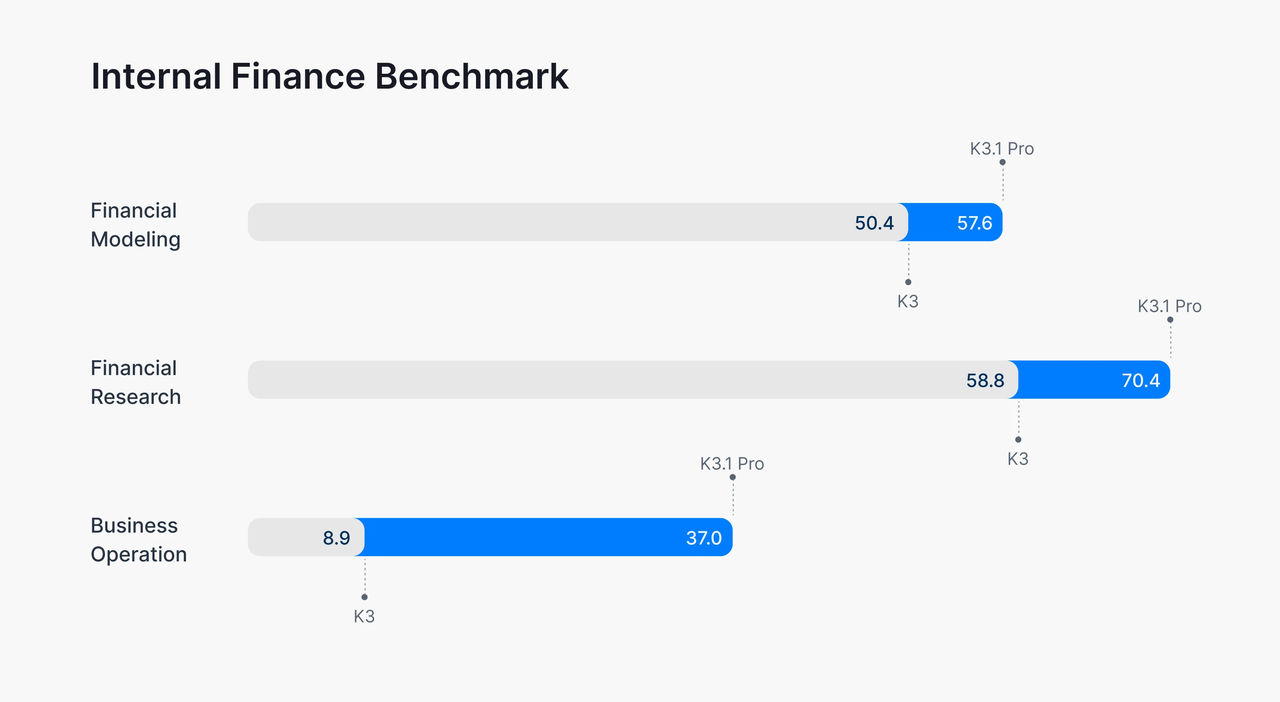
Moonshot의 내부 금융 결과는 금융 모델링, 리서치, 시뮬레이션 비즈니스 운영을 다룹니다. 이 공급업체 보고 과제 점수는 투자 수익률의 측정이 아닙니다. 각 과제 설정을 무관한 벤치마크에 동일하게 가정해서는 안 됩니다.
Moonshot의 내부 테스트에서 Financial Modeling은 50.4에서 57.6으로 7.2점 상승했고, Financial Research는 58.8에서 70.4로 11.6점 상승했습니다. Business Operation은 8.9에서 37.0으로 약 4.2배 상승했습니다.
이 벤치마크는 시뮬레이션된 비즈니스 환경에서 장기 관리 및 의사결정을 평가합니다. 따라서 단순한 금융 질의응답보다 에이전틱 기획과 더 밀접한 관련이 있습니다.
Financial Research는 출처 요구사항과 정보 컷오프를 준수하면서 근거 기반 리서치를 수행하는 능력을 측정합니다. Financial Modeling은 수학적 관계, 스프레드시트 로직, 워크북 품질에 초점을 둡니다.
이 패턴은 금융 업무에서 지속적 추론, 검증, 구조화된 결과물이 필요할 때 K3.1 Pro가 특히 가치가 큼을 시사합니다.
투자자, 애널리스트, 비즈니스 사용자에게 실무적 이점은 다문서 워크플로를 더 잘 처리할 가능성입니다. 어느 모델도 금융 의사결정을 위한 절대 권위로 사용되어서는 안 됩니다.
장문맥 추론과 사실 신뢰성
한편 AA-LCR 장문맥 결과에서는 K3가 약간 앞섭니다. 이는 최신 모델이 전반적으로 크게 개선되더라도 모든 특수 과제를 이기지는 못할 수 있음을 상기시켜 줍니다.
보고된 평가에서는 각 테스트 세트에서 사실 오류가 감소했습니다.
Kimi Hallu Bench Hard with tools에서 Moonshot은 클레임 단위 오류율이 K3의 23.4%에서 K3.1 Pro의 8.3%로 감소했다고 보고합니다.
이는 일상 오류율의 추정치가 아니라, Moonshot의 의도적으로 어려운 스트레스 테스트에서 약 65%의 상대적 감소를 의미합니다. 별개로, Artificial Analysis는 AA-Omniscience 환각률이 53%에서 44%로 하락했다고 보고합니다. 두 평가는 서로 다른 방법을 사용하므로 백분율을 직접 비교할 수는 없습니다.
실무적 교훈은 K3.1 Pro가 평가된 작업에서 더 신뢰할 수 있어 보이지만, 중대한 워크플로에서는 검색, 인용, 계산 검증, 인간 검토가 여전히 필요하다는 점입니다.
데이터 분석: Plotly의 평가 증거
Plotly는 OpenRouter를 통해 표준 K3.1 Pro를 대상으로 합성 풍력에너지 데이터 웨어하우스에 대한 43문항 비공개 테스트를 수행했습니다. Highspeed는 테스트하지 않았습니다. 결과는 해당 SQL 기반 분석 워크플로에서 답변 품질, 완료 시간, 비용 간의 트레이드오프를 보여줍니다.
| Plotly Data Analytics Measure | Kimi K3 | Kimi K3.1 Pro |
|---|---|---|
| Correct answers | 35/43 | 42/43 |
| Accuracy | 81.4% | 97.7% |
| Hidden patterns discovered | 0/5 | 5/5 |
| Data-quality issues identified | 1/3 | 3/3 |
| Full evaluation cost | $5.01 | $13.47 |
| Median time per question | 43 seconds | 2.5 minutes |
이 평가에서 K3.1 Pro는 더 많은 문항에 정답을 내고 숨은 패턴과 데이터 품질 이슈를 더 많이 식별했지만, 더 높은 비용과 더 긴 중앙 완료 시간을 보였습니다.
표시된 요금은 Moonshot의 표준 API 가격에서 계산된 추정치가 아니라 관찰된 평가 비용입니다. 공개된 설정은 두 모델 실행 사이에서 모든 공급자 설정이 동일했다는 점을 확립하지 않으므로, 차이가 모델만의 영향이라고 단정할 수 없습니다.
이 결과는 추가 발견이 더 많은 시간과 지출을 정당화할 수 있는 분석 작업에서 K3.1 Pro를 평가할 근거를 제공합니다. 동일한 정확도나 비용 advantag
Kimi K3.1 Pro는 Kimi K3보다 빠른가요?
출력 토큰 처리량과 종단 간 작업 지연을 구분하십시오.
Artificial Analysis는 Kimi의 API를 사용해 최대 추론 강도에서 K3.1 Pro가 초당 73.5 출력 토큰, K3가 초당 38.5 출력 토큰을 보인다고 보고합니다. 이는 2026년 10월 24일 확인된 토큰 생성 측정치이며, 총 작업 지연은 추론 길이와 도구 실행에도 좌우됩니다.
하지만 더 빠른 토큰 생성이 더 빠른 작업 완료를 보장하지는 않습니다.
Moonshot은 K3.1 Pro Highspeed도 제공하며, 표준 변형 대비 약 2~3배 빠른 출력 속도를 제공한다고 광고합니다. 이는 서빙 속도 개선이며, 별도의 검증된 지능 향상이 아닙니다.
K3.1 Pro의 보고된 출력 토큰 처리량은 더 높지만, 반드시 작업을 더 빨리 끝내는 것은 아닙니다. 토큰 생성 속도와 추론, 도구 호출, 작업 완료에 필요한 시간을 구분하십시오.
출력 속도 vs 작업 완료 시간
Artificial Analysis는 Kimi의 API에서 최대 추론 강도 기준으로 K3.1 Pro 73.5 토큰/초, K3 38.5 토큰/초의 출력 속도를 보고합니다. 이 측정치는 2026년 10월 24일 확인되었으며, 종단 간 작업 지연이 아니라 토큰 생성 처리량을 설명합니다.
모델이 더 많은 추론 토큰을 생성하거나 추가 도구 호출을 수행하면 토큰 생성은 더 빠르더라도 전체 소요 시간은 더 길어질 수 있습니다. 앞서 언급한 Plotly 평가에서 K3.1 Pro의 문항당 중앙 완료 시간은 2.5분, K3는 43초였으며, 정확도는 K3.1 Pro가 더 높았습니다.
대화형 애플리케이션에서는 선택한 공급자 경로에서 최초 토큰까지의 시간과 총 작업 완료 시간을 측정하십시오. 출력 처리량만으로는 반응성을 예측하기에 충분하지 않습니다.
K3.1 Pro Highspeed 고려
Moonshot은 K3.1 Pro Highspeed가 표준 K3.1 Pro 대비 약 23배의 출력 속도를 제공한다고 광고합니다. 이 주장은 서빙 속도에 관한 것이며, 총 작업 완료 시간이 23배 단축된다는 의미로 해석해서는 안 됩니다.
사용자가 응답을 기다리는 대화형 코딩이나 어시스턴트에는 Highspeed를 고려하십시오. 선택 전에 표준 엔드포인트 대비 종단 간 지연, 작업 성공, 총 과금 비용을 비교하십시오. Highspeed는 일반 입력과 출력 토큰 단가가 더 높으며, 캐시된 입력 단가는 동일합니다.
Kimi K3.1 Pro vs Kimi K3: 비용
공식 API 및 CometAPI 요금
표준 K3.1 Pro의 공식 입력, 출력, 캐시 적중 단가는 K3 대비 3분의 1 낮습니다. CometAPI의 입력 및 출력 단가는 해당 공식 요금 대비 추가로 20% 낮게 책정되어 있습니다.
| Model | Official Input / 1M | Official Output / 1M | Official Cached Input / 1M | CometAPI Input / 1M | CometAPI Output / 1M |
|---|---|---|---|---|---|
| Kimi K3.1 Pro | $2.00 | $10.00 | $0.20 | $1.60 | $8.00 |
| Kimi K3 | $3.00 | $15.00 | $0.30 | $2.40 | $12.00 |
| Kimi K3.1 Pro Highspeed | $4.00 | $20.00 | $0.20 | Check current quote | Check current quote |
백만 토큰당 USD; 2026년 10월 24일 확인. 입력 열은 일반 비캐시 입력 요금입니다. 세금 및 별도 과금 항목은 제외됩니다.
공식 Kimi 가격에는 캐시 쓰기 요금도 기재되어 있습니다. 표준 Pro는 5분/1시간 보존에 대해 백만 토큰당 $2/$4, Highspeed는 $4/$8입니다. 캐시 적중, 캐시 쓰기, 일반 입력은 서로 배타적인 별도 과금 범주입니다.
공식 Kimi와 CometAPI는 별도의 공급자 경로입니다. Highspeed 제공 여부를 포함해 선택한 경로의 현재 요금과 캐시 지원을 확인하십시오. 토큰 단가뿐 아니라 작업당 총 과금 비용을 비교하십시오.
고정 토큰 비용 예시
비캐시 입력 토큰 100,000개와 출력 토큰 20,000개를 소비하는 워크로드를 가정합니다.
이 고정 워크로드에서 공식 API 비용은 K3 $0.60, K3.1 Pro $0.40입니다. 기재된 CometAPI 요금으로는 각각 $0.48과 $0.32입니다. 이 합계에는 명시된 입력 및 출력 토큰만 포함됩니다.
그러나 이는 고정 토큰 비교입니다. 복잡한 에이전트 워크플로는 모델에 따라 추론 토큰과 도구 호출 수가 달라질 수 있습니다.
토큰 절감 효과가 사라질 수 있음
I를 동일한 비캐시 입력 토큰 수, O를 Kimi K3의 과금 출력 토큰 수, P를 Kimi K3.1 Pro의 과금 출력 토큰 수(모두 백만 단위)라고 하겠습니다. 가격표의 표준 공식 요금에서 비용은 각각 3I + 15O, 2I + 10P 달러입니다. 두 값은 P = 1.5O + 0.1I일 때 같습니다.
출력 위주 요청에서는 K3.1 Pro가 약 50% 더 많은 과금 출력 토큰을 사용하더라도 가격 우위를 유지할 수 있습니다. 이 계산은 변경되지 않은 요금을 가정하며 캐싱, 도구 요금, 기타 별도 과금 사용을 제외합니다. 가시적인 답변 길이 대신 실제 과금 토큰 범주를 사용하십시오.
성공적으로 완료된 작업당 비용
성공적으로 완료된 작업당 비용은 평가에 시도된 모든 실행의 총 과금 비용을 사전에 정의된 수용 기준을 충족한 고유 작업 수로 나눈 값으로 계산하십시오. 공급자가 과금하는 경우 실패, 재시도, 타임아웃에 대한 비용도 포함하십시오. 성공한 실행 비용만 합산해 그 개수로 나누면 작업당 비용이 과소 추정될 수 있습니다.
Kimi K3와 K3.1 Pro 간에 작업 집합, 수용 기준, 재시도 한도, 타임아웃 정책을 동일하게 유지하십시오. 성공률과 함께 성공당 비용을 보고하여, 어려운 작업을 제외하는 행위가 모델을 인위적으로 경제적으로 보이게 만들지 않도록 하십시오. 어떤 작업도 성공하지 못하면 성공당 비용은 정의되지 않으며 0이 아닙니다.
Kimi K3.1 Pro vs Kimi K3: 비교와 선택
대부분의 호스팅된 에이전틱 워크로드에서는 K3.1 Pro가 더 강력한 출발점입니다. 그럼에도 불구하고, 결정은 작업 복잡성과 배포 요구사항을 반영해야 합니다.
| Use Case | Recommended Model | Reason |
|---|---|---|
| Autonomous coding | Kimi K3.1 Pro | 다수 파일 변경, 터미널 작업, 디버깅, 최종 테스트 결과를 평가하십시오. |
| Multi-document financial research | Kimi K3.1 Pro | 개선된 리서치 및 비즈니스 운영 벤치마크 |
| Complex data analysis | Kimi K3.1 Pro | 문제 발견과 데이터 품질 테스트에서 더 우수 |
| 3D creation and CAD workflows | Kimi K3.1 Pro | 특화된 도구 보조 기능이 강함 |
| Straightforward text tasks | Benchmark both | 일상 텍스트와 단순 코딩 작업은 두 모델을 비교하십시오. 추가 추론이 수용 가능한 결과를 개선하지 않고 지연을 늘릴 수 있습니다. |
| Long-context retrieval accuracy | Benchmark both | AA-LCR에서 K3가 소폭 우위 |
| Immediate self-hosting | Kimi K3 | 다운로드 가능한 가중치가 이미 제공 |
| Interactive high-capability agents | K3.1 Pro Highspeed | 더 빠른 서빙, 비용 검증 필요 |
| Cost-sensitive production workflows | Benchmark both | 낮은 토큰 단가가 작업 비용 감소를 의미하지 않을 수 있음 |
호스팅 자동화와 전문 워크플로
호스팅된 코딩 에이전트와 분석 워크플로에서는 실제 업무의 어려운 부분을 기준으로 K3.1 Pro를 평가하십시오. 다수 파일 변경, 증거 수집, 계산 검증, 도구 호출 실패 후 복구를 중점적으로 보세요. 높은 헤드라인 점수 자체보다 실패 작업 또는 보정 작업의 감소라는 측정 가능한 개선을 우선하십시오.
기존 K3 애플리케이션의 경우, 비교 기준으로 기존 경로를 유지하십시오. 일상 작업은 이미 수용 기준을 충족할 수 있으며, 특화된 장문맥 작업은 집계 벤치마크와 다르게 동작할 수 있습니다. 업그레이드의 측정 가능한 이점이 있는 워크로드 구간에 우선순위를 두십시오.
자체 호스팅과 배포 제약
2026년 10월 24일 기준으로, K3의 전체 가중치는 모델 라이선스와 하드웨어 요구사항에 따라 배포 가능합니다. K3.1 Pro의 전체 가중치는 아직 공개되지 않았습니다.
Moonshot은 K3.1 Pro 가중치를 2026년 11월 4일까지 공개할 계획입니다. 이는 발표된 공개 계획이며, 이미 이용 가능한 체크포인트가 아닙니다. 자체 호스팅 일정을 잡기 전에 공개된 가중치와 적용 조건을 확인하십시오.
프로덕션 평가 기준
동일한 프롬프트, 도구, 수용 기준, 재시도 한도, 타임아웃으로 대표 작업에서 K3와 K3.1 Pro를 비교하십시오. 공급자와 추론 설정을 기록하고, API 요구에 따라 전체 assistant 메시지를 보존하십시오.
과금된 실패와 재시도를 포함해 작업 성공, 지연, 토큰 사용량, 성공당 비용을 측정하십시오. K3는 성공했지만 K3.1 Pro가 실패한 사례를 검토하십시오. 사람 평가에서는 모델 라벨을 숨기고 출력 순서를 무작위화하십시오.
K3.1 Pro가 품질, 지연, 비용 기준을 충족하면 검증된 K3 폴백과 함께 점진적으로 롤아웃하십시오.
통제된 마이그레이션과 폴백
실무적 접근법은 프로덕션 트래픽의 일부를 K3.1 Pro로 시작하는 것입니다.
검증 기간 동안 K3를 폴백으로 유지하십시오. K3.1 Pro 사용률을 늘리기 전에 작업 품질, 지연, 실패율, 지출을 비교하십시오.
도구 호출 스키마, 추론 관련 메시지 필드, 멀티모달 입력, 출력 파싱에 특히 유의하십시오. API 호환성이 애플리케이션 동작의 일치를 자동으로 보장하지는 않습니다.
벤치마크 상승과 회귀
두 모델이 동일한 43문항에 답했고 35와 42를 기록했다면, K3.1 Pro가 K3의 실패 7건을 수정하면서 회귀는 없었거나, 실패 8건을 수정하는 대신 이전에 정답이던 1건을 잃었을 수 있습니다. 총점만으로는 이 결과를 구분할 수 없습니다.
짝지은 답변을 검토해 둘 다 정답, K3만 정답, K3.1 Pro만 정답, 둘 다 오답으로 분류하십시오. 마이그레이션 전에 최우선 영향 과제에서 K3만 성공한 사례를 검토하십시오. 42/43 결과는 해당 테스트 세트를 설명할 뿐, 다른 워크로드에서 97.7% 성공률을 보장하지 않습니다.
모델 출력의 블라인드 평가
모델 라벨을 숨기고, 검토자가 출력을 보는 순서를 무작위화하십시오. 검토 전에 수용 기준을 정의하십시오. 코드의 경우 실행 가능한 테스트와 회귀 검사를, 리서치의 경우 출처 근거, 계산, 요청된 산출물의 완결성을 확인하십시오. 표현이나 문체보다 정확성을 먼저 채점하십시오.
품질 평가가 기록된 후에만 모델 정체, 지연, 과금 비용을 공개하십시오. 이렇게 하면 최신 모델에 대한 기대치와는 독립적으로 출력 품질을 평가할 수 있습니다. 검토자 간 이견은 동일한 테스트나 출처 자료를 기준으로 해결하고, 이후 모델 또는 프롬프트 변경을 일관되게 평가할 수 있도록 결정을 보관하십시오.
Kimi K3.1 Pro와 Kimi K3는 어디에서 이용할 수 있나요?
공식 공급자 접근
직접 공급자 연동을 위해 문서화된 Kimi K3 API 또는 Kimi K3.1 Pro API를 사용하십시오. 선택한 엔드포인트의 모델 식별자, 지원 요청 필드, 계정 한도를 확인하십시오. 공개 API 접근과 다운로드 가능한 모델 가중치는 별도의 배포 옵션입니다.
CometAPI를 통한 접근
개발자는 CometAPI의 통합 인터페이스를 통해 Kimi K3.1 Pro API와 Kimi K3 API에 접근하고 동일한 애플리케이션 워크로드로 두 경로를 비교할 수 있습니다.
이는 이미 OpenAI 호환 채팅 인터페이스를 사용하는 애플리케이션에서 K3에서 K3.1 Pro로의 마이그레이션을 비교적 간단하게 합니다.
CometAPI를 사용하려면 계정과 API 키를 생성한 뒤, 통합 문서의 엔드포인트와 모델 식별자를 애플리케이션에 구성하십시오. K3는 kimi-k3, 표준 K3.1 Pro는 kimi-k3.1-pro, 지원되는 경우 Highspeed 경로는 kimi-k3.1-pro-highspeed를 선택하십시오. 작은 요청으로 시작한 뒤, 반환 결과, 지연, 과금 사용량을 확인하면서 모델 간 동일 워크로드를 비교하십시오.
결론
Kimi K3.1 Pro는 이 글에서 검토한 평가 기준에서 요구가 높은 자율 코딩, 금융 리서치, 확장된 에이전트 워크플로에 더 강력한 후보입니다. Kimi K3는 즉시 자체 호스팅이 가능하고, 기존 정확도나 지연 프로파일이 요구사항을 이미 충족하는 워크로드에서는 여전히 유효합니다.
대표 작업과 실제 공급자 경로를 기준으로 선택하십시오. 성공적 결과, 지연, 총 지출을 비교한 다음 점진적으로 마이그레이션하십시오. 더 낮은 토큰 단가와 더 높은 집계 벤치마크 점수는 유용한 출발점이지만, 모든 애플리케이션에 최적 구성을 보장하지는 않습니다.