
TL;DR
MiniMax M3.1 Flash는 자율 에이전트, 소프트웨어 엔지니어링, 컴퓨터 사용, 복잡한 워크플로 자동화를 위해 설계된 고속 AI 모델입니다. 2026년 10월 19일 공식 출시되었으며, 100만 토큰 컨텍스트 윈도우, 구성 가능한 추론 깊이, 낮은 추론 비용을 결합합니다.
MiniMax는 초당 200+ 출력 토큰, 전작 대비 에이전트 워크로드 비용 70% 절감, Automation-Bench, DeepSWE, OSWorld 전반에 걸친 경쟁력을 보고합니다. 입력 100만 토큰당 $0.15, 출력 100만 토큰당 $0.60의 가격으로 멀티스텝 AI 에이전트 워크플로를 더 경제적으로 만듭니다.
Key Takeaways
- MiniMax M3.1 Flash 성능: 공급업체 보고 벤치마크에는 Automation-Bench 62.8, DeepSWE v1.1 73.7, OSWorld 2.0 61.7이 포함되며, 에이전트 자동화, 코딩, 컴퓨터 사용 역량을 강조합니다.
- MiniMax M3.1 Flash API 가격: 공식 요율은 입력 $0.15/M, 출력 $0.60/M, 캐시 입력 $0.015/M입니다. 2026년 10월 21일 기준 CometAPI 요율은 입력 $0.80/M, 출력 $3.20/M이며, 모델 페이지에는 캐시 요율이 게시되지 않았습니다.
- MiniMax M3.1 Flash 추론 속도: MiniMax는 유리한 조건에서 초당 200+ 토큰, P50 처리량 170 토큰/s 이상을 보고하여 반응성 높은 에이전트 워크플로를 지원합니다.
- MiniMax M3.1 Flash 에이전트 효율: 다섯 가지 추론 노력 수준으로 개발자가 작업 완료율, 지연 시간, 전체 AI 에이전트 비용을 균형 있게 조절할 수 있습니다.
- MiniMax M3.1 Flash API 접근: 개발자는 MiniMax를 통해 출시 모델에 접근하거나 제공자별 모델 식별자와 가격을 사용해 CometAPI 통합을 탐색할 수 있습니다.
What Is MiniMax M3.1 Flash?
MiniMax M3.1 Flash는 에이전트형 추론, 코딩, 도구 사용, 자율적 워크플로 실행에 최적화된 차세대 언어 모델입니다. MiniMax officially introduced M3.1 Flash는 2026년 10월 19일에 발표되었습니다.
단순히 대화형 지능이나 고립된 점수에만 집중하기보다, 반복적 추론, 도구 호출, 멀티스텝 실행을 통해 작업을 완료하는 총 비용을 목표로 합니다. MiniMax는 또한 초기 개발을 Space Bunny와 연관 지었는데, 이는 발표 이전에 200조 개 이상의 토큰을 처리했다고 하는 익명 배포 모델입니다. 이는 보고된 사용량 수치이며 공개된 학습 토큰 수는 아닙니다.
자율 코딩 어시스턴트, 엔터프라이즈 AI 동료, 브라우저 기반 에이전트를 구축하는 개발자를 위해 M3.1 Flash는 광범위한 컨텍스트 용량, 빠른 생성, 저렴한 토큰 사용이라는 세 가지 장점을 제공합니다.
What Are MiniMax M3.1 Flash’s Specifications?
| API specifications | MiniMax M3.1 Flash |
|---|---|
| Developer | MiniMax |
| Official release | 2026년 10월 19일 |
| Model family | MiniMax M3 |
| Context window | 1,000,000 tokens |
| Primary capabilities | 에이전트 자동화, 코딩, 추론, 컴퓨터 사용 |
| Input modalities | MiniMax의 OpenAI 호환 API를 통한 텍스트, 이미지, 비디오; 기타 제공자에서는 지원 여부 확인 |
| Output modality | 텍스트 |
| Reasoning controls | Low, medium, high, xhigh, max |
| Reported output speed | 최대 200+ tokens/s |
| Reported P50 speed | 170+ tokens/s |
| Access channels | MiniMax API, M Plan, MiniMax Code |
| Open weights | 향후 공개 예정 |
| M3.1-specific parameter count | 발표에서 확정되지 않음 |
대형 컨텍스트 윈도우는 리포지토리 규모 코딩 및 문서 중심 워크플로에 유용하지만, 완전한 기억을 보장하지는 않습니다. 프로덕션 에이전트는 선택적 검색, 구조화된 도구 응답, 컨텍스트 압축을 계속 사용해야 합니다.
다섯 가지 추론 노력 설정을 통해 개발자는 복잡한 계획 수립과 디버깅에만 집중 계산을 예약하고, 분류·추출·간단한 도구 선택 같은 단계에 매번 최대 노력을 쓰지 않도록 할 수 있습니다. 단일 에이전트 요청이 수십 번의 모델 호출을 촉발할 수 있으므로, 일상적 단계에서의 작은 절감이 전체 비용을 실질적으로 낮출 수 있습니다.
How Does MiniMax M3.1 Flash Perform on Benchmarks?
MiniMax는 비즈니스 자동화, 소프트웨어 엔지니어링, 컴퓨터 사용, 사이버보안, 멀티모달 추론에 걸친 벤치마크 결과를 보고합니다. 이는 공급업체가 보고한 평가로, 실제 배포의 독립적 테스트를 대체하지 않습니다.
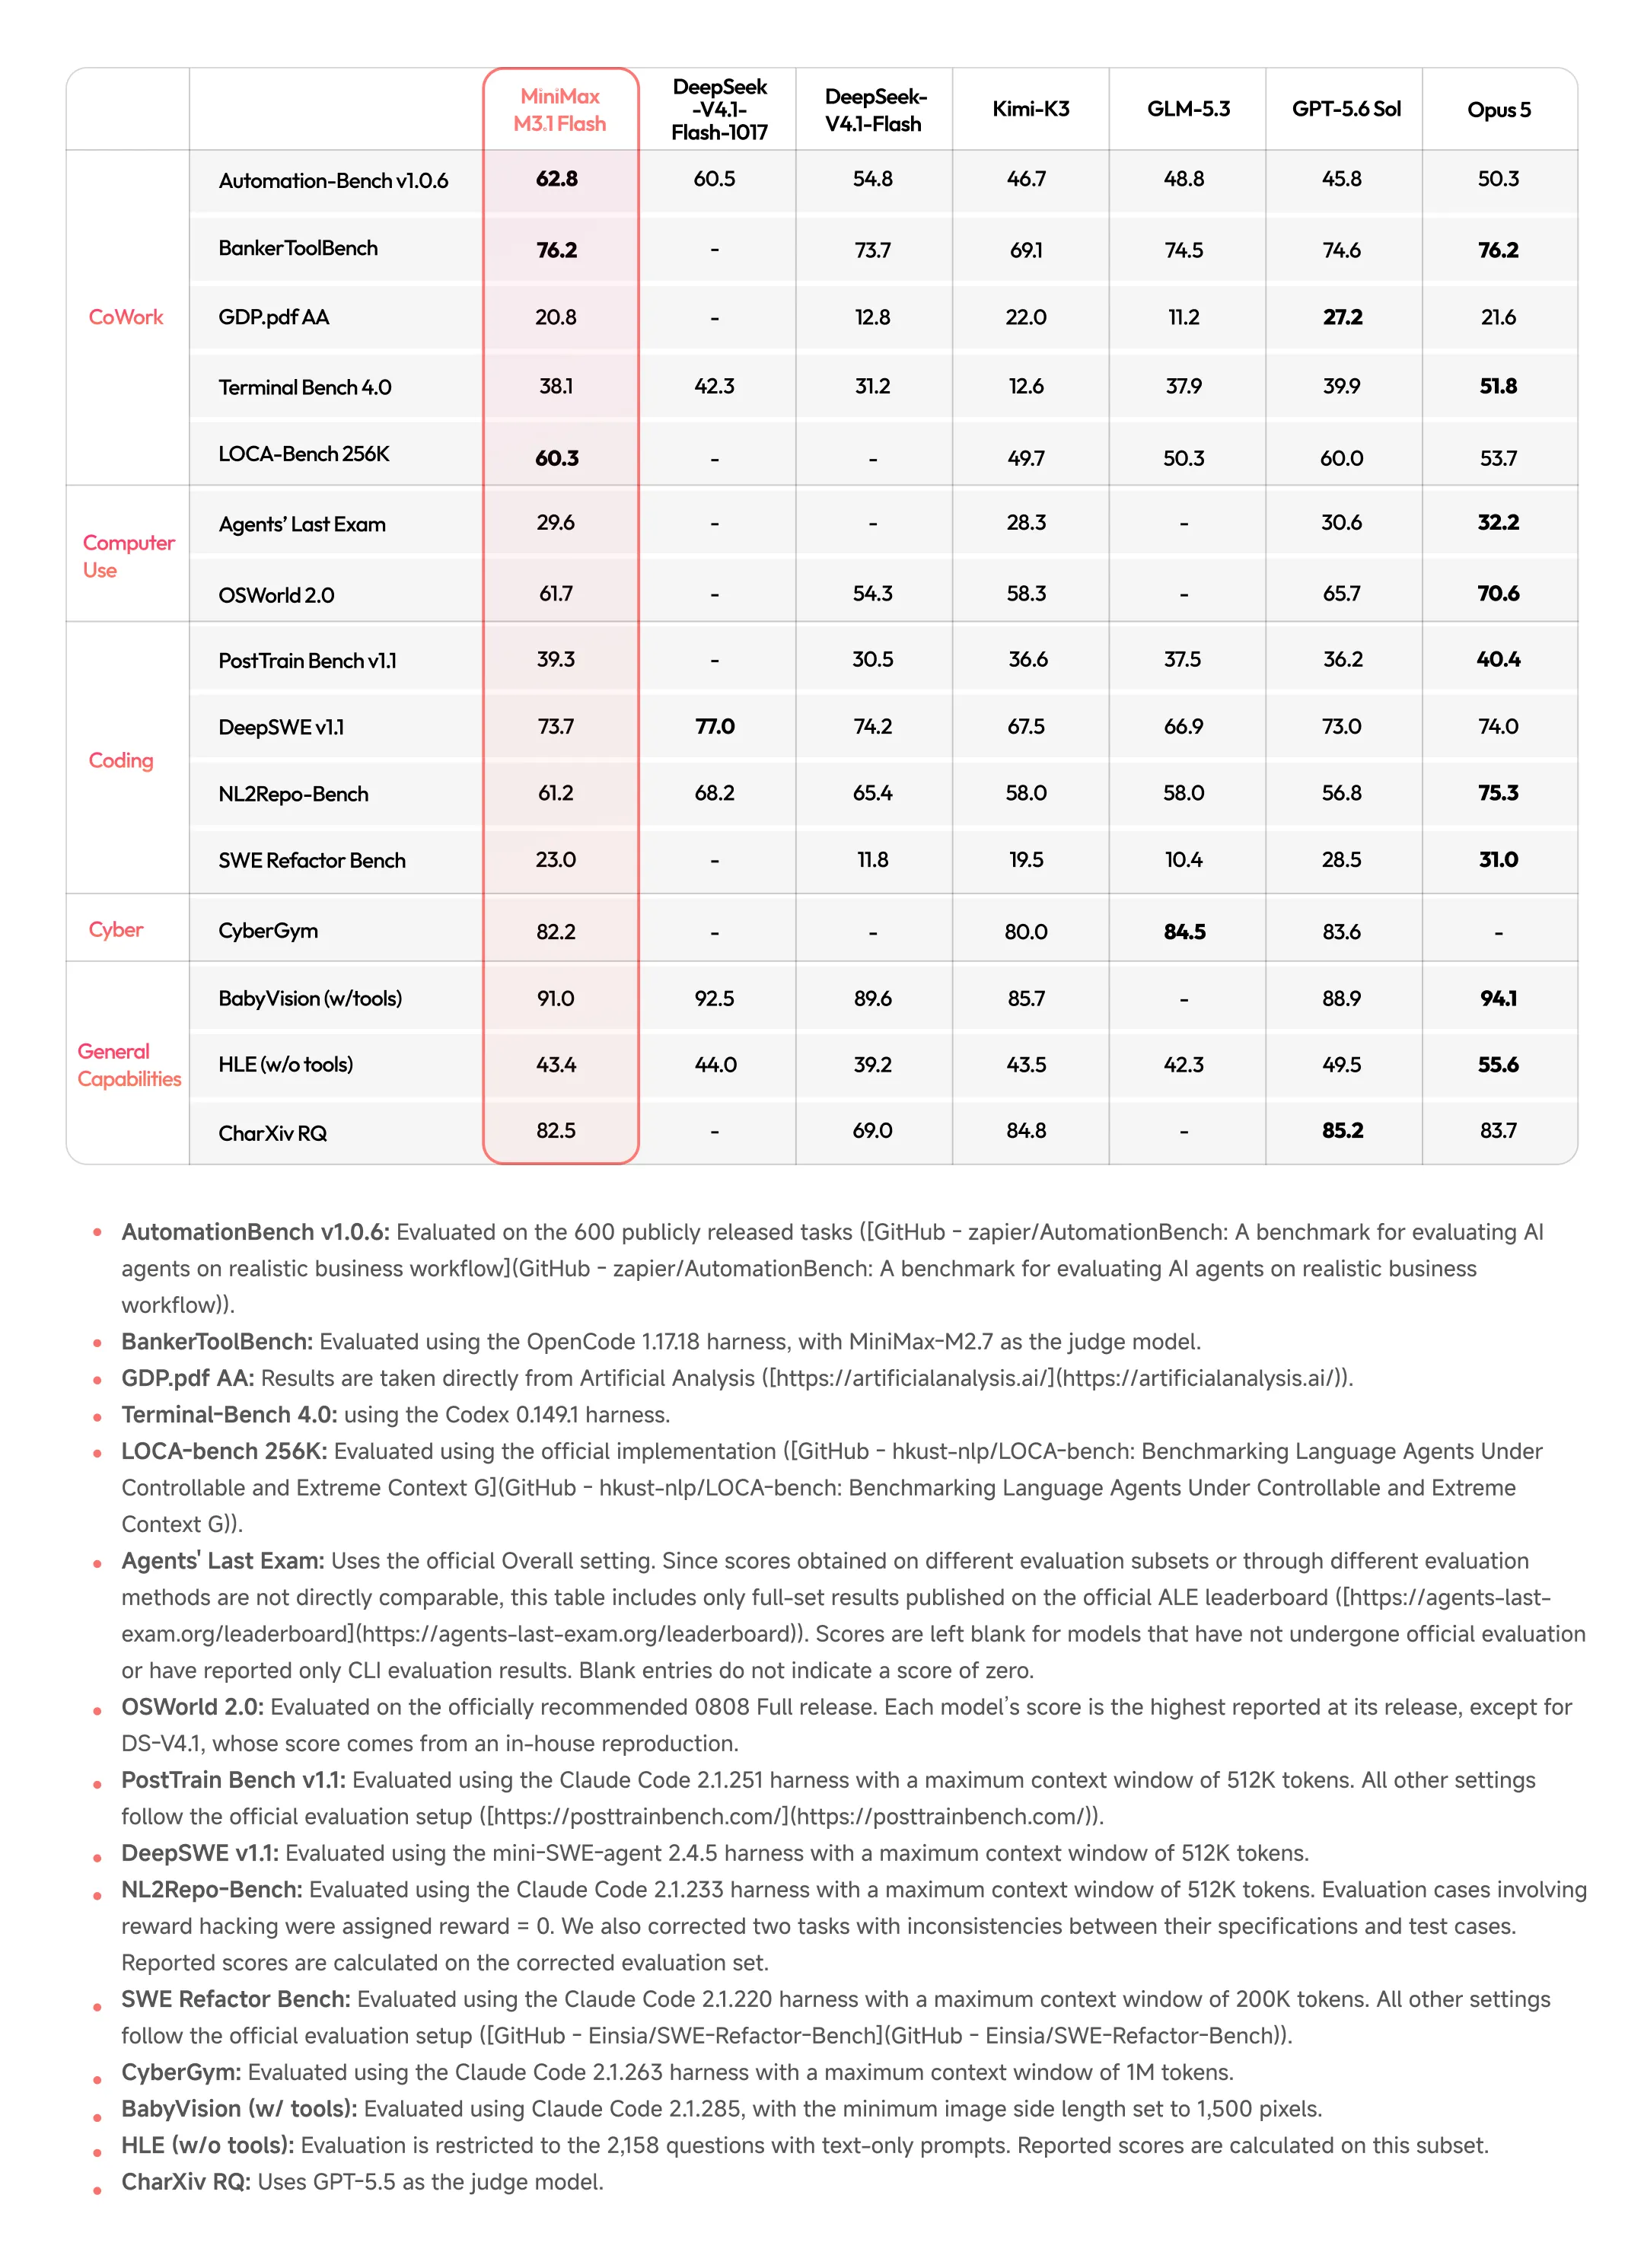
MiniMax의 공식 벤치마크 비교 및 평가 노트. 점수는 벤더 보고치이며, 균일한 독립 테스트를 대표하지 않습니다.
| Official benchmark results | M3.1 Flash | What it measures |
|---|---|---|
| Automation-Bench v1.0.6 | 62.8 | 멀티스텝 비즈니스 자동화 |
| BankerToolBench | 76.2 | 금융 추론과 도구 사용 |
| LOCA-Bench 256K | 60.3 | 롱 컨텍스트 에이전트 실행 |
| DeepSWE v1.1 | 73.7 | 자율 소프트웨어 엔지니어링 |
| Terminal Bench 4.0 | 38.1 | 터미널 기반 문제 해결 |
| OSWorld 2.0 | 61.7 | 데스크톱/컴퓨터 상호작용 |
| Agents’ Last Exam | 29.6 | 복잡한 경제 과제 |
| CyberGym | 82.2 | 사이버보안 문제 해결 |
| BabyVision with tools | 91.0 | 도구 기반 시각적 추론 |
| HLE without tools | 43.4 | 어려운 지식 및 추론 |
Automation-Bench v1.0.6은 600개의 공개 과제를 사용합니다. BankerToolBench는 OpenCode 1.17.18과 MiniMax-M2.7을 심판으로 사용합니다; Terminal Bench 4.0은 Codex 0.149.1을 사용합니다. DeepSWE v1.1은 512K 컨텍스트 제한의 mini-SWE-agent 2.4.5를 사용합니다. OSWorld는 0808 Full 릴리스를 사용합니다: 표는 각 모델의 최고 릴리스 점수를 결합하며, DeepSeek V4.1만 MiniMax가 내부적으로 재현했습니다. 이러한 상이한 설정은 모델 간 직접 비교를 제한합니다.
비즈니스 자동화에는 Automation-Bench와 BankerToolBench를, 코딩 에이전트에는 DeepSWE와 터미널 기반 결과를 우선적으로 살펴보세요. OSWorld는 단순히 지시를 생성하는 것이 아니라 컴퓨터 환경과의 상호작용을 평가합니다. 단일 종합 점수는 과제별 분석을 대체할 수 없습니다.
How Fast Is MiniMax M3.1 Flash?
에이전트 시스템은 종종 순차적인 모델 호출을 여러 번 수행하므로, 처리량만으로 반응성을 설명할 수 없습니다.
| Speed metric | Reported performance |
|---|---|
| Everyday peak output throughput | 200+ tokens/s |
| Median output throughput (P50) | 170+ tokens/s |
| Online inference improvement | 이전 세대 대비 거의 3× |
| Agent workload cost reduction | 전작 대비 70% |
이러한 벤더 보고 속도 및 워크로드 비용 수치는 MiniMax의 출시 평가를 설명하며, 모든 애플리케이션에서 보장되는 처리량이나 절감을 의미하지는 않습니다. 서빙 하드웨어, 동시성, 프롬프트 길이, 반복 실행 변동성은 발표에서 완전히 명시되지 않았습니다.
엔드투엔드 지연에는 첫 토큰 지연, 추론 오버헤드, 도구 시간, 재시도, 단계 간 종속성도 포함됩니다. 더 빠른 생성기라도 동일한 작업을 완료하기 위해 더 많은 호출이 필요하다면 이점을 잃을 수 있습니다.
How Much Does MiniMax M3.1 Flash API Cost?
MiniMax는 초기 가격 설명에서 별도의 롱 컨텍스트 고요금 계층 없이 M3.1 Flash에 대해 균일한 표준 요율을 발표했습니다. 한편, CometAPI의 MiniMax M3.1 Flash Preview API는 표시된 기준 요율 대비 20% 할인된 별도의 가격 구조를 제공합니다.
| Pricing category | Official M3.1 Flash | CometAPI Preview (≤512K) | CometAPI Preview (>512K) |
|---|---|---|---|
| Input tokens / 1M | $0.15 | $0.24 | $0.48 |
| Output tokens / 1M | $0.60 | $0.96 | $1.92 |
| Cached input / 1M | $0.02 | $0.05 | $0.10 |
| Pricing structure | 균일 요율 | 쇼트 컨텍스트 계층 | 롱 컨텍스트 계층 |
공식 MiniMax API 가격은 M3.1 Flash를 에이전트 워크로드에 특히 매력적으로 만듭니다. 출력 토큰은 표준 입력 요율의 4배, 캐시 입력은 10분의 1입니다. 따라서 반복 지시와 도구 히스토리가 주요 최적화 대상이 될 수 있습니다.
CometAPI의 Preview 가격은 입력 100만 토큰당 $0.24, 출력 100만 토큰당 $0.96에서 시작하며, 이는 표시된 Preview 기준 가격 대비 20% 할인입니다. 그러나 두 제공자의 가격 기준이 다르기 때문에, 이 요율은 새로 발표된 공식 M3.1 Flash 가격보다 여전히 높습니다.
개발자에게 핵심 차이는 CometAPI가 통합된 경험을 제공한다는 점이며, 반면 공식 릴리스는 현재 더 낮은 게시 토큰 요율을 제공합니다. 배포 전에 활성 모델 버전, 컨텍스트 길이 계층, 과금 규칙을 확인해 자율 에이전트 워크플로의 비용을 정확히 추정하세요.
MiniMax M3.1 Flash Cost per Agent Task
Estimated inference cost = (uncached input tokens × input rate + cached input tokens × cache rate + output tokens × output rate) / 1,000,000.
| Illustrative workload | Uncached input | Cached input | Output | Est. cost |
|---|---|---|---|---|
| Simple tool assistant | 10K | 0 | 2K | $0.0027 |
| Pull request review | 40K | 20K | 8K | $0.0111 |
| Multi-step coding agent | 100K | 200K | 30K | $0.0360 |
| Enterprise research | 300K | 700K | 80K | $0.1035 |
| Large autonomous workflow | 1M | 3M | 200K | $0.3150 |
예시 계산이며, 실제 청구가 아닙니다. 캐시된 읽기가 발표된 캐시 요율 자격을 갖춘다고 가정하며, 도구·검색·브라우저·인프라·휴먼 리뷰 비용은 제외합니다.
Reasoning Effort and Task Cost
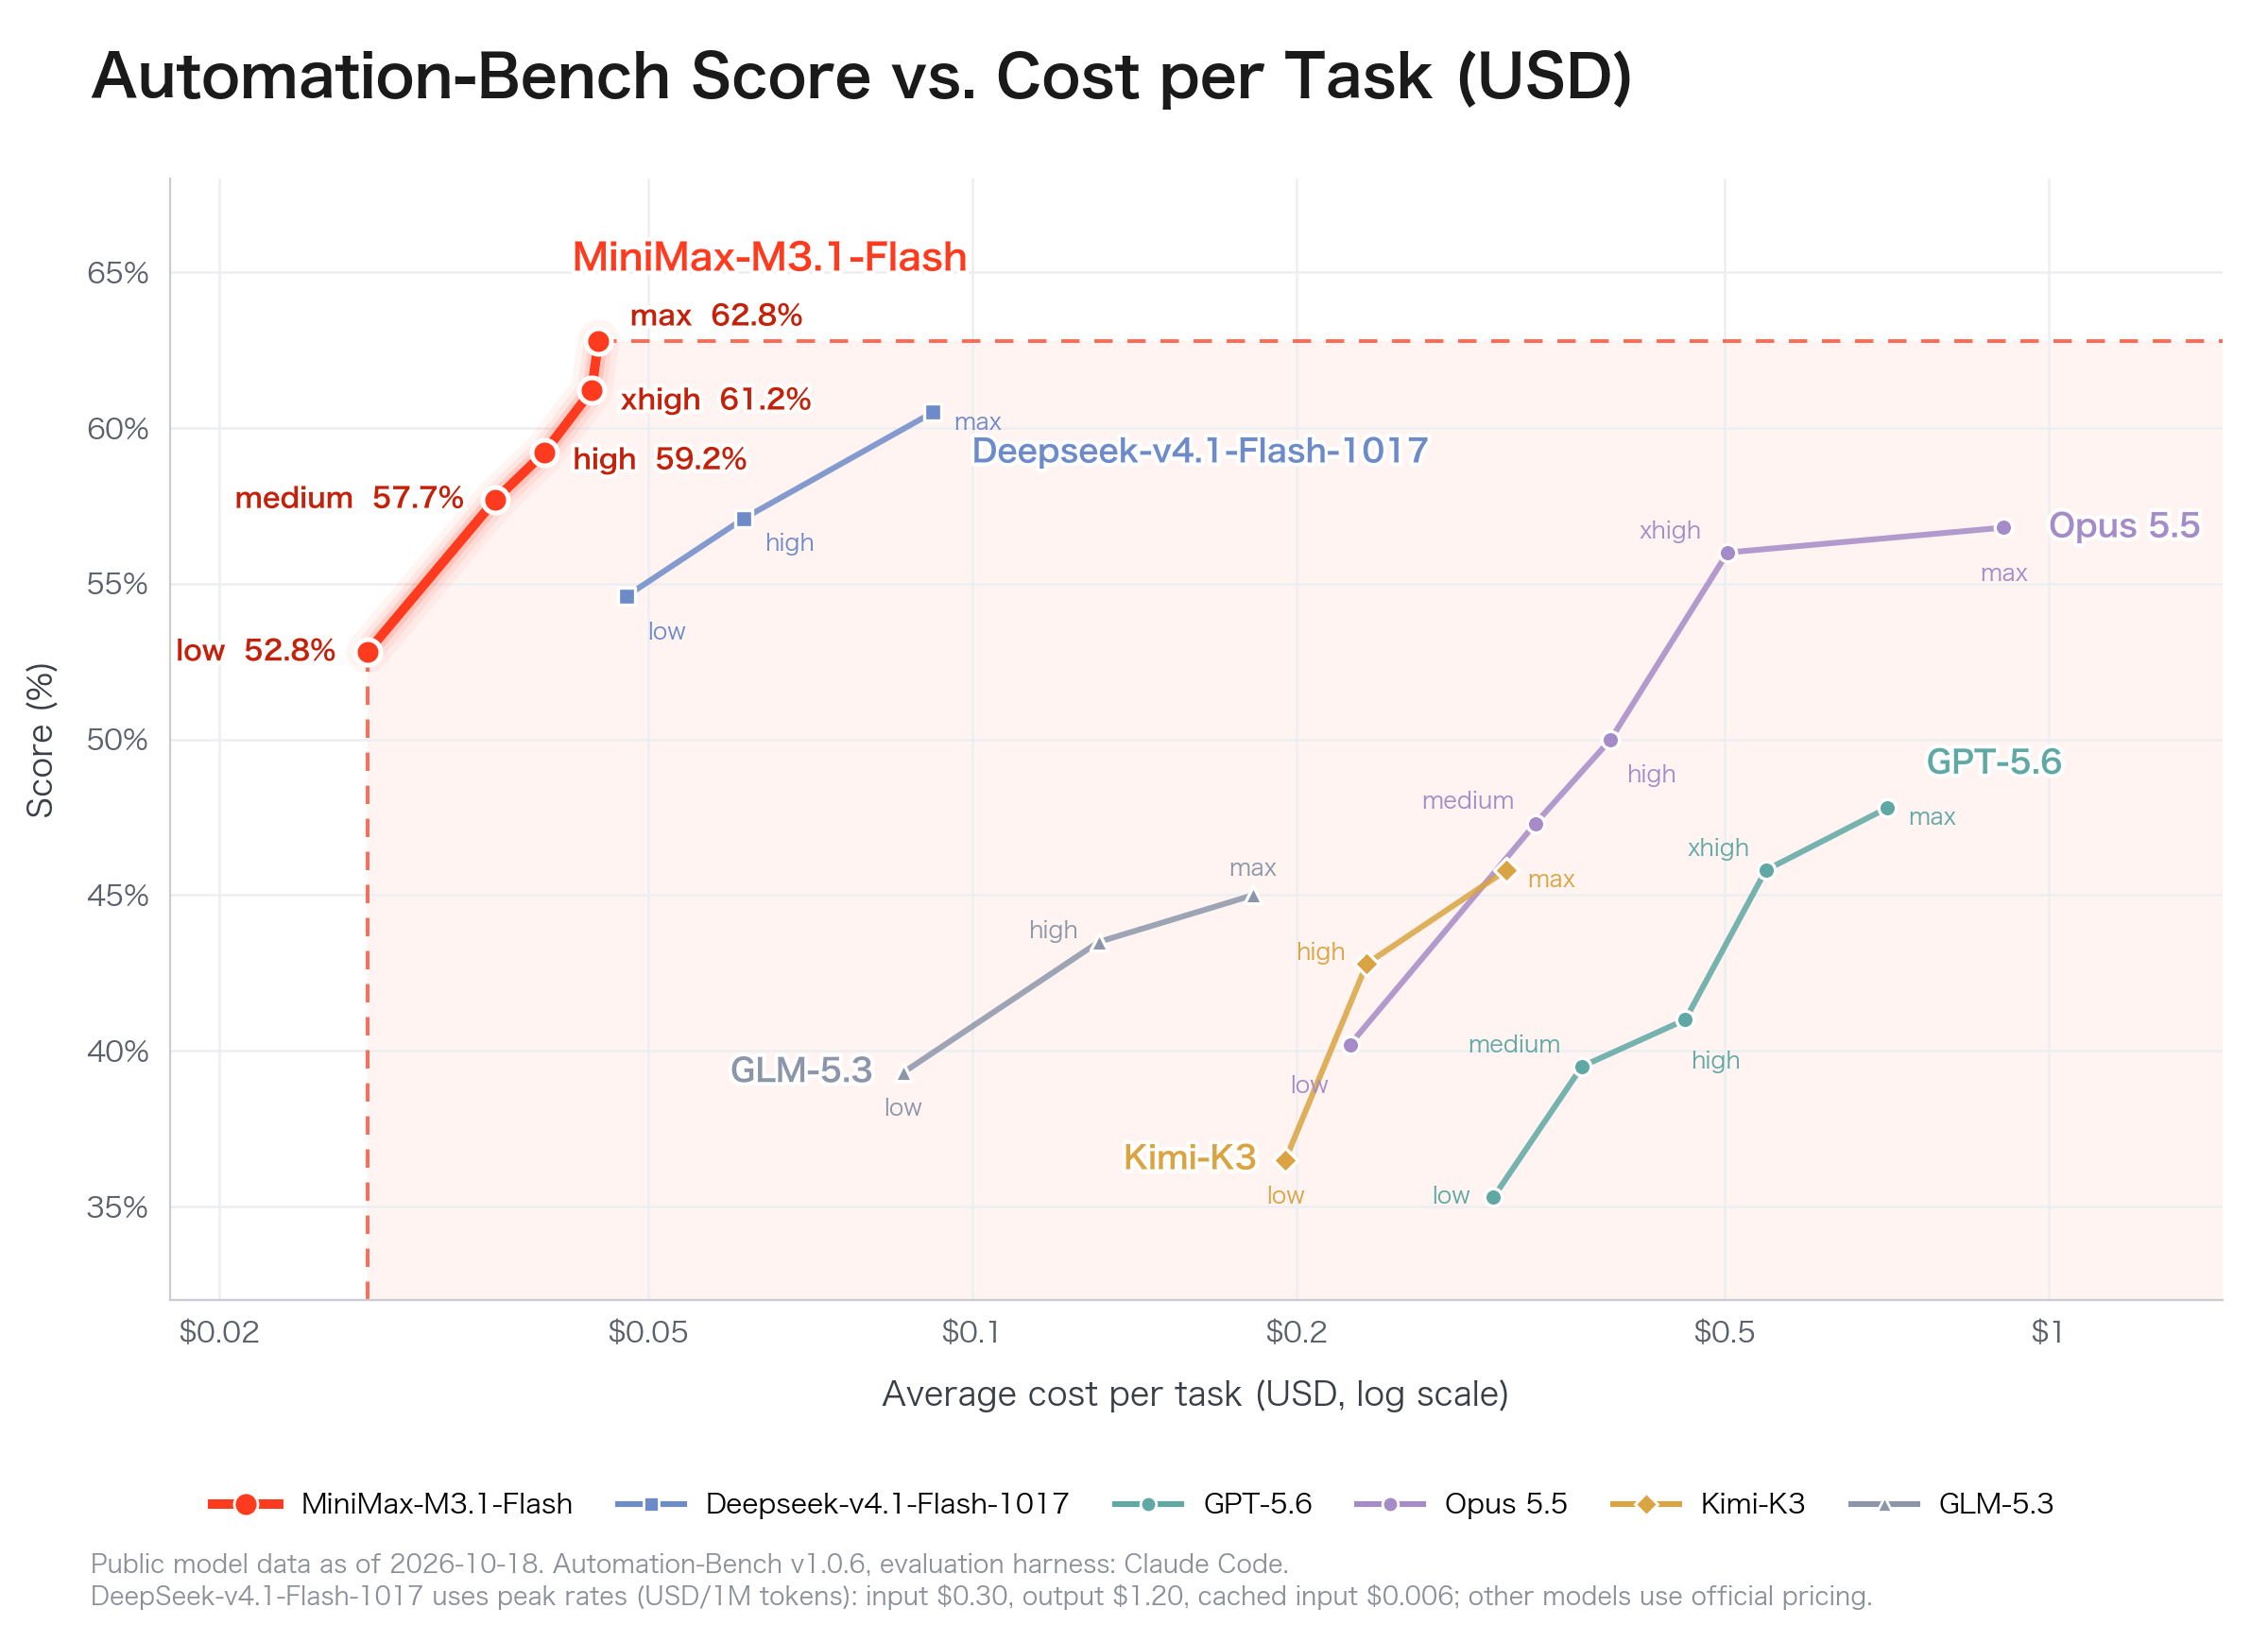
MiniMax의 Automation-Bench 비용 분석은 추론 노력과 벤치마크 성공, 과제별 추론 지출을 연결합니다.
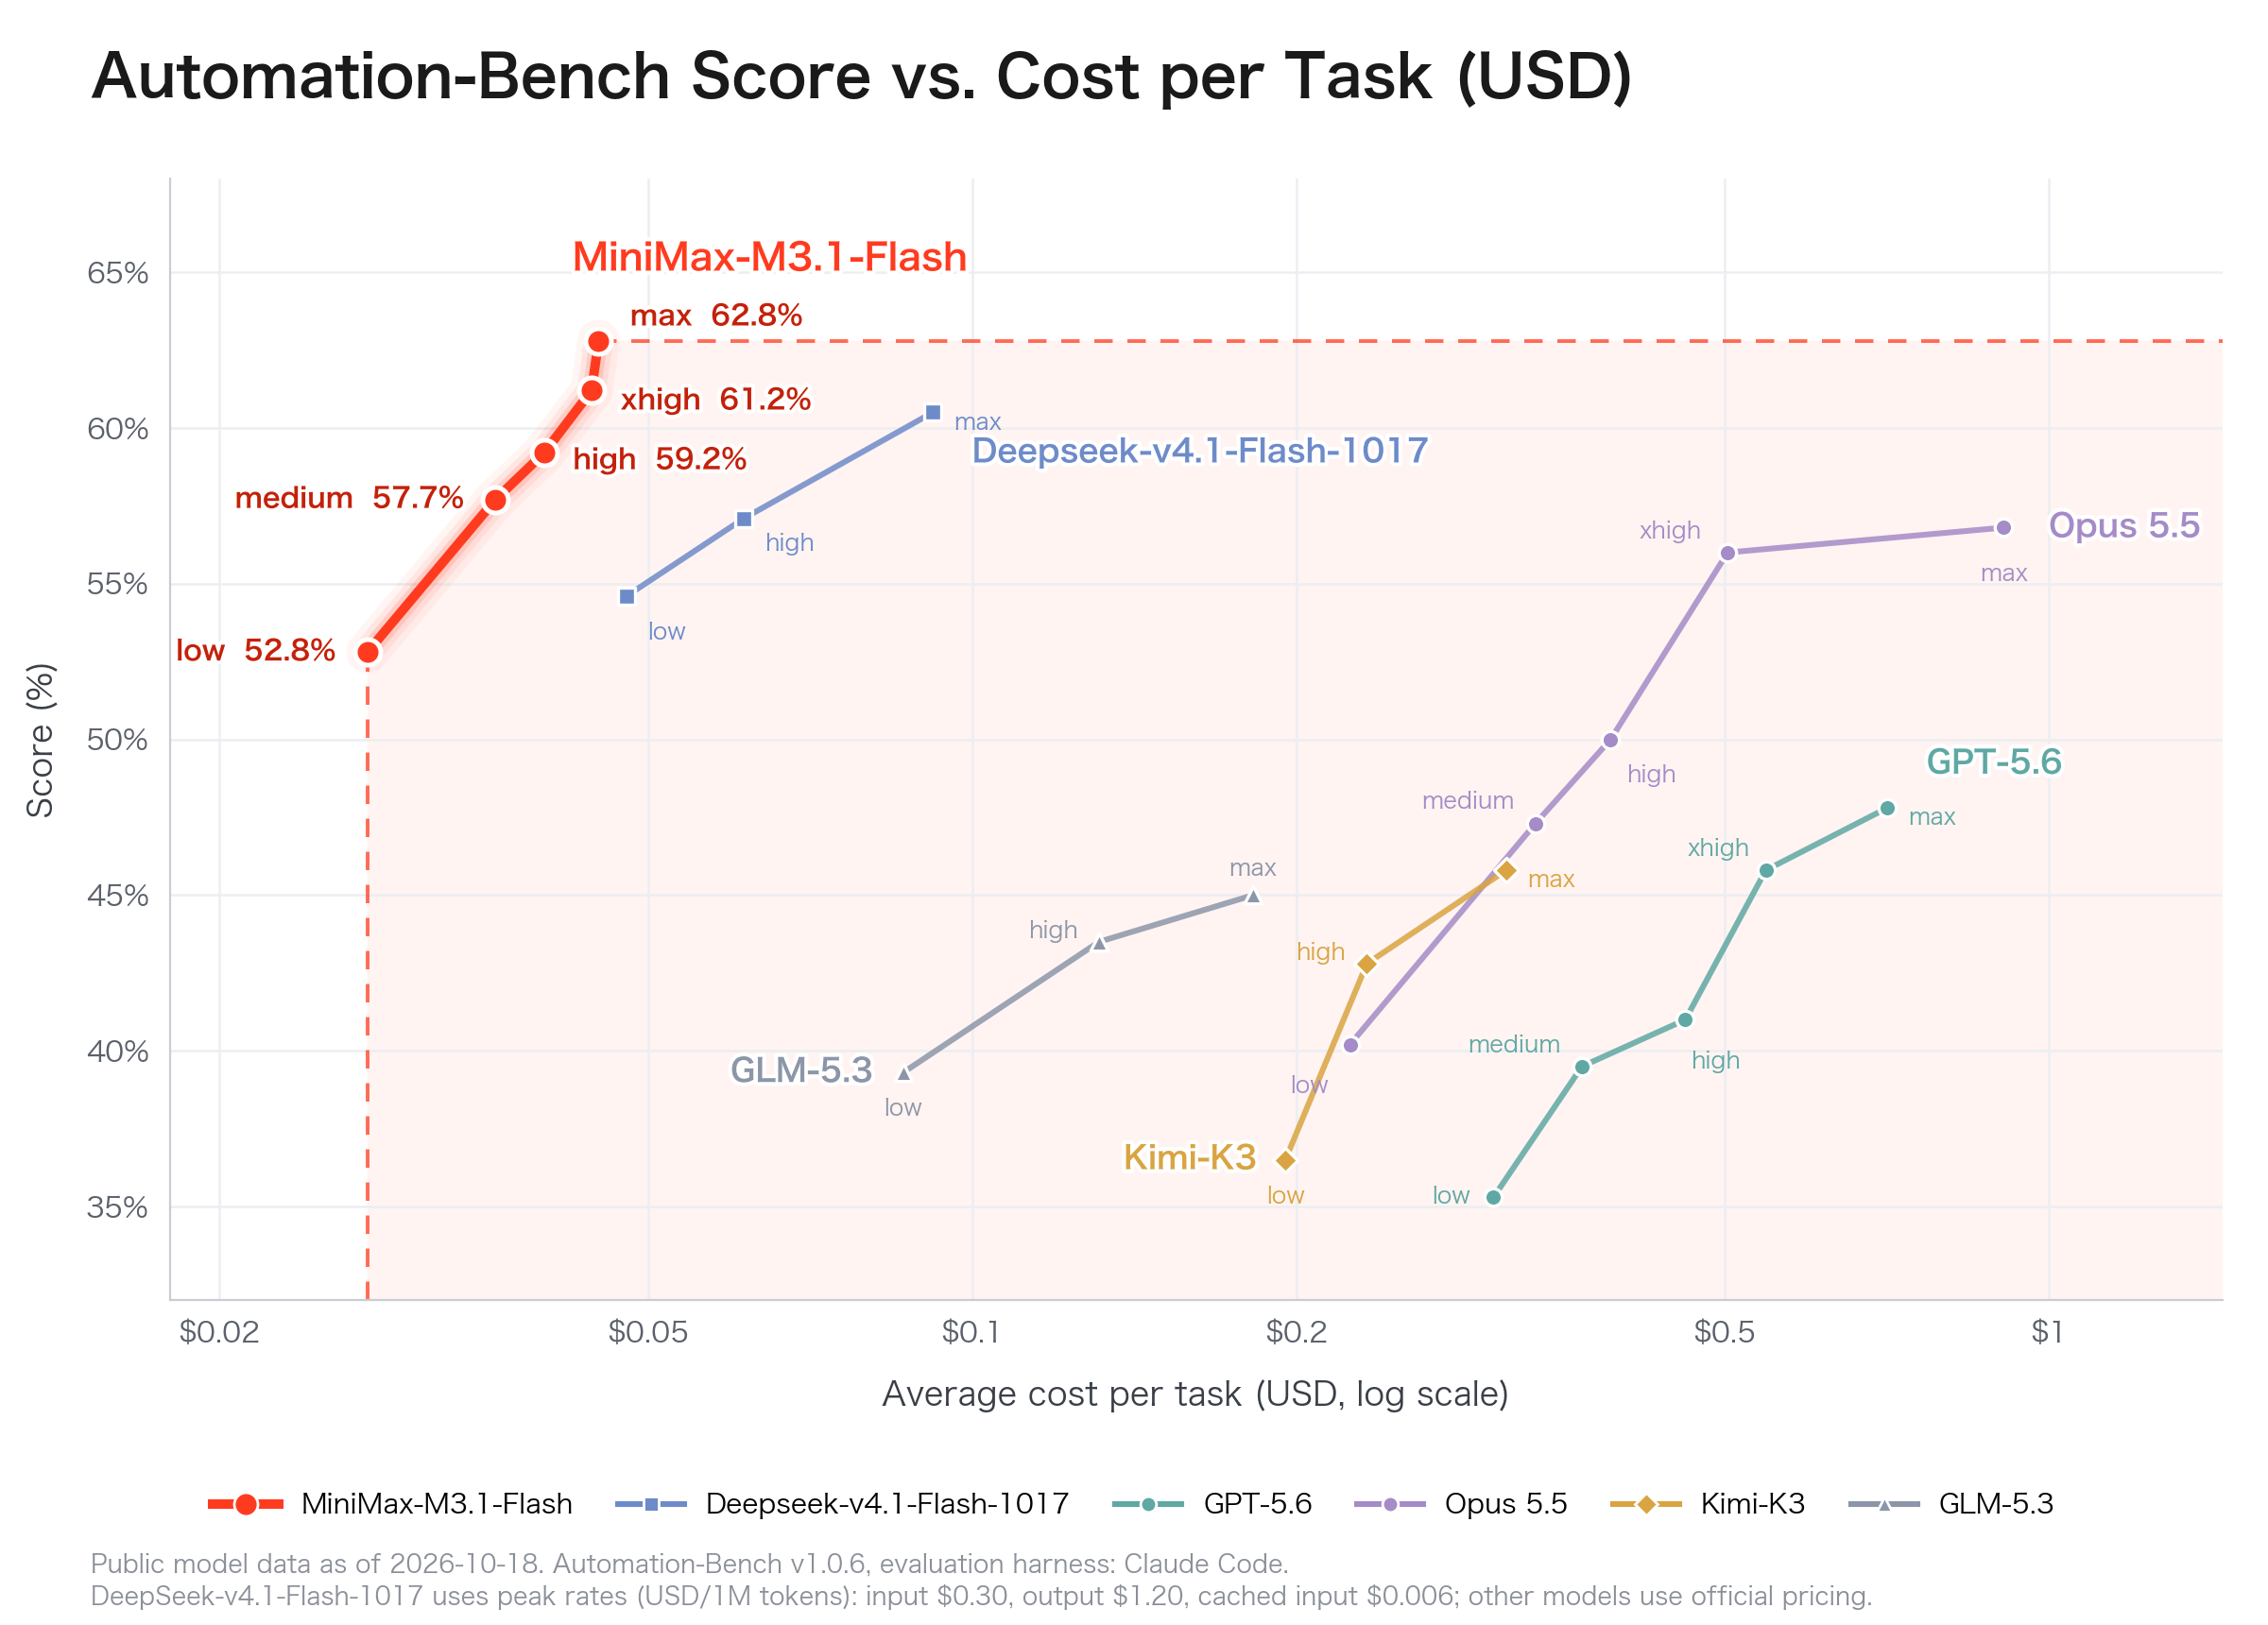
MiniMax의 공식 Automation-Bench 점수 대 비용 차트입니다. 가로축은 로그 스케일이며, 개별 MiniMax 포인트의 정확한 달러 비용은 인쇄되지 않았습니다.
공식 차트의 평가 노트는 2026년 10월 18일 기준 Claude Code 하니스와 공개 모델 데이터를 사용한 Automation-Bench v1.0.6을 명시합니다. DeepSeek은 최대 토큰 요율을, 다른 모델은 공식 가격을 사용합니다. 하드웨어 세부와 반복 실행 신뢰구간은 명시되지 않았습니다.
| Reasoning effort | Labeled Automation-Bench score |
|---|---|
| Low | 52.8% |
| Medium | 57.7% |
| High | 59.2% |
| Xhigh | 61.2% |
| Max | 62.8% |
현재 공식 비교 표와 최대 노력 지점 모두 62.8을 보여줍니다. 비용 곡선은 벤더 설정 내 노력 설정 간 비교이며, 프로덕션 에이전트의 고정 달러 비용을 확정하지는 않습니다.
표기 점수는 Low에서 Max까지 10%포인트 상승합니다. 배포에서는 고정 과제 집합에서 Medium과 더 높은 노력을 비교하고, 실패 시도와 재시도를 총 지출에 포함해 평가하세요. 수용 기준을 만족하면서 과제당 최저 비용을 달성하는 설정을 선택하세요.
How Can Developers Access MiniMax M3.1 Flash Through CometAPI?
개발자는 CometAPI의 MiniMax M3.1 Flash API에 접근할 수 있습니다. 2026년 10월 20일 확인된 공개 카탈로그에는 페이지 URL에 preview 접미사가 남아 있어도 모델 ID가 minimax-m3.1-flash로 표시됩니다. 페이지 URL에서 API 식별자를 유추하지 말고, 계정에서 사용 가능한 모델 ID를 사용하세요.
Authorization: Bearer YOUR_COMETAPI_KEY와 Content-Type: application/json으로 https://api.cometapi.com/v1/chat/completions에 POST 요청을 전송하세요. JSON 본문에서 model을 minimax-m3.1-flash(계정에서 활성화된 경우)로 설정하고 messages 배열을 제공합니다. 요청 세부사항은 CometAPI documentation을 참조하세요.
왜 CometAPI인가요? 단일 API 키, 호환 요청 형식, 사용량 대시보드는 여러 모델 제공자에 걸쳐 작업을 단순화할 수 있습니다. MiniMax M3.1 Flash의 경우, 위의 제공자별 가격 대비 통합 편의성을 저울질하고, 계정에서 사용 가능한 기능을 확인하세요.
Which AI Agents Benefit Most From MiniMax M3.1 Flash?
| Use case | Why it may fit | Deployment consideration |
|---|---|---|
| Enterprise automation | 강한 Automation-Bench 결과 | 도구와 재시도 검증 |
| Coding assistants | 경쟁력 있는 DeepSWE 성능 | 테스트 실행 및 패치 리뷰 |
| Customer support | 낮은 입력 및 캐시 가격 | 정확도 모니터링 |
| Research agents | 1M 컨텍스트 윈도우 | 증거와 출처 확인 |
| Computer-use agents | OSWorld 역량 | UI 변경과 복구 처리 |
| Security code review | CyberGym 결과 | 독립적 검증 |
이점은 에이전트가 충분한 작업을 올바르게 완료해 재시도, 오케스트레이션, 리뷰 비용을 상쇄할 때 가장 큽니다. 프로덕션에서는 모델 수준과 워크플로 수준 성능 모두를 측정해야 합니다.
Is MiniMax M3.1 Flash the Best Value for AI Agents?
MiniMax M3.1 Flash는 반복 컨텍스트와 구조화된 도구를 포함하는 비용 민감형 에이전트에 강력한 선택지이지만, 최저 토큰 가격이 항상 성공 과제당 최저 비용으로 이어지지는 않습니다. 실패 호출, 추가 재시도, 인간 개입이 절감을 상쇄할 수 있습니다. 수용 완료율, 엔드투엔드 시간, 성공 과제당 총 비용, 인간 개입률을 평가하세요.
FAQ
왜 MiniMax M3.1 Flash가 빈 응답을 반환할 수 있나요?
MiniMax의 네이티브 OpenAI 호환 API에서는 thinking 토큰이 생성 예산을 소비합니다. 제한이 너무 작으면 finish_reason이 length로 설정되면서 가시적 답변 텍스트가 생성되기 전에 요청이 종료될 수 있습니다. 종료 사유와 토큰 사용량을 점검하고, 적절할 때 완료 예산을 늘리며, reasoning_content를 최종 답변과 별도로 처리하세요. 타사 경로에서도 동일한 응답 의미론을 확인하세요.
MiniMax M3.1 Flash 도구 호출 이력은 어떻게 저장해야 하나요?
일치하는 도구 결과를 추가하기 전에 도구 호출과 reasoning content를 포함한 어시스턴트 메시지를 완전하게 보존하세요. 가시적 답변만 저장하면 다음 단계에 필요한 정보가 제거될 수 있습니다. 도구 호출 ID와 메시지 순서를 유지하고, 실제 제공자 엔드포인트로 재생 동작을 검증하세요. MiniMax's conversation-history guidance는 네이티브 API 요구사항을 설명합니다.
팀은 MiniMax M3.1 Flash 라우팅 변경을 어떻게 탐지하나요?
고정 입력, 예상 출력 구조, 도구 호출 단언을 포함한 소규모 회귀 스위트를 유지하세요. 요청한 모델 ID, 반환된 모델 식별자(존재할 경우), 제공자, 타임스탬프, 과금 사용량을 기록하세요. 제공자 업데이트 후 재실행하세요; 안정적 별칭만으로는 기본 체크포인트나 동작이 변하지 않았음을 입증할 수 없습니다.
MiniMax M3.1 Flash 마이그레이션은 어떻게 단계적으로 수행해야 하나요?
읽기 전용 또는 재생 작업으로 시작한 다음, 테스트된 폴백을 유지하면서 실시간 트래픽의 일부를 라우팅하세요. 도구 호출 오류, 타임아웃, 실패 과제에 대한 롤백 임계값을 정의한 후 트래픽을 늘리세요. 평균 점수에만 의존하지 말고 회귀 사례를 검토하세요. 적은 수의 고비용 실패가 낮은 토큰 가격의 이점을 초과할 수 있습니다.
Conclusion
MiniMax M3.1 Flash는 저렴한 토큰, 구성 가능한 추론, 대형 컨텍스트 윈도우, 강력한 자동화 및 코딩 보고 성능을 통해 자율 AI 에이전트의 경제성을 개선합니다. 핵심 이점은 모든 벤치마크에서의 절대적 우월성보다 성능·지연·작업 비용 간 균형입니다.
개발자는 실제 워크플로 완료율과 전체 에이전트 비용을 검증하고, 요구사항에 맞는 활성 구성, 지원 기능, 과금이 있는 MiniMax M3.1 Flash 경로를 선택하세요.