Tencent Hunyuan은 2026년 11월 2일 과학 모델, 소프트웨어 도구, 재사용 가능한 워크플로를 개발하기 위한 연구용 Harness인 Hyra 2.0을 공개했다. 핵심 특징은 수일 또는 수주에 걸친 실험 전반에 대한 지속적 조정이다.
현재 공개 버전은 일반적으로 제공되는 호스팅형 Hyra 2.0 서비스가 아니라, 선택된 연구 산출물—모델, 코드, 가중치, 보고서—로 구성되어 있다. 2026년 11월 4일 기준, Tencent의 공개 자료에는 범용 오케스트레이션 API나 구독 플랜이 문서화되어 있지 않다.
핵심 요점
연구 목표: Hyra 2.0은 하나의 연구 프로젝트를 넘어 활용 가능한 재사용형 과학 모델과 도구를 개발한다.
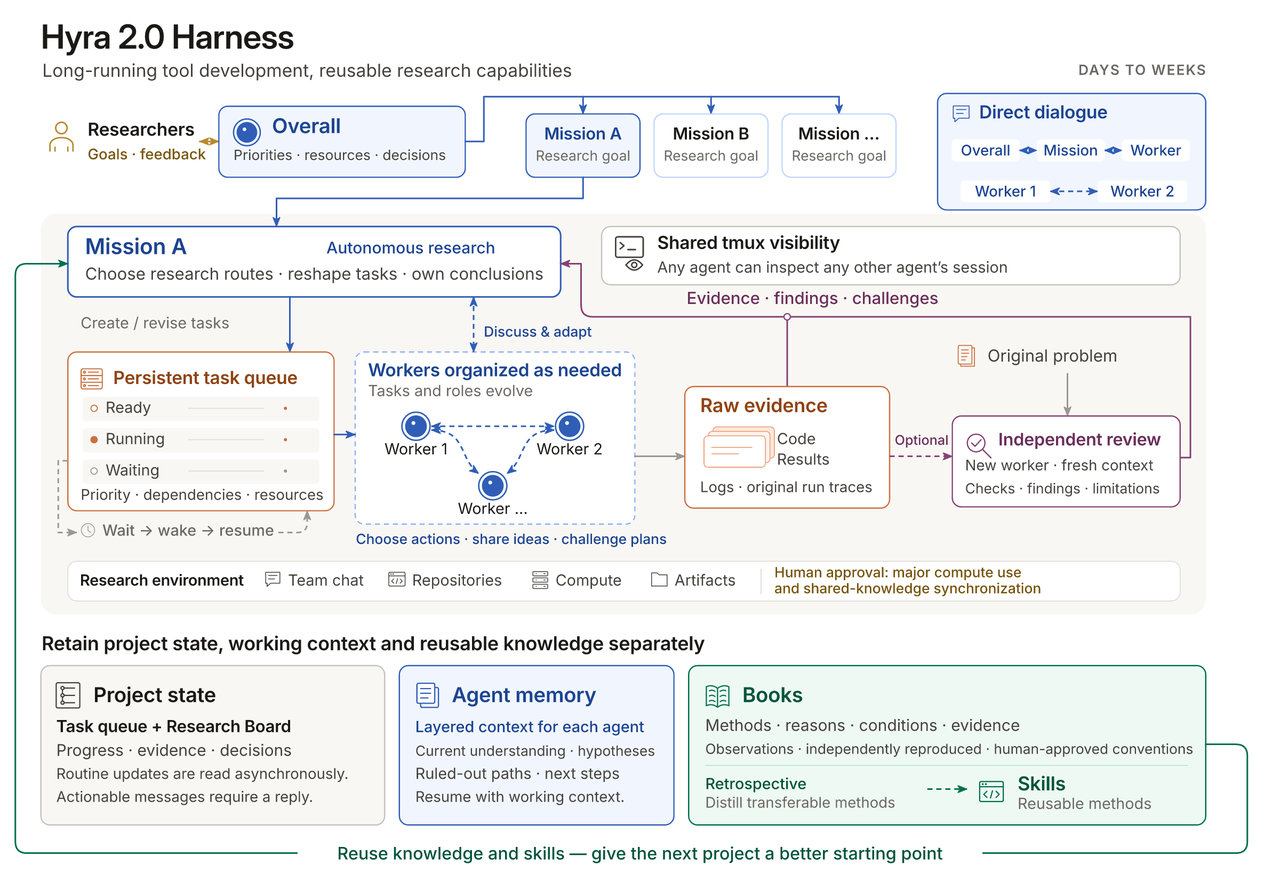
지속적 조정: Overall, Mission, Worker 에이전트가 역할을 분담하며, 큐와 연구 기록이 장기 실험의 진행을 보존한다.
지식 재사용: 에이전트 메모리, Books, 연구 스킬이 근거와 사용 조건과 함께 발견을 보존한다.
작업별 결과: 공개된 단백질, 포스필드, 세포 모델은 서로 다른 과학 워크로드를 대상으로 하며, 속도와 품질을 함께 평가해야 한다.
실무적 접근: 사용 가능한 연구 산출물부터 시작하라. 완전한 Hyra Harness와 호스팅형 Hunyuan 모델 API는 별개의 제공물이다.
Tencent Hunyuan Hyra 2.0란 무엇인가?
는 Hunyuan Research Agent 2.0을 의미하며, 복잡한 과학 연구와 엔지니어링 워크플로를 자동화하도록 설계된 멀티에이전트 시스템이다.
Tencent는 Hyra 2.0을 개별 문제 해결에서 벗어나, 더 넓은 범주의 질문을 탐구하는 데 사용되는 모델, 방법, 인프라를 개발하는 방향으로의 변화로 제시한다.
Hyra 2.0은 고정된 파라미터 수나 컨텍스트 윈도우를 갖춘 독립형 기본 모델이 아니다. 다양한 AI 모델을 사용할 수 있고, 코드를 실행하며, 과학 실험을 관리하고, 특화된 연구 에이전트를 조정할 수 있는 오케스트레이션 시스템이다.
과학 연구는 단순한 추론을 넘어선다. 완전한 프로젝트에는 실험 설계, 구현, 학습, 디버깅, 평가, 반복 수정이 필요할 수 있다. 이러한 활동은 종종 며칠 또는 몇 주에 걸쳐 진행되며, 병렬 실험과 공유 컴퓨팅 자원이 관여한다.
Hyra 2.0은 모델 지능을 지속적 실행, 구조화된 협업, 증거 기반 검증과 결합해 이러한 운영적 과제를 해결한다.
Hyra 2.0 기술 사양
사양
Hyra 2.0
개발자
Tencent Hunyuan
공개 발표
2026년 11월 2일
시스템 범주
자율형 과학 연구 에이전트
핵심 아키텍처
계층적 멀티에이전트 Harness
에이전트 역할
Overall, Mission, Worker
연구 실행
장시간, 동시 워크플로
작업 관리
지속형 작업 큐
협업
Research Board 및 에이전트 메시징
검증
증거 기반 결과 및 독립적 Review Worker
메모리
프로젝트 상태, 계층형 에이전트 메모리, 공유 Books
지식 재사용
검증된 발견과 재사용 가능한 스킬
모델 유연성
서로 다른 Workers가 상이한 기반 모델을 사용할 수 있음
연구 환경
WeCom, 컴퓨팅 플랫폼, 코드 저장소
인적 감독
중대한 작업에 대한 승인 체크포인트
공개 산출물
선택된 모델, 소스 코드, 학습된 가중치, 기술 보고서
이 사양은 시스템의 오케스트레이션과 연구 역량을 설명한다. Hyra 2.0이 생성한 개별 과학 모델은 별도의 아키텍처, 파라미터 수, 성능 벤치마크를 가진다.
왜 Hyra 2.0은 도구를 구축하는가
Hyra 1.0에서 Hyra 2.0으로의 전환은 자동화된 연구의 근본적 한계를 다룬다. 즉, 하나의 문제를 성공적으로 해결했다고 해서 다음 문제를 해결하는 시스템의 능력이 반드시 향상되는 것은 아니다.
Hyra 1.0은 비교적 단순한 에이전트 루프를 사용해 해법을 생성하고, 평가를 실행하며, 반복 시도를 통해 결과를 개선했다. Tencent의 오픈소스 Hy3 모델을 기반으로, Hyra 1.0은 sumsets와 difference sets를 연결하는 지수의 최적값을 확정하는 데 기여했고, 결과와 함께 기계 검증된 증명이 공개되었다. 이 구분은 중요하다. 평가된 수학적 결과는 구체적 산출물인 반면, 연구 과정의 개선은 이후 문제들에서 재사용될 수 있다.
다음 과제는 연구 진행을 누적되게 만드는 것이다.
답에서 재사용 가능한 역량으로
수학 자동화를 세 단계로 생각해 보자:
에이전트가 개별 수학 문제를 푼다.
에이전트가 유사한 문제를 풀 수 있는 증명 워크플로를 개발한다.
에이전트가 향후 연구 시스템이 사용할 추론 모델과 검증 도구를 개선한다.
첫째는 답을 만든다. 둘째는 재사용 가능한 방법을 만든다. 셋째는 근본적인 연구 역량 자체를 개선할 수 있다.
Hyra 2.0은 둘째와 셋째 수준을 목표로 한다.
Tencent는 재사용 가능한 도구를 두 가지 큰 범주로 설명한다. 기호적 도구는 코드, 알고리즘, 규칙, 워크플로로 역량을 표현한다. 예로 자동 검증 시스템, 과학 검색 알고리즘, 실험 관리 파이프라인이 있다. 파라메트릭 도구는 단백질 설계 모델과 과학용 기본 모델을 포함해 학습된 역량을 모델 가중치에 저장한다.
어느 범주를 개선하든 모든 연구 프로젝트가 동일한 출발점에서 시작할 필요 없이 다수의 다운스트림 작업에 이점을 제공할 수 있다.
재귀적 자기개선 방향
Hyra 2.0은 재귀적 자기개선로 향하는 경로도 만든다. 기본 모델 연구는 학습 인프라, 합성 데이터 파이프라인, 최적화 알고리즘, 추론 시스템에 의존한다.
만약 AI 에이전트가 이러한 도구를 개선한다면, 더 강한 모델 개발을 도울 수 있다. 더 강한 모델은 이후의 도구 개발 라운드에 참여할 수 있다.
더 나은 연구 도구 → 더 강한 AI 모델 → 더 유능한 연구 에이전트 → 더 나은 연구 도구.
Tencent는 사전학습 인프라, 사후학습 데이터 생성, 추론 최적화에 Hyra를 적용한다고 설명한다. 이는 도구 개발과 모델 개발 간의 그럴듯한 피드백 루프를 만든다. 그 자체로 무제한 또는 완전히 자율적인 재귀 개선을 입증하는 것은 아니며, 제안된 각 이득은 그 효과를 분리하는 실험을 여전히 필요로 한다.
Hyra 2.0 Harness 아키텍처는 어떻게 작동하는가?
Harness는 Hyra 2.0의 핵심 엔지니어링 혁신이다. 일반적인 에이전트 루프는 도구를 실행하고 결과를 점검하며 세션 내에서 추론을 계속할 수 있다. 과학 모델 개발은 더 정교한 실행 환경을 필요로 한다.
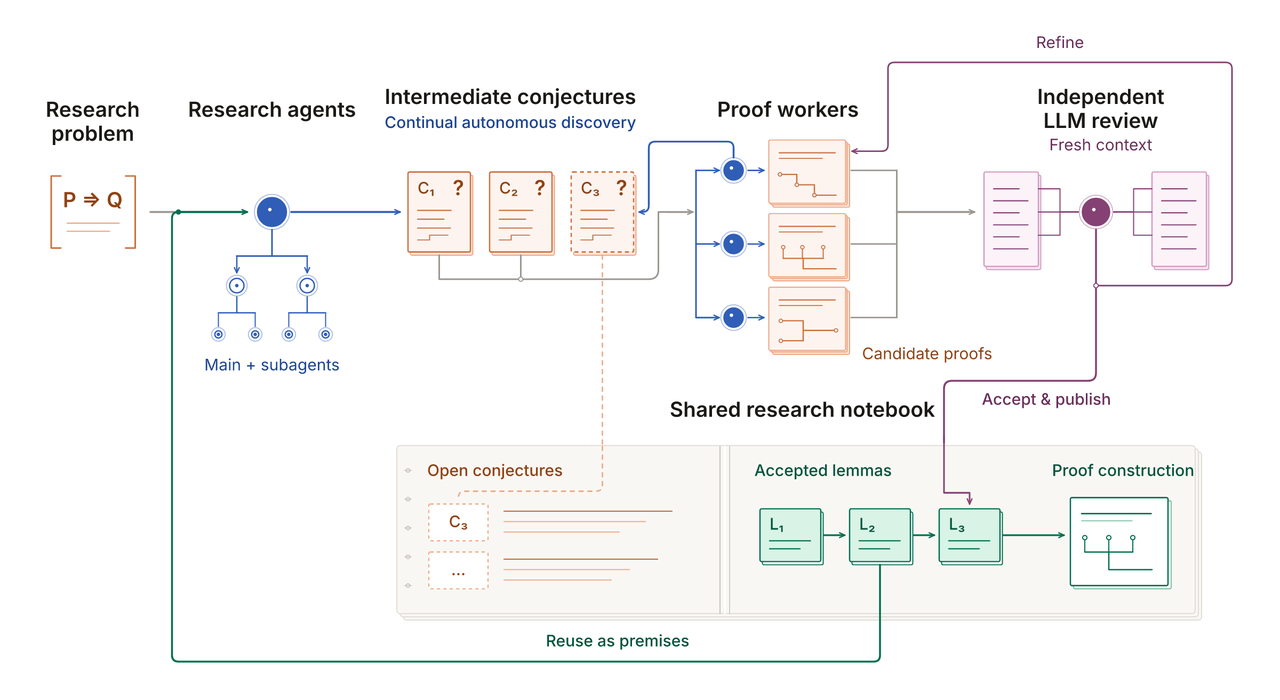
실험은 몇 시간 동안 진행될 수 있고, 학습 작업은 며칠이 걸릴 수 있으며, 별도 연구 방향은 상이한 컴퓨팅 자원과 검증 방법을 요구할 수 있다. Hyra 2.0은 세 계층의 에이전트, 지속적 작업 스케줄링, 구조화된 연구 기록, 독립적 검증을 통해 이러한 요구를 해결한다.
Overall은 최고 수준의 조정 계층이다. 사람 연구자와 소통하고, 연구 목표와의 정합을 유지하며, 우선순위를 관리하고, 컴퓨팅 자원을 조정한다.
책임에는 추가 자원을 받아야 할 프로젝트를 결정하고 인간 승인이 필요한 결정을 식별하는 일이 포함된다. 따라서 Overall은 자율 연구 활동과 인간 연구 관리 사이의 조정 계층 역할을 한다.
Mission: 장기 연구 계획
각 Mission은 특정 연구 문제를 책임진다. Mission은 여러 실험에 걸쳐 연구 방향을 유지하고, Workers를 조직하며, 결과를 해석하고, 가설이 추가 조사를 받을 가치가 있는지 결정한다.
또한 언제 연구 접근법을 수정하거나 포기해야 하는지도 결정한다. 이는 단일 에이전트 세션이 모든 중간 행동을 유지할 필요 없이 장기 프로젝트의 연속성을 만든다.
Worker: 실험 실행과 독립적 탐색
Workers는 특화된 연구 작업을 수행한다. 책임에는 코드 읽기, 알고리즘 구현, 실험 실행, 실패 진단, 대안 접근법 제안이 포함된다.
Workers는 Mission의 결정을 도전할 수 있으며, 서로 다른 Workers는 서로 다른 기반 AI 모델을 사용할 수 있다. 이 구조는 병렬 탐색을 지원하고 단일 에이전트의 추론 경로에 대한 의존을 줄인다.
지속형 스케줄링과 Research Board
Hyra 2.0은 연구 작업을 지속형 큐에 넣는다. 스케줄러는 작업 우선순위, 의존성, 사용 가능한 자원을 고려해 Workers를 실행한다.
한 실험이 학습 결과나 인간 승인을 기다리는 동안에도 다른 작업은 계속될 수 있다. 에이전트는 실험 종료 후 다음 활성화를 스스로 스케줄링할 수도 있다.
Research Board는 가설, 발견, 증거, 주요 결정을 기록한다. 이는 연구 프로젝트의 지속 상태를 개별 에이전트 대화와 분리한다.
독립 검증과 인간 승인
Worker의 결론은 코드 버전, 실행 로그, 평가 결과, 원본 트레이스 같은 실험 증거로 뒷받침되어야 한다.
추가 검토가 필요한 결과의 경우, 별도의 Review Worker가 원 문제와 증거를 독립적으로 점검할 수 있다. 이 과정은 후속 연구에 영향을 미치기 전, 근거 없는 결론과 구현 실수를 식별하는 데 도움이 된다.
고비용 컴퓨팅 작업과 공유 팀 지식 변경은 여전히 인간 승인을 받는다. 따라서 아키텍처는 자율 실행과 중대한 결정에 대한 명시적 체크포인트를 결합한다.
Books: 연구 경험을 스킬로 전환
Hyra 2.0은 정보를 세 가지 저장 범주로 분리한다:
프로젝트 상태: 작업 큐, 협업 기록, 연구 진행.
에이전트 메모리: 현재 이해, 가설, 기각된 접근법, 향후 계획.
Books: 연구 프로젝트 간 공유되는 재사용 지식.
Books는 정보를 관찰, 검증된 발견, 관례로 분류한다. 단일 실험은 관찰을 생성할 수 있다. 독립적으로 재현된 발견은 검증된 지식이 될 수 있다. 팀 행동에 영향을 주는 관례는 인간 확인을 요구한다.
프로젝트 리뷰 중, 재사용 가능한 방법은 스킬로 전환될 수 있다. 성공적인 수치 검증 절차나 학습 불안정성 진단 방법은 향후 연구 워크플로의 재사용 가능한 구성 요소가 될 수 있다.
이 메커니즘은 개별 세션을 넘어 운영적 개선을 보존하도록 한다.
Hyra 2.0는 어떤 연구 결과를 달성했는가?
Hyra 2.0의 초기 결과는 과학 모델, 수학 연구, 양자 컴퓨팅, 로보틱스, 단일 세포 분석, 하드웨어 엔지니어링을 포괄한다.
공식 연구 저장소는 선택된 구현, 가중치, 보고서, 검증 산출물을 포함한다. 아래 개요는 Tencent가 보고한 결과를 요약한다. 이어지는 하위 섹션은 시험 조건과 이용 가능성을 설명한다. 이는 하나의 범용 에이전트 능력 순위가 아니라 서로 다른 과학 작업들이다.
연구 산출물
기술 규모 또는 지표
보고된 성과
HyInv
1.96M parameters
ProteinMPNN 대비 단백질 서열 생성 57× 속도
HyPLM-Flash
650M parameters; 726B training tokens
하나의 H20에서 130,000 residues/s; 32개 과제 전반에서 경쟁적 품질
HyFF
다섯 모델; 2.3M–1.2B parameters
16개 공개 모델 대비 정확도-속도 파레토 전선
HyCell
16.1M parameters; 512-dimensional embeddings
7개 홀드아웃 세포 아틀라스에서 종합 점수 0.735
HyProver
수학적 증명 워크플로
Petty의 추측과 Yau의 circle-action 추측 관련 결과
HyQEC
Quantum code [[488,123,22]]
효율 지표 122.0; 명시된 제약 하에서 이전 챌린지 리더 대비 약 48% 향상
Spiral Hand
5지 로보틱 디자인
DR5 시뮬레이션에서 객체 회전 28.6% 더 빠름
XiangShan RISC-V
SPEC CPU2006 성능
GHz당 점수 5.79% 향상, 면적 0.3% 증가
이 결과는 하나의 범용 에이전트 점수가 아니라 다양한 유형의 연구 산출물을 보여준다.
HyInv: 57× 더 빠른 단백질 역접힘
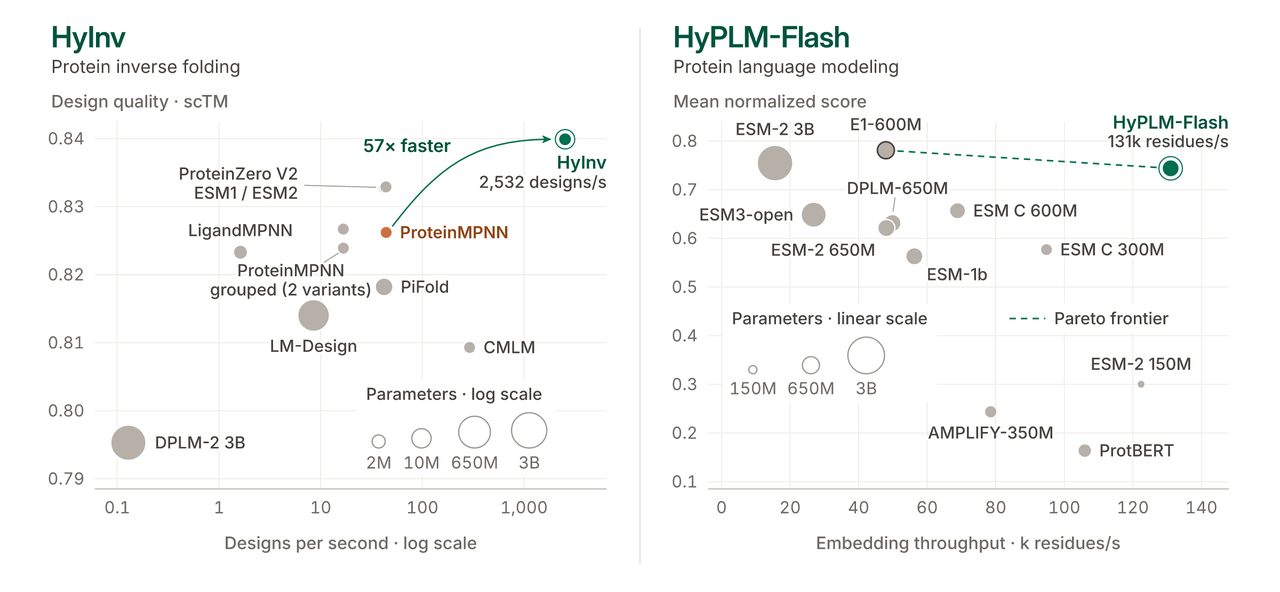
HyInv는 목표 백본에 대한 단백질 서열을 생성한다. 1.96M-parameter 모델이 ProteinMPNN 대비 57× 더 빠르게 동작한다고 보고된다. 128개 디자인에 대해 402-residue 백본, 하나의 H20와 BF16에서 50.6 ms로 보고되며, 컴파일과 CUDA 그래프 캡처는 제외된다. 이는 웜업된 생성 속도로 보아야 하며, 구조적 스크리닝은 전체 설계 주기에 여전히 기여한다.
HyPLM-Flash: 고처리량 단백질 언어 모델링
HyPLM-Flash는 726B 토큰으로 학습된 650M-parameter 단백질 언어 모델이다. 공개된 28-checkpoint, 32-task 평가에서 ProteinGym 점수는 유사한 인코더들과 통계적으로 동률이었다. INT8 추론은 하나의 H20에서 약 130,000 residues/s에 도달한다. 다운스트림 분석에서 작은 표현 차이가 영향을 미칠 때는 BF16이 바람직하다. 아래 출시 도표는 다른 평가 범위를 사용한다.
HyFF: 다섯 가지 모델 크기로 더 빠른 분자 시뮬레이션
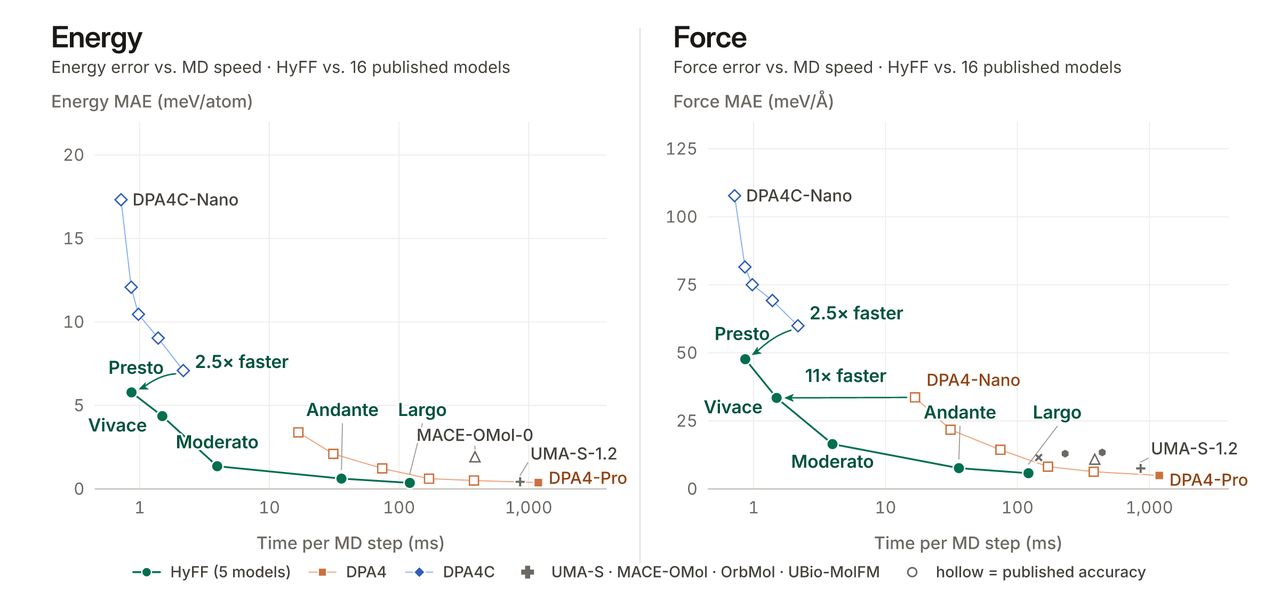
HyFF는 분자 에너지와 원자력을 예측하며, 2.3M–1.2B 파라미터 범위의 다섯 모델 크기를 제공한다. 보고된 OMol25 비교에서, Andante는 UMA-S-1.2와 유사한 force 오차(7.65 대 7.55 meV/Å)와 함께 분자 동역학에서 29× 더 빠르다. Largo는 DPA4-Pro보다 낮은 에너지 오차(0.364 대 0.380 meV/atom)와 9.7× 더 높은 속도를 보고한다. 시뮬레이션할 분자에 대해 정확도와 런타임을 모두 시험해 크기를 선택하라.
HyCell: 단일 세포 임베딩 모델
HyCell은 인간 세포 유전자 발현 카운트를 512차원 임베딩으로 매핑하는 16.1M-parameter 모델이다. 7개 홀드아웃 세포 아틀라스 전반에서 종합 점수 0.735를 기록하며, Stack의 0.736에 근접한다. 이 점수는 생물학적 보존성, 배치 보정, 주석 전이를 결합한 것이며, 분류 정확도가 아니다. 연구에 관련된 구성 지표를 확인하라.
HyProver: 수학 연구를 위한 재사용 워크플로
HyProver는 수학 작업을 탐색, 증명 개발, 리뷰로 조직한다. 보고된 결과는 Petty의 등거리 집합 추측의 5차원 사례를 확립하고, Yau의 circle-action 추측의 비제한 형태에 대한 반례를 제시한다. 이러한 결과는 구체적 경계를 가진다. Petty의 추측은 모든 차원에서 해결된 것이 아니며, Yau의 단순연결 형태는 여전히 열린 문제다.
HyQEC: 양자 코드 효율 48% 향상
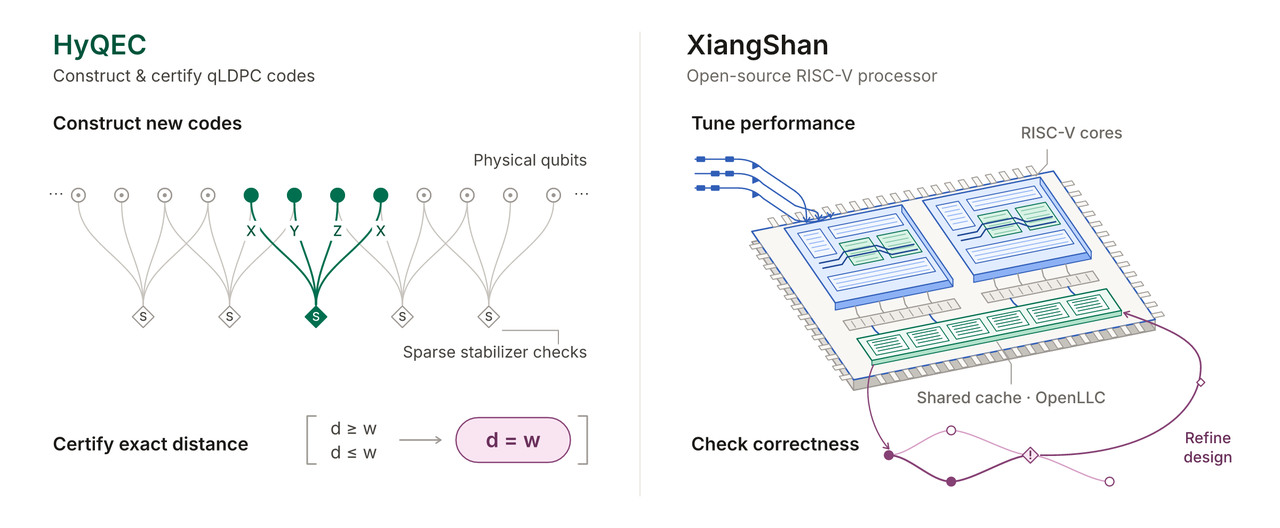
HyQEC는 양자 오류정정 코드를 탐색하고 거리를 점검한다. Tencent는 [[488,123,22]] 구성과 kd²/n 효율 지표 122.0을 보고하며, 명시된 제약 하에서 이전 챌린지 리더 대비 약 48% 높다고 한다. 이는 코드 효율을 측정하는 것이며, 양자 하드웨어 성능을 의미하지 않는다. 2026년 11월 5일 기준, 공식 릴리스는 hyqec-verify와 hyqec-check 도구를 포함하지만, 이 특정 구성의 코드 파일과 증명서는 공개 예정 증거로 여전히 표기되어 있다. 공개 도구와 특정 결과에 대한 공공 재현 가능 증거는 별개의 이정표다.
Spiral Hand: AI 설계 로보틱 형태
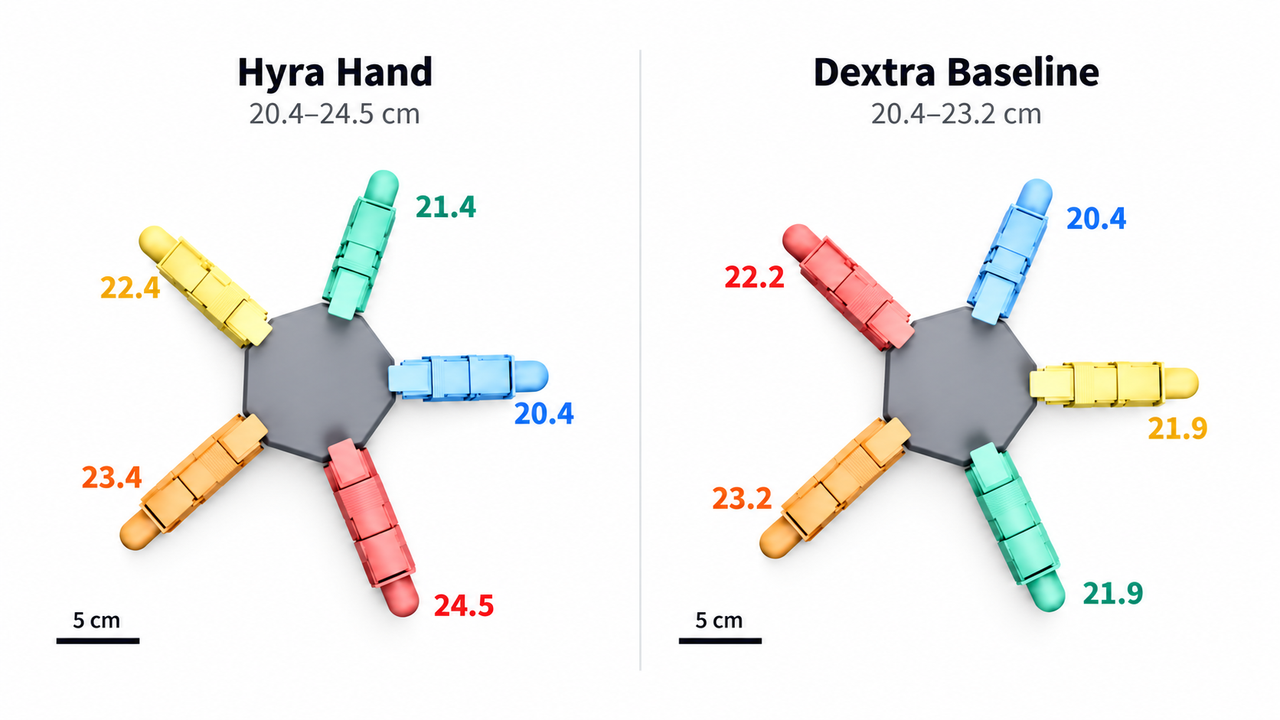
Hyra의 Spiral Staircase Hand는 손바닥 주변으로 갈수록 더 긴 손가락을 사용한다. Tencent는 동일한 정책 파인튜닝 예산 이후, DR5 시뮬레이션에서 Dextra 대비 객체 회전 28.6% 더 빠르고 완료된 목표가 21% 더 많다고 보고한다. 실제 하드웨어 검증은 미완이다.
XiangShan: 프로세서 최적화와 형식 검증
XiangShan RISC-V 프로세서에서, Tencent는 GHz당 SPEC CPU2006 점수 5.79% 개선, 코어 주파수 불변, 면적 0.3% 증가를 보고한다. 또한 이전에 보고되지 않은 버그 10개와 캐시 일관성 반례를 발견했다. 이러한 결과는 평가된 설계와 워크로드에 적용되며, 모든 RISC-V 시스템에 일반화되는 것은 아니다.
연구자들은 Hyra 2.0의 벤치마크를 어떻게 해석해야 하는가?
각 벤치마크를 해당 워크로드 맥락에서 읽어라. 동일한 입력, 하드웨어, 정밀도, 타이밍 경계를 비교하고, 출력 품질을 런타임과 함께 평가하라. 과학적 주장에 대해서는 지원 코드, 데이터, 증명 또는 증명서를 점검하라. 보고된 결과와 독립 재현된 결과는 증거 수준이 다르다.
개발자는 API로 Hyra 2.0을 사용할 수 있는가?
2026년 11월 4일 기준, 공개 Hyra 자료는 연구 산출물과 선택된 릴리스를 설명한다. 일반적으로 제공되는 Hyra 2.0 오케스트레이션 API, 구독 가격, 완전한 배포 패키지는 문서화되어 있지 않다. 연구 발표와 다운로드 가능한 산출물은 전체 시스템의 호스팅형 접근과 구분해야 한다.
공개 자료는 연구 결과와 선택된 산출물에 초점을 맞춘다. 개발자는 HyInv, HyPLM-Flash, HyFF, HyCell 등 Hyra를 통해 만들어진 일부 모델을 관련 연구 저장소를 통해 이용할 수 있다.
완전한 Hyra 2.0 Harness는 이러한 다운로드 산출물과 구분되어야 한다.
Hyra 2.0과 호스팅형 Hunyuan API
개발자는 모델 ID **hy4**로 CometAPI를 통해 Tencent Hy4에 접근할 수 있다. 이는 코딩, 분석, 에이전트 워크플로 같은 애플리케이션을 위한 호스팅형 모델 추론을 제공한다. 완전한 Hyra 2.0 연구 Harness를 제공하는 것은 아니며, Hyra를 통해 개발된 과학 모델은 Tencent의 연구 저장소를 통해 별도로 제공된다.
연구팀에서 Hyra 2.0이 유용하려면?
공개된 산출물 하나와 작은 기준 워크로드로 시작하라. 성공적으로 실행되면, 고정된 품질 임계값과 컴퓨팅 예산으로 대표적인 로컬 데이터를 시험하라. 저장소 리비전, 가중치, 환경, 입력, 출력을 함께 보관해 동료가 결과를 재현할 수 있도록 하라. 대기 시간, 의존 실험, 경쟁 가설이 의미 있게 존재할 때 지속형 멀티에이전트 조정을 추가하라.
결론
Hyra 2.0은 연구 계획, 실험 실행, 재사용 지식을 하나의 지속적 워크플로로 결합한다. 과학적 산출물은 후속 작업을 위한 유망한 출발점이다. 연구팀에게 실질적 시험은 공개된 산출물이 실제 실험을 개선하고 다른 이들이 점검·재현할 수 있는 증거를 산출하는지 여부다.
FAQ
연구실은 첫 Hyra 산출물 시험을 어떻게 예산화해야 하는가?
세 단계에 예산을 배분하라: 재현 가능한 환경 설정, 작은 기준 사례 실행, 대표적 로컬 워크로드 평가. 가속기 사용뿐 아니라 준비와 리뷰 시간도 포함하라. 시작 전에 수용 기준을 정하라. 예를 들어, 요구되는 품질 수준을 유지하면서 처리 시간을 줄이는 것이다. 초기 시험은 전체 연구 캠페인에 필요한 자원을 투입하지 않고도 실패를 진단할 수 있을 만큼 작아야 한다.
재현성 패키지에는 무엇이 포함되어야 하는가?
저장소 리비전, 모델 가중치 식별자, 환경 버전, 입력 데이터 출처, 구성, 관련 시 랜덤 시드, 평가 출력을 함께 보관하라. 공개 예시에 대한 변경 사항을 기록하라. 결과가 증명 또는 증명서에 의존하는 경우, 검사기 버전과 그 출력도 보존하라. 패키지는 다른 연구자가 소프트웨어 문제, 변경된 입력, 과학적 결과의 실제 차이를 구분할 수 있게 해야 한다.
벤치마크 오염을 어떻게 피할 수 있는가?
모델 선택이나 설정 튜닝에 사용한 데이터와 최종 평가에 사용한 데이터를 분리하라. 후보를 비교하기 전에 최종 프로토콜을 고정하고, 확인 가능한 범위에서 사전학습 또는 개발 데이터와의 중복을 문서화하라. 새로운 과학 데이터셋의 경우, 의도된 배포 환경을 반영하는 분할을 사용하라. 예를 들어, 홀드아웃 연구나 실험 조건이다. 평가 예제가 반복적으로 시험된 시스템을 형성했다면 강한 점수의 정보 가치는 낮아진다.
상충하는 에이전트 결론은 어떻게 처리해야 하는가?
다수결로 결론을 결합하기보다 근거가 되는 실험을 비교하라. 에이전트가 동일한 데이터셋 버전, 가정, 지표, 소프트웨어 구성을 사용했는지 확인하라. 차이가 설명될 때까지 두 발견을 보존하고, 경쟁 설명을 구별하는 집중 실험을 실행하라. 에이전트 간 합의는 유용하지만, 외부 측정이나 점검 가능한 논증을 대체하지는 않는다.
더 단순한 연구 워크플로가 바람직한 때는 언제인가?
성숙한 스크립트와 명확한 평가기를 가진 짧고 결정적인 작업은 지속형 멀티에이전트 조정의 이점을 못 볼 수 있다. 추가 스케줄링, 기록 보관, 리뷰 비용이 절감분을 초과할 수 있다. 의미 있는 의존성, 긴 대기, 여러 경쟁 가설, 유지가 필요한 재사용 산출물이 있을 때 오케스트레이션을 도입하라. 결정은 워크로드 구조와 관찰된 조정 비용을 따라야 한다.