
TL;DR: FLUX 3는 Black Forest Labs의 통합 멀티모달 기반 모델입니다. 공개 Video API는 텍스트, 이미지, 키프레임 또는 기존 비디오로부터 최대 20초, 24 fps의 클립을 생성하며, 선택적으로 동기화된 오디오를 포함할 수 있습니다. HD부터 UHD/4K까지 해상도를 지원하며, FLUX 3 Image와 오픈 웨이트 FLUX 3 Dev 모델은 별도의 롤아웃 대상입니다.
FLUX 3란 무엇인가?
FLUX 3는 Black Forest Labs의 프런티어 멀티모달 모델입니다. 이미지는 이미지, 비디오는 비디오, 오디오는 오디오처럼 각각을 따로 학습하는 대신, BFL은 이들 모달리티 전반에 걸쳐 공유 표현을 학습합니다.
핵심 아이디어는 이미지, 비디오, 사운드가 동일한 기저 세계에 대한 서로 다른 관측이라는 점입니다. 움직이는 자동차는 시각적 외형, 동작, 소리, 공간적 관계, 재질 특성, 인과적 거동을 가집니다. 이러한 신호를 함께 학습하면 개별 프레임만 학습하는 것보다 더 많은 제약을 모델에 부여할 수 있습니다.
이 때문에 Black Forest Labs는 FLUX 3를 단순한 이미지/비디오 생성기가 아닌 현실 모델 혹은 세계 모델로의 한 걸음이라 설명합니다. 공개된 비디오 시스템은 이미 그 방향을 보여줍니다. 동기화된 오디오, 동작, 장면 구조, 대사, 카메라 거동, 환경음이 하나의 생성 워크플로 내에서 처리됩니다.
발표된 FLUX 3의 모든 기능이 아직 공개된 것은 아닙니다. 2026년 9월 현재, FLUX 3 Video가 제공되며, FLUX 3 Image와 오픈 웨이트 FLUX 3 Dev 모델은 별도의 롤아웃 항목으로 남아 있습니다.
FLUX 3 한눈에 보기 사양
다음 사양은 7월의 초기 런치 구성보다 현재 FLUX 3 개발자 문서를 반영합니다.
| Specification | Official FLUX 3 documentation |
|---|---|
| Developer | Black Forest Labs |
| Model family | FLUX 3 |
| Model type | Unified multimodal foundation / generative video model |
| Public video release | August 4, 2026 |
| Core training direction | Joint image, video, and audio representation learning |
| Research foundation | Self-Flow |
| Current primary API output | Video with synchronized audio |
| Text-to-video | Supported |
| Image-to-video | Supported |
| Keyframe-to-video | Supported |
| Video continuation | Supported |
| Maximum T2V/I2V duration | 20 seconds |
| Video continuation duration | 5–15 seconds |
| Frame rate | 24 fps |
| Resolution | HD, FHD, QHD/2K, and UHD/4K |
| FHD 16:9 resolution | 1920 × 1088 |
| Image references | Up to 10 for I2V/keyframe workflows |
| Native audio | Yes |
| Multilingual dialogue | Yes |
| Lip synchronization | Yes |
| Multi-shot generation | Yes |
| Draft Mode | Yes |
| Public still-image FLUX 3 endpoint | Not yet generally released by BFL |
| Open-weight FLUX 3 Dev | Planned |
현재 BFL 문서는 텍스트-투-비디오 및 이미지-투-비디오에 대해 5–20초, 비디오 이어 생성에 대해 5–15초의 생성 윈도우를 명시합니다. 지원 화면비는 21:9, 2:1, 16:9, 4:3, 1:1, 3:4, 9:16입니다.
FLUX 3는 어떻게 동작하나?
Self-Flow
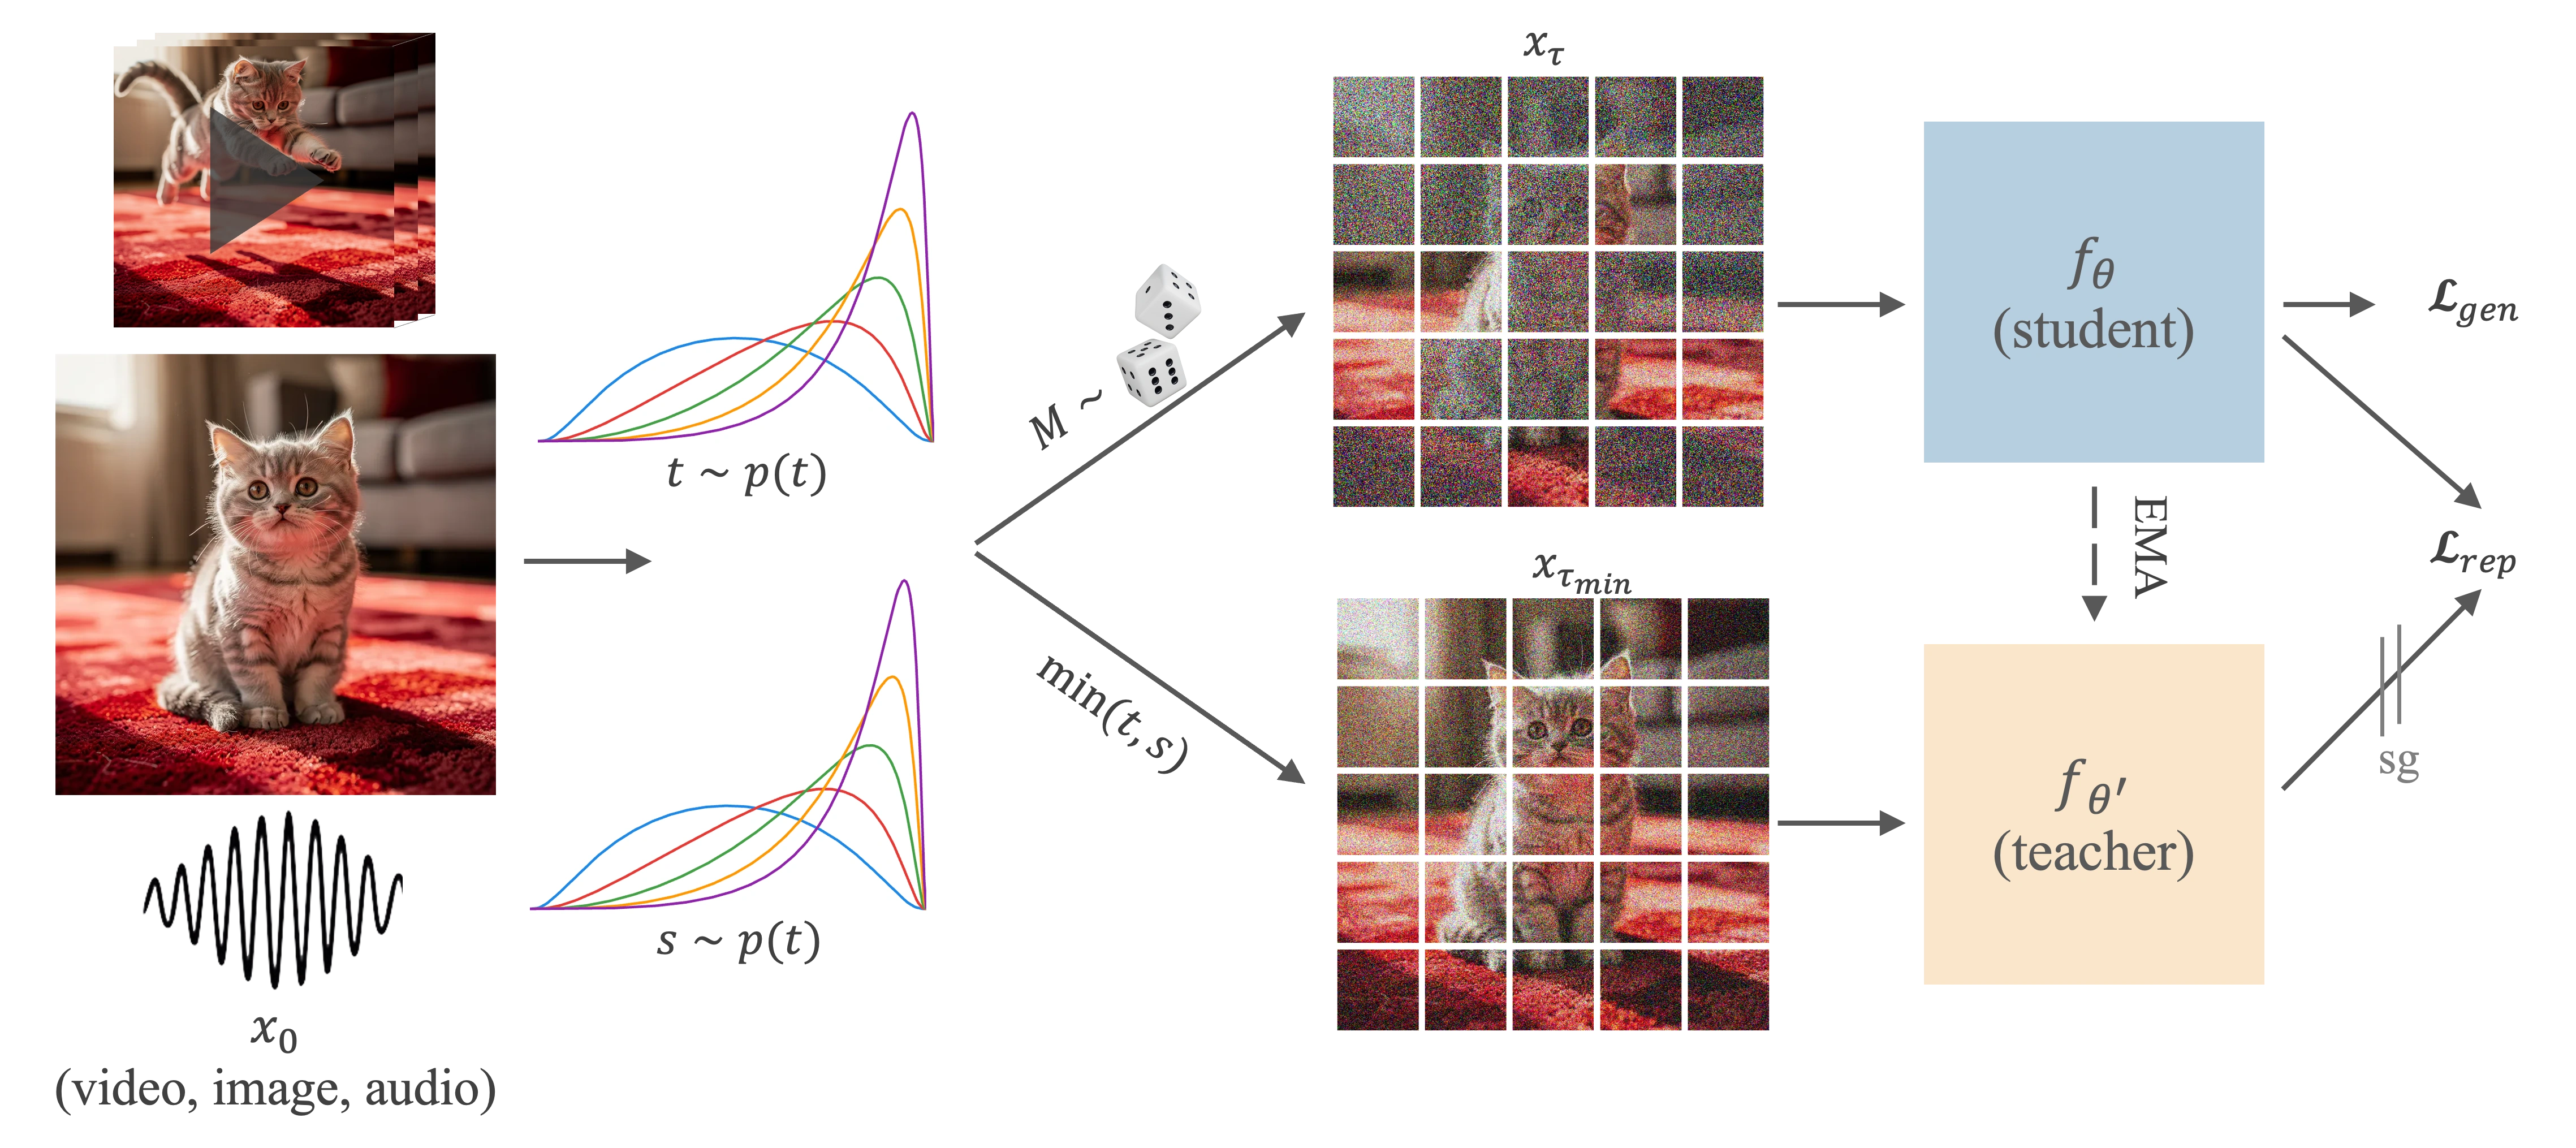
핵심 연구 기반은 BFL의 자기지도식 플로 매칭 접근법인 Self-Flow입니다. 전통적 생성 파이프라인은 종종 별도의 사전학습 표현 모델이나 보조 감독에 의존합니다. Self-Flow는 생성 목적 자체로부터 유용한 표현을 직접 학습하도록 설계되었습니다.
주요 메커니즘은 Dual-Timestep Scheduling입니다. 서로 다른 토큰 그룹에 훈련 중 상이한 노이즈 레벨을 부여해 정보 비대칭을 만듭니다. 일부 입력 부분은 다른 부분보다 더 많은 유효 정보를 포함하게 되고, 네트워크는 누락 정보를 추론하는 데 도움이 되는 표현을 구축하도록 강제됩니다.
실무적으로, FLUX 3는 개별 프레임의 모양을 암기하는 대신 객체, 프레임, 동작, 소리, 시간적 사건 간의 관계를 학습하도록 유도됩니다.
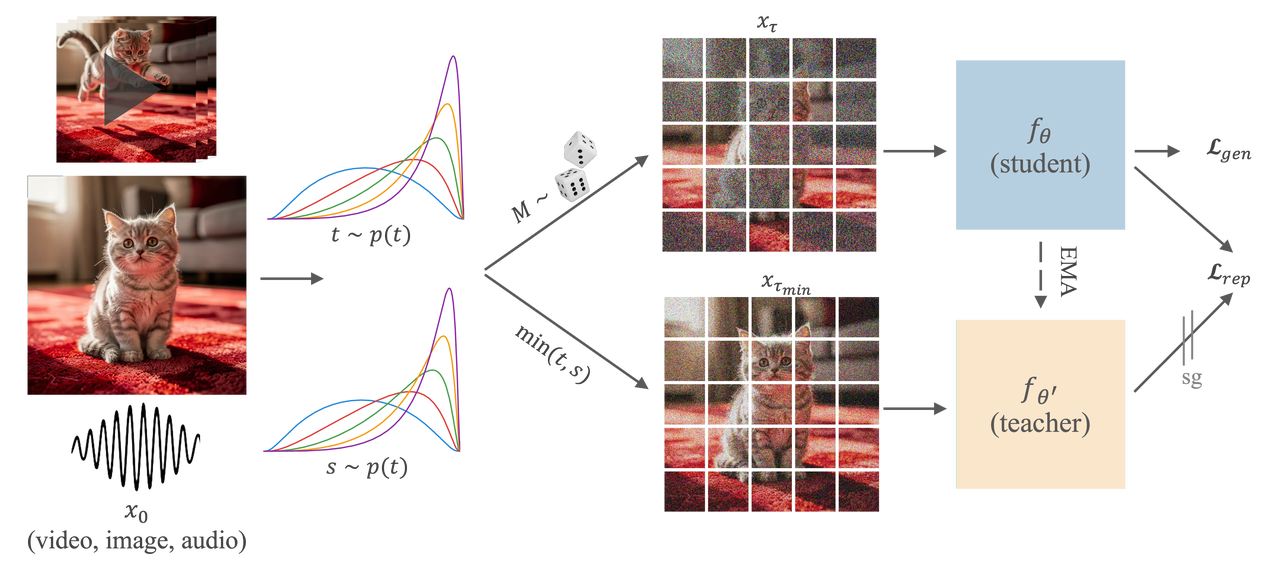
Self-Flow 방법 아키텍처 - 공식 이미지 출처: Black Forest Labs Self-Flow project
BFL은 또한 FLUX.2 파생 백본과 수백만 개의 비디오, 수억 장의 이미지를 사용한 공동 멀티모달 학습을 시험했습니다. 이 실험은 표현 학습과 생성을 별개 시스템으로 둘 필요가 없다는 FLUX 3의 더 넓은 가설을 뒷받침합니다.
왜 비디오가 FLUX 3의 중심인가
비디오는 정지 이미지로는 제공할 수 없는 정보를 포함하므로 세계 모델링에 특히 가치가 있습니다. 한 프레임은 바닥 위의 공을 보여줄 수 있지만, 비디오는 공이 떨어지고, 튀고, 충돌 시 변형되고, 소리를 내며, 그 후 방향이 바뀌는 것을 드러낼 수 있습니다.
BFL은 비디오 예측이 FLUX 3 학습 연산의 95% 이상을 차지한다고 공개했습니다. 오디오는 훨씬 저차원 신호이며 가시 이벤트와 밀접히 결합되어 있어 상대적으로 비용이 저렴합니다. 이러한 자원 배분은 왜 비디오가 FLUX 3에서 가장 먼저 일반 제공에 도달했는지를 설명합니다.
FLUX 3로 무엇을 할 수 있나?
텍스트-투-비디오
사용자는 자연어 지시만으로 완전한 비디오를 생성할 수 있습니다. BFL에 따르면 공개 모델은 단순·복합 프롬프트 모두를 처리하며, 동작, 장면 논리, 시각적 구성, 소리를 조율합니다. 단일 피사체의 짧은 애니메이션이 아니라 다중 순차 이벤트가 포함된 프롬프트에 특히 유용합니다.
이미지-투-비디오와 키프레임
FLUX 3는 시작 이미지를 애니메이션화하거나, 종료 프레임을 목표로 하거나, 여러 이미지를 시간에 맞춘 키프레임으로 사용할 수 있습니다. 현재 API는 이미지-투-비디오 워크플로에서 최대 10개의 이미지 참조를 지원하여, 모델이 전체 시퀀스를 즉흥적으로 만드는 대신 시간이 지남에 따라 장면이 어떻게 변하는지 제어할 수 있게 합니다.
비디오 이어서 생성
기존 비디오와 그 오디오를 컨텍스트로 제공하면, FLUX 3가 다음에 일어나는 일을 생성할 수 있습니다. BFL은 전환 구간에서도 동작, 카메라 거동, 대사, 사운드를 보존하는 이어 생성을 설명하며, 이는 두 개의 독립 클립을 각각 생성해 단순히 파일을 이어붙이는 것과 실질적으로 다릅니다.
네이티브 오디오와 대사
FLUX 3는 별도의 음성/사운드 생성 과정 없이 생성 시점에 오디오를 함께 만듭니다. 공개된 오디오 기능에는 대사, 효과음, 앰비언스가 포함됩니다. 립싱크를 갖춘 다국어 대사도 지원됩니다.
한 번의 생성에 여러 샷
하나의 프롬프트에 여러 장면 또는 카메라 앵글을 포함할 수 있습니다. 이는 많은 초기 비디오 모델이 하나의 짧고 시각적으로 연속적인 샷에서 가장 강한 성능을 보였던 것과 달리, FLUX 3는 하나의 생성 내에서 멀티 샷 시퀀스를 명시적으로 지원하도록 설계되었음을 의미합니다.
Draft Mode
Draft Mode는 대량 비디오 생성에서 실용적 추가 기능 중 하나입니다. 모든 프롬프트 실험에 정가를 지불하는 대신, 더 빠르고 저렴한 미리보기를 만든 뒤 선택한 드래프트를 향상해 구도와 동작을 유지할 수 있습니다. 현재 BFL 요금에 따르면 표준 T2V/I2V 드래프트는 초당 $0.06이며, 일반 HD 생성은 초당 $0.17입니다.
아직 출하되지 않은 것은?
FLUX 3의 론치 발표는 단일 아키텍처 방향 아래 이미지, 비디오, 오디오, 액션 기능을 설명했지만, 제공은 순차적으로 진행됩니다.
| Capability | Current BFL roadmap and availability |
|---|---|
| FLUX 3 Video generation | Generally available |
| Native video audio | Generally available |
| Text-to-video | Generally available |
| Image-to-video / keyframes | Generally available |
| Video continuation | Generally available |
| Richer image/video/audio reference combinations | Planned expansion |
| FLUX 3 Image generation and editing | Upcoming |
| FLUX 3 Dev open weights | Planned |
| Action-prediction deployment | Research / commercial partner track |
이 구분은 FLUX.2 Max에 익숙한 사용자라면 특히 중요합니다. FLUX.2는 여전히 정지 이미지 생성에 특화된 현재 옵션이며, 공개 FLUX 3 제품은 비디오와 오디오에 초점을 맞춥니다.
FLUX 3 벤치마크 성능
이제 FLUX 3 벤치마크는 두 가지 유의미한 근거가 있습니다. BFL의 출시 후 내부 평가와 독립 제3자 평가입니다. 전자는 BFL 프로토콜 하의 상대적 인간 선호를 보여주며, 후자는 별도로 설계된 벤치마크에서도 그 강점이 유지되는지 확인합니다.
BFL 출시 후 ELO 평가
7월 초기 발표에는 예비 승률이 포함되어 있었습니다. 현재 사용자에게 더 관련 있는 것은 8월 4일 출시 모델 평가입니다. Black Forest Labs는 내부 전대전 평가에서 텍스트-투-비디오 ELO 1135를 보고합니다.
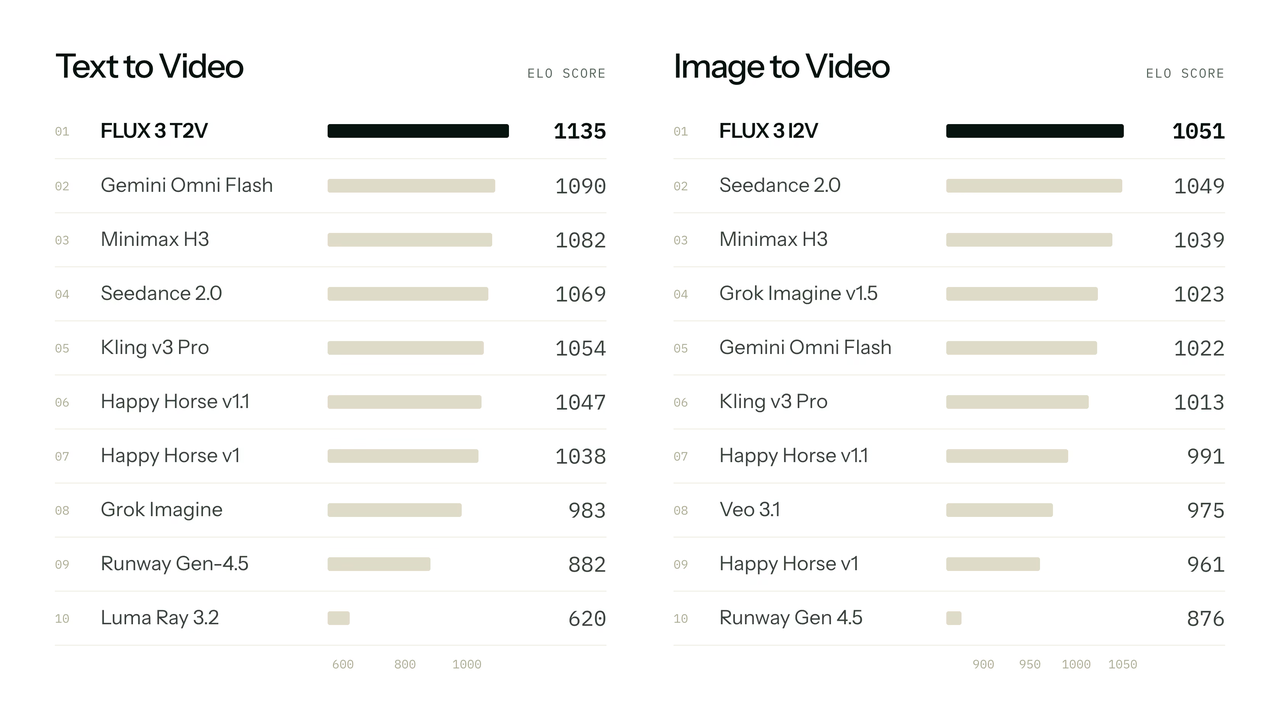
FLUX 3 출시 모델 ELO 평가 - 공식 이미지 출처: Black Forest Labs
| Metric | BFL released-model evaluation |
|---|---|
| Text-to-video ELO | 1135 |
| T2V position | Highest score in BFL’s tested group |
| Image-to-video result | Tied the strongest tested competitor and beat the remaining evaluated models |
| Evaluation type | Internal human-preference evaluation |
| Model stage | Generally available FLUX 3 Video release |
이는 8월 출시 모델을 평가했다는 점에서 초기 런치 벤치마크보다 더 강한 증거입니다. 다만 벤더가 운영한 벤치마크이므로, 모든 프롬프트 범주에서 FLUX 3가 모든 경쟁자를 능가한다는 증거로 해석해선 안 됩니다.
독립 FLUX 3 벤치마크
Megaton의 v-benchmark v2는 독립 검증을 제공합니다. FLUX 3는 2026년 8월 평가를 받았으며, 현재 Megaton Index 76.51/100으로 당시 공개 세트에서 3위를 기록합니다.
| Benchmark dimension | Megaton FLUX 3 evaluation |
|---|---|
| Megaton Index | 76.51 |
| Prompt Adherence | 87.07 |
| Scene Consistency | 94.76 |
| Physics | 70.63 |
| Human Fidelity | 73.70 |
| Object & Product Fidelity | 83.82 |
| Causal & Semantic Coherence | 80.91 |
| Text Fidelity | 82.41 |
| Cinematography | 71.43 |
| Taste & Art Direction | 65.00 |
전체 점수보다 프로파일이 더 유익합니다. 장면 일관성 94.76이 가장 강한 주요 항목이며, 프롬프트 준수, 객체 충실도, 인과 일관성, 텍스트 충실도도 80을 상회합니다. 물리, 인간 충실도, 취향·아트 디렉션은 약하며, 더 강한 시간 표현이 물리적 부자연스러움이나 예술적 품질 변동을 제거하지는 못함을 보여줍니다.
이로 인해 벤치마크 결론이 달라질 수 있음을 설명합니다. BFL의 내부 선호 테스트는 비교 집합에서 FLUX 3를 최상위에 두는 반면, Megaton의 독립 리더보드는 3위로 배치합니다. 프롬프트 분포, 채점 항목, 평가자 구성, 집계 방식의 차이가 서로 다른 순위를 낳을 수 있습니다.
FLUX 3 vs Seedance 2.5 vs MiniMax H3 vs Wan 3.0
AI 비디오 시장은 2026년에 빠르게 움직였습니다. FLUX 3는 장편 생성, 동기화 오디오, 레퍼런스, 편집을 점차 결합하는 멀티모달 시스템과 경쟁합니다.
| Dimension | FLUX 3 | Seedance 2.5 | MiniMax H3 | Wan 3.0 |
|---|---|---|---|---|
| Developer | Black Forest Labs | ByteDance Seed | MiniMax | Alibaba |
| Maximum advertised clip | 20 s | 30 s | 15 s | 30 s |
| Video resolution | HD / FHD / QHD (2K) / UHD (4K) | API tier dependent | Up to 2K | Up to 1080p |
| Native audio | Yes | Yes | Yes, stereo | Yes |
| Text-to-video | Yes | Yes | Yes | Yes |
| Image/reference input | Yes | Yes | Yes | Yes |
| Keyframe/reference control | Strong timed keyframes | Strong multimodal reference control | Multimodal conditioning | Multimodal reference control |
| Video continuation/editing | Continuation available | Editing-oriented workflow | Omni generation focus | Editing and reference workflows |
| Multi-shot generation | Yes | Yes | Yes | Yes |
| Distinctive strength | Reality-model architecture, scene consistency, Self-Flow | Long-form storytelling and reference control | 2K audiovisual generation and omni-modal context | Long clips and lower starting cost |
| CometAPI starting/unit price* | $0.136/s | $0.0824/s listed | $0.064/s | $0.040/s |
* Pricing is a rough comparison only. 비디오 API는 해상도, 길이, 품질 티어, 과금 규칙이 서로 다르므로, 초당 최저가가 동등 품질의 최저 비용을 의미하진 않습니다.
FLUX 3 vs Seedance 2.5
Seedance 2.5는 최대 30초 생성으로 FLUX 3의 20초보다 명백한 길이 이점을 지닙니다. 또한 레퍼런스 기반 생성, 편집, 장편 스토리텔링에 강한 지향을 가집니다. FLUX 3는 공유 세계 모델 아키텍처, 장면 일관성, 네이티브 오디오비주얼 생성, 시간 제어 키프레임, 더 넓은 이미지/액션 로드맵으로 차별화됩니다.
독립 테스트는 이것이 진정한 하이엔드 경쟁임을 강화합니다. Megaton은 현재 전체적으로 Seedance 2.5를 FLUX 3보다 상위에 배치합니다.
FLUX 3 vs MiniMax H3
MiniMax H3는 최대 2K 출력과 네이티브 스테레오 오디오를 제공해 오디오비주얼 콘텐츠에 강한 기술 사양을 갖춥니다. FLUX 3는 최대 생성 윈도우가 더 길어(H3의 15초 대비 20초), Draft Mode로 비용 통제형 반복 워크플로를 제공합니다.
FLUX 3 vs Wan 3.0
Wan 3.0은 폭넓은 멀티모달 입력, 오디오비주얼 생성, 편집, 최대 30초 클립을 강조합니다. CometAPI 시작가도 더 저렴합니다. FLUX 3는 더 비싸지만 현실 모델 지향, 장면 일관성, Self-Flow 연구 기반, Draft Mode, 액션 예측과의 통합으로 차별화합니다.
FLUX 3 가격
Black Forest Labs는 생성된 비디오 길이에 따라 FLUX 3 요금을 부과합니다.
| Mode | Official BFL FLUX 3 pricing |
|---|---|
| T2V / I2V Draft HD | $0.06/s |
| T2V / I2V HD | $0.17/s |
| T2V / I2V FHD | $0.29/s |
| T2V / I2V QHD (2K) | $0.40/s |
| T2V / I2V UHD (4K) | $0.80/s |
| Video continuation Draft | $0.12/s |
| Video continuation HD | $0.41/s |
| Video continuation FHD | $0.53/s |
| Video continuation QHD (2K) | $0.65/s |
| Video continuation UHD (4K) | $0.95/s |
따라서 표준 10초 HD 생성 비용은 BFL 공시 기준 약 $1.70이며, 10초 FHD 생성은 약 $2.90입니다. 비디오 이어 생성은 일반 생성보다 초당 비용이 상당히 높으므로, 클립을 자주 연장하는 애플리케이션은 해당 비용을 별도로 모델링해야 합니다.
CometAPI의 FLUX 3 가격
CometAPI는 현재 FLUX 3 제공을 모델 ID flux-3로 표기합니다.
| Resolution | CometAPI FLUX 3 pricing |
|---|---|
| 720p | $0.136/s |
| 1080p | $0.232/s |
10초 생성 시 720p는 약 $1.36, 1080p는 약 $2.32에 해당합니다. BFL 공시 $0.17/s 및 $0.29/s와 비교하면, 두 티어에서 CometAPI 기본 가격이 약 20% 낮습니다.
가용성 참고: CometAPI의 일부 오래된 설명 카피는 여전히 7월 Early Access 기간을 반영합니다. 현재 라이브 모델 카드, 가격 섹션, API 예시는 flux-3를 Available로 표시하며, CometAPI 출시일은 2026년 8월 13일입니다. 통합 의사결정 시에는 오래된 카피보다 라이브 API와 가격 필드가 더 관련성 높습니다.
왜 FLUX 3가 AI 비디오를 넘어 중요한가
FLUX 3의 가장 특이한 점은 20초 비디오 생성이 아닙니다. 이미 여러 경쟁자가 동등하거나 더 긴 클립을 생성할 수 있습니다. 더 큰 기술적 베팅은 강력한 비디오 표현이 다른 형태의 지능을 위한 기반이 될 수 있다는 점입니다.
비디오 예측에서 액션 예측으로
로봇 제어 신호는 시각 관측에 조건화된 시간적 예측이므로, BFL은 FLUX 3의 비디오 표현을 액션 예측의 기반으로 사용합니다. mimic robotics와의 협업은, 액션 디코더가 완전히 독립된 인지 스택을 학습하는 대신 비디오 모델의 표현을 읽는 FLUX-mimic을 만들어냈습니다.
BFL은 FLUX-mimic 백본이 단일 RTX 5090에서 80 ms 미만으로 동작하고, 완전한 로봇 시스템은 약 101 ms 반응 루프에 도달한다고 보고합니다. Audi와의 산업 평가도 논의되었습니다.
이는 공개 FLUX 3 Video API가 로보틱스 API라는 뜻은 아닙니다. 다만 BFL이 비디오 생성을 고립된 미디어 작업으로 보지 않고, 멀티모달 비디오 표현에 집중 투자한 이유를 보여줍니다.
FLUX 3의 주요 강점은?
- 장면·시간 일관성. Megaton의 장면 일관성 94.76은 모델의 가장 강한 주요 벤치마크 항목입니다.
- 네이티브 오디오비주얼 생성. 대사, 효과, 앰비언스, 비주얼을 별도 모델 조합이 아닌 함께 생성합니다.
- 강한 프롬프트 준수. 독립 프롬프트 준수 87.07은 순수 시각적 완성도 외의 강점을 시사합니다.
- 키프레임 제어. 최대 10장의 이미지를 현재 이미지-투-비디오 워크플로에 활용해 시간적 제어를 제공합니다.
- 드래프트-투-파이널 워크플로. Draft Mode는 프롬프트 반복 중 다수 생성물이 폐기되는 비용 문제를 완화합니다.
- 폭넓은 시각 표현. FLUX 3는 고정 하우스 스타일이 아니라 자연주의, 시네마틱, 향수, 장난스러움, 스타일화, 비정형까지 폭넓은 결과를 목표로 합니다.
- 세계 모델 연구 지향. Self-Flow와 액션 예측은 FLUX 3를 미디어 생성 너머로 관련성 있게 만듭니다.
FLUX 3의 한계는?
- 완전한 멀티모달 로드맵은 아직 출하되지 않음. 공개 FLUX 3 Image 및 FLUX 3 Dev 오픈 웨이트는 패밀리 단위 발표와 혼동하면 안 됩니다.
- 20초는 업계 최고 길이가 아님. 일부 2026년 경쟁자는 30초 생성을 지원합니다.
- 물리는 해결되지 않음. Megaton의 물리 점수 70.63은 장면 일관성 대비 상당히 낮습니다.
- 인간 충실도 개선 여지. 73.70의 독립 점수는 어려운 인체 구조와 사실적 인간 동작 실패 가능성을 시사합니다.
- 비디오 이어 생성은 비쌈. BFL의 이어 생성 단가는 일반 T2V/I2V 대비 초당 상당히 높습니다.
- BFL의 대표 경쟁 벤치마크는 내부 결과. 프로덕션 의사결정에는 애플리케이션 자체 프롬프트, 샷 유형, 언어, 레퍼런스 자산을 사용한 독립 테스트가 포함되어야 합니다.
CometAPI로 FLUX 3를 사용하는 방법
CometAPI의 이전 FLUX 3 커버리지는 7월 Early Access 단계, 예비 벤치마크, 계획된 롤아웃을 설명합니다. 이 섹션은 현재 프로덕션 통합, 가격, 작동 API 흐름에 초점을 맞추며, 과거 워크스루를 반복하지 않습니다. FLUX 3 프로덕션 모델의 모델 ID는 flux-3입니다.
기본 720p 요청은 /v1/videos 엔드포인트를 사용합니다:
Bash
curl --request POST "https://api.cometapi.com/v1/videos" \--header "Authorization: Bearer $COMETAPI_KEY" \ --form-string "model=flux-3" \ --form-string "prompt=잔잔한 연못 위를 종이배가 부드러운 아침빛 속에서 미끄러지듯 나아간다" \ --form-string "seconds=5" \ --form-string "size=1280x720" |
|---|
비디오 워크플로는 비동기식입니다. 초기 요청이 태스크 ID를 반환하면, 애플리케이션은 생성이 완료될 때까지 태스크를 확인하고 결과 비디오를 가져옵니다. 프로덕션 애플리케이션에서는 전체 렌더 시간을 HTTP 요청으로 유지하기보다 백그라운드 잡이나 태스크 큐로 생성을 처리하는 것이 일반적입니다.
누가 FLUX 3를 사용해야 할까?
FLUX 3는 시각적으로 매력적인 5초 클립을 넘어서는 애플리케이션에 특히 적합합니다. 동기화된 시각·오디오가 필요한 광고 시스템, 자동 숏폼 제작, 객체 지속성이 중요한 제품 데모, 다국어 대사 생성, 스토리보드-투-비디오 워크플로, 키프레임 제어 애니메이션, 교육 콘텐츠, 더 긴 멀티모달 파이프라인 실험 등입니다.
반대로 초당 최소 비용만이 요구되거나, 한 번에 20초를 초과해 생성해야 하거나, 정지 이미지 생성이 주된 작업인 경우 매력도가 낮을 수 있습니다. 정지 이미지는 현재 FLUX.2 Max 같은 기존 FLUX 이미지 모델이 더 적합할 수 있습니다.
FLUX 3가 다른 AI 비디오 모델보다 더 좋은가?
모든 사용 사례에 걸친 단일한 답은 없습니다. BFL 내부 평가는 출시된 FLUX 3를 텍스트-투-비디오 비교에서 최상위에 두는 반면, 독립 Megaton 평가는 최신 경쟁자들 뒤를 이어 FLUX 3를 전체 3위로 배치합니다. 두 결과는 서로 다른 프롬프트 분포, 품질 항목, 평가자 구성, 집계 방식 때문에 동시에 타당할 수 있습니다.
FLUX 3는 장면 일관성, 프롬프트 준수, 객체 충실도, 인과 일관성, 텍스트 렌더링, 동기화 사운드, 제어 가능한 키프레임이 중요한 경우 특히 강해 보입니다. 다른 모델은 최대 길이, 해상도, 예술적 선호, 인간 충실도, 편집 워크플로, 비용에서 우세할 수 있습니다. 개발자에게 올바른 비교는 리더보드가 아니라 워크로드별 비교입니다.
자주 묻는 질문
FLUX 3는 지금 사용할 수 있나요?
예. FLUX 3 Video는 2026년 8월 4일 BFL을 통해 일반 제공이 되었습니다. CometAPI 역시 FLUX 3를 Available로 표기하며, 모델 ID는 flux-3입니다. 정지 이미지 FLUX 3 출시와 FLUX 3 Dev 오픈 웨이트는 별도의 로드맵 항목으로 남아 있습니다.
FLUX 3는 오디오를 생성할 수 있나요?
예. FLUX 3 Video는 대사, 앰비언스, 효과음을 포함한 동기화된 네이티브 오디오를 생성합니다. 다국어 대사 및 립싱크도 지원됩니다.
FLUX 3 비디오는 얼마나 길게 만들 수 있나요?
현재 텍스트-투-비디오와 이미지-투-비디오는 5–20초를 지원합니다. 비디오 이어 생성은 5–15초의 신규 생성 콘텐츠를 지원합니다.
FLUX 3는 어떤 해상도를 지원하나요?
BFL은 HD(프레임당 최대 1MP), FHD(최대 2MP), QHD/2K(최대 4MP), UHD/4K(최대 8MP)를 지원합니다. 16:9 FHD 출력은 1920 × 1088입니다. 해상도 밴드는 화면비가 아니라 프레임당 총 픽셀 수를 기준으로 하며, Draft Mode는 HD만 지원합니다.
FLUX 3는 이미지-투-비디오를 지원하나요?
예. 이미지-투-비디오와 키프레임 생성은 일반 제공되는 FLUX 3 Video의 기능 세트 일부입니다.
FLUX 3는 이미지 생성 모델인가요?
아키텍처상 FLUX 3는 이미지, 비디오, 오디오 전반에 걸쳐 학습되며, BFL은 이미지 생성 및 편집 연구를 시연했습니다. 그러나 FLUX 3 Image 제품은 여전히 향후 출시 대상입니다. 패밀리 로드맵을 현재 공개된 FLUX 3 Video API와 혼동하지 마세요.
FLUX 3는 오픈 소스인가요?
현재는 아닙니다. BFL은 오픈 웨이트 멀티모달 변형 FLUX 3 Dev를 발표했지만, 아직 공개 출시일을 제공하지 않았습니다.
FLUX 3의 비용은 얼마인가요?
BFL은 Draft HD $0.06/s, HD $0.17/s, FHD $0.29/s, QHD $0.40/s, UHD $0.80/s(텍스트/이미지-투-비디오)를 공시합니다. 비디오-투-비디오는 Draft HD $0.12/s, HD $0.41/s, FHD $0.53/s, QHD $0.65/s, UHD $0.95/s입니다. CometAPI는 현재 720p $0.136/s, 1080p $0.232/s를 표기합니다.
Self-Flow란 무엇인가요?
Self-Flow는 BFL의 자기지도식 플로 매칭 연구 접근법입니다. 외부 표현 모델에 의존하지 않고, 생성 모델이 유용한 내부 표현을 개발하도록 설계되었습니다. 토큰별 다른 노이즈 레벨 사용은 네트워크가 누락 정보를 추론하고 멀티모달 관측 간의 관계를 학습하도록 장려합니다.
FLUX 3는 세계 모델인가요?
Black Forest Labs는 FLUX 3의 공유 표현이 오디오비주얼 예측에서 물리적 액션 예측으로 확장된다는 점에서 현실 모델 기반이라고 포지셔닝합니다. 이를 완전한 범용 세계 모델이라 부르는 것은 현재 증거보다 강한 표현일 수 있으며, 보다 정확한 설명은 세계 모델링 목적에 명시적으로 설계된 멀티모달 생성 기반 모델입니다.
결론
FLUX 3는 한 FLUX 이미지 모델에서 다른 모델로의 통상적 업그레이드 이상의 변화입니다. 세계에 대한 공유 멀티모달 표현을 학습하고, 그 표현을 비디오, 사운드, 이미지, 궁극적으로 액션에 활용한다는 아이디어가 핵심입니다. Self-Flow가 연구 기반을 제공하며, 출시된 FLUX 3 Video 모델은 이 전략의 첫 프로덕션 증명입니다.
2026년 9월 현재, FLUX 3 Video는 최대 20초, 24 fps, HD~UHD/4K 출력, 동기화 오디오, 다국어 대사, 이미지-투-비디오, 키프레임, 비디오 이어 생성, 멀티 샷 생성, Draft Mode를 지원합니다.
벤치마크 그림도 런치 당시보다 신뢰도가 높아졌습니다. BFL의 현재 출시 모델 평가는 내부 T2V ELO 테스트에서 FLUX 3를 1위에 두고, 독립 Megaton 평가는 전체 3위로 배치하며 장면 일관성의 강점을 강조합니다.
따라서 FLUX 3가 모든 워크로드에서 자동으로 최선의 비디오 모델은 아닙니다. Seedance 2.5, MiniMax H3, Wan 3.0은 더 긴 생성, 더 높은 명목 해상도, 더 낮은 가격, 다른 레퍼런스/편집 기능을 제공할 수 있습니다.
FLUX 3를 특별히 흥미롭게 만드는 것은 비디오 생성기 아래의 방향성입니다. BFL은 설득력 있는 비디오를 예측하는 데 필요한 동일한 표현이 궁극적으로 이미지 생성, 오디오, 물리 추론, 로봇 액션을 지원할 수 있다고 보고 있습니다. 개발자는 CometAPI에서 flux-3 모델 ID로 FLUX 3의 첫 프로덕션 단계를 이미 시험해 볼 수 있습니다.