

TL;DR: Penyedia mana paling murah?
Untuk permintaan GPT-6 Astra interaktif biasa, GPT-6 Astra API dalam CometAPI mempunyai kadar Standard konteks pendek yang diterbitkan paling rendah dalam perbandingan ini pada $8 per juta token input dan $40 per juta token output. OpenAI Standard ialah $10/$50.
Untuk tugasan yang toleran kelewatan, ekonominya berubah: OpenAI menetapkan harga Batch dan Flex pada 50% daripada Standard, iaitu $5/M input dan $25/M output untuk permintaan Astra konteks pendek. OpenRouter juga menyediakan laluan Batch pada $5/$25. Laluan tersebut lebih murah daripada inferens Standard interaktif, namun ia bukan pengganti langsung untuk aplikasi sensitif latensi.
Untuk ujian sebelum membayar, CometAPI menyatakan akaun baharu menerima kredit pendaftaran percuma tanpa memerlukan kad kredit. Azure menawarkan pelanggan baharu yang layak $200 dalam kredit selama 30 hari, manakala AWS menawarkan pelanggan baharu sehingga $200 dalam kredit di bawah program Free Tier. Kelayakan kredit dan akses model hendaklah disahkan dalam akaun sebelum mengandaikan penggunaan Astra dilindungi.
Nota kelayakan: kredit promosi dan akses GPT-6 Astra berbeza mengikut akaun, wilayah, dan program. Sahkan kedua-dua kelayakan kredit dan akses model sebelum menganggar percubaan percuma.
Ringkasan Utama
- Kadar interaktif paling murah yang disahkan di sini: CometAPI Standard pada $8/M input dan $40/M output, 20% di bawah OpenAI Standard.
- Laluan toleran kelewatan paling murah: OpenAI Batch/Flex atau OpenRouter Batch pada $5/M input dan $25/M output.
- OpenAI tiada Free API tier untuk Astra; jadual had kadar rasmi menandakan Free sebagai tidak disokong.
- CometAPI ialah percubaan paling rendah geseran dalam perbandingan ini kerana kredit pendaftaran ditawarkan tanpa kad kredit; jumlah kredit semasa tidak dikodkan secara statik.
- Sempadan input 272K penting: melebihinya, Astra beralih kepada harga konteks panjang untuk keseluruhan permintaan.
- Jangan bandingkan hanya harga token. Caching, alat, percubaan semula, latensi, pertumbuhan konteks, dan kejayaan tugasan yang diterima boleh mendominasi kos keseluruhan.
Apakah GPT-6 Astra, dan Mengapa API-nya Diharga Premium?
GPT-6 Astra ialah model teratas OpenAI untuk kerja hujung-ke-hujung yang sukar dan bukannya sembang kos rendah volum tinggi. OpenAI memposisikannya untuk penaakulan kompleks, kejuruteraan perisian, penyelidikan, penggunaan komputer, aliran kerja profesional, dan ejen jangka panjang.
Spesifikasi model rasmi memberikan Astra tetingkap konteks 1,050,000 token, output maksimum 128,000 token, had pengetahuan April 30, 2026, input teks dan imej, serta output teks. Ia menyokong lima tetapan usaha penaakulan: low, medium, high, xhigh, dan max.
| Spesifikasi GPT-6 Astra | Nilai |
|---|---|
| Pembangun | OpenAI |
| Model ID | gpt-6-astra |
| Tetingkap konteks | 1,050,000 token |
| Output maksimum | 128,000 token |
| Had pengetahuan | April 30, 2026 |
| Input | Teks, imej |
| Output | Teks |
| Usaha penaakulan | Low, Medium, High, XHigh, Max |
| Panggilan fungsi | Disokong |
| Output berstruktur | Disokong |
| Penggunaan komputer | Disokong |
| Carian web / fail | Disokong |
| Penalaan halus | Tidak disokong |
| Harga Standard konteks pendek | $10/M input; $50/M output |
| Input yang di-cache | $1/M |
| Penulisan cache | $12.50/M |
| Ambang konteks panjang | Melebihi 272K token input |
Had konteks juga merupakan sempadan harga. Untuk prompt melebihi 272K token input, OpenAI mengenakan harga input/cache 2× dan harga output 1.5× untuk keseluruhan permintaan. Permintaan yang hanya sedikit melepasi 272K dengan itu boleh melonjak ketara dalam jumlah kos.
Astra juga memperkenalkan kemampuan berorientasikan ejen seperti async tool calling dan mid-turn steering. Itulah sebab perbandingan penyedia yang berguna perlu mempertimbangkan alat, caching, peringkat pemprosesan, dan penyempurnaan tugasan—bukan hanya harga input utama.
Sehebat Manakah GPT-6 Astra? Prestasi Penanda Aras Rasmi
Jadual penanda aras rasmi merekodkan keputusan kukuh merentasi penggunaan komputer, automasi profesional, konteks panjang, sains, pengaturcaraan, dan keselamatan siber. Ia melaporkan 97.6% pada FrontierMath Tier 4 (v2), 99.9% pada ARC-AGI-3, dan 100% pada ExploitBench. Ini ialah hasil penilaian yang diterbitkan vendor dan harus ditafsirkan mengikut metodologi yang dinyatakan.
| Penanda aras | GPT-6 Astra | Perbandingan / makna |
|---|---|---|
| FrontierMath Tier 4 (v2) | 97.6% | Matematik peringkat penyelidikan |
| ARC-AGI-3 | 99.9% | Penaakulan/penyesuaian baharu |
| ExploitBench | 100.0% | Keupayaan eksploit keselamatan siber |
| OSWorld 2.0 | 72.6% | Tugasan penggunaan komputer |
| ScreenSpot-Pro | 92.7% | Pengasasaan UI visual |
| AutomationBench | 41.4% | Automasi aliran kerja profesional |
| BenchCAD | 95.9% | Tugasan CAD / reka bentuk profesional |
| BrowseComp | 91.5% | Pengambilan maklumat berasaskan pelayar |
| MRCR v2, 512K–1M | 96.3% | Pengambilan konteks sangat panjang |
| Terminal-Bench Science 0.1 | 64.6% | Aliran kerja ejen sains |
Untuk penilaian kos, keputusan OSWorld 2.0 OpenAI merekodkan 72.6% pada kira-kira 40 minit per tugasan untuk Astra, berbanding 65.7% pada kira-kira 75 minit untuk GPT-5.6 Sol. Ini menyokong penilaian kos per tugasan yang disiapkan dan bukan menganggap harga per token sebagai keseluruhan model kos.
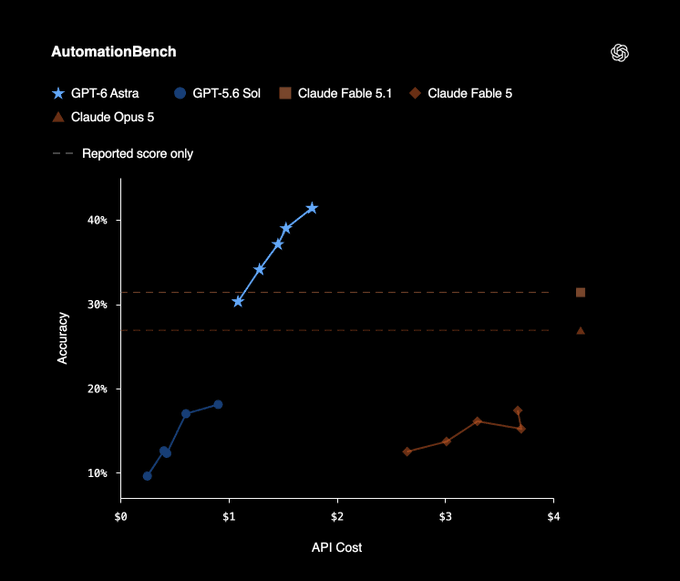
Grafik penanda aras OpenAI AutomationBench rasmi.
Penyedia API GPT-6 Astra Mana Paling Murah pada 2026?
Jadual di bawah membandingkan harga token yang boleh disahkan secara awam untuk model GPT-6 Astra yang sama. Ia mengecualikan sebut harga relay yang luar biasa murah apabila asal model, had konteks, privasi, atau tingkah laku perkhidmatan tidak dapat disahkan secara bebas. Harga model langsung CometAPI menunjukkan $8/M input dan $40/M output untuk akses Standard konteks pendek.
| Penyedia / laluan | Input / 1M | Output / 1M | Percubaan / kredit | Kesesuaian terbaik |
|---|---|---|---|---|
| CometAPI Standard | $8 | $40 | Kredit pendaftaran | Kadar interaktif paling rendah di sini |
| OpenAI Standard | $10 | $50 | Tiada Free API tier untuk Astra | Akses pihak pertama terus |
| OpenAI Batch / Flex | $5 | $25 | Akaun API yang sama | Kadar toleran kelewatan pihak pertama terendah |
| OpenRouter Standard | $10 | $50 | Tiada percubaan khusus Astra disahkan | Perutean berbilang penyedia |
| OpenRouter Batch | $5 | $25 | Tiada percubaan khusus Astra disahkan | Perutean async kos rendah |
| Azure Global | $10 | $50 | $200 / 30 hari untuk pengguna baharu layak | Beban kerja awan Microsoft |
| Azure US Data Zone | $11 | $55 | Kredit Azure tertakluk kelayakan | Keperluan zon data |
| AWS Global CRIS | $10 | $50 | Sehingga $200 kredit AWS umum | Beban kerja asli AWS |
| AWS In-Region | $11 | $55 | Kredit AWS tertakluk kelayakan | Penyebaran serantau |
Jadual Astra yang diterbitkan Azure mengesahkan $10/$50 untuk Standard Global dan $11/$55 untuk US Data Zone. Butiran harga Microsoft Foundry juga menunjukkan jalur konteks panjang yang sepadan. AWS menerbitkan $10/$50 untuk Global CRIS dan $11/$55 untuk In-Region/Geo CRIS. Harga Amazon Bedrock menyatakan bahawa ini ialah kadar peringkat Standard.
Oleh itu terdapat dua jawapan “paling murah” yang berbeza. Untuk inferens Standard interaktif, CometAPI ialah peneraju harga dalam set yang disahkan ini. Untuk beban kerja asinkron atau fleksibel, Batch/Flex pada $5/$25 mempunyai kadar token mentah yang lebih rendah.
Nota harga: kadar penyedia dan kredit promosi boleh berubah. Semak semula dokumentasi penyedia yang dipautkan sejurus sebelum penerbitan atau perancangan bajet produksi.
Sejauh Mana Lebih Murah API GPT-6 Astra dalam CometAPI?
| Kategori token | OpenAI Standard | CometAPI | Perbezaan |
|---|---|---|---|
| Input | $10.00/M | $8.00/M | 20% lebih rendah |
| Input yang di-cache | $1.00/M | $0.80/M | 20% lebih rendah |
| Penulisan cache | $12.50/M | $10.00/M | 20% lebih rendah |
| Output | $50.00/M | $40.00/M | 20% lebih rendah |
| Input konteks panjang | $20.00/M | $16.00/M | 20% lebih rendah |
| Output konteks panjang | $75.00/M | $60.00/M | 20% lebih rendah |
Implikasi praktikalnya mudah: jika aplikasi anda memerlukan inferens interaktif gaya Standard dan bukannya Batch/Flex, kadar Astra yang diterbitkan CometAPI mengurangkan komponen token sebanyak 20% merentasi kategori yang sepadan.
Penyedia API GPT-6 Astra Mana Mempunyai Percubaan Percuma Terbaik?
“API GPT-6 Astra percuma” boleh bermaksud sama ada lapisan model percuma kekal atau kredit promosi sementara. Itu bukan perkara yang sama. Jadual had kadar rasmi OpenAI menandakan lapisan API Percuma sebagai tidak disokong.
CometAPI: laluan percubaan tanpa kad paling mudah
Panduan cepat CometAPI menyatakan akaun baharu menerima kredit pendaftaran percuma dan tiada kad kredit diperlukan untuk bermula. Oleh kerana jumlah promosi boleh berubah, skrin pendaftaran atau harga langsung harus dianggap sebagai sumber kebenaran dan bukannya mengkodkan angka dolar secara statik.
Azure: percubaan awan nilai tetap paling jelas
Pelanggan Azure baharu yang layak boleh menerima $200 dalam kredit Azure selama 30 hari. Jika GPT-6 Astra didayakan untuk akaun dan wilayah, kredit tersebut boleh menjadikan Azure berguna untuk ujian bukti konsep sebelum pengebilan biasa.
AWS: tetingkap kredit umum yang lebih panjang
AWS menawarkan pelanggan baharu $100 dalam kredit semasa pendaftaran dan peluang untuk memperoleh lagi $100—sehingga $200 sepanjang enam bulan. Oleh kerana pelan Percuma AWS tidak menyediakan setiap perkhidmatan dan ciri AWS, sahkan kelayakan pelan akaun dan akses model Bedrock sebelum menganggap kredit sebagai percubaan Astra yang dijamin.
Bilakah OpenAI Batch Lebih Murah untuk GPT-6 Astra?
Kesilapan kos terbesar ialah membandingkan hanya penyedia sambil mengabaikan peringkat pemprosesan. OpenAI menyatakan bahawa Batch dan Flex berharga 50% daripada Standard, manakala Fast mode berharga 2× kadar yang berkenaan. Untuk permintaan Astra konteks pendek, julatnya ialah $5/$25 pada Batch/Flex, $10/$50 pada Standard, dan $20/$100 pada Fast.
| Pilihan pemprosesan | Input / 1M | Output / 1M | Relatif kepada OpenAI Standard |
|---|---|---|---|
| Batch | $5 | $25 | 50% |
| Flex | $5 | $25 | 50% |
| CometAPI Standard | $8 | $40 | 80% daripada OpenAI Standard |
| OpenAI Standard | $10 | $50 | 100% |
| OpenAI Fast | $20 | $100 | 200% |
Batch/Flex harus dinilai terlebih dahulu untuk analisis malam, semakan kod luar talian, pengayaan set data, larian penilaian, dan penyelidikan yang tidak mendesak. Untuk aplikasi di mana pengguna sedang menunggu, perbandingan Standard kekal lebih relevan.
Berapakah Kos Sebenar GPT-6 Astra untuk Anda?
Pertimbangkan permintaan ejen konteks pendek menggunakan 100,000 token input dan 10,000 token output. Mengabaikan caj cache dan alat, kos dipermudah ialah token input × kadar input + token output × kadar output.
| Penyedia / laluan | Kos per permintaan | Kos untuk 1,000 permintaan setara |
|---|---|---|
| OpenAI Batch/Flex | $0.75 | $750 |
| CometAPI Standard | $1.20 | $1,200 |
| OpenAI Standard | $1.50 | $1,500 |
| OpenRouter Standard | $1.50 | $1,500 |
| Azure Global | $1.50 | $1,500 |
| AWS Global CRIS | $1.50 | $1,500 |
| AWS In-Region | $1.65 | $1,650 |
Perbezaan $0.30 antara CometAPI Standard dan OpenAI Standard kelihatan kecil pada satu permintaan. Pada 10,000 permintaan setara, ia menjadi kira-kira $3,000 sebelum kos alat atau percubaan semula.
Konteks panjang mengubah kiraan sekali lagi. Pada 300K input dan 20K output, OpenAI Standard kira-kira $7.50 pada kadar konteks panjang yang diterbitkan, manakala kadar CometAPI yang sepadan menghasilkan kira-kira $6.00. Inilah sebab ambang 272K harus dipantau dengan jelas dalam telemetri produksi.
Bagaimana Anda Boleh Mengurangkan Kos API GPT-6 Astra Tanpa Menukar Penyedia?
Cache prompt ialah tuil utama kerana kadar input di-cache Standard Astra adalah satu per sepuluh daripada input baharu. Arahan sistem yang stabil, definisi alat, bahan rujukan boleh guna semula, dan prefiks prompt biasa merupakan calon kukuh untuk reka bentuk yang sedar cache.
Kawalan konteks ialah tuil kedua. Tetingkap 1.05M token ialah siling kapasiti, bukan sasaran. Kekal di bawah sempadan harga 272K apabila sejarah tambahan tidak diperlukan boleh memberi kesan lebih besar daripada pemampatan prompt kecil.
Peringkat pemprosesan ialah tuil ketiga: Batch/Flex untuk kerja toleran kelewatan, Standard untuk produksi interaktif biasa, dan Fast hanya apabila latensi lebih rendah mempunyai nilai perniagaan yang boleh diukur. Akhir sekali, ukur kos per tugasan diterima—bukan hanya kos per token—kerana percubaan semula, panggilan alat, dan pembetulan manusia boleh membalikkan perbandingan kad kadar yang mudah.
Penyedia API GPT-6 Astra Mana Patut Anda Pilih?
| Keutamaan anda | Pilihan permulaan terbaik | Sebab |
|---|---|---|
| Kadar token interaktif paling rendah | CometAPI | Kadar Standard konteks pendek $8/$40 |
| Kadar token toleran kelewatan paling rendah | OpenAI Batch/Flex atau OpenRouter Batch | $5/$25 |
| Percubaan tanpa kad | CometAPI | Kredit pendaftaran; tiada kad diperlukan |
| Percubaan awan jangka pendek nilai tetap terbesar | Azure | $200 untuk 30 hari bagi pengguna baharu layak |
| Tetingkap kredit awan umum lebih panjang | AWS | Sehingga $200; sahkan kelayakan Astra/Bedrock |
| Akses asli pihak pertama OpenAI | OpenAI | API terus dan keupayaan asli terbaharu |
| Seni bina awan Microsoft sedia ada | Azure Foundry | Tadbir urus dan perolehan Microsoft |
| Seni bina AWS sedia ada | Amazon Bedrock | Keselamatan, pengebilan, dan kawalan serantau AWS |
| Perutean berbilang penyedia | OpenRouter | Satu lapisan perutean merentas penyedia |
Bagi pembangun bebas atau pasukan sensitif kos yang memerlukan inferens Astra interaktif, CometAPI ialah titik permulaan berorientasikan harga yang paling kukuh dalam perbandingan ini. Untuk kerja luar talian berskala besar, Batch/Flex harus dinilai sebelum menukar penyedia kerana diskaun peringkat pemprosesannya 50% lebih besar daripada perbezaan kadar Standard 20%.
Bagi pasukan perusahaan, kadar token terendah mungkin tidak menghasilkan kos keseluruhan terendah. Azure atau AWS masih boleh menjadi pilihan ekonomi yang lebih baik apabila pasukan sudah bergantung pada perbelanjaan awan komited, rangkaian peribadi, perolehan berpusat, atau kawalan keselamatan dan pematuhan terbina dalam. Nilai simpanan operasi tersebut secara berasingan daripada harga per token model.
Bagaimana Anda Memanggil API GPT-6 Astra melalui CometAPI?
CometAPI menggunakan pola integrasi serasi OpenAI. Cipta kunci API CometAPI, arahkan SDK OpenAI kepada URL asas CometAPI, dan panggil model gpt-6-astra. Dokumentasi model Astra CometAPI menerbitkan kedua-dua titik akhir Chat Completions dan Responses.
from openai import OpenAI
import os

client = OpenAI(
    api_key=os.environ["COMETAPI_KEY"],
    base_url="https://api.cometapi.com/v1",
)

response = client.responses.create(
    model="gpt-6-astra",
    reasoning={"effort": "medium"},
    input="Analyze this software architecture and identify the three highest-risk bottlenecks.",
)

print(response.output_text)
Untuk ejen baharu yang banyak menggunakan alat, Responses API ialah antara muka yang lebih penting kerana keupayaan berorientasikan ejen Astra direka di sekeliling aliran kerja tersebut.
Adakah Relay GPT-6 Astra Ultramurah Benar-Benar Lebih Murah?
Pengagregator harga kadangkala memaparkan relay yang menyebut harga Astra jauh di bawah kadar arus perdana. Tawaran tersebut tidak seharusnya secara automatik dianggap setara. Sahkan asal-usul model, sokongan konteks penuh, tingkah laku alat, terma privasi, dasar pembalakan, masa hidup (uptime), had kadar, dan bagaimana penyedia mengekalkan harga di bawah ekonomi huluan biasa.
Nota risiko relay: untuk ejen produksi, kod sumber, dokumen perusahaan, data pelanggan, atau beban kerja sensitif keselamatan, asal model dan pengendalian data adalah sebahagian daripada harga efektif. Sahkan sokongan konteks, tingkah laku alat, terma privasi, pembalakan, masa hidup, dan had kadar sebelum menggunakan relay kos rendah.
Soalan Lazim API GPT-6 Astra: Harga, Percubaan Percuma, dan Penyedia
Apakah penyedia API GPT-6 Astra paling murah?
Untuk inferens interaktif Standard dalam kalangan penyedia yang disahkan di sini, CometAPI paling murah pada $8/M input dan $40/M output. Untuk beban kerja toleran kelewatan, OpenAI Batch/Flex dan OpenRouter Batch lebih murah pada $5/$25.
Adakah terdapat API GPT-6 Astra percuma?
Tiada lapisan API Percuma kekal untuk Astra oleh OpenAI. Kredit promosi daripada CometAPI, Azure, atau AWS boleh mengurangkan atau sementara menampung kos ujian, tertakluk kepada peraturan kelayakan dan akses model setiap program.
Adakah CometAPI menawarkan percubaan percuma GPT-6 Astra?
CometAPI menyatakan akaun baharu menerima kredit pendaftaran percuma dan tiada kad kredit diperlukan untuk bermula. Oleh kerana promosi berubah, sahkan jumlah kredit semasa semasa pendaftaran.
Berapakah kos GPT-6 Astra melalui OpenAI?
Harga Standard konteks pendek OpenAI ialah $10/M input, $1/M input yang di-cache, $12.50/M penulisan cache, dan $50/M output. Di atas 272K token input, kadar Standard menjadi $20/M input, $2/M input yang di-cache, $25/M penulisan cache, dan $75/M output untuk keseluruhan permintaan.
Mengapa GPT-6 Astra Batch boleh lebih murah daripada CometAPI?
Batch/Flex ialah peringkat pemprosesan berbeza, bukan sekadar penyedia berbeza. OpenAI menetapkannya pada separuh daripada Standard, iaitu $5/M input dan $25/M output untuk permintaan Astra konteks pendek. Kadar $8/$40 CometAPI ialah kadar gaya Standard interaktif.
Adakah Azure lebih murah daripada OpenAI untuk GPT-6 Astra?
Azure Standard Global sejajar dengan OpenAI Standard pada $10/M input dan $50/M output. Azure mungkin masih menarik secara ekonomi kerana kredit akaun baharu, perjanjian perusahaan, tadbir urus Microsoft, dan perbelanjaan komited sedia ada.
Adakah AWS Bedrock lebih murah daripada OpenAI untuk GPT-6 Astra?
AWS Global CRIS ialah $10/$50, manakala In-Region dan Geo CRIS ialah $11/$55 untuk konteks pendek. AWS mungkin tetap lebih disukai bagi pasukan yang menilai pengebilan awan sedia ada, kawalan serantau, dan integrasi infrastruktur.
Adakah OpenRouter lebih murah untuk GPT-6 Astra?
OpenRouter Standard ialah $10/$50, jadi ia tidak mengatasi OpenAI pada kadar token Standard. Laluan Batchnya ialah $5/$25; kelebihan lebih luasnya ialah perutean berbilang penyedia.
Apakah kos tersembunyi terbesar API GPT-6 Astra?
Ambang input 272K ialah salah satu sempadan kos tersembunyi paling penting. Panggilan alat, carian web/fail, percubaan semula, kegagalan cache, dan trajektori ejen yang terlalu panjang juga boleh menaikkan kos tugasan keseluruhan dengan ketara.
Patutkah saya memilih penyedia hanya berdasarkan harga token?
Tidak. Bandingkan kos tugasan berjaya, latensi, masa hidup, sokongan konteks, keserasian alat, tingkah laku cache, dasar data, had akaun, dan had kadar. Token termurah hanya berguna jika laluan tersebut boleh dipercayai menyampaikan beban kerja yang anda perlukan.