
Ringkasan
Claude Haiku 5.5 dan GPT-6 Luna ialah model penaakulan kos rendah untuk beban kerja API volum tinggi. Kedua-duanya bermula pada $0.10 per satu juta token input dan $0.50 per satu juta token output. Haiku mencatat skor lebih tinggi dalam enam perbandingan yang diterbitkan dalam bahan pelancaran Anthropic. Luna mengekalkan kadar token asasnya untuk prompt sehingga 272K token input, berbanding ambang 100K bagi Haiku. Bagi pembangun, ukuran utama ialah kadar penerimaan, latensi hujung ke hujung, keserasian API, dan kos per hasil diterima—jumlah kos semua percubaan dibahagi dengan bilangan output yang melepasi semakan pratakrif.
Perkara Utama
- Haiku 5.5 mendahului perbandingan penggunaan komputer OSWorld 2.1 yang dipetik, 72.4% berbanding 48.9% untuk Luna.
- Pada Terminal-Bench 4.0, keputusan yang dipetik ialah 39.2% untuk Haiku dan 16.4% untuk Luna.
- Kedua-duanya bermula pada harga konteks pendek yang sama, tetapi peringkat harga lebih tinggi Haiku bermula melepasi 100K token prompt, berbanding ambang 272K bagi Luna.
- Halaman model usaha maksimum Artificial Analysis, disemak pada 9 Oktober 2026, menunjukkan kelajuan output 240.6 token/s untuk Haiku dan 123.0 token/s untuk Luna; kadar aliran tidak termasuk masa menunggu token pertama.
- Mulakan dengan Haiku untuk tugas penggunaan komputer dan terminal seperti dalam penanda aras yang dikongsi; pertimbangkan Luna untuk prompt besar. Kekalkan model semasa anda sehingga percubaan rintis yang mewakili menunjukkan penambahbaikan yang berguna.
Apakah Claude Haiku 5.5 dan GPT-6 Luna?
Claude Haiku 5.5: Gambaran keseluruhan
Claude Haiku 5.5 dilancarkan pada 7 Oktober 2026. Ia menggabungkan inferens berharga rendah dengan penaakulan boleh laras, penggunaan alat, konteks panjang, dan input teks serta imej. Aplikasi tipikal termasuk pengekstrakan dokumen, pertanyaan pangkalan data, sokongan pelanggan, dan subagen ringan.
GPT-6 Luna: Gambaran keseluruhan
GPT-6 Luna dilancarkan pada 22 September 2026. Ia diposisikan untuk tugas berfokus pada skala, termasuk klasifikasi, pengekstrakan maklumat, output berstruktur, bantuan pengaturcaraan, dan pemprosesan dokumen panjang. Tetapan penaakulan yang fleksibel termasuk konfigurasi tanpa penaakulan untuk kerja yang lebih mudah.
Spesifikasi
| Spesifikasi | Claude Haiku 5.5 | GPT-6 Luna |
|---|---|---|
| Pembangun | Anthropic | OpenAI |
| Tarikh pelancaran | 7 Oktober 2026 | 22 September 2026 |
| Model ID | claude-haiku-5-5 | gpt-6-luna |
| Tetingkap konteks | 1,000,000 token | 1,050,000 token |
| Output maksimum (API standard) | 128,000 token | 128,000 token |
| Input | Teks dan imej | Teks dan imej |
| Output | Teks | Teks |
| Penaakulan | Boleh laras, Rendah hingga Maks | Tiada hingga Maks |
| Usaha lalai | Sederhana | Sederhana |
| Had pengetahuan | Jun 2026 | 18 Mei 2026 |
| Penggunaan alat | Ya | Ya |
| Output berstruktur | Ya | Ya |
| Berat terbuka | Tidak | Tidak |
| Seni bina dan bilangan parameter | Tidak dinyatakan dalam bahan rasmi yang dipetik | Tidak dinyatakan dalam bahan rasmi yang dipetik |
Spesifikasi menggunakan dokumentasi model API standard vendor, disemak pada 9 Oktober 2026: Spesifikasi API standard Haiku dan Spesifikasi API standard Luna. Seni bina dan bilangan parameter tidak dinyatakan kerana sumber ini tidak menetapkannya.
Claude Haiku 5.5 lwn GPT-6 Luna: Keputusan Penanda Aras
| Penanda aras | Haiku 5.5 | GPT-6 Luna | Peneraju |
|---|---|---|---|
| GDPval-AA v2.1 (Elo) | 1,620 | 1,437 | Haiku +183 |
| AA-Briefcase v1.1 (Elo) | 1,578 | 1,336 | Haiku +242 |
| OSWorld 2.1, skor separa luar talian | 72.4% | 48.9% | Haiku +23.5 mata peratusan |
| Terminal-Bench 4.0 | 39.2% | 16.4% | Haiku +22.8 mata peratusan |
| FrontierCode 1.1 Main | 46.4% | 42.4% | Haiku +4.0 mata peratusan |
| Chartography, tanpa alat | 46.4% | 29.1% | Haiku +17.3 mata peratusan |
Enam baris di atas mengulang hasil perbandingan pelancaran yang diterbitkan oleh Anthropic, disemak pada 9 Oktober 2026. Ia merupakan perbandingan yang diterbitkan oleh Anthropic, termasuk keputusan bebas yang diulang di sana, dan bukannya ujian baharu yang dijalankan untuk artikel ini. GDPval-AA dan AA-Briefcase ialah skor Elo; jurang peratusan ialah mata peratusan. Keluarga penanda aras ini mengukur tugas berbeza dan tidak harus dipuratakan menjadi pemenang sejagat.
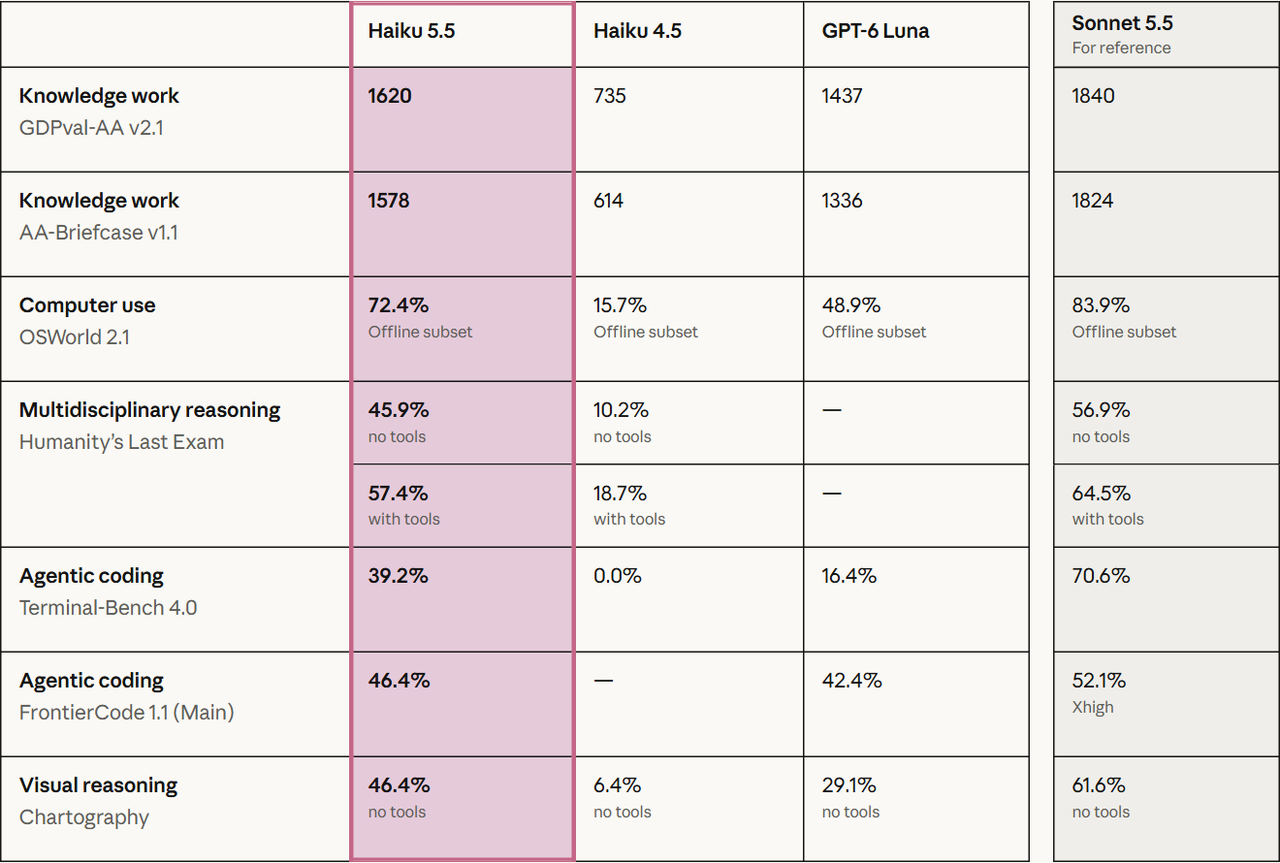
Kekuatan relatif Haiku yang paling ketara dalam jadual pelancaran ini muncul dalam interaksi komputer visual dan tugas berasaskan terminal. Kelebihan yang lebih kecil dalam FrontierCode memberi amaran agar tidak mengekstrapolasi jurang 20 mata kepada setiap situasi pengaturcaraan. Gunakan keputusan ini untuk memilih calon rintis, kemudian sahkan prompt dan susunan alat anda.
Usaha Penaakulan dan Had Penilaian
Tahap usaha penaakulan mengubah pertukaran ketepatan–kos. Bandingkan tetapan yang tersedia menggunakan beban kerja dan rangka uji yang sama; nama tetapan yang sama merentas vendor tidak menjamin bajet token penaakulan yang sama. Jadual pelancaran melaporkan subset luar talian OSWorld dan Chartography tanpa alat. Rangka uji, pemilihan tugas, percubaan semula, dan akses alat boleh mengubah hasil. Kad sistem Anthropic mendokumenkan keadaan khusus penanda aras. Baca kaedah penanda aras dalam kad sistem Anthropic.
- OSWorld menggunakan subset luar talian 82 tugas, mesin maya Ubuntu, tangkapan skrin 1080p, had 500 tindakan, usaha maksimum, dan lima percubaan per tugas. Perbandingan 72.4%/48.9% ialah pemarkahan kredit separa, bukan peratusan tugas yang diselesaikan dengan sempurna; kadar lulus ketat Haiku ialah 37.1%. Anthropic menjalankan Luna pada subset tugas yang sama melalui API OpenAI.
- Terminal-Bench menggunakan 66 tugas berbekas; Haiku dijalankan pada usaha maksimum dalam Claude Code bare mode, tanpa egress internet atau model sandaran, dengan purata sepuluh cubaan per tugas.
- FrontierCode Main mengandungi 100 tugas dengan lima larian per tugas; model Claude menggunakan Claude Code dan model GPT menggunakan Codex.
- GDPval-AA dan AA-Briefcase dinilai secara bebas oleh Artificial Analysis dan diulang dalam bahan pelancaran. Ini ialah saluran penilaian berasingan, bukan satu rangka produksi bersama.
Claude Haiku 5.5 lwn GPT-6 Luna: Perbandingan Ciri
Penggunaan Komputer dan Pengaturcaraan Beragen
Kelebihan terkuat Haiku ialah dalam tugas pelancaran yang dikongsi yang memerlukan interaksi dengan komputer grafik atau bekerja dalam terminal. Jurang skor separa OSWorld ialah 23.5 mata peratusan, manakala Terminal-Bench berbeza 22.8 mata. Perbezaan 4.0 mata yang lebih kecil dalam FrontierCode menunjukkan mengapa kategori pengaturcaraan yang lebih luas tidak harus dianggap sebagai satu beban kerja.
Untuk automasi pelayar, uji navigasi halaman, pengisian borang, pemulihan daripada kegagalan alat, dan penyempurnaan hujung ke hujung. Untuk pengaturcaraan, uji sama ada tampalan melepasi semakan fungsi repositori anda dan kekal dalam skop. Semakan penerimaan tersebut lebih berguna daripada memilih model berdasarkan jurang tajuk utama yang terbesar.
Konteks Panjang dan Pemprosesan Dokumen
Perbezaan 5% dalam kapasiti konteks nominal kurang signifikan berbanding kebolehpercayaan dan harga pemprosesan prompt besar. Tiada model yang secara inheren lebih unggul dalam mendapatkan semula maklumat hanya kerana tetingkap konteksnya lebih besar.
Perbezaan utama ialah masa kadar lebih tinggi dikenakan: prompt 150K token melintasi ambang Haiku tetapi kekal dalam peringkat asas Luna. Oleh itu, Luna ialah titik permulaan kos lebih rendah untuk beban token tersebut. Sama ada ia penganalisis dokumen yang lebih baik masih bergantung pada ketepatan pengekstrakan, petikan, dan percubaan semula yang diperlukan untuk mendapatkan jawapan yang boleh diterima.
Kawalan Penaakulan
Kedua-dua model mendedahkan usaha penaakulan boleh laras, dengan sederhana sebagai lalai dalam dokumentasi yang dipetik. Luna juga mendedahkan tetapan none. Gunakan kawalan tersebut agar sesuai dengan tugas: pengekstrakan dan penghalaan mungkin memerlukan kurang penaakulan berbanding aliran kerja alat berbilang langkah yang tidak pasti. Label usaha yang sama tidak menyiratkan bajet compute yang sama merentas vendor.
Input Multimodal dan Aliran Kerja Berstruktur
Kedua-duanya menerima teks dan imej dan menghasilkan teks. Ini menjadikannya calon untuk tangkapan skrin, pengekstrakan imej dokumen, dan aliran kerja hiliran berstruktur. Sokongan input mereka sahaja tidak membuktikan ketepatan yang sama pada teks kecil, carta, atau antara muka visual; nilai kes-kes tersebut secara berasingan.
Kelajuan dan Ekonomi Tugas
| Metrik bebas (usaha maksimum) | Haiku 5.5 — Artificial Analysis | GPT-6 Luna — Artificial Analysis |
|---|---|---|
| Intelligence Index v4.3.2 | 43 | 38 |
| Kelajuan output | 240.6 token/s | 123.0 token/s |
| Kos berwajaran per tugas Intelligence Index | $0.21 | $0.07 |
Artificial Analysis ialah penerbit ujian bebas. Jadual ini ialah petikan halaman model usaha maksimum mereka yang disemak pada 9 Oktober 2026, bukannya prestasi rasmi vendor. Kelajuan output mengukur token diterima selepas generasi bermula; ia berasingan daripada masa ke token pertama dan latensi tugas penuh. Kos per tugas ialah metrik Intelligence Index berwajaran, bukan sebut harga untuk tugas produksi anda atau kos per hasil berjaya.
Kadar aliran output petikan Haiku adalah kira-kira 1.96 kali Luna, manakala kos tugas penilaian berwajaran Luna lebih rendah. Ini tidak menetapkan kelebihan 1.96 kali dalam masa penyempurnaan tugas penuh. Ujian produksi harus merekod masa ke token pertama, masa penyempurnaan, panjang output, penggunaan penaakulan, dan masa pelaksanaan alat secara berasingan.
Claude Haiku 5.5 lwn GPT-6 Luna: Harga dan Akses API
Kadar Standard Rasmi
| USD per 1M token | Haiku ≤100K | Haiku >100K | Luna ≤272K | Luna >272K |
|---|---|---|---|---|
| Input | $0.10 | $0.50 | $0.10 | $0.20 |
| Bacaan cache | $0.01 | $0.05 | $0.01 | $0.02 |
| Tulisan cache (Haiku: TTL 5 minit) | $0.125 | $0.625 | $0.125 | $0.25 |
| Output | $0.50 | $2.50 | $0.50 | $0.75 |
USD per satu juta token pada kadar pemprosesan standard, disemak pada 9 Oktober 2026. Jadual menggunakan kadar standard dan tulisan cache 5 minit Haiku dan kadar konteks pendek dan panjang Luna. Yuran alat, cukai, kenaikan serantau, dan pelarasan peringkat pemprosesan pilihan dikecualikan. Di atas ambang input, kadar lebih tinggi yang berkenaan meliputi permintaan tersebut dan bukannya hanya token lebihan.
Perbezaan teras ialah ambang pengebilan. Haiku beralih ke kadar lebih tinggi melepasi 100K token prompt, manakala Luna mengekalkan peringkat rendahnya hingga 272K. Malah melebihi ambang itu, harga input dan output konteks panjang Luna yang dipetik adalah lebih rendah.
Haiku juga menawarkan tulisan cache 1 jam pada $0.20/$1.00 per satu juta token untuk prompt pendek/panjang. Ketekalan cache dan mekanisme harga berbeza antara vendor, jadi bandingkan corak guna semula dan bukannya menganggap kedua-dua baris tulisan cache sebagai produk yang sama. Had output 128K Haiku ialah had API standard; Message Batches API boleh menyokong output 300K dengan pengepala beta.
Kos Ilustrasi pada Bajet Token Tetap
| Beban kerja | Input / Output | Haiku 5.5 | GPT-6 Luna |
|---|---|---|---|
| Pengelasan tiket | 2K / 200 | $0.0003 | $0.0003 |
| Laporan pendek | 40K / 4K | $0.006 | $0.006 |
| Analisis repositori | 150K / 5K | $0.0875 | $0.0175 |
| Semakan dokumen besar | 300K / 10K | $0.175 | $0.0675 |
| Analisis konteks besar-besaran | 800K / 20K | $0.45 | $0.175 |
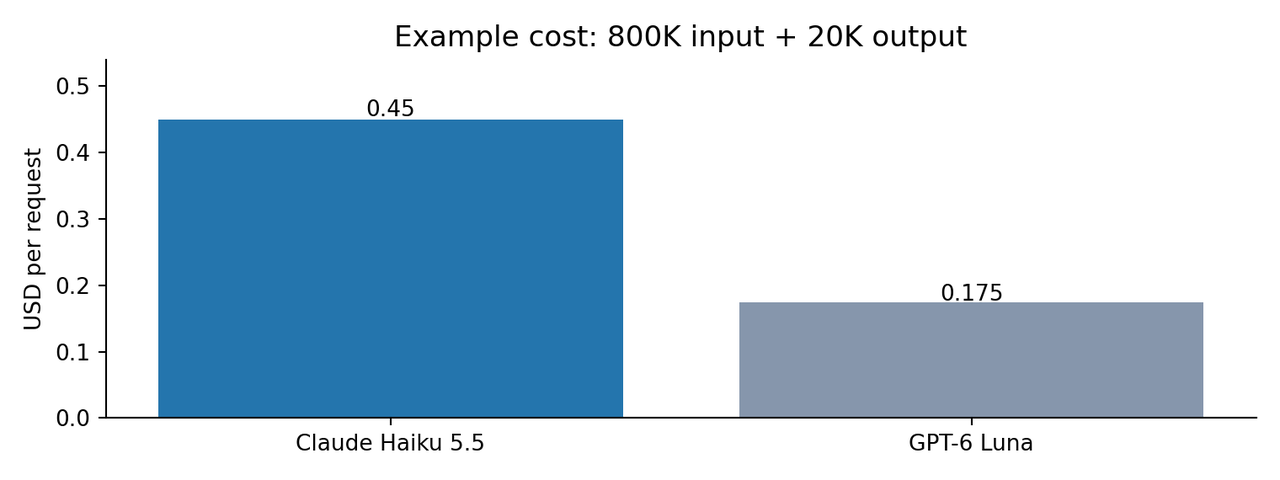
Anggaran kadar standard tanpa cache yang dikira oleh penulis: kos = token input × kadar input / 1,000,000 + token output dibilkan × kadar output / 1,000,000. “Output” bermaksud jumlah output dibilkan untuk anggaran ini, termasuk token penaakulan jika dicaj sebagai output; ia tidak semestinya panjang jawapan yang kelihatan. Jumlah token yang dilaporkan sama digunakan untuk kedua-dua model, walaupun tokenizer boleh berbeza.
Token murah tidak semestinya hasil berjaya yang murah. Pasukan harus mengambil kira percubaan berulang, panggilan alat yang gagal, penggunaan token penaakulan, dan tingkah laku tokenizer yang berbeza.
Akses CometAPI dan Kekangan Integrasi
CometAPI menyediakan pilihan akses untuk kedua-dua model. Sebelum membandingkan atau melancarkannya melalui gerbang, sahkan ID model, titik akhir yang disokong, parameter permintaan, tingkah laku alat, dan peraturan pengebilan bagi setiap laluan. Pautan penyedia ini mendokumenkan pilihan akses; ia tidak menggantikan sumber teknikal atau harga standard vendor.
Untuk integrasi OpenAI terus, Luna menyokong alat terbina dalam melalui Responses API; pemanggilan fungsi Chat Completions memerlukan tetapan penaakulan none. Haiku menggunakan Messages API Anthropic dan adaptive thinking. Gerbang tidak menjadikan skema asas saling boleh ganti: sahkan definisi alat, tingkah laku output berstruktur, acara penstriman, dan perakaunan dengan laluan tepat yang anda ingin gunakan.
Bagaimanakah Pembangun Boleh Membandingkan Claude Haiku 5.5 dan GPT-6 Luna Dengan Prompt yang Sama?
Contoh Pengekstrakan Dokumen Panjang
Perbandingan praktikal boleh menggunakan himpunan kontrak pembekal yang mengandungi tarikh berkuat kuasa, terma pembaharuan, tempoh notis penamatan, dan pengecualian harga. Kekalkan himpunan dokumen, arahan pengekstrakan, medan yang dijangka, dan peraturan pengesahan yang sama. Yang berikut ialah reka bentuk penilaian, bukan keputusan model baharu yang diukur.
Contoh prompt: Ekstrak nama pembekal, tarikh berkuat kuasa, tarikh pembaharuan, tempoh notis penamatan, dan pengecualian harga bagi setiap kontrak. Untuk setiap nilai yang diekstrak, petik tajuk dokumen dan petikan sokongan yang tepat. Pulangkan null apabila medan tiada; jangan membuat inferens tarikh yang hilang. Tanda klausa bercanggah dan kekalkan jawapan akhir dalam 1,000 patah perkataan.
| Semakan | Kriteria penerimaan | Apa yang direkod |
|---|---|---|
| Ketepatan pengekstrakan | Medan diperlukan sepadan dengan kunci jawapan yang diperiksa secara bebas | Nilai betul, salah, dan hilang |
| Pembuktian | Setiap medan bukan null mempunyai petikan sokongan yang sah | Dakwaan tanpa sokongan dan petikan dokumen yang salah |
| Pematuhan arahan | Tiada tarikh direka; medan yang tiada pulangkan null | Kegagalan skema dan pelanggaran kekangan |
| Ekonomi | Kira perbelanjaan per pengekstrakan yang diterima | Input, output, penaakulan, percubaan semula, dan kos sandaran yang dibilkan |
| Latensi | Bandingkan penyempurnaan tugasan penuh di bawah dasar alat yang sama | Masa token pertama dan masa hujung ke hujung |
Jalankan lebih daripada satu himpunan yang mewakili dan ulang kes di mana keputusan berbeza. Mulakan dengan tahap usaha tersedia yang sama, kemudian uji konfigurasi kos lebih rendah untuk setiap model. Laporkan saiz sampel, tetapan, laluan, tarikh, dan bilangan kegagalan sebelum membentangkan pemenang.
Haiku 5.5 atau GPT-6 Luna: Yang mana patut dipilih?
| Dimensi | Titik mula yang lebih disokong | Sempadan keputusan |
|---|---|---|
| Interaksi GUI | Claude Haiku 5.5 | Skor separa OSWorld yang dikongsi memihak kepada Haiku; sahkan penyempurnaan tugasan penuh |
| Pengaturcaraan terminal | Claude Haiku 5.5 | Skor Terminal-Bench yang dikongsi memihak kepada Haiku; sahkan perubahan repositori |
| Prompt pendek dan harga asas | Uji kedua-duanya | Kadar asas sama; bandingkan penggunaan dibilkan dan percubaan semula |
| Prompt melebihi 100K token | GPT-6 Luna pada kadar standard | Luna mengekalkan peringkat asas lebih lama; ketepatan mungkin mengubah jumlah kos |
| Kadar aliran token distrim | Claude Haiku 5.5 dalam petikan bertarikh | Kadar aliran berbeza daripada latensi penyempurnaan penuh |
| Pengekstrakan berulang yang ringkas | Uji Luna dengan penaakulan rendah atau tiada | Pilih berdasarkan output diterima yang sah, bukan harga semata-mata |
Pilih Claude Haiku 5.5 untuk Tugas Interaktif Berkaitan Penanda Aras
Mulakan dengan Haiku apabila aplikasi anda menyerupai tugas komputer grafik, pengaturcaraan terminal, atau kerja profesional yang diterbitkan, dan kadar penyempurnaan lebih tinggi akan mengimbangi perbelanjaan penaakulan atau konteks panjang tambahan. Sahkan kelebihan itu pada susunan alat anda sendiri sebelum menghala trafik produksi.
Pilih GPT-6 Luna untuk Kawalan Kos Prompt Besar
Mulakan dengan Luna apabila prompt kerap melebihi 100K token dan kos token standard memberi kesan material pada bajet anda. Ia juga calon untuk pengekstrakan berulang atau penghalaan yang boleh berjaya dengan penaakulan rendah atau tiada. Kekalkan cadangan bersyarat pada kadar hasil diterima dan penggunaan dibilkan sebenar.
Guna Kedua-duanya Apabila Beban Kerja Mempunyai Keperluan Berbeza
Percubaan rintis boleh menghala pengekstrakan dokumen panjang kepada Luna dan tugas GUI atau terminal kepada Haiku, kemudian mengesahkan setiap pilihan terhadap semakan penerimaan. Picu sandaran apabila output gagal pengesahan skema, tiada bukti diperlukan, atau gagal semakan khusus tugas, dan sertakan kos serta latensi sandaran dalam perbandingan.
Sahkan Sebelum Bertukar
Sertakan model semasa anda sebagai garis dasar. Beralih hanya apabila calon memenuhi sasaran ketepatan pratakrif dan memperbaiki kos per hasil diterima atau latensi hujung ke hujung secukupnya untuk menampung migrasi dan penyelenggaraan. Tangguh pelancaran jika ralat alat kritikal meningkat. Cadangan berubah jika percubaan rintis anda menunjukkan kadar lebih rendah Luna diimbangi oleh percubaan semula, atau skor penanda aras lebih tinggi Haiku tidak memperbaiki kejayaan tugas anda.
- Gunakan sampel beban kerja yang mewakili dan skor keputusan betul, salah, dan tidak lengkap.
- Ukur latensi token pertama, masa tugas hujung ke hujung, dan kebolehpercayaan alat.
- Jejak kiraan token input, cache, output, dan penaakulan secara berasingan.
- Kira kos per hasil berjaya, termasuk percubaan semula dan sandaran.
- Bandingkan usaha sederhana dan tinggi sebelum mendayakan tetapan maksimum sebagai lalai.
Kesimpulan
Claude Haiku 5.5 mempunyai bukti perbandingan pelancaran yang lebih kukuh merentas penanda aras kerja profesional, penggunaan komputer, dan pengaturcaraan beragen yang dibandingkan di sini. Ia juga mempunyai kadar aliran output lebih tinggi dalam petikan bebas. GPT-6 Luna mempunyai kelebihan kadar standard yang jelas untuk prompt melepasi ambang 100K Haiku dan kos tugas penilaian berwajaran lebih rendah. Tiada satu pemerhatian pun secara sendiri menentukan kebolehpercayaan produksi atau kos per hasil berjaya.
Pemenang praktikal ialah model yang menyampaikan hasil yang boleh diterima pada kos operasi terukur terendah. Jalankan kedua-duanya terhadap prompt, alat, dan peraturan percubaan semula anda sendiri dan jangan menganggap satu penanda aras sebagai jawapan.
Soalan Lazim
Mengapa kos tugasan boleh berbeza apabila kedua-dua model mempunyai harga token asas yang sama?
Harga asas yang sama tidak bermakna jumlah bil yang sama. Model boleh menggunakan jumlah token input, output, dan penaakulan yang berbeza, dan mungkin memerlukan bilangan percubaan semula atau panggilan alat yang berbeza untuk menghasilkan hasil yang boleh diterima. Kadar konteks panjang dan penggunaan cache juga mempengaruhi jumlah. Bandingkan jumlah kos semua percubaan dibahagi bilangan hasil diterima, bukannya harga token semata-mata.
Adakah kadar konteks panjang yang lebih tinggi hanya terpakai kepada token melebihi ambang?
Tidak. Di bawah harga standard yang diterangkan dalam artikel ini, melintasi ambang input mengenakan kadar lebih tinggi pada permintaan, bukan hanya token lebihan. Contohnya, permintaan 150K token input melintasi ambang 100K Haiku tetapi kekal dalam peringkat asas 272K Luna. Gunakan kadar input dan output yang berkenaan untuk keseluruhan permintaan apabila menganggarkan kos.
Bolehkah Claude Haiku 5.5 dan GPT-6 Luna berkongsi cache prompt?
Jangan anggap entri cache boleh dipindahkan antara model atau penyedia. Reka strategi guna semula berasingan, kemudian ukur kadar kejayaan dan penggunaan dibilkan pada setiap laluan. Sokongan gerbang, peraturan penyimpanan, dan struktur permintaan boleh menjejaskan sama ada input berulang layak untuk cache; sahkan perkara ini sebelum meramalkan penjimatan.
Apakah yang perlu diliputi oleh ujian migrasi Haiku ke Luna?
Uji input teks dan imej yang mewakili, medan berstruktur yang diperlukan, argumen alat, respons distrim, dan pemulihan ralat. Tetapkan kadar penerimaan sistem semasa anda sebelum migrasi, kemudian bandingkan kedua-dua calon di bawah dasar percubaan semula dan alat yang sama. Harga token yang serupa atau kategori model tidak membuktikan keserasian.
Patutkah skor penanda aras menentukan sandaran Haiku atau Luna?
Gunakan skor untuk memilih calon, kemudian picu sandaran berdasarkan kegagalan yang diperhatikan seperti argumen alat tidak sah, medan diperlukan hilang, atau semakan tugas tidak dipenuhi. Jejak kekerapan sandaran dan jumlah kos dibilkan. Model kedua boleh menambah latensi dan perbelanjaan, jadi sahkan bahawa ia memperbaiki hasil diterima dan bukan sekadar menghasilkan jawapan kedua.
Bolehkah data sensitif dihalakan melalui kedua-dua API?
Semak vendor dan gerbang yang terlibat, tetapan penyimpanan semasa mereka, lokasi pemprosesan, terma kontrak, dan dasar data organisasi anda sebelum menghala input sensitif. Keupayaan model dan jadual harga tidak menetapkan kelayakan laluan untuk data terkawal atau sulit. Gunakan laluan yang diluluskan apabila keperluan tersebut menentukan.