
TL;DR
Google mengumumkan Gemini 4 Argon pada 30 September 2026 sebagai model frontier untuk alur kerja kompleks dan jangka panjang. Keputusan yang diterbitkan menunjukkan pola yang jelas: prestasi kukuh dalam kerja pengetahuan profesional, tugasan berkonteks panjang, dan beberapa penilaian kejuruteraan perisian terpilih, dengan keputusan yang lebih lemah pada sesetengah penanda aras terminal dan penggunaan komputer. Google memperkenalkan model ini melalui pelancaran berfasa. Secara berasingan, CometAPI melaporkan ketersediaan katalog setakat 1 Oktober; kelayakan akaun dan kejayaan permintaan ujian perlu disemak sebelum penerapan. Cerita prestasi yang lebih berguna ialah di mana peningkatannya muncul.
Argon mencatat 68.9% pada Vals Index, 65.4% pada Vals Finance Agent v2, 77.9% pada DeepSWE v1.1, 91.7% pada LVBench, dan 84.2% pada GraphWalks pada konteks 256K–1M. Pada masa yang sama, ia ketinggalan berbanding model frontier bersaing pada FrontierSWE v2, Terminal-Bench 4.0, Terminal-Bench Science, dan OSWorld-2.0.
Keputusan ini menyokong pandangan khusus beban kerja terhadap Argon. Skor terkuatnya berkumpul sekitar kerja pengetahuan profesional, tugasan berkonteks sangat panjang, serta penilaian multimodal dan kejuruteraan perisian terpilih. Model lain kekal mempunyai kelebihan pada beberapa ujian terminal dan penggunaan komputer.
Perkara Utama
- Gemini 4 Argon paling kuat dalam kerja pengetahuan perusahaan, penaakulan konteks panjang, pemahaman multimodal, dan beberapa penilaian pengekodan berjangka panjang.
- Had output maksimum 1 juta token menyediakan lebih banyak ruang untuk trajektori penaakulan panjang; ia tidak menetapkan spesifikasi konteks input awam.
- Argon mendahului beberapa hasil kerja pengetahuan dan konteks panjang yang diterbitkan, tetapi GPT-6 Astra dan Claude Opus 5.5 kekal di hadapan pada pengekodan dan penilaian penggunaan komputer terpilih.
- Skor penanda aras menerangkan konfigurasi model-dan-agen tertentu. Metrik, keadaan input dan tetapan penilaian sama pentingnya dengan peratusan utama.
- Pelancaran Google dan akses CometAPI ialah tuntutan ketersediaan yang berasingan. Sahkan laluan aktif, pengenal pasti model dan kelayakan akaun sebelum memindahkan trafik.
Apakah Gemini 4 Argon?
Gemini 4 Argon ialah model Gemini frontier baharu oleh Google DeepMind, dibina untuk alur kerja sukar yang memerlukan penaakulan melalui banyak langkah dan bukannya menjawab satu prompt pendek.
Penentuan rasmi Google menekankan kejuruteraan perisian dunia nyata, kerja pengetahuan perusahaan seperti undang-undang dan kewangan, keselamatan siber defensif, pemahaman multimodal, dan tugasan agen yang berjalan lama.
Ini ialah perbezaan penting berbanding keluaran Flash terkini. Gemini 3.8 Flash API in CometAPI direka sebagai kuda beban kos rendah untuk alur kerja agen pada skala. Sebaliknya, Argon mewakili hujung frontier dalam tumpukan Google, memprioritikan kedalaman dan pelaksanaan berterusan.
Spesifikasi Model
| Spesifikasi | Gemini 4 Argon |
|---|---|
| Pembangun | Google DeepMind |
| Diumumkan | 30 September 2026 |
| Keluarga model | Gemini 4 |
| Penentuan | Model penaakulan frontier dan jangka panjang |
| Output maksimum | 1,000,000 token |
| Penilaian konteks panjang | Diuji sehingga 256K–1M pada GraphWalks |
| Had konteks input awam | Tidak dinyatakan secara formal dalam jadual spesifikasi API awam standard ketika pelancaran |
| Pemahaman multimodal | Ya; termasuk carta, dokumen dan penilaian video panjang |
| Pengekodan agen | Ya |
| Penggunaan komputer | Dinilai |
| Keselamatan siber | Keupayaan defensif khusus |
| ID model API awam Google | Tidak diumumkan dalam dokumentasi awam awal Google; CometAPI menggunakan gemini-4-argon sebagai pengenal katalog. |
Bajet Output dan Pertukaran
Google mengumumkan had output maksimum 1 juta token untuk Argon, meningkat daripada had 64K yang disebut dalam pengumuman pelancarannya. Ini menyediakan ruang untuk trajektori penaakulan yang lebih panjang. Ia tidak harus ditafsirkan sebagai bajet total terjamin untuk keseluruhan sesi agen berbilang panggilan, atau sebagai bukti bahawa setiap tugasan akan bertambah baik.
Output maksimum bukanlah sama dengan kecerdasan. Memberi model lebih banyak token output tidak secara automatik menjadikannya lebih berkemampuan; ia hanya menghapuskan satu potensi hambatan. Model masih perlu menggunakan bajet itu secara produktif.
Terdapat juga pertukaran kos dan kependaman. Model yang benar-benar menjana ratusan ribu token boleh menjadi mahal dan perlahan walaupun harga per token nominal kelihatan menarik.
Keputusan penanda aras terpilih diambil semula daripada artikel. Bandingkan model dalam setiap baris; metrik dan keadaan penilaian berbeza. Carta ini menggantikan karya seni kecerunan hiasan dan tidak mewakili ujian bebas.
Had output maksimum dan tetingkap konteks input menerangkan kapasiti yang berbeza. Julat penilaian GraphWalks ialah bukti tentang input yang diuji, bukan pengganti untuk spesifikasi API awam.
Bagaimanakah Prestasi Gemini 4 Argon pada Penanda Aras?
Jadual prestasi Google DeepMind merangkumi alur kerja agen, kerja pengetahuan profesional dan tugasan multimodal. Nilai di bawah mengulangi perbandingan yang diterbitkan itu. Ia mengukur prestasi tugas, bukan throughput token atau kependaman respons; “—” bermaksud keputusan tidak dilaporkan dalam perbandingan ini.
| Penanda aras | Gemini 4 Argon | GPT-6 Astra | Claude Fable 5.1 | Claude Opus 5.5 | Syarat penilaian |
|---|---|---|---|---|---|
| Vals Index | 68.9% | 63.1% | 65.8% | 67.0% | Vals AI |
| AutomationBench | 51.3% | 41.4% | 31.4% | 42.5% | Set peribadi; papan pendahulu Zapier |
| Vals Finance Agent v2 | 65.4% | 53.5% | 58.9% | 58.6% | Vals AI |
| Harvey's Legal Agent | 19.6% | 5.4% | 6.7% | 3.8% | Vals AI |
| DeepSWE v1.1 | 77.9% | 74.1% | 67.4% | 74.2% | mini-swe harness; sumber campuran |
| FrontierSWE v2 | 55.0% | 65.5% | 56.3% | 62.3% | Proximal leaderboard |
| Vibe Code Bench | 91.9% | 89.6% | 90.3% | 90.3% | Papan pendahulu Vals AI |
| Terminal-Bench 4.0 | 57.4% | 58.2% | 57.9% | 66.4% | Ujian kendiri / papan pendahulu |
| PostTrainBench | 45.3% | 44.3% | 40.2% | 49.3% | v1.1; OpenCode; 10j; satu H100 |
| Terminal-Bench Science 0.1 | 57.6% | 68.1% | 52.6% | 63.3% | Had masa verifikasi ×6 |
| LABBench 2 | 88.8% | 85.4% | 68.6% | 73.1% | Alat Linux; internet |
| RiemannBench | 76.0% | 72.0% | 65.6% | 69.6% | Papan pendahulu Surge |
| GraphWalks up to 128K | 99.7% | 98.7% | 91.4% | 90.6% | BFS F1; 650 item |
| GraphWalks 256K–1M | 84.2% | 71.8% | 65.0% | 66.8% | BFS F1; 200 item |
| Agent's Last Exam | 39.5% | 34.2% | — | 38.2% | Lulus binari; ALE-Claw; 5j |
| OSWorld-2.0 | 69.2% | 72.6% | — | — | Skor separa luar talian; terbaik 3 larian |
| Chartography | 71.6% | 71.0% | 46.2% | 66.3% | Tiada alat; papan pendahulu Surge |
| LVBench | 91.7% | 87.5% | 79.7% | 83.7% | Tiada alat; pensampelan bingkai khusus model |
| CWE-bench v1 | 68.0% | 68.0% | 58.0% | 67.0% | pass@1; pass@4 memutuskan seri |
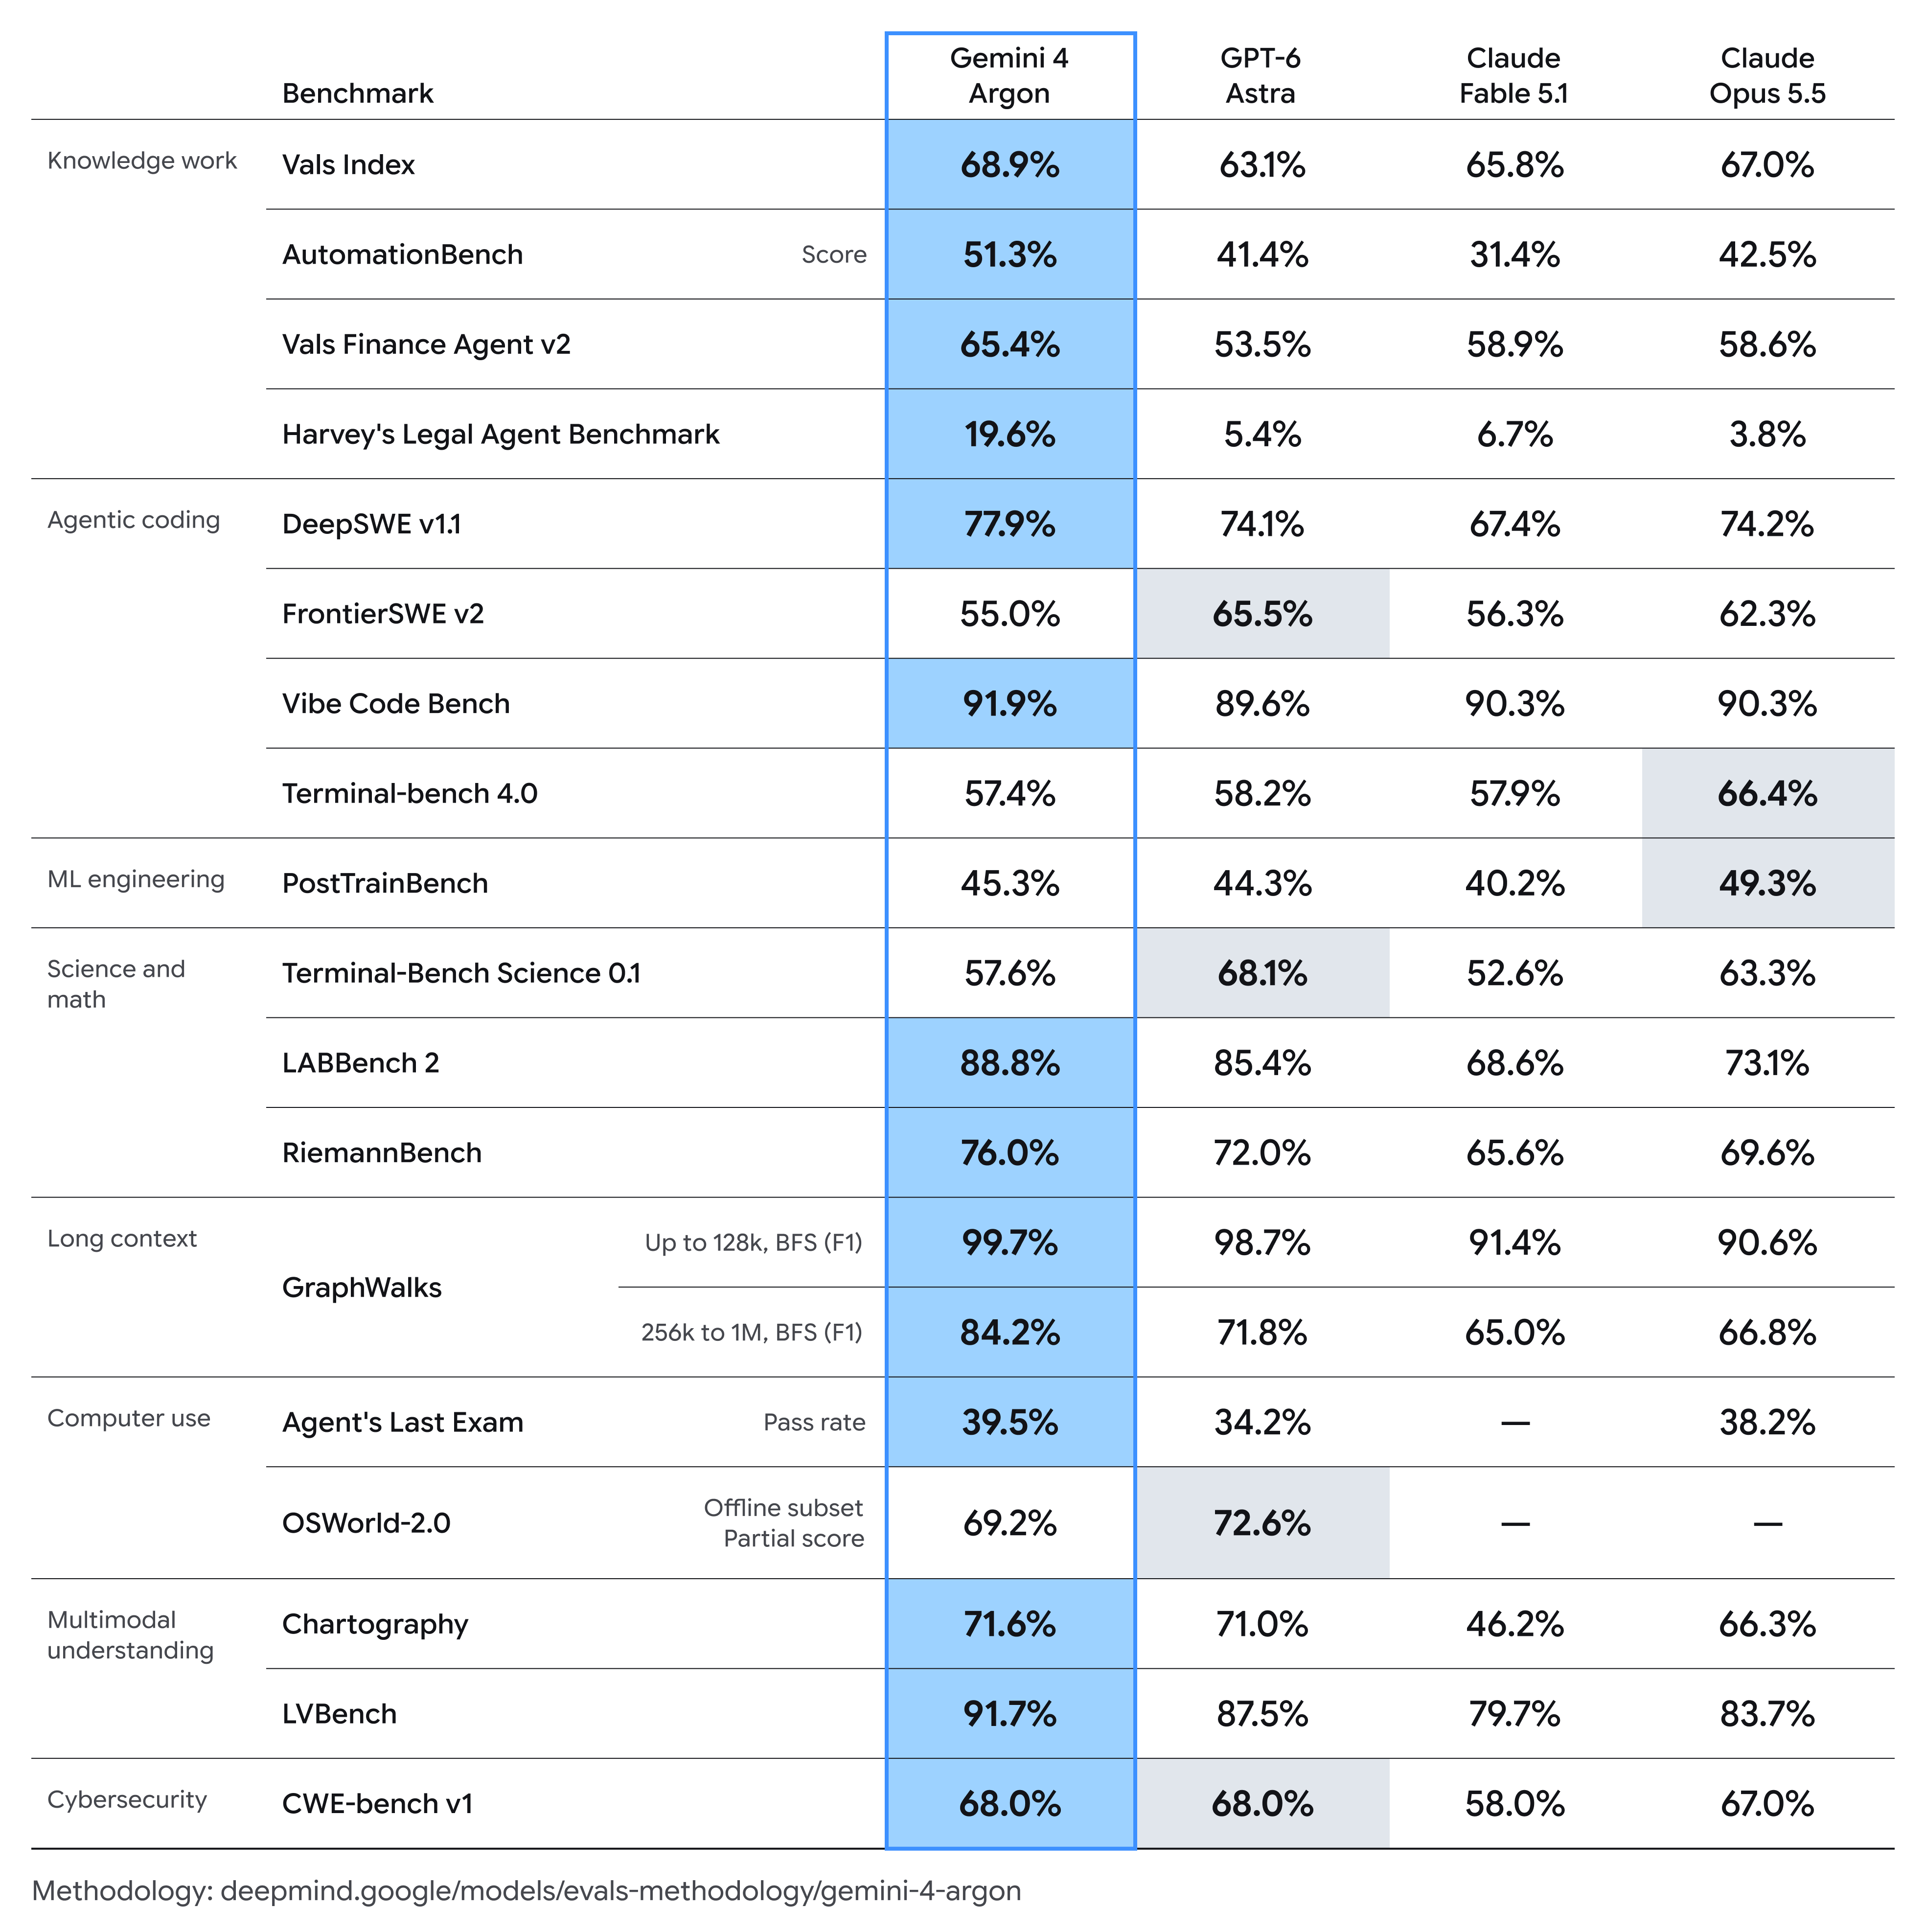
Perbandingan penanda aras rasmi Gemini 4 Argon oleh Google
Kecuali dinyatakan sebaliknya, keputusan Argon menggunakan satu percubaan dan tetapan thinking tertinggi. Keputusan model lain lazimnya datang daripada laporan penyedia, dengan pengecualian khusus penanda aras. LVBench menggunakan 1 FPS untuk Gemini, 800 bingkai untuk GPT-6 Astra, 300 untuk Fable 5.1 dan 600 untuk Opus 5.5. Input ini tidak identik, jadi bandingkan konfigurasi yang dilaporkan dan jangan anggap setiap baris sebagai ulang uji yang terkawal.
Syarat Penilaian dan Had
Jadual ini berguna, tetapi ia tidak harus ditafsirkan sebagai papan pendahulu sejagat bebas.
- Pemilihan penanda aras adalah pilihan Google.
- Tetapan penilaian khusus penanda aras berbeza merentas baris, termasuk rangka kerja agen, bajet masa, alat dan pensampelan input.
- Metodologi rasmi mengenal pasti keputusan pesaing yang dilaporkan penyedia sebagai lalai, dengan pengecualian khusus papan pendahulu dan yang dikira sendiri.
- Tetapan penanda aras tertinggi mungkin tidak mencerminkan konfigurasi inferens produksi lalai.
- Skor penanda aras utama sahaja tidak mendedahkan penggunaan token, panggilan alat, percubaan semula, masa berlalu, atau campur tangan manusia.
Untuk sistem produksi, metrik yang lebih baik selalunya ialah kos per tugas yang berjaya disiapkan dan bukannya harga per token atau satu peratusan penanda aras.
Beban Kerja Manakah Paling Sesuai untuk Gemini 4 Argon?
Prestasi Kerja Pengetahuan
Pola paling jelas dalam keputusan Argon muncul dalam kerja pengetahuan profesional berbilang langkah.
Pada Vals Index, Argon mencapai 68.9%, berbanding 67.0% untuk Claude Opus 5.5. Jurang angka itu sederhana, tetapi pola menjadi lebih jelas dalam alur kerja khusus.
- Vals Finance Agent v2: 65.4%, 6.5 mata di atas pesaing terkuat yang ditunjukkan dalam jadual Google.
- AutomationBench: 51.3%, 8.8 mata di atas Claude Opus 5.5.
- Harvey's Legal Agent Benchmark: 19.6%, berbanding 6.7% untuk model dilaporkan seterusnya tertinggi.
Profil prestasi mencadangkan bahawa Argon mendapat manfaat paling banyak apabila model mesti mengumpul maklumat, mengekalkan keadaan, menaakul merentasi beberapa peringkat, dan menghasilkan artifak profesional bukannya sekadar menjawab soalan tertutup.
Skor agen undang-undang mutlak yang rendah juga penting. Skor 19.6% sahaja tidak mendedahkan berapa banyak kriteria atau alur kerja lengkap yang gagal. Kesimpulan berguna ialah Argon menunjukkan peningkatan relatif yang besar pada penilaian ini, sementara keputusan itu tidak mewujudkan automasi kerja undang-undang yang boleh dipercayai.
Penaakulan Konteks Panjang
Kelebihan paling ketara Argon mungkin pada GraphWalks versi 256K–1M.
- Gemini 4 Argon: 84.2%
- GPT-6 Astra: 71.8%
- Claude Opus 5.5: 66.8%
- Claude Fable 5.1: 65.0%
Itu ialah kelebihan 12.4 mata berbanding model terhampir dalam perbandingan yang diterbitkan.
Jurang jauh lebih kecil pada panjang konteks yang lebih pendek: pada GraphWalks sehingga 128K, Argon mencatat 99.7% dan GPT-6 Astra 98.7%. Ini mencadangkan bahawa Argon merosot kurang tajam daripada model yang dibandingkan pada penilaian konteks sangat panjang ini.
Apa yang Google belum dedahkan ialah maklumat seni bina yang mencukupi untuk mengaitkan perbezaan ini dengan mekanisme perhatian tertentu, sistem capaian, resipi latihan, atau strategi masa inferens. Dakwaan seperti “Gemini 4 memperkenalkan seni bina perhatian baharu” akan melampaui bukti awam.
Prestasi Pengaturcaraan
Jadual penanda aras rasmi tidak menyokong jawapan ya yang mudah.
Argon berprestasi sangat baik pada beberapa bentuk pengekodan dan tewas jelas pada yang lain. Pada DeepSWE v1.1 ia mencapai 77.9%, berbanding 74.2% untuk Claude Opus 5.5 dan 74.1% untuk GPT-6 Astra. Skor Vibe Code Bench juga kukuh pada 91.9%.
- FrontierSWE v2: 55.0% Argon berbanding 65.5% GPT-6 Astra.
- Terminal-Bench 4.0: 57.4% Argon berbanding 66.4% Claude Opus 5.5.
- Terminal-Bench Science 0.1: 57.6% Argon berbanding 68.1% GPT-6 Astra.
Perbezaan ini penting untuk pembangun. Argon nampaknya khususnya kuat apabila pengekodan menjadi alur kerja kejuruteraan panjang dengan konteks dan perancangan substansial, manakala pelaksanaan berat-terminal kekal lebih kompetitif. Penanda aras migrasi repositori dan penanda aras terminal interaktif tidak harus dianggap sebagai ukuran “keupayaan pengekodan” yang boleh ditukar ganti.
Keselamatan Siber Defensif
Keselamatan siber ialah bidang penerapan teras. Penentuan keselamatan siber defensif Google termasuk penemuan, validasi dan pembaikan kelemahan secara autonomi. Ini ialah tuntutan keupayaan penyedia; keputusan CWE-bench di bawah mengukur pembetulan kelemahan pada penilaiannya sendiri.
Pada CWE-bench v1, Argon mencatat 68%, setara dengan GPT-6 Astra dan sedikit di hadapan Claude Opus 5.5 pada 67%.
Google juga menyerlahkan perlindungan yang lebih kukuh terhadap penyalahgunaan, suntikan prompt tidak langsung, tingkah laku agen berisiko, dan kompromi persekitaran pelaksanaan. Ini menjadikan Argon sama banyaknya keluaran keselamatan agen seperti naik taraf model konvensional.
Pemahaman Multimodal
Argon mencatat 71.6% pada Chartography dan 91.7% pada LVBench untuk pemahaman video panjang. Keputusan LVBench adalah 4.2 mata peratusan di atas GPT-6 Astra dalam jadual Google. Oleh kerana model menerima konfigurasi pensampelan bingkai yang berbeza, ini ialah perbandingan set konfigurasi yang dilaporkan dan bukannya kelebihan model semata-mata.
Ini penting kerana banyak alur kerja profesional bukan teks semata-mata. Agen penyelidikan kewangan mungkin perlu memeriksa carta; pembantu perusahaan mungkin menggabungkan laporan, PDF dan tangkapan skrin; sistem analisis video mungkin perlu mengekalkan peristiwa sepanjang jujukan panjang dan bukannya memproses bingkai individu secara bebas.
Gabungan persepsi multimodal dan penaakulan berterusan Argon oleh itu lebih relevan daripada sokongan multimodal sahaja.
Prestasi Sains dan Matematik
Keputusan adalah bercampur tetapi umumnya kukuh. Argon mencapai 88.8% pada LABBench 2 dan 76.0% pada RiemannBench, di hadapan model yang dibandingkan dalam jadual Google. Walau bagaimanapun, pada Terminal-Bench Science 0.1, GPT-6 Astra mencapai 68.1% berbanding 57.6% bagi Argon.
Perbezaan itu menunjuk kepada pola yang lebih luas: Argon nampaknya lebih kuat dalam penaakulan ke atas maklumat saintifik daripada setiap bentuk pelaksanaan saintifik berasaskan alat.
Prestasi Penggunaan Komputer
Pada Agent's Last Exam, Argon mencatat kadar lulus binari 39.5%, di hadapan GPT-6 Astra pada 34.2% dan Claude Opus 5.5 pada 38.2%. Pada subset luar talian OSWorld-2.0, skor separanya 69.2%, di bawah 72.6% GPT-6 Astra. Nilai OSWorld bukan kadar kejayaan tugas penuh, dan entri Claude yang hilang tidak menyiratkan keupayaan sifar.
Jadi data semasa tidak menunjukkan kelebihan penggunaan komputer merentas papan. Untuk penerapan produksi, skor penanda aras harus dilengkapkan dengan ujian peringkat tugas bagi ketepatan navigasi, klik gagal, kekerapan percubaan semula, tindakan tidak disengajakan, masa ke siap, dan kadar pembetulan manusia.
Gemini 4 Argon vs GPT-6 Astra dan Claude
| Dimensi | Gemini 4 Argon | GPT-6 Astra | Claude Opus 5.5 | Claude Fable 5.1 |
|---|---|---|---|---|
| Kerja pengetahuan | Sangat kuat | Kuat | Sangat kuat | Kuat |
| Penanda aras konteks panjang | Keputusan diterbitkan terkuat | Kuat | Sederhana–kuat | Sederhana |
| Pengekodan jangka panjang | Sangat kuat | Sangat kuat | Sangat kuat | Kuat |
| Pengekodan terminal | Kompetitif | Kuat | Terkuat dalam ujian terpilih | Kompetitif |
| Agen sains berasaskan terminal | Kompetitif | Terkuat dalam ujian terpilih | Kuat | Kompetitif |
| Pemahaman multimodal | Sangat kuat | Sangat kuat | Kuat | Kompetitif |
| Penggunaan komputer | Kompetitif | Kuat | Campuran / perbandingan terhad | Perbandingan terhad |
| Keselamatan siber | Terikat di puncak pada CWE-bench v1 | Terikat di puncak | Sangat hampir | Lebih rendah |
Argon menonjol dalam perbandingan ini untuk alur kerja berkonteks panjang, berat dokumen dan kerja agen profesional. Pembangun boleh membandingkannya dengan GPT-6 Astra, Claude Opus 5.5 dan Claude Fable 5.1 melalui CometAPI.
Pemilihan berasaskan prestasi
Label kualitatif di atas merumuskan jadual penanda aras terpilih, bukan kedudukan sejagat. Utamakan Argon untuk projek perintis apabila kerja menyerupai penilaian teratasnya; uji Astra dan Opus pada beban kerja berat-terminal sebelum memilih lalai.
Spesifikasi dan kekangan penerapan
Perbandingan prestasi ini tidak mewujudkan kelebihan seni bina atau pemenang harga-prestasi umum. Kiraan parameter dan seni bina Argon tidak dinyatakan dalam bahan pelancaran Google yang dikaji. Had konteks input awam memerlukan dokumentasi API rasmi. CometAPI melaporkan laluan gemini-4-argon; sahkan parameter yang disokong dan akses akaun secara bebas daripada pelancaran lebih luas Google. Bandingkan had setiap laluan dan kos tugas sebenar sebelum menerapkan.
Bagaimana Pembangun Boleh Mengakses Gemini 4 Argon melalui CometAPI?
CometAPI melaporkan model ini tersedia di bawah gemini-4-argon. Gunakan papan pemuka akaun untuk mencipta kunci API, pilih pengenal tersebut dalam playground, dan jalankan permintaan ujian sebelum integrasi. Contoh serasi OpenAI menggunakan URL asas https://api.cometapi.com/v1. Sahkan titik akhir dan parameter yang disokong model dalam dokumentasi akaun; lencana katalog sahaja tidak mengesahkan panggilan yang berjaya.
- Cipta akaun CometAPI dan jana kunci API dalam papan pemuka.
- Pilih gemini-4-argon dan sahkan permintaan representatif dalam playground.
- Konfigurasikan klien serasi dengan URL asas CometAPI, kunci anda dan pengenal model; sahkan skema permintaan dan pengebilan yang disokong sebelum penerapan.
CometAPI dan harga rasmi
Google mengumumkan harga pengenalan $2 per juta token input dan $10 per juta token output, dengan input cache berharga 95% diskaun daripada kadar input. Selepas tempoh pengenalan, kadar yang diumumkan ialah $4 input dan $20 output per juta token. Ini ialah kadar yang diumumkan oleh Google, bukan harga CometAPI atau pengesahan akses API umum segera.
| Asas pengebilan | Gemini 4 Argon API dalam CometAPI | Pengumuman rasmi Google | Perbandingan |
|---|---|---|---|
| Input / 1M token | $3.20 | $4.00 selepas tempoh pengenalan | 20% di bawah kadar selepas pengenalan yang diumumkan |
| Output / 1M token | $16.00 | $20.00 selepas tempoh pengenalan | 20% di bawah kadar selepas pengenalan yang diumumkan |
Kesimpulan
Profil penanda aras Gemini 4 Argon lebih menarik daripada tuntutan papan pendahulu yang ringkas.
Keputusan terkuat dalam perbandingan ini berkumpul sekitar kerja pengetahuan profesional, konteks panjang dan pelaksanaan agen berterusan. Pola ini berguna untuk pemilihan beban kerja, tetapi tidak mengenal pasti seni bina asas atau membuktikan mekanisme yang menyebabkan peningkatan.
Keputusan kewangan, undang-undang, video panjang dan kejuruteraan perisian yang dilaporkan menyokong projek perintis fokus untuk beban kerja tersebut. Sama ada kelebihan yang sama kekal dalam produksi bergantung pada campuran input, rangka kerja agen, tetapan inferens dan keperluan verifikasi.
Pada masa yang sama, keputusan menunjukkan bahawa prestasi model frontier semakin khusus. Argon boleh mendahului DeepSWE sambil ketinggalan pada FrontierSWE; mendahului Agent's Last Exam sambil ketinggalan pada OSWorld; dan mendahului LABBench sambil ketinggalan pada Terminal-Bench Science. Penanda aras ini menekankan bahagian berbeza dalam sistem agen.
Bagi pembangun, pelajaran paling penting ialah pemilihan model semakin perlu dilakukan pada peringkat beban kerja dan bukannya jenama atau keluarga.
Soalan Lazim
Bagaimanakah pembangun harus mengesahkan Gemini 4 Argon pada beban kerja mereka sendiri?
Bina set tugas representatif dengan kriteria penerimaan yang jelas. Kekalkan alat, had masa, penyediaan input dan polisi percubaan semula yang setanding merentas model. Rekod tugasan yang disiapkan, jumlah token, masa berlalu dan pembetulan manusia. Mulakan dengan perintis kecil dan teliti kes kegagalan sebelum merutekan trafik produksi.
Bolehkah peratusan penanda aras Gemini 4 Argon dipuratakan menjadi satu skor?
Tidak. Jadual ini menggabungkan metrik berbeza, termasuk F1, kadar lulus, dan skor separa. Gunakan kriteria khusus tugas dan bukannya mempuratakan semua peratusan.
Perlukah agen Gemini 4 Argon sentiasa menggunakan keseluruhan bajet outputnya?
Tidak. Pilih bajet terkecil yang diuji yang memenuhi keperluan kualiti dan kebolehpercayaan anda. Had output maksimum ialah siling, bukan sasaran.
Bagaimanakah pasukan harus menilai akses Gemini 4 Argon melalui CometAPI?
Mulakan dengan semakan ketersediaan peringkat akaun dan permintaan kecil menggunakan laluan CometAPI yang didokumenkan. Ukur kualiti respons, kependaman, had dan token dibilkan, kemudian gunakan ujian penerimaan yang sama untuk model alternatif. Anggap tuntutan akses CometAPI berasingan daripada pelancaran lebih luas Google, dan kekalkan perutusan boleh dikonfigurasi sehingga laluan tersebut memenuhi keperluan anda.