
TL;DR
Gemini 4 Argon tidak termasuk dalam peringkat percuma Gemini API, dan langganan Google AI Pro sahaja tidak menyediakan akses API Argon. Google AI Ultra mungkin menyediakan akses melalui produk Gemini terpilih, manakala penggunaan API berbayar dibilkan secara berasingan. CometAPI menawarkan laluan API bebas tanpa memerlukan setiap pengguna akhir memegang langganan Google AI Pro atau Ultra. Kadar input dan output tanpa cache yang diterbitkan ialah $1.60 dan $8 per sejuta token, berbanding kadar Standard pengenalan Google iaitu $2 dan $10.
Akses dan kadar utama penyedia diperiksa pada 16 Oktober 2026.
Key Takeaways
- Harga pengenalan: $2 / 1M token input dan $10 / 1M token output; mulai 1 Disember, kadar berganda.
- Input dalam cache: diskaun cache tersirat 95% pada hit yang layak; minimum cache ialah 4,096 token prompt.
- Pengebilan output termasuk token pemikiran; input, pemikiran dan output boleh dilihat berkongsi bajet 1,048,576 token.
- Asingkan langganan aplikasi Gemini daripada hak akses Antigravity dan akses API berbayar. Ketiadaan model dalam satu produk tidak membuktikan setiap laluan akses tidak tersedia.
- CometAPI menyediakan laluan API bebas dengan kadar input dan output tanpa cache yang diterbitkan lebih rendah. Aplikasi boleh melayani berbilang pengguna akhir melalui satu akaun CometAPI tanpa memerlukan setiap pengguna mengekalkan langganan Google AI Pro atau Ultra; kuota, baki, kadar dan had kebergantungan peringkat akaun tetap terpakai.
Apakah Had Akses Semasa Gemini 4 Argon Google?
Keputusan pertama ialah di mana anda memerlukan Argon: aplikasi interaktif, persekitaran pengkodan tempatan, atau integrasi API. Pengumuman akses pembangun Google membezakan akses API Gemini berbayar daripada akses pelanggan Ultra dalam AI Studio dan Antigravity. Jangan tafsir sekatan langganan Antigravity sebagai keperluan membeli Ultra untuk setiap aliran kerja API berbayar.
Untuk aplikasi API, CometAPI menyediakan akaun dan laluan pengebilan alternatif. Ini berguna apabila anda mahu menilai Argon bersama model lain tanpa membeli langganan pengguna Google untuk tujuan itu. Ia tidak mengubah hak akses dalam aplikasi Google sendiri, dan ia tidak sepatutnya digambarkan sebagai penggunaan tanpa had.
Berapakah Kos API Gemini 4 Argon?
Kadar Standard Gemini 4 Argon Google terpakai sehingga 30 November 2026, dengan kadar lebih tinggi bermula 1 Disember. Semua jumlah di bawah adalah USD per sejuta token kecuali dinyatakan sebaliknya. Batch, Flex dan Priority mempunyai kadar berasingan.
| Kategori pengebilan (USD / 1M token) | Google Standard: sehingga 30 Nov 2026 | Google Standard: dari 1 Dis 2026 | Gemini 4 Argon API dalam CometAPI: sehingga 30 Nov 2026 |
|---|---|---|---|
| Input | $2.00 | $4.00 | $1.60 |
| Input di-cache | $0.10 | $0.20 | $0.08 |
| Output, termasuk pemikiran | $10.00 | $20.00 | $8.00 |
Kadar CometAPI diperiksa pada 14 Oktober 2026. Harga input dan output yang diterbitkan adalah 20% di bawah kadar Standard pengenalan Google. Angka input dalam cache datang daripada kalkulator kos CometAPI; sahkan kadar akaun aktif dan kelayakan cache sebelum bergantung padanya. Perubahan harga Disember Google akan menentukan kadar masa hadapan CometAPI; semak kadar yang ditunjukkan dalam akaun CometAPI anda semasa membuat bajet.
Pada kadar ini, 200,000 token input tanpa cache ditambah 60,000 token output boleh dibilkan berharga $0.80 melalui CometAPI, berbanding $1.00 melalui Google semasa tempoh pengenalan. Contoh pengiraan ini tidak termasuk alat dan cubaan semula.
Berapakah Kos Gemini 4 Argon Merentas Beban Kerja Realistik?
Senario berikut ialah contoh pengiraan, bukan penggunaan model yang diukur. Input tidak di-cache; output termasuk kedua-dua pemikiran dan teks boleh dilihat. Permintaan ejen pengkodan dengan 200,000 token input dan 60,000 token output boleh dibilkan berharga $1.00 semasa tempoh pengenalan dan $2.00 selepas itu. Beban kerja yang sama diulang 1,000 kali berharga $1,000 atau $2,000 sebelum cubaan semula, alat dan cukai.
| Permintaan contoh | Token input tanpa cache | Token output boleh dibilkan | Harga pengenalan | Harga Standard |
|---|---|---|---|---|
| Jawapan pembantu pendek | 5K | 1K | $0.02 | $0.04 |
| Analisis dokumen | 100K | 10K | $0.30 | $0.60 |
| Ejen pengkodan kompleks | 200K | 60K | $1.00 | $2.00 |
| Aliran kerja penyelidikan | 500K | 100K | $2.00 | $4.00 |
| Permintaan nyahkod panjang | 100K | 500K | $5.20 | $10.40 |
Formula: Kos = (token input tanpa cache × kadar input + token input di-cache × kadar cache + token output boleh dibilkan × kadar output) / 1,000,000. Contoh di atas adalah ilustratif dan mengandaikan tiada cache.
Bagaimana Anda Boleh Mengurangkan Kos API Gemini 4 Argon?
Cache Tersirat dan Prefiks Prompt Guna Semula
Cache mengurangkan perbelanjaan input guna semula, bukan keseluruhan harga permintaan. Untuk contoh 200K input / 60K output, hit cache input lengkap yang layak mengurangkan kos input pengenalan daripada $0.40 kepada $0.02. Jumlah kos token menjadi $0.62 dan bukannya $1.00: pengurangan 38%, walaupun diskaun input ialah 95%. Jika 50% token input dilayan daripada cache, permintaan yang sama berharga $0.81: 100,000 token input di-cache × $0.10 / 1M + 100,000 token input tanpa cache × $2 / 1M + 60,000 token output boleh dibilkan × $10 / 1M = $0.01 + $0.20 + $0.60. Di sini, 50% merujuk khusus kepada volum token input. Anggap ini sebagai senario dan gunakan penggunaan token di-cache yang diperhati untuk ramalan.
Google membolehkan cache tersirat untuk prompt sekurang-kurangnya 4,096 token dan tidak menyokong penciptaan cache eksplisit untuk Argon. Kekalkan prefiks prompt yang boleh diguna semula, tetapi bajetkan untuk input tanpa cache sehingga hit cache yang diperhati membenarkan anggaran lebih rendah.
Tahap Pemikiran dan Perbelanjaan Output
Jawapan boleh dilihat yang pendek masih boleh membawa kos output yang besar kerana pemikiran boleh dibilkan. Mulakan dengan pemikiran tahap sederhana, kemudian uji tahap lebih rendah dan lebih tinggi pada tugasan perwakilan. Jejak kedua-dua kualiti dan jumlah penggunaan output; pilih tahap penalaran terendah yang memenuhi kriteria penerimaan anda.
Oleh kerana pemikiran dan output boleh dilihat berkongsi had respons, nilai max_output_tokens yang rendah boleh meninggalkan ruang yang tidak mencukupi untuk jawapan akhir. Bandingkan kejayaan penyempurnaan tugasan pada setiap tahap pemikiran sebelum mengurangkan had output.
Kawalan Operasi untuk Kos Gemini 4 Argon
- Gunakan had output realistik dan elakkan generasi panjang yang tidak perlu.
- Guna semula prefiks prompt berkongsi apabila layak untuk cache tersirat.
- Lalukan tugasan mudah kepada model yang kurang mahal, mengekalkan Argon untuk kes sukar.
- Log jumlah token boleh dibilkan, kegagalan, cubaan semula dan kos per tugasan berjaya.
- Nilai ekonomi pada kadar pasca promosi sebelum komited kepada pengeluaran besar.
Bagaimana Anda Boleh Mengakses Gemini 4 Argon?
Pilih akses aplikasi Gemini untuk kerja interaktif peribadi dan laluan API berbayar untuk aplikasi serta ejen automatik. Argon dikecualikan daripada peringkat percuma Gemini API; langganan Google AI Pro sahaja tidak memberikan akses API Argon. Hak akses aplikasi Pro dan Ultra berasingan daripada pengebilan token API, dan Ultra tidak diperlukan untuk Gemini API berbayar.
| Laluan akses | Akses Argon | Pengebilan / hak akses |
|---|---|---|
| Aplikasi Gemini | Pelanggan Pro dan Ultra yang layak | Langganan dan had aplikasi |
| Google AI Studio | Pelanggan Ultra yang layak atau pengguna API berbayar | Bergantung pada laluan akses |
| Gemini API | Projek berbayar yang layak | Pengebilan API berasaskan penggunaan |
| Google Antigravity | Pelanggan Ultra yang layak | Hak akses khusus produk |
| CometAPI | Akaun CometAPI yang disokong | Kadar dan syarat CometAPI |
Integrasi API Terus Gemini 4 Argon
Pembangun boleh mengintegrasikan Gemini 4 Argon terus melalui projek Gemini API berbayar yang layak. ID model ialah gemini-4-argon. Laluan ini ditujukan untuk aplikasi, ejen automatik dan aliran kerja produksi yang memerlukan akses terus kepada API Google, pengebilan berasaskan penggunaan dan ciri API rasmi.
Peringkat percuma Gemini API tidak termasuk Argon. Akses aplikasi Google AI Pro juga tidak secara automatik menyediakan akses API atau kredit API. Pembangun harus mengkonfigurasi pengebilan dan kelayakan untuk projek yang dikaitkan dengan kelayakan API mereka.
Ralat pengesahan, pengebilan atau kelayakan mesti diselesaikan untuk projek yang memiliki kunci sebelum mencuba semula; menukar langganan pengguna sahaja tidak mengkonfigurasi pengebilan API.
Akses CometAPI untuk Gemini 4 Argon
Pembangun boleh mengakses Gemini 4 Argon API dalam CometAPI melalui akaun dan kunci API berasingan. Kelebihan praktikalnya ialah pengebilan API bebas, akses kepada pelbagai model melalui satu penyedia, dan kadar input/output yang diterbitkan seperti perbandingan di atas. Laluan ini tidak memerlukan pembelian Google AI Pro atau Ultra sebagai langganan pengguna.
Akses berasaskan akaun bukan janji kapasiti tanpa sekatan. Sahkan ketersediaan model, baki, kadar dan had kebergantungan, rantau yang disokong, cache, kawalan pemikiran dan pelaporan penggunaan untuk akaun CometAPI anda. Akses API juga tidak membuka Argon dalam aplikasi Gemini atau Antigravity.
Mulakan dengan permintaan kecil melalui penyedia yang dipilih, sahkan medan model dan penggunaan yang dipulangkan, kemudian tetapkan had perbelanjaan sebelum meningkatkan trafik.
Adakah Gemini 4 Argon Berbaloi dengan Kos?
Gemini 4 Argon ialah calon untuk penaakulan, pengkodan, penyelidikan dan kerja konteks panjang yang menuntut. Nilainya bergantung pada sama ada ia meningkatkan kejayaan penyempurnaan tugasan atau mengurangkan cubaan semula mencukupi untuk membenarkan perbelanjaan token. Gunakan spesifikasi dan penanda aras yang diterbitkan di bawah untuk mengenal pasti beban kerja untuk diuji, kemudian nilai kualiti dan kos dengan prompt, alat dan laluan akses anda sendiri.
Spesifikasi Gemini 4 Argon
| Spesifikasi | Gemini 4 Argon |
|---|---|
| ID model | gemini-4-argon |
| Pembangun | Google DeepMind |
| Jenis model | Model multimodal berorientasikan penaakulan |
| Tetingkap input + pemikiran + output bersatu | Sehingga 1,048,576 token digabung |
| Tahap pemikiran | Rendah / sederhana / tinggi |
| Tahap pemikiran lalai | Sederhana |
| Sokongan output panjang | Pelaksanaan latar belakang; maksimum tertakluk pada bajet berkongsi |
| Cache konteks | Tersirat; prompt layak ≥ 4,096 token |
| Cache eksplisit | Tidak disokong |
Had sejuta token dikongsi merentas input, pemikiran dan output yang dijana. Pada Interactions API, penjanaan lebih daripada 65,536 token memerlukan kedua-dua background=True dan generation_config.max_output_tokens melebihi 65,536. Menetapkan background=True sahaja tidak menaikkan had output lalai. GenerateContent API juga menyokong kesinambungan sisi klien untuk nyahkod panjang
Gemini 4 Argon vs GPT-6 Astra vs Claude Opus 5.5: Penanda Aras Diterbitkan
Nilai berikut sepadan dengan hasil penilaian yang diterbitkan Google. Ia adalah hasil yang diterbitkan vendor yang dikompilasi daripada pelbagai sumber penilaian, bukannya perbandingan terkawal baharu untuk artikel ini.
| Penanda aras diterbitkan | Gemini 4 Argon | GPT-6 Astra | Claude Opus 5.5 |
|---|---|---|---|
| Vals Index | 68.9% | 63.1% | 67.0% |
| AutomationBench | 51.3% | 41.4% | 42.5% |
| Vals Finance Agent v2 | 65.4% | 53.5% | 58.6% |
| DeepSWE v1.1 | 77.9% | 74.1% | 74.2% |
| FrontierSWE v2 | 55.0% | 65.5% | 62.3% |
| Terminal-bench 4.0 | 57.4% | 58.2% | 66.4% |
| GraphWalks 256K–1M, BFS F1 | 84.2% | 71.8% | 66.8% |
| LVBench | 91.7% | 87.5% | 83.7% |
Syarat Penilaian dan Kebolehbandingan
Metodologi penilaian Google menggunakan Gemini API pada tetapan pemikiran tertinggi kecuali dinyatakan sebaliknya, lazimnya dengan pass@1. DeepSWE menggunakan mini-swe untuk Argon; angka pesaing datang daripada papan kedudukan atau kad sistem. GraphWalks 256K–1M menggunakan 200 masalah. LVBench berjalan tanpa alat, dengan 1 FPS untuk Gemini, 800 bingkai untuk GPT-6 Astra dan 600 untuk Opus 5.5. Hasil Vals datang daripada Vals AI; AutomationBench menggunakan papan kedudukan set peribadi Zapier. Perbezaan ini menghadkan kebolehbandingan langsung.
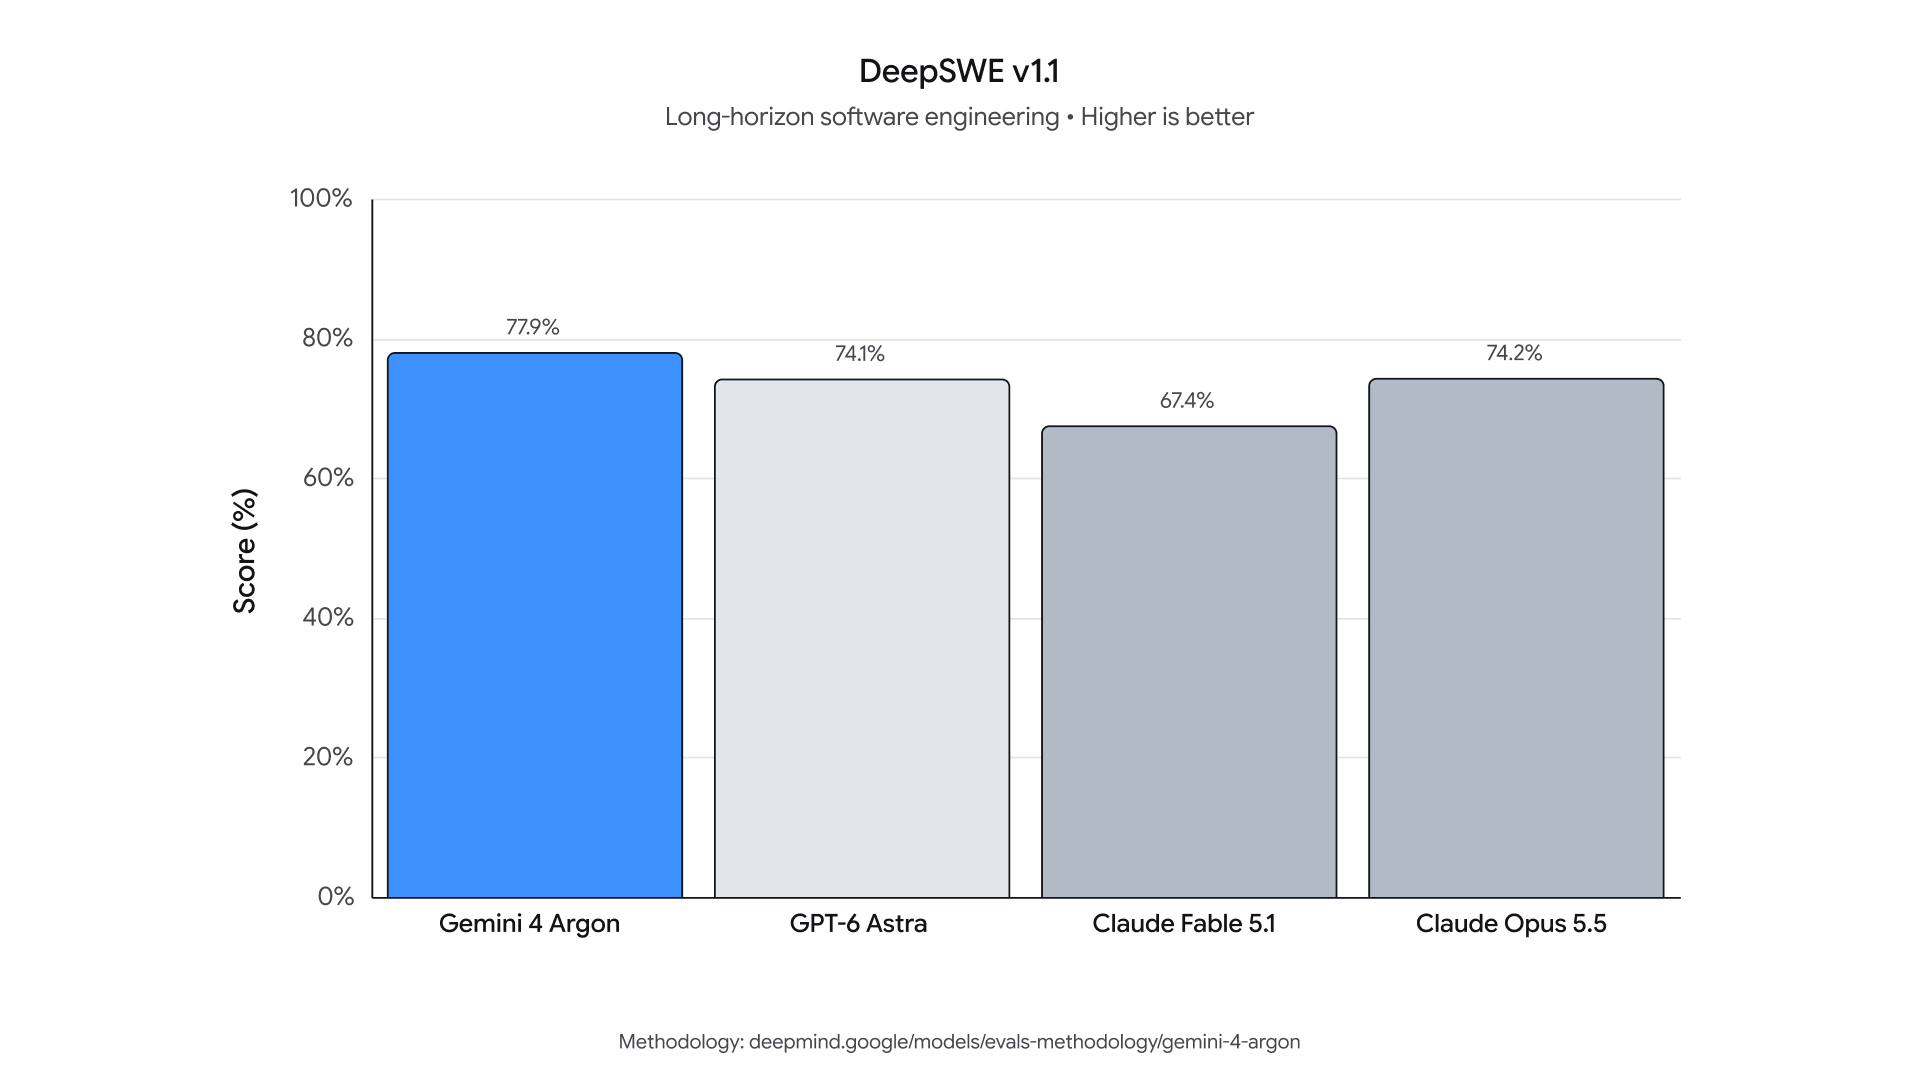
Carta DeepSWE v1.1 rasmi Google menunjukkan Gemini 4 Argon (77.9%), GPT-6 Astra (74.1%), Claude Fable 5.1 (67.4%), dan Claude Opus 5.5 (74.2%), dari kiri ke kanan. Jadual di atas memilih tiga daripada model ini; imej rasmi termasuk keempat-empatnya.
Implikasi Prestasi untuk Pengguna Gemini 4 Argon
Tafsiran: Argon mendahului dalam Vals Index, AutomationBench, ejen kewangan, dan baris konteks panjang yang dipilih; ia tidak mendahului dalam FrontierSWE atau Terminal-bench. Oleh kerana harnas penilaian dan prompt mungkin berbeza, gunakan hasil ini sebagai bukti berarah dan jalankan ujian khusus beban kerja.
Untuk perolehan, ukur kos tugasan berjaya bersama ketepatan, kependaman, cubaan semula dan penggunaan token. Skor diterbitkan yang lebih tinggi tidak membuktikan kos produksi lebih rendah di bawah prompt, alat atau laluan akses anda.
Pilih Gemini 4 Argon atau Model Lebih Murah
Uji Argon pada tugasan penaakulan, pengkodan dan konteks panjang yang sukar di mana lebih sedikit cubaan semula atau kadar penyempurnaan lebih tinggi boleh membenarkan perbelanjaan token yang lebih besar. Untuk pengelasan rutin, pengekstrakan dan pemerkhidmatan ringkasan volum tinggi, uji model kos lebih rendah terlebih dahulu.
Bandingkan jumlah kos per tugasan berjaya, termasuk token pemikiran, penggunaan cache, panggilan alat dan cubaan semula. Pilih model dan laluan akses yang memenuhi keperluan kualiti anda pada kos yang boleh diterima.
FAQ
Adakah Batch dan Flex Gemini 4 Argon lebih murah daripada Standard?
Kadar token Argon Batch dan Flex Google ialah $1 input dan $5 output per sejuta token sehingga 30 November 2026, meningkat kepada $2 dan $10 selepas itu. Input di-cache ialah $0.05, meningkat kepada $0.10. Ini adalah pilihan pemprosesan berasingan, jadi sahkan kekangan operasinya terhadap beban kerja anda sebelum menggantikan integrasi Standard.
Anggarkan penggunaan Standard, Batch dan Flex secara berasingan menggunakan kadar setiap pilihan yang berkenaan, kemudian tambah subtotak untuk bajet beban kerja bercampur.
Adakah anggaran token Gemini 4 Argon termasuk caj carian?
Tidak. Aritmetik token sahaja mengecualikan perkhidmatan yang dibilkan secara berasingan. Search grounding charge Google ialah $14 per 1,000 pertanyaan selepas elaun bulanan 5,000 permintaan yang dikongsi untuk Gemini 3 dan model lebih baharu. Permintaan yang dihantar mungkin mengeluarkan lebih daripada satu pertanyaan carian, jadi jejak penggunaan grounding sebenar secara berasingan dan jangan anggap satu prompt pengguna sama dengan satu pertanyaan boleh dibilkan.
Bagaimana saya harus membajet Gemini 4 Argon merentas perubahan harga?
Pisahkan ramalan penggunaan token kepada tempoh pengenalan dan standard, kemudian gunakan kadar setiap tempoh. Sebagai contoh, 10 juta token input tanpa cache ditambah 1 juta token output berharga $30 pada kadar Standard pengenalan atau $60 selepas itu. Jika separuh daripada volum itu jatuh dalam setiap tempoh, anggaran token ialah $45. Tambah kos alat dan cubaan semula secara berasingan, dan gunakan kadar pasca promosi untuk bajet keadaan mantap.
Mengapa jawapan Gemini 4 Argon boleh berhenti sebelum lengkap?
Had output termasuk pemikiran serta teks boleh dilihat. Prompt yang menuntut boleh menghabiskan peruntukan itu sebelum jawapan akhir lengkap. Untuk respons panjang, pelaksanaan latar belakang meneruskan penjanaan secara hop sehingga selesai atau had yang dikonfigurasi; ia masih memerlukan nilai max_output_tokens yang mencukupi. Semak status penyempurnaan dan penggunaan, kemudian laraskan kedalaman penalaran atau had tersebut dan bukannya berulang kali menghantar permintaan yang sama yang kurang bajet.
Conclusion
Pilih akses Gemini 4 Argon mengikut aliran kerja, kemudian bandingkan kos menyiapkan tugasan berguna. Hak akses aplikasi Google dan Antigravity berbeza daripada akses API berbayar. CometAPI menawarkan laluan API berasingan dengan harga input/output yang diterbitkan 20% di bawah kadar Standard pengenalan Google, menjadikannya pilihan praktikal untuk penilaian kecil yang dibajetkan. Sahkan had akaun dan ciri yang diperlukan, jejak token pemikiran dan cubaan semula, dan skala hanya apabila kualiti serta jumlah kos memenuhi keperluan anda.