
TL;DR
Claude Fable 5.1 mempunyai kes penanda aras yang lebih kukuh untuk pengkodan autonomi yang sukar dan kerja jangka panjang. GPT-5.6 Sol menawarkan kos token biasa yang lebih rendah, timbunan alat natif yang luas, dan masa ke token pertama yang lebih rendah dalam perbandingan usaha maksimum bebas. Lalai yang betul bergantung pada kos tugas yang gagal, bukan sekadar skor penanda aras tertinggi.
Dalam snapshot Intelligence Index pada 8 September 2026, Fable 5.1 memperoleh 53, berbanding 47 untuk GPT-5.6 Sol. Kadar keluaran pada dasarnya seri pada 69.9 berbanding 69.8 tok/s. Keputusan ini menyokong keputusan antara kualiti dan kos; ia tidak menetapkan pemenang kelajuan sejagat.
Intipati Utama
- Pilih Fable 5.1 untuk tugas autonomi paling sukar apabila penilaian anda sendiri membenarkan harga yang lebih tinggi.
- Mulakan dengan GPT-5.6 Sol untuk inferens barisan hadapan yang sensitif kos dan aplikasi yang mendapat manfaat daripada alat bersepadu.
- Bandingkan kelewatan permulaan secara berasingan daripada kelajuan keluaran: GPT-5.6 Sol mempunyai masa ke token pertama yang diukur lebih rendah, manakala kadar keluaran hampir sama.
- Modelkan penulisan cache, bacaan, pengekalan, dan kadar konteks panjang secara berasingan. Harga input/output utama tidak menggambarkan setiap beban kerja ejen.
Data disemak pada 8 September 2026. Keputusan bebas menggunakan GPT-5.6 Sol pada usaha maksimum dan Fable 5.1 dengan Adaptive Reasoning, Max Effort, Default Fallback. Penanda aras vendor dan penanda aras bebas menggunakan persediaan penilaian yang berbeza. Harga adalah USD per sejuta token (MTok), kecuali dinyatakan sebaliknya.
GPT-5.6 Sol vs Fable 5.1: keputusan pantas
| Dimensi | GPT-5.6 Sol | Claude Fable 5.1 | Pilihan lebih baik |
|---|---|---|---|
| Independent Intelligence Index v4.3 (Sep 8) | 47 | 53 | Fable 5.1 |
| Independent Terminal-Bench 4.0 (Sep 7) | 39.9% | 52.0% | Fable 5.1 |
| Anthropic-run Terminal-Bench 4.0 | 37.3% | 55.8% | Fable 5.1 |
| Tetingkap konteks | 1.05M | 1M | Pada dasarnya seri |
| Keluaran maksimum | 128K | 128K | Seri |
| Input teks/imej | Yes | Yes | Seri |
| Harga input rasmi / MTok | $4 | $10 | Sol |
| Harga output rasmi / MTok | $20 | $50 | Sol |
| Bacaan cache rasmi / MTok | $0.40 | $0.25 | Fable 5.1 |
| Kelajuan output bebas (Sep 8) | 69.8 tok/s | 69.9 tok/s | Pada dasarnya seri |
| Keluasan alat API | Sangat luas | Kuat | Sol |
| Kerja autonomi jangka panjang | Cemerlang | Kekuatan teras | Fable 5.1 |
| Pengeluaran sensitif kos | Lalai lebih baik | Penskalaan premium | Sol |
Dasar permulaan yang berguna ialah Sol untuk kerja barisan hadapan rutin, dengan Fable 5.1 sebagai laluan penskalaan apabila sesuatu tugas gagal ambang kualiti atau autonomi anda. Sahkan dasar itu terhadap kos per tugas yang berjaya.
GPT-5.6 Sol mendedahkan enam aras usaha penaakulan, daripada tiada hingga maks, dengan aras sederhana sebagai lalai. Fable 5.1 menggunakan pemikiran adaptif sentiasa aktif; kawalan usaha mempengaruhi kedalaman penaakulan, dan lalainya ialah tinggi.
Tambahan 50,000 token dalam konteks GPT-5.6 Sol tidak mungkin menentukan kebanyakan seni bina. Pengebilan dan guna semula cache menjadi lebih penting apabila permintaan menghampiri satu juta token; bahagian konteks panjang di bawah menerangkan sebabnya.
Apakah GPT-5.6 Sol?
GPT-5.6 Sol ialah peringkat keupayaan tinggi dalam keluarga GPT-5.6 OpenAI untuk aliran kerja pengkodan, penyelidikan, perancangan, dan ejen yang menuntut. Tarikan utamanya dalam perbandingan ini ialah gabungan kawalan penaakulan dan persekitaran pelaksanaan sekelilingnya.
Melalui Responses API, GPT-5.6 Sol menyokong portfolio alat natif yang luas: carian web, carian fail, juru tafsir kod, shell dihoskan, apply patch, penggunaan komputer, MCP, skills, dan carian alat. Ini boleh mengurangkan bilangan komponen runtime berasingan yang perlu diintegrasikan oleh aplikasi.
OpenAI juga menerangkan pemanggilan alat secara programatik dan pelaksanaan multi-ejen untuk keluarga tersebut. Ciri platform ini penting apabila model mesti menyelaras kerja merentasi alat dan bukan mengembalikan satu jawapan sahaja.
Apakah Claude Fable 5.1?
Claude Fable 5.1 menyasarkan pengkodan yang menuntut, kerja pengetahuan profesional, penyelidikan, dan ejen jangka panjang. Keputusan penanda aras langsungnya menjadikannya calon kukuh untuk tugas di mana pemulihan, ketekunan, dan penyelesaian yang berjaya lebih penting daripada respons yang singkat.
Anthropic menekankan pelaksanaan autonomi berterusan merentas aplikasi, termasuk perancangan, pemulihan daripada langkah gagal, dan komunikasi kemajuan. Anggapkan kedudukan itu sebagai sebab untuk menguji tugas lebih panjang, bukan jaminan bahawa setiap aliran kerja akan selesai dengan betul.
Fable 5.1 juga berbeza daripada GPT-5.6 Sol dalam tingkah laku API: sekatan pemilihan alat paksa penting untuk aliran kerja yang memerlukan model memanggil alat tertentu. Semak mod tool_choice yang disokong apabila memindahkan gelung ejen deterministik.
Soalan integrasi oleh itu bersifat praktikal: bolehkah aplikasi anda menampung gelung penaakulan yang lebih autonomi, atau adakah ia memerlukan kawalan yang lebih halus ke atas setiap langkah? Uji tingkah laku alat yang tepat sebelum memilih laluan.
Perbandingan penanda aras: Fable 5.1 mempunyai bukti langsung yang lebih kukuh
Perbandingan penanda aras antara vendor pesaing mudah disalah guna. Penilaian pelancaran GPT-5.6 asal OpenAI mendahului Fable 5.1, manakala pelepasan Fable 5.1 Anthropic mengandungi perbandingan GPT-5.6 Sol langsung yang lebih baharu.
Cara paling bersih untuk membaca bukti adalah dalam tiga lapisan: perbandingan langsung Anthropic, ujian bebas semasa, dan profil keupayaan GPT-5.6 Sol milik OpenAI sendiri.
Keputusan langsung Fable 5.1 vs GPT-5.6 Sol oleh Anthropic
Keputusan penanda aras rasmi merangkumi lima tugas dengan skor yang dilaporkan untuk kedua-dua model. Perbezaan mata peratusan dan Elo di bawah dikira daripada nilai yang diterbitkan tersebut.
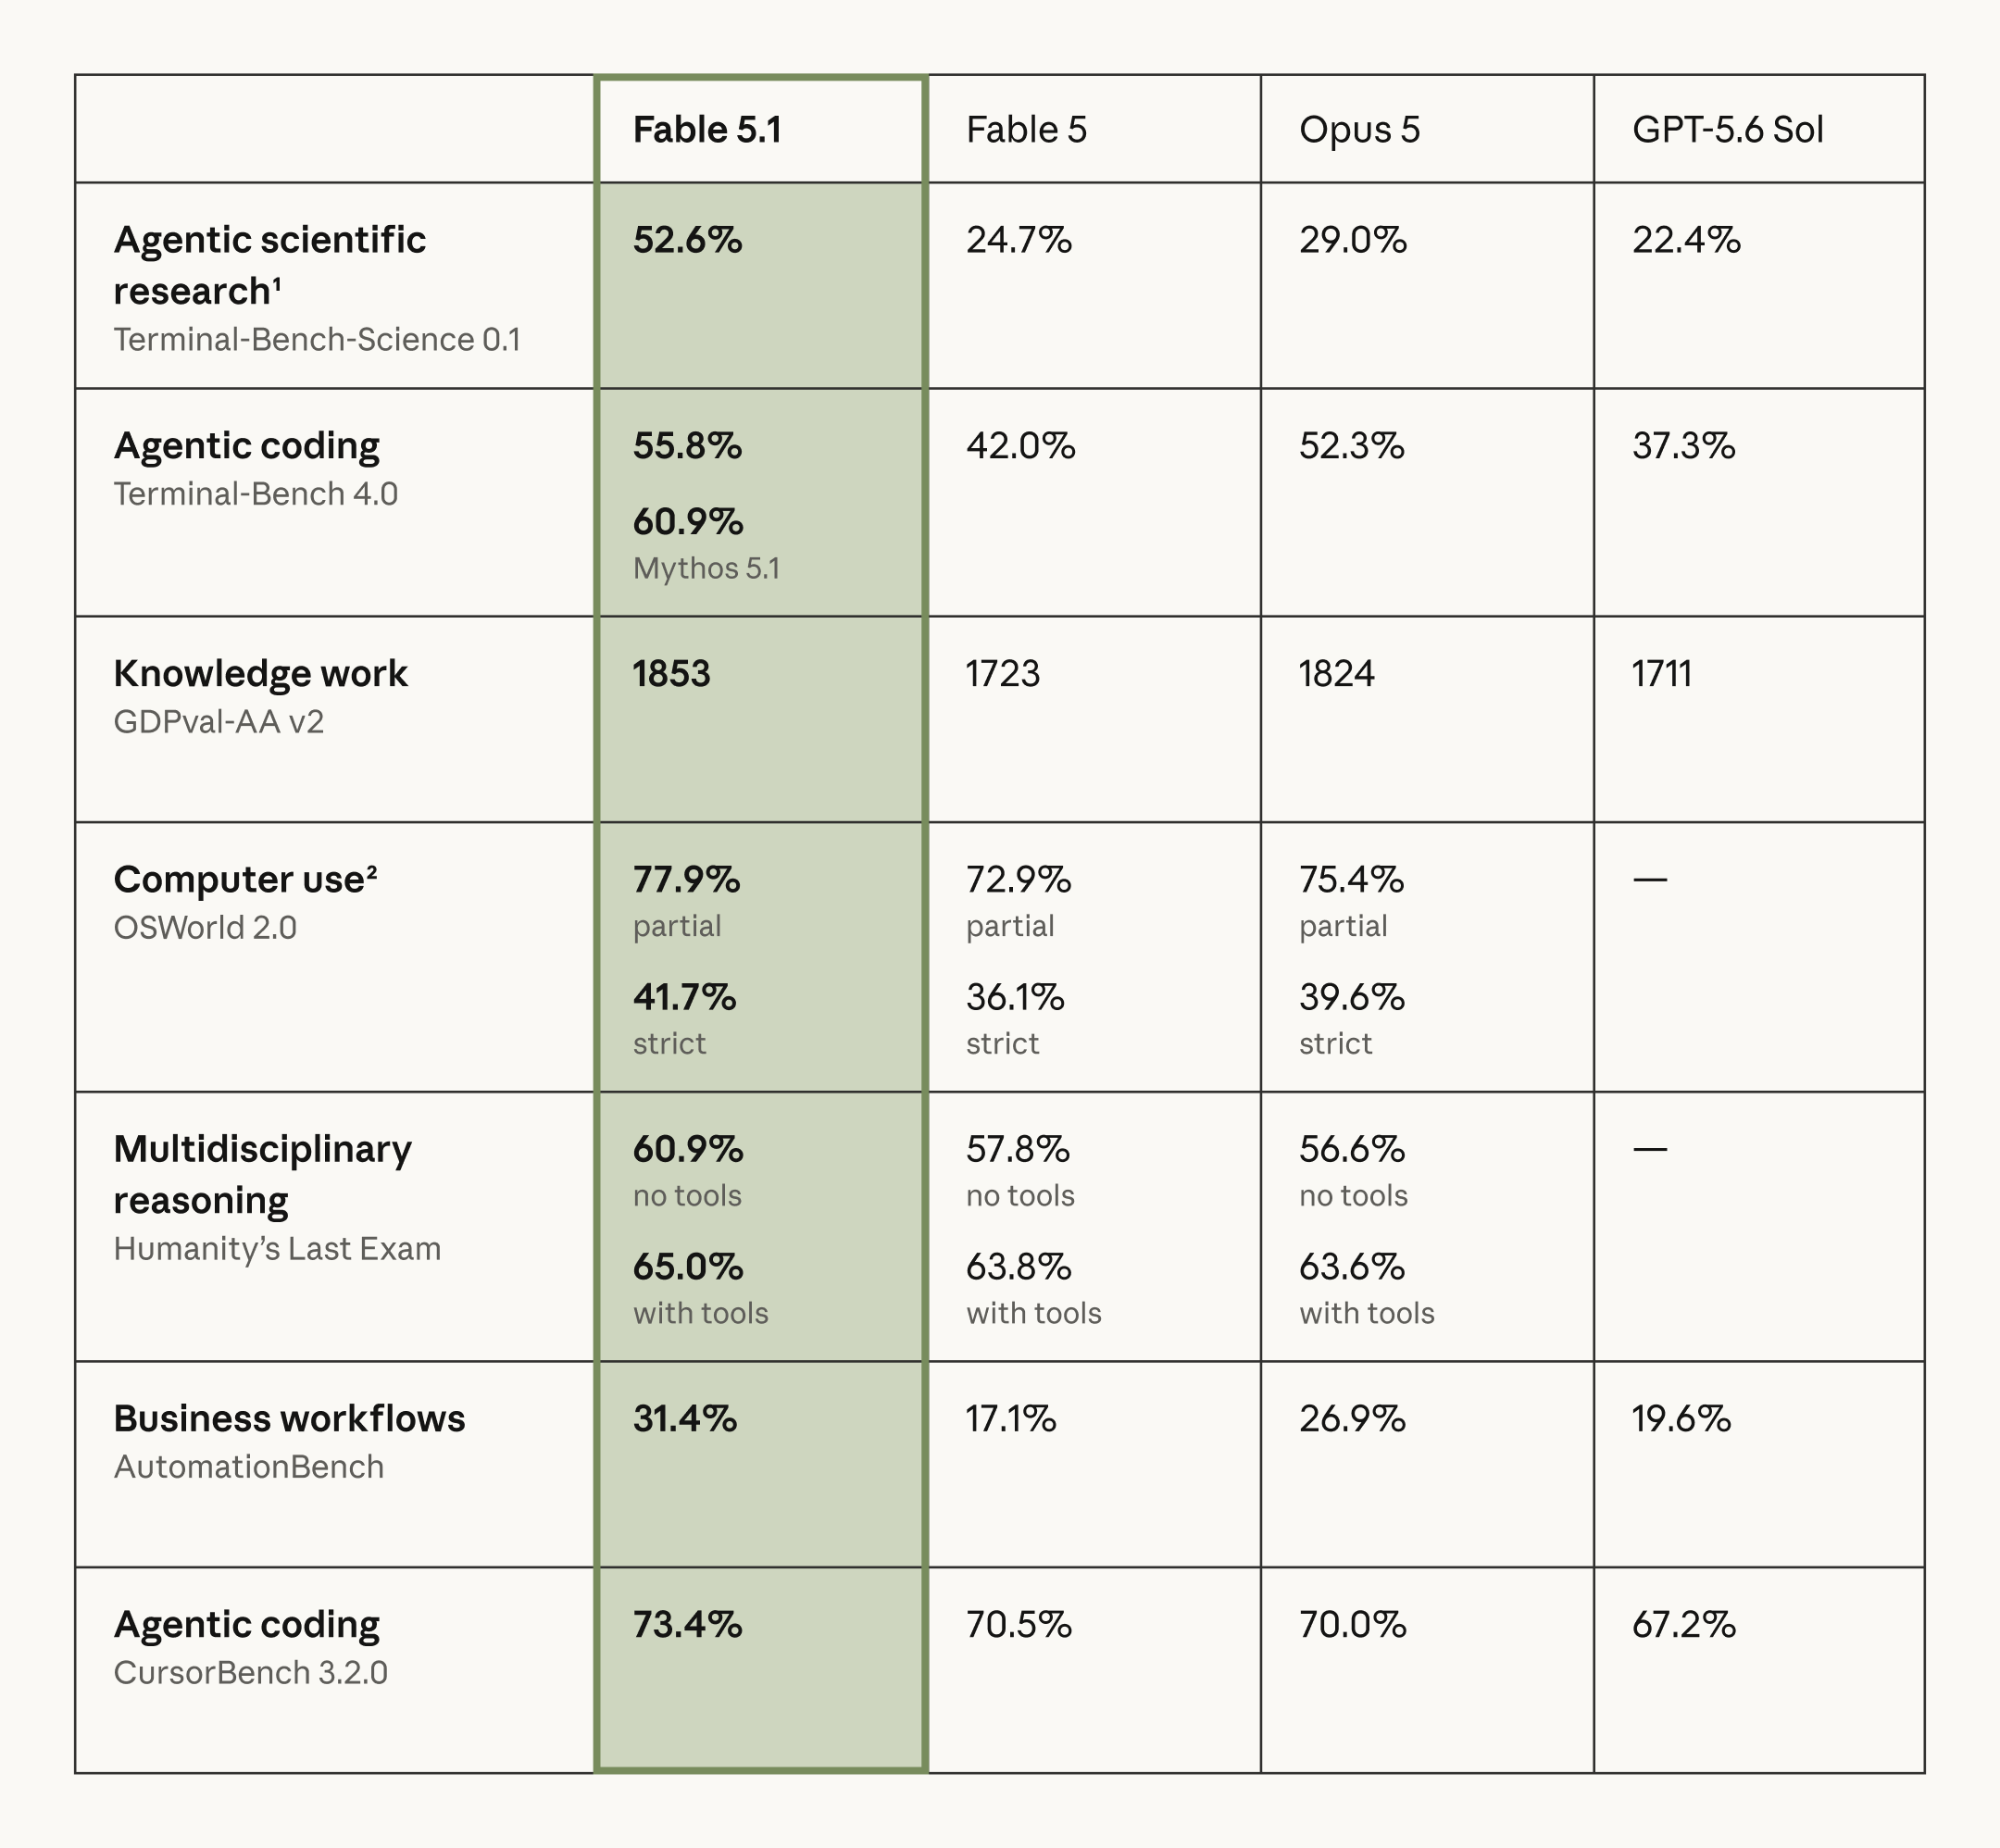
| Penanda aras | GPT-5.6 Sol | Claude Fable 5.1 | Mendahului Fable 5.1 |
|---|---|---|---|
| Terminal-Bench-Science 0.1 | 22.4% | 52.6% | +30.2 mata |
| Terminal-Bench 4.0 | 37.3% | 55.8% | +18.5 mata |
| GDPval-AA v2 | 1711 Elo | 1853 Elo | +142 Elo |
| AutomationBench | 19.6% | 31.4% | +11.8 mata |
| CursorBench 3.2.0 | 67.2% | 73.4% | +6.2 mata |
Keputusan ini luar biasa konsisten: Fable 5.1 mendahului GPT-5.6 Sol dalam setiap baris langsung yang diterbitkan Anthropic. Perbezaan terbesar muncul dalam penyelidikan saintifik berasaskan ejen dan pengkodan berasaskan terminal, bukan penaakulan bentuk pendek biasa.
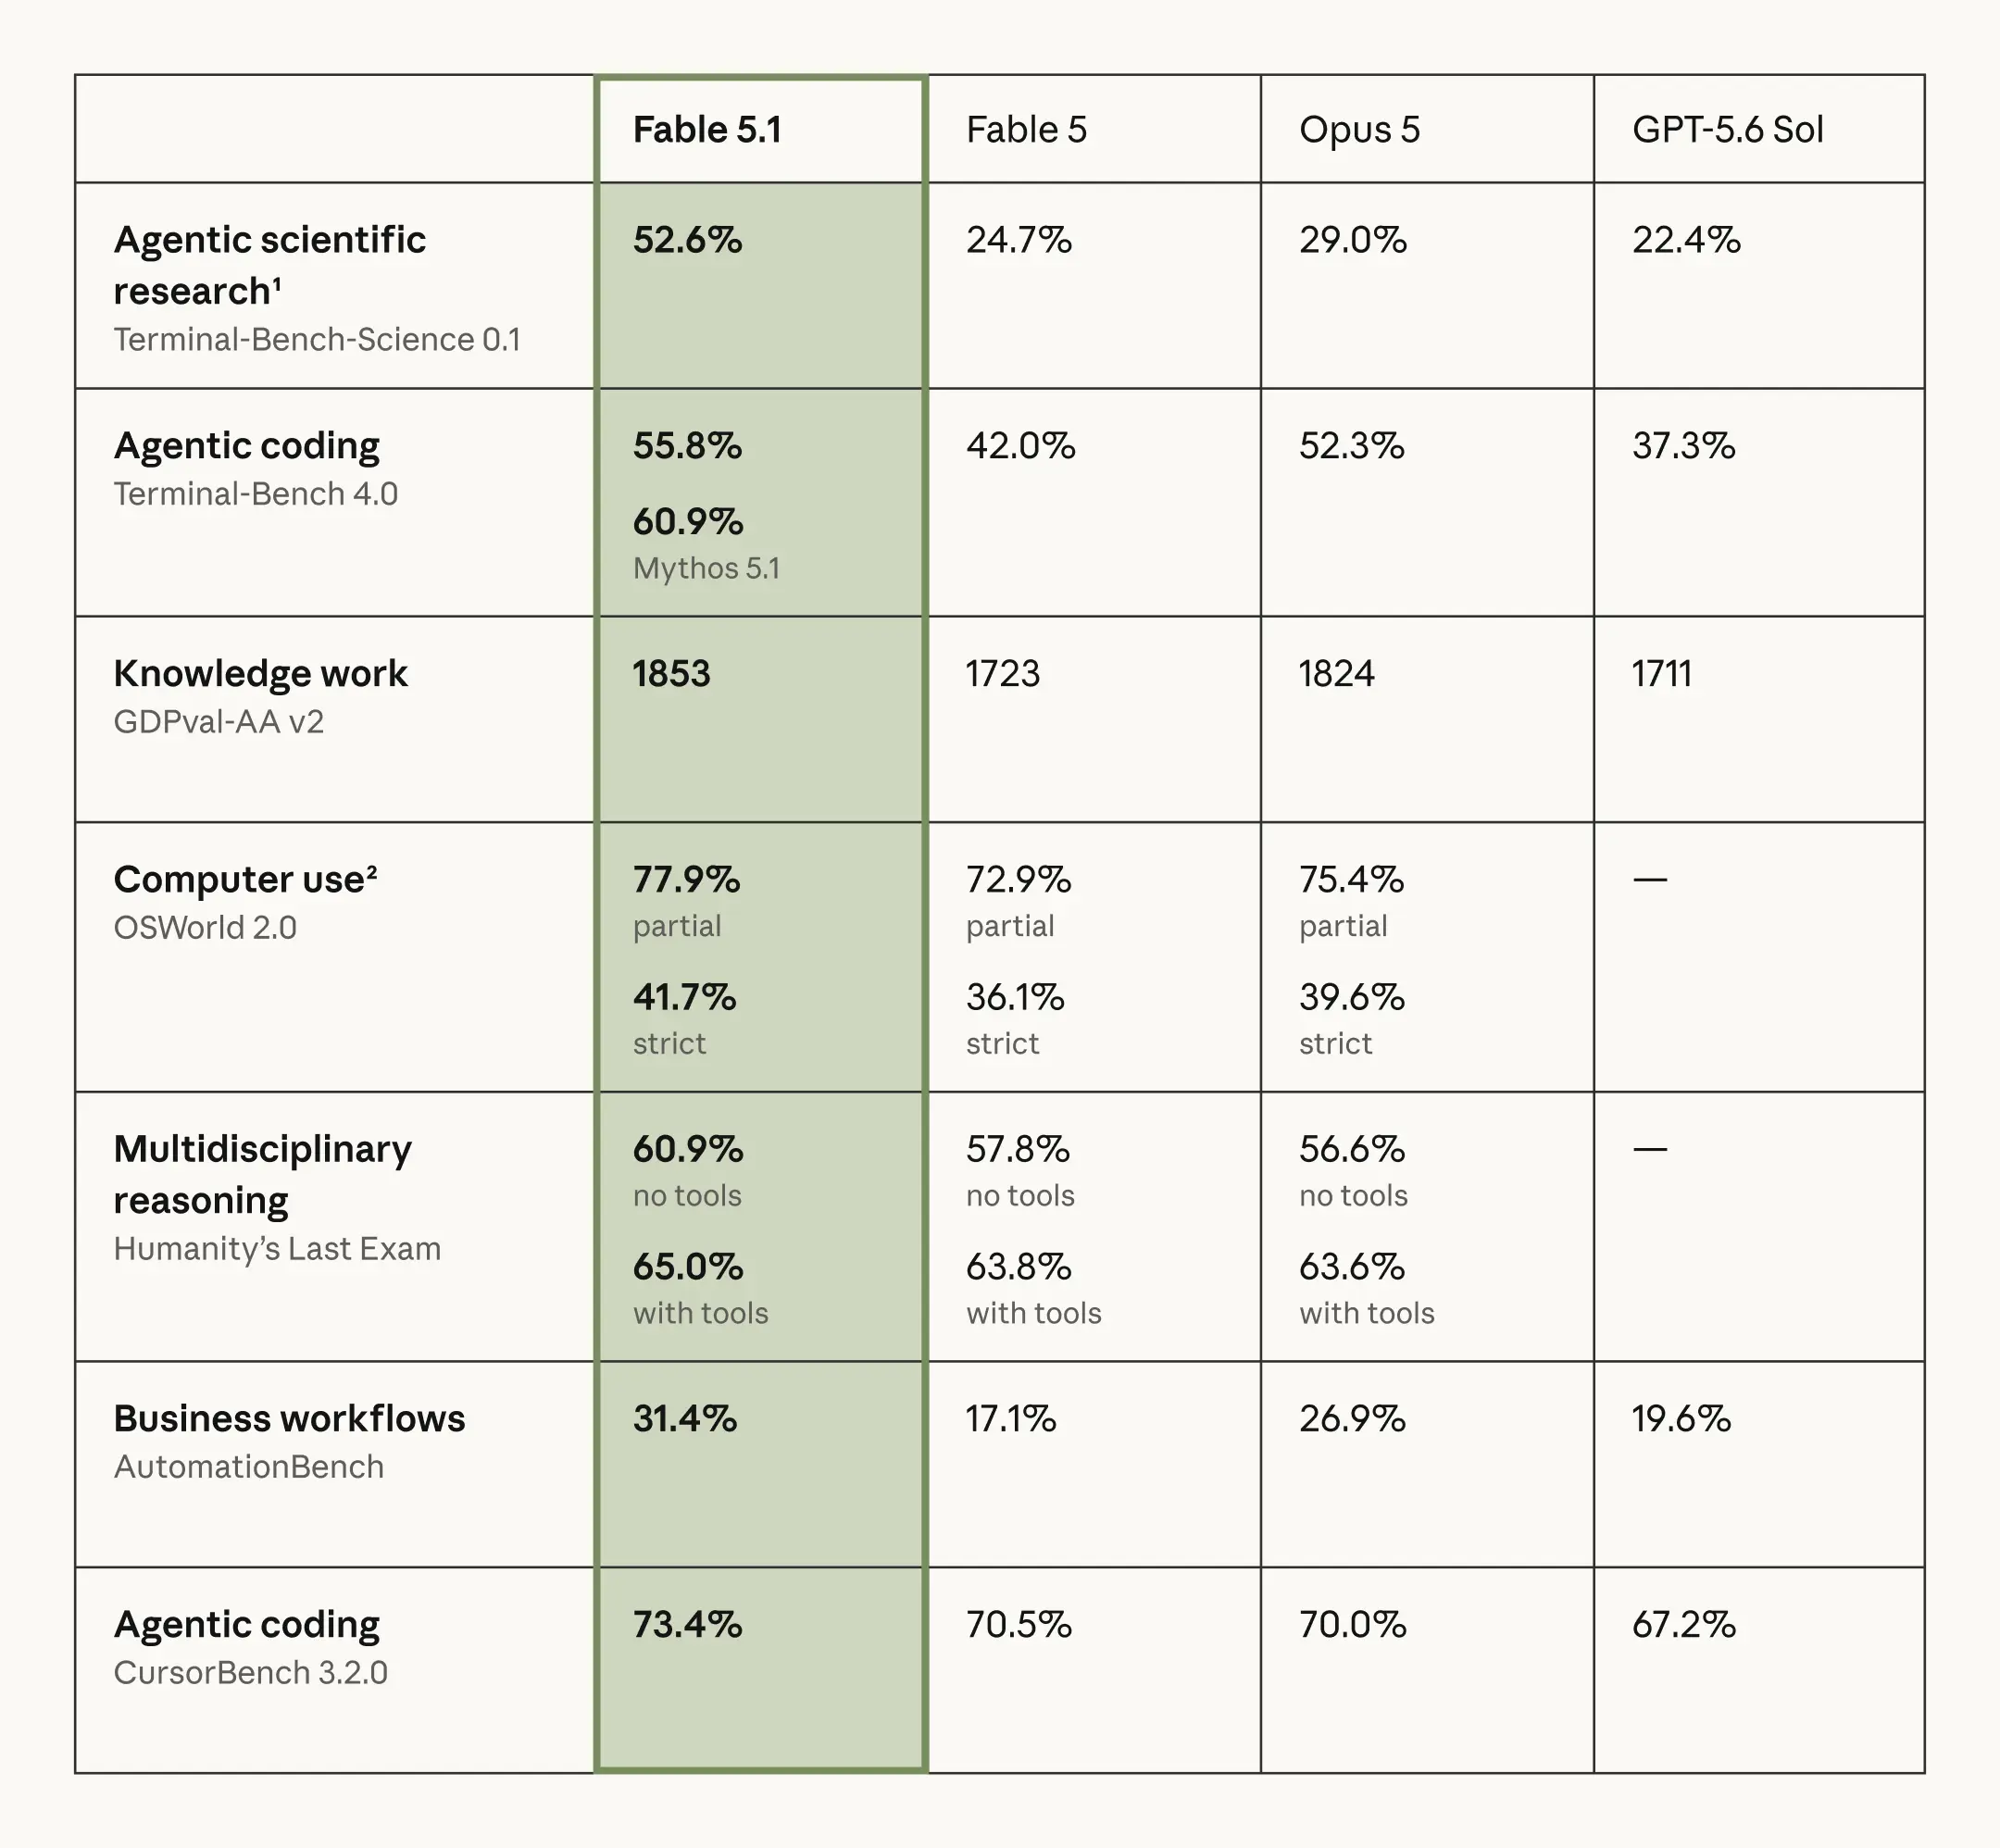
Sumber: Anthropic — grafik penanda aras asal.
Ini ialah penilaian yang dijalankan vendor: Anthropic menguji modelnya sendiri dan model pesaing. Ia memberikan bukti perbandingan langsung, tetapi ia bukan ujian bebas. Anthropic melaporkan ralat piawai ±3.5–4.5 mata peratus bagi setiap model pada Terminal-Bench-Science; jadual di atas menunjukkan anggaran titik, bukan selang keyakinan.
Keputusan vendor memihak kepada Fable 5.1, tetapi bukti bebas memerlukan tarikh dan konfigurasi tersendiri.
Penanda aras bebas: pisahkan keputusan bertarikh daripada pengukuran langsung
Artificial Analysis memperkenalkan Intelligence Index v4.3 pada 7 September, menggantikan Terminal-Bench 2.1 dengan Terminal-Bench 4.0 dan menambah AutomationBench-AA. Keluaran itu melaporkan 53 untuk Fable 5.1 dan 47 untuk GPT-5.6 Sol, sepadan dengan skor dibundarkan yang ditunjukkan dalam perbandingan 8 September. Jadual membezakan keputusan terminal keluaran tersebut daripada snapshot prestasi kemudian.
| Perbandingan metrik AA bebas / keluaran v4.3 | GPT-5.6 Sol (maks) | Claude Fable 5.1 (maks) | Keputusan |
|---|---|---|---|
| Intelligence Index v4.3 (Sep 8) | 47 | 53 | Fable |
| Terminal-Bench 4.0 (Sep 7 release) | 39.9% | 52.0% | Fable |
| OSWorld 2.0 | 62.6% | 41.7% | |
| Kelajuan output (Sep 8) | 69.8 tok/s | 69.9 tok/s | Pada dasarnya seri |
| Masa ke token pertama (Sep 8) | 132.10 s | 277.47 s | Sol |
| Harga campuran token ternormal AA / MTok | $3.08 | $7.175 | Sol |
Snapshot: 8 September 2026, kecuali baris Terminal-Bench 7 September yang dinyatakan dengan jelas. Fable 5.1 menggunakan Adaptive Reasoning, Max Effort, Default Fallback; Sol menggunakan maks. Pengukuran langsung boleh berubah. Harga campuran token ternormal AA menggunakan nisbah 7:2:1 cache-hit/input/output; ia bukan kos setiap permintaan API.
OSWorld 2.0 ialah kelebihan terbesar yang dilaporkan untuk Sol dalam perbandingan ini: 62.6% berbanding 41.7% untuk Fable 5.1, mendahului 20.9 mata. Ini mengimbangi keputusan Fable yang lebih kuat pada Intelligence Index dan Terminal-Bench.
Bukti menyokong pertukaran khusus: Fable 5.1 mempunyai Intelligence Index yang lebih tinggi, manakala Sol mempunyai masa ke token pertama yang lebih rendah dan harga ternormal lebih rendah. Kadar keluaran pada dasarnya seri. Pengukuran ini menyokong pilihan berbeza untuk kerja kelompok sensitif kualiti dan aplikasi interaktif.
Perbandingan Terminal-Bench bebas yang bertarikh menunjukkan arah yang sama seperti ujian Anthropic: 52.0% berbanding 39.9%, berbanding 55.8% berbanding 37.3% milik vendor. Kedua-dua jurang tidak boleh ditukar ganti kerana persediaan penilaian berbeza.
Apa yang penanda aras OpenAI masih memberitahu tentang GPT-5.6 Sol
Penilaian pelancaran OpenAI memberikan konteks tambahan untuk keupayaan GPT-5.6 Sol. Ia mendahului keputusan head-to-head yang lebih baharu yang dibincangkan di atas, jadi ia tidak boleh digunakan sebagai perbandingan langsung dengan Fable 5.1.
OpenAI melaporkan 88.8% pada Terminal-Bench 2.1 untuk GPT-5.6 Sol. Itu ialah bukti keupayaan pengkodan berasaskan ejen yang kukuh di bawah persediaan pelancaran; versi penanda aras yang lebih lama tidak harus dibandingkan secara berangka dengan skor Terminal-Bench 4.0.
GPT-5.6 Sol vs Fable 5.1 untuk pengkodan
Untuk penjanaan kod yang lurus, kedua-dua model adalah terlebih layak untuk banyak beban kerja produksi. Pemisahan menjadi lebih jelas apabila pengkodan berubah menjadi kejuruteraan perisian berasaskan ejen: memeriksa repositori besar, mengedit berbilang fail, menjalankan arahan, mendiagnosis kegagalan, menulis ujian, dan beriterasi sehingga tugas lulus.
Di sini, Claude Fable 5.1 mempunyai kes penanda aras semasa yang lebih kuat. Ia mendahului kedua-dua perbandingan Terminal-Bench 4.0 yang dijalankan vendor dan bebas, dan keputusan CursorBench Anthropic juga memihak kepadanya 73.4% berbanding 67.2%.
Untuk penilaian pengkodan praktikal, sertakan perubahan seluruh repositori, ujian, semakan, dan kerja prestasi. Coretan kod pendek yang berjaya ialah proksi yang lemah untuk menyiapkan tugas yang merentasi beberapa fail dan percubaan yang gagal.
GPT-5.6 Sol kekal menarik apabila persekitaran pelaksanaan sekeliling sama pentingnya dengan kualiti model mentah. Sokongan natif untuk pelaksanaan shell, apply-patch, juru tafsir kod, carian fail, penggunaan komputer dan MCP boleh mengurangkan jumlah infrastruktur orkestrasi yang perlu anda bina sendiri.
Keputusan pengkodan: pilih Fable 5.1 apabila penilaian anda menekankan kerja repositori autonomi paling sukar. Pilih GPT-5.6 Sol apabila keupayaan penanda aras yang sedikit lebih rendah boleh diterima sebagai pertukaran untuk kos yang lebih rendah dan timbunan pelaksanaan bersepadu yang luas.
Kawalan penaakulan dan pengalaman pembangun
Kedua-dua API mendedahkan kecerdasan secara berbeza.
Julat usaha none-to-max Sol membolehkan pasukan menguji kualiti dan kelewatan pada beberapa tetapan. Usaha lebih rendah boleh mengurangkan kerja penaakulan, tetapi tetapan yang betul bergantung pada kos kegagalan tugas.
Pemikiran adaptif sentiasa aktif Fable menjadikan penalaan usaha satu latihan yang berbeza. Bandingkan tetapan yang akan digunakan oleh aplikasi anda dan bukannya menganggap label usaha yang sama sebagai bajet kiraan yang serupa.
Akibatnya tiada perbandingan yang sejagat adil antara “Sol lalai” dan “Fable lalai.” Konfigurasi penaakulan lalai mereka berbeza. Penilaian produksi harus membandingkan sama ada bajet usaha yang setara atau tetapan tepat yang akan benar-benar digunakan oleh aplikasi anda.
GPT-5.6 Sol vs Fable 5.1: Mana yang lebih baik untuk ejen AI?
Pilihan bergantung pada sama ada kekangan ialah penaakulan yang sukar atau runtime yang mengelilinginya.
Kelebihan Fable dalam penanda aras terminal, automasi, dan kerja profesional yang dipetik menjadikannya calon munasabah untuk tugas paling sukar. Ukur kadar penyelesaian dan pemulihan daripada langkah gagal sebelum mengeneralisasikan kelebihan itu kepada ejen anda.
Portfolio alat Responses yang didokumenkan GPT-5.6 Sol menjadikannya menarik untuk aplikasi yang dibina sekitar carian, fail, pelaksanaan shell, dan patch. Itu ialah kelebihan integrasi untuk dinilai bersama ketepatan tugas, bukan penggantinya.
| Keperluan ejen | GPT-5.6 Sol | Claude Fable 5.1 |
|---|---|---|
| Penaakulan jangka panjang yang sukar | Cemerlang | Padanan terbaik |
| Autonomi terminal/repositori | Cemerlang | Bukti lebih kukuh |
| Portfolio alat bersepadu natif | Lebih kuat | Kuat |
| Pemilihan alat paksa | Disokong; semak API yang dipilih | Terhad; semak mod tool_choice |
| Integrasi platform multi-ejen | Kelebihan kuat | Tersedia melalui seni bina ejen |
| Komunikasi kemajuan semasa kerja panjang | Baik | Tingkah laku teras |
| Ejen volum tinggi sensitif kos | Lebih baik | Premium |
| Konteks besar ter-cache berulang | Baik | Berpotensi sangat menarik |
Menggunakan kedua-duanya boleh menjimatkan apabila hanya sebahagian kecil tugas memerlukan penskalaan. Ukur sama ada kejayaan tambahan mengimbangi harga dan kelewatan permulaan model kedua yang lebih tinggi.
Konteks panjang: 1.05M vs 1M bukan perbezaan penting
Nombor utama kelihatan hampir sama: GPT-5.6 Sol menawarkan 1.05M token dan Fable menawarkan 1M. Perbezaan kapasiti 5% tidak mungkin menentukan sama ada anda boleh menganalisis repositori besar, korpus undang-undang, arkib penyelidikan, atau sejarah ejen berjam-jam. Kedua-duanya sudah dalam kelas sejuta token.
Untuk GPT-5.6 Sol, input melebihi 272K mencetuskan kadar konteks panjang yang lebih tinggi bagi permintaan: $8/MTok input, $0.80/MTok input ter-cache, dan $30/MTok output. Penulisan cache juga meningkat daripada $5 kepada $10/MTok.
Fable 5.1 mengekalkan kadar konteks 1M standard: $10/MTok input, $50/MTok output, dan $0.25/MTok bacaan cache. Tiada premium berasingan di atas 272K dalam konfigurasi yang didokumenkan ini.
Pertimbangkan satu pusingan dengan 100K token input tidak ter-cache, 900K token bacaan cache, dan 20K jumlah token output dibil. Kos GPT-5.6 Sol ialah 0.1 × $8 + 0.9 × $0.80 + 0.02 × $30 = $2.12. Kos Fable 5.1 ialah 0.1 × $10 + 0.9 × $0.25 + 0.02 × $50 = $2.225.
Pusingan berat cache ini hampir menutup jurang harga kerana bacaan cache Fable lebih murah. Keputusan bergantung pada campuran token beban kerja; ini tidak bermakna kedua-dua model berharga sama untuk sesi ejen penuh.
Andaian kos: awalan 900K token sudah ter-cache, dan 100K input baharu tidak dibil sebagai penulisan cache baharu. Anggaran mengecualikan penulisan cache awal dan yuran alat. Elaun output 20K termasuk semua output dibil, termasuk sebarang token penaakulan yang dibil.
Harga: Sol menang untuk beban kerja biasa, Fable menang pada satu metrik cache penting
Pada kadar yang disemak, Sol berharga $4 input / $20 output per MTok, dengan bacaan cache $0.40. Fable 5.1 berharga $10 input, $50 output, dan $0.25 bacaan cache. Jadual memisahkan harga penyedia daripada kadar GPT-5.6 Sol API dalam CometAPI dan Claude Fable 5.1 API dalam CometAPI.
| Komponen harga | Harga rasmi GPT-5.6 Sol | Harga rasmi Claude Fable 5.1 |
|---|---|---|
| Harga input rasmi / MTok | $4.00 | $10.00 |
| Harga output rasmi / MTok | $20.00 | $50.00 |
| Bacaan cache rasmi / MTok | $0.40 | $0.25 |
| Penulisan cache rasmi / MTok | $5.00 (30 minit) | $12.50 (5 minit) |
| Di atas 272K input: input / bacaan cache / penulisan cache / output | $8 / $0.80 / $10 / $30 | Kadar asas didokumenkan yang sama |
| CometAPI input / MTok | $3.20 | $8.00 |
| CometAPI output / MTok | $16.00 | $40.00 |
Tempoh penulisan cache berbeza: Sol menggunakan tempoh pengekalan lalai 30 minit, manakala kadar Fable 5.1 yang ditunjukkan adalah untuk penulisan 5 minit. Semak penciptaan, penyegaran, dan tingkah laku luput cache untuk penyedia dan laluan yang anda gunakan.
Pada kadar penyedia langsung yang disemak, Fable 5.1 berharga 2.5× ganda Sol untuk input tidak ter-cache ($10 vs $4/MTok) dan output ($50 vs $20/MTok). Anggap kadar yang disemak ini sebagai perbandingan bertarikh, kerana promosi penyedia dan harga gateway boleh berubah.
Permintaan konteks pendek dengan 100K input dan 10K jumlah output dibil berharga kira-kira $0.60 dengan Sol atau $1.50 dengan Fable pada kadar penyedia langsung. Pada kadar CometAPI yang ditunjukkan di atas, campuran yang sama berharga $0.48 atau $1.20. Contoh ini mengecualikan penulisan cache dan yuran alat.
Kadar bacaan cache konteks pendek Fable adalah 37.5% lebih rendah: ($0.40 − $0.25) ÷ $0.40. Itu boleh penting untuk ejen yang menggunakan semula awalan besar yang stabil, tetapi penjimatan keseluruhan masih bergantung pada input baharu, kekerapan penulisan, dan volum output.
Keputusan harga: Sol ialah titik permulaan yang lebih murah untuk trafik konteks segar. Fable menjadi lebih kompetitif apabila bahagian bacaan cache bertambah; bandingkan kos sesi penuh, termasuk penciptaan dan penyegaran cache.
Kelajuan dan kependaman
Ujian usaha maksimum boleh membelanjakan masa yang besar untuk penaakulan sebelum token pertama yang kelihatan.
Pengukuran kadar keluaran dan kependaman pada 8 September menunjukkan 69.9 token output/s untuk Fable dan 69.8 untuk Sol. Masa ke token pertama ialah 277.47 saat berbanding 132.10 saat. Kadar keluaran pada asasnya sama; Sol mula menghasilkan output yang kelihatan lebih awal dalam konfigurasi ini.
Ini ialah pengukuran penanda aras usaha maksimum, bukan kependaman yang dijanjikan untuk setiap panggilan API. Panjang prompt, konfigurasi penaakulan, beban penyedia, alat, dan keadaan cache boleh mengubah hasilnya. Masa ke token pertama dan masa respons penuh ialah metrik yang berbeza.
Untuk kerja interaktif, kelewatan permulaan yang diperhatikan lebih rendah boleh memihak kepada Sol. Untuk penyelidikan tak segerak atau kerja repositori semalaman, penyelesaian yang berjaya boleh lebih penting daripada menunggu token pertama. Nilai kedua-dua model pada tetapan dan ke serentakan yang anda ingin gunakan.
Perlindungan ialah perbezaan dalam produksi
Kedua-dua model menggunakan perlindungan yang lebih kuat kerana keupayaan mereka meluas ke domain keselamatan siber dan saintifik yang sensitif, tetapi mereka melaksanakannya secara berbeza.
OpenAI menerangkan perlindungan berlapis dan pemantauan untuk keluarga GPT-5.6. Aplikasi dalam domain sensitif harus menilai perlindungan yang berkaitan sebagai sebahagian daripada tingkah laku pelaksanaan mereka.
Terma pengalihan dan pengekalan Anthropic menerangkan pengalihan beberapa permintaan keselamatan siber atau biologi sensitif kepada model yang kurang berkeupayaan, tanpa mengenakan kadar Fable untuk permintaan yang dialihkan. Tempoh pengekalan data lalai ialah 30 hari, dengan pengecualian untuk pengaturan perusahaan yang layak.
Untuk pengkodan biasa dan kerja pengetahuan, perbezaan ini mungkin tidak muncul. Untuk produk keselamatan, beban kerja terkawal atau pelaksanaan sensitif privasi, perbezaan ini perlu dalam senarai semak penilaian bersama kualiti penanda aras dan harga.
Model manakah yang patut anda pilih?
Perbandingan keseluruhan boleh diringkaskan kepada bentuk beban kerja.
| Beban kerja | GPT-5.6 Sol | Claude Fable 5.1 | Cadangan |
|---|---|---|---|
| Pengkodan autonomi sukar | Cemerlang | Bukti semasa lebih kukuh | Fable 5.1 |
| Penyelidikan jangka panjang | Cemerlang | Kekuatan teras | Fable 5.1 |
| API barisan hadapan volum tinggi | Jauh lebih murah | Mahal | Sol |
| Pembantu pengkodan interaktif | TTFT usaha maksimum diukur lebih rendah | TTFT usaha maksimum diukur lebih tinggi | Uji tetapan dikerahkan |
| Ejen API berat alat | Timabunan alat natif lebih luas | Kuat | Sol |
| Ejen cache sejuta token | Kompetitif | Harga bacaan cache sangat rendah | Uji kedua-duanya |
| Kualiti penaakulan maksimum | Cemerlang | Mendahului secara bebas | Fable 5.1 |
| Kos per permintaan biasa | Kelebihan jelas | Premium | Sol |
| Penaakulan imej/dokumen | Kuat | Kuat | Uji pada beban kerja |
| Tumpukan OpenAI penyedia tunggal | Padanan semula jadi | Memerlukan migrasi/gateway | Sol |
| Penghalaan bebas model | Kuat | Kuat | Guna kedua-duanya melalui CometAPI |
Dasar penghalaan harus sepadan dengan kerumitannya. Bandingkan garis dasar model tunggal dengan dasar Sol-dahulu yang menskalakan tugas sukar kepada Fable 5.1, dan kekalkan penghala hanya jika ia memperbaiki kos per tugas berjaya pada kualiti yang diperlukan.
Cara membandingkan GPT-5.6 Sol dan Fable 5.1 melalui CometAPI
CometAPI sudah mengintegrasikan GPT-5.6 Sol dan Claude Fable 5.1. Akses kedua-dua model dengan format permintaan natif masing-masing, hantar set penilaian yang sama, dan bandingkan hasil yang dipulangkan di bawah tetapan yang sepadan.
Gunakan permintaan format natif untuk setiap model dan kekalkan prompt, set data, tetapan usaha, ke serentakan, dan peraturan pemarkahan secara tetap. Ulangi larian; satu permintaan berurutan per model tidak mencukupi untuk menganggar kependaman atau kualiti yang boleh dipercayai.
Untuk penilaian produksi, gunakan set prompt tetap, ulang larian secara berselang-seli, rekod tetapan usaha, dan skor ketepatan, kadar lulus ujian, kejayaan alat, percubaan semula, penggunaan token, masa berlalu, dan jumlah kos per tugas berjaya. Talaan setiap model secara berasingan selepas garis dasar umum.
Keputusan akhir: GPT-5.6 Sol atau Claude Fable 5.1?
Fable 5.1 mempunyai bukti langsung yang lebih kuat untuk pengkodan autonomi paling sukar dan kerja jangka panjang. Ia mendahului lima baris penanda aras vendor yang dikongsi dan perbandingan terminal bebas yang bertarikh. Itu menjadikannya calon penskalaan yang kukuh, tertakluk kepada pengesahan pada tugas anda sendiri.
Sol mempunyai harga token biasa yang lebih rendah, kawalan penaakulan yang lebih halus, dan timbunan alat natif yang luas. Dalam konfigurasi usaha maksimum bebas yang disemak, ia juga mempunyai masa ke token pertama yang lebih rendah; kadar keluaran pada dasarnya seri.
Utamakan Fable 5.1 apabila tugas autonomi paling sukar menentukan kadar kejayaan anda. Mulakan dengan Sol untuk inferens barisan hadapan yang peka kos atau aplikasi berat alat. Untuk beban kerja interaktif, uji tetapan usaha yang dikerahkan untuk mengesahkan sama ada kelebihan kelewatan permulaan yang diperhatikan itu kekal.
Pilih satu model apabila ia memenuhi keperluan anda dengan mudah. Tambah penghalaan apabila keputusan penilaian menunjukkan bahawa bertukar antara kedua-duanya meningkatkan kualiti atau kos per tugas berjaya.
Soalan Lazim
Adakah Claude Fable 5.1 lebih baik daripada GPT-5.6 Sol?
Ia mempunyai Intelligence Index bebas yang lebih tinggi dalam snapshot 8 September: 53, berbanding 47 untuk Sol. Ia juga mendahului ujian terminal bebas yang bertarikh. Itu menyokong kelebihan kualiti pada penilaian ini, bukan dakwaan bahawa ia lebih baik untuk setiap beban kerja.
Adakah GPT-5.6 Sol lebih murah daripada Claude Fable 5.1?
Untuk trafik API tidak ter-cache biasa, ya: kadar penyedia langsung yang disemak ialah $4/$20 per MTok untuk Sol dan $10/$50 untuk Fable 5.1. Beban kerja berat cache boleh mengecilkan jurang itu kerana kadar bacaan cache Fable lebih rendah. Sertakan tingkah laku penulisan dan luput dalam anggaran.
Model manakah yang lebih baik untuk pengkodan?
Fable 5.1 mempunyai bukti penanda aras pengkodan autonomi yang lebih kukuh dalam perbandingan ini. Sol kekal menarik untuk aliran kerja kos lebih rendah dan alat pelaksanaan bersepadu. Gunakan tugas repositori dengan ujian boleh dijalankan untuk memutuskan sama ada jurang keupayaan terukur itu penting untuk aplikasi anda.
Model manakah mempunyai tetingkap konteks lebih besar?
Sol secara teknikal mendahului pada 1.05M berbanding 1M token Fable 5.1, manakala kedua-duanya membenarkan sehingga 128K output. Dalam praktiknya, ambang harga >272K Sol dan bacaan cache murah Fable biasanya lebih penting daripada perbezaan kapasiti 50K token.
Bolehkah saya mengakses kedua-dua model melalui CometAPI?
Ya. GPT-5.6 Sol API dalam CometAPI dan Claude Fable 5.1 API dalam CometAPI menyokong titik permulaan bersama untuk penilaian teks. Semak sokongan penaakulan, cache, dan alat khusus laluan sebelum memperluas garis dasar kepada ejen produksi.