Spesifikasi Teknikal GLM-5.3-Flash
| Spesifikasi | GLM-5.3-Flash |
|---|---|
| Penyedia | Z.ai (Zhipu AI) |
| Keluarga model | GLM-5 |
| Jenis model | Model Campuran Pakar (Mixture-of-Experts) multimodal secara natif |
| Jumlah parameter | 320B |
| Parameter aktif | 18B |
| Seni bina | Perhatian hibrid jarang + linear |
| Tetingkap konteks | 1,048,576 token (1M) |
| Output maksimum | 131,072 token |
| Modaliti input | Teks, imej, video |
| Modaliti output | Teks |
| Penaakulan | Disokong |
| Visi | Disokong |
| Panggilan fungsi | Disokong |
| Penggunaan alat | Disokong |
| Carian web | Disokong melalui integrasi API yang disokong |
| Berat terbuka | Ya |
| Lesen | MIT |
| Keluaran | 26 Ogos 2026 |
Z.ai menerangkan GLM-5.3-Flash sebagai model pertama yang multimodal secara natif dalam keluarga GLM-5. Ia mengandungi 320B jumlah parameter tetapi hanya mengaktifkan 18B parameter bagi setiap langkah inferens. Model ini memperkenalkan seni bina hibrid yang menggabungkan perhatian jarang dan linear serta menggunakan mHC untuk meningkatkan kecekapan penskalaan.
Apakah GLM-5.3-Flash?
GLM-5.3-Flash ialah ahli berorientasikan kecekapan dalam generasi GLM-5, direka untuk menggabungkan keupayaan penaakulan tahap terdepan dan pengekodan beragen dengan kos inferens yang jauh lebih rendah.
Perbezaan terpentingnya daripada model "Flash" konvensional ialah bahawa Flash tidak bermaksud model kecil. GLM-5.3-Flash mengandungi 320B jumlah parameter, tetapi seni bina MoE mengaktifkan hanya 18B parameter bagi setiap token. Ini membolehkan Z.ai menyasarkan pengiraan inferens yang jauh lebih rendah sambil mengekalkan kumpulan parameter yang besar untuk kapasiti model.
Ia juga merupakan model GLM-5 pertama dengan keupayaan multimodal natif. Model ini menyokong input visual selain teks dan diposisikan untuk pengekodan, interaksi pelayar, pemahaman dokumen, pengekodan visual dan aliran kerja beragen.
Z.ai menyatakan GLM-5.3-Flash dilatih daripada model asas yang baru dilatih dan bukannya versi termampat ringkas GLM-5.2. Latihannya menggunakan korpus pra-latihan multimodal 30 trilion token, manakala seni bina direka semula berasaskan keupayaan dan kecekapan inferens.
Ciri Utama GLM-5.3-Flash
- MoE 320B dengan 18B parameter aktif: GLM-5.3-Flash menggabungkan kapasiti jumlah parameter yang sangat besar dengan jejak parameter aktif yang agak kecil, menjadikan model jauh lebih cekap untuk disediakan berbanding model padat 320B.
- Pemahaman multimodal natif: Tidak seperti model GLM-5 terdahulu, GLM-5.3-Flash memproses input visual secara natif. Kad modelnya menyediakan contoh pemahaman imej dan mengenal pasti model sebagai multimodal.
- Konteks 1M token: Model ini direka untuk aplikasi konteks panjang melibatkan repositori besar, dokumen meluas, trajektori agen panjang dan aliran kerja berbilang langkah yang kompleks. Cloudflare dan Vercel kedua-duanya menyenaraikan tetingkap konteks 1,048,576 token.
- Perhatian hibrid jarang + linear: GLM-5.3-Flash ialah model GLM pertama yang menggabungkan perhatian jarang dan perhatian linear. Z.ai mengatakan seni bina ini mengurangkan kos penyajian konteks panjang sambil mengekalkan keupayaan konteks panjang yang tepat.
- Pengekodan beragen dan penggunaan alat: Model ini dioptimumkan untuk kejuruteraan perisian, tugas terminal, interaksi pelayar dan aliran kerja dipacu alat. Skor Terminal-Bench 2.1 yang dilaporkan ialah 84.3.
- Penyebaran berat terbuka: Berat berlesen MIT boleh digunakan dengan Transformers, vLLM, SGLang, TokenSpeed dan KTransformers, memberikan pembangun pilihan untuk hos sendiri dan pengoptimuman inferens.
Prestasi Penanda Aras GLM-5.3-Flash
GLM-5.3-Flash mempunyai profil yang sangat kukuh pada penanda aras pengekodan dan beragen.
| Penanda Aras | GLM-5.3-Flash | GLM-5.2 | Nota |
|---|---|---|---|
| Terminal-Bench 2.1 | 84.3 | 81.0 | Terminal / pengekodan beragen |
| DeepSWE v1.1 | 63.4 | 46.2 | Kejuruteraan perisian |
| AutomationBench | 48.8 | 26.2 | Automasi penggunaan komputer |
| Toolathlon-Verified | 78.4 | 59.9 | Keupayaan penggunaan alat |
| NL2Repo-Bench | 56.3 | 48.9 | Pengekodan bahasa-ke-repositori |
| Agent's Last Exam | 26.3 | 20.4 | Penaakulan beragen |
| Humanity's Last Exam | 55.3 | — | Dengan alat |
| GDPval-AA v2 | 1773 Elo | 1504 Elo | Produktiviti / kerja pengetahuan |
| OfficeQA-Pro | 62.4 | — | Produktiviti multimodal |
| CharXiv RQ | 89.4 | — | Penaakulan multimodal |
Bahagian penilaian rasmi Hugging Face menyenaraikan 84.3 pada Terminal-Bench 2.1, 63.4 pada DeepSWE dan 55.3 pada HLE. Bahan pelancaran Z.ai melaporkan keputusan tambahan termasuk AutomationBench, Toolathlon, NL2Repo dan GDPval.
Artificial Analysis bebas pada masa ini memberikan GLM-5.3-Flash Indeks Kecerdasan 57, meletakkannya di tempat #3 dalam set perbandingan semasa yang merangkumi 108 model.
Angka-angka ini perlu ditafsir dengan peringatan khusus penanda aras: beberapa keputusan dilaporkan vendor, rangka kerja penilaian berbeza, dan skor penanda aras tidak harus dianggap sebagai kedudukan universal kualiti model.
GLM-5.3-Flash vs GLM-5.3 vs GLM-5.2
| Ciri | GLM-5.3-Flash | GLM-5.3 | GLM-5.2 |
|---|---|---|---|
| Generasi model | GLM-5 | GLM-5 | GLM-5 |
| Pemposisian | Model multimodal / beragen yang cekap | Model penaakulan umum bertahap tinggi | Model generasi terdahulu yang umum |
| Visi natif | Ya | Tidak | Bergantung pada model |
| Jumlah parameter | 320B | Konfigurasi flagship lebih besar | Model berskala besar |
| Parameter aktif | 18B | — | — |
| Konteks | 1M | Kelas 200K dalam penyebaran | Kelas 200K dalam penyebaran |
| Perhatian hibrid jarang/linear | Ya | Tidak | Tidak |
| Pengekodan beragen | Cemerlang | Cemerlang | Kukuh |
| Berat terbuka | Ya | Bergantung pada penyebaran | Bergantung pada penyebaran |
| Kelebihan utama | Keupayaan per unit pengiraan inferens | Keupayaan penaakulan maksimum GLM-5 | Generasi GLM yang matang dan lebih rendah kos |
Perbezaan utama ialah GLM-5.3-Flash bukan sekadar GLM-5.3 pada saiz lebih kecil. Z.ai menyatakan ia bermula daripada model asas yang baru dilatih dan memperkenalkan seni bina perhatian hibrid yang direka semula, mHC dan pra-latihan multimodal.
GLM-5.3-Flash vs DeepSeek V4 Flash — Ringkasan Perbandingan
| Dimensi | GLM-5.3-Flash (Z.ai / Zhipu) | DeepSeek V4 Flash (DeepSeek) | Kelebihan |
|---|---|---|---|
| Tarikh Keluaran | 26 Ogos 2026 | Pratonton April 2026; titik semak utama (0731) 31 Julai 2026 | — |
| Jumlah / Parameter Aktif | 320B / 18B | 284B / 13B | GLM sedikit lebih besar |
| Tetingkap Konteks | 1M token | 1M token | Seri |
| Output Maksimum | ~131K token | Sehingga 384K token | DeepSeek |
| Modaliti | Multimodal natif (input teks + imej + video) | Utamanya teks (varian visi eksperimen tersedia) | GLM |
| Sorotan Seni Bina | Perhatian jarang termampat + linear (~3× pengiraan perhatian lebih rendah, ~4.4× cache KV lebih kecil berbanding GLM-5.3 penuh) | Compressed Sparse Attention (CSA) + Heavily Compressed Attention (HCA) | Masing-masing ada kekuatan |
| Lesen | MIT (berat di Hugging Face) | MIT (berat tersedia) | Seri |
| Harga API Standard ($ / 1M token) | Input $0.15 / Output $0.50 (input cache ~$0.03) | Julat biasa $0.14–$0.44 input / $0.28–$1.32 output (puncak/luar puncak berbeza) | GLM lebih murah |
| Harga Promosi Pelancaran | ~$0.075 input / $0.25 output (masa terhad, ~awal Sep 2026) | Tiada promosi setara | GLM |
| Indeks Kecerdasan AA | 57 (dilaporkan vendor) | ~50 (pengukuran bebas) | GLM |
| Terminal-Bench 2.1 | 84.3 | 82.7 | GLM |
| DeepSWE | 63.4 | 54.4 | GLM |
| SWE-bench Verified | Data bebas terhad setakat ini | ~79% (keputusan bebas yang kukuh) | DeepSeek |
| Kekuatan Utama | Harga lebih rendah, multimodal natif, mendahului beberapa skor beragen/pengekodan, konteks panjang cekap | Pengesahan bebas lebih matang, rekod cemerlang untuk agen pengekodan, reka bentuk konteks panjang sangat cekap, ekosistem kukuh | — |
| Kelemahan Utama | Keluaran lebih baharu (sebahagian skor masih dilaporkan vendor); kelajuan purata | Sokongan multimodal lebih lemah; harga efektif lebih tinggi pada banyak laluan | — |
| Terbaik Untuk | Penggunaan umum, beban kerja multimodal, projek sensitif kos, keupayaan agen seimbang | Agen pengekodan tulen, penaakulan teks konteks panjang, senario yang memerlukan penanda aras bebas yang terbukti | — |
Ringkasan satu ayat:
Sehingga akhir Ogos 2026, GLM-5.3-Flash kini mendahului dari segi harga, keupayaan multimodal, dan beberapa penanda aras bertindih, menawarkan nilai keseluruhan yang lebih baik. DeepSeek V4 Flash kekal sebagai pilihan yang sangat boleh dipercayai untuk agen berfokuskan pengekodan berkat pengesahan bebas yang lebih kukuh dan kecekapan konteks panjang. Uji kedua-duanya pada beban kerja spesifik anda sebelum membuat keputusan.
Kegunaan GLM-5.3-Flash
1. Kejuruteraan perisian beragen
GLM-5.3-Flash sangat sesuai untuk agen pengekodan yang perlu memeriksa repositori, mengubah suai berbilang fail, menjalankan arahan terminal, menjalankan ujian dan beriterasi pada pelaksanaan.
Skor Terminal-Bench 2.1 sebanyak 84.3 dan keputusan DeepSWE 63.4 menunjukkan bahawa kejuruteraan perisian merupakan salah satu bidang aplikasi terkuatnya.
2. Pengekodan visual
Memandangkan GLM-5.3-Flash adalah multimodal natif, pembangun boleh menyediakan tangkapan skrin, rajah dan input visual lain bersama arahan pengekodan. Ini berguna untuk pelaksanaan UI, nyahpepijat visual dan aliran kerja reka bentuk-ke-kod.
3. Analisis dokumen konteks panjang
Tetingkap konteks 1M token menjadikan model ini sesuai untuk set dokumentasi teknikal yang besar, repositori, laporan panjang dan sejarah agen berbilang peringkat.
4. Agen pelayar dan penggunaan komputer
Keupayaan penggunaan alat dan multimodal model menjadikannya sesuai untuk aliran kerja melibatkan pelayar, antara muka grafik dan alat luaran.
5. Kerja pengetahuan perusahaan
GLM-5.3-Flash boleh memproses sejumlah besar maklumat berstruktur dan tidak berstruktur sambil menggunakan alat untuk melaksanakan tugas berbilang langkah, menjadikannya sesuai untuk analisis dokumen, bantuan penyelidikan dan automasi aliran kerja.
6. Infrastruktur AI hos sendiri
Lesen MIT dan berat yang tersedia secara umum menjadikan GLM-5.3-Flash menarik bagi organisasi yang memerlukan kawalan ke atas penyebaran, pemprosesan data dan infrastruktur inferens.
Parameter API GLM-5.3-Flash
| Parameter | Penerangan |
|---|---|
| model | Pengecam model khusus penyedia |
| messages | Input perbualan berstruktur |
| prompt | Input prompt tunggal pada API yang disokong |
| max_tokens / max_completion_tokens | Had token output |
| temperature | Mengawal keacakkan pensampelan |
| tools | Takrif alat/fungsi |
| stream | Membolehkan output penstriman |
| reasoning | Mengawal usaha penaakulan pada gateway yang disokong |
| Image content | Disokong |
| Function calling | Disokong |
| Context | Sehingga 1M token |
Vercel AI Gateway pada masa ini mendokumenkan maksimum 131,000 token output, dengan token penaakulan dikira dalam had output.
Cara Menggunakan API GLM-5.3-Flash dalam CometAPI
Langkah 1: Dapatkan Akses API
Log masuk ke CometAPI. Jika anda belum menjadi pengguna kami, sila daftar terlebih dahulu. Log masuk ke CometAPI console. Dapatkan kunci API akses. Klik “Add Token” pada token API di pusat peribadi, dapatkan kunci token: sk-xxxxx dan serahkan.
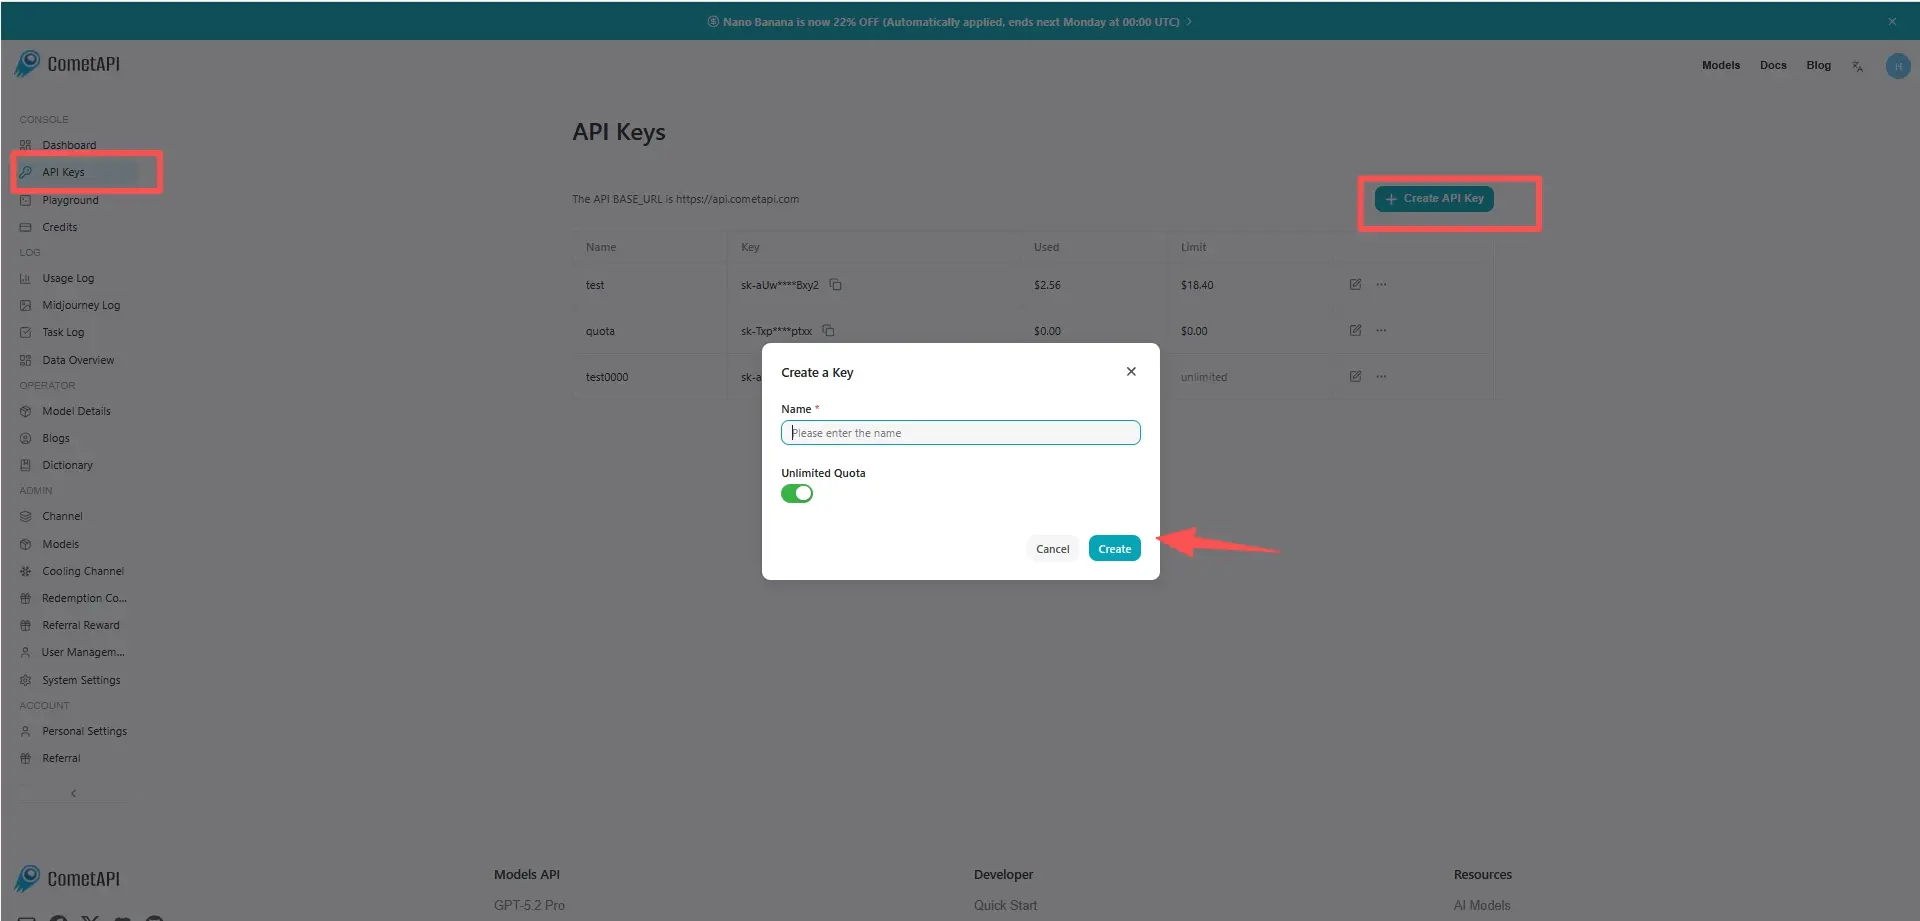
Langkah 2: Hantar Permintaan ke API GLM-5.3-Flash
Pilih titik akhir “GLM-5.3-Flash” untuk menghantar permintaan API dan tetapkan badan permintaan. Kaedah permintaan dan badan permintaan diperoleh daripada dok API laman web kami. Laman web kami juga menyediakan ujian Apifox untuk kemudahan anda. Gantikan <YOUR_API_KEY> dengan kunci CometAPI sebenar daripada akaun anda.
Masukkan soalan atau permintaan anda ke dalam medan kandungan—ini yang akan dijawab oleh model. Proses respons API untuk mendapatkan jawapan yang dijana.
Langkah 3: Proses Respons
API mengembalikan respons calon berstruktur termasuk teks yang dijana, sitaan, metadata keselamatan, dan output alat pilihan. Untuk permintaan multimodal, kandungan mesej boleh distrukturkan dengan input teks dan imej apabila titik akhir CometAPI yang dipilih mendedahkan keupayaan visi model.
Titik akhir CometAPI yang tepat, parameter yang disokong dan ketersediaan semasa harus diambil daripada dokumentasi API CometAPI langsung dan bukannya disimpulkan daripada API natif Z.ai.
Untuk CometAPI, integrasi harus menggunakan ID model yang ditunjukkan pada titik akhir model CometAPI langsung dan bukannya menyalin ID khusus penyedia secara automatik daripada Z.ai, Cloudflare atau Vercel.
Batasan GLM-5.3-Flash
- Jejak model besar: Walaupun hanya 18B parameter aktif, model yang dikeluarkan mengandungi kira-kira 321B parameter, menjadikan hos sendiri jauh lebih menuntut berbanding penyebaran model 7B–70B konvensional.
- Kelajuan inferens tidak semestinya “flash” secara mutlak: Artificial Analysis pada masa ini mengukur kira-kira 50 token output/saat dalam persekitaran perbandingannya, meletakkan model jauh di bawah model kecil terpantas.
- Konteks sangat panjang meningkatkan keperluan infrastruktur: Tetingkap konteks 1M token berguna tetapi boleh meningkatkan penggunaan memori dan kerumitan penyajian.
- Prestasi penanda aras berbeza mengikut tugas: GLM-5.3-Flash amat kuat dalam penanda aras pengekodan beragen dan penggunaan alat, tetapi tiada satu penanda aras pun menetapkan keunggulan universal ke atas model proprietari terdepan.
- Output multimodal terhad: Keupayaan multimodal natif model adalah terutamanya pada sisi input; output standardnya ialah teks dan bukannya imej atau video yang dijana.