
TL;DR
Muse Wonder, Claude Opus 5.5 dan GPT-6 Sol ialah model berkeupayaan tinggi yang disasarkan untuk pengkodan dan aliran kerja agen. Muse Wonder baharu daripada Meta menekankan memori berterusan dan pelaksanaan berpanjangan; Opus 5.5 mendahului indeks kecerdasan agregat yang dipetik; GPT-6 Sol mempunyai kadar input dan output konteks pendek standard terendah dalam perbandingan ini, manakala peringkat konteks panjangnya diberi harga berasingan. Buat pilihan berdasarkan kualiti tugasan perwakilan, kebolehpercayaan dan jumlah kos, bukan satu skor papan pendahulu.
Takeaway Utama
- Kecerdasan keseluruhan: Claude Opus 5.5 mencatat 58 berbanding 52 untuk Muse Wonder pada Intelligence Index v4.3 yang dilaporkan.
- Pengkodan jangka panjang: Muse Wonder memperoleh 78.8 pada DeepSWE 1.1 dan 53.1 pada SWE-Marathon; Opus 5.5 mencatat 74.2 dan 46.3 dalam jadual Meta.
- Penaakulan kos rendah: GPT-6 Sol bermula pada $2 input / $10 output per juta token melalui API standard konteks pendek OpenAI.
- Agen berfokus memori: Muse Wonder memperkenalkan Active Memory dan Active Focus.
- Ketersediaan penting: Muse Wonder Full ialah produk berasingan yang lebih terhad berbanding Muse Wonder standard yang boleh diakses oleh pembangun.
Muse Wonder vs Claude Opus 5.5 vs GPT-6 Sol secara Sepintas Lalu
Pilih Muse Wonder untuk agen berterusan dan kejuruteraan berjangka panjang, Claude Opus 5.5 untuk pengkodan meluas dan kerja berintensif terminal, dan GPT-6 Sol untuk kos token standard konteks pendek yang lebih rendah.
| Faktor keputusan | Muse Wonder | Claude Opus 5.5 | GPT-6 Sol |
|---|---|---|---|
| Mula menguji dengan | Agen berterusan dan kejuruteraan lanjutan | Pengkodan berintensif terminal dan aliran kerja profesional | Pengkodan dan automasi peka bajet |
| Tetingkap konteks | 1,048,576 tokens | 1M tokens | 1,050,000 tokens |
| Kekuatan diterbitkan | DeepSWE 78.8; SWE-Marathon 53.1 | Intelligence Index 58; ProgramBench 70.5 | Input/output standard $2/$10 per 1M tokens |
| Input / output standard per 1M tokens | $4 / $20 | $4 / $20 | $2 / $10; peringkat konteks pendek |
| Akses penyedia | Meta Model API; Full ialah produk langganan berasingan | Anthropic API | OpenAI API |
| Metrik pemilihan | Kualiti tugasan diterima dan jumlah kos | Kualiti tugasan diterima dan jumlah kos | Kualiti tugasan diterima dan jumlah kos |
| Pembangun | Meta | Anthropic | OpenAI |
| Keluaran | October 12, 2026 | September 22, 2026 | September 16, 2026 |
| Modaliti input | Teks, imej, audio, video; input PDF didokumenkan | Teks, imej | Teks, imej |
| Output | Teks | Teks | Teks |
| Keupayaan tersendiri | Active Memory dan Active Focus | Alat dan aliran kerja subagen | Usaha penaakulan boleh dikonfigurasi dan alat API |
Gambaran keseluruhan ini meringkaskan spesifikasi bertarikh dan keputusan diterbitkan yang diperiksa di bawah. Baris penanda aras menggunakan kaedah penilaian berbeza, dan kadar token rendah tidak membuktikan kos lebih rendah per tugasan berjaya. Muse Wonder standard dan Muse Wonder Full ialah pilihan akses yang berbeza.
Spesifikasi diperiksa pada October 13, 2026. Modaliti dan ciri yang disokong bergantung pada titik akhir dan permukaan keluaran yang dipilih, termasuk ketersediaan audio. Keupayaan pada peringkat model tidak menjamin sokongan pada setiap laluan gerbang.
Muse Wonder vs Claude Opus 5.5 vs GPT-6 Sol: Gambaran dan Spesifikasi
Muse Wonder: Aliran Kerja Agen Berterusan
Meta memperkenalkan Muse Wonder dan Muse Wonder Full pada October 12, 2026. Muse Wonder standard menekankan tugasan profesional berjangka panjang, memori agen berterusan, dan pemulihan daripada halangan. Active Memory bertujuan mengambil semula konteks terdahulu yang berguna, manakala Active Focus direka untuk mengekalkan kemajuan merentas kerja berbilang langkah. Meta menerangkan pengkodan, penyelidikan, analisis kewangan, dan bantuan peribadi sebagai senario utama.
Claude Opus 5.5: Pengkodan Profesional dan Penggunaan Alat
Claude Opus 5.5 menyasarkan pengkodan, penaakulan, dan aliran kerja profesional berbilang alat. Anthropic mengeluarkannya pada September 22, 2026. Tetingkap konteksnya ialah satu juta token, manakala keputusan pengkodan yang dilaporkan di bawah menunjukkan kekuatan yang berbeza mengikut penanda aras.
GPT-6 Sol: Penaakulan Peka Kos
GPT-6 Sol bertujuan menggabungkan penaakulan dan penggunaan alat yang kukuh dengan inferens yang relatif berpatutan. Ia menyokong aliran kerja berprogram melalui ekosistem API OpenAI. Kadar konteks pendek standardnya lebih rendah daripada kadar Claude Opus 5.5 yang disenaraikan, walaupun ekonomi hujung ke hujung juga bergantung pada cubaan semula dan penggunaan token penaakulan.
OpenAI menerangkan GPT-6 Sol sebagai model untuk pengkodan kompleks dan aliran kerja agen; pengumuman keluarannya menyediakan keputusan penilaian yang digunakan di bawah. Artikel ini membandingkan versi model yang dinyatakan, bukan setiap model terbaharu dalam barisan setiap vendor.
Seni Bina dan Kawalan Penaakulan
Sumber yang dipetik di sini tidak menyediakan pecahan kiraan parameter dan seni bina yang setara untuk ketiga-tiga model. Oleh itu tiada kedudukan padat berbanding mixture-of-experts yang wajar. Active Memory dan Active Focus menerangkan keupayaan agen Meta; ia bukan pengganti seni bina neural yang didedahkan. GPT-6 Sol mendedahkan usaha penaakulan boleh dikonfigurasi, manakala skor Meta dan Claude yang dilaporkan juga bergantung pada usaha dan tetapan penilaian. Anggap tetapan tersebut sebagai sebahagian daripada konfigurasi yang dibandingkan, bukan langkah compute yang boleh disaling ganti.
Keputusan perbandingan: Ketiga-tiganya menawarkan tetingkap konteks besar dan API pembangun. Muse Wonder mendokumenkan modaliti input pada peringkat model yang lebih luas; Opus 5.5 dan GPT-6 Sol menekankan aliran kerja teks dan imej. Kapasiti konteks dan ketersediaan ciri masih perlu diperiksa pada titik akhir yang dipilih.
Muse Wonder vs Claude Opus 5.5 vs GPT-6 Sol: Prestasi
Penanda Aras Diterbitkan dan Sempadan Sumber
Kad model rasmi Meta menawarkan perbandingan terus Muse Wonder berbanding Claude Opus 5.5. OpenAI menerbitkan keputusan GPT-6 Sol secara berasingan, jadi ketiga-tiga model tidak boleh diletakkan pada satu papan pendahulu terkawal sepenuhnya tanpa menyeragamkan harness penilaian, versi dan tetapan.
| Penanda aras | Muse Wonder | Claude Opus 5.5 | Skor lebih tinggi |
|---|---|---|---|
| Artificial Analysis Intelligence Index v4.3 | 52 | 58 | Opus |
| Personal Superintelligence Index | 54.3 | 55.2 | Opus |
| Harvey LAB-AA | 10.0 | 4.2 | Muse |
| Vals Finance Agent V2 | 56.6 | 58.6 | Opus |
| AutomationBench-AA | 39.1 | 41.2 | Opus |
| JobBench | 70.5 | 75.4 | Opus |
| MemoryBench | 85.6 | 81.5 | Muse |
| Terminal-Bench 4.0-AA | 52.0 | 59.6 | Opus |
| DeepSWE 1.1 | 78.8 | 74.2 | Muse |
| SWE-Marathon | 53.1 | 46.3 | Muse |
| ProgramBench | 50.0 | 70.5 | Opus |
| HealthBench Pro | 60.5 | 65.6 | Opus |
Metodologi kad model rasmi membezakan ujian dalaman, penilaian pihak ketiga, dan skor pesaing yang dilaporkan oleh penyedia. Jadual ini mengulang nilai yang dilaporkan; ia tidak mewujudkan percubaan terkawal seragam merentas semua baris.
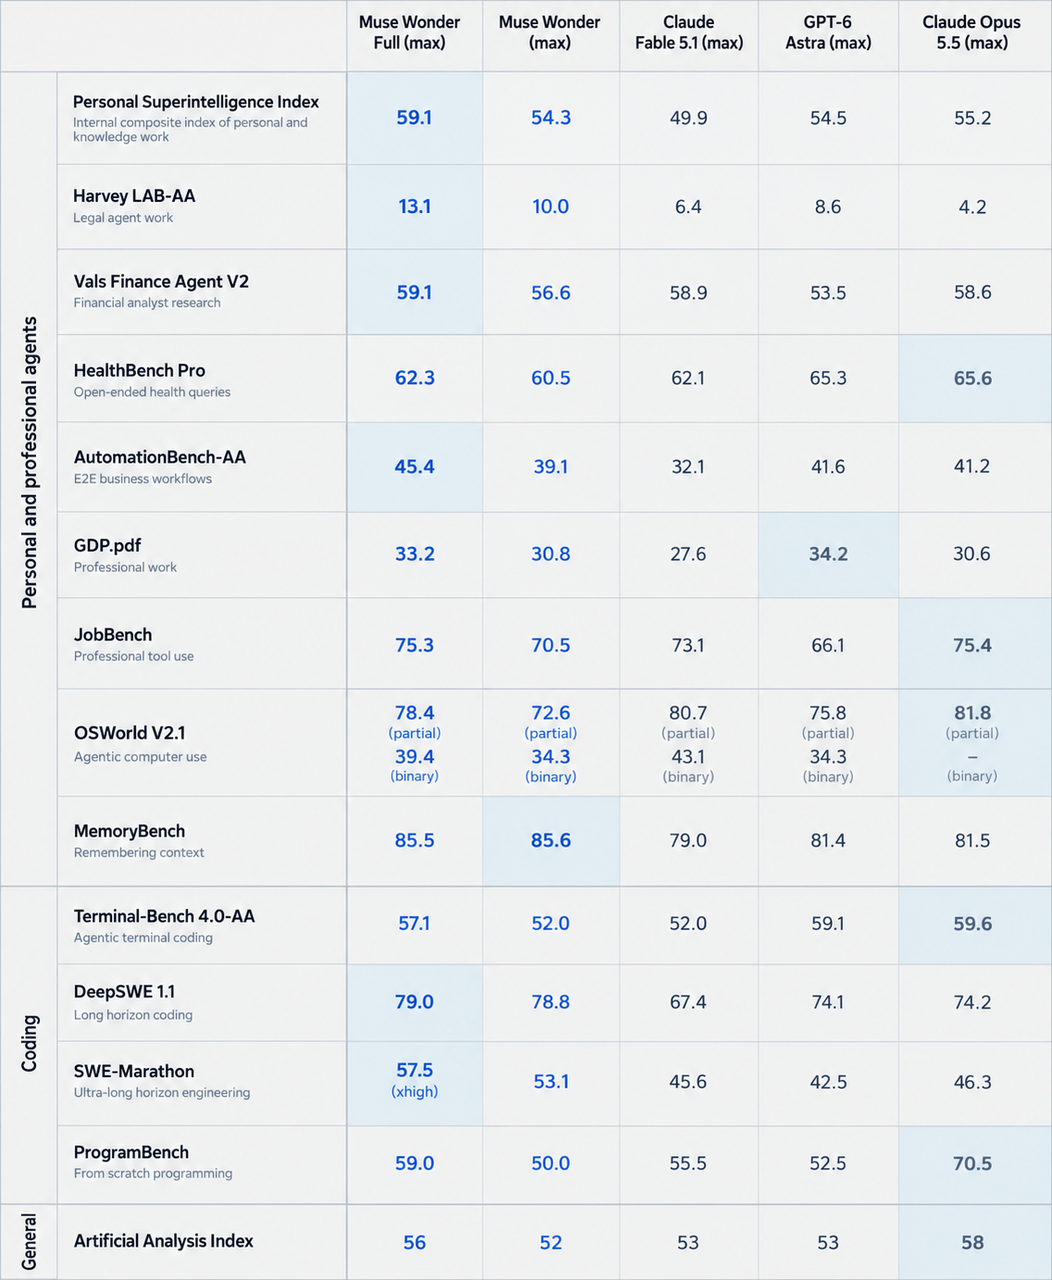
Kad skor penanda aras asal daripada kad model Muse Wonder Meta, diulang tanpa dilukis semula. Model OpenAI tambahan yang ditunjukkan dalam imej rasmi ini ialah GPT-6 Astra, bukan GPT-6 Sol. Jadual sekeliling mengenal pasti model yang relevan dengan artikel ini.
Keadaan Penilaian
DeepSWE v1.1 merangkumi 113 tugasan merentas 91 repositori dan lima bahasa, dinilai oleh ujian fungsian dan regresi menggunakan pass@1; kad skor Meta menggunakan keputusan Datacurve untuk Muse Wonder dan Opus 5.5. SWE-Marathon menggunakan ujian projek dan melaporkan pass@1 daripada Abundant AI; harness agen berbeza, dan skor Wonder Full ditanda xhigh. ProgramBench menggunakan mini-swe-agent dan mengukur rollout yang melepasi sekurang-kurangnya 95% ujian tersembunyi, dengan internet dilumpuhkan selepas penyediaan. Persekitaran dan metrik ini tidak boleh digabungkan menjadi satu skor ketepatan umum.
Pengkodan dan Kejuruteraan Perisian
Muse Wonder mendahului pada keputusan DeepSWE 1.1 dan SWE-Marathon yang dilaporkan. Claude Opus 5.5 mendahului pada Terminal-Bench 4.0-AA dan ProgramBench. Perpecahan ini menunjukkan bahawa kejuruteraan jangka panjang, penggunaan alat baris perintah, dan pembinaan semula program menguji kemahiran berbeza.
Keputusan GPT-6 Sol dan Kebolehbandingan Merentas Sumber
| Penilaian OpenAI yang diterbitkan | GPT-6 Sol | Tetapan dilaporkan |
|---|---|---|
| DeepSWE 1.1 | 68.8% | Penaakulan maksimum |
| AutomationBench 1.0.6 | 33.2% | Penaakulan xhigh |
| Agents' Last Exam V1 | 56.4% | Penaakulan maksimum |
| OSWorld 2.0 offline | 60.5% | Penaakulan xhigh |
Keputusan penilaian diterbitkan OpenAI melaporkan skor di atas. Keputusan OSWorldnya ialah ganjaran separa pada set offline v2026.08.08, bukannya kadar penyiapan tugasan yang ketat. OpenAI menyatakan bahawa penilaian menggunakan persekitaran penyelidikannya atau API; konfigurasi produksi boleh berbeza.
Skor DeepSWE yang dilaporkan membayangkan jurang 10.0 mata peratusan antara Muse Wonder dan GPT-6 Sol, dan jurang 5.4 mata antara Opus 5.5 dan GPT-6 Sol. Ini ialah perbezaan aritmetik antara penerbitan, bukan anggaran terkawal bagi kelebihan model semata-mata. Tetapan agen berbeza, arahan, tahap usaha, dan bajet alat boleh mempengaruhi keputusan.
Memori dan Agen Berjalan Lama
Muse Wonder menyasarkan agen yang mesti mengingati keputusan terdahulu, memulihkan konteks, dan meneruskan kerja yang terganggu. Active Memory boleh membantu pembantu penyelidikan mengingati fakta khusus projek, manakala Active Focus menyokong tindakan berulang apabila rancangan terdahulu tidak berjaya. Keupayaan produk ini tidak menggantikan pengesahan keadaan, keizinan, jejak audit atau pengesahan manusia mandatori untuk tindakan sensitif.
Prestasi Muse Wonder Full
Muse Wonder Full ialah pilihan produk berasingan. Meta menawarkan Muse Wonder standard melalui API, manakala Full terhad kepada langganan Power Usage dan Maximum Usage dalam Muse Code. Skor yang lebih tinggi tidak menjadikan Full pengganti API untuk model standard.
Keputusan Wonder Full yang dilaporkan Meta ialah 56 pada Intelligence Index, 59.1 pada Personal Superintelligence, 13.1 pada Harvey LAB-AA, dan 45.4 pada AutomationBench-AA. Ia juga mencatat 79.0 pada DeepSWE 1.1, 57.5 pada SWE-Marathon, 85.5 pada MemoryBench, dan 75.3 pada JobBench. Keputusan yang diterbitkan ini menerangkan produk Full yang diakses secara berasingan; ia bukan ukuran baharu daripada perbandingan harness umum.
Berbanding skor Muse Wonder standard di atas, Full bertambah baik pada tujuh daripada lapan ukuran yang dilaporkan ini; MemoryBench sedikit lebih rendah pada 85.5 berbanding 85.6. Opus 5.5 masih mendahului Intelligence Index yang dilaporkan pada 58.
Kelewatan dan Kebolehpercayaan
Bukti yang dipetik tidak menyediakan perbandingan kelewatan tiga model yang dipadankan. Ukur masa ke output berguna pertama, masa tugas hujung ke hujung median dan peratusil ke-95, kekerapan tamat masa, dan penyiapan tanpa campur tangan. Kekalkan input tugasan, keizinan alat, kebersamaan, dan kriteria penerimaan tetap; rekod tetapan usaha dan bajet cubaan semula. Penjanaan token yang lebih pantas sahaja tidak membuktikan penyiapan lebih pantas bagi tugasan berbilang langkah.
Keputusan perbandingan: Muse Wonder mendahului ujian kejuruteraan berterusan yang dipetik, manakala Opus 5.5 mendahului ujian terminal dan pembinaan semula program yang dipetik. GPT-6 Sol kekal sebagai calon dengan harga token lebih rendah, tetapi penerbitan yang tersedia tidak membuktikan kedudukan kualiti atau kelajuan dalam persekitaran setara merentas ketiga-tiganya.
Muse Wonder vs Claude Opus 5.5 vs GPT-6 Sol: Kos
Harga Token API Rasmi
| Harga per 1M tokens | Muse Wonder | Claude Opus 5.5 | GPT-6 Sol |
|---|---|---|---|
| Input standard | $4 | $4 | $2 |
| Output standard | $20 | $20 | $10 |
| Input cache | $0.20 | $0.20 | $0.20 |
| Input konteks panjang | $4 | $4 | $4 |
| Output konteks panjang | $20 | $20 | $15 |
| Input cache konteks panjang | $0.20 | $0.20 | $0.40 |
Meta menerbitkan $4 input, $20 output, dan $0.20 input cache per juta token. Anthropic menyenaraikan Opus 5.5 pada $4 input, $20 output, dan $0.20 kejayaan cache per juta token. Jadual harga OpenAI menyenaraikan GPT-6 Sol pada $2/$10 untuk input/output konteks pendek dan $4/$15 untuk konteks panjang; kadar input cache juga berbeza mengikut peringkat. Gunakan peringkat konteks setiap permintaan, mod pemprosesan, dan syarat titik akhir yang berkaitan sebelum menganggarkan beban kerja.
Untuk GPT-6 Sol, permintaan yang mengandungi lebih daripada 272,000 token input dibilkan pada kadar lebih tinggi:
- Token input: 2× kadar standard, meningkat daripada $2 kepada $4 per juta token.
- Token input cache: 2× kadar standard, meningkat daripada $0.20 kepada $0.40 per juta token.
- Token output: 1.5× kadar standard, meningkat daripada $10 kepada $15 per juta token.
Kadar lebih tinggi ini terpakai kepada seluruh permintaan, bukan hanya token yang melebihi 272,000. Oleh itu, permintaan dengan 272,001 token input memasuki peringkat harga konteks panjang untuk semua token input, input cache, dan outputnya.
Sebagai perbandingan, Muse Wonder dan Claude Opus 5.5 tidak mengenakan premium harga konteks panjang setara di bawah kadar API standard mereka.
Perbezaan ini amat penting untuk analisis dokumen besar, pengkodan seluruh repositori, dan agen AI berjalan lama, di mana kelebihan harga konteks pendek GPT-6 Sol mungkin mengecil apabila permintaan menjadi lebih besar.
Harga dan Syarat Pengebilan CometAPI
Pada masa ulasan, CometAPI menyenaraikan Opus 5.5 pada $3.20 input / $16 output dan GPT-6 Sol pada $1.60 input / $8 output per juta token. Ini ialah kadar bebas CometAPI dan tidak boleh dikelirukan dengan harga rasmi penyedia di atas. Sahkan laluan yang terpakai, peringkat konteks, dan syarat pengebilan akaun sebelum menganggarkan kos; harga dan syarat boleh berubah.
Kos per Tugasan Diterima
Kira kos per tugasan diterima sebagai jumlah perbelanjaan model dan alat yang dibilkan, termasuk cubaan semula dan penggantian yang dicaj, dibahagi dengan bilangan output yang memenuhi kriteria penerimaan yang ditetapkan. Rekodkan masa semakan manusia secara berasingan atau tukarkannya menggunakan kadar buruh yang jelas. Jejak permintaan gagal dan caj sebenar secara berdikari: kegagalan sahaja tidak membuktikan sama ada permintaan tersebut dibilkan.
Keputusan perbandingan: GPT-6 Sol mempunyai kadar input dan output konteks pendek standard terendah yang disenaraikan, manakala Muse Wonder dan Opus 5.5 berkongsi kadar asas yang sama. Kos sebenar per tugasan diterima bergantung pada laluan pengebilan yang dipilih, penggunaan cache, peringkat konteks, yuran alat, cubaan semula, dan usaha semakan.
Muse Wonder vs Claude Opus 5.5 vs GPT-6 Sol: Perbandingan dan Pemilihan
Pemilihan Berdasarkan Keupayaan dan Beban Kerja
- Untuk pengkodan meluas dan aliran kerja terminal, mulakan dengan Claude Opus 5.5 kerana ia mendahului Intelligence Index, Terminal-Bench, dan ProgramBench yang dipetik. Sahkan pada kerja pengubahsuaian kod, pelaksanaan alat, dan konsistensi peringkat program.
- Untuk projek kejuruteraan lanjutan, mulakan dengan Muse Wonder kerana keputusan DeepSWE dan SWE-Marathon yang dilaporkan lebih kukuh daripada Opus 5.5. Ukur penyiapan tugas, pemulihan daripada halangan, dan jumlah kos tugas.
- Untuk agen peribadi berterusan, mulakan dengan Muse Wonder kerana ia menawarkan Active Memory dan Active Focus dan mempunyai skor MemoryBench yang lebih tinggi daripada Opus 5.5. Uji ingatan, pembetulan, kesinambungan, dan pengasingan projek.
- Untuk aliran kerja alat berbilang langkah, nilai ketiga-tiga model. Muse menawarkan Active Focus, Opus menekankan orkestrasi alat, dan GPT-6 Sol menyokong alat Responses API. Bandingkan keseluruhan timbunan agen, termasuk keizinan alat, cubaan semula, dan pengendalian keadaan.
- Untuk dokumen profesional dan analisis, nilai Muse Wonder atau Claude Opus 5.5. Muse mempunyai kekuatan khusus, manakala Opus mempunyai indeks agregat yang lebih kukuh seperti dipetik. Gunakan dokumen perwakilan dan kriteria penerimaan khusus tugas.
- Untuk automasi volum tinggi dan peka kos, mulakan dengan GPT-6 Sol kerana ia mempunyai kadar input dan output standard konteks pendek terendah. Semak kos tugasan diterima, peringkat konteks, kelewatan, dan cubaan semula.
- Untuk pilihan tertinggi Meta, nilai Muse Wonder Full jika ia boleh diakses. Ia mempunyai skor yang lebih tinggi pada beberapa tugas khusus yang dilaporkan, tetapi ia berasingan daripada model API standard. Sahkan akses langganan dan kesesuaian sebelum menguji.
Pengkodan Profesional
Claude Opus 5.5 ialah lalai yang baik untuk pasukan yang memerlukan pembantu kejuruteraan luas, terutamanya apabila pelaksanaan alat, pengubahsuaian kod, dan konsistensi peringkat program penting. Kelebihannya pada Terminal-Bench dan ProgramBench yang dilaporkan mengukuhkan hujah ini, walaupun pasukan harus mengesahkan keseluruhan timbunan agen dan bukan hanya model.
Automasi Volum Tinggi
GPT-6 Sol menarik apabila permintaan banyak dan kepekaan kos adalah tinggi. Walaupun sedikit defisit kualiti boleh diterima untuk tugas berisiko rendah yang mudah diperiksa seperti draf dokumentasi, mengekstrak medan berstruktur, atau menerangkan kod. Untuk larian autonomi panjang, jejak kualiti, token, kelewatan, dan cubaan semula bersama-sama.
Senarai Semak Penilaian Pengeluaran
Penilaian pengeluaran harus menjejak enam metrik: ketepatan, diukur oleh jawapan diterima atau ujian lulus; kebolehpercayaan, diukur oleh tugas yang disiapkan tanpa penyelamatan manusia; kelewatan, diukur oleh tempoh tugas hujung ke hujung; penggunaan token, diukur oleh jumlah input dan output yang dibilkan; kecekapan agen, diukur oleh panggilan alat dan cubaan pembetulan; dan kos berkesan, dikira sebagai jumlah perbelanjaan dibahagi dengan tugas diterima.
Keputusan perbandingan: Senaraipendekkan Muse Wonder untuk tingkah laku agen berterusan dan tugas kejuruteraan lanjutan, Opus 5.5 untuk aliran kerja pengkodan luas dengan tuntutan terminal yang kuat, dan GPT-6 Sol apabila kos token menjadi kekangan utama. Naik taraf calon hanya selepas ia memenuhi ambang kualiti dan kebolehpercayaan khusus tugas.
Di Mana Anda Boleh Mengakses Muse Wonder, Claude Opus 5.5, dan GPT-6 Sol?
Akses Penyedia Rasmi
Gunakan Meta Model API untuk Muse Wonder standard, Anthropic API untuk Opus 5.5, atau OpenAI API untuk GPT-6 Sol. Muse Wonder Full tersedia melalui pelan langganan Muse Code yang dinyatakan dan bukannya pengganti masuk-guna untuk model API standard. Semak akses akaun, had penggunaan, dan ciri permintaan yang disokong bagi laluan yang anda pilih.
Akses CometAPI
Gerbang bersatu boleh memudahkan pengesahan, pengebilan, dan perutean. Gunakan model berprestasi tinggi untuk semakan seni bina kompleks dan model lebih murah untuk draf berulang berisiko rendah. Pengecam model dan format permintaan yang disokong harus sentiasa diperiksa terhadap titik akhir API sasaran.
Pembangun boleh mengakses API Claude Opus 5.5 di CometAPI dan API GPT-6 Sol di CometAPI untuk menilai beban kerja perwakilan. Sahkan permukaan API yang disokong untuk setiap model dan jangan anggap gerbang yang dikongsi menjadikan semua format permintaan boleh saling gantikan.
Laluan CometAPI yang dipetik dalam artikel ini meliputi Opus 5.5 dan GPT-6 Sol. Artikel ini tidak mewujudkan laluan CometAPI untuk Muse Wonder atau Wonder Full; gunakan laluan penyedia yang disahkan apabila menilai produk tersebut.
Kesimpulan
Tiada satu model yang menang merentas setiap beban kerja. Muse Wonder ialah calon terkuat untuk diuji bagi tingkah laku agen berterusan dan tugas kejuruteraan berjangka panjang. Claude Opus 5.5 ialah calon kukuh untuk pengkodan meluas, aliran kerja berintensif terminal, dan kerja pengetahuan, dan ia mendahului nilai Artificial Analysis Intelligence Index yang dilaporkan oleh Meta. GPT-6 Sol menawarkan harga token standard konteks pendek terendah dan menarik untuk automasi peka kos. Pasukan produksi harus membuat pilihan akhir menggunakan kualiti tugasan diterima, kebolehpercayaan, kelewatan, cubaan semula, penggunaan alat, dan jumlah kos pada beban kerja perwakilan.
Soalan Lazim
Bagaimanakah pasukan boleh menguji Muse Wonder, Opus 5.5, dan GPT-6 Sol secara adil?
Gunakan set tugas sebenar yang dipegang keluar dengan kriteria penerimaan tetap, artifak input seragam, dan keizinan alat yang didokumenkan. Rekod setiap versi model, tetapan usaha, harness agen, tamat masa, dan bajet token. Jalankan percubaan berulang apabila output bervariasi, laporkan kegagalan serta kejayaan, dan asingkan perbandingan harness umum daripada perbandingan sistem berkonfigurasi terbaik. Ini menghasilkan bukti yang terpakai pada aliran kerja anda dan bukannya tetapan penanda aras pasukan lain.
Bolehkah gerbang API mengekalkan keadaan agen apabila menukar model?
Alamat gerbang dikongsi tidak semestinya menjamin keadaan perbualan mudah alih, pengecam panggilan alat, atau rujukan respons tersimpan. Simpan rekod sisi aplikasi yang kanonik tentang mesej, output alat, dan keadaan tugas yang disahkan. Uji keadaan dan semantik alat setiap laluan sebelum merutekan kerja yang sedang berlangsung kepada model lain; jika tidak, pengganti lebih murah mungkin kehilangan maklumat yang diperlukan untuk menyiapkan dengan betul.
Bagaimanakah pasukan harus memperuntukkan bajet untuk cubaan semula dan semakan manusia?
Takrifkan hasil yang diterima sebelum menguji, kemudian bahagi jumlah perbelanjaan model dan alat yang dibilkan dengan hasil yang diterima. Laporkan tenaga kerja semakan secara berasingan atau sertakannya menggunakan kadar setiap jam yang dinyatakan. Kira percubaan gagal, panggilan pembetulan, dan model sandaran, dan bandingkan tugas yang tipikal serta berkos tinggi. Ini mengelakkan menganggap harga token yang lebih rendah sebagai jaminan pengurangan kos kerja yang berguna.
Apa yang harus disertakan dalam penilaian agen sensitif memori?
Uji sama ada agen mengingati fakta relevan, menggabungkan pembetulan, mengabaikan arahan usang, dan mengekalkan projek berasingan terasing. Sertakan susulan tertunda dan kemas kini bercanggah bukannya hanya satu prompt panjang. Semak tingkah laku memori pada peringkat aplikasi serta peringkat model, kerana ketekalan, pengambilan semula, dan pemadaman bergantung pada sistem yang digunakan.