
TL;DR
OpenAI Decisions API dan TypeSafe Jev kedua-duanya mengembalikan keputusan terikat yang disandarkan kebarangkalian, bukannya prosa generatif biasa. OpenAI menggunakan GPT-6 Luna melalui endpoint khusus; Jev ialah model System One khusus. Jev lebih murah pada kadar token input yang diterbitkan ($0.042 berbanding $0.10 per juta), manakala OpenAI mempunyai sokongan imej natif. Angka vendor yang dikaji di sini tidak menetapkan pemenang ketepatan atau kelajuan secara bersemuka.
Key Takeaways
- Harga: Jev 58% lebih murah per token input pada kadar asas yang diterbitkan.
- Arkitektur: OpenAI Decisions API menggunakan GPT-6 Luna; Jev dibina khusus untuk pemprosesan keputusan.
- Modaliti: OpenAI menyokong teks dan imej; Jev memfokuskan pada teks dan input berstruktur.
- Penanda aras: Dakwaan kelajuan vendor menggunakan garis dasar berbeza; bandingkan pada set data berlabel yang sama.
- Pemilihan: Utamakan sokongan multimodal dan integrasi OpenAI, atau throughput teks sahaja dan kos, bergantung pada aplikasi anda.
At Glance: OpenAI Decisions API vs Jev
Gambaran di bawah membandingkan endpoint keputusan yang didokumenkan dan kadar asas yang diterbitkan, diperiksa pada 12 Oktober 2026. Akses model, had, dan syarat perkhidmatan perlu disahkan untuk akaun penyebaran.
| Feature | OpenAI Decisions API | TypeSafe Jev |
|---|---|---|
| Provider | OpenAI | TypeSafe AI |
| Engine | GPT-6 Luna | Jev System One |
| Endpoint | POST /v1/decisions | POST /v1/systemone |
| Model identifier | gpt-6-luna | jev-1.13.0 / jev-latest |
| Inputs | Text + images | Text / structured text |
| Question types | Predicate (condition probability), choice (category), score (rubric) | Noul (condition probability), choice (category), score (levels) |
| Request questions | Array with names | Object keyed by ID |
| Context limit | Not specified in the linked Decisions guide | 64K total; state + longest question ≤32K |
| Base input cost / 1M | USD 0.10 | USD 0.042 |
| Output token cost | No charge | No charge |
| Vendor speed statement | About 10× faster than Responses API | 70–500 ms end to end |
| Availability | Public beta | Early access in the launch announcement; verify current account access |
| Distinct advantage | Image-based decisions | Lower published input cost |
| Generative reasoning / coding | Not the output contract of this endpoint | Not the output contract of this endpoint |
Banyak aliran kerja AI memerlukan kategori, kebarangkalian, atau skor—bukan perenggan. Tiket sokongan perlu dirutekan; ejen perlu memilih tindakan yang diluluskan; barisan semakan perlu mengenal pasti input yang tidak pasti. Kedua-dua produk menjadikan keputusan sedemikian sebagai output API kelas pertama.
OpenAI mengeluarkan Decisions API dalam beta pada 6 Oktober 2026. Endpoint GPT-6 Luna menerima teks dan imej. Jev ialah model System One khusus milik TypeSafe AI untuk penilaian bukan generatif, dengan pendekatan latihan yang digambarkan sebagai Reinforcement Learning for Calibrated Decisions (RLCD).
Jenis soalan dalam jadual merangkumi tiga tugasan bersama. Predicate milik OpenAI dan noul milik Jev menganggarkan sama ada sesuatu syarat adalah benar, seperti niat bayaran balik atau kelayakan. Choice memilih daripada kategori pratakrif, seperti Billing, Technical, dan Shipping, untuk perutean. Score menilai input terhadap rubrik atau tahap, seperti keperluan segera atau keutamaan. Penerangan ini menyatukan dua gambaran produk; skema permintaan dan semantik kebarangkalian masih memerlukan pengendalian khusus penyedia.
What is OpenAI Decisions API and Jev?
OpenAI Decisions API dan TypeSafe Jev ialah perkhidmatan AI berfokus keputusan yang direka untuk menukarkan data input kepada output terstruktur dan terikat bukannya teks terbuka. Tidak seperti model bahasa besar tradisional yang menjana penjelasan atau respons perbualan, API ini menilai soalan pratakrif dan memulangkan keputusan, kebarangkalian, atau skor. Ini menjadikannya amat berguna untuk aliran kerja automatik seperti perutean permintaan pelanggan, pengelasan kandungan, penilaian risiko, dan pemilihan alat ejen AI, di mana output yang boleh diramal dan pemprosesan yang cekap adalah penting.
OpenAI Decisions API dikuasakan oleh GPT-6 Luna dan beroperasi melalui endpoint /v1/decisions. Ia menyokong input teks dan imej, dengan tiga jenis keputusan: predicate, choice, dan score. Kelebihan utamanya ialah menggabungkan pemahaman kontekstual model tujuan umum dengan antara muka keputusan khusus, menjadikannya sesuai untuk pengelasan multimodal dan aplikasi yang sudah berintegrasi dalam ekosistem OpenAI.
TypeSafe Jev, sebaliknya, ialah model keputusan khusus yang diakses melalui endpoint /v1/systemone. Ia memfokuskan pada penilaian berasaskan teks menggunakan tiga jenis soalan: noul, choice, dan score. Jev menekankan inferens cekap, ramalan terstruktur, dan penentukuran kebarangkalian, menjadikannya pilihan menarik untuk pengelasan volum tinggi dan talian paip keputusan automatik. Walaupun kedua-dua perkhidmatan menangani masalah yang serupa, perbezaan dalam arkitektur, keupayaan input, harga, dan reka bentuk API boleh mempengaruhi kesesuaian terhadap sesuatu aplikasi.
Model Approach, Input Limits, and Scope
Perbandingan ini membabitkan tingkah laku API yang didokumenkan dan kedudukan produk. OpenAI mendedahkan GPT-6 Luna melalui endpoint keputusan, manakala TypeSafe memposisikan Jev sebagai model System One khusus. Penerangan ini sahaja tidak menetapkan kelebihan ketepatan atau mendedahkan semua butiran pelaksanaan.
Jev membenarkan 64K token merentasi keseluruhan permintaan, dengan had 32K berasingan untuk state ditambah soalan terpanjang. Kira arahan soalan dan kriteria serta input yang dikongsi. Panduan Decisions OpenAI yang dipaut tidak menyatakan had konteks berangka berasingan untuk endpoint ini; sahkan had yang terpakai dan jangan menganggap angka tetingkap konteks model umum terpakai tanpa perubahan.
Penanda aras penaakulan generatif dan penjanaan kod di luar skop endpoint keputusan terikat ini. Untuk penjanaan penjelasan atau kod, nilai endpoint generatif yang sesuai secara berasingan. Keputusan untuk model tujuan umum yang mendasari tidak menetapkan prestasi untuk endpoint Decisions.
Accuracy and Latency
Bahan vendor yang dipetik tidak menyediakan ujian berpadanan yang menetapkan pemenang ketepatan atau latensi. Pernyataan kelajuan kira-kira 10× OpenAI membandingkan Decisions dengan Responses API. TypeSafe melaporkan latensi hujung-ke-hujung 70–500 ms dan menyatakan penilaiannya yang diterbitkan lazimnya dijalankan dari komputer riba di barat Amerika Syarikat.
| Metric | OpenAI Decisions API | Jev | Assessment |
|---|---|---|---|
| Head-to-head accuracy | No matched test in the cited sources | No matched test in the cited sources | No winner |
| Speed | Relative vendor claim | Absolute vendor range | Not directly comparable |
| Calibration | Probabilities; separate confidence for choice/score | Probabilities; derived confidence for choice/score | Test observed calibration |
| Text categorization | Supported | Supported | Both viable |
| Visual categorization | Native images | No native images | OpenAI advantage |
Probability Calibration and Review Thresholds
Sebuah model mungkin tepat tetapi kurang terkalibrasi. Dalam kalangan ramalan yang diberikan kebarangkalian 0.90 untuk kelas terpilih, kira-kira 90% sepatutnya betul jika kebarangkalian tersebut terkalibrasi pada taburan penilaian. Jangan gantikan medan API bernama confidence dengan kebarangkalian ini tanpa memeriksa takrifannya. Jev memperoleh keyakinan Choice daripada taburan kebarangkalian: confidence = (p_max − 1/n) / (1 − 1/n), di mana n ialah bilangan pilihan. Keputusan Noulnya tiada medan confidence berasingan. Ukur ECE dan skor Brier daripada kebarangkalian yang sesuai, di samping precision, recall, dan macro F1; pilih ambang semakan daripada contoh berlabel.
Pricing and Cost per Accepted Decision
OpenAI menyenaraikan $0.10 per juta token input untuk /v1/decisions; Jev menyenaraikan $0.042 per juta token input. Kedua-duanya menyenaraikan tiada caj token output untuk perkhidmatan keputusan ini. Pada kadar asas tersebut, Jev 58% lebih murah per token input. Premium pemprosesan serantau OpenAI dan pengganda konteks panjang boleh terpakai; percubaan semula, prapemprosesan, dan semakan boleh menambah kos aliran kerja.
Anggap setiap permintaan menggunakan 500 token input boleh dibilkan pada kedua-dua perkhidmatan. Ini ialah pengiraan ilustrasi, bukan invois vendor.
| Monthly decisions | Input tokens | OpenAI cost | Jev cost | Difference |
|---|---|---|---|---|
| 10,000 | 5M | $0.50 | $0.21 | $0.29 |
| 100,000 | 50M | $5.00 | $2.10 | $2.90 |
| 1,000,000 | 500M | $50 | $21 | $29 |
| 10,000,000 | 5B | $500 | $210 | $290 |
| 100,000,000 | 50B | $5,000 | $2,100 | $2,900 |
Kos per keputusan diterima yang betul = (perbelanjaan API + perbelanjaan percubaan semula + perbelanjaan semakan manusia) / bilangan keputusan diterima yang betul. Kadar per token yang rendah boleh diimbangi oleh kadar salah rute atau eskalasi yang lebih tinggi.
Untuk aliran kerja GPT-6 Luna konvensional, jadual harga model CometAPI menyenaraikan kadar USD per juta token, diperiksa pada 12 Oktober 2026. Ini ialah kadar endpoint model; halaman terpaut menunjukkan contoh Responses API dan tidak menetapkan sokongan asli /v1/decisions atau harganya.
| Published tier | Input / 1M tokens | Output / 1M tokens |
|---|---|---|
| Short context (page condition: ≤272,000 tokens) | $0.08 | $0.40 |
| Long context (as listed on the page) | $0.16 | $0.60 |
Token output GPT-6 Luna biasa CometAPI dibilkan. Kekalkan anggaran ini berasingan daripada dua perkhidmatan keputusan di atas, yang caj token output diterbitkannya sifar. Sebagai contoh, 500 token input ditambah 20 token output berharga $0.000048 per permintaan konteks pendek, atau $48 per sejuta permintaan, sebelum caj lain. Sahkan tier yang berkenaan dan kadar akaun dalam katalog model langsung sebelum membuat belanjawan.
Agent Workflows and Modality Tradeoffs
Kedua-duanya boleh merutekan panggilan alat, menilai sama ada syarat pengawal dipenuhi, atau memberi skor kepada tindakan. Tiada satu pun menggantikan kebenaran, pengesahan input, atau kebenaran alat yang jelas. Untuk automasi visual, sokongan imej natif OpenAI memudahkan talian paip; untuk perutean teks tulen, kos asas Jev yang lebih rendah boleh menarik.
Pengendalian output berbeza pada sempadan respons. OpenAI memulangkan answers array, dengan name mengenal pasti soalan; Jev memulangkan answers object yang diindeks oleh ID soalan. Normalkan struktur-struktur ini sebelum menerapkan peraturan perniagaan bersama. Jev memperoleh confidence daripada taburan kebarangkalian; jangan anggap medan bernama sama mempunyai makna setara merentas penyedia. Sahkan label dan kalibrasikan ambang semakan pada data aplikasi.
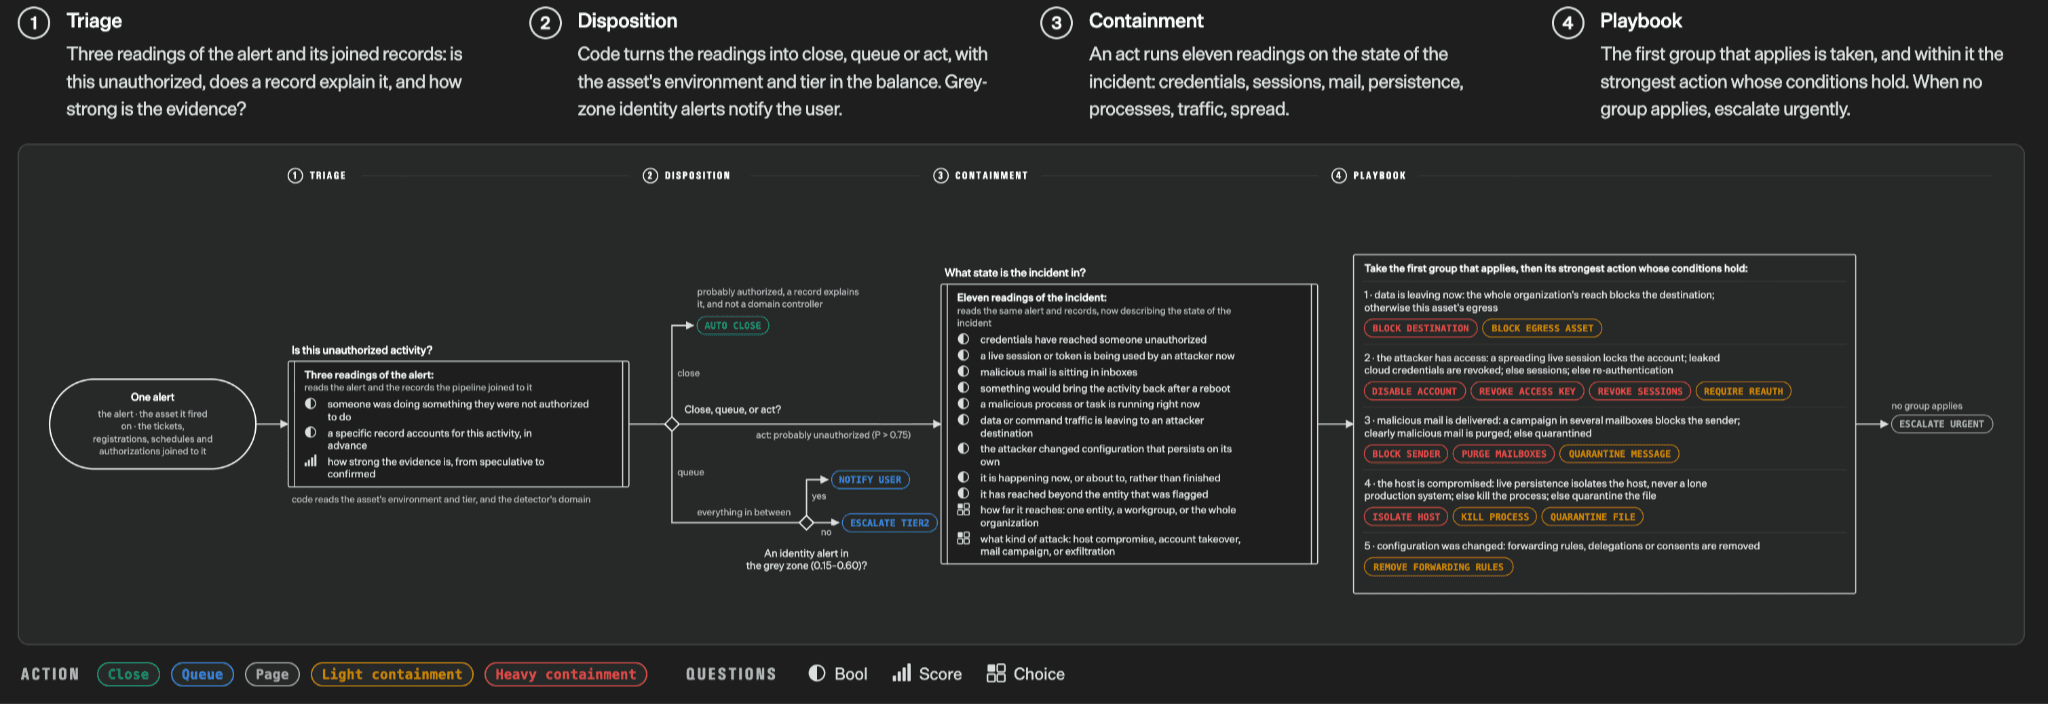
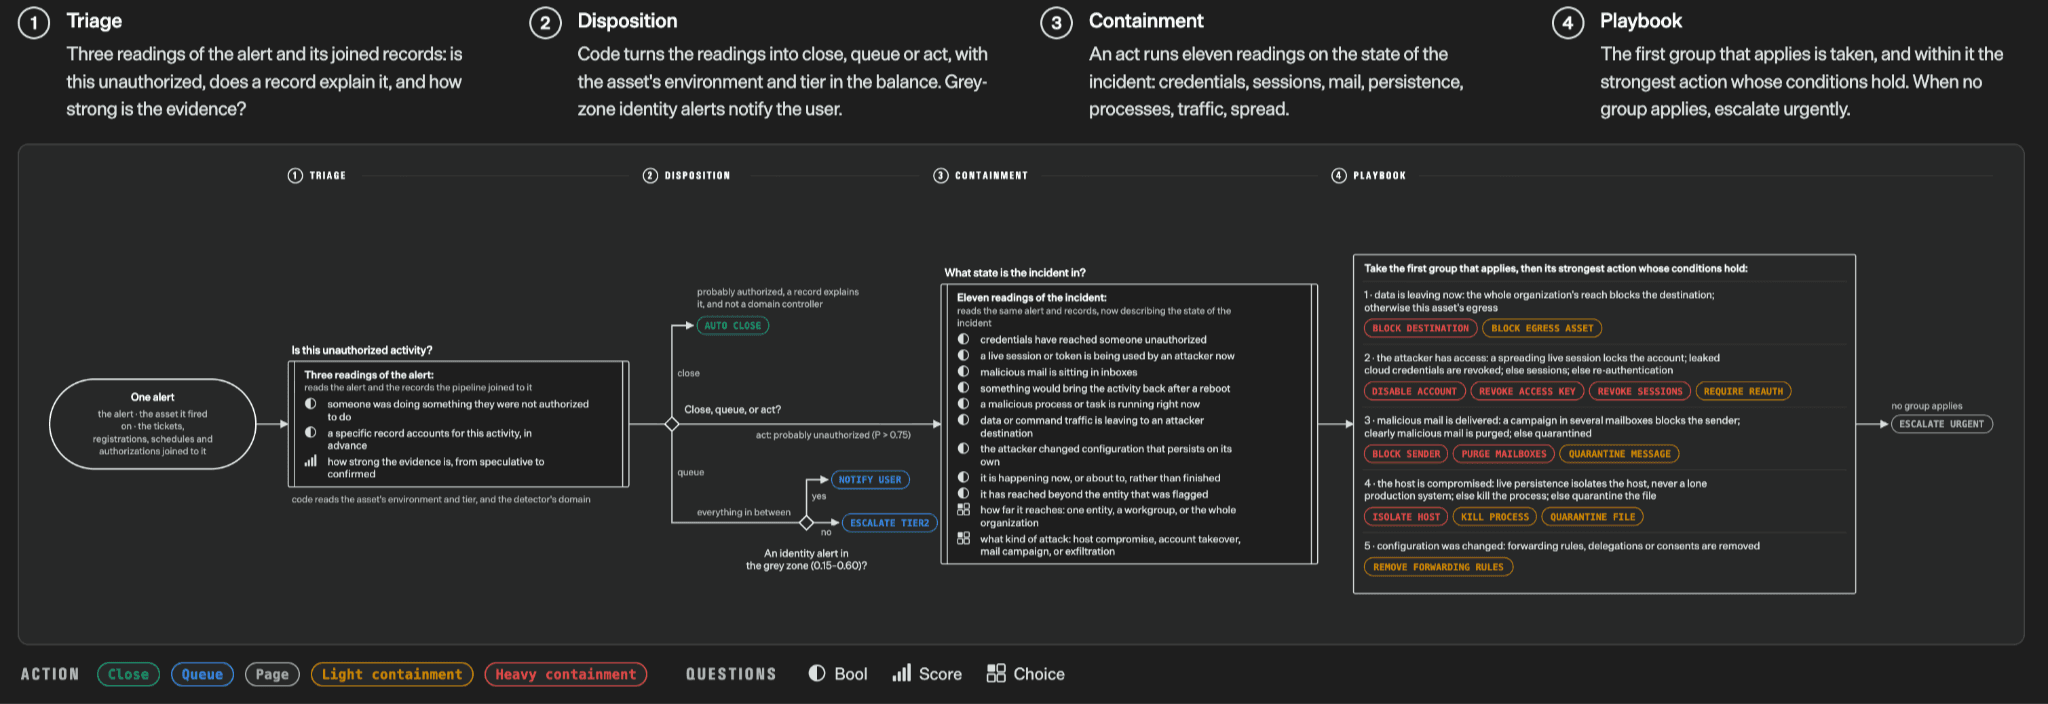
Sumber: Introducing System One Models & Jev; imej asal. Ini menggambarkan komposisi aliran kerja, bukan penanda aras berpadanan terhadap OpenAI Decisions API.
How API Usage Differs: OpenAI Decisions API vs Jev
Akses mesti dikonfigurasi secara berasingan untuk setiap penyedia: setiap contoh di bawah menggunakan hos dan kunci API masing-masing. OpenAI mendokumenkan Decisions sebagai endpoint beta umum. Untuk Jev, sahkan akses dan kelayakan semasa dengan TypeSafe sebelum penyebaran. Untuk mana-mana perkhidmatan, sahkan kebenaran akaun, ketersediaan wilayah, kuota, dan syarat perkhidmatan; contoh permintaan tidak menjamin akses produksi. Akses pihak ketiga kepada model generatif tidak dengan sendirinya mengesahkan sokongan untuk endpoint keputusan natifnya.
How to use OpenAI Decisions API
Konsepnya bertindih, tetapi skema permintaan berbeza. OpenAI menghantar input dan array soalan bernama; Jev menggunakan state dan objek questions yang diindeks oleh ID soalan. Laksanakan penyesuai khusus penyedia sebelum menggunakan polisi keputusan bersama.
Route a support ticket with OpenAI Decisions API.
curl https://api.openai.com/v1/decisions \
  -H "Authorization: Bearer $OPENAI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "gpt-6-luna",
    "input": "I was charged twice for my order.",
    "questions": [{
      "type": "choice", "name": "department",
      "instructions": "Which team should handle this?",
      "choices": [
        {"value":"billing","description":"Charges and refunds"},
        {"value":"technical","description":"Product errors"},
        {"value":"other","description":"Other requests"}
      ]
    }]
  }'
How to use Jev API
Permintaan cURL berikut menggunakan endpoint System One Jev untuk mengelas sebuah tiket sokongan. Tetapkan TYPESAFE_API_KEY dalam persekitaran anda, letakkan tiket dalam state, dan takrifkan department dalam objek questions. Peta criteria-nya menyenaraikan label perutean yang dibenarkan dan penerangannya. Selepas permintaan berjaya, baca entri department dalam answers dan sahkan label yang dipilih sebelum merutekan tiket. Sahkan bahawa pengenal model tersedia untuk akaun anda.
Route a support ticket with TypeSafe Jev.
curl https://api.typesafe.ai/v1/systemone \
  -H "Authorization: Bearer $TYPESAFE_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "jev-1.13.0",
    "state": "I was charged twice for my order.",
    "questions": {
      "department": {
        "type": "choice",
        "instructions": "Which team should handle this?",
        "criteria": {
          "billing":"Charges and refunds",
          "technical":"Product errors",
          "other":"Other requests"
        }
      }
    }
  }'
| Integration element | OpenAI | Jev |
|---|---|---|
| Input | input | state |
| Questions | Array | Keyed object |
| Question ID | name | Object key |
| Binary question | predicate | noul |
| Choices | choices | criteria |
| Answer shape | answers array | answers object |
Shared Review Policy for Selected-Class Probabilities
Gunakan ambang terkalibrasi secara jelas pada kebarangkalian kelas terpilih.
from dataclasses import dataclass
from math import isfinite

@dataclass
class NormalizedDecision:
    label: str | None
    selected_probability: float | None
    provider: str
    needs_review: bool

def apply_review_policy(label, selected_probability, provider, threshold):
    if not isfinite(threshold) or not 0.0 <= threshold <= 1.0:
        raise ValueError("threshold must be between 0 and 1")
    valid_probability = (
        selected_probability is not None
        and isfinite(selected_probability)
        and 0.0 <= selected_probability <= 1.0
    )
    return NormalizedDecision(
        label=label,
        selected_probability=selected_probability,
        provider=provider,
        needs_review=(
            not label
            or not valid_probability
            or selected_probability < threshold
        ),
    )
Contoh Python 3.10+ ini ialah lapisan polisi aplikasi, bukan penghuraian respons API. Setiap penyesuai penyedia mesti mengesahkan respons dan mengekstrak kebarangkalian kelas terpilih. Jangan hantarkan medan confidence mentah Jev sebagai selected_probability. Bekalkan ambang yang terkalibrasi untuk penyedia, soalan, dan set penilaian tersebut; tangani penolakan dan ralat pengangkutan sebelum memanggil polisi.
OpenAI Decisions API vs Jev: How to choose
Pilih dalam dua peringkat. Pertama, tapis keperluan penyebaran: input imej, akses akaun, had input, dan usaha integrasi. Kemudian jalankan penanda aras perkhidmatan yang layak pada beban kerja berlabel yang sama. Untuk perutean teks sahaja, uji sama ada harga input terbitan Jev yang lebih rendah diterjemahkan menjadi kos keseluruhan lebih rendah; untuk keputusan bergantung imej, nilai laluan imej natif OpenAI. Bandingkan salah rute, penentukuran, latensi ekor, percubaan semula, dan semakan manusia pada sasaran kualiti yang dipersetujui. Jadual di bawah ialah senarai pendek permulaan, bukan bukti pemenang prestasi keseluruhan.
| Use case | OpenAI Decisions API | Jev | Practical recommendation |
|---|---|---|---|
| Support routing | Supported | Supported | Benchmark Jev first for cost |
| Text categorization | Supported | Supported | Compare calibration |
| Screenshot inspection | Native | Requires vision preprocessing | OpenAI |
| Agent tool selection | Supported | Supported | Measure end-to-end outcomes |
| Multimodal moderation | Text and images | Text only | OpenAI |
| Existing OpenAI stack | Native | New integration | OpenAI |
Untuk automasi perniagaan volum tinggi, seperti perutean sokongan dan pengelasan teks, Jev wajar diberi keutamaan apabila kos input dan throughput menjadi keutamaan. Untuk aplikasi multimodal, termasuk pemeriksaan tangkapan skrin, penyederhanaan visual, dan keputusan berasaskan imej, OpenAI Decisions API ialah pilihan yang lebih praktikal kerana sokongan imej natifnya. Untuk ejen AI dan aliran kerja perusahaan, pilihan bergantung pada infrastruktur sedia ada, kerumitan integrasi, dan akibat keputusan yang salah. OpenAI mungkin menawarkan laluan yang lebih lancar untuk pasukan yang sudah menggunakan ekosistemnya, manakala Jev patut dipertimbangkan untuk beban kerja teks berskala besar. Dalam semua senario, keputusan akhir harus berdasarkan ketepatan yang diukur, penentukuran kebarangkalian, latensi, dan jumlah kos operasi, bukannya hanya harga tajuk.
How Should You Benchmark OpenAI Decisions API Against Jev?
Jalankan kedua-dua perkhidmatan pada input dunia sebenar yang berlabel sama, dengan takrif soalan dipadankan dan wilayah klien yang sama. Jejak ketepatan, macro F1, ECE, skor Brier, latensi p50/p95/p99, tamat masa, penolakan, kadar semakan, dan kos dolar per keputusan diterima yang betul.
| Dimension | Recommended metrics | Why it matters |
|---|---|---|
| Classification | Accuracy, precision, recall, macro F1 | Quality of labels |
| Calibration | ECE, Brier score | Reliability of probabilities |
| Latency | p50 / p95 / p99 | Operational responsiveness |
| Reliability | 429 / timeout / refusal rate | Production behavior |
| Economics | Cost per accepted correct decision | Real operating expense |
Prosedur yang disyorkan: bina set berlabel yang mewakili; sertakan kes samar dan di luar taburan; hantar tugas yang semantik sama; ulang permintaan secukupnya untuk mengukur varians; kalibrasikan ambang setiap sistem secara bebas; dan bandingkan kos hujung-ke-hujung termasuk eskalasi dan percubaan semula.
Conclusion
Pilih OpenAI Decisions API apabila keputusan bergantung pada bukti imej atau apabila integrasi OpenAI sedia ada mengurangkan kerja penyebaran. Nilai Jev untuk beban kerja keputusan teks sahaja di mana kadar token input terbitannya yang lebih rendah boleh mengurangkan perbelanjaan inferens. Ukur kualiti label, penentukuran, latensi ekor, dan beban kerja semakan pada data aplikasi yang sama sebelum memilih.
Jev mempunyai harga asas token input yang diterbitkan lebih rendah; OpenAI Decisions API mempunyai input imej natif. Angka vendor yang dipetik tidak menetapkan pemenang keseluruhan bagi ketepatan atau kelajuan. Pilihan terbaik bergantung pada kos dan kualiti keputusan yang diterima dalam aliran kerja lengkap.
Pembangun boleh menggunakan GPT-6 Luna API dalam CometAPI untuk memprototaip pengelasan ringan dalam aliran kerja multi-model yang lebih luas. Halaman model terpaut menyediakan contoh Responses API. Akses ke endpoint generatif tersebut tidak menetapkan sokongan untuk endpoint /v1/decisions khusus. Ini ialah prototaip penjanaan teks konvensional. Ia tidak memulangkan skema jawapan Decisions natif atau taburan kebarangkalian kelas terkalibrasi. Sahkan label yang dipulangkan terhadap kategori yang dibenarkan dan tangani ralat API sebelum menyambungkannya kepada tindakan hiliran. Sahkan sokongan /v1/decisions natif secara berasingan jika endpoint itu diperlukan.