
TL;DR: Welke GPT-6 Astra API‑alternatief moet je kiezen?
Kies het model naar workload: Claude Opus 5 als dichtstbijzijnde premium‑vervanger, Claude Fable 5.1 voor de moeilijkste, volgehouden redenering, GPT-5.6 Sol voor de laagste frictie bij OpenAI‑migratie, Claude Sonnet 5 voor grootschalige productie, Gemini 3.8 Flash voor goedkope multimodale taken, en DeepSeek V4.1 Flash wanneer tokencost de primaire beperking is.
Houd GPT-6 Astra voor workloads waarbij sterkere computer‑use, autonome uitvoering, wetenschappelijke redenering of cybersecurity‑prestaties merkbaar het aantal retries en menselijke interventie verminderen.
Kernpunten: Wat is belangrijk bij het vervangen van GPT-6 Astra?
- GPT-6 Astra is lastig te vervangen op zijn sterkste agent‑achtige taken. De officiële GPT-6 Astra-benchmarktabel noteert 57,9% op Terminal-Bench 4.0, 97,6% op FrontierMath Tier 4 en 96,0% op GPQA Diamond.
- Claude Opus 5 is de meest uitgebalanceerde directe kandidaat om als eerste te testen. Anthropic prijst Opus 5 op $5/$25 per miljoen input-/outputtokens, de helft van Astra’s basistarieven.
- Claude Fable 5.1 is geen budgetalternatief. De prijzen van $10/$50 voor input/output komen overeen met Astra’s headline‑tarief, terwijl geselecteerde kennis- en long‑horizon‑reasoning‑evaluaties Fable 5.1 bevoordelen.
- GPT-5.6 Sol is de gemakkelijkste downgrade in plaats van een echte platformswitch. Het 1,05M‑contextvenster, 128K maximale output en $4/$20‑prijzen verkleinen de migratiefrictie voor OpenAI‑applicaties.
- Gemini 3.8 Flash biedt een sterke gehoste prijs/prestatie‑case. Het introductietarief in 2026 is $0,75/$3,75 per miljoen input/outputtokens.
- DeepSeek V4 Flash zit in een andere kostenklasse. De officiële piek- en dalurenprijzen liggen ver onder premium‑modellen, maar lagere tokencosts betekenen niet automatisch gelijke agentsuccespercentages.
- De beste productiemetric is meestal kosten per geaccepteerde voltooide taak. Neem retries, tool‑failures, latentie, outputtokens en menselijke naverwerking mee.
Wat is de GPT-6 Astra API?
OpenAI positioneert GPT-6 Astra als het vlaggenschipmodel voor complexe end‑to‑end‑taken. De API‑specificatie omvat een contextvenster van 1.050.000 tokens en 128.000 tokens maximale output, tekst- en beeldinput, ondersteuning voor redeneertokens en vijf instellingen voor reasoning‑effort: low, medium, high, xhigh en max.
Astra verschilt van een conventionele chatbot doordat het is ontworpen voor langdurige uitvoering. Het officiële overzicht van mogelijkheden benadrukt computer use en professioneel werk, naast software‑engineering, browsen, wetenschap, cybersecurity en complexe redenering.
| GPT-6 Astra specification | Value |
|---|---|
| API model ID | gpt-6-astra |
| Provider | OpenAI |
| Context window | 1,050,000 tokens |
| Maximum output | 128,000 tokens |
| Input | Text, images |
| Output | Text |
| Knowledge cutoff | 30 april 2026 |
| Reasoning effort | Low, medium, high, xhigh, max |
| Standard input price | $10 / 1M tokens |
| Cached input | $1 / 1M tokens |
| Standard output price | $50 / 1M tokens |
| Long-context threshold | More than 272K input tokens |
Opmerking prijsstelling lange context:
requests above 272K input tokens
worden voor het gehele request geprijsd op $20/M input en $75/M output. Begroot deze requests apart.
Waarom teams verder kijken dan GPT-6 Astra
Astra is het overtuigendst wanneer de extra capaciteiten mislukte pogingen, toolfouten, handmatige interventie of herhaalde calls naar zwakkere modellen elimineren. De premiumprijs is lastiger te rechtvaardigen voor samenvatten, extractie, classificatie, routine‑RAG, gewone chat en standaard codegeneratie.
Teams evalueren daarom alternatieven om kosten te verlagen, binnen een bestaande providerekosysteem te blijven, cache‑economie te verbeteren, multimodale ondersteuning toe te voegen of een sneller model voor routinetraffic te gebruiken terwijl Astra gereserveerd blijft voor escalatie.
Benchmarkvergelijking en beperkingen
Bewijsnoot: de tabel gebruikt OpenAI’s gepubliceerde vergelijkingskader om verschillende alternatieven onder een gemeenschappelijke setup te plaatsen. Deze door leveranciers gerapporteerde scores kunnen veranderen met modelsnapshots, prompts, tools en evaluatiemethodologie; gebruik ze om kandidaten te shortlistten en valideer finalisten op representatieve productietaken.
| Benchmark | GPT-6 Astra | GPT-5.6 Sol | Claude Fable 5.1 | Claude Opus 5 | Gemini 3.8 Flash |
|---|---|---|---|---|---|
| Terminal-Bench 4.0 | 57.9% | 37.3% | 55.8% | 52.6% | 19.1% |
| DeepSWE v1.1 | 74.1% | 72.7% | 67.4% | 73.7% | 73.8% |
| FrontierCode 1.1 Extended | 64.5% | 60.6% | 63.6% | 63.6% | 56.3% |
| GPQA Diamond | 96.0% | 94.6% | 93.7% | 93.7% | 95.3% |
| FrontierMath Tier 4 | 97.6% | 83.0% | 87.8% | 73.2% | — |
| Humanity’s Last Exam, with tools | 57.2% | — | 65.0% | 63.6% | — |
De resultaten laten zien waarom het misleidend is om elk model een universele “Astra‑vervanging” te noemen. Astra heeft een duidelijke voorsprong op verschillende agent‑achtige en wetenschappelijke evaluaties, terwijl Fable 5.1 beter presteert op Humanity’s Last Exam en enkele alternatieven zeer dicht bij elkaar liggen op DeepSWE.
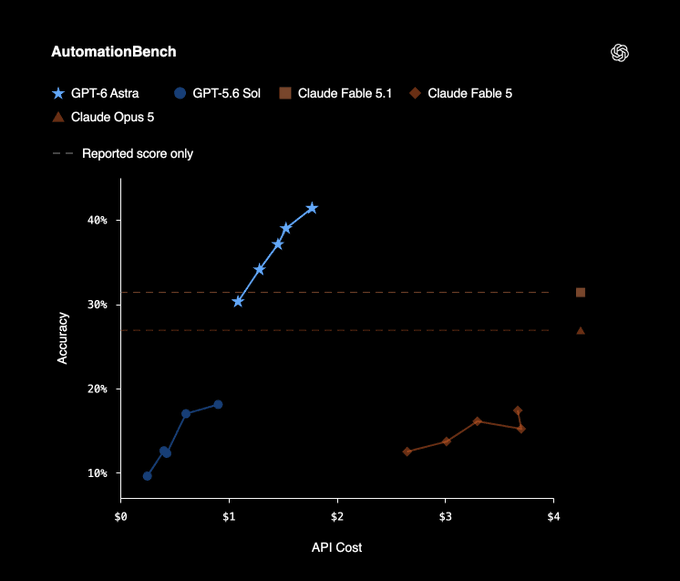
Officiële OpenAI AutomationBench-benchmarkgrafiek.
Publieke benchmarkindexen kunnen ook veranderen naarmate methodologie en modelsnapshots worden herzien. Gebruik ze om kandidaten te shortlistten, niet als vervanging voor workload‑specifieke evaluatie.
Alternatieven voor GPT-6 Astra
Geen enkel model vervangt Astra in elke workload. De meest praktische keuze hangt af van de benodigde capaciteiten, het providerekosysteem dat je al gebruikt en de kosten van mislukte of herhaalde runs.
| Alternative | Official input / output price per 1M tokens | Context | Best reason to choose it |
|---|---|---|---|
| Claude Opus 5 | $5 / $25 | 1M | Dichtstbijzijnde algehele premium‑vervanger |
| Claude Fable 5.1 | $10 / $50 | 1M | Zwaarste redenering en langlopende agents |
| GPT-5.6 Sol | $4 / $20 | 1.05M | Laagste frictie bij OpenAI‑migratie |
| Claude Sonnet 5 | $2 / $10 | 1M | Hoogvolumeproductie |
| Gemini 3.8 Flash | $0.75 / $3.75 promotional | 1M | Lage‑kosten multimodaal en batch‑werk |
| DeepSeek V4.1 Flash | $0.22–$0.44 / $0.66–$1.32 | 1M | Laagste tokencost en high‑volume‑verwerking |
Claude Opus 5
Waarom overwegen
Claude Opus 5 is de eerste alternatieve testkandidaat wanneer een product premium redenering, coding of professioneel‑werkprestaties nodig heeft tegen een lagere lijstprijs dan Astra.
Prijs, context en cache
Anthropic vermeldt Claude Opus 5 op $5/M input en $25/M output met een contextvenster van 1M tokens. Bevestig de huidige cachevoorwaarden voor productie‑budgettering.
Waar het goed presteert
Competitief op coding, analyse, professioneel schrijven en agent‑workflows; de aangehaalde benchmarktabel plaatst het dicht bij Astra op DeepSWE en FrontierCode.
Beperkingen
Het overtreft Astra niet consequent. Astra blijft de sterkere kandidaat wanneer computerbediening, geavanceerde autonome uitvoering, cybersecurity of OpenAI‑native tools centraal staan.
Beste voor / Vermijd wanneer
Beste voor: premium coding‑agents, complexe analyse en professioneel schrijven. Vermijd wanneer: de workflow sterk leunt op Astra‑specifieke tools of computer‑use‑capaciteit.
Claude Fable 5.1
Waarom overwegen
Claude Fable 5.1 is een concurrerend vlaggenschip voor de zwaarste redenering, research, coding en langlopende agenttaken, niet een low‑cost vervanger.
Prijs, context en cache
De tarieven van $10/M input en $50/M output komen overeen met Astra’s headline‑prijzen. Het contextvenster van 1M tokens en $0,25/M voor cache‑reads kunnen de economie verbeteren bij frequente hergebruikprompts.
Waar het goed presteert
Bijzonder aantrekkelijk voor volgehouden redenering en cache‑zware agents; in de vergelijking leidt het Astra op Humanity’s Last Exam met tools.
Beperkingen
Het verlaagt de headline‑tokenprijs niet, en Astra behoudt voordelen op verschillende agent‑achtige en wetenschappelijke benchmarks evenals OpenAI‑native tooling.
Beste voor / Vermijd wanneer
Beste voor: maximale redeneerkwaliteit en herhaalde long‑context‑workflows. Vermijd wanneer: het primaire doel een grote verlaging van standaard tokenprijzen is.
GPT-5.6 Sol
Waarom overwegen
GPT-5.6 Sol biedt de laagste frictie voor applicaties die al zijn gebouwd rond OpenAI‑compatibel gedrag en tooling.
Prijs, context en cache
De aangehaalde modelspecificatie vermeldt $4/M input en $20/M output, een contextvenster van 1,05M tokens en 128K maximale output. Verifieer de huidige voorwaarden voor gecachte input vóór definitieve budgettering.
Waar het goed presteert
Het blijft dicht bij Astra op DeepSWE en GPQA Diamond, terwijl het aanzienlijk minder kost onder de standaard kort‑context‑tier.
Beperkingen
De kloof wordt groter op taken die worden weergegeven door Terminal‑Bench en FrontierMath, waardoor besparingen kunnen verdwijnen als zwakkere taakvoltooiing leidt tot retries of handmatige reparatie.
Beste voor / Vermijd wanneer
Beste voor: bestaande OpenAI‑applicaties en algemene workloads die Astra’s sterkste agent‑capaciteiten niet nodig hebben. Vermijd wanneer: de workload herhaaldelijk profiteert van Astra’s grote benchmarkwinsten.
Claude Sonnet 5
Waarom overwegen
Claude Sonnet 5 is een praktische productiestandaard voor competente, reproduceerbare kenniswerk‑taken die niet bij elk request een frontier‑vlaggenschip vereisen.
Prijs, context en cache
Het aangehaalde permanente tarief is $2/M input en $10/M output met een contextvenster van 1M tokens. Bevestig de huidige cachevoorwaarden voor deployments met veel prompt‑hergebruik.
Waar het goed presteert
Geschikt voor ticketclassificatie, documentextractie, standaard RAG, contenttransformatie, codeuitleg, routine function calling en gestructureerde generatie.
Beperkingen
Het kan niet betrouwbaar Astra vervangen op elke long‑horizon‑ of frontier‑redeneringsopgave.
Beste voor / Vermijd wanneer
Beste voor: high‑volume productie‑traffic en routine zakelijke automatisering. Vermijd wanneer: falen op een moeilijke agent‑taak duurder is dan de premium van een vlaggenschipmodel.
Gemini 3.8 Flash
Waarom overwegen
Gemini 3.8 Flash combineert multimodale input, grote context en lage gehoste‑API‑kosten voor documenten, media, coding en batch‑pipelines.
Prijs, context en cache
Het aangehaalde introductietarief is $0,75/M input en $3,75/M output tot en met 31 december 2026, met een contextvenster van 1M tokens en kortingen op caching tijdens de promotieperiode.
Waar het goed presteert
Zeer geschikt voor multimodale extractie, PDF’s, audio, video, afbeeldingen, grote documentcollecties, batchanalyse en kostenbewuste coding‑workloads.
Beperkingen
Promotionele prijzen zijn tijdsgebonden, en de zwaarste autonome‑agent‑ of computer‑use‑taken vereisen nog steeds workload‑specifieke validatie tegen Astra.
Beste voor / Vermijd wanneer
Beste voor: goedkope multimodale en high‑volume batchverwerking. Vermijd wanneer: de applicatie de sterkste autonome uitvoering vereist ongeacht tokencost.
DeepSeek V4.1 Flash
Waarom overwegen
DeepSeek V4.1 Flash is de kosten‑eerst‑optie voor high‑throughput redenering, coding, samenvatten, extractie, classificatie en offline verwerking.
Prijs, context en cache
Het aangehaalde piek- en dalurenrooster vermeldt cache‑hit input op $0,007–$0,014/M, cache‑miss input op $0,22–$0,44/M en output op $0,66–$1,32/M, met een contextvenster van 1M tokens. Controleer de actuele V4.1‑prijspagina vóór publicatie.
Waar het goed presteert
Aantrekkelijk wanneer tokencost domineert en de applicatie routing, validatie of offline kwaliteitscontroles kan gebruiken om variabiliteit te managen.
Beperkingen
Een veel lagere tokencost betekent niet automatisch gelijkwaardige autonome taaksucces. Betrouwbaarheid, toolgedrag, latentie en acceptatiepercentage moeten op de doelworkload worden gemeten.
Beste voor / Vermijd wanneer
Beste voor: grootschalige, kostenbewuste verwerking met validatie. Vermijd wanneer: een mislukte autonome run met hoge waarde de tokencurve besparingen tenietdoet.
GPT-6 Astra vs alternatieven: Welk model wint in elke categorie?
Door prijs, architectuur, context en benchmark‑evidence samen te nemen, ontstaat een nuttigere beslisstabel dan modellen simpelweg van eerste tot zesde te rangschikken.
| Category | Best choice | Why |
|---|---|---|
| Overall Astra alternative | Claude Opus 5 | Sterke near‑frontier‑prestaties tegen de helft van Astra’s lijstprijs |
| Maximum reasoning | Claude Fable 5.1 | Vlaggenschip‑redenering en sterke long‑horizon‑prestaties |
| Stay inside OpenAI | GPT-5.6 Sol | Vergelijkbaar API‑ekosysteem met 60% lagere tokenprijzen |
| High-volume production | Claude Sonnet 5 | Sterke kwaliteit voor $2/$10 |
| Multimodal price/performance | Gemini 3.8 Flash | 1M context plus zeer lage introductieprijzen in 2026 |
| Lowest API cost | DeepSeek V4.1 Flash | $0,22–$0,44 input en $0,66–$1,32 output |
| Computer-use-heavy agents | GPT-6 Astra | Een van Astra’s duidelijkste differentiators |
| Scientific and difficult mathematical workflows | GPT-6 Astra | Zeer sterke FrontierMath‑ en science‑agent‑resultaten |
| Cache-heavy long agents | Claude Fable 5.1 | $0,25/M cache‑reads |
Het belangrijkste inzicht is dat GPT-6 Astra nog steeds sommige categorieën wint. Een alternatievenartikel mag niet impliceren dat een goedkoper model het universeel vervangt. Astra wordt duur wanneer het overal wordt ingezet; het kan nog steeds economisch zijn wanneer de hogere taakvoltooiingsgraad meerdere pogingen met zwakkere modellen vervangt.
Hoeveel kun je werkelijk besparen door de GPT-6 Astra API te vervangen?
Neem een workload die 1 miljoen ongecachete inputtokens en 200.000 outputtokens verbruikt. Cachekortingen, toolkosten, retries, batchprijzen en lange‑context‑toeslagen buiten beschouwing gelaten:
| Model | Approximate API cost |
|---|---|
| GPT-6 Astra | $20.00 |
| Claude Fable 5.1 | $20.00 |
| Claude Opus 5 | $10.00 |
| GPT-5.6 Sol | $8.00 |
| Claude Sonnet 5 | $4.00 |
| Gemini 3.8 Flash promotional rate | $1.50 |
| DeepSeek V4.1 Flash off-peak | $0.35 |
De basisberekening is:
total_cost =
(input_tokens / 1,000,000 * input_rate)
+
(output_tokens / 1,000,000 * output_rate)
Dit eenvoudige voorbeeld laat ook zien waarom tokenpricing niet de enige metric kan zijn. Als een Astra‑request van $20 in één keer slaagt terwijl een model van $4 zes pogingen, meerdere tool‑retries en menselijke reparatie vereist, was Astra in feite goedkoper.
Een betere productiemetric is:
cost_per_accepted_task =
total_model_and_tool_cost
/
number_of_tasks_accepted_without_rework
Volg dat getal naast latentie, taaksucces, retry‑rate, tool‑call‑fouten en escalatie‑naar‑mens‑percentage.
Hoe kun je GPT-6 Astra‑alternatieven testen via CometAPI?
Een praktisch voordeel van een multi‑model API‑laag is dat evaluatie geen provider‑integratieproject hoeft te worden. CometAPI biedt GPT-6 Astra API, GPT-5.6, Claude Fable 5.1, Claude Sonnet 5, Gemini 3.8 Flash en DeepSeek V4.1 Flash via één modelcatalogus.
Met een OpenAI‑compatibele client kan het model configureerbaar worden gemaakt in plaats van hard‑coded:
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.environ["COMETAPI_KEY"],
    base_url="https://api.cometapi.com/v1",
)

model = "claude-fable-5-1"

response = client.chat.completions.create(
    model=model,
    messages=[
        {
            "role": "user",
            "content": "Review this migration plan and identify the three highest-risk assumptions.",
        }
    ],
)

print(response.choices[0].message.content)
Je kunt dezelfde evaluatieset opnieuw uitvoeren met model‑ID’s zoals:
gpt-6-astra
gpt-5.6
claude-fable-5-1
claude-sonnet-5
gemini-3.8-flash
deepseek-v4-flash
Dit is over het algemeen informatiever dan alleen een alternatief kiezen vanaf een benchmarkleaderboard. Neem 100–500 representatieve productie‑prompts en registreer taaksucces, menselijke acceptatie, retries, tool‑fouten, totale tokens, latentie en totale API‑kosten.
Moet je GPT-6 Astra vervangen door één model of modelrouting gebruiken?
Voor veel applicaties is het vervangen van Astra door één universeel model de verkeerde optimalisatie. Een efficiëntere architectuur ziet er zo uit:
- Routineverkeer → Claude Sonnet 5, Gemini 3.8 Flash of DeepSeek V4.1 Flash
- Moeilijke redenering → Claude Opus 5 of GPT-5.6 Sol
- Zeer moeilijke long‑horizon‑taken → Claude Fable 5.1 of GPT-6 Astra
- Computer‑use of Astra‑specifieke agent‑workflows → GPT-6 Astra
Dit maakt van Astra een escalatiemodel in plaats van het standaardmodel. Als slechts 10% van de requests echt frontier‑agent‑prestaties vereist, betekent 100% van het verkeer via Astra routeren dat je ook de premium ervan betaalt voor de andere 90%.
Welk GPT-6 Astra API‑alternatief moet je kiezen?
Kies Claude Opus 5 als je de dichtstbijzijnde algehele balans van kwaliteit en prijs wilt.
Kies Claude Fable 5.1 als maximale redenering belangrijker is dan het verlagen van headline‑tokenprijzen.
Kies GPT-5.6 Sol als je al OpenAI gebruikt en de kleinste integratiewijziging wilt.
Kies Claude Sonnet 5 als het grootste deel van je productie‑traffic competent maar gewoon kenniswerk is.
Kies Gemini 3.8 Flash als multimodaliteit, schaal en lage gehoste‑API‑kosten belangrijk zijn.
Kies DeepSeek V4.1 Flash als tokencost de dominante beperking is en je workload meer evaluatie en validatie kan tolereren.
En kies GPT-6 Astra zelf wanneer je applicatie daadwerkelijk profiteert van sterkere computer‑use, moeilijke autonome software‑taken, wetenschappelijke redenering of andere agent‑capaciteiten.
De grootste fout is niet het kiezen van het “verkeerde” frontier‑model. Het is frontier‑modelprijzen betalen voor requests die nooit een frontier‑model nodig hadden.
FAQ
Wat is het beste algehele alternatief voor de GPT-6 Astra API?
Claude Opus 5 is een van de sterkste general‑purpose vervangers. Het biedt een contextvenster van 1M, sterke coding‑ en agent‑capaciteiten en $5/$25 lijstprijzen—de helft van Astra’s standaard tokenprijzen.
Wat is het goedkoopste GPT-6 Astra‑alternatief?
Onder de hier besproken modellen heeft DeepSeek V4.1 Flash de laagste first‑party tokenpricing. Het huidige off‑peak‑tarief is $0,22/M ongecachete input en $0,66/M output. Verwacht echter niet dat het Astra’s autonome taaksucces evenaart enkel omdat het goedkoper is.
Is Claude Fable 5.1 beter dan GPT-6 Astra?
Geen van beide wint elke workload. OpenAI’s vergelijking geeft Astra aanzienlijke voordelen op FrontierMath Tier 4 en Terminal‑Bench 4.0, terwijl Fable 5.1 hoger scoort op Humanity’s Last Exam met tools.
Is GPT-5.6 Sol nog de moeite waard na GPT-6 Astra?
Ja. De standaard API‑prijzen van $4/$20 liggen aanzienlijk onder Astra’s $10/$50, terwijl het een contextvenster van 1,05M behoudt. Het kan daarom een betere default zijn voor workloads waar Astra’s voordelen de taakvoltooiing niet materieel verbeteren.
Is Gemini 3.8 Flash goed genoeg om GPT-6 Astra te vervangen?
Voor sommige coding‑, multimodale, document‑ en batch‑workloads: ja. Het is dramatisch goedkoper en heeft een contextvenster van 1M. Voor de zwaarste autonome agent‑ en computer‑use‑taken blijft Astra de sterkere keuze.
Heeft GPT-6 Astra een prijsnadeel voor zeer lange prompts?
Ja. OpenAI past een hogere prijstier toe wanneer input meer dan 272K tokens bedraagt, dus long‑context‑requests moeten apart worden begroot.
Moet ik modellen vergelijken op tokenprijs of benchmarkscores?
Gebruik beide alleen als screeningmetrics. De productiemetric die meestal het belangrijkst is, is kosten per geaccepteerde voltooide taak, inclusief reasoningtokens, retries, toolcalls, latentie en menselijke naverwerking.
Kan ik meerdere GPT-6 Astra‑alternatieven in dezelfde applicatie gebruiken?
Ja. In veel applicaties is modelrouting te verkiezen boven elke request aan één model toewijzen. Een goedkoop model kan routinetaken afhandelen terwijl sterkere modellen steeds moeilijkere escalaties behandelen.
