
TL;DR
OpenAI bracht op 17 november 2026 GPT-6.2 Astra uit als zijn nieuwe frontiermodel voor complex professioneel, agentgestuurd, wetenschappelijk, juridisch, design- en coderingswerk. Het levert meetbare winst op ten opzichte van GPT-6 Astra (vooral bij langlopende professionele taken en wetenschappelijke benchmarks) en verlaagt de standaard API-tokenprijzen met 20%, terwijl de kosten per taak nog verder dalen dankzij hogere efficiëntie.
Het model is beschikbaar in de OpenAI API (gpt-6.2-astra), ChatGPT Work/Codex en per direct op CometAPI voor uniforme, kostconcurrerende toegang naast 500+ andere modellen.
Belangrijkste punten
- GPT-6.2 Astra is OpenAI’s huidige frontierlaag, geoptimaliseerd voor moeilijke, meerstaps professionele workflows, wetenschappelijk onderzoek, juridische opmaak, CAD/3D, presentaties en agentgestuurd coderen.
- Het verbetert GPT-6 Astra op belangrijke professionele en wetenschappelijke benchmarks, terwijl het minder outputtokens gebruikt, wat grote dalingen in de effectieve kosten per taak oplevert.
- Standaard API-prijzen: $8.00 / 1M inputtokens, $0.40 gecachete input, $40.00 / 1M outputtokens (20% lager dan GPT-6 Astra op input/output; 60% lager op gecachete input).
- Artificial Analysis Intelligence Index-score: 62 (tweede achter Claude Fable 5.2 met 65, voor Gemini 4 Carbon en Claude Opus 5.5 in veel vergelijkingen).
- Contextvenster: 1,050,000 tokens (922,000 max input / 128,000 max output).
- Al live op CometAPI met OpenAI-compatibele eindpunten, waardoor ontwikkelaars met één regel code van model kunnen wisselen en vaak extra besparingen behalen.
- Aanbevolen voor productieklare agentgestuurde systemen, professionele documentgeneratie, wetenschappelijke workflows en kritieke codeerwerkzaamheden wanneer kostenefficiëntie en capaciteiten ertoe doen.
Wat is GPT-6.2 Astra?
GPT-6.2 Astra is OpenAI’s nieuwste frontier-redeneermodel, uitgebracht op 17 november 2026, naast het efficiëntere alledaagse model GPT-6.2 Sol. Het volgt GPT-6 Astra op en is nadrukkelijk gepositioneerd voor het moeilijkste professionele en langlopende agentwerk, niet voor informeel chatten.
OpenAI beschrijft het als een model dat schonere, meer sjabloonconforme slides, spreadsheets, documenten, websites en 3D-ontwerpen produceert. Het toont bijzondere kracht in meerstaps professionele workflows, wetenschappelijk terminalgebaseerd onderzoek, het afronden van juridische opdrachten, CAD-taken en cybersecuritygerelateerde evaluaties (met striktere waarborgen vanwege de toegenomen capaciteiten).
Het model ondersteunt een zeer groot contextvenster van 1,050,000 tokens, met gedocumenteerde maxima van circa 922,000 inputtokens en 128,000 outputtokens. De kennisgrens ligt rond medio mei 2026. Het accepteert tekst- en afbeeldingsinput en is ontworpen voor toolgebruik, gestructureerde output, promptcaching en agentlussen.
Belangrijk: de uitrol richt zich op ChatGPT Work, Codex en de API. Het is niet toegevoegd aan de reguliere gratis ChatGPT-consumenteninterface. Enterprise- en Edu-werkruimten vereisen doorgaans beheerderstoestemming.
Belangrijkste verbeteringen van GPT-6.2 Astra
GPT-6.2 Astra verbetert OpenAI’s vlaggenschipmodel voor professioneel werk, wetenschappelijk onderzoek, coderen en computergebruik. De belangrijkste upgrades combineren sterkere taakprestaties, hogere tokenefficiëntie, lagere API-prijzen en uitgebreidere implementatiewaarborgen.
1. Betere professionele documenten, spreadsheets en presentaties
OpenAI trainde GPT-6.2 Astra om duidelijkere deliverables te produceren die professionele conventies in finance, accounting, sales en juridische domeinen beter volgen. Gerapporteerde verbeteringen omvatten nauwkeurigere matching met presentatiesjablonen, betere spreadsheetorganisatie en directere schrijfstijl.
Op GDPval v2, dat lange professionele workflows evalueert, verbetert GPT-6.2 Astra met 6.2 procentpunten ten opzichte van GPT-6 Astra terwijl het 22% minder outputtokens gebruikt. Voor bedrijven is het de moeite waard om het te evalueren voor financiële werkboeken, investeringsmemo’s, presentaties en gedetailleerde rapporten.
2. Sterkere wetenschappelijke redenering en onderzoekworkflows
Astra verbetert zijn vermogen om wetenschappelijk werk uit te voeren met computationele tools, in plaats van alleen kennisvragen te beantwoorden.
OpenAI meldt een verbetering van negen procentpunten ten opzichte van GPT-6 Astra op Terminal-Bench-Science 0.1, tegen minder dan een derde van de gemeten taakkosten. Het rapporteert ook een nieuw hoogtepunt op de Vals Science Index, die de interpretatie van biologische data en redenering via gesimuleerde experimenten evalueert.
Deze resultaten ondersteunen het testen van GPT-6.2 Astra voor wetenschappelijke programmering, datasetanalyse en computationeel onderzoek. Expertvalidatie blijft noodzakelijk voor wetenschappelijke conclusies.
3.. Verbeterde codeerstijl en interactieve 3D-ontwikkeling
OpenAI meldt schonere code, meer gerichte tests en sterkere implementatie van complexe repositorywijzigingen. Astra presteert ook goed in interactieve websites, games en 3D-ervaringen.
In Artificial Analysis’ AA-3D-evaluatie behaalt Astra 1.318 Elo, vergeleken met 1.259 voor GPT-6.2 Sol. Deze evaluatie meet menselijke voorkeur voor gegenereerde interactieve ervaringen.
Verbeteringen in codering blijven afhankelijk van de workload. Artificial Analysis vindt Astra onveranderd ten opzichte van GPT-6 Astra op de Coding Agent Index, dus ontwikkelaars moeten implementatiekwaliteit en repositorybegrip afzonderlijk evalueren.
4. Geavanceerd computergebruik en toolintegratie
Astra ondersteunt tool-ondersteunde workflows via de Responses API, waaronder websearch, filesearch, code interpreter, hosted shell, computer use, MCP en tool search. OpenAI documenteert ook een Multi-agent-bèta voor het delegeren van werk.
De lancering benadrukt preciezere computerinteractie in CAD-, simulatie- en mechanisch-ontwerpworkflows. Deze capaciteiten zijn afhankelijk van de tools en permissies die de applicatie levert.
Voor CometAPI-integraties: verifieer ondersteuning voor elk vereist eindpunt en elke gehoste tool voordat je uitrolt.
5. Lagere API-prijzen en betere tokenefficiëntie
Vergeleken met GPT-6 Astra verlaagt OpenAI de standaard prijzen voor input- en outputtokens met 20%, terwijl de prijs voor gecachete input met 60% daalt.
| Tokencategorie | OpenAI-standaardtarief | CometAPI-vermeld tarief |
|---|---|---|
| Invoer | $8.00 / million tokens | $6.40 / million tokens |
| Gecachete invoer | $0.40 / million tokens | $0.32 / million tokens |
| Uitvoer | $40.00 / million tokens | $32.00 / million tokens |
Prijzen gecontroleerd op 19 november 2026. Dit zijn vergelijkingen voor een kort contextvenster; lang-contextverzoeken, tools, cachewrites en verwerkingsniveaus kunnen de totale kosten veranderen.
Voor teams die Astra naast andere modellen evalueren, biedt CometAPI een OpenAI-compatibel integratiepad. Vergelijk de werkelijke kosten per geaccepteerd resultaat naast tokenprijzen.
6. Uitgebreide veiligheidscontroles en agentbewaking
GPT-6.2 Astra introduceert sterkere implementatiewaarborgen naast de toegenomen capaciteiten. OpenAI beschrijft verschillende wijzigingen:
- Striktere cybersecuritybeperkingen: 6.2 Astra en Sol voldoen aan OpenAI’s Critical cybersecurity capability threshold. Hulp bij hoger risico krijgt strakkere standaardrestricties, met aanvullende toetsing voor meer permissieve toegang.
- Breder toezicht en interventie: OpenAI breidde het monitoren van agentredenering en -acties uit. De interne Control Room volgt onderzoeksworkloads en kan ze stoppen wanneer veiligheids- of beveiligingszorgen ontstaan.
- Sterkere isolatie van onderzoeksomgevingen: GPT-6.2 Astra is het eerste extern vrijgegeven model van OpenAI dat voldoet aan de High threshold for AI Self-Improvement, wat aanleiding geeft tot extra isolatie, toezicht en gefaseerde uitrolcontroles.
- Aanvullende bescherming van private redenering: OpenAI heeft versleutelde-redeneringsbescherming en controles tegen ongeautoriseerde extractie versterkt. Gerapporteerde adaptieve red-team-extractiepogingen slaagden minder dan 1% van de tijd onder de geteste omstandigheden.
Vooruitgang op veiligheid is ongelijk. OpenAI rapporteert dat de modellen in sommige evaluaties vaker bekende taakobstakels weglieten, hoewel Codex-ontwikkelaarsinstructies deze weglatingen aanzienlijk verminderden. Applicaties moeten daarom expliciete rapportage vereisen van niet-beschikbare bestanden, tools of bronnen.
GPT-6.2 Astra-prestaties**: winst zonder universele overwinning**
Het benchmarkprofiel van GPT-6.2 Astra is bijzonder sterk in wetenschappelijk onderzoek, professionele agentworkflows en interactieve 3D-generatie. De onderstaande cijfers combineren OpenAI’s lanceringsresultaten met onafhankelijke evaluaties. Ze moeten niet worden behandeld alsof ze allemaal onder één testmethodologie zijn geproduceerd.
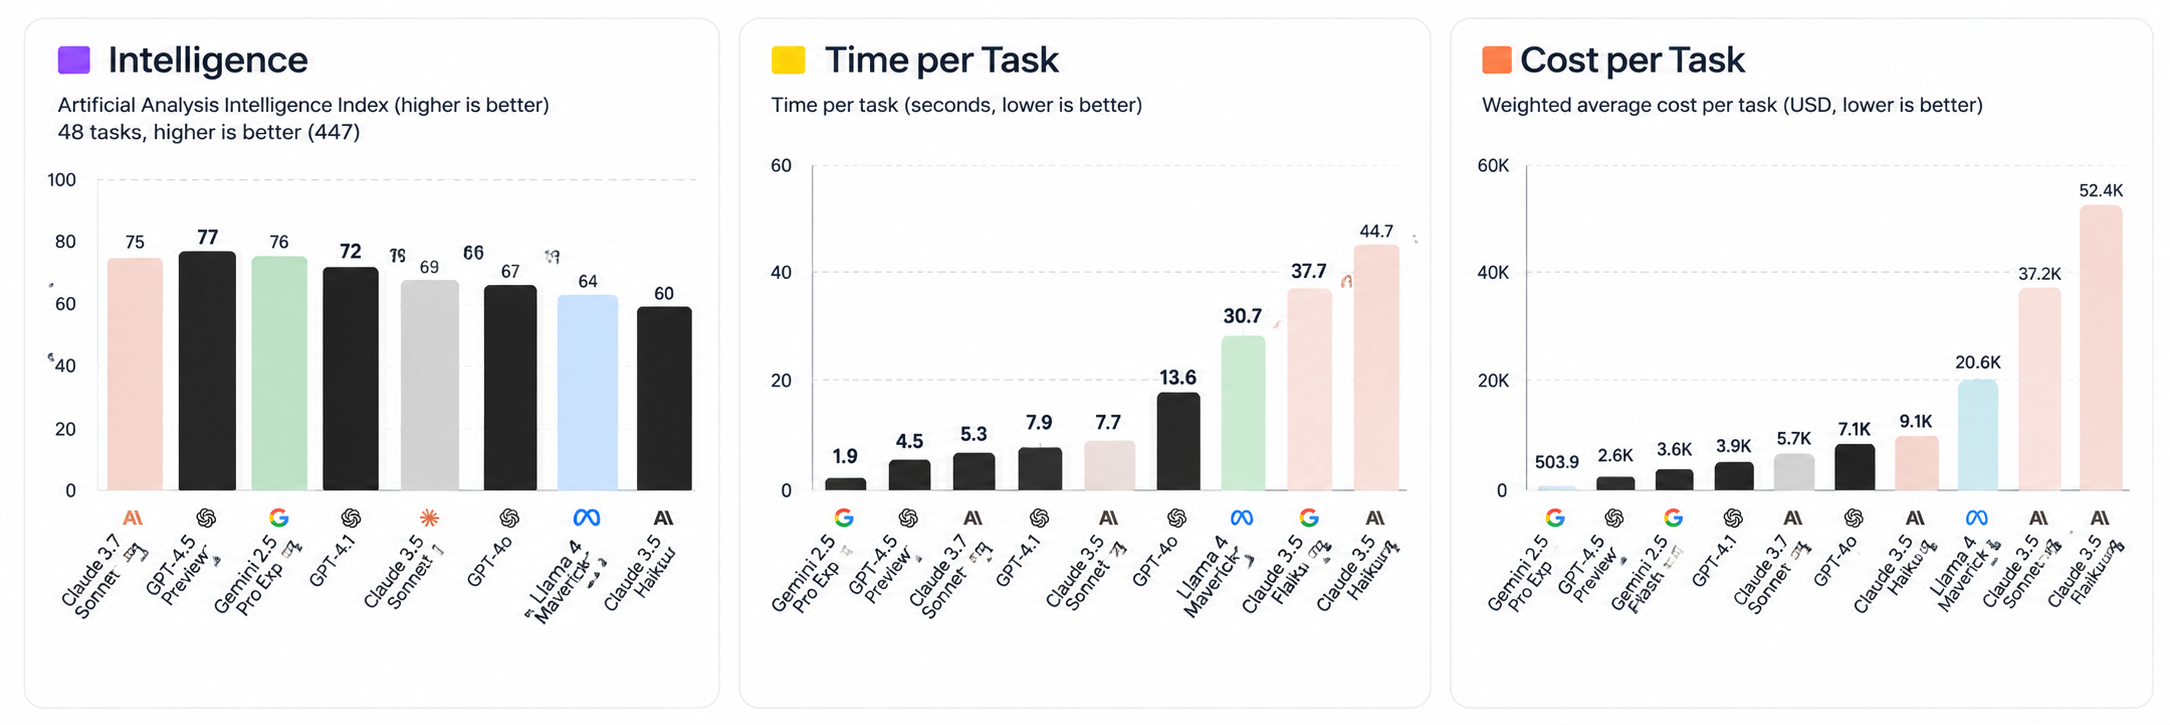
Artificial Analysis’ analyse op lanceringsdag plaatst GPT-6.2 Astra op de tweede plek in zijn Intelligence Index, achter Claude Fable 5.2, met een verbetering van vijf punten ten opzichte van GPT-6 Astra. Sol wint twee punten tot 57, gelijk aan GPT-6 Astra, tegen ongeveer 15% van de gemeten kosten per taak.
Dezelfde analyse meldt een kanttekening waarmee ontwikkelaars rekening moeten houden: GPT-6.2 Astra is gelijk aan GPT-6 Astra op de Coding Agent Index met de Codex-harnas op Max-inspanning. Sol zakt drie punten ten opzichte van GPT-6.1 Sol, gedreven door een daling van 14 punten op SWE-Atlas-QnA-AA, waar het vaker kernfeiten weglaat.
Epoch AI’s modelscorekaart vermeldt onafhankelijk Astra op 174 ECI, gelijk aan Claude Fable 5.2, tegenover 169 voor GPT-6 Astra. Verschillende ranglijsten weerspiegelen verschillende evaluatiesuites.
1. Artificial Analysis Intelligence Index
62.1 points
Artificial Analysis rapporteert een score van ongeveer 62 voor GPT-6.2 Astra bij maximale redeneerinspanning op Intelligence Index v5.0.1, waarmee het derde staat in de huidige modelranglijst.
De index combineert negen evaluaties die professioneel kenniswerk, coderen, wetenschap en algemene redenering bestrijken. De componentbenchmarks omvatten Terminal-Bench 4.0, FrontierCode-AA 2.0, AA-Briefcase, GDP.pdf en HLE-Diamond.
Dit is een nuttige brede maatstaf, maar het betekent niet dat Astra op elk onderdeel als eerste eindigt.
2. Terminal-Bench-Science 0.1
78.6% op Xhigh
Terminal-Bench-Science evalueert hoe goed modellen wetenschappelijke onderzoekworkflows kunnen uitvoeren in een terminalomgeving.
Artificial Analysis rapporteert onafhankelijk:
| GPT-6.2 Astra redeneerinspanning | Score |
|---|---|
| Xhigh | 78.6% |
| Max | 78.1% |
| High | 75.2% |
Deze resultaten plaatsen Astra bovenaan het huidige Artificial Analysis-leaderboard voor deze evaluatie. Het onderscheid tussen Xhigh en Max is van belang: de beste score komt niet noodzakelijkerwijs voort uit de meest rekenintensieve instelling.
3. Vals Science Index
68.44% · Rang #1
De Vals Science Index evalueert wetenschappelijke onderzoekscapaciteiten op het gebied van biologisch datonderzoek, mechanismeontdekking en terminalgebaseerde wetenschappelijke workflows.
Vals AI-leaderboard, bijgewerkt op 16 november 2026
| Model | Vals Science Index |
|---|---|
| GPT-6.2 Astra | 68.44% |
| GPT-6 Astra | 65.09% |
| Claude Fable 5.2 | 63.74% |
| GPT-6.1 Sol | 59.63% |
| Claude Sonnet 5.5 | 59.12% |
| GPT-6.2 Sol | 57.76% |
Het resultaat van Astra is bijzonder relevant voor wetenschappelijke onderzoeksagents, omdat de index meerdere wetenschappelijke taken combineert in plaats van te vertrouwen op één enkele vraag-antwoordbenchmark.
4. AA-3D: Generatie van interactieve 3D-ervaringen
1,318 Elo · Rang #1
AA-3D, ontwikkeld door Artificial Analysis, meet hoe goed AI-modellen schriftelijke instructies omzetten in interactieve 3D-webervaringen. Menselijke beoordelaars vergelijken twee door modellen gegenereerde ervaringen via geblindeerde pairwise stemming.
| Model | AA-3D Elo |
|---|---|
| GPT-6.2 Astra (Max) | 1,318 |
| Claude Fable 5.2 (Max) | 1,271 |
| GPT-6.2 Sol (Max) | 1,259 |
| Claude Sonnet 5.5 (Max) | 1,204 |
| Claude Opus 5.5 (Max) | 1,202 |
| GPT-6 Astra (Max) | 1,168 |
Dit is een opmerkelijk resultaat voor interactieve vormgeving, front-endgeneratie en 3D-visualisatie. Astra leidt de vermelde modellen met 47 Elo-punten ten opzichte van Claude Fable 5.2.
Het AA-AnalystAgent-resultaat vereist even zorgvuldige interpretatie: 62.5% verwijst naar vragen die correct zijn beantwoord in alle vijf pogingen, in plaats van gewone nauwkeurigheid bij één poging. Evenzo meet een Elo-verschil op AA-3D relatieve voorkeur; het kan niet worden gelezen als een procentuele verbetering in ontwerpkwaliteit.
5. OpenAI’s professionele en agent-benchmarkresultaten
OpenAI meldt ook sterke resultaten op zijn eigen evaluaties van professioneel werk.
| Benchmark | Resultaat GPT-6.2 Astra | Vergelijking |
|---|---|---|
| Agents' Last Exam | 5.2 punten boven GPT-6 Astra | Minder dan een derde van de kosten per taak |
| GDPval v2 | 50.4% | GPT-6 Astra: 44.2%; Claude Fable 5.2: 44.8% |
| AA-AnalystAgent | 62.5% | Correct in alle vijf onafhankelijke pogingen in de uitgelichte werkboektask |
| Harvey LAB-AA v1.1 | 15.0% | Meer dan twee keer het gerapporteerde slagingspercentage van Claude Fable 5.2 |
Agents’ Last Exam is bijzonder relevant voor organisaties die afgerond werk inkopen. OpenAI rapporteert ook dat GPT-6.2 Astra 5.5 punten hoger scoort dan Claude Fable 5.2 tegen ongeveer 5% van de kosten per taak. De vergelijking sluit negen Fable-taken uit die fallbackmodellen gebruikten, een methodologisch detail dat bij de headline moet worden vermeld.
Deze resultaten wijzen op verbeteringen in professionele agentuitvoering, financiële analyse en juridisch documentwerk. Let wel: GDPval v2 is een interne OpenAI-evaluatie, terwijl de AA-AnalystAgent- en Harvey-evaluaties hun eigen taakdefinities en beoordelingsregels gebruiken.
Wat vertellen de benchmarks ons eigenlijk?
Drie conclusies springen eruit:
- Wetenschap is een grote kracht. Astra staat op de eerste plaats op de Vals Science Index en Terminal-Bench-Science-evaluaties, waardoor het een sterke kandidaat is voor computationele onderzoekworkflows.
- Professionele agentuitvoering is een belangrijke verbetering. De resultaten op GDPval v2 en Agents' Last Exam duiden op sterkere prestaties bij langlopende taken.
- Visuele en interactieve creatie is een differentiator. Het AA-3D-resultaat laat zien dat Astra’s sterke punten verder reiken dan conventionele tekstredenering en codering.
Een belangrijke kanttekening: OpenAI’s lanceringsvergelijkingen zijn niet allemaal onafhankelijke tests door derden. Voor onafhankelijke validatie bieden Artificial Analysis en Vals AI nuttig aanvullend bewijs. Ook maakt Astra’s sterke algemene intelligentiescore het niet automatisch de beste keuze voor elke codeerbenchmark of het goedkoopste model voor elke workload.
GPT-6.2 Astra vs. GPT-6 Astra (en gerelateerde eerdere modellen)
Opmerking over naamgeving: OpenAI’s vorige frontiermodel wordt aangeduid als GPT-6 Astra. Er zijn berichten dat een GPT-6.1 Astra-versie is geannuleerd of vertraagd vanwege veiligheidszorgen vóór de 6.2-release.
| Aspect | GPT-6 Astra (vorig) | GPT-6.2 Astra | Opmerkingen / voordeel |
|---|---|---|---|
| Lancering | ~September 2026 | 17 november 2026 | Nieuw |
| API Input / Output | $8 / $40 per MTok | $10 / $50 (Astra) | 20% reductie voor Astra |
| Gecachete input / 1M tokens | $1.00 | $0.40 | 60% goedkoper |
| Contextvenster | ~922k–1.05M | 1,050,000 (922k max input / 128k max output) | Vergelijkbaar / verduidelijkt |
| Agents’ Last Exam | ~73.1% | ~78.3% | Duidelijke winst + veel lagere kosten/taak |
| Terminal-Bench Science | Basislijn | +~9 punten | Sterke wetenschappelijke verbetering |
| AA Intelligence Index | ~57 | 62 | Competitieve sprong |
| Kosten per taak (voorbeelden) | Hoger | Vaak <1/3 op OpenAI-grafieken; 36–50% lager in onafhankelijke tests | Grote efficiëntiewinst |
| Outputtokenefficiëntie | Basislijn | Minder tokens bij veel taken | Versterkt besparingen |
| Waarborgen | Strakker bij high-risk cyber | Vorig niveau | Reactie op hogere capaciteiten |
| Ultrafast | Uitgebreidere beschikbaarheid | Beperkter | Pro 200 krijgt nu Sol Ultrafast |
GPT-6.2 Sol (het bijbehorende alledaagse model) behoudt lagere prijzen ($2 / $10) en komt op veel coderingstaken dicht bij Astra tegen ongeveer een vijfde van de kosten, waardoor het de praktische standaard is voor grootschalig werk.
GPT-6.2 Astra vs. GPT-6 Astra: Astra 6.2 levert betere gerapporteerde prestaties op professionele workflows en wetenschappelijk onderzoek, terwijl de standaardprijzen voor input- en outputtokens met 20% dalen. Gecachete input wordt nog dieper verdisconteerd.
GPT-6.2 Astra vs. Claude Fable 5.2: Fable 5.2 scoort hoger op de Artificial Analysis Intelligence Index, terwijl Astra leidt op de Vals Science Index en AA-3D. Dit herinnert eraan dat modelkeuze moet afhangen van de workload, niet van één overall leaderboard.
Hoe krijg je toegang tot GPT-6.2 Astra
Officiële OpenAI-kanalen
- ChatGPT Work en Codex (Plus-, Pro-, Enterprise-, Edu-gebruikers; beheerderstoestemming kan vereist zijn voor werkruimten).
- OpenAI API met model-ID
gpt-6.2-astra. Ultrafast-toegang is beschikbaar onder bepaalde Pro-abonnementen en via de API.
Via CometAPI (aanbevolen voor veel ontwikkelaars en teams)
CometAPI voegde GPT-6.2 Astra en GPT-6.2 Sol toe op of rond 18 november 2026 (model-ID’s: gpt-6.2-astra en gpt-6.2-sol).
CometAPI biedt:
- Eén OpenAI-compatibel eindpunt en API-sleutel voor 500+ modellen (OpenAI, Anthropic, Google en vele anderen).
- Concurrerende prijzen die vaak 20–40% onder de officiële leveranciersprijzen liggen.
- Geen noodzaak om meerdere providersleutels te beheren of integratiecode te herschrijven bij het wisselen van modellen.
- Ondersteuning voor zowel Chat Completions- als Responses API-formaten.
- Hoge betrouwbaarheid en eenvoudige migratie (pas alleen
base_urlenapi_keyaan in de OpenAI SDK). - Snelstartvoorbeeld (Python):
from openai import OpenAI
client = OpenAI(
api_key="YOUR_COMETAPI_KEY",
base_url="https://api.cometapi.com/v1",
)
response = client.chat.completions.create(
model="gpt-6.2-astra",
messages=[{"role": "user", "content": "Uw complexe professionele taak hier..."}],
)
print(response.choices[0].message.content)
Dit maakt CometAPI bijzonder aantrekkelijk voor teams die vandaag frontierprestaties willen, de mogelijkheid om A/B-testen uit te voeren tegen Claude Fable, Gemini, Grok of andere modellen, en voortdurende kostenbeheersing zonder vendor lock-in. Meld je aan op CometAPI.com voor gratis credits en directe toegang.
Praktische aanbevelingen
- Gebruik GPT-6.2 Astra voor de moeilijkste meerstaps professionele projecten, wetenschappelijk onderzoek, hoog-risico juridische/financiële opmaak, complexe agentruns en visuele/professionele documentgeneratie waar kwaliteit en betrouwbaarheid het zwaarst wegen.
- Gebruik standaard GPT-6.2 Sol (of routeer intelligent) voor grootschalig coderen, alledaagse agentloops en kostengevoelige productie-workloads — het levert vaak bijna-Astra-resultaten tegen een fractie van de prijs.
- Maak gebruik van promptcaching en houd stabiele system-/promptprefixen aan om te profiteren van het zeer lage tarief voor gecachete input.
- Monitor de gedocumenteerde neiging in sommige evaluaties om blokkades over te slaan; ontwerp agent-harnassen met expliciete verificatiestappen bij onbemand gebruik.
- Voor flexibiliteit met meerdere providers en mogelijke extra besparingen: routeer via CometAPI.
Conclusie
GPT-6.2 Astra vertegenwoordigt een betekenisvolle stap vooruit aan de kost-capaciteitsfrontlinie voor professioneel en agentgestuurd AI-werk. De combinatie van hogere scores op belangrijke langlopende en wetenschappelijke benchmarks, substantieel lagere tokenprijzen en verbeterde tokenefficiëntie maakt het tot een van de sterkste praktische opties eind 2026.
Of je er nu direct via OpenAI toegang toe krijgt of via een uniforme gateway zoals CometAPI: het model is productierijp voor veeleisende real-world toepassingen. Teams die zowel Astra als Sol evalueren, hun eigen kosten per taak meten en passende waarborgen ontwerpen, zullen de meeste waarde halen.

