
TL;DR
Per 9 oktober 2026 suggereren berichten dat Kimi K3.1 deze maand zou kunnen verschijnen, maar de geraadpleegde bronnen leggen geen officiële lanceringsdatum, definitieve prijzen of K3.1-specifieke benchmarkresultaten vast. Gerapporteerde Low / High / Max, Extra Long, Agent en Swarm-flags overlappen met bestaande K3-functies. De mogelijke upgrade is relevant als deze de efficiëntie van redeneren, de betrouwbaarheid bij lange contexten en de kosten per afgeronde taak verbetert; alleen configuratielabels kunnen die verbeteringen niet aantonen.
Key Takeaways
- Timing release: oktober is een door media gemelde mogelijkheid, zonder door de aangehaalde bronnen bevestigde officiële lanceringsverplichting.
- Technische aanwijzingen: Low / High / Max en een gerapporteerde optie van 1M tokens overlappen met K3-capaciteiten; K3.1-architectuur en definitieve limieten blijven onbevestigd.
- Agent-workflows: Agent-, Swarm-, search- en batch-flags duiden mogelijk op integratiewerk in plaats van gemeten verbeteringen.
- Prestaties en prijzen: Gepubliceerde K3-resultaten en -tarieven zijn referentie-baselines, geen K3.1-benchmarks of -tarieven.
- API-gereedheid: Bevestig ingeschakelde model-ID’s, gedocumenteerde parameters en accounttoegang voordat je K3.1 via CometAPI uitrolt.
What is Kimi K3.1?
Kimi K3.1 is een gerapporteerde volgende iteratie van Moonshot AI’s Kimi-modelfamilie. Gelekte configuratie-identifiers suggereren werk aan redeneren, lange context en agent-workflows. De definitieve specificaties, releasedatum en prijsstelling zijn niet vastgesteld door de beoordeelde bronnen, dus het moet worden behandeld als een toekomstig model in plaats van een bevestigde publieke release.
What Do We Know About Kimi K3.1?
(Laatste community-rapporten per 23 oktober 2026)
Kimi K3.1 is de verwachte opvolger van Moonshot AI’s Kimi K3 (vrijgegeven op 16 juli 2026 — een 2,8T-parameter open-weight MoE-model met 1M context). Er zijn geen officiële specificaties, prijzen, benchmarks of releasedatum door Moonshot aangekondigd. Alles hieronder is community-gebaseerd bewijs en speculatie.
Quiet Testing on Arena Under Codename “Kibitz”
Een anoniem model genaamd Kibitz verscheen in LMSYS / Arena.ai coding battles rond 21–22 oktober 2026.
Community-bewijs wijst sterk erop dat het om een Moonshot/Kimi-model gaat:
- Het identificeert zichzelf als Kimi wanneer daarom gevraagd.
- Tokenizer-fingerprinttests tonen aan dat het faalt op alle 11 Moonshot-only testtokens (exact zoals eerdere Kimi-modellen); modellen van andere labs slagen wel.
- Naamgevingspatroon komt overeen met eerdere stealth-tests: K2.5 → Kiwido, K2.6 → Kiwire, K3 → Kivine, en nu Kibitz.
- De interne config van Kimi Code toonde kort een model-switchdoel genaamd “k3.1” (en een migratieregel van K3-sessies).
Early user tests (vooral 3D/voxelgeneratie, SVG, Three.js-scenes en complexe frontend-taken) werden beschreven als zeer sterk — soms dicht bij Claude Opus 5.5 Medium of concurrerend met Fable 5.1 / GPT-6 Astra, met merkbaar snellere generatie in sommige gevallen.
Arena.ai zelf postte: “Er komt een nieuw model van @Kimi_Moonshot. Blijf op de hoogte van waar het in de Arena terechtkomt.”
Official 24-Second Teaser Video (October 23, 2026)
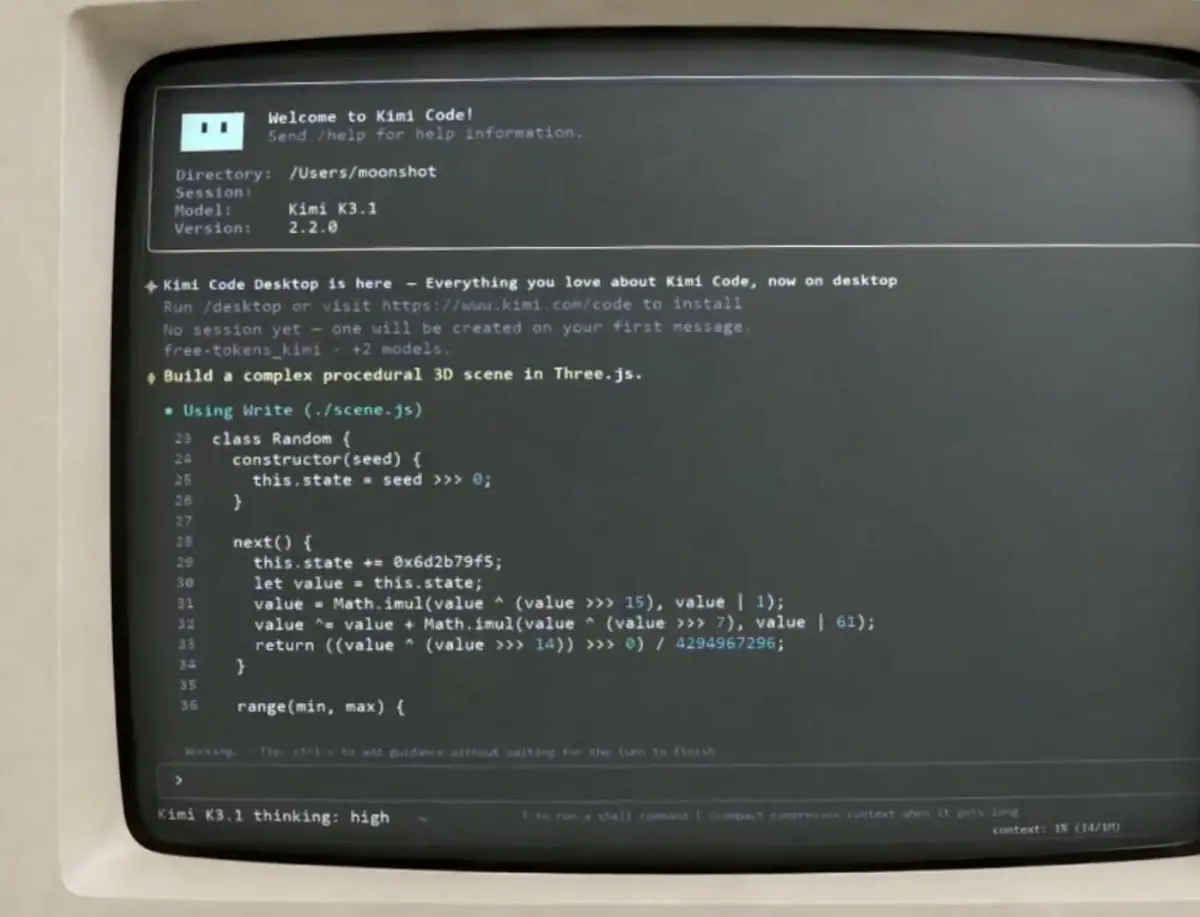
Op 23 oktober 2026 plaatste het officiële account @Kimi_Moonshot een 24-seconden durende teaser in retrostijl zonder bijschrift.
Het toont een vintage CRT-monitor waarop Kimi Code (versie 2.2.0) draait. De modelselector vermeldt duidelijk “Kimi K3.1”, met thinking ingesteld op “high” en een 1M context-indicator. Het model krijgt de prompt om een complexe procedurele 3D-scene in Three.js te genereren.
Dit is de eerste keer dat Moonshot publiekelijk de naam “Kimi K3.1” toont. Er werden geen aanvullende details (releasedatum, omvang, prijs of gewichten) verstrekt. De post kreeg snel veel engagement.
Other Supporting Clues
- Eind september 2026: ontwikkelaars zagen een “kimi-k3-1”-identifier op de API-backend van Moonshot.
- Een kortlevende SGLang pull request (binnen enkele minuten gesloten) verwees naar een live DeepInfra Kimi-K3.1-deployment, inclusief een nieuw “medium” thinking-effortniveau en image input.
- Community-lekkers (bijv. @ChrisGPT) claimen dat het een goedkope, state-of-the-art open-source model zal zijn en mogelijk vóór aanstaande dinsdag kan verschijnen (dus zeer binnenkort). Een veel gedeelde Minecraft self-portrait test claimde dramatisch betere kostenefficiëntie dan GPT-6 Astra, hoewel deze cijfers niet officieel zijn.
Current Status Summary
- Niet uitgebracht — geen modelcard, API-endpoint, prijzen, gewichten of officiële aankondiging tot nu toe.
- Sterkste signalen: Kibitz-testen op Arena + officiële teaser video met de naam.
- Verwachte focus (gebaseerd op K3-voorgeschiedenis en community-geluiden): verbeterde agentische coding op lange horizon, 3D/creatieve generatie, efficiëntie en mogelijk lagere kosten dan K3.
- Historisch patroon: K3 verscheen zelf anoniem op Arena (~30 uur) vóór de officiële lancering.
De community-consensus is dat een volledige release aanstaande is (dagen in plaats van weken), maar niets is bevestigd totdat Moonshot dit bekendmaakt.
When Will Kimi K3.1 Be Released?
De geraadpleegde bronnen leggen geen officiële releasedatum voor Kimi K3.1 vast. IT Home meldt oktober 2026, terwijl de eerdere berichtgeving van Wccftech “voor oktober” zegt. Dit zijn uiteenlopende media-voorspellingen, geen geverifieerde ontwikkelplanning. Een screenshot kan geen uitroldata, accountgeschiktheid of deploy-gereedheid vaststellen.
Zoek naar een gedateerde aankondiging van Moonshot, ondersteunde model-ID’s, ontwikkelaarsdocumentatie en toegangsvoorwaarden voordat je een lanceringsdatum als bevestigd beschouwt. Prijzen en reproduceerbare K3.1-specifieke evaluaties zijn afzonderlijk bewijs dat nodig is voor deploy-beslissingen.
What Specifications Could Kimi K3.1 Offer?
De sterkste technische baseline is de bestaande Kimi K3, een release uit juli 2026 met een sparse MoE-architectuur met 2,8 biljoen parameters, native visuele input en een contextvenster dat doorgaans als 1M tokens wordt beschreven. De aangehaalde bronnen leggen geen K3.1-architectuur, aantal parameters of model-specifieke evaluatieresultaten vast.
Moonshot’s officiële modelsamenvatting specificeert 104B geactiveerde parameters en een contextvenster van 1.048.576 tokens. De open-weight aankondiging van 27 juli bevestigt de vrijgave van K3-gewichten. Deze specificaties gelden voor K3, niet voor het geruchtmakende K3.1.
| Specificatie | Kimi K3 | Kimi K3.1 |
|---|---|---|
| Release | juli 2026 | Mogelijk oktober 2026 |
| Totaal aantal parameters | 2,8 biljoen | Niet bekendgemaakt |
| Geactiveerde parameters | 104 miljard (officiële modelsamenvatting) | Niet bekendgemaakt |
| Architectuur | Sparse MoE, KDA, AttnRes | Niet bekendgemaakt |
| Context | 1.048.576 tokens (ongeveer 1M) | Tot 1M gesuggereerd |
| Redenering | Low / High / Max in huidige Kimi Code-documentatie | Low / High / Max-flags |
| Visie | Native visuele input | Niet bevestigd |
| Swarm | Bestaande Kimi Swarm-capability | Swarm-flag naar verluidt aanwezig |
| API-prijs | Gepubliceerd K3-tarief | Geen definitieve prijs |
| Gewichten | K3-gewichten vrijgegeven | Onbekend |
What Features Are Reported for Kimi K3.1?
De drie onderstaande thema’s combineren de gerapporteerde K3.1-aanwijzingen met gedocumenteerde K3-capabilities. Ze leggen uit wat de instellingen zouden kunnen betekenen, zonder geruchtmakende K3.1-functies als bevestigde specificaties te presenteren.
Three reasoning levels provide an effort trade-off
Low, High en Max zijn gerapporteerde K3.1-configuratielabels. Ze beschrijven een afweging in inspanning, niet een nieuwe architectuur. Huidige Kimi Code-documentatie ondersteunt low / high / max voor K3, met high als standaard. Dit is een Kimi Code-instelling; veronderstel niet dat defaults en rechten identiek zijn in elke API of elk product.
Low kan geschikt zijn voor extractie, eenvoudige Q&A en routineclassificatie wanneer lagere latency belangrijk is. High kan een praktische balans bieden voor meerstaps ontwikkeling en documentwerk. Max kan meer redeneringsbudget toewijzen aan moeilijke coding- of onderzoekstaken, met hogere latency en mogelijke kosten. Deze taaktoewijzingen zijn interpretaties om te testen, geen geverifieerde garanties voor K3.1.
Deze workloadvoorbeelden zijn analytische interpretaties, geen geverifieerde K3.1-servicegaranties. Ontwikkelaars moeten kwaliteit per bestede eenheid vergelijken: een high-effort run kan meer per poging kosten, maar minder retries kunnen de totale workflowkosten verlagen. De betekenisvolle upgrade zou verbeterd taalsucces zijn bij een vergelijkbaar token- en toolbudget.
A 1M-token option extends the long-context baseline
Een venster van een miljoen tokens kan aanzienlijke code-repositories, lange technische documenten, projectgeschiedenissen en uitgebreide tooltraces omvatten. Maar maximale contextlengte is niet hetzelfde als accurate benutting van verre informatie. Een productief model moet nog steeds de juiste feiten ophalen, consistentie over documenten behouden en de prefill-latentie beheersbaar houden.
Evalueer lange context door retrieval te testen op verschillende promptposities, consistentie over documenten en tijd tot eerste token. Meet ook cache-hergebruik en de kosten van het behouden of comprimeren van agentgeschiedenis. Een nominale 1M-tokenlimiet is alleen nuttig als het model verre evidence nauwkeurig kan terugvinden binnen acceptabele latency en budget.
Moonshot rapporteert een K3 BrowseComp-score van 90,4 met een 1M-tokencontext en zonder contextmanagement. Dit is een specifieke K3-evaluatieconditie, onderscheiden van resultaten met gecomprimeerde context en van elke K3.1-prestatieclaim.
Agent and Swarm flags suggest coordinated task execution
De agent-gerelateerde identifiers en Swarm-flags zijn vermoedelijk interessanter dan het contextgetal. Kimi ondersteunt al multi-agentwerk; daarom zou een veronderstelde upgrade routing, delegatie, resultaataggregatie en kostencontrole moeten verbeteren in plaats van alleen een Swarm-label toe te voegen.
In een plausibele georkestreerde workflow breekt een coördinator een complexe aanvraag op in research-, coding-, test- en synthese-subtaken. Gespecialiseerde workers draaien parallel, leveren evidence aan en worden door de coördinator verzoend. Zulke parallelisatie kan de doorlooptijd verminderen terwijl het totale aantal modelcalls toeneemt, dus wall-clock snelheid en kosten moeten apart worden gerapporteerd.
Kimi’s officiële Agent Swarm-documentatie beschrijft bestaande parallelle agent-executie. Het onderstaande voorbeeld illustreert hoe zulke orkestratie het werk kan opdelen; het stelt niet de definitieve configuratie van K3.1 of een vereiste Swarm-topologie vast.
Een research-worker kan bronnen ophalen en citaties verifiëren; een coding-worker kan modules aanpassen en execution-evidence teruggeven; een analyse-worker kan alternatieven vergelijken met reproduceerbare berekeningen. Een coördinator wijst taken toe, verzoent meningsverschillen en begrenst het budget. De output van elke worker moet worden geverifieerd voordat het gecombineerde resultaat wordt geaccepteerd.
Voor K3.1 moeten ontwikkelaars uitkijken naar reproduceerbare benchmarks van succesvolle end-to-end agenttaken, failover, afhandeling van meningsverschillen tussen agents, aantal tool-calls en totale uitgaven. Alleen configuratie-flags kunnen geen verbetering vaststellen.
How Does Kimi K3.1 Compare with K3 on Benchmarks?
Er is geen geverifieerde K3.1-specifieke benchmarktabel beschikbaar. De volgende cijfers zijn afkomstig uit Moonshot’s officiële K3-evaluaties, uitsluitend weergegeven als vergelijking-baseline. Verschillende modelharnassen en beoordelingsinstellingen beperken strikte “apples-to-apples”-inferentie.
| Benchmark | Kimi K3 | GPT-5.6 Sol | Claude Fable 5 |
|---|---|---|---|
| DeepSWE | 67,5 | 73,0 | 70,0 |
| Terminal-Bench 2.1 | 88,3 | 88,8 | 88,0 |
| FrontierSWE | 81,2 | 71,3 | 86,6 |
| Program Bench | 77,8 | 77,6 | 76,8 |
| Kimi Code Bench 2.0 | 72,9 | 64,8 | 76,9 |
| SWE Marathon | 42,0 | 39,0 | 35,0 |
Bronverschil: de oorspronkelijke visual toont Fable 5 op 84,6 voor Terminal-Bench 2.1, terwijl de officiële repository-evaluatietabel 88,0 rapporteert. De bovenstaande tabel volgt de repository; de officiële afbeelding is zonder wijzigingen gereproduceerd.
De evaluatie-opmerkingen specificeren K3 max effort, temperature 1,0 en top-p 1,0. DeepSWE v1.1 gebruikt hier Kimi Code; het afzonderlijk aangehaalde mini-SWE-agentresultaat is 67,3. Terminal-Bench gebruikt Kimi Code voor K3, Terminus 2 voor Fable 5 en Codex voor Sol. FrontierSWE gebruikt Kimi Code/Codex en dominantie-scores van 16 juli; ProgramBench gebruikt Kimi Code voor K3. KCB 2.0 gebruikt Kimi Code/Claude Code voor K3 en Claude Code/Codex voor Fable/Sol. SWE Marathon gebruikt een H20-gekalibreerde v1.1-branch met Claude Code/Codex; Fable had fallbacks op 35% van de taken. Dit zijn door leveranciers gerapporteerde resultaten onder verschillende harnassen.
Raadpleeg de officiële evaluatie-opmerkingen voor het volledige protocol van elke benchmark; de cijfers leggen geen gecontroleerde K3.1-vergelijking vast.
K3 is in deze set bijzonder competitief op Program Bench en SWE Marathon, terwijl de relatieve leiders per test verschillen. K3.1 kan niet als sneller of nauwkeuriger worden bestempeld totdat er tests zijn gepubliceerd met een gedocumenteerd agentharnas, redeneringsbudget en evaluatiedatum.
What Could Kimi K3.1 API Pricing Look Like?
Het officiële K3-lanceringstarief is $0,30 cached input, $3 ongecachede input en $15 output per miljoen tokens. De volgende tabel noteert dat referentieschema, niet een geverifieerd huidig K3.1-tarief. K3.1-tarieven en eventuele orkestratiekosten vereisen afzonderlijke bevestiging.
| Metriek | Kimi K3 API in CometAPI (referentie bij officiële lancering) | Kimi K3.1 API in CometAPI (onbevestigd tarief) |
|---|---|---|
| Cached input | US$0,30 / 1M tokens | Onbevestigd |
| Uncached input | US$3,00 / 1M tokens | Onbevestigd |
| Output | US$15,00 / 1M tokens | Onbevestigd |
| Agent-orkestratie | Afhankelijk van daadwerkelijk gebruik | Onbevestigd |
Tegen deze K3-referentietarieven zouden 100.000 ongecachede inputtokens plus 10.000 outputtokens US$0,45 kosten. Dit is een illustratief K3-rekenvoorbeeld, geen K3.1-prijs. Voor enterprise-planning moet je kosten per geverifieerde taak gebruiken in plaats van alleen tokens.
How Can Developers Prepare for Kimi K3.1 API Access?
Access checks come before integration
Ontwikkelaars kunnen Kimi K3.1 API in CometAPI volgen voor toegangsupdates. Op 9 oktober 2026 vermeldde de beschikbaarheidssectie van de pagina nog Coming Soon, naast generieke endpoint- en health-tekst. Behandel die inconsistente pagina als een ontdekkingslink; bevestig een ingeschakelde model-ID en een geslaagde test op accountniveau voordat je productie-toegang veronderstelt.
A launch checklist guides the deployment decision
| Vraag | Nu beschikbare aanwijzingen | Benodigde bevestiging |
|---|---|---|
| Release? | Lekrapporten in september | Moonshot-releaseaankondiging |
| Nieuwe architectuur? | Geen K3.1 modelcard | Technisch rapport en parameters |
| Betere redenering? | Drie bekende effort-modes | Kwaliteit/kosten vs K3 per niveau |
| Betere lange context? | Gerapporteerde 1M-optie | Nauwkeurigheid en latency bij 1M |
| Betere multi-agent? | Agent/Swarm-configuratie-flags | Agent-succes- en kostbenchmarks |
| API-productietoegang? | Coming Soon-indicator | Ondersteunde ID’s, docs, prijzen |
Voorbereiding kan starten met draagbare evaluaties en een begrensd testbudget. Migratie moet wachten op gedocumenteerde toegang en herhaalbare verbeteringen op workloadoverdracht. De beslissingsvraag is of K3.1 geaccepteerde resultaten betrouwbaarder en economischer oplevert, niet of er een cataloguspagina of configuratie-flag bestaat.
FAQs
How can developers verify Kimi K3.1 access?
Bevestig de ondersteunde model-ID van de provider en de accountrechten, voer vervolgens een kleine request uit en inspecteer de teruggegeven modelidentifier, usage en errors. Een geslaagde call verifieert toegang voor dat account en die route op dat moment; een catalogusvermelding of health-label alleen bewijst geen publieke lancering of stabiel quotum.
Can Kimi K3.1 replace K3 in an existing agent?
Behandel migratie als een compatibiliteitswijziging. Controleer toolschemas, afhandeling van redeneringsgeschiedenis, outputformaten en timeoutgedrag voordat je representatieve taken opnieuw afspeelt. Gebruik een vastgezette baseline en behoud rollback-routing. Een vergelijkbare modelnaam of contextlimiet is onvoldoende bewijs dat langlopende sessies identiek zullen gedragen.
How should teams budget for a Kimi K3.1 pilot?
Begin met een begrensde taakset in plaats van een geruchtmakende tokenprijs te extrapoleren. Volg ongecachede input, cache-hits, redenerings-/outputtokens, toolcalls, retries en tijd voor menselijke correctie. Reserveer een vast evaluatiebudget en vergelijk kosten per geaccepteerd resultaat nadat definitieve tarieven zijn gedocumenteerd.
What would count as a meaningful Kimi K3.1 upgrade?
Vereis herhaalbare winst op je workload bij vergelijkbare redenerings- en toolbudgetten. Test retrieval van verre evidence, conflicterende documenten, agentherstel en end-to-end taakacceptatie. Registreer faalpercentage, latency en totale uitgaven samen; een groter nominaal venster of extra configuratie-flag alleen is onvoldoende.
Conclusion
Kimi K3.1 moet het best worden behandeld als een gerapporteerde, prospectieve release. Het beoordeelde bewijs identificeert mogelijke configuratiewerkzaamheden, terwijl K3 al lange context, verstelbare inspanning en Swarm-executie biedt. De praktische kans is betere taakkwaliteit tegen duurzame kosten. Bereid nu draagbare evaluaties voor en neem migratiebeslissingen nadat officiële specificaties, toegangsvoorwaarden, prijzen en reproduceerbare K3.1-resultaten beschikbaar zijn.
