TL;DR
Implementeer Kimi K3.1 Pro op een Linux GPU-server en verbind vervolgens een lokale applicatie met het inference-endpoint. Deze walkthrough gebruikt één NVIDIA B300-node met acht GPU’s en vLLM. Je hebt shell-toegang tot de server nodig, compatibele drivers en opslagruimte voor het volledige checkpoint. Begin met één kort tekstverzoek voordat je langere input of agent-workflows test.
Zonder geschikte GPU’s kun je je applicatie lokaal draaien en verbinden met de officiële Kimi-API of een derde partij zoals CometAPI.
Belangrijkste punten
- De 104B actieve parameters van het model vertegenwoordigen niet de volledige opslagvereiste.
- Hardwarecompatibiliteit omvat GPU-geheugen, interconnects, quantization-ondersteuning en inference-kernels.
- Sterke benchmarkresultaten maken het model het testen waard, maar garanderen niet dezelfde prestaties in jouw applicatie.
- Een werkend inference-endpoint bevat niet automatisch een browser, code-sandbox of complete agent-runtime.
- Vergelijk self-hosting en API-toegang op kosten per succesvolle taak, inclusief retries en onderhoud.
Wat is Kimi K3.1 Pro?
Kimi K3.1 Pro is Moonshot AI’s open-weight multimodaal model voor codering, documentanalyse en toolgebruik. De belangrijkste specificaties staan hieronder, gebaseerd op de officiële modelkaart.
| Specificatie | Gepubliceerde configuratie |
|---|---|
| Architectuur | MoE; 2,8T totale parameters, 104B actief |
| Attention | 93 lagen: 69 KDA + 24 Gated DSA |
| Experts | 896 gerouteerd; 16 geselecteerd per token; 2 gedeeld |
| Context | 1.048.576 tokens |
| Invoer | Tekst en afbeeldingen; MoonViT-V2 vision-encoder |
| Quantization | MXFP4 gewichten / MXFP8 activaties; mixed-precision checkpoint |
| Aanbevolen engines | vLLM, SGLang, TokenSpeed |
Het model activeert 104B parameters per token, maar deployment vereist nog steeds het volledige checkpoint met 2,8T parameters. De inference-engine moet ook de KDA- en Gated DSA-lagen en MXFP4-quantization ondersteunen.
Welke hardware heb je lokaal nodig voor Kimi K3.1 Pro?
De onderstaande tabel vat de vLLM-configuraties samen die relevant zijn voor deze gids. De walkthrough gebruikt één B300-node met acht GPU’s; GB300- en AMD-deployments vereisen hun bijbehorende configuraties.
| Hardware | Gedocumenteerd pad | Planningsnotities |
|---|---|---|
| NVIDIA B300 | Eén node met acht GPU’s, TP8 | Baseline voor de walkthrough hieronder |
| NVIDIA GB300 | Acht GPU’s over twee trays, TP8 | Vereist multi-node-configuratie en interconnect-instelling |
| AMD MI355X | Node met acht GPU’s en AMD-specifieke config | Gebruik het ROCm/AITER-pad; hergebruik NVIDIA-omgeving niet |
| Consumenten-GPU 24–32 GB | Onvoldoende voor direct laden van volledig checkpoint | Niet praktisch als doel voor deze tutorial |
Ter indicatie: 2,8T parameters nemen ongeveer 5,6 TB in bij BF16, 2,8 TB bij acht bits of 1,4 TB bij een geïdealiseerde vier bits. Dit zijn ruwe opslagberekeningen voor parameters, geen werkelijke checkpointgroottes of runtime-VRAM-minima. Mixed precision en metadata beïnvloeden de bestandsgrootte; cache en runtime-allocaties verhogen de serving-vereiste.
Reserveer NVMe-capaciteit voor de volledige download, tijdelijke bestanden en een rollback-kopie. Valideer op multi-node-systemen de communicatie voordat je het model laadt.
Hoe implementeer je Kimi K3.1 Pro
Gebruik self-hosting als je geschikte hardware hebt; begin anders met een hosted API. De onderstaande stappen gebruiken vLLM; aan het einde van deze sectie staat SGLang als alternatief. Vergelijk hostingkosten nadat je één werkend verzoek hebt.
Voer de setup-, download-, launch- en verificatieopdrachten uit in een Bash-shell op de GPU-server. Als je vanaf een laptop werkt, maak dan eerst een SSH-verbinding met die server. De Python-client kan later op beide machines draaien met de onderstaande verbindingsinstructies.
Deze walkthrough volgt het officiële deployment-recept; hij is niet onafhankelijk getest voor dit artikel.
1. Controleer GPU-zichtbaarheid, opslag en connectiviteit
Begin met basale infrastructuurchecks:
nvidia-smi
nvidia-smi topo -m
df -h
Bevestig dat alle doel-GPU’s zichtbaar zijn en dat de modelmap voldoende ruimte heeft. Reserveer extra opslag voor downloadcaches, logs en toekomstige checkpointversies.
Controleer bij multi-node-deployments de communicatie tussen nodes voordat je het model probeert te starten.
Houd de eerste mijlpaal klein: laad het checkpoint en voltooi één kort tekstverzoek. Dit maakt het eenvoudiger om fouten te diagnosticeren.
2. Bereid de serving-omgeving voor
Gebruik voor dit single-nodevoorbeeld een Linux-host met acht B300-GPU’s. Maak in een CUDA-omgeving die compatibel is met het gepubliceerde recept een geïsoleerde omgeving en installeer de serving-tools:
python3 -m venv kimi-env
source kimi-env/bin/activate
python -m pip install --upgrade pip
python -m pip install --upgrade huggingface_hub
python -m pip install "vllm>=0.34.0" fastsafetensors
python -c "import vllm; print(vllm.__version__)"
De minimumversie garandeert geen compatibiliteit met elke driver of wheel. Als het hardwarerecept een dedicated container of build vereist, gebruik dan die omgeving. Pin de succesvol geteste versie vóór productie.
3. Download het volledige checkpoint
Installeer de Hugging Face CLI en download de modelrepository:
python -m pip install --upgrade huggingface_hub

hf download moonshotai/Kimi-K3.1-Pro \
  --local-dir /srv/models/Kimi-K3.1-Pro
Bewaar de configuratie-, tokenizer-, processorbestanden en gewichtindex naast de weight-shards. Alleen geselecteerde tensorbestanden kopiëren kan de deployment onvolledig achterlaten.
Leg voor reproduceerbare productie-deployments de repository-revisie vast die je hebt gevalideerd en pin deze. Bekijk de aangepaste licentie van de repository vóór commercieel gebruik.
4. Start de vLLM-server
Het officiële recept specificeert vLLM 0.34.0 of later. Begin met de hardwarespecifieke omgevingsconfiguratie en pin vervolgens de versie en dependencies die jouw tests doorstaan.
Gebruik na het voorbereiden van de omgeving het volgende basiscommando. Het start achtvoudige tensorparallelisme en beperkt het initiële contextvenster tot 32.768 tokens:
export VLLM_ENGINE_READY_TIMEOUT_S=3600

vllm serve /srv/models/Kimi-K3.1-Pro \
  --served-model-name kimi-local \
  --tensor-parallel-size 8 \
  --trust-remote-code \
  --load-format fastsafetensors \
  --enable-auto-tool-choice \
  --tool-call-parser kimi_k3 \
  --reasoning-parser kimi_k3 \
  --max-model-len 32768 \
  --host 127.0.0.1 \
  --port 8000
De naam kimi-local is een naar de applicatie gerichte alias. Gebruik dezelfde naam in volgende verzoeken.
De instelling van 32.768 tokens is een conservatief startpunt voor deze walkthrough, niet de maximale context die het model ondersteunt.
De optie --trust-remote-code staat toe dat aangepaste repositorycode wordt geladen. Combineer dit met een beoordeelde, gepinde checkpointrevisie.
Hier verwijst 127.0.0.1 naar de machine die de client draait. De onderstaande curl-checks worden op de GPU-server uitgevoerd, waar ze het inference-proces bereiken. Om de Python-client vanaf je laptop te gebruiken, open je in een aparte laptopterminal een SSH-tunnel en laat je die actief:
ssh -N -L 8000:127.0.0.1:8000 user@gpu-server
Vervang user@gpu-server door je SSH-login en serveradres. Met deze tunnel kan de laptopclient http://127.0.0.1:8000/v1 gebruiken. Als poort 8000 al bezet is op de laptop, kies dan een andere lokale poort en werk de client-URL bij.
5. Verifieer het lokale endpoint
Controleer of de server het model aanbiedt:
curl http://127.0.0.1:8000/v1/models
Verstuur vervolgens een kort completion-verzoek:
curl http://127.0.0.1:8000/v1/chat/completions \
  -H "Content-Type: application/json" \
  -d '{
    "model": "kimi-local",
    "messages": [
      {
        "role": "user",
        "content": "Leg uit wat database-indexen zijn in drie zinnen."
      }
    ],
    "reasoning_effort": "low",
    "max_tokens": 2048
  }'
Controleer de response en serverlogs op:
- De verwachte modelnaam.
- Een definitief antwoord in de response.
- Een finish_reason die aangeeft of de generatie voltooid is of de limiet bereikte.
- GPU-geheugen- of unsupported-operation-fouten.
Reasoning kan een deel van het generatiebudget verbruiken. Als het verzoek zijn limiet bereikt voordat een definitief antwoord is geproduceerd, verhoog dan het budget en probeer opnieuw voordat je concludeert dat de server defect is.
6. Verbind een lokale Python-applicatie
python -m pip install openai
from openai import OpenAI

client = OpenAI(
    base_url="http://127.0.0.1:8000/v1",
    api_key="EMPTY",
    timeout=300.0,
    max_retries=1,
)
response = client.chat.completions.create(
    model="kimi-local",
    messages=[{"role": "user", "content": "Schrijf een Python-functie die dubbele bestandsnamen verwijdert met behoud van de volgorde."}],
    reasoning_effort="low",
    max_tokens=2048,
)
print(response.choices[0].message.content)
print(response.choices[0].finish_reason)
EMPTY is een placeholder voor deze loopback-only server zonder API-sleutelauthenticatie. Gebruik je geconfigureerde referentie voor een geauthenticeerd endpoint. Valideer afbeeldingsinvoer en toolexecutie afzonderlijk voordat je een agent aansluit.
SGLang-alternatief
Gebruik voor SGLang het officiële hardwarespecifieke kookboek. Selecteer B300, Unified en Low-Latency (TP8) voor de dichtstbijzijnde match met deze single-node walkthrough. Controleer de weergegeven verificatiestatus; een gegenereerde configuratie is niet per se een geteste configuratie.
Installeer op de GPU-server Docker en configureer NVIDIA Container Toolkit, maak vervolgens een container met het gedownloade checkpoint aangekoppeld op /models/Kimi-K3.1-Pro. Stop vLLM eerst, zodat beide engines niet om dezelfde GPU’s concurreren.
docker pull lmsysorg/sglang:dev-kimi-k31-pro
docker run --rm -it --gpus all \
  --shm-size 32g --ipc=host \
  -p 127.0.0.1:30000:30000 \
  -v /srv/models/Kimi-K3.1-Pro:/models/Kimi-K3.1-Pro:ro \
  lmsysorg/sglang:dev-kimi-k31-pro bash
Plak binnen de container het volledige startcommando dat door het kookboek voor jouw geselecteerde configuratie is gegenereerd. Vervang het modelpad door /models/Kimi-K3.1-Pro, stel de service-host in op 0.0.0.0 en de poort op 30000, en behoud de hardwarespecifieke vlaggen. De container moet op zijn netwerkinterface luisteren om Docker port-forwarding te laten werken; de hostzijdepoort hierboven blijft aan loopback gebonden. Wacht op het service-ready-bericht voordat je test.
Voer in een tweede shell op de GPU-server de aangeboden modellenlijst op en verstuur vervolgens een verzoek met de exacte model-ID die is teruggegeven:
curl http://127.0.0.1:30000/v1/models

MODEL_ID="replace-with-id-from-models-response"
curl http://127.0.0.1:30000/v1/chat/completions \
  -H "Content-Type: application/json" \
  -d "{\"model\":\"$MODEL_ID\",\"messages\":[{\"role\":\"user\",\"content\":\"Leg uit wat database-indexen zijn in drie zinnen.\"}],\"reasoning_effort\":\"low\",\"max_tokens\":2048}"
Een succesvolle response zou een definitief antwoord moeten bevatten. Als het opstarten mislukt, inspecteer dan de containerlogs en bevestig dat het geselecteerde hardwarerecept en image overeenkomen. Gebruik voor laptoptoegang hetzelfde SSH-tunnelpatroon met poort 30000. Zie de SGLang Docker-installatiegids voor de containervereisten.
Hoe presteert Kimi K3.1 Pro op benchmarks?
Gebruik de officiële evaluatieresultaten hieronder om taken voor je deploymenttest te kiezen. Deze scores beschrijven de gepubliceerde evaluatie-setup; ze meten niet de lokaal geconfigureerde server uit deze gids.
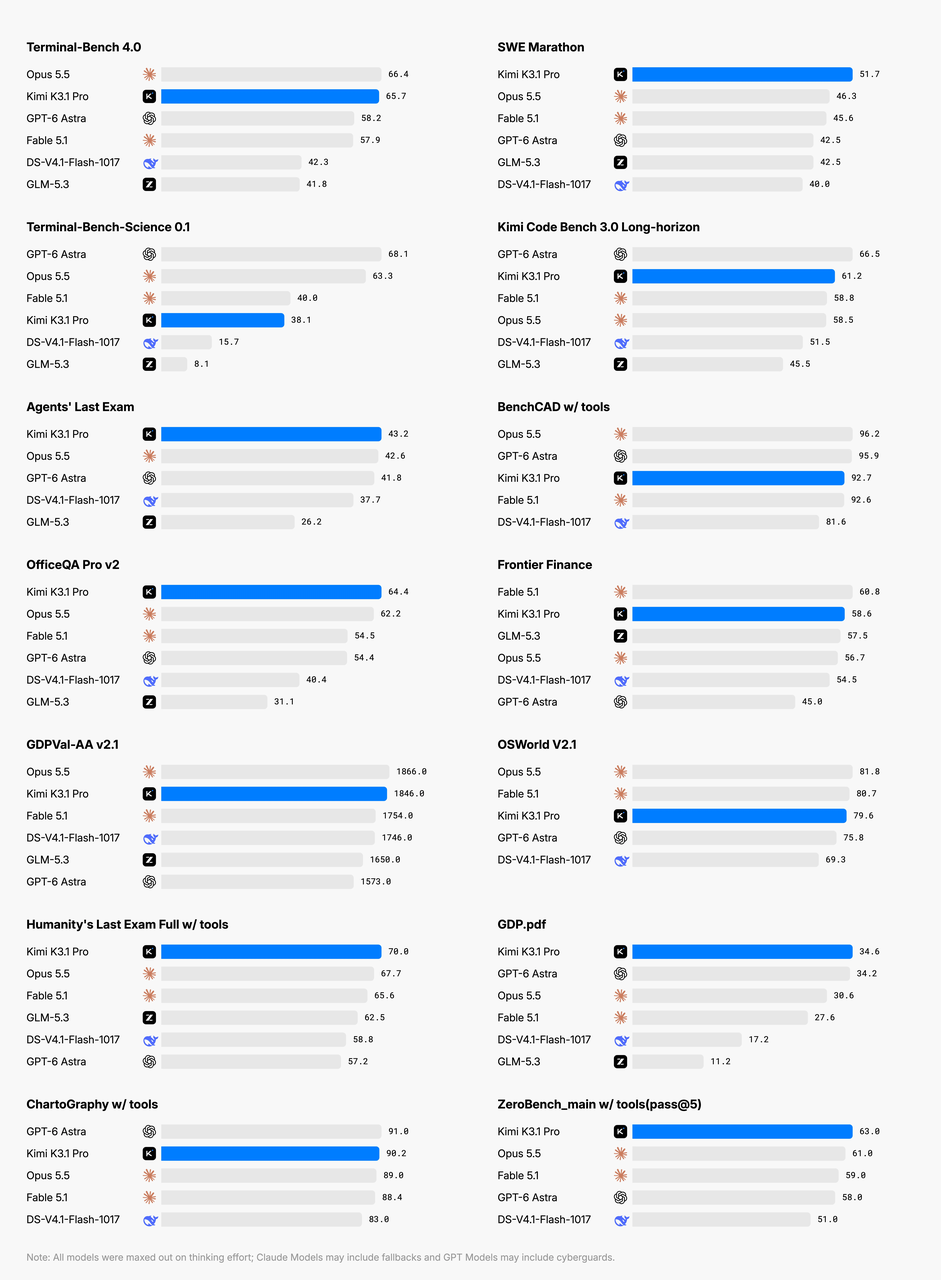
De volgende tabel toont geselecteerde resultaten en hun posities binnen de vergelijkingsset die in de modelkaart is gepubliceerd.
| Benchmark en officiële resultaten | Modelscore | Positie binnen die vergelijking |
|---|---|---|
| Terminal-Bench 4.0 | 65,7 | Tweede |
| SWE Marathon v1.1 | 51,7 | Eerste |
| Program Bench | 31,5 | Vierde |
| OfficeQA Pro v2 | 64,4 | Eerste onder gerapporteerde resultaten |
| Frontier Finance | 58,6 | Tweede |
De resultaten ondersteunen het testen van het model voor uitgebreide engineeringstaken en documentworkflows. Kimi K3.1 Pro voert deze vergelijking aan op SWE Marathon maar staat vierde op ProgramBench, waardoor beide nuttige kandidaten zijn voor toepassingsspecifiek testen.
Deze posities zijn berekend binnen de officiële vergelijkende tabel, niet een live wereldwijde ranglijst. Evaluatiekaders, tools, reasoningbudgetten en steekproefselectie verschillen per benchmark.
Voor een deploy-beslissing bouw je een kleine evaluatieset op basis van echt werk: repository-fixes, vragen over meerdere documenten en meerstaps tooltaken. Meet de kwaliteit van voltooiing, menselijke correcties en verstreken tijd. Gepubliceerde scores zijn nuttig voor de voorselectie; toepassingsspecifieke tests bepalen of de deployment de moeite waard is.
Hoe optimaliseer je lokale inference met Kimi K3.1 Pro?
Beheer context en gelijktijdigheid
Zodra korte verzoeken werken, test je langere documenten, afbeeldingen, meerdaagse gesprekken en tool-aanroepen afzonderlijk.
Volg first-token latency, outputtokens per seconde en piek-GPU-geheugen bij jouw beoogde contextlengte en gelijktijdigheid. Registreer ook taaksucces en kosten per succesvolle taak, zodat snellere output niet meer retries of menselijke correcties maskeert.
Verander één grote variabele per keer. Contextlengte, gelijktijdigheid en optimalisatie-instellingen tegelijk verhogen maakt prestatieregressies moeilijk uit te leggen.
Kies reasoning effort en cache-instellingen bewust
Gebruik low, high of max reasoning effort afhankelijk van de taak. Begin met low voor interfacechecks, vergelijk vervolgens high en max op moeilijke taken met zowel de kwaliteit van de voltooiing als de verstreken tijd. Een langere reasoning-trace is op zichzelf geen bewijs van een beter resultaat.
Evalueer voor lange sessies de cachecapaciteit en prefix-hergebruik voordat je speculatieve decodering of meer gelijktijdigheid toevoegt. Houd een bekende, goede baseline aan en verander één instelling per keer.
Waarom kan tool-aanroep mislukken na deployment van Kimi K3.1 Pro?
Je applicatie voert tool-aanroepen uit, retourneert hun resultaten en zet het gesprek voort. Bewaar het volledige assistant-bericht — inclusief reasoning_content en tool_calls — en retourneer elk toolresultaat met de bijbehorende tool_call_id.
Meerdere interacties zijn ook van belang. De gebruiksinstructies van het model vereisen het behouden van het volledige assistant-bericht, inclusief reasoning- en tool-call-velden, in plaats van alleen de uiteindelijke tekst.
| Symptoom | Eerste checks |
|---|---|
| Niet-herkende modelarchitectuur | Runtimeversie, aangepaste code en configuratie |
| Out of memory tijdens laden | GPU-capaciteit, parallelisme en concurrerende processen |
| Korte verzoeken werken maar lange falen | Contextlimiet, cachecapaciteit en gelijktijdigheid |
| Tool-aanroepen niet te parsen | Parserinstellingen en toolschema |
| De agent stopt na het vragen van een tool | Applicatie-executie en afhandeling toolresultaat |
| Inconsistente antwoorden over meerdere beurten | Ontbrekende velden in het assistant-bericht |
Gebruik een minimaal reproduceerbaar verzoek om elke fout te isoleren. Als dat werkt, voeg je de extra instellingen van de applicatie één voor één weer toe.
Zelf-hosting of een hosted API gebruiken?
Kies self-hosting wanneer je controle nodig hebt over gewichten, infrastructuur of datalocatie en je de GPU’s nuttig bezet kunt houden. Vergelijk voor een eerste evaluatie of variabele vraag de officiële Kimi-API en CometAPI met dezelfde prompts en acceptatiecriteria. Bevestig per service modeltoegang, ondersteunde parameters, quota en gegevensverwerkingsvoorwaarden.
| Kosten- of operationele factor | Self-hosted | Officiële Kimi API / CometAPI |
|---|---|---|
| Capaciteitskosten | Aankoop of huur van GPU’s, inclusief idle-tijd | API-gebruik gefactureerd; controleer actuele tarieven |
| Opslag en netwerk | Checkpointopslag, cache en netwerkverkeer | Eventuele opslag en netwerkverkeer aan applicatiekant |
| Operaties | Deployment, monitoring, upgrades en herstel | Integratie, quotabeheer en request-monitoring |
| Retries | Tel hun GPU-tijd mee in compute-kosten | Tel hun tokens of calls mee in API-kosten |
| Menselijke review | Tel correctietijd met hetzelfde tarief | Tel correctietijd met hetzelfde tarief |
| Beste fit | Constante vraag en infrastructuurcontrole | Evaluatie en variabele vraag |
Een nuttige vergelijking is:
Kosten per succesvolle taak = (GPU-compute of API-kosten + opslag en netwerk + operaties + menselijke correctie) / succesvol voltooide taken.
Gebruik kosten en aantallen succesvolle taken uit dezelfde meetperiode. Neem mislukte pogingen en retries eenmaal op in de compute- of API-totaalpost; voeg geen tweede retry-kosten toe. Neem bij een hybride workflow zowel compute- als API-kosten op. Tel unieke voltooide taken, niet pogingen.
Een onderbenutte server kan duur blijven, zelfs bij uitstekende theoretische throughput. Omgekeerd kan een team met bestaande infrastructuur, constante vraag en strikte datavereisten veel waarde halen uit self-hosting.
Gebruik identieke prompts en acceptatiecriteria bij het vergelijken van deploy-routes. Neem end-to-end-latency en outputkwaliteit mee in de beslissing.
Probeer het hosted endpoint zonder gewichten te laden
De officiële Kimi API quickstart gebruikt het onderstaande endpoint. Stel MOONSHOT_API_KEY in je omgeving in en bevestig modeltoegang in je account. Dit verzoek draait op de infrastructuur van de provider.
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.environ["MOONSHOT_API_KEY"],
    base_url="https://api.moonshot.ai/v1",
)
response = client.chat.completions.create(
    model="kimi-k3.1-pro",
    messages=[{"role": "user", "content": "Leg uit wat database-indexen zijn in drie zinnen."}],
    reasoning_effort="low",
    max_completion_tokens=2048,
)
print(response.choices[0].message.content)
Voor de Kimi K3.1 Pro API in CometAPI stel je COMETAPI_API_KEY in je omgeving in en bevestig je dat je account toegang heeft tot het gevraagde model. Het verzoek draait extern:
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.environ["COMETAPI_API_KEY"],
    base_url="https://api.cometapi.com/v1",
)
response = client.chat.completions.create(
    model="kimi-k3.1-pro",
    messages=[{"role": "user", "content": "Leg uit wat database-indexen zijn in drie zinnen."}],
    max_tokens=2048,
)
print(response.choices[0].message.content)
Vergelijk het resultaat met je lokale endpoint met dezelfde acceptatiecriteria. Controleer de actuele prijs van de route en de ondersteunde parameters voordat je productiekosten schat.
Conclusie
Self-hosting van Kimi K3.1 Pro is haalbaar met een ondersteunde GPU-configuratie en de bijbehorende inference-omgeving. Gebruik de bovenstaande deploy-stappen om een werkend endpoint op te zetten en meet vervolgens taakkwaliteit, latency en kosten op je eigen workload. Kies een hosted API als je de applicatie nog valideert of geen geschikte hardware hebt.
FAQ
Kan een gewone laptop het volledige model draaien?
Een gewone laptop is geen praktisch doel voor de capaciteitsvereisten van het originele checkpoint. Hij kan fungeren als client die is verbonden met je eigen inference-server of een hosted API.
Telt het installeren van de desktopapplicatie als lokale deployment?
De installatielocatie van de applicatie bepaalt niet waar inference plaatsvindt. Self-hosting vereist dat de modelgewichten en het inference-proces draaien in infrastructuur die jij beheert.
Waarom heeft het model zoveel geheugen nodig als slechts 104B parameters actief zijn?
Verschillende tokens kunnen verschillende experts selecteren. Actieve parameters beschrijven deelname aan de berekening; de deployment moet nog steeds de volledige set gewichten opslaan en benaderen.
Kan ik meteen de volledige context van een miljoen tokens inschakelen?
Verhoog de contextlengte geleidelijk en meet het GPU-gehebruik bij jouw beoogde gelijktijdigheid. Het model ondersteunt 1.048.576 tokens, maar de bruikbare servingcapaciteit hangt af van je cache- en parallelisme-instellingen.
Zal de lokale deployment gepubliceerde benchmarkscores reproduceren?
Niet automatisch. Quantization, reasoningbudgetten, tools, prompts en evaluatiekaders kunnen allemaal resultaten beïnvloeden. Valideer de configuratie op je eigen taken.
Moet ik via een API testen voordat ik hardware aanschaf?
Als je nog niet hebt vastgesteld dat het model aan je kwaliteitsvereisten voldoet, biedt API-testen een eerste baseline met minder infrastructuurwerk. Teams met geschikte hardware en duidelijke data-residency-eisen kunnen direct doorgaan naar een gecontroleerde self-hosting-evaluatie.