TL;DR
Kimi K3.1 Pro is Moonshot AI’s upgrade van 24 oktober 2026 voor Kimi K3. Extra post-training verbetert autonoom coderen, financieel onderzoek en uitgebreide workflows met tools, terwijl dezelfde contextcapaciteit van circa één miljoen tokens behouden blijft.
Onafhankelijke evaluaties tonen een sterkere algehele prestatie, en de standaard officiële input-/output-tokenprijzen dalen met een derde. De upgrade vereist echter nog steeds werklasttests: dieper redeneren kan de taaklatentie en de totale uitgaven verhogen, terwijl K3 een kleine voorsprong behoudt op AA-LCR en momenteel beschikbare gewichten voor self-hosting.
Key Takeaways
- De duidelijkste verbeteringen zitten in agentmatige uitvoering. Artificial Analysis meldt Terminal-Bench 4.0-scores van circa 67% voor K3.1 Pro tegenover 13% voor K3; Moonshot’s interne Financial Research-scores stijgen van 58.8 naar 70.4.
- Lagere tokenprijzen garanderen geen lagere taakkosten. De standaard officiële input-/outputtarieven dalen van $3/$15 naar $2/$10 per miljoen tokens, maar extra redeneren, toolaanroepen en retries kunnen de besparingen tenietdoen.
- Het contextvenster blijft hetzelfde. Beide modellen ondersteunen tot 1,048,576 tokens. K3 blijft iets voor in de genoemde AA-LCR v1.1-evaluatie, dus test de nauwkeurigheid op lange context op je eigen documenten.
- Beschikbaarheid van gewichten kan de keuze bepalen. Per 24 oktober 2026 zijn K3-gewichten beschikbaar; K3.1 Pro-gewichten staan gepland voor release uiterlijk 4 november. Teams die direct self-hosting nodig hebben, moeten met dit verschil rekening houden.
Kimi K3.1 Pro vs Kimi K3: Overzicht en specificaties
Kimi K3.1 Pro bouwt voort op K3 via extra post-training, met verbeteringen gericht op coderen, financieel onderzoek en uitgebreide agent-workflows. Beide behouden ongeveer één miljoen tokens aan context. De belangrijkste verschillen zijn taakprestaties, tokenprijzen, serving-opties en beschikbaarheid van gewichten.
| Specificatie | Kimi K3.1 Pro | Kimi K3 |
|---|---|---|
| Ontwikkelaar | Moonshot AI | Moonshot AI |
| Releasedatum | October 24, 2026 | July 16, 2026 |
| Architectuur | Van K3 afgeleide MoE, verder post-getraind | MoE met KDA, AttnRes |
| Modelgrootte | 3T-klasse en 104B actieve parameters | 2.8T totaal en 104B actieve parameters |
| Contextvenster | Tot 1,048,576 tokens | Tot 1,048,576 tokens |
| Standaard API-prijs input / output | $2 / $10 per miljoen tokens | $3 / $15 per miljoen tokens |
| Highspeed-versie | Beschikbaar | Geen aparte K3 Highspeed-variant vermeld |
| Beschikbaarheid van gewichten | Release gepland uiterlijk November 4, 2026 | Beschikbaar onder de Kimi K3-licentie |
Beschikbaarheid van gewichten weerspiegelt de stand van zaken per October 24, 2026. API-prijzen zijn in USD voor reguliere input en output, exclusief cache-write-kosten, belastingen en andere toepasselijke vergoedingen.
Architectuur en post-training
K3 introduceerde een architectuur met 2.8 biljoen parameters die Kimi Delta Attention, Attention Residuals en Stable LatentMoE combineert. Het activeert circa 104 miljard parameters per token.
Moonshot beschrijft K3.1 Pro als een post-getrainde versie van K3, ontwikkeld met substantieel meer post-training compute. De upgrade richt zich op het toepassen van de capaciteiten van het model op meerstapstaken, waaronder toolgebruik, debuggen en resultaatverificatie. De aankondiging introduceert geen afzonderlijk benoemde basisarchitectuur.
Gedeelde mogelijkheden en API-vereisten
Beide modellen ondersteunen multimodale input, het aanroepen van tools, gestructureerde output en contextcaching. Formaten voor beeld- en video-invoer zijn afhankelijk van de gekozen API-route. Beide redeneren altijd en ondersteunen low, high en max redeneringsinspanning, met max als standaard.
Voor meer-ronde gesprekken en toolaanroepen moeten integraties volledige assistant-berichten behouden, inclusief redeneringsinhoud en toolaanroepen, zoals vereist door de API. Controleer ook de werkelijke contextlimieten en functiebeschikbaarheid voor de gekozen provider, het product en het abonnementsniveau.
Kimi K3.1 Pro vs Kimi K3: Prestaties
Het bewijs komt uit interne tests van Moonshot en gerapporteerde vergelijkingen, naast onafhankelijke evaluaties door derden.
Deze moeten afzonderlijk worden geïnterpreteerd omdat benchmark-harnassen, testsets, redeneringsinstellingen en beoordelingscriteria kunnen verschillen.
De lanceerevaluatie van Artificial Analysis rapporteert een stijging van 11 punten op de samengestelde Intelligence Index, met bijzonder grote verbeteringen bij terminal-gebaseerd coderen en agentmatige workflows.
| Onafhankelijke benchmark (Artificial Analysis) | Kimi K3 | Kimi K3.1 Pro | Verschil |
|---|---|---|---|
| Intelligence Index | 44 | 55 | +11 |
| Terminal-Bench 4.0 | ~13% | ~67% | +54 percentage points |
| AutomationBench-AA | 58% | 73% | +15 pp |
| GDPval-AA Elo | 1,534 | 1,846 | +312 |
| AA-Omniscience Index | 20 | 30 | +10 |
| Humanity's Last Exam | ~47% | ~52% | +5 pp |
| AA-Omniscience hallucination rate | 53% | 44% | −9 pp |
| AA-LCR v1.1 | 88.7% | 86.3% | −2.4 pp |
Dit zijn onafhankelijke evaluatieresultaten. Afgeronde waarden worden gebruikt waar de evaluator afgeronde scores rapporteert. Lagere hallucinatiegraad is beter.
De grootste verbetering treedt op bij terminal-gebaseerd coderen. K3.1 Pro presteert aanzienlijk beter op taken die commando-uitvoering, omgevingsinteractie, debuggen en herhaalde validatie vereisen.
AutomationBench-AA laat ook een significante winst zien, wat wijst op sterkere uitvoering in software-as-a-service-workflows.
Moonshot's release-benchmarks richten zich op coderen, wetenschap, 3D-reconstructie, financiën, kenniswerk en autonome agents.
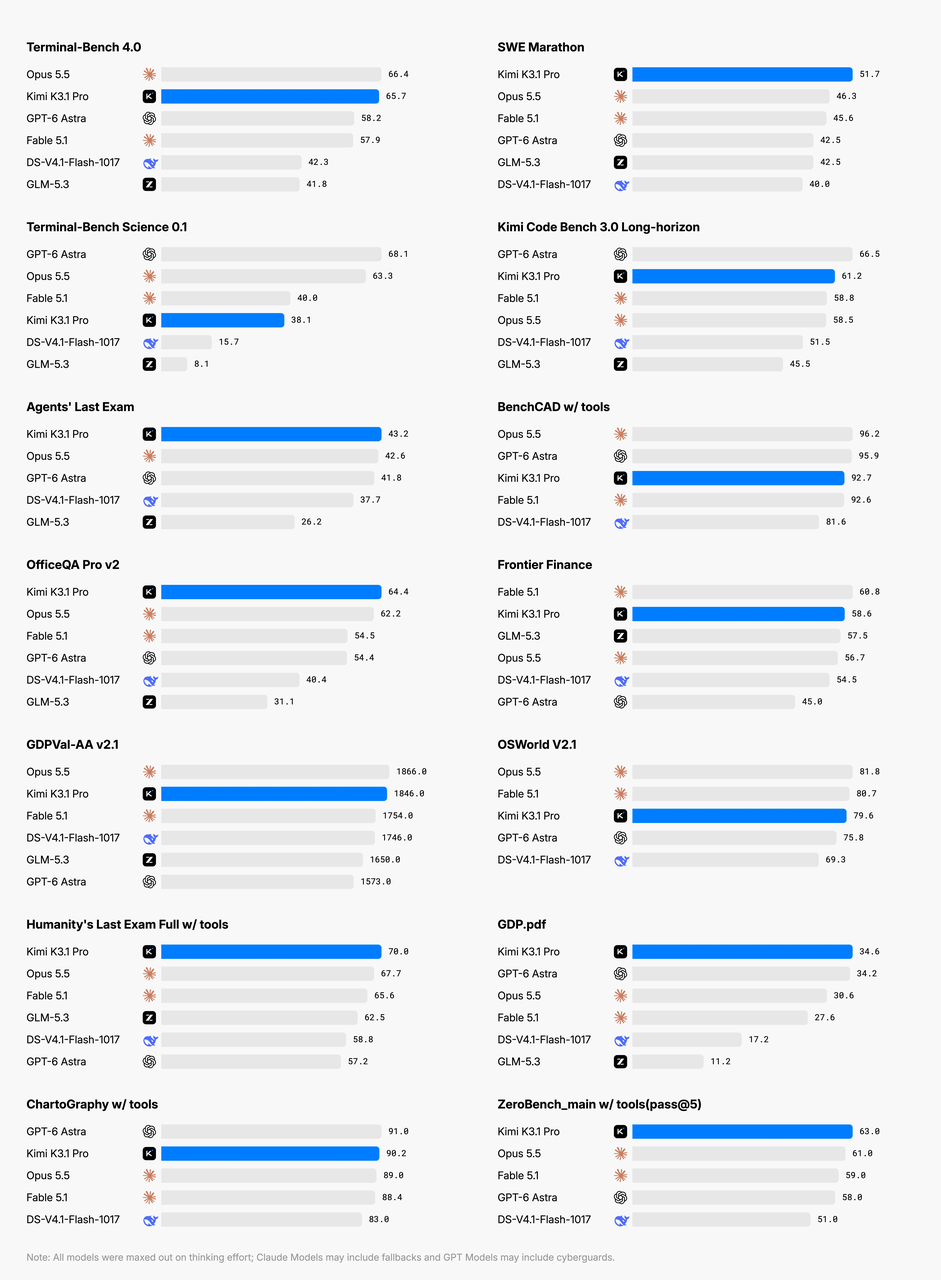
De geselecteerde vergelijkingen omvatten Claude Opus 5.5 en GPT-6 Astra. Vergelijk elk resultaat binnen de genoemde benchmark en opgegeven configuratie.
| Benchmark (Moonshot AI) | Kimi K3.1 Pro | Ander model | Score van vergelijkingsmodel |
|---|---|---|---|
| Terminal-Bench 4.0 | 65.7% | Claude Opus 5.5 | 66.4% |
| Terminal-Bench 4.0 | 65.7% | GPT-6 Astra | 58.2% |
| SWE-Marathon | 51.7% | Claude Opus 5.5 | 46.3% |
| Kimi Code Bench 3.0 | 61.2% | GPT-6 Astra | 66.5% |
| BenchCAD with tools | 92.7% | Claude Opus 5.5 | 96.2% |
| OfficeQA Pro v2 | 64.4 | Claude Opus 5.5 | 62.2 |
| Frontier Finance | 58.6 | Claude Opus 5.5 | 56.7 |
| OSWorld 2.1 | 79.6% | Claude Opus 5.5 | 81.8% |
K3.1 Pro nadert of overtreft verschillende toonaangevende proprietary modellen in geselecteerde taken. Maar het domineert niet elke categorie.
Zo blijft het achter op Claude Opus 5.5 in de door de leverancier gerapporteerde BenchCAD- en OSWorld-vergelijkingen, en de officiële grafiek toont een grotere zwakte in Terminal-Bench Science.
Evaluatie-opzetten verschillen: Artificial Analysis gebruikt de mini-swe-agent-harness voor Terminal-Bench 4.0, terwijl Moonshot Claude Code gebruikt. Vergelijk scores binnen dezelfde testopzet; harnesses, redeneringsinspanning en runtime-limieten kunnen de resultaten beïnvloeden.
Coderen en software-engineering
Voor complexe autonome codeertaken is K3.1 Pro over het algemeen de sterkere keuze.
Moonshot's interne Kimi Code Bench 3.0 Long-horizon-resultaten stijgen van 55.95% voor K3 naar 61.2% voor K3.1 Pro, een winst van ongeveer 5.25 procentpunt.
Onafhankelijke Terminal-Bench-resultaten tonen eveneens een substantiële winst. Deze tests beoordelen meerstapsexecutie: een repository begrijpen, bestanden wijzigen, commando’s uitvoeren, fouten diagnosticeren en het resultaat verifiëren.
K3.1 Pro is de sterkere kandidaat voor ontwikkeling met meerdere bestanden, autonoom terminalwerk en uitgebreide debugging. Voor eenvoudige codegeneratie: vergelijk beide modellen op je eigen taken; K3 blijft de directe optie wanneer self-hosting vereist is.
Een belangrijk onderscheid is dat scores op codeerbenchmarks sterk afhangen van het agentframework. Tools, prompts, runtime-limieten en testomgevingen beïnvloeden de uitkomst.
Voor softwareontwikkeling in productie blijft de beste evaluatie een gelijkwaardige vergelijking op je eigen repositories.
Financieel onderzoek en bedrijfsvoering
Financiële modellering biedt enkele van de duidelijkste directe vergelijkingen tussen de twee modellen.
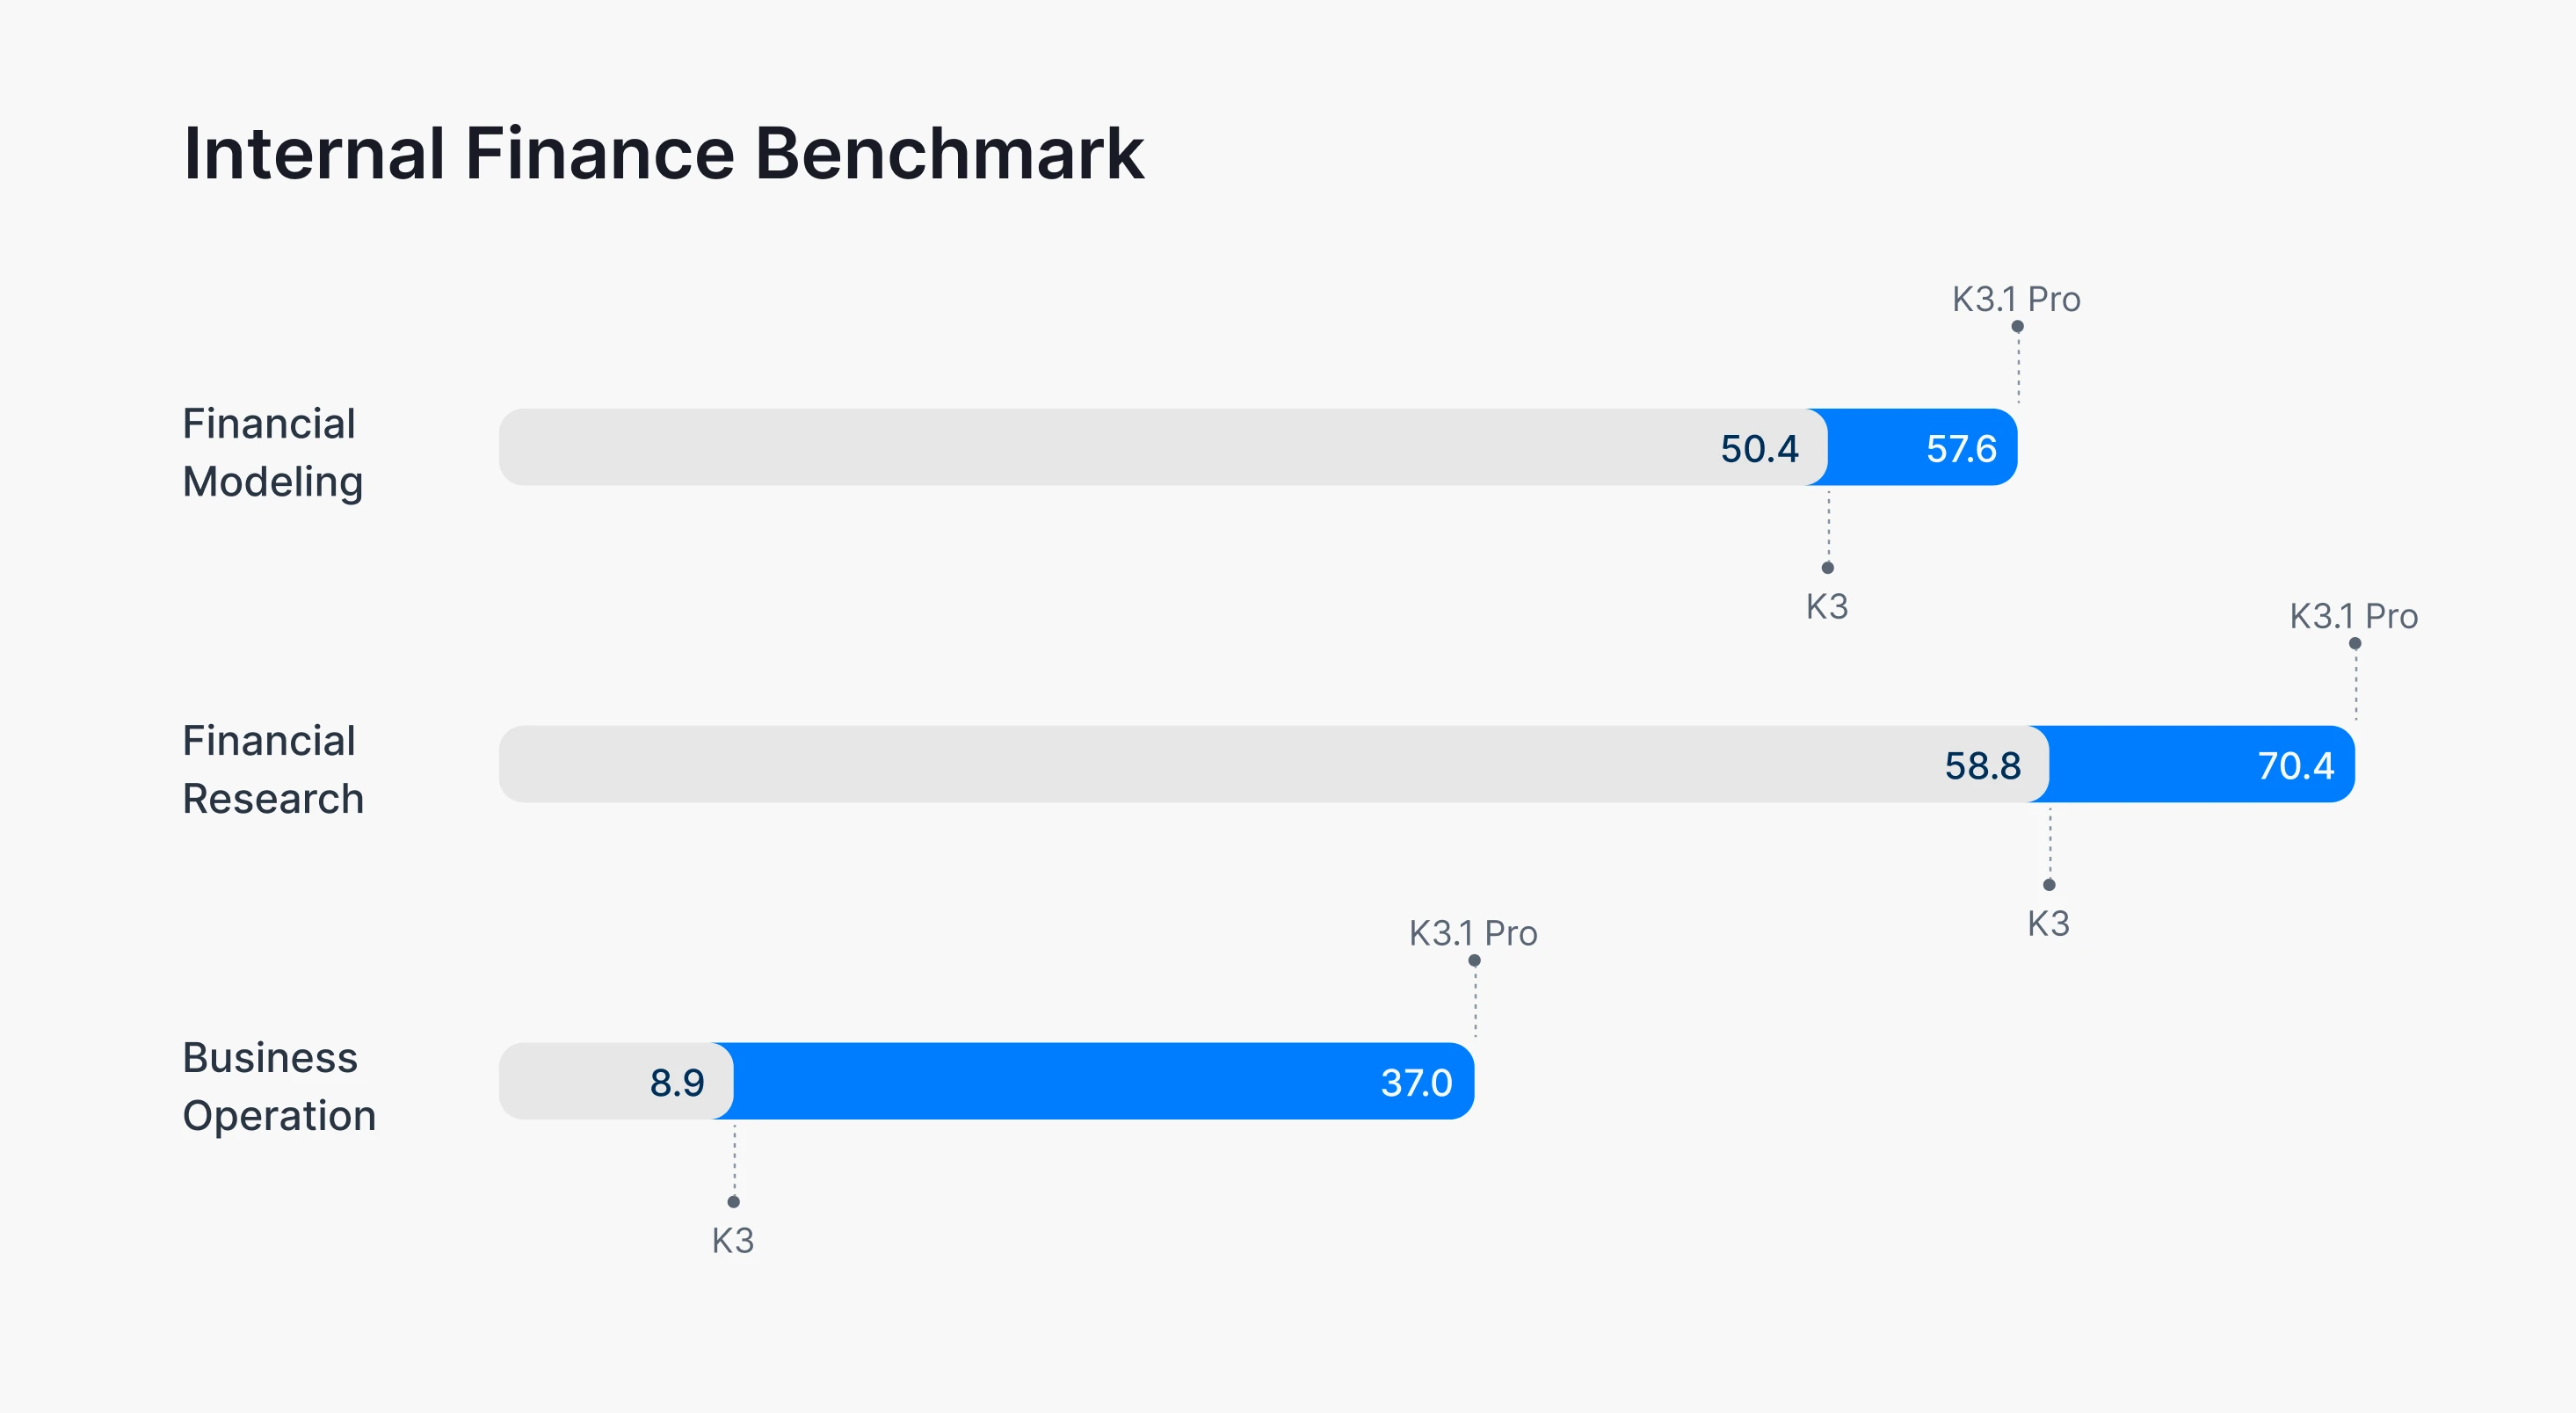
Moonshot testte zowel K3 als K3.1 Pro op interne evaluaties die spreadsheetconstructie, onderzoekskwaliteit en gesimuleerde bedrijfsvoering bestrijken.
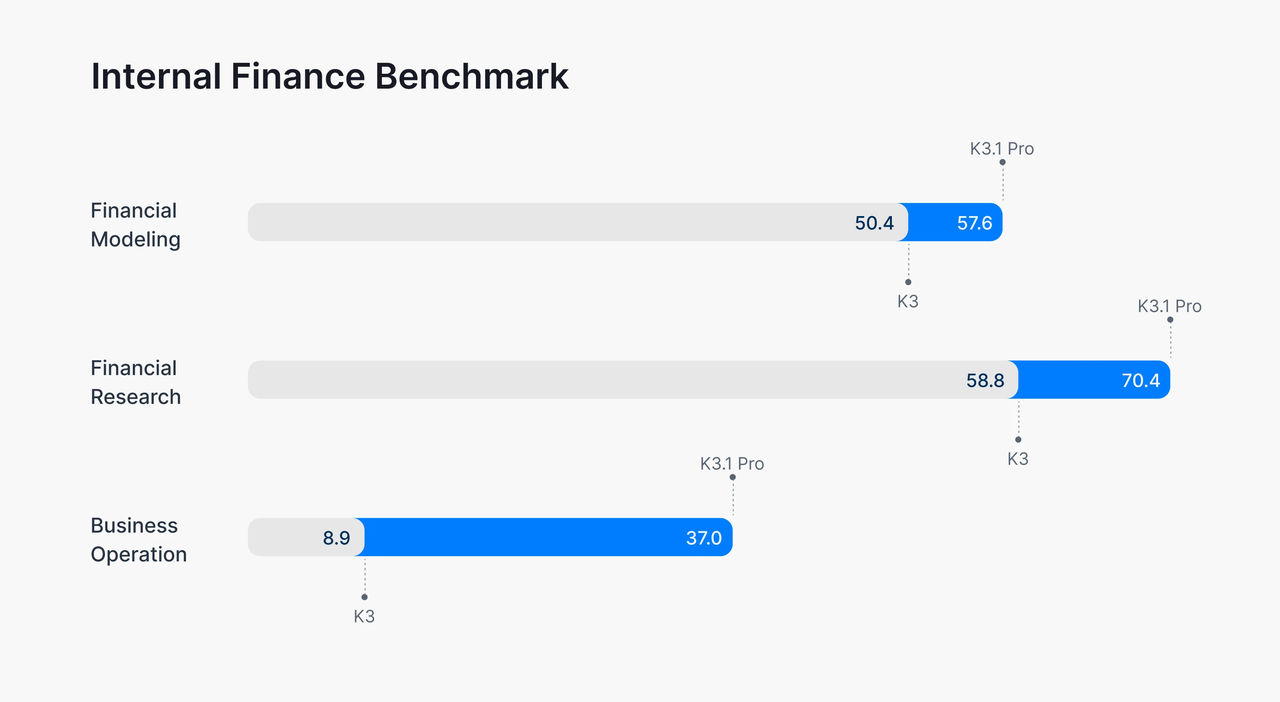
Moonshot's interne financiële resultaten bestrijken financiële modellering, onderzoek en gesimuleerde bedrijfsvoering. Deze door de leverancier gerapporteerde taakscores zijn geen maat voor beleggingsrendementen. Instellingen per taak moeten niet als identiek aan niet-gerelateerde benchmarks worden aangenomen.
In Moonshot's interne tests stijgt Financial Modeling van 50.4 naar 57.6, een winst van 7.2 punten, en Financial Research stijgt van 58.8 naar 70.4, een winst van 11.6 punten. Business Operation stijgt van 8.9 naar 37.0, circa 4.2 keer de K3-score.
Deze benchmark beoordeelt management en besluitvorming over een lange horizon in een gesimuleerde bedrijfsomgeving. Hij is daarom nauwer verwant aan agentmatige planning dan aan eenvoudig financieel vraag-antwoord.
Financial Research meet het vermogen om bewijsgebaseerd onderzoek te produceren met inachtneming van bronvereisten en informatiecutoffs. Financial Modeling richt zich op wiskundige relaties, spreadsheetlogica en de kwaliteit van werkboeken.
Het patroon suggereert dat K3.1 Pro bijzonder waardevol is wanneer financiële taken volgehouden redeneren, verificatie en gestructureerde deliverables vereisen.
Voor investeerders, analisten en zakelijke gebruikers is het praktische voordeel mogelijk een betere afhandeling van workflows met meerdere documenten. Geen van beide modellen mag worden gebruikt als onbetwistbare autoriteit voor financiële beslissingen.
Redeneren over lange context en feitelijke betrouwbaarheid
De AA-LCR-long-contextresultaten tonen K3 echter iets voor. Dit is een nuttige herinnering dat een nieuwer model in het algemeen sterk kan verbeteren zonder elke gespecialiseerde taak te winnen.
De gerapporteerde evaluaties tonen minder feitelijke fouten op hun respectieve testsets.
Op Kimi Hallu Bench Hard with tools rapporteert Moonshot dat de foutgraad op claimniveau daalde van 23.4% voor K3 naar 8.3% voor K3.1 Pro.
Dat is ongeveer een relatieve daling van 65% op Moonshot's bewust moeilijke stresstest, niet een schatting van alledaagse foutpercentages. Afzonderlijk meldt Artificial Analysis een daling in AA-Omniscience-hallucinatiegraad van 53% naar 44%. De twee evaluaties gebruiken verschillende methoden, dus hun percentages zijn niet direct vergelijkbaar.
De praktische les is dat K3.1 Pro betrouwbaarder lijkt op de geëvalueerde taken, maar feitelijke verbeteringen nemen de noodzaak voor retrieval, citaties, rekencontroles en menselijke review in belangrijke workflows niet weg.
Data-analyse: bewijs uit Plotly’s evaluatie
Plotly evalueerde standaard K3.1 Pro via OpenRouter met een private test van 43 vragen over een synthetisch wind-energie datawarehouse. Highspeed werd niet getest. De resultaten illustreren de afweging tussen antwoordkwaliteit, voltooiingstijd en kosten in die specifieke SQL-gebaseerde analytische workflow.
| Plotly-data-analysemaatstaf | Kimi K3 | Kimi K3.1 Pro |
|---|---|---|
| Juiste antwoorden | 35/43 | 42/43 |
| Nauwkeurigheid | 81.4% | 97.7% |
| Verborgen patronen ontdekt | 0/5 | 5/5 |
| Gegevenskwaliteitsproblemen geïdentificeerd | 1/3 | 3/3 |
| Totale evaluatiekosten | $5.01 | $13.47 |
| Mediaan tijd per vraag | 43 seconds | 2.5 minutes |
In deze evaluatie beantwoordde K3.1 Pro meer vragen correct en identificeerde het meer verborgen patronen en gegevenskwaliteitsproblemen, maar met hogere kosten en een langere mediane voltooiingstijd.
De gerapporteerde kosten zijn waargenomen evaluatiekosten, geen schattingen berekend op basis van Moonshot’s standaard API-prijzen. De gepubliceerde opzet toont niet aan dat alle providersettings identiek waren tussen de twee modelruns, dus de verschillen kunnen niet uitsluitend aan het model worden toegeschreven.
Deze resultaten ondersteunen het evalueren van K3.1 Pro voor analytische taken waarbij extra bevindingen meer tijd en uitgaven kunnen rechtvaardigen. Ze tonen niet dezelfde nauwkeurigheid of kosten advantag
Is Kimi K3.1 Pro sneller dan Kimi K3?
Maak onderscheid tussen output-token-doorvoer en end-to-end-taaklatentie.
Artificial Analysis rapporteert 73.5 outputtokens per seconde voor K3.1 Pro, vergeleken met 38.5 voor K3 bij maximale redeneringsinspanning, via Kimi’s API. Dit zijn metingen van tokengeneratie, gecontroleerd op October 24, 2026; de totale taaklatentie hangt ook af van de lengte van de redenering en de uitvoering van tools.
Snellere tokengeneratie garandeert echter niet snellere taakvoltooiing.
Moonshot biedt ook K3.1 Pro Highspeed, dat wordt geadverteerd als ongeveer twee tot drie keer snellere output dan de standaardvariant. Dit is een verbetering in serveersnelheid, geen afzonderlijk geverifieerde intelligentie-upgrade.
K3.1 Pro heeft een hogere gerapporteerde outputtoken-doorvoer, maar voltooit niet noodzakelijkerwijs taken sneller. Maak onderscheid tussen de snelheid van tokengeneratie en de tijd die nodig is om te redeneren, tools aan te roepen en het werk te voltooien.
Outputsnelheid vs. tijd tot taakvoltooiing
Artificial Analysis rapporteert outputsnelheden van 73.5 tokens per seconde voor K3.1 Pro en 38.5 voor K3 bij maximale redeneringsinspanning, via Kimi’s API. Deze metingen zijn gecontroleerd op October 24, 2026 en beschrijven tokengeneratiedoorvoer in plaats van end-to-end-taaklatentie.
Een model kan sneller tokens genereren en toch langer duren als het meer redeneringstokens produceert of extra toolaanroepen uitvoert. In de hierboven besproken Plotly-evaluatie was K3.1 Pro’s mediane voltooiingstijd 2.5 minuten per vraag, vergeleken met 43 seconden voor K3, naast hogere nauwkeurigheid.
Voor interactieve toepassingen: meet time-to-first-token en totale tijd tot taakvoltooiing op de daadwerkelijke providerroute. Doorvoer alleen is niet voldoende om de responsiviteit te voorspellen.
Overweeg K3.1 Pro Highspeed
Moonshot adverteert K3.1 Pro Highspeed als ongeveer twee tot drie keer de outputsnelheid van standaard K3.1 Pro. Die claim betreft serveersnelheid; deze mag niet worden geïnterpreteerd als een twee- tot drievoudige reductie van de totale tijd tot taakvoltooiing.
Overweeg Highspeed voor interactief coderen of assistenten waarbij gebruikers wachten op respons. Vergelijk end-to-end-latentie, taalsucces en totale gefactureerde kosten met de standaardendpoint voordat je hiervoor kiest. Highspeed heeft hogere reguliere input- en outputtokenprijzen, terwijl het cached-input-tarief hetzelfde is.
Kimi K3.1 Pro vs Kimi K3: Kosten
Officiële API- en CometAPI-tarieven
De officiële input-, output- en cache-hit-tarieven van standaard K3.1 Pro liggen een derde lager dan die van K3. De vermelde CometAPI-input- en outputtarieven liggen nog eens 20% onder de overeenkomstige officiële tarieven.
| Model | Officiële input / 1M | Officiële output / 1M | Officiële cached input / 1M | CometAPI input / 1M | CometAPI output / 1M |
|---|---|---|---|---|---|
| Kimi K3.1 Pro | $2.00 | $10.00 | $0.20 | $1.60 | $8.00 |
| Kimi K3 | $3.00 | $15.00 | $0.30 | $2.40 | $12.00 |
| Kimi K3.1 Pro Highspeed | $4.00 | $20.00 | $0.20 | Check current quote | Check current quote |
USD per miljoen tokens; tarieven gecontroleerd op October 24, 2026. Inputkolommen tonen reguliere ongecachete inputtarieven. Belastingen en apart gefactureerde kosten zijn uitgesloten.
Officiële Kimi-prijzen vermelden ook cache-write-kosten: $2/$4 per miljoen tokens voor standaard Pro met 5-minuten/1-uur retentie, en $4/$8 voor Highspeed. Cache-hits, cache-writes en reguliere input zijn afzonderlijke, elkaar uitsluitende facturatiecategorieën.
Officiële Kimi en CometAPI zijn afzonderlijke providerroutes. Bevestig de actuele prijzen en cache-ondersteuning voor je gekozen route, inclusief Highspeed-beschikbaarheid. Vergelijk de totale gefactureerde taakkosten naast tokenprijzen.
Voorbeeld: vaste tokenkosten
Neem een werklast die 100,000 ongecachete inputtokens en 20,000 outputtokens verbruikt.
Voor deze vaste werklast bedragen de officiële API-kosten $0.60 met K3 en $0.40 met K3.1 Pro. Tegen de vermelde CometAPI-tarieven kosten dezelfde aantallen tokens respectievelijk $0.48 en $0.32. Deze totalen omvatten alleen de vermelde input- en outputtokens.
Maar dit is een vergelijking met vaste tokens. Complexe agentworkflows kunnen verschillende hoeveelheden redeneringstokens en toolaanroepen verbruiken, afhankelijk van het model.
Tokenbesparing verdwijnt
Laat I het identieke aantal ongecachete inputtokens zijn, O het gefactureerde aantal outputtokens van Kimi K3, en P het gefactureerde aantal outputtokens van Kimi K3.1 Pro, alle gemeten in miljoenen. Tegen de standaard officiële tarieven in de prijstabel zijn de kosten respectievelijk 3I + 15O en 2I + 10P dollar. Ze zijn gelijk wanneer P = 1.5O + 0.1I.
Voor outputzware verzoeken kan K3.1 Pro daarom ongeveer 50% meer gefactureerde outputtokens gebruiken voordat het zijn prijsvoordeel verliest. Deze berekening gaat uit van ongewijzigde tarieven en sluit caching, toolkosten en andere apart gefactureerde vormen van gebruik uit. Gebruik daadwerkelijke gefactureerde tokencategorieën in plaats van zichtbare antwoordlengte.
Kosten per succesvol voltooide taak
Bereken kosten per succesvolle taak als de totale gefactureerde kosten van alle evaluatiepogingen gedeeld door het aantal unieke taken dat voldoet aan een vooraf gedefinieerd acceptatiecriterium. Neem kosten van mislukte pogingen, retries en time-outs op wanneer de provider deze factureert; alleen de kosten van geslaagde runs delen door hun aantal kan de kosten per succes onderschatten.
Houd de taakset, acceptatiecriteria, retrylimiet en time-outbeleid gelijk tussen Kimi K3 en K3.1 Pro. Rapporteer het slagingspercentage naast kosten per succes, zodat het laten vervallen van moeilijke taken een model niet kunstmatig economisch doet lijken. Als geen enkele taak slaagt, is de kosten per succes ongedefinieerd, niet nul.
Kimi K3.1 Pro vs Kimi K3: Vergelijking en keuze
Voor de meeste gehoste agentworkloads is K3.1 Pro het sterkere startpunt. Desondanks moet de beslissing de taakcomplexiteit en implementatievereisten weerspiegelen.
| Use case | Aanbevolen model | Reden |
|---|---|---|
| Autonoom coderen | Kimi K3.1 Pro | Evalueer wijzigingen over meerdere bestanden, terminalwerk, debugging en uiteindelijke testuitkomsten. |
| Financieel onderzoek met meerdere documenten | Kimi K3.1 Pro | Verbeterde onderzoeks- en bedrijfsvoeringsbenchmarks |
| Complexe data-analyse | Kimi K3.1 Pro | Betere probleemontdekking en testen van gegevenskwaliteit |
| 3D-creatie en CAD-workflows | Kimi K3.1 Pro | Sterke gespecialiseerde, tool-ondersteunde capaciteiten |
| Eenvoudige teksttaken | Benchmark beide | Vergelijk routinetekst en eenvoudige codeertaken op beide modellen; extra redeneren kan latentie toevoegen zonder een beter resultaat. |
| Nauwkeurigheid bij retrieval met lange context | Benchmark beide | K3 leidt licht in AA-LCR |
| Onmiddellijke self-hosting | Kimi K3 | Downloadbare gewichten reeds beschikbaar |
| Interactieve agenten met hoge capaciteiten | K3.1 Pro Highspeed | Snellere serving, onder voorbehoud van kostenvalidatie |
| Kostengevoelige productie-workflows | Benchmark beide | Lagere tokenprijzen hoeven niet te leiden tot lagere taakkosten |
Gehoste automatisering en professionele workflows
Voor gehoste codeeragenten en analytische workflows: evalueer K3.1 Pro op de moeilijke delen van het echte werk: wijzigingen over meerdere bestanden, bewijsverzameling, rekencontroles en herstel na een mislukte toolaanroep. Geef de voorkeur aan gemeten reducties in mislukte taken of correctiewerk boven alleen een hogere hoofdlijnscore.
Voor gevestigde K3-toepassingen: behoud de bestaande route als vergelijkingsbaseline. Routinetaken kunnen al aan de acceptatiedrempel voldoen, terwijl gespecialiseerde taken met lange context zich anders kunnen gedragen dan de geaggregeerde benchmarks. Geef prioriteit aan de werklastsegmenten waar een upgrade een meetbaar voordeel heeft.
Self-hosting en implementatiebeperkingen
Per October 24, 2026 zijn K3’s volledige gewichten beschikbaar voor implementatie, onder voorbehoud van de modellicentie en hardwarevereisten. K3.1 Pro’s volledige gewichten zijn nog niet gepubliceerd.
Moonshot is van plan om K3.1 Pro-gewichten uiterlijk November 4, 2026 te publiceren. Dit is een aangekondigd releaseplan, geen beschikbaar checkpoint; bevestig de gepubliceerde gewichten en toepasselijke voorwaarden voordat je self-hosting inplant.
Criteria voor productie-evaluatie
Vergelijk K3 en K3.1 Pro op representatieve taken met dezelfde prompts, tools, acceptatiecriteria, retrylimieten en time-outs. Noteer provider- en redeneringsinstellingen en bewaar volledige assistant-berichten zoals vereist door de API.
Meet taalsucces, latentie, tokenverbruik en kosten per succesvolle taak, inclusief gefactureerde mislukkingen en retries. Bekijk gevallen waarin K3 slaagt maar K3.1 Pro faalt. Verberg modellijsten en randomiseer de uitvoervolgorde bij menselijke evaluatie.
Als K3.1 Pro voldoet aan je kwaliteits-, latentie- en kostendrempels, rol het dan geleidelijk uit met een geteste K3-fallback.
Gecontroleerde migratie en fallbacks
Een praktische aanpak is om te beginnen met een klein percentage van het productieverkeer op K3.1 Pro.
Houd K3 beschikbaar als fallback tijdens de validatie. Vergelijk taakkwaliteit, latentie, faalpercentages en uitgaven voordat je het gebruik van K3.1 Pro opschaalt.
Let extra op tool-call-schema’s, aan redenering gerelateerde berichtvelden, multimodale input en outputparsing. API-compatibiliteit garandeert niet automatisch identiek applicatiegedrag.
Benchmark-winst en regressies
Als beide modellen dezelfde 43 vragen beantwoordden en 35 en 42 scoorden, had K3.1 Pro zeven K3-fouten kunnen corrigeren zonder regressies, of acht fouten terwijl één eerder goed antwoord verloren ging. De totale score alleen kan deze uitkomsten niet onderscheiden.
Inspecteer gepaarde antwoorden en classificeer ze als: beide correct, alleen K3 correct, alleen K3.1 Pro correct, of beide onjuist. Beoordeel de K3-only successen ten opzichte van je meest impactvolle taken voordat je migreert. Het 42/43-resultaat beschrijft die testset; het garandeert geen 97.7% succes op een andere werklast.
Blinde evaluatie van modeluitvoer
Verberg de modellabels en randomiseer de volgorde waarin reviewers de outputs zien. Definieer het acceptatiekader vóór de review: gebruik voor code uitvoerbare tests en regressiechecks; controleer voor onderzoek bronondersteuning, berekeningen en of het gevraagde deliverable compleet is. Scoor correctheid voordat je presentatie of schrijfstijl overweegt.
Open modelidentiteit, latentie en gefactureerde kosten pas nadat de kwaliteitsbeoordeling is vastgelegd. Dit scheidt outputkwaliteit van verwachtingen over het nieuwere model. Los recensentverschillen op aan de hand van dezelfde tests of bronmateriaal, en bewaar de beslissingen zodat een later model of promptwijziging consistent kan worden geëvalueerd.
Waar kun je Kimi K3.1 Pro en Kimi K3 gebruiken?
Toegang via de officiële provider
Gebruik de gedocumenteerde Kimi K3 API of Kimi K3.1 Pro API voor directe integratie bij de provider. Controleer de modelidentifier van de gekozen endpoint, ondersteunde requestvelden en accountlimieten. Openbare API-toegang en downloadbare modelgewichten zijn afzonderlijke implementatieopties.
Toegang via CometAPI
Ontwikkelaars kunnen via CometAPI’s uniforme interface toegang krijgen tot de Kimi K3.1 Pro API en Kimi K3 API en beide routes met dezelfde applicatiewerklast vergelijken.
Dit maakt K3-naar-K3.1 Pro-migratie relatief eenvoudig, vooral voor toepassingen die al een OpenAI-compatibele chatinterface gebruiken.
Om CometAPI te gebruiken, maak een account en API-sleutel aan en configureer je applicatie met de endpoint en modelidentifier in de integratiedocumentatie. Selecteer kimi-k3 voor K3, kimi-k3.1-pro voor standaard K3.1 Pro, of kimi-k3.1-pro-highspeed voor de Highspeed-route waar ondersteund. Begin met een klein verzoek en vergelijk vervolgens dezelfde werklast tussen modellen terwijl je de geretourneerde resultaten, latentie en gefactureerd gebruik controleert.
Conclusie
Kimi K3.1 Pro is de sterkere kandidaat voor veeleisend autonoom coderen, financieel onderzoek en uitgebreide agentworkflows in de hier besproken evaluaties. Kimi K3 blijft relevant voor directe self-hosting en werklasten waar de bestaande nauwkeurigheid of latentie al aan de eisen voldoet.
Kies op basis van representatieve taken en de daadwerkelijke providerroute. Vergelijk succesvolle uitkomsten, latentie en totale uitgaven en migreer vervolgens geleidelijk. Lagere tokenprijzen en hogere geaggregeerde benchmark-scores zijn nuttige startpunten, maar bepalen niet automatisch de beste configuratie voor elke toepassing.