TL;DR: Alibaba bracht op 16 november 2026 Qwen4-Max uit als het vlaggenschipmodel van de Qwen4-generatie. Officiële evaluaties melden betere prestaties op industriële taken en lagere uitvoeringskosten dan Qwen3.8-Max, wat verbeteringen in tokenefficiëntie en lagere API-prijzen weerspiegelt.
Belangrijkste punten
- Modelgrootte: Qwen4-Max heeft 2.4 biljoen backbone-parameters, met 71 miljard geactiveerd per token.
- Contextvenster: Qwen4-Max ondersteunt een contextvenster van één miljoen tokens.
- Multimodale ondersteuning: Qwen4-Max accepteert tekst, afbeeldingen en video en genereert tekst.
- Functies voor ontwikkelaars: Qwen4-Max ondersteunt functieaanroepen, gestructureerde uitvoer, contextcaching en webzoekopdrachten.
- Toegangsopties: Gebruikers hebben toegang tot Qwen4-Max via ondersteunde Qwen-apps, de verbruiksgebaseerde QwenCloud-API en Token Plan-abonnementen.
Wat is Qwen4-Max?
In de officiële aankondiging beschrijft Qwen Qwen4-Max als een AI-teamgenoot voor werk, creatie en verkenning. De capaciteiten richten zich op het begrijpen van doelen, het bedienen van tools, het reageren op uitvoeringsfeedback en het leveren van resultaten in meerdere stappen.
Voor deze workflows levert het model redenering en coördinatie. Verbonden applicaties, tools en uitvoeringsomgevingen voeren de handelingen uit.
Qwen4-Max-specificaties
De officiële QwenCloud-modelpagina vermeldt de volgende specificaties:
| Specificatie | Qwen4-Max |
|---|---|
| Model-ID | qwen4-max |
| Backbone-parameters | 2.4 biljoen |
| Geactiveerde parameters per token | 71 miljard |
| Contextvenster | 1 miljoen tokens |
| Invoer / uitvoer | Tekst, afbeeldingen en video / Tekst |
| Limieten in standaardmodus | Maximale input: 991K; maximale output: 131K tokens |
| Limieten in denkmodus | Maximale input: 983K; maximale output: 262K tokens |
| Maximale redeneerlengte | 262K tokens |
| Mogelijkheden voor ontwikkelaars | Functieaanroepen, gestructureerde uitvoer, contextcaching en webzoekopdrachten |
| API-compatibiliteit | OpenAI- en Anthropic-API-protocollen |
Contextgrootte, inputlimieten en outputlimieten vertegenwoordigen verschillende beperkingen. Applicaties moeten hier gezamenlijk aan voldoen en voldoende capaciteit reserveren voor gegenereerde antwoorden en redenering.
Wat zijn de belangrijkste functies van Qwen4-Max?
De mogelijkheden van Qwen4-Max zijn vooral relevant wanneer een taak meerdere documenten, tools en uitvoeringsstappen omvat. Een lang contextvenster bewaart de werkachtergrond, visueel begrip vergroot het beschikbare bewijs en agent-capaciteiten helpen de taak richting oplevering te sturen.
Context van één miljoen tokens en native visueel begrip
Het grote contextvenster maakt het mogelijk om gerelateerde materialen binnen een gedeelde werkcontext te verwerken. Praktische toepassingen omvatten het vergelijken van contracten, het analyseren van afhankelijkheden tussen codebestanden en het beoordelen van rapporten naast ondersteunende documenten.
Native visueel begrip strekt zich uit tot screenshots, diagrammen, gescande pagina’s en video. Een gebruiker kan een technische tekening of interfacescreenshot aanleveren en het model vragen deze te interpreteren naast schriftelijke vereisten.
Voor documentintensieve taken helpt het behouden van bestandsnamen, datums en sectielabels om het bewijs te organiseren en de resulterende analyse gemakkelijker verifieerbaar te maken.
Coderen en professioneel gebruik van tools
Qwen4-Max ondersteunt functieaanroepen, waardoor ontwikkelaars het kunnen verbinden met databases, zoekservices, bestandsoperaties en bedrijfssystemen. Gestructureerde uitvoer helpt modelresultaten door te geven aan daaropvolgende softwareprocessen.
Officiële demonstraties tonen bredere softwareworkflows. In gameontwikkeling gebruikt het model engines zoals Unity, Unreal Engine en Godot om scènes te bouwen, gameplay te implementeren en resultaten te verfijnen via testen. In Blender coördineert het geometrie, materialen, belichting en rendering.
Het reproduceren van deze workflows vereist de betreffende software, assets en uitvoeringsrechten. De demonstraties laten zien wat het model binnen die omgevingen kan bereiken.
Langetermijnagenten en Live Delivery
Lange taken worden moeilijk te beheren wanneer gebruikers de voortgang pas bij voltooiing kunnen inspecteren. De Live Delivery-aanpak van Qwen4-Max introduceert een initiële bruikbare uitkomst, gevolgd door opeenvolgende updates.
Voor een onderzoeksopdracht kan een agent eerst voorlopige bevindingen en een bronnenlijst leveren, vervolgens de analyse uitbreiden en grafieken toevoegen. Gebruikers kunnen elke versie beoordelen en het vervolgwerk bijsturen.
Qwen heeft ook de Qwen-Live-Delivery-Plugin uitgebracht. Voor workflows die uren of langer duren, creëert gefaseerde oplevering praktische controlemomenten om kwaliteit te beoordelen en de koers te corrigeren.
Architectuur en tokenefficiëntie
Qwen4-Max introduceert verschillende wijzigingen in zijn sparse mixture-of-experts-architectuur:
- Gated DeltaNet en Qwen Sparse Attention: combineren compressie van historische informatie met selectieve aandacht voor relevante context, wat rekenwerk voor lange sequenties vermindert.
- Gated Residual: gebruikt vier parallelle residuele takken en dynamische gates om informatieoverdracht en trainingsstabiliteit te verbeteren.
- N-gram Embedding: voegt 328 miljard embedding-parameters toe om lokale tokenpatronen via opzoekbewerkingen te representeren, waardoor capaciteit toeneemt met relatief weinig extra rekenwerk.
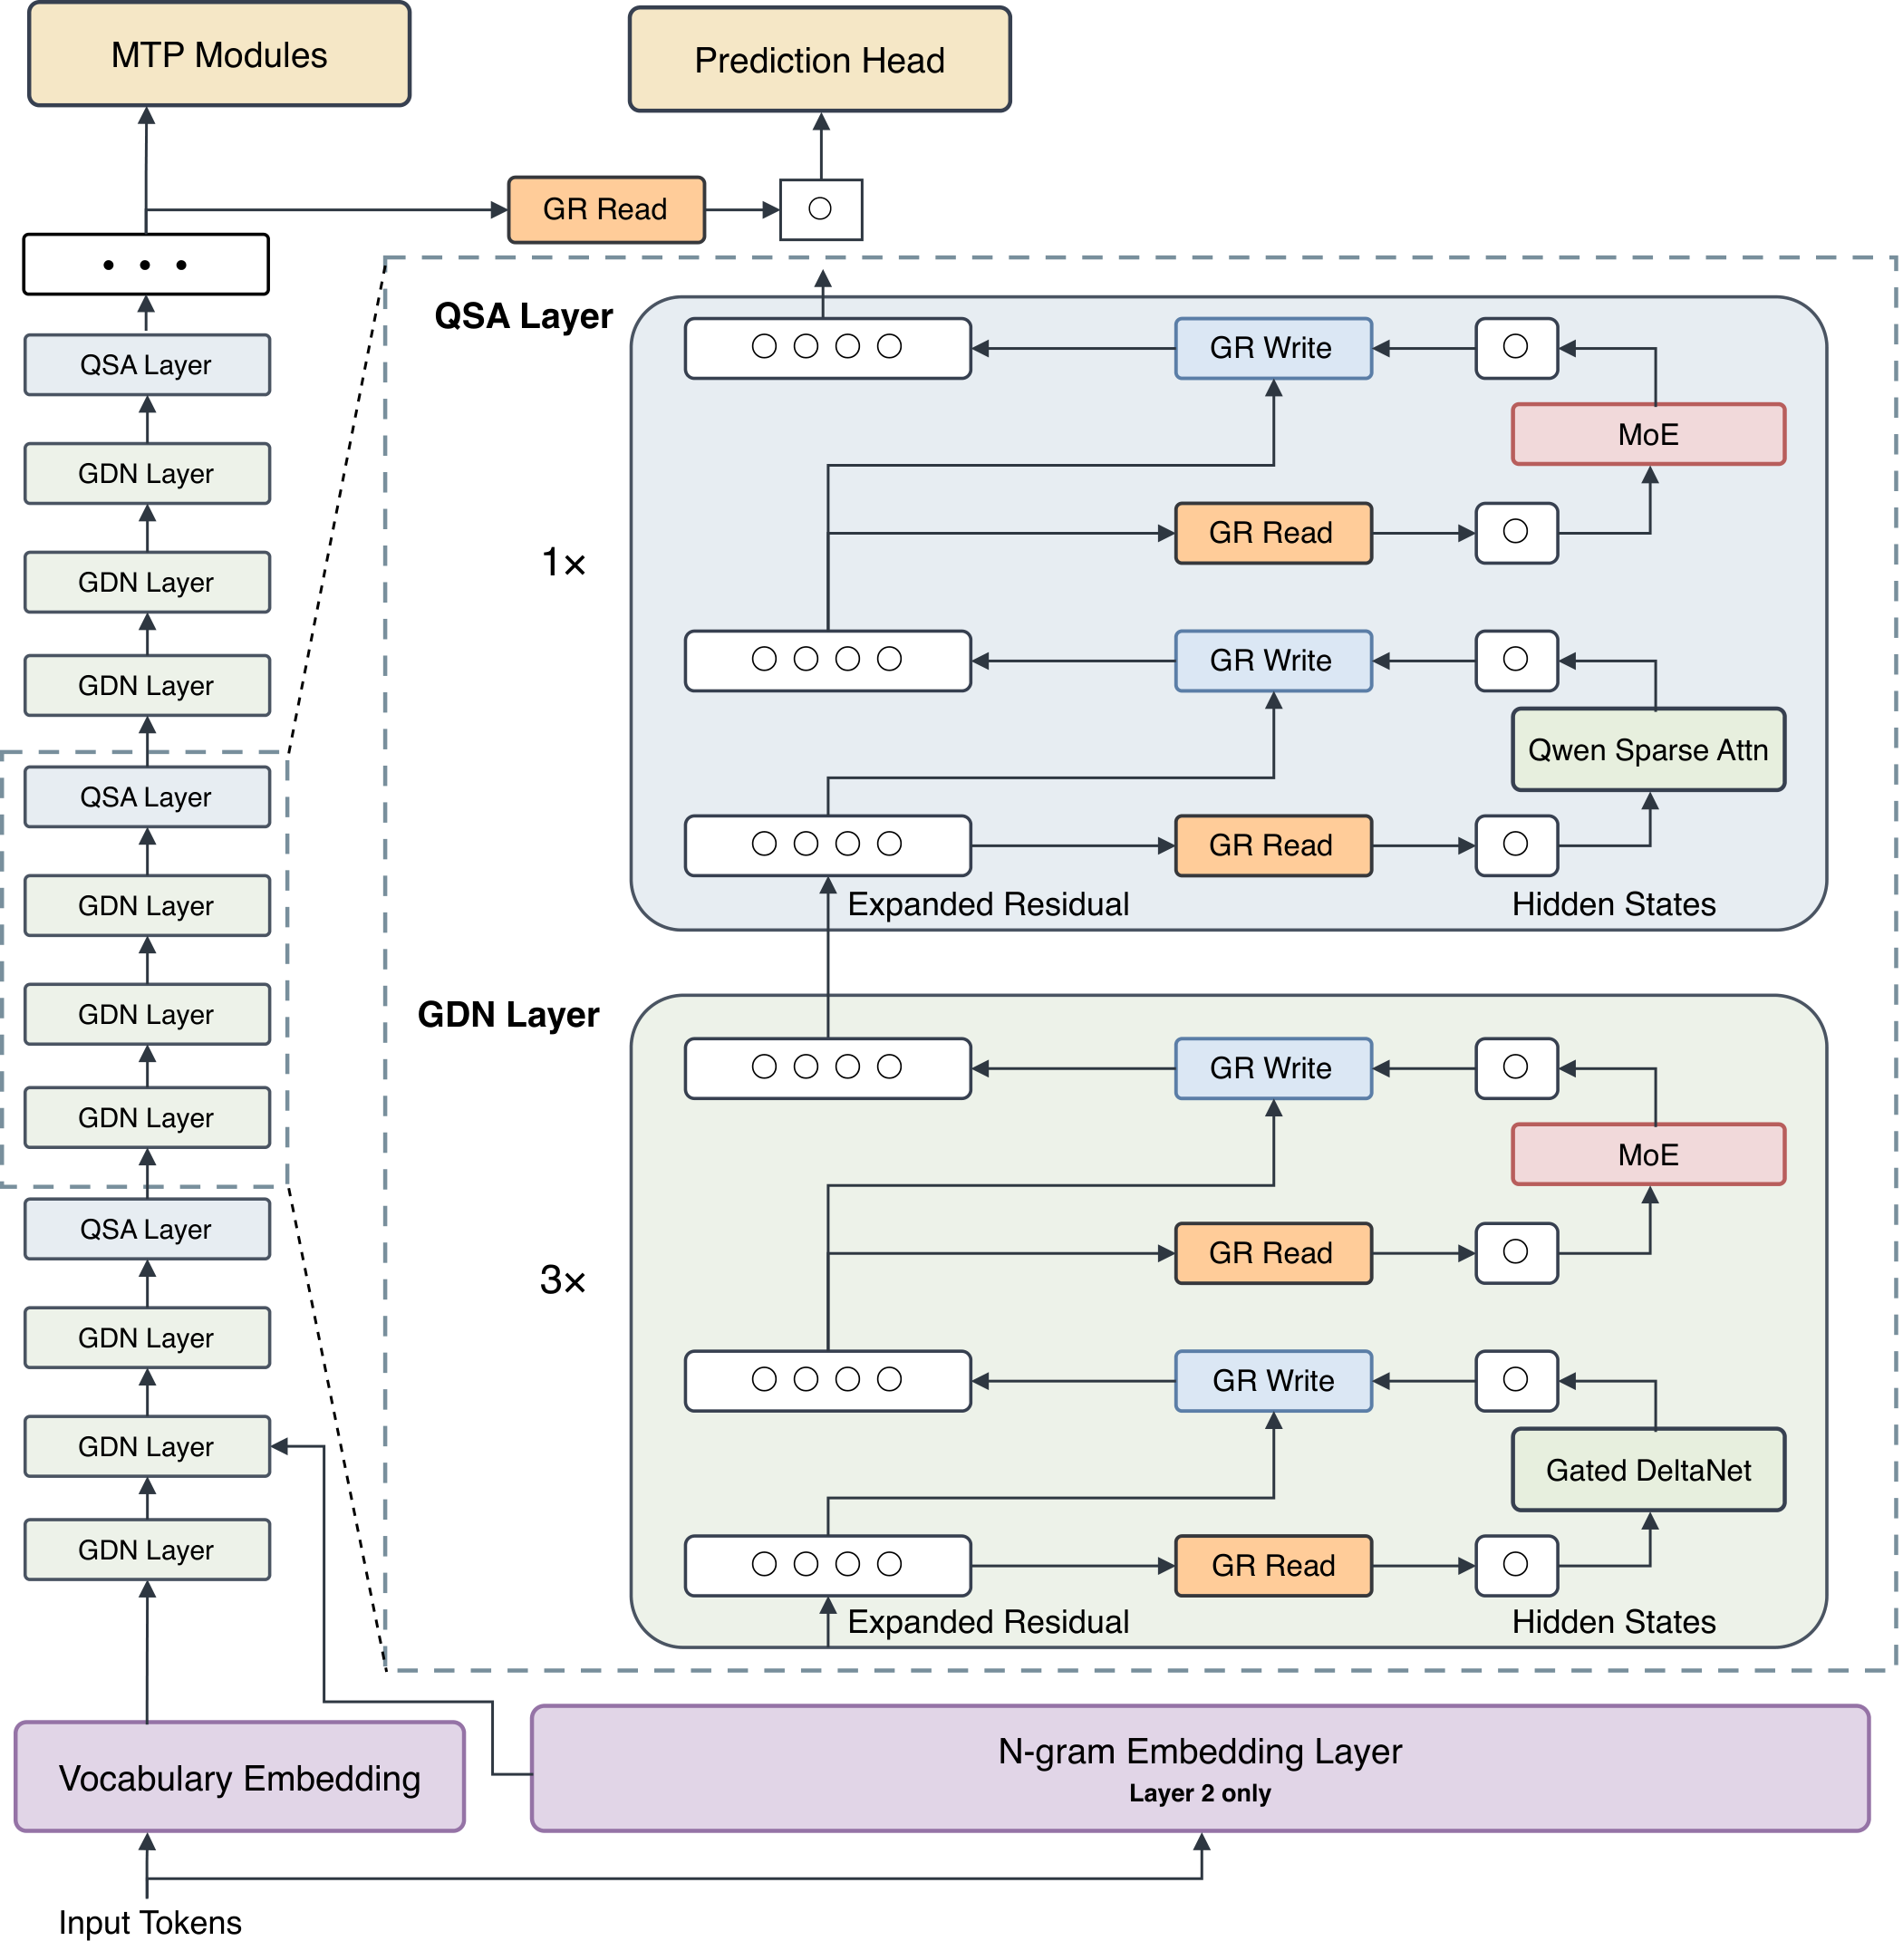
Voor gebruikers is de praktische test of deze wijzigingen de resources verlagen die nodig zijn om een acceptabel resultaat te leveren. Door Qwen gepubliceerde metingen van tokenverbruik leveren bewijs van verbeteringen op de geëvalueerde taken.
Hoe presteert Qwen4-Max? Officiële benchmarks en voorbeelden
Door Qwen gepubliceerde benchmarks meten taakprestatie, tokenverbruik en uitvoeringskosten, terwijl demonstraties praktische workflows illustreren.
Qwen4-Max-benchmarkresultaten
De volgende resultaten vergelijken Qwen4-Max met Qwen3.8-Max:
| Metriek | Qwen4-Max vs. Qwen3.8-Max |
|---|---|
| Work360-score | Gestegen van 47.74 naar 52.69 |
| Work360-tokenverbruik | Ongeveer 24% lager bij Xhigh en 35% bij High |
| Terminal-Bench 4.0-tokenverbruik | Ongeveer 48% lager bij Xhigh en 49% bij High |
| Gemiddelde Work360-taakkosten | Gedaald van RMB 26.58 naar RMB 11.16, ongeveer 58% lager |
De kostenverlaging weerspiegelt zowel lager tokenverbruik als aangepaste API-prijzen.
Voor applicaties die herhaaldelijk toolaanroepen doen, is de kost per succesvol voltooide taak een nuttigere vergelijking dan alleen tokenprijzen. Een goedkoper verzoek biedt beperkte besparing als de workflow veel retries of handmatige correctie vereist.
Voorbeelden in financieel onderzoek en productie
Verschillende officiële voorbeelden leveren concrete resultaten en meetbare uitkomsten.
In financieel onderzoek combineert het model marktdata-tools en zoeken om Excel-werkdocumenten en bewerkbare PowerPoint-rapporten te produceren. Bronlinks en uitgelijnde grafieken stellen reviewers in staat om bevindingen in het rapport terug te traceren naar ondersteunende data.
In een productievoorbeeld combineert het model parametrisch modelleren, toolpath-generatie en simulatiefeedback. De gerapporteerde menselijke programmeerinspanning voor één werkstuk daalde van ongeveer 475 minuten naar 24 minuten. Dit resultaat beschrijft het getoonde werkstuk en de toolomgeving en biedt een nuttig startpunt voor het evalueren van vergelijkbare processen.
Hoe de resultaten te interpreteren
De Work360-score van Qwen4-Max steeg van 47.74 naar 52.69, een winst van 4.95 punten. Dit duidt op sterkere prestaties over de geëvalueerde industriële taken, hoewel individuele taakresultaten kunnen variëren. De reducties in tokenverbruik vormen een aparte maat voor efficiëntie, met verschillende besparingen bij de instellingen High en Xhigh voor redenering.
De gerapporteerde 58% daling in gemiddelde Work360-taakkosten combineert lager tokenverbruik met aangepaste API-prijzen. Voor ontwikkelaars is de relevante vraag of die besparingen doorwerken naar een succesvol voltooide taak na retries en handmatige correcties.
Applicatiedemonstraties voegen bewijs toe over specifieke workflows en deliverables. Gebruik ze om taken te identificeren die het testen waard zijn, vergelijk vervolgens opleverkwaliteit, beoordelingsinspanning en totale kosten onder consistente toolcondities.
Qwen4-Max-prijzen: API-kosten en Token Plan-opties
Qwen4-Max is beschikbaar via verbruiksgebaseerde API-facturatie en Token Plan-abonnementen. De juiste optie hangt af van of je een applicatie bouwt of een interactieve AI-tool gebruikt.
Officiële verbruiksgebaseerde API-prijzen
QwenCloud vermeldt de volgende prijzen voor de regio Singapore:
| Facturatie-item | Prijs per 1 miljoen tokens |
|---|---|
| Standaardinput | $1.50 |
| Output | $4.50 |
| Impliciete cache-input | $0.075 |
| Expliciete cache-leesactie | $0.075 |
Het aanmaken van een expliciete cache kost $1.875 per miljoen tokens voor een cache van vijf minuten en $3.00 voor een cache van één uur.
Een taak met 100,000 niet-gecachte inputtokens en 10,000 factureerbare outputtokens kost $0.195 aan modeltokenkosten, exclusief extra betaalde tools of services.
Gecachte input is 95% goedkoper dan standaardinput. Applicaties die herhaaldelijk dezelfde instructies, tooldefinities of documentprefixen verzenden, kunnen inputkosten verlagen door cachegebruik te verbeteren.
Hoe Token Plan werkt
Token Plan gebruikt abonnementsfacturatie en Credits-afboekingen. Het vermeldt momenteel qwen4-max onder de ondersteunde modellen.
Per 17 november 2026 toont de pagina voor de regio Singapore de volgende individuele maandplannen:
| Plan | Maandprijs | Maandelijkse Credits |
|---|---|---|
| Lite | $6 | 20,000 |
| Essential | $10 | 45,000 |
| Standard | $18 | 80,000 |
| Pro | $43 | 200,000 |
De pagina adverteert ook een promotie voor nieuwe gebruikers vanaf $3. De geschiktheid en het eindbedrag worden tijdens het afrekenen getoond.
Credits zijn abonnementsfacturatie-eenheden en geen directe token-toewijzing. Verbruik hangt af van de toepasselijke model- en toolregels.
Volgens de Token Plan-documentatie is de service bedoeld voor interactief gebruik in compatibele AI-tools en momenteel beschikbaar in de regio Singapore.
Hoe krijg je toegang tot Qwen4-Max
Er zijn drie praktische routes: gebruik een Qwen-product, verbind direct via QwenCloud of configureer een compatibele AI-tool. Elk heeft andere installatievereisten, met name rond inloggegevens en eindpunten.
Gebruik Qwen-applicaties
De officiële aankondiging vermeldt Qwen Studio, de Qwen-app, QwenWork en Qoder als toegangskanalen.
Deze producten bieden een handig startpunt voor het testen van documentanalyse, codeerhulp en kantoorworkflows. Ontwikkelaars die verzoeken, tools en resultaatafhandeling willen beheersen, kunnen overstappen op directe API-integratie.
Toegang tot de QwenCloud-API
Om toegang te krijgen tot Qwen4-Max, meld je je aan bij QwenCloud, verkrijg je een API-sleutel voor je geselecteerde regio en configureer je het bijbehorende eindpunt met de model-ID qwen4-max. QwenCloud biedt OpenAI-compatibele toegang. Gebruikers die migreren vanuit de preview dienen ook hun aanvraagparameters en facturatieconfiguratie te herzien.
Configureer codeer- en agenttools
De Token Plan-documentatie biedt integratierichtlijnen voor tools, waaronder Qwen Code, Cline, Cursor en OpenCode.
Configuratie vereist doorgaans een aparte API-sleutel, de juiste Base URL en de modelnaam. Token Plan gebruikt het afzonderlijke eindpuntdomein token-plan.maas.qwencloudapi.com, en de bijbehorende sleutels zijn niet uitwisselbaar met sleutels voor de verbruiksgebaseerde API.
Volg de gids voor je gekozen tool en valideer de setup met een taak die leesmateriaal omvat, een bewerking uitvoert en het resultaat controleert.
Voor wie is Qwen4-Max bedoeld?
Qwen4-Max is het evalueren waard wanneer een terugkerende workflow veel context, meerdere tools en een verifieerbare oplevering vereist.
- Ontwikkelaars kunnen Qwen4-Max evalueren voor codewijzigingen over meerdere bestanden, frontend-ontwikkeling en agenten die externe tools gebruiken.
- Kantoor- en onderzoeksteams kunnen het gebruiken om documenten te analyseren, data te organiseren en rapporten met traceerbare bronnen voor te bereiden.
- Design- en contentteams kunnen het testen voor 3D-modellering, gameprototypes en videoworkflows die verbonden zijn met professionele software.
- Enterpriseteams kunnen terugkerende processen evalueren met gedefinieerde datatoegang, toolinterfaces en acceptatiecriteria.
Gebruik het voor financiële, juridische en medische workflows voor bewijsverwerking en analytische ondersteuning, met gekwalificeerde professionals die belangrijke conclusies beoordelen.
FAQ
Is de outputlimiet van Qwen4-Max één miljoen tokens?
Nee. Het contextvenster en de maximale outputlengte zijn aparte limieten. QwenCloud vermeldt maximale outputs van 131K tokens in standaardmodus en 262K tokens in denkmodus. Verzoeken moeten ook voldoen aan de toepasselijke input- en contextlimieten.
Moet ik kiezen voor de Qwen4-Max-API of Token Plan?
Kies de verbruiksgebaseerde API wanneer je Qwen4-Max integreert in een applicatie of backendservice. Token Plan is bedoeld voor interactief gebruik in compatibele AI-tools en gebruikt abonnement-Credits. De twee opties vereisen aparte inloggegevens en eindpunten.
Kan ik Qwen4-Max gratis gebruiken?
Officiële API-toegang en Token Plan zijn betaalde services. Gratis toegang via Qwen-applicaties, waar beschikbaar, volgt de account- en gebruiksregels van elk product; het biedt geen gratis API-tegoed.
Kan ik Qwen4-Max downloaden voor lokale implementatie?
Per 17 november 2026 heeft Qwen geen open gewichten voor Qwen4-Max verstrekt, dus de officiële release biedt geen downloadbaar model voor lokale implementatie. Qwen heeft plannen aangekondigd om kleinere modellen in de Qwen4-serie stapsgewijs open source te maken.
Conclusie
Qwen4-Max is een sterke kandidaat voor langdocumentanalyse, complexe codering en workflows met meerdere tools. Officiële evaluaties tonen hogere scores en lagere taakkosten dan Qwen3.8-Max op de gerapporteerde workloads.
Begin met een representatieve taak die al duidelijke acceptatiecriteria heeft. Vergelijk outputkwaliteit, tijd voor handmatige correctie, uitvoeringstijd en totale kosten. Verbeteringen op die punten vormen een praktische basis om Qwen4-Max uit te breiden naar vergelijkbare workflows.