
TL;DR
Tencent Hunyuan introduceerde Hyra 2.0 op 2 november 2026 als een research Harness voor het ontwikkelen van wetenschappelijke modellen, softwaretools en herbruikbare workflows. Het onderscheidende kenmerk is persistente coördinatie over meerdaagse of meerweekse experimenten.
De publieke release bestaat momenteel uit geselecteerde onderzoeksartefacten—modellen, code, gewichten en rapporten—in plaats van een algemeen beschikbare gehoste Hyra 2.0-dienst. Per 4 november 2026 documenteren Tencent’s publieke materialen geen algemeen bruikbare orkestratie-API of abonnementsplan.
Key Takeaways
- Onderzoeksdoel: Hyra 2.0 ontwikkelt herbruikbare wetenschappelijke modellen en tools die meer dan één onderzoeksproject kunnen ondersteunen.
- Persistente coördinatie: Overall-, Mission- en Worker-agents verdelen verantwoordelijkheden, terwijl wachtrijen en onderzoeksdossiers de voortgang over lange experimenten heen bewaren.
- Herbruikbare kennis: Agentgeheugen, Books en research skills behouden bevindingen samen met ondersteunend bewijs en toepassingsvoorwaarden.
- Taakspecifieke resultaten: De vrijgegeven eiwit-, force-field- en celmodellen richten zich op verschillende wetenschappelijke workloads; snelheid en kwaliteit moeten gezamenlijk worden beoordeeld.
- Praktische toegang: Begin met de beschikbare onderzoeksartefacten. De volledige Hyra Harness en gehoste Hunyuan-model-API’s zijn afzonderlijke aanbiedingen.
What Is Tencent Hunyuan Hyra 2.0?
Hyra 2.0 staat voor Hunyuan Research Agent 2.0, een multi-agent systeem ontworpen om complexe wetenschappelijke onderzoeks- en engineeringworkflows te automatiseren.
Tencent presenteert Hyra 2.0 als een verschuiving van het oplossen van geïsoleerde problemen naar het ontwikkelen van de modellen, methoden en infrastructuur die worden gebruikt om een bredere klasse van vragen te onderzoeken.
Hyra 2.0 is geen op zichzelf staand foundation model met een vaste parameteromvang of contextvenster. Het is een orkestratiesysteem dat verschillende AI-modellen kan gebruiken, code kan uitvoeren, wetenschappelijke experimenten kan beheren en gespecialiseerde research agents kan coördineren.
Wetenschappelijk onderzoek omvat meer dan redeneren. Een compleet project kan experimentontwerp, implementatie, training, debugging, evaluatie en herhaalde revisies vereisen. Deze activiteiten kunnen meerdere dagen of weken duren, vaak met parallelle experimenten en gedeelde compute-resources.
Hyra 2.0 pakt deze operationele uitdaging aan door modelintelligentie te combineren met persistente uitvoering, gestructureerde samenwerking en bewijsgebaseerde verificatie.
Hyra 2.0 Technical Specifications
| Specificatie | Hyra 2.0 |
|---|---|
| Ontwikkelaar | Tencent Hunyuan |
| Publieke aankondiging | 2 november 2026 |
| Systeemcategorie | Autonome wetenschappelijke research agent |
| Kernarchitectuur | Hiërarchische multi-agent Harness |
| Agentrollen | Overall, Mission, Worker |
| Onderzoeksuitvoering | Langlopende, gelijktijdige workflows |
| Taakbeheer | Persistente taakwachtrij |
| Samenwerking | Research Board en agent messaging |
| Verificatie | Resultaten met bewijs en onafhankelijke Review Workers |
| Geheugen | Projectstatus, gelaagd agentgeheugen, gedeelde Books |
| Kennishergebruik | Gevalideerde bevindingen en herbruikbare skills |
| Modelflexibiliteit | Verschillende Workers kunnen verschillende onderliggende modellen gebruiken |
| Onderzoeksomgevingen | WeCom, compute-platforms, coderepositories |
| Menselijk toezicht | Goedkeuringscheckpoints voor consequente operaties |
| Publieke artefacten | Geselecteerde modellen, broncode, getrainde gewichten, technische rapporten |
De specificaties van het systeem beschrijven de orkestratie- en onderzoeksvermogen. Individuele wetenschappelijke modellen die door Hyra 2.0 zijn gemaakt, hebben afzonderlijke architecturen, parameteraantallen en prestatiebenchmarks.
Why Hyra 2.0 Builds Tools
De overgang van Hyra 1.0 naar Hyra 2.0 pakt een fundamentele beperking in geautomatiseerd onderzoek aan: het succesvol oplossen van één probleem verbetert niet noodzakelijkerwijs het vermogen van het systeem om het volgende op te lossen.
Hyra 1.0 gebruikte een relatief eenvoudige agentlus om oplossingen te genereren, evaluaties uit te voeren en resultaten te verbeteren via herhaalde pogingen. Aangedreven door Tencent’s open-source Hy3-model hielp Hyra 1.0 de optimale exponent vast te stellen die somsets en verschilsets relateert, met een machine-gecontroleerd bewijs dat samen met het resultaat werd vrijgegeven. Het onderscheid is belangrijk: een geëvalueerd wiskundig resultaat is een concreet output, terwijl een verbetering van het onderzoeksproces kan worden hergebruikt bij latere problemen.
De volgende uitdaging is het cumuleren van onderzoeksvoortgang.
From Answers to Reusable Capabilities
Overweeg drie niveaus van wiskundige automatisering:
- Een agent lost een individueel wiskundig probleem op.
- Een agent ontwikkelt een proof-workflow die vergelijkbare problemen kan oplossen.
- Een agent verbetert de redeneermodellen en verificatietools die door toekomstige onderzoekssystemen worden gebruikt.
Het eerste levert een antwoord op. Het tweede levert een herbruikbare methode op. Het derde kan het onderliggende onderzoeksvermogen zelf verbeteren.
Hyra 2.0 richt zich op het tweede en derde niveau.
Tencent beschrijft twee brede categorieën herbruikbare tools. Symbolic tools drukken capaciteiten uit via code, algoritmen, regels en workflows. Voorbeelden zijn geautomatiseerde verificatiesystemen, wetenschappelijke zoekalgoritmen en experimentmanagementpijplijnen. Parametric tools slaan geleerde capaciteiten op in modelgewichten, waaronder eiwitontwerpmodellen en wetenschappelijke foundation models.
Het verbeteren van een van beide categorieën kan meerdere downstream-taken ten goede komen zonder dat elk onderzoeksproject vanaf hetzelfde startpunt hoeft te beginnen.
The Direction Toward Recursive Self-Improvement
Hyra 2.0 creëert ook een pad richting recursieve zelfverbetering. Onderzoek naar foundation models is afhankelijk van trainingsinfrastructuur, synthetische-datapijplijnen, optimalisatiealgoritmen en inference-systemen.
Als AI-agents deze tools verbeteren, kunnen ze helpen sterkere modellen te ontwikkelen. Die sterkere modellen kunnen vervolgens deelnemen aan volgende rondes van toolontwikkeling.
Betere researchtools → sterkere AI-modellen → capabelere research agents → betere researchtools.
Tencent beschrijft de toepassing van Hyra op pretraininginfrastructuur, post-training datageneratie en inference-optimalisatie. Dit creëert een plausibele feedbacklus tussen toolontwikkeling en modelontwikkeling. Het vestigt op zichzelf geen onbeperkte of volledig autonome recursieve verbetering; elke voorgestelde winst vereist nog steeds een experiment dat het effect isoleert.
How Does the Hyra 2.0 Harness Architecture Work?
De Harness is Hyra 2.0’s centrale technische innovatie. Een conventionele agentlus kan tools uitvoeren, resultaten inspecteren en binnen een sessie blijven redeneren. Wetenschappelijke modelontwikkeling vereist een geavanceerdere uitvoeringsomgeving.
Experimenten kunnen uren duren, trainingsjobs dagen, en afzonderlijke onderzoeksrichtingen kunnen verschillende compute-resources en validatiemethoden vereisen. Hyra 2.0 pakt deze vereisten aan via drie lagen van agents, persistente taakscheduling, gestructureerde onderzoeksregistraties en onafhankelijke verificatie.
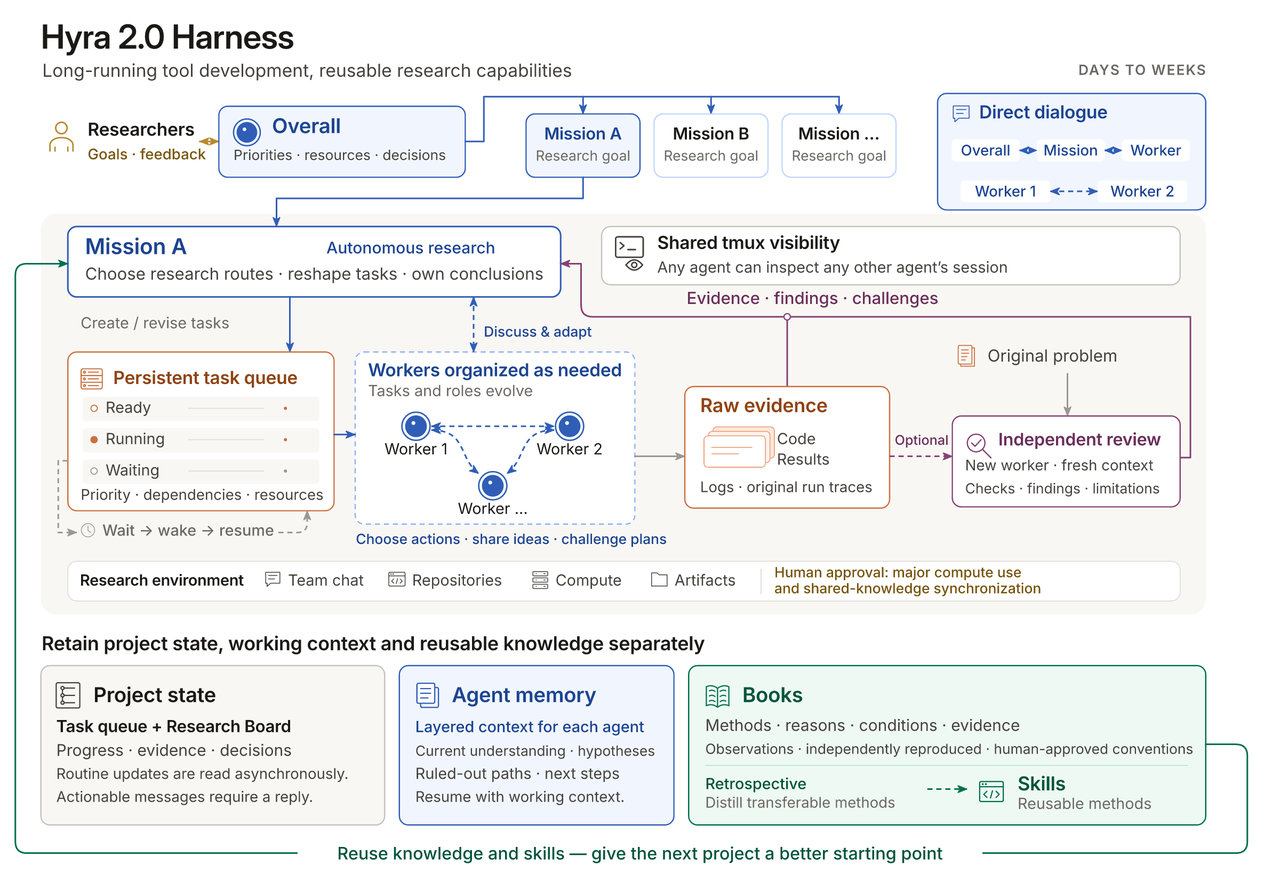
Tencent Hunyuan's official Hyra 2.0 architectuurdiagram toont de hiërarchie, de persistente werkqueue, het reviewproces en afzonderlijke opslagplaatsen voor projectstatus, agentgeheugen en gedeelde kennis.
Overall: Research Coordination and Resource Management
Overall is de hoogste coördinatielaag. Het communiceert met menselijke onderzoekers, bewaakt de afstemming met onderzoeksdoelen, beheert prioriteiten en coördineert compute-resources.
De verantwoordelijkheden omvatten het bepalen welke projecten extra resources moeten krijgen en het identificeren van beslissingen die menselijke goedkeuring vereisen. Overall functioneert dus als de coördinatielaag tussen autonome onderzoeksactiviteiten en menselijk onderzoeksmanagement.
Mission: Long-Term Research Planning
Elke Mission is verantwoordelijk voor een specifiek onderzoeksprobleem. Een Mission onderhoudt de onderzoeksrichting over meerdere experimenten, organiseert Workers, interpreteert resultaten en beslist of een hypothese verdere verkenning verdient.
Het bepaalt ook wanneer een onderzoeksaanpak moet worden herzien of verlaten. Dit creëert continuïteit binnen een langlopend project zonder dat één agentsessie elke tussenliggende actie hoeft te behouden.
Worker: Experiment Execution and Independent Exploration
Workers voeren gespecialiseerde onderzoekstaken uit. Hun verantwoordelijkheden omvatten het lezen van code, het implementeren van algoritmen, het uitvoeren van experimenten, het diagnosticeren van fouten en het voorstellen van alternatieve benaderingen.
Workers kunnen de beslissingen van een Mission ter discussie stellen, en verschillende Workers kunnen verschillende onderliggende AI-modellen gebruiken. Deze structuur ondersteunt parallelle verkenning en vermindert de afhankelijkheid van het redeneringspad van één agent.
Persistent Scheduling and Research Board
Hyra 2.0 plaatst onderzoekstaken in een persistente wachtrij. De scheduler houdt rekening met taakprioriteit, afhankelijkheden en beschikbare resources bij het starten van Workers.
Wanneer een experiment wacht op trainingsresultaten of menselijke goedkeuring, kunnen andere taken doorgaan. Agents kunnen ook hun volgende activatie plannen nadat een experiment is afgerond.
De Research Board registreert hypothesen, bevindingen, bewijs en belangrijke beslissingen. Dit scheidt de persistente status van het onderzoeksproject van individuele agentconversaties.
Independent Verification and Human Approval
Conclusies van Workers moeten worden ondersteund door experimenteel bewijs, zoals codeversies, uitvoeringslogs, evaluatieresultaten of originele traces.
Wanneer een resultaat extra onderzoek vereist, kan een afzonderlijke Review Worker het oorspronkelijke probleem en het bewijs onafhankelijk inspecteren. Dit proces helpt ongefundeerde conclusies en implementatiefouten te identificeren voordat ze latere research beïnvloeden.
Hogekost-compute-operaties en wijzigingen in gedeelde teamkennis blijven onderworpen aan menselijke goedkeuring. De architectuur combineert dus autonome uitvoering met expliciete checkpoints voor consequente beslissingen.
Books: Turning Research Experience Into Skills
Hyra 2.0 scheidt informatie in drie opslagcategorieën:
- Projectstatus: Taakwachtrijen, samenwerkingsrecords en onderzoeksvoortgang.
- Agentgeheugen: Huidige inzichten, hypothesen, verworpen benaderingen en toekomstplannen.
- Books: Herbruikbare kennis die over onderzoeksprojecten wordt gedeeld.
Books categoriseert informatie in observaties, geverifieerde bevindingen en conventies. Eén experiment kan een observatie opleveren. Onafhankelijk gereproduceerde bevindingen kunnen geverifieerde kennis worden. Conventies die teamgedrag beïnvloeden vereisen menselijke bevestiging.
Tijdens projectreviews kunnen herbruikbare methoden worden omgezet in skills. Een succesvolle numerieke verificatieprocedure of een methode voor het diagnosticeren van trainingsinstabiliteit kan een herbruikbare component van toekomstige researchworkflows worden.
Dit mechanisme stelt het systeem in staat operationele verbeteringen te behouden voorbij individuele sessies.
What Research Results Has Hyra 2.0 Achieved?
Hyra 2.0’s initiële resultaten omvatten wetenschappelijke modellen, wiskundig onderzoek, quantumcomputing, robotica, single-cell analyse en hardware-engineering.
De officiële research repository bevat geselecteerde implementaties, gewichten, rapporten en verificatie-artefacten. Het onderstaande overzicht vat Tencent’s gerapporteerde resultaten samen; de volgende subsecties leggen hun testcondities en beschikbaarheid uit. Dit zijn verschillende wetenschappelijke taken, geen enkele ranglijst van algemene agent-capaciteit.
| Research output | Technische schaal of metric | Gerapporteerde prestatie |
|---|---|---|
| HyInv | 1,96M parameters | 57× snellere eiwitsequentiegeneratie dan ProteinMPNN |
| HyPLM-Flash | 650M parameters; 726B trainingstokens | 130.000 residuen/s op één H20; concurrerende kwaliteit over 32 taken |
| HyFF | Vijf modellen; 2,3M–1,2B parameters | Nauwkeurigheid-snelheid Paretofront tegen 16 publieke modellen |
| HyCell | 16,1M parameters; 512-dimensionale embeddings | Totale score 0,735 over zeven achtergehouden celatlassen |
| HyProver | Wiskundige proof-workflow | Resultaten betreffende Petty’s conjecture en Yau’s circle-action conjecture |
| HyQEC | Quantumcode [[488,123,22]] | Efficiëntiemetric 122,0; circa 48% boven de vorige challengeleider |
| Spiral Hand | Vijfvingerig robotontwerp | 28,6% snellere objectrotatie in DR5-simulatie |
| XiangShan RISC-V | SPEC CPU2006-prestaties | 5,79% hogere score per GHz met 0,3% area-toename |
Deze resultaten tonen meerdere typen onderzoeksoutput in plaats van één algemene agentscore.
HyInv: 57× Faster Protein Inverse Folding
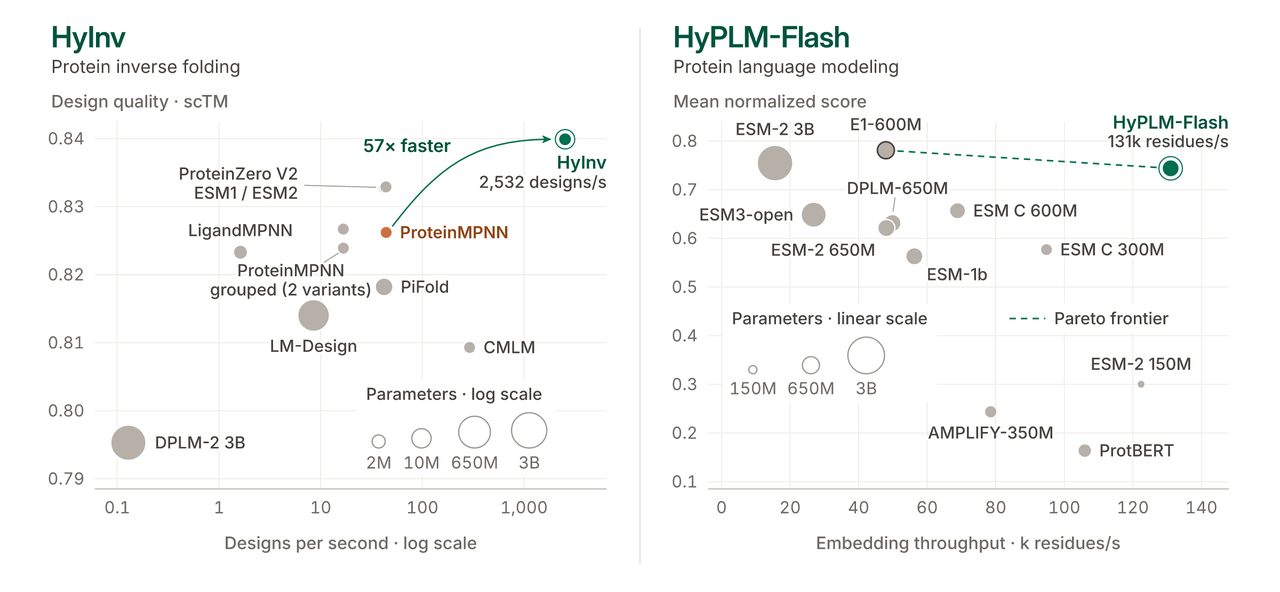
HyInv genereert eiwitsequenties voor een doel-backbone. Het model met 1,96M parameters draait naar verluidt 57× sneller dan ProteinMPNN. De gerapporteerde 50,6 ms voor 128 designs gebruikt een backbone van 402 residuen, één H20 en BF16, exclusief compilatie en CUDA graph capture. Beschouw dit als opgewarmde generatiesnelheid; structurele screening draagt nog steeds bij aan de volledige ontwerpcyclus.
HyPLM-Flash: High-Throughput Protein Language Modeling
HyPLM-Flash is een eiwittaalmodel met 650M parameters, getraind op 726B tokens. In de vrijgegeven evaluatie met 28 checkpoints en 32 taken was de ProteinGym-score statistisch gelijk aan vergelijkbare encoders. INT8-inference bereikt ongeveer 130.000 residuen/s op één H20; BF16 is te verkiezen wanneer kleine representatieverschillen downstream-analyse beïnvloeden. De lanceringsgrafiek hieronder gebruikt een andere evaluatiescope.
HyFF: Faster Molecular Simulation With Five Model Sizes
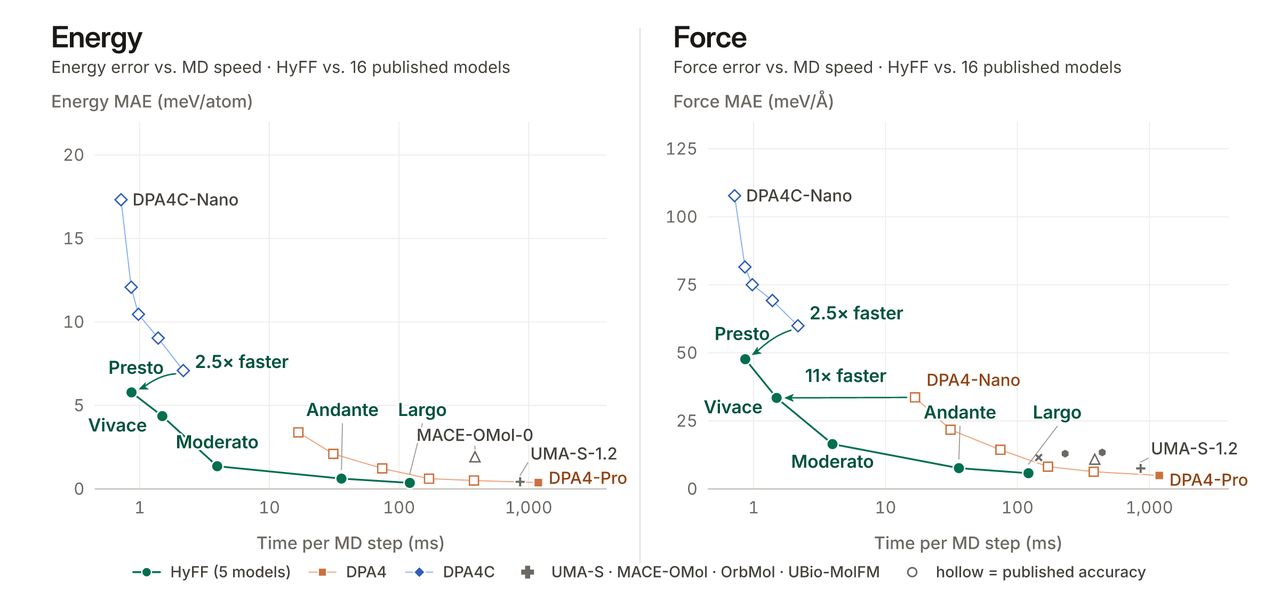
HyFF voorspelt moleculaire energieën en atoomkrachten, met vijf modelgroottes van 2,3M–1,2B parameters. In de gerapporteerde OMol25-vergelijking combineert Andante een vergelijkbare force error als UMA-S-1.2 (7,65 versus 7,55 meV/Å) met 29× snellere moleculaire dynamica. Largo rapporteert een lagere energy error dan DPA4-Pro (0,364 versus 0,380 meV/atom) en 9,7× hogere snelheid. Kies een grootte door zowel nauwkeurigheid als runtime te testen op de moleculen die u wilt simuleren.
HyCell: A Single-Cell Embedding Model
HyCell vertaalt genexpressietellingen van menselijke cellen naar 512-dimensionale embeddings met een model van 16,1M parameters. Over zeven achtergehouden celatlassen is de samengestelde score 0,735, dicht bij Stack’s 0,736. Die score combineert biologische conservatie, batchcorrectie en annotatie-overdracht; het is geen classificatienauwkeurigheid. Controleer de componentmetrics die relevant zijn voor uw studie.
HyProver: Reusable Workflows for Mathematical Research
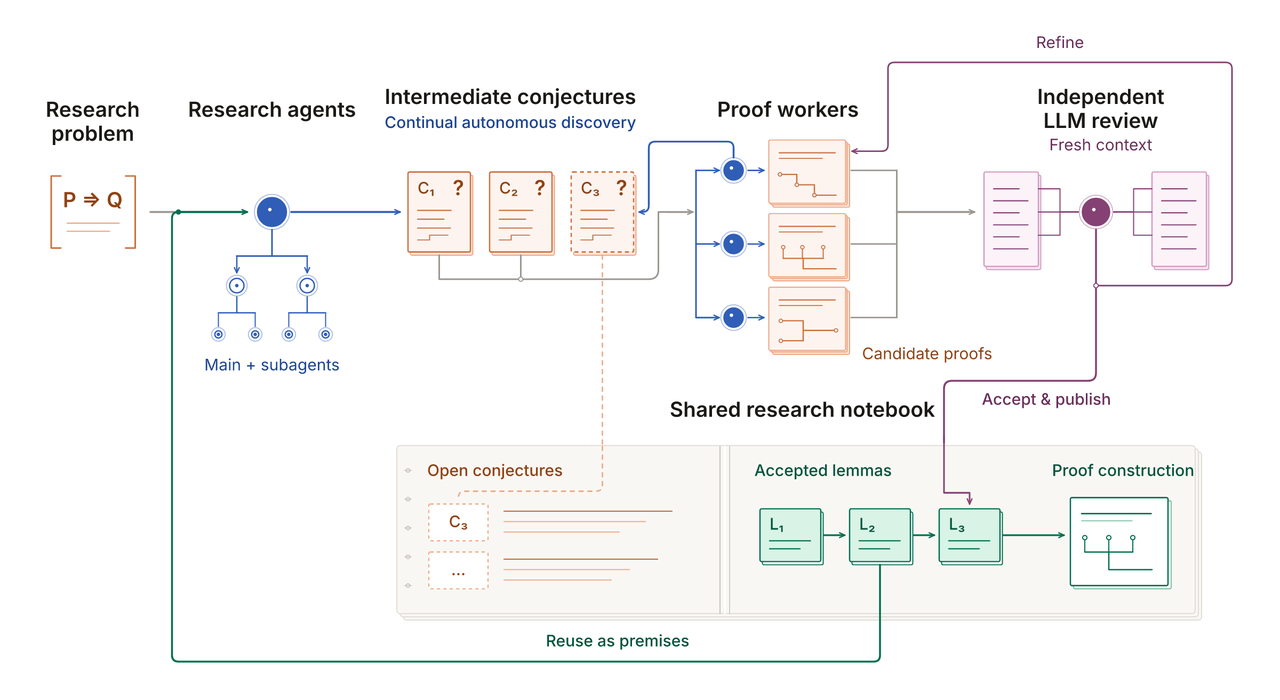
HyProver organiseert wiskundig werk in exploratie, proof-ontwikkeling en review. De gerapporteerde resultaten stellen de vijfdimensionale case van Petty’s equilateral-set conjecture vast en geven een tegenvoorbeeld voor de onbegrensde vorm van Yau’s circle-action conjecture. Deze resultaten hebben specifieke grenzen: Petty’s conjecture is niet in elke dimensie beslecht, en Yau’s simply connected-formulering blijft open.
HyQEC: A 48% Improvement in Quantum-Code Efficiency
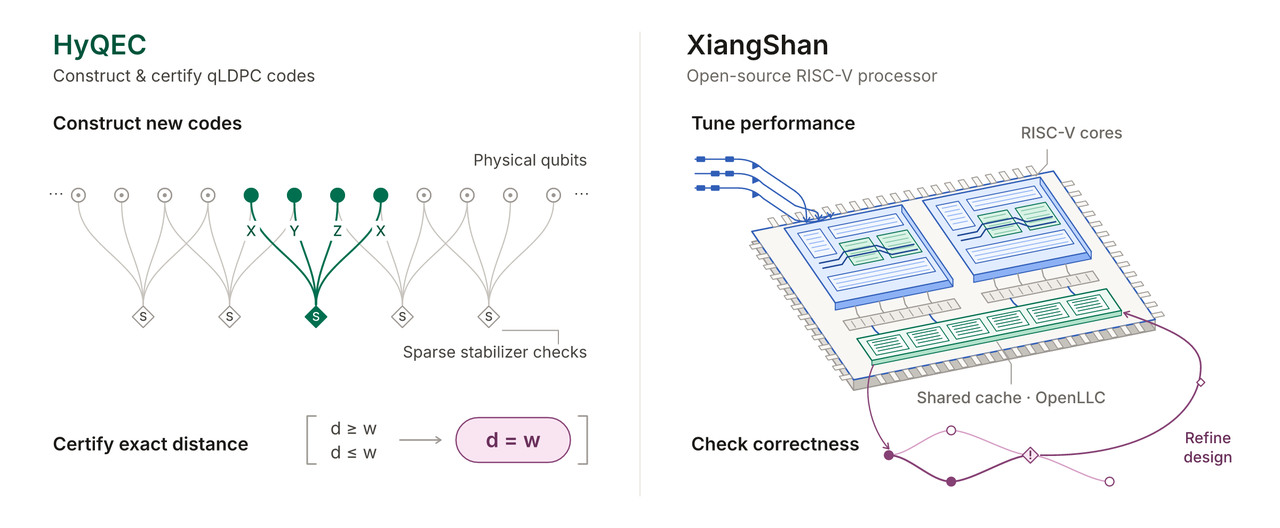
HyQEC zoekt naar quantum error-correcting codes en controleert hun afstanden. Tencent rapporteert een [[488,123,22]]-constructie met een efficiëntiemetric kd²/n van 122,0, ongeveer 48% boven de vorige challengeleider onder de genoemde constraints. Dit meet code-efficiëntie, niet quantum-hardwareprestaties. Zoals gecontroleerd op 5 november 2026 bevat de officiële release de tools hyqec-verify en hyqec-check, maar vermeldt nog steeds het codebestand en certificaat van deze specifieke constructie als bewijs dat nog zal worden vrijgegeven. Publieke tools en publiek reproduceerbaar bewijs voor een specifiek resultaat zijn afzonderlijke mijlpalen.
Spiral Hand: AI-Designed Robotic Morphology
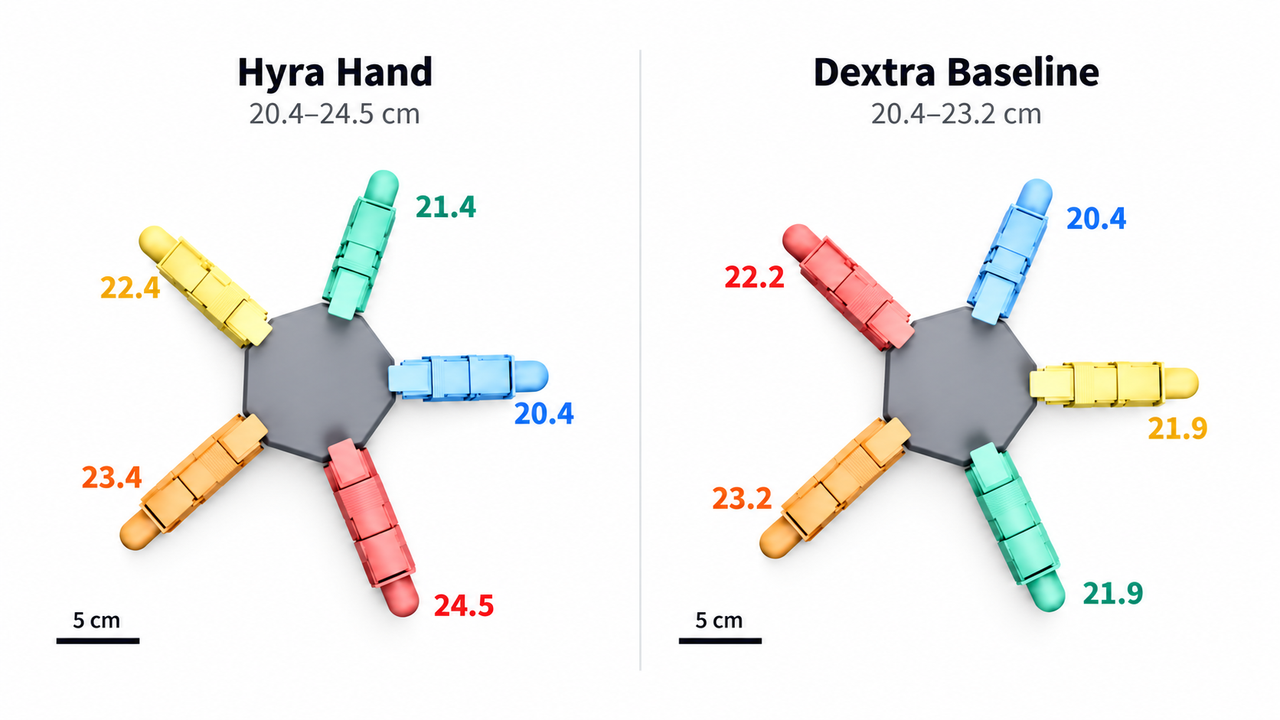
Hyra’s Spiral Staircase Hand gebruikt geleidelijk langere vingers rond de handpalm. Tencent rapporteert 28,6% snellere objectrotatie en 21% meer voltooide doelen dan de Dextra-baseline in DR5-simulatie na gelijke policy fine-tuning-budgetten. Validatie op fysieke hardware staat nog uit.
XiangShan: Processor Optimization and Formal Verification
Voor de XiangShan RISC-V-processor rapporteert Tencent een verbetering van 5,79% in SPEC CPU2006-score per GHz, ongewijzigde kloksnelheid en een area-toename van 0,3%. Het werk vond ook tien voorheen ongerapporteerde bugs en een cache-coherentie-tegenvoorbeeld. Deze uitkomsten gelden voor het geëvalueerde ontwerp en workloads, niet voor alle RISC-V-systemen.
How Should Researchers Interpret Hyra 2.0's Benchmarks?
Lees elke benchmark binnen zijn eigen workload. Vergelijk dezelfde inputs, hardware, precisie en timinggrens, en beoordeel vervolgens de outputkwaliteit naast de runtime. Inspecteer voor wetenschappelijke claims de ondersteunende code, data, proof of certificaat: een gerapporteerd resultaat en een onafhankelijk gereproduceerd resultaat bieden verschillende niveaus van bewijs.
Can Developers Use Hyra 2.0 Through an API?
Per 4 november 2026 beschrijven de publieke Hyra-materialen onderzoeksoutputs en geselecteerde releases. Ze documenteren geen algemeen beschikbare Hyra 2.0-orkestratie-API, abonnementsprijs of compleet deploymentpakket. Een onderzoeksaankondiging en downloadbare artefacten moeten daarom worden onderscheiden van gehoste toegang tot het volledige systeem.
De publiek beschikbare materialen richten zich op onderzoeksresultaten en geselecteerde artefacten. Ontwikkelaars kunnen bepaalde modellen die via Hyra zijn gemaakt, waaronder HyInv, HyPLM-Flash, HyFF en HyCell, benaderen via de bijbehorende research repositories.
De volledige Hyra 2.0 Harness moet worden onderscheiden van die downloadbare outputs.
Hyra 2.0 and Hosted Hunyuan APIs
Ontwikkelaars kunnen Tencent Hy4 via CometAPI gebruiken met het model-ID hy4. Dit biedt gehoste model-inference voor toepassingen zoals codering, analyse en agentworkflows. Het biedt niet de volledige Hyra 2.0 research Harness; wetenschappelijke modellen die via Hyra zijn ontwikkeld, zijn afzonderlijk beschikbaar via Tencent’s research repositories.
What Would Make Hyra 2.0 Useful in a Research Team?
Begin met één vrijgegeven artefact en een kleine referentieworkload. Zodra dat succesvol draait, test representatieve lokale data met een vaste kwaliteitsdrempel en compute-budget. Houd de repository-revisie, gewichten, omgeving, inputs en outputs bij elkaar zodat collega’s het resultaat kunnen reproduceren. Voeg persistente multi-agentcoördinatie toe wanneer lange wachttijden, afhankelijke experimenten of concurrerende hypothesen dit nuttig maken.
Conclusion
Hyra 2.0 brengt onderzoeksplanning, experimentuitvoering en herbruikbare kennis samen in één persistente workflow. De wetenschappelijke outputs zijn veelbelovende startpunten voor vervolgwerk. Voor een onderzoeksteam is de praktische test of een vrijgegeven artefact een echt experiment verbetert en bewijs oplevert dat anderen kunnen inspecteren en reproduceren.
FAQ
How should a lab budget its first Hyra artifact trial?
Begroot voor drie fasen: het opzetten van een reproduceerbare omgeving, het draaien van een kleine referentiecase en het evalueren van een representatieve lokale workload. Neem naast acceleratorgebruik ook voorbereidingstijd en reviewtijd op. Kies vóór de start een acceptatiecriterium, zoals het handhaven van een vereist kwaliteitsniveau terwijl de doorlooptijd wordt verkort. Een initiële proef moet klein genoeg zijn om fouten te diagnosticeren zonder de resources te committeren die nodig zijn voor een volledige researchcampagne.
What should a reproducibility package contain?
Bewaar de repository-revisie, modelgewichtsidentifiers, omgevingsversies, herkomst van inputdata, configuratie, random seeds waar relevant, en evaluatieoutputs bij elkaar. Noteer eventuele wijzigingen aan het gepubliceerde voorbeeld. Wanneer een resultaat afhankelijk is van een proof of certificaat, bewaar dan ook de checker-versie en de output. Het pakket moet een andere onderzoeker in staat stellen een softwareprobleem, een gewijzigde input en een werkelijk verschil in het wetenschappelijk resultaat van elkaar te onderscheiden.
How can researchers avoid benchmark contamination?
Scheid de data die wordt gebruikt om modellen te kiezen of instellingen te tunen van de data die wordt gebruikt voor de uiteindelijke evaluatie. Vries het definitieve protocol in voordat u kandidaten vergelijkt, en documenteer eventuele overlap met pretraining- of ontwikkelingsdata die kan worden vastgesteld. Gebruik voor nieuwe wetenschappelijke datasets splits die de beoogde inzetsetting weerspiegelen, zoals een achtergehouden studie of experimentele conditie. Een sterke score is minder informatief als de evaluatievoorbeelden herhaaldelijk het geteste systeem hebben gevormd.
How should teams handle conflicting agent conclusions?
Vergelijk de onderliggende experimenten in plaats van de conclusies te combineren via meerderheidstemmen. Controleer of de agents dezelfde datasetversie, aannames, metric en softwareconfiguratie gebruikten. Bewaar beide bevindingen totdat het verschil is verklaard, en voer vervolgens een gericht experiment uit dat onderscheid maakt tussen de concurrerende verklaringen. Overeenstemming tussen agents is nuttig, maar vervangt geen externe metingen of een controleerbaar argument.
When is a simpler research workflow preferable?
Een korte, deterministische taak met een volwassen script en een duidelijke evaluator profiteert mogelijk niet van persistente multi-agentcoördinatie. De extra scheduling, administratie en review kunnen meer kosten dan ze opleveren. Introduceer orkestratie wanneer experimenten betekenisvolle afhankelijkheden hebben, lange wachttijden, meerdere concurrerende hypothesen of herbruikbare outputs die doorlopend onderhoud vereisen. De beslissing moet de structuur van de workload en de geobserveerde coördinatiekosten volgen.
