
TL;DR
Muse Ember is Meta’s kleinste multimodale redeneermodel, gebouwd voor agent-taken met hoog volume zoals routering, extractie, tool-aanroepen en gefocuste code. Meta introduceerde Muse Ember op 9 november 2026.
Het contextvenster van 1.048.576 tokens biedt plaats aan omvangrijk bronmateriaal. Meta biedt toegang via Model API en Muse Code; CometAPI vermeldt muse-ember, met de activatiestatus hieronder. Begin met een herhaalbare taak waarvan je de output kunt controleren, en vergelijk vervolgens de kosten per succesvol resultaat, inclusief redenering, tools en retries.
Belangrijkste punten
- Rol: Muse Ember is gebouwd voor herhaalde agent-executie, waaronder classificatie, extractie, tool-aanroepen en begrensde codetaken.
- Inputs en capaciteit: Muse Ember accepteert tekst, afbeeldingen, audio en video, met een contextvenster van 1M tokens en tot 512K uitvoertokens.
- Prestaties: Meta’s resultaten zijn in het voordeel van Muse Ember op verschillende agent-benchmarks, terwijl onafhankelijke analytische tests laten zien dat lage tokenprijzen niet altijd de laagste taakkosten opleveren.
- Prijzen: Aanvragen boven 200K inputtokens vallen in een hogere prijstier; de totale taakkosten hangen ook af van redenering en toole gebruik.
- Toegang: Meta Model API en Muse Code zijn beschikbaar; CometAPI’s vermelding markeert het model momenteel als Coming soon.
Waar is Muse Ember het beste voor?
Muse Ember handelt de uitvoeringstappen in een agent-workflow af, terwijl een groter model de planning beheert. Het past bij taken met hoog volume, duidelijke input, een beperkte scope en een resultaat dat je toepassing kan verifiëren. De kerntaken zijn:
- Classificatie en routering: Verzoeken labelen en naar de juiste queue of service sturen.
- Extractie: Documenten en media omzetten in gestructureerde velden met bronbewijs.
- Tool-aanroepen: Een functie selecteren en de argumenten aanleveren die je toepassing uitvoert.
- Batchverwerking: Een herhaalbare bewerking toepassen op bestanden of records.
Support-ticketroutering
Een praktische support-workflow kan Ember vragen een orderreferentie te extraheren, een categorie toe te wijzen en ontbrekende informatie te markeren. Je toepassing kan de referentie valideren tegen zijn eigen records voordat het ticket wordt gerouteerd. Houd refunds, accountwijzigingen en andere ingrijpende acties achter de autorisatiecontroles van de toepassing zelf.
Documentextractie met bewijs
Vraag voor factuur- of contractverwerking zowel de geëxtraheerde waarde als de pagina of passage die deze ondersteunt. Behandel ontbrekende en onleesbare velden als expliciete uitkomsten in plaats van het model uit te nodigen te gokken. Dit levert records op die reviewers kunnen inspecteren zonder elk document opnieuw te lezen.
Gefocust codewerk
Geef een codeworker een kleine eigendomsgrens: de bestanden die hij mag wijzigen, het te behouden gedrag en de tests die de voltooiing definiëren. Meta’s parallelle code-migratievoorbeeld illustreert deze werkverdeling. De omliggende agent voert opdrachten uit en controleert resultaten; de reactie van het model alleen is geen bewijs dat een wijziging zijn tests heeft doorstaan.
Meta’s Muse Ember-launchvisual gaat vergezeld van de gids voor het combineren van een executiemodel met een groter planningsmodel.
Meta zegt dat Muse Ember het eerste model is dat is getraind met Muse Wonder Full, waarmee het zijn strategie uitbreidt om grotere modellen te gebruiken voor het ontwikkelen van gespecialiseerde modellen.
Specificaties van Muse Ember
De kernspecificaties zijn:
| Specificatie | Muse Ember |
|---|---|
| Ontwikkelaar | Meta Superintelligence Labs |
| Aankondigingsdatum | 9 november 2026 |
| Modelcategorie | Multimodaal redeneren en agent-executie |
| Contextvenster | 1.048.576 tokens |
| Maximale output | 524.288 tokens |
| Inputmodaliteiten | Tekst, afbeeldingen, audio, video |
| Bestandsinputs | Ondersteund via de Responses API |
| Outputmodaliteit | Tekst |
| Redeneringsinspanning | Minimal, Low, Medium, High, XHigh, Max |
| Standaardinspanning | Max |
| Tool-aanroepen | Ondersteund |
| Gestructureerde output | Ondersteund |
| Search grounding | Ondersteund via de Model API |
Meta heeft de gewichten van Muse Ember niet vrijgegeven of het aantal parameters bekendgemaakt. De aanvraag- en tokenlimieten gelden per team, waarbij alle API-sleutels in dat team de toewijzing van het model delen.
Context en multimodale inputs
Voor PDF-workflows extraheert Meta tekst van de eerste 100 pagina’s en afbeeldingen van de eerste 50, dus splits langere bestanden voordat je ze verwerkt. Stuur het materiaal dat nodig is voor de taak; redeneringstokens delen de limiet van 524.288 uitvoertokens met het eindantwoord.
Gebruik screenshots als de lay-out ertoe doet, scans voor documentextractie, audio voor vergadering-analyses en video voor gebeurtenissen die zich in de tijd ontvouwen. Een transcript is genoeg voor een tekst-only samenvatting. Bestanden worden ondersteund via de Responses API, en resultaten worden als tekst teruggegeven.
Configureerbare redeneringsinspanning
Muse Ember biedt zes redeneringsniveaus: Minimal, Low, Medium, High, XHigh en Max. Meta’s standaard is Max; geen ervan is unsupported en retourneert HTTP 400. Begin routine routering en classificatie op een lager niveau, en verhoog het pas wanneer de toename in geaccepteerde antwoorden de extra latentie en uitvoertokenkosten rechtvaardigt.
Tool-aanroepen en gestructureerde output
Muse Ember ondersteunt tool-aanroepen en gestructureerde output. Tool-aanroepen verbinden modelbeslissingen met applicatiefuncties, terwijl gestructureerde output het eenvoudiger maakt om geëxtraheerde velden te valideren en door te geven aan de volgende stap.
Dit illustratieve support-ticketresultaat geeft een routeringsapplicatie een categorie, een prioriteit en een reviewvlag:
{
  "category": "billing",
  "priority": "high",
  "requires_human_review": true
}
De Meta Model API ondersteunt ook search grounding en computer-use-workflows. De gekoppelde toepassing levert de tools, voert acties uit en beheert de permissies.
Hoe presteert Muse Ember op benchmarks?
Meta’s launchresultaten gebruiken maximale redeneringsinspanning. Agents’ Last Exam bestrijkt de Linux-subset in Meta’s interne evaluatie, terwijl Terminal-Bench het beste gepubliceerde harnas van elk model gebruikt. Ze combineren extern gerapporteerde Artificial Analysis-resultaten met Meta’s interne evaluaties; de Personal Superintelligence Index is Meta’s interne samengestelde score, geen aparte onafhankelijke ranglijst.
Benchmarkresultaten van Muse Ember
| Benchmark | Muse Ember | Claude Haiku 5.5 | GPT-6 Luna |
|---|---|---|---|
| AutomationBench-AA | 37.8 | 13.9 | 20.2 |
| Agents' Last Exam | 61.6 | 57.0 | 57.1 |
| Personal Superintelligence Index | 46.8 | 36.1 | 37.0 |
| Terminal-Bench 4.0 | 40.9 | 39.2 | 16.4 |
| Coding Agent Index-AA | 46 | 37 | 31 |
| FrontierCode 2.0-AA | 27.2 | 34.9 | 25.2 |
| GDP.pdf-AA | 22.8 | 20.8 | 22.8 |
| OSWorld 2.1 (partial score) | 69.5 | 68.9 | 50.5 |
| OSWorld 2.1 (binary score) | 33.8 | 27.8 | 17.0 |
| PerceptionBench (with tools) | 80.6 | 78.6 | 62.8 |
| Artificial Analysis Intelligence Index | 36 | 36 | 28 |
Terminal-Bench 4.0 gebruikt mini-swe-agent voor Muse Ember, Claude Code voor Haiku 5.5 en Codex voor GPT-6 Luna. Dit zijn niet identieke executieomgevingen. OSWorld 2.1 rapporteert zowel partial-credit als binaire scores, terwijl PerceptionBench tools omvat. De Artificial Analysis Intelligence Index-resultaten zijn van versie 5 zoals gepubliceerd op 9 november 2026.
Benchmarkanalyse van Muse Ember
Agent-executie is Muse Ember’s sterkste gebied.
Op AutomationBench-AA scoort Muse Ember 37,8, vergeleken met 13,9 voor Haiku 5.5 en 20,2 voor GPT-6 Luna. Dit ondersteunt Meta’s positionering van Muse Ember als een model voor end-to-end bedrijfsworkflows en herhaalde agentoperaties.
Codeprestaties zijn competitief, maar niet universeel superieur.
Muse Ember scoort 40,9 op Terminal-Bench 4.0 en 46 op Coding Agent Index-AA. Het scoort echter 27,2 op FrontierCode 2.0-AA, onder de 34,9 van Haiku 5.5. Dit suggereert dat Muse Ember een nuttige kandidaat is voor begrensde codetaken, terwijl moeilijker engineeringswerk getest moet worden tegen sterkere alternatieven.
Multimodale en computer-use-resultaten zijn veelbelovend.
Muse Ember scoort 80,6 op PerceptionBench met tools en 69,5 op OSWorld 2.1 partial-credit scoring. Deze resultaten ondersteunen de positionering voor workflows met visueel begrip en computerinteractie.
Algemene intelligentie is vergelijkbaar met Haiku 5.5.
Muse Ember en Haiku 5.5 ronden beide af op 36 op de Artificial Analysis Intelligence Index, voor GPT-6 Luna met 28. Voor een selectiebeslissing, combineer die brede vergelijking met de taakspecifieke resultaten hierboven.
Muse Ember-intelligentie versus kosten per taak
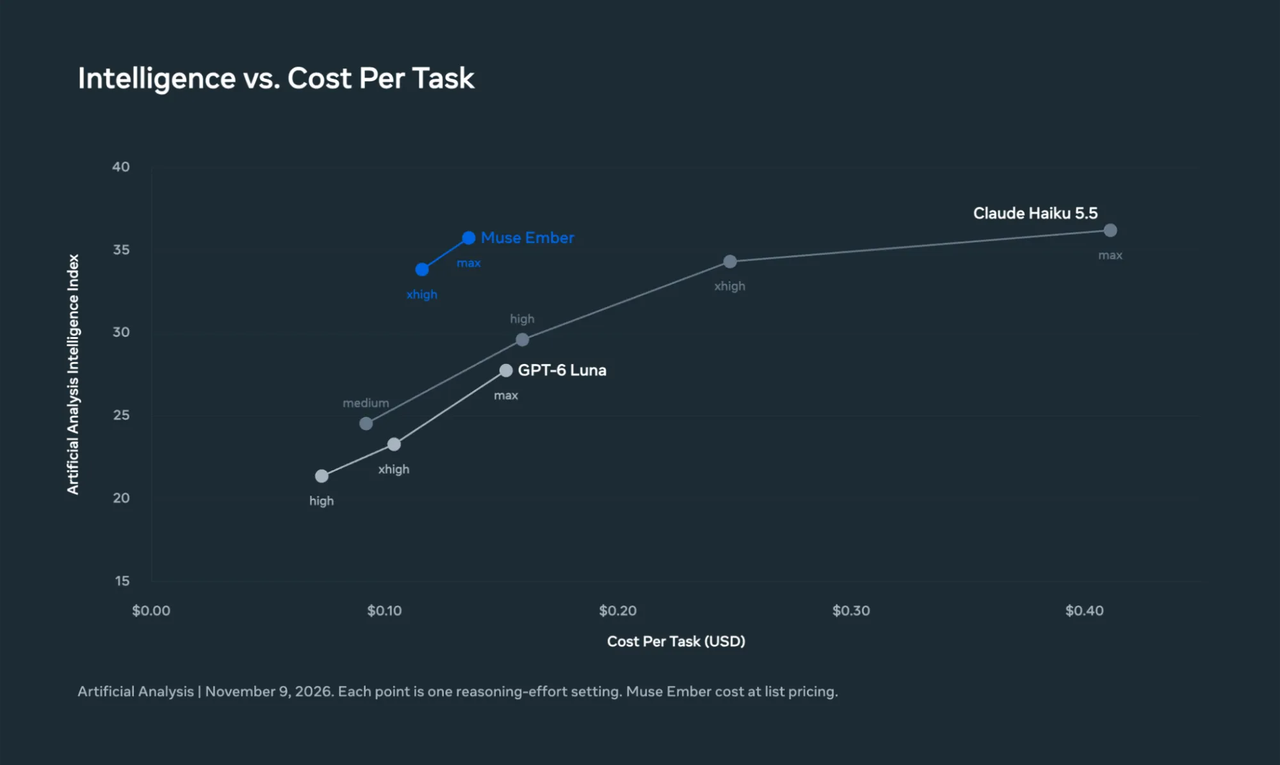
Meta’s grafiek vergelijkt Artificial Analysis Intelligence Index-scores met geschatte kosten per taak bij verschillende redeneringsinspanning-standen.
Bij maximale redeneringsinspanning scoort Muse Ember 35,8 op de Artificial Analysis Intelligence Index bij een geschatte $0,136 per taak. Haiku 5.5 scoort 36,2 bij $0,411, terwijl GPT-6 Luna 27,8 scoort bij $0,152. Op deze benchmark benadert Ember Haiku’s score voor ongeveer een derde van de taakkosten en overtreft Luna’s score tegen een iets lagere kost.
Deze schattingen gebruiken benchmark-tokenverbruik en lijstprijzen. De volgende evaluatie laat zien waarom toolactiviteit ertoe doet bij het kiezen van een model voor een specifieke workflow.
Onafhankelijke data-analyseresultaten
Plotly’s data-analyse-evaluatie van 10 november 2026 testte 43 vragen in Plotly Studio Embedded tegen een synthetische wind-energydataset. Muse Ember liep via OpenRouter; de gerapporteerde kosten gebruiken de prijzen die golden toen elk model draaide. Het zijn workload-specifieke resultaten, geen Meta-native API-billingtest.
| Evaluatiemetriek | Muse Ember | GPT-6 Luna | Claude Haiku 5.5 |
|---|---|---|---|
| Geslaagde vragen | 38/43 | 38/43 | 37/43 |
| Totale testkost | $1.04 | $0.13 | $0.38 |
| Medianetijd per vraag | 28 seconden | 18 seconden | 14 seconden |
Voor deze data-analyseworkload leverde GPT-6 Luna dezelfde 38/43 score op als Ember voor een achtste van de totale kost, met een lagere mediane responstijd. Haiku was het snelst met 14 seconden per vraag, met 37/43 geslaagd. Luna is de sterkere startkandidaat voor een vergelijkbare, kostengevoelige analytics-workflow; Ember’s lage tokenrate alleen maakt het niet de goedkoopste keuze.
Plotly vond dat Muse Ember gemiddeld 78 queries deed bij vragen met verborgen patronen, vergeleken met een mediaan van 25 over de geteste modellen. De extra toolactiviteit verhoogde het tokenverbruik en de totale kost.
De test liet ook sterke punten zien: Muse Ember beantwoordde alle 20 duidelijk gedefinieerde analytische vragen, alle vijf ambigue vragen, alle vijf onmogelijke verzoeken en alle drie datakwaliteitschecks correct. Het had de meeste moeite met verborgen patronen in de data.
Plotly draaide elk model één keer en observeerde variatie tot drie vragen bij het herhalen van andere modellen. Behandel de 38 versus 37 scores als nagenoeg gelijk; het duidelijkere verschil hier is toole gebruik en totale kost.
Muse Ember vs Muse Wonder vs Muse Spark
Kies een Muse-model op basis van de verantwoordelijkheid die het op zich neemt: planning, de hoofdagentloop of herhaalde executie.
| Dimensie | Muse Wonder | Muse Spark 1.3 | Muse Ember |
|---|---|---|---|
| Primaire rol | Frontier-redeneren en complexe engineering | Hoofdcode- en agentmodel | Executie met hoog volume |
| Belangrijkste kracht | Planning, langlopende taken, complexe code | Coding en agentische workflows | Repetitieve subtaken en tool-calls |
| Typische workload | Engineering op repository-schaal | Hoofdagent-executie | Classificatie, routering, extractie |
| API-model-ID | muse-wonder-1.0 | muse-spark-1.3 | muse-ember-1.0 |
| Contextvenster | 1M tokens | 1M tokens | 1M tokens |
| Standaardredenering | Max | High | Max |
| Standaard inputprijs / 1M | $4.00 | $1.25 | $0.10 |
| Standaard outputprijs / 1M | $20.00 | $4.25 | $0.50 |
De tabel gebruikt Meta’s tokenprijzen in Standard-modus. Ember’s prijzen hier gelden voor aanvragen tot 200K inputtokens; Wonder en Spark hebben niet Ember’s long-context-premium.
Selectie van Muse-modellen
Kies Wonder voor moeilijke planning, engineering op repository-schaal en herstel over lange sequenties van stappen. Kies Spark om de hoofdcode- of agentloop te draaien. Kies Ember voor herhaalbare subtaken met onafhankelijk verifieerbare outputs, zoals routering, extractie en gerichte bestandswijzigingen.
Een repositorymigratie kan bijvoorbeeld dependency-analyse toewijzen aan een groter model en een nauw afgebakende bestandswijziging aan Ember. De overdracht moet de bestanden, het verwachte gedrag en de acceptatiechecks noemen. Die verdeling is alleen nuttig wanneer coördineren en beoordelen van de kleinere taken minder kost dan het hele werk met het hoofdmodel voltooien.
Om tussen hen te kiezen, voer je dezelfde representatieve taken uit via je kandidaten met dezelfde acceptatiechecks. Verwerp eerst configuraties die je vereiste succesratio of latentiedoel missen. Vergelijk onder de overblijvers de totale uitgaven gedeeld door geaccepteerde resultaten, inclusief retries en tool-aanroepen. Wijs Ember die taaktypen toe waar het die kost verlaagt, en routeer onopgeloste gevallen terug naar Spark of Wonder.
Wat kost Muse Ember?
De tabel koppelt Meta’s officiële tarieven aan een 20%-kortingsschatting voor CometAPI, in USD per miljoen tokens. Elke cel toont Meta / korting-schatting. CometAPI’s vermelding publiceert nog geen live-tarief; gebruik de kortingcijfers voor budgetplanning.
| Gebruik per 1M tokens (Meta / 20%-kortingsschatting) | Tot 200K inputtokens | Boven 200K inputtokens |
|---|---|---|
| Input | $0.10 / $0.08 | $0.30 / $0.24 |
| Gecachte input | $0.004 / $0.0032 | $0.012 / $0.0096 |
| Output | $0.50 / $0.40 | $1.50 / $1.20 |
Het totale aantal inputtokens van de aanvraag, inclusief gecachte input, bepaalt de tier. Een aanvraag boven 200K inputtokens gebruikt de hogere tarieven voor de volledige aanvraag, inclusief de output. Met Meta’s previous_response_id telt opgeslagen gespreksgeschiedenis mee voor het inputtotaal.
Typische kosten voor een Muse Ember-aanvraag
Met ongecachte input en 20K gefactureerde uitvoertokens, inclusief redenering, kost een aanvraag met 200K input $0,0300 tegen Meta’s tarieven, of $0,0240 in het 20%-kortingsscenario. Het verhogen van de input naar 220K verplaatst de volledige aanvraag naar de hogere tier: dezelfde 20K output brengt de totalen dan op $0,0960 bij Meta’s tarieven, of geschat $0,0768 met de korting. Deze voorbeelden sluiten afzonderlijke toolkosten uit. Relevante context binnen de lagere tier houden kan meer besparen dan een korting van 20% alleen.
| Scenario | Inputtokens | Gefactureerde uitvoertokens | Meta-kost | CometAPI-kost |
|---|---|---|---|---|
| Standaardaanvraag | 200K | 20K | $0.0300 | $0.0240 |
| Long-context-aanvraag | 220K | 20K | $0.0960 | $0.0768 |
Redeneringstokens tellen als gefactureerde output. Voor Meta’s native API kost web search grounding aanvullend $2,50 per 1.000 queries, en Ember heeft geen Contributor-modevariant. De tokenprijzentabel hierboven past de 20% korting niet toe op afzonderlijke toolkosten.
Hoe krijg je toegang tot Muse Ember?
CometAPI-vermelding: de modelpagina identificeert het model als muse-ember, maar de catalogusstatus is Coming soon per 16 november 2026. Volg die pagina voor activatie en prijzen; gebruik voor directe toegang Meta Model API of Muse Code.
Via Meta Model API: gebruik muse-ember-1.0 met https://api.meta.ai/v1. De native API ondersteunt Responses-, Chat Completions- en Messages-formaten. Bestandsinputs gebruiken Responses. Houd elke provider’s endpoint en modelidentifier samen bij het configureren van je client.
Native API-limieten en andere toegang: Meta vermeldt 3.000 requests per minuut en 4.000.000 tokens per minuut per team, gedeeld door de API-sleutels van het team. Muse Ember is ook beschikbaar in Muse Code. Controleer de limieten van je gekozen route bij het dimensioneren van een batch, en gebruik Meta’s integratiegids voor native API-setup.
Wat zijn de beperkingen van Muse Ember?
Drie factoren bepalen of Ember geschikt is voor je volgende workflow:
- Complexe engineering blijft afhankelijk van de workload. Ember blijft achter bij Haiku 5.5 op FrontierCode 2.0-AA ondanks de sterkere Terminal-Bench-score. Een smalle codewinst bewijst niet de geschiktheid voor elke repository-schaalwijziging.
- Lang context en lage tokenprijzen garanderen geen lage taakkosten. Grote aanvragen gaan naar een hogere prijstier, en herhaald toole gebruik kan genoeg tokens verbruiken om het lage per-token tarief te overtreffen.
- Tool-ondersteuning vereist nog steeds een toepassing. Het omliggende systeem voert aanroepen uit, beheert permissies en valideert resultaten. Het vermogen van een model om een actie aan te vragen levert op zichzelf geen betrouwbare workflow op.
Conclusie
Adopteer Ember waar de acceptatiecriteria duidelijk genoeg zijn om te meten. Een nuttige eerste uitrol is een stap met hoog volume die al een bekend resultaat heeft, zoals het routeren van gelabelde tickets of het extraheren van velden uit beoordeelde documenten. Vergelijk kosten per succesvolle taak, foutpercentages en latentie met je huidige model voordat je de rol uitbreidt. Dat bewijs vertelt je of Ember de kosten van je workflow verlaagt terwijl de benodigde kwaliteit behouden blijft.
Veelgestelde vragen
Hoe moet je Muse Ember-extractieresultaten valideren?
Bouw een referentieset van documenten met door mensen gecontroleerde antwoorden, inclusief ontbrekende velden, onleesbare scans en tegenstrijdige waarden. Meet nauwkeurigheid per veld in plaats van elke geldige JSON-respons als succes te behandelen. Controleer of elke geëxtraheerde waarde wordt ondersteund door de aangehaalde bronpassage, en stuur mismatchen naar review. Dit scheidt formatteringsbetrouwbaarheid van feitelijke betrouwbaarheid.
Wanneer moet een Muse Ember-subtaak terug naar de hoofdagent?
Definieer escalatievoorwaarden vóór uitvoering: een vereist bestand valt buiten de toegewezen scope, de bronnen spreken elkaar tegen, een acceptatiecheck mislukt herhaaldelijk, of de taak vereist een beslissing die de worker niet gemachtigd was te nemen. Geef het bewijs, de pogingen en de onopgeloste vraag terug aan de hoofdagent. Een duidelijke overdracht is nuttiger dan de worker zijn opdracht onbeperkt te laten verbreden.
Wat moet je loggen bij het testen van Muse Ember in productie?
Log de exacte provider en modelidentifier, redeneringsinstelling, input en gefactureerde outputtokens, gecachte tokens, aantal tool-aanroepen, retries, latentie en het uiteindelijke acceptatieresultaat. Bewaar de validatie-uitkomst naast het gebruiksrecord zodat je kosten per geaccepteerde taak kunt berekenen. Vergelijk vergelijkbare taaktypen afzonderlijk; een gemiddelde over routering, coding en long-documentwerk kan verhullen waar het model helpt of kosten toevoegt.
Hoe voorkom je dubbele acties in een Muse Ember-workflow?
Maak de toepassing verantwoordelijk voor actie-identiteit en voltooiingsstatus. Wijs voor een bewerking zoals het aanmaken van een ticket een stabiele operatiekey toe, controleer of deze al is voltooid, en gebruik idempotentie-ondersteuning van de bestemmings-API wanneer beschikbaar. Inspecteer na een timeout de status van de actie voordat je opnieuw probeert. Dit ontwerp voorkomt dat een onzekere respons wordt behandeld als bewijs dat de oorspronkelijke actie nooit heeft plaatsgevonden.