
TL;DR
Claude Haiku 5.5 og GPT-6 Luna er rimelige resonneringsmodeller for API-arbeidsbelastninger med høyt volum. Begge starter på $0.10 per million input-tokens og $0.50 per million output-tokens. Haiku scorer høyere på de seks sammenligningene publisert i Anthropics lanseringsmateriale. Luna beholder sine grunnsatser for tokens for prompt opp til 272K input-tokens, sammenlignet med Haikus 100K-terskel. For utviklere er nøkkelmålene akseptrate, ende-til-ende-latens, API-kompatibilitet og kostnad per akseptert resultat—den totale kostnaden for alle forsøk dividert på antall utdata som består forhåndsdefinerte kontroller.
Nøkkelpunkter
- Haiku 5.5 leder den siterte OSWorld 2.1-computer-use-sammenligningen, 72.4% mot Lunas 48.9%.
- På Terminal-Bench 4.0 er de siterte resultatene 39.2% for Haiku og 16.4% for Luna.
- Begge starter med identiske priser for kort kontekst, men Haikus høyere pristrinn starter over 100K prompt-tokens, mot Lunas 272K-terskel.
- Artificial Analysis’ maks-innsats-modellsider, sjekket 9. oktober 2026, viser utdatahastigheter på 240.6 tokens/s for Haiku og 123.0 tokens/s for Luna; gjennomstrømning ekskluderer ventetid til første token.
- Start med Haiku for oppgaver i databruk og terminal som reflekteres i delte benchmarks; vurder Luna for store prompter. Behold nåværende modell til et representativt pilotforsøk demonstrerer en nyttig forbedring.
Hva er Claude Haiku 5.5 og GPT-6 Luna?
Claude Haiku 5.5: Oversikt
Claude Haiku 5.5 ble lansert 7. oktober 2026. Den kombinerer rimelig inferens med justerbar resonnering, verktøybruk, lang kontekst og tekst- og bildeinput. Typiske bruksområder inkluderer dokumentuttrekk, databasespørringer, kundestøtte og lette subagenter.
GPT-6 Luna: Oversikt
GPT-6 Luna ble lansert 22. september 2026. Den er posisjonert for fokuserte oppgaver i skala, inkludert klassifisering, informasjonsuttrekk, strukturert utdata, programmeringshjelp og langdokumentprosessering. De fleksible resonnneringsinnstillingene inkluderer en non-reasoning-konfigurasjon for enklere arbeid.
Spesifikasjoner
| Spesifikasjon | Claude Haiku 5.5 | GPT-6 Luna |
|---|---|---|
| Utvikler | Anthropic | OpenAI |
| Lansering | 7. oktober 2026 | 22. september 2026 |
| Modell-ID | claude-haiku-5-5 | gpt-6-luna |
| Kontekstvindu | 1,000,000 tokens | 1,050,000 tokens |
| Maksimalt utdata (standard API) | 128,000 tokens | 128,000 tokens |
| Inndata | Tekst og bilde | Tekst og bilde |
| Utdata | Tekst | Tekst |
| Resonnering | Justerbar, lav til maks | Ingen til maks |
| Standard innsats | Medium | Medium |
| Kunnskapsavgrensning | juni 2026 | 18. mai 2026 |
| Verktøybruk | Ja | Ja |
| Strukturert utdata | Ja | Ja |
| Åpne vekter | Nei | Nei |
| Arkitektur og antall parametere | Ikke spesifisert i de siterte offisielle materialene | Ikke spesifisert i de siterte offisielle materialene |
Spesifikasjonene bruker leverandørenes standard dokumentasjon for API-modeller, sjekket 9. oktober 2026: Haikus standard API-spesifikasjoner og Lunas standard API-spesifikasjoner. Arkitektur og parameterantall er ikke oppgitt fordi disse kildene ikke etablerer dem.
Claude Haiku 5.5 vs GPT-6 Luna: Benchmark-resultater
| Benchmark | Haiku 5.5 | GPT-6 Luna | Leder |
|---|---|---|---|
| GDPval-AA v2.1 (Elo) | 1,620 | 1,437 | Haiku +183 |
| AA-Briefcase v1.1 (Elo) | 1,578 | 1,336 | Haiku +242 |
| OSWorld 2.1, offline delpoengsum | 72.4% | 48.9% | Haiku +23.5 pp |
| Terminal-Bench 4.0 | 39.2% | 16.4% | Haiku +22.8 pp |
| FrontierCode 1.1 Main | 46.4% | 42.4% | Haiku +4.0 pp |
| Chartography, uten verktøy | 46.4% | 29.1% | Haiku +17.3 pp |
De seks radene over gjengir Anthropics publiserte lanserings-sammenligningsresultater, sjekket 9. oktober 2026. Dette er sammenligninger publisert av Anthropic, inkludert uavhengige resultater gjengitt der, snarere enn nye tester kjørt for denne artikkelen. GDPval-AA og AA-Briefcase er Elo-poeng; prosentgapene er prosentpoeng. Disse benchmark-familiene måler forskjellige oppgaver og bør ikke gjennomsnittliges til en universell vinner.
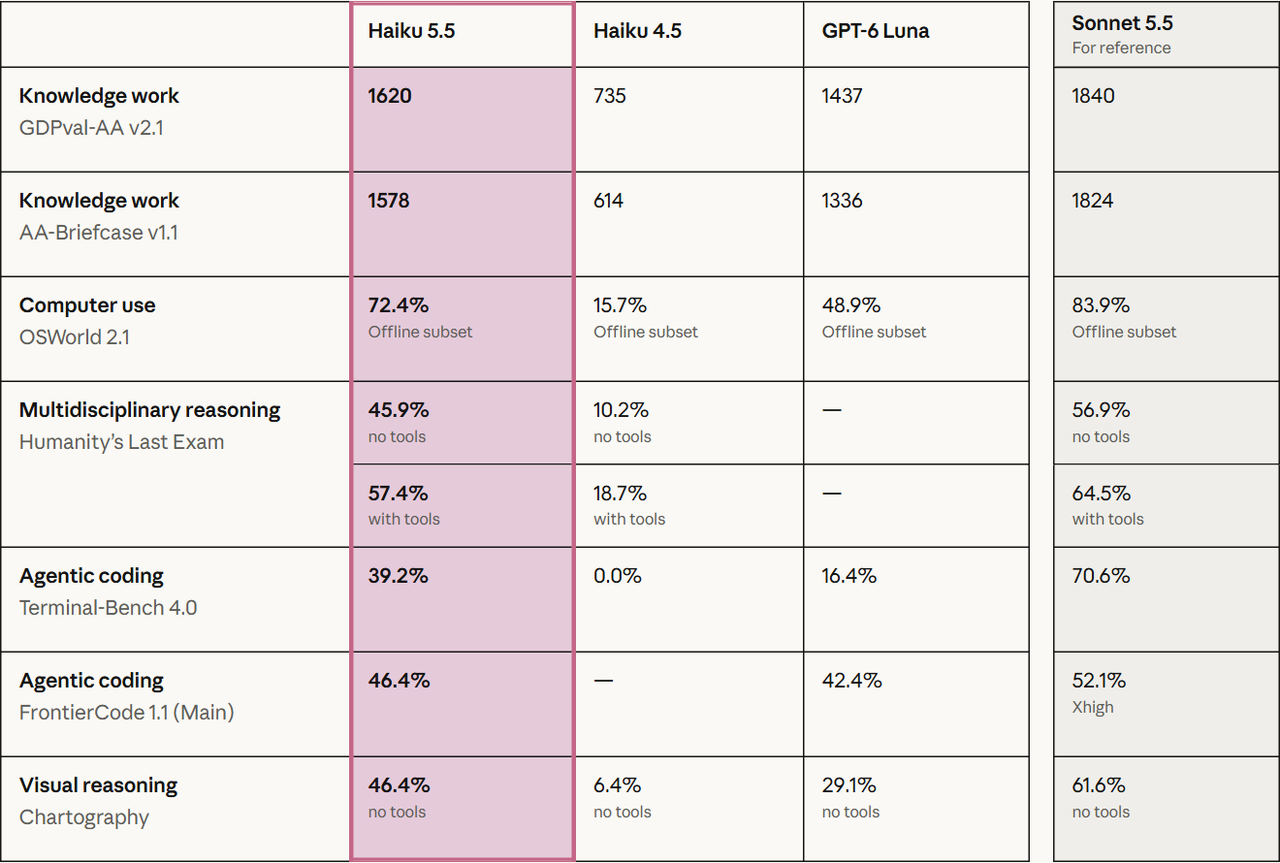
Haikus sterkeste relative resultater i denne lanseringstabellen fremstår i visuell datamaskininteraksjon og terminalbaserte oppgaver. Den mindre ledelsen i FrontierCode advarer mot å ekstrapolere et 20-poengs gap til enhver kodingssituasjon. Bruk disse resultatene til å velge pilotkandidater, og valider deretter promptene og verktøystakken din.
Resonneringsinnsats og evalueringsgrenser
Resonneringsinnsats endrer nøyaktighet–kost-nivået. Sammenlign tilgjengelige innstillinger med samme arbeidslast og rammeverk; like leverandørnavn på innstillinger garanterer ikke like resonnementstoken-budsjetter. Lanseringstabellen rapporterer OSWorlds offline-undermengde og Chartography uten verktøy. Rammeverk, oppgavevalg, gjentakelser og verktøystøtte kan endre utfallet. Anthropics systemkort dokumenterer benchmark-spesifikke betingelser. Les benchmark-metodene i Anthropics systemkort.
- OSWorld bruker 82-oppgavens offline-undermengde, en Ubuntu virtuell maskin, 1080p skjermbilder, en grense på 500 handlinger, maks innsats og fem forsøk per oppgave. 72.4%/48.9%-sammenligningen er delkreditt-poenggiving, ikke andelen perfekt fullførte oppgaver; Haikus strenge beståttandel er 37.1%. Anthropic kjørte Luna på samme oppgaveundermengde via OpenAIs API.
- Terminal-Bench bruker 66 containeriserte oppgaver; Haiku kjørte med maks innsats i Claude Code bare mode, uten utgående internettrafikk eller en fallback-modell, med i snitt ti forsøk per oppgave.
- FrontierCode Main inneholder 100 oppgaver med fem kjøringer per oppgave; Claude-modeller brukte Claude Code og GPT-modeller brukte Codex.
- GDPval-AA og AA-Briefcase ble uavhengig evaluert av Artificial Analysis og gjengitt i lanseringsmaterialet. Dette er separate evalueringspipeliner, ikke ett delt produksjonsrammeverk.
Claude Haiku 5.5 vs GPT-6 Luna: Funksjonssammenligning
Databruk og agentisk koding
Haikus sterkeste fordel ligger i de delte lanseringsoppgavene som krever interaksjon med en grafisk datamaskin eller arbeid i en terminal. OSWorlds delpoeng-gap er 23.5 prosentpoeng, mens Terminal-Bench skiller 22.8 poeng. FrontierCodes mindre forskjell på 4.0 poeng viser hvorfor den bredere kategorien koding ikke bør behandles som én enkelt arbeidslast.
For nettleserautomatisering: test sidenavigasjon, skjemautfylling, gjenoppretting fra verktøyfeil og ende-til-ende fullføring. For koding: test om en patch består kodelagerets funksjonelle kontroller og holder seg innenfor omfang. Disse akseptkontrollene er mer nyttige enn å velge en modell basert på det største overskriftsgapet.
Lang kontekst og dokumentbehandling
Den 5% nominelle forskjellen i kontekstkapasitet er mindre viktig enn påliteligheten og prisen for å prosessere store prompter. Ingen av modellene er iboende overlegne i informasjonsgjenfinning bare fordi kontekstvinduet er større.
Nøkkelforskjellen er når høyere satser gjelder: en prompt på 150K tokens krysser Haikus terskel mens den forblir innenfor Lunas grunntariff. Luna er derfor det rimeligere utgangspunktet for den token-arbeidslasten. Om den er den bedre dokumentanalytikeren avhenger fortsatt av utvinningsnøyaktighet, siteringer og antall forsøk som kreves for å få et akseptabelt svar.
Resonneringskontroller
Begge modellene eksponerer justerbar resonneringsinnsats, med medium som standard i de siterte dokumentene. Luna eksponerer også en none-innstilling. Bruk disse kontrollene for å passe oppgaven: utvinning og ruting kan kreve mindre resonnering enn en usikker flertrinns verktøyarbeidsflyt. Samme innsatsmerkelapp innebærer ikke samme beregningsbudsjett på tvers av leverandører.
Multimodal inndata og strukturerte arbeidsflyter
Begge aksepterer tekst og bilder og produserer tekst. Dette gjør dem aktuelle for skjermbilder, dokumentbilde-uttrekk og strukturerte nedstrøms arbeidsflyter. Støtte for inndata alene etablerer ikke lik nøyaktighet på liten tekst, diagrammer eller visuelle grensesnitt; mål disse tilfellene separat.
Hastighet og oppgaveøkonomi
| Uavhengig metrikk (maks innsats) | Haiku 5.5 — Artificial Analysis | GPT-6 Luna — Artificial Analysis |
|---|---|---|
| Intelligence Index v4.3.2 | 43 | 38 |
| Utdatahastighet | 240.6 tokens/s | 123.0 tokens/s |
| Vektet kostnad per Intelligence Index-oppgave | $0.21 | $0.07 |
Artificial Analysis er den uavhengige testutgiveren. Tabellen er et øyeblikksbilde av deres maks-innsats-modellsider sjekket 9. oktober 2026, heller enn offisiell leverandørytelse. Utdatahastighet måler tokens mottatt etter at generering begynner; den er separat fra tid til første token og total oppgavelatens. Kostnad per oppgave er en vektet Intelligence Index-metrikk, ikke et pristilbud for din produksjonsoppgave eller en kostnad per vellykket resultat.
Haikus øyeblikksbilde for utdata-gjennomstrømning er omtrent 1.96 ganger Lunas, mens Lunas vektede evalueringsoppgavekostnad er lavere. Dette etablerer ikke en 1.96-dobbel fordel i total oppgavefullføringstid. Produksjonstesting bør registrere tid til første token, fullføringstid, utdatalengde, resonnneringsforbruk og verktøykjøretid separat.
Claude Haiku 5.5 vs GPT-6 Luna: Priser og API-tilgang
Offisielle standardsatser
| USD per 1M tokens | Haiku ≤100K | Haiku >100K | Luna ≤272K | Luna >272K |
|---|---|---|---|---|
| Inndata | $0.10 | $0.50 | $0.10 | $0.20 |
| Bufret lesing | $0.01 | $0.05 | $0.01 | $0.02 |
| Cache-skriving (Haiku: 5-minutters TTL) | $0.125 | $0.625 | $0.125 | $0.25 |
| Utdata | $0.50 | $2.50 | $0.50 | $0.75 |
USD per million tokens ved standard prosesseringssatser, sjekket 9. oktober 2026. Tabellen bruker Haikus standard- og 5-minutters cache-skrivingssatser og Lunas kort- og langkontekst-satser. Verktøyavgifter, skatter, regionale påslag og valgfrie justeringer av prosesseringstrinn er ekskludert. Over inndata-terskelen dekker de høyere gjeldende satsene forespørselen, ikke bare overskytende tokens.
Den sentrale forskjellen er faktureringsgrensen. Haiku går til høyere satser utover 100K prompt-tokens, mens Luna beholder lavt trinn opp til 272K. Selv over den terskelen er Lunas siterte input- og utdata-priser for lang kontekst lavere.
Haiku tilbyr også cache-skriving med 1-times varighet til $0.20/$1.00 per million tokens for korte/lange prompter. Cache-utholdenhet og prismekanismer varierer mellom leverandører, så sammenlign gjenbruks-mønstre i stedet for å behandle begge cache-skrive-radene som identiske produkter. Haikus 128K utdatagrense er standard API-grense; dens Message Batches API kan støtte 300K utdata med en beta-header.
Illustrerende kostnader ved faste token-budsjetter
| Arbeidsmengde | Inndata / Utdata | Haiku 5.5 | GPT-6 Luna |
|---|---|---|---|
| Saksklassifisering | 2K / 200 | $0.0003 | $0.0003 |
| Kort rapport | 40K / 4K | $0.006 | $0.006 |
| Repository-analyse | 150K / 5K | $0.0875 | $0.0175 |
| Gjennomgang av stort dokument | 300K / 10K | $0.175 | $0.0675 |
| Analyse med massiv kontekst | 800K / 20K | $0.45 | $0.175 |
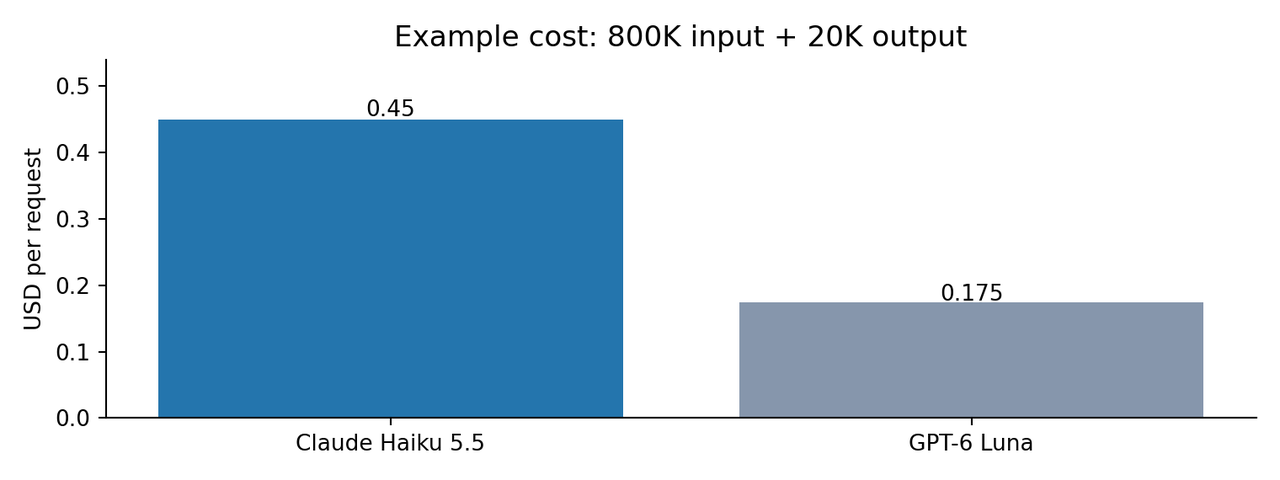
Forfatterberegnet, ikke-bufret anslag med standardsats: kostnad = input-tokens × input-sats / 1,000,000 + fakturerte output-tokens × output-sats / 1,000,000. “Output” betyr total fakturert utdata for dette anslaget, inkludert resonnementstokens der de belastes som utdata; det er ikke nødvendigvis synlig svarelengde. De samme rapporterte token-tellingene brukes for begge modeller, selv om tokenizerne kan variere.
En billig token er ikke nødvendigvis et billig vellykket utfall. Team bør ta hensyn til gjentatte forsøk, mislykkede verktøykall, forbruk av resonnementstokens og ulik tokenizer-oppførsel.
CometAPI-tilgang og integrasjonsbegrensninger
CometAPI tilbyr tilgangsalternativer for begge modellene. Før du sammenligner eller distribuerer dem via gatewayen, verifiser modell-ID-er, støttede endepunkter, forespørselsparametere, verktøyatferd og faktureringsregler for hver rute. Disse leverandørlenkene dokumenterer tilgangsalternativer; de erstatter ikke leverandørenes tekniske eller standardprisingskilder.
For direkte OpenAI-integrasjoner støtter Luna innebygde verktøy via Responses API; Chat Completions-funksjonskalling krever resonneringsinnsatsnivået "none". Haiku bruker Anthropics Messages API og adaptiv tenkning. En gateway gjør ikke de underliggende skjemaene ombyttbare: valider verktøydefinisjoner, oppførsel for strukturert utdata, strømmehendelser og regnskap med nøyaktig den ruten du har tenkt å bruke.
Hvordan kan utviklere sammenligne Claude Haiku 5.5 og GPT-6 Luna med samme prompt?
Eksempel på utvinning fra lang dokumenttekst
En praktisk sammenligning kan bruke en bunke med leverandørkontrakter som inneholder ikrafttredelsesdatoer, fornyelsesvilkår, oppsigelsesfrister og unntak. Hold dokumentbunken, utvinningsinstruksjoner, forventede felt og valideringsregler identiske. Det følgende er et evalueringsdesign, ikke et nytt målt modellresultat.
Eksempelprompt: Ekstraher for hver kontrakt leverandørnavn, ikrafttredelsesdato, fornyelsesdato, oppsigelsesfrist og prisunntak. For hver ekstrahert verdi, oppgi dokumenttittel og eksakt underbyggende tekstutdrag. Returner null når et felt mangler; ikke utled manglende datoer. Marker motstridende klausuler og hold det endelige svaret innenfor 1,000 ord.
| Sjekk | Akseptkriterium | Hva som skal registreres |
|---|---|---|
| Treffsikkerhet i utvinning | Påkrevde felt samsvarer med en uavhengig kontrollert fasit | Korrekte, feilaktige og manglende verdier |
| Forankring | Hvert ikke-null-felt har et gyldig underbyggende utdrag | Uunderbygde påstander og feil dokumenthenvisninger |
| Instruksjonsoppfølging | Ingen oppdiktede datoer; manglende felt returnerer null | Skjemafeil og brudd på begrensninger |
| Økonomi | Beregn kostnad per akseptert utvinning | Fakturert inndata, utdata, resonnement, forsøk og fallback-kostnad |
| Latens | Sammenlign full jobbfullføring under samme verktøypraksis | Tid til første token og ende-til-ende-tid |
Kjør mer enn én representativ bunke og gjenta tilfellene der resultatene varierer. Start med samme tilgjengelige innsatsnivå, test deretter en rimeligere konfigurasjon for hver modell. Rapporter utvalgsstørrelse, innstillinger, rute, dato og antall feil før du presenterer en vinner.
Haiku 5.5 eller GPT-6 Luna: Hvilken skal du velge?
| Dimensjon | Bedre startpunkt | Beslutningsgrense |
|---|---|---|
| GUI-interaksjon | Claude Haiku 5.5 | Delte OSWorld-delpoeng favoriserer Haiku; verifiser full oppgavefullføring |
| Terminalkoding | Claude Haiku 5.5 | Delte Terminal-Bench-poeng favoriserer Haiku; valider endringer i kodelager |
| Korte prompt og basispriser | Test begge | Identiske grunnsatser; sammenlign fakturert bruk og antall forsøk |
| Prompter over 100K tokens | GPT-6 Luna på standardsatser | Luna beholder grunntrinnet lenger; nøyaktighet kan endre totalkostnad |
| Strømmet token-gjennomstrømning | Claude Haiku 5.5 i datert øyeblikksbilde | Gjennomstrømning avviker fra total fullføringslatens |
| Enkel gjentatt utvinning | Test Luna med lav eller ingen resonnering | Velg etter gyldig akseptert utdata, ikke pris alene |
Velg Claude Haiku 5.5 for benchmark-relevante interaktive oppgaver
Start med Haiku når applikasjonen ligner de publiserte grafiske datamaskin-, terminalkodings- eller profesjonelle arbeidsoppgavene, og en høyere fullføringsrate vil oppveie ekstra resonnement eller langkontekst-kostnader. Bekreft den fordelen i din egen verktøystakk før du ruter produksjonstrafikk.
Velg GPT-6 Luna for kostnadskontroll ved store prompter
Start med Luna når prompter ofte overstiger 100K tokens og standard tokenkostnader i vesentlig grad påvirker budsjettet. Den er også en kandidat for gjentatt utvinning eller ruting som kan lykkes med lav eller ingen resonnering. Hold anbefalingen betinget av akseptrater og faktisk fakturert bruk.
Bruk begge når arbeidslastene har ulike behov
En pilot kan rute langdokument-utvinning til Luna og GUI- eller terminaloppgaver til Haiku, og deretter validere hvert valg mot akseptkontroller. Utløs en fallback når en utdata feiler skjemavalidering, mangler nødvendig evidens, eller feiler en oppgavespesifikk sjekk, og inkluder fallback-kostnader og latens i sammenligningen.
Valider før du bytter
Inkluder nåværende modell som basislinje. Bytt først når kandidaten møter en forhåndsdefinert korrekthetsmålsetning og forbedrer kostnad per akseptert resultat eller ende-til-ende-latens nok til å dekke migrasjon og vedlikehold. Sett utrulling på vent hvis kritiske verktøyfeil øker. Anbefalingen endres hvis piloten viser at Lunas lavere sats oppveies av flere forsøk, eller at Haikus høyere benchmark-poeng ikke forbedrer oppgavesuksess.
- Bruk et representativt arbeidslastutvalg og vurder korrekte, feilaktige og ufullstendige resultater.
- Mål latens til første token, ende-til-ende oppgavetid og verktøypålitelighet.
- Før separat oversikt over antall inndata-, cachede, utdata- og resonnementstokens.
- Beregn kostnad per vellykket resultat, inkludert forsøk og fallbacks.
- Sammenlign medium og høy resonneringsinnsats før du aktiverer maksinnstillinger som standard.
Konklusjon
Claude Haiku 5.5 har sterkere hode-til-hode-lanseringsbevis på tvers av de profesjonelle arbeids-, databruks- og agentiske kodings-benchmarkene som er sammenlignet her. Den har også høyere utdata-gjennomstrømning i det uavhengige øyeblikksbildet. GPT-6 Luna har en tydelig fordel i standardsatser for prompter over Haikus 100K-terskel og lavere vektet evalueringsoppgavekostnad. Ingen av observasjonene alene avgjør produksjonspålitelighet eller kostnad per vellykket resultat.
Den praktiske vinneren er modellen som leverer et akseptabelt resultat til lavest fullt målt driftskostnad. Kjør begge mot egne prompter, verktøy og retry-regler, i stedet for å behandle én enkelt benchmark som fasit.
FAQ
Hvorfor kan oppgavekostnader variere når begge modellene har samme grunnpris per token?
Samme grunnpris betyr ikke samme totalregning. Modeller kan bruke ulike mengder inndata-, utdata- og resonnementstokens, og kan trenge forskjellig antall forsøk eller verktøykall for å produsere et akseptabelt resultat. Satser for lang kontekst og cache-bruk påvirker også totalen. Sammenlign total kostnad for alle forsøk dividert på antall aksepterte resultater, i stedet for bare tokenpriser.
Gjelder høyere langkontekstsatser bare for tokens over terskelen?
Nei. Under standard prising beskrevet i denne artikkelen, innebærer det å krysse inndata-terskelen at de høyere satsene gjelder for forespørselen, ikke bare de overskytende tokens. For eksempel krysser en forespørsel med 150K input-tokens Haikus 100K-terskel, men forblir innenfor Lunas 272K grunntrinn. Bruk gjeldende inndata- og utdatasatser for hele forespørselen når du estimerer kostnad.
Kan Claude Haiku 5.5 og GPT-6 Luna dele en prompt-cache?
Ikke anta at cache-oppføringer overføres mellom modeller eller leverandører. Design separate gjenbruksstrategier, og mål deretter treffrater og fakturert bruk på hver rute. Gateway-støtte, oppbevaringsregler og forespørselsstruktur kan påvirke om gjentatt inndata er kvalifisert for caching; verifiser dette før du anslår besparelser.
Hva bør en Haiku-til-Luna-migrasjonstest dekke?
Test representative tekst- og bildeinndata, påkrevde strukturerte felt, verktøyargumenter, strømmede svar og feilretting. Etabler akseptraten til nåværende system før migrasjon, og sammenlign deretter begge kandidatene under samme retry- og verktøypraksis. Like tokenpriser eller modellekategorier etablerer ikke kompatibilitet.
Bør benchmark-poeng styre en Haiku- eller Luna-fallback?
Bruk poeng til å velge kandidater, og utløse fallbacks ved observerte feil som ugyldige verktøyargumenter, manglende påkrevde felt eller ikke beståtte oppgavesjekker. Spor fallback-frekvens og total fakturert kostnad. En andre modell kan legge til latens og utgift, så verifiser at den forbedrer aksepterte utfall og ikke bare produserer et annet svar.
Kan sensitive data rutes gjennom begge API-ene?
Gå gjennom de eksakte leverandørene og gatewayen, deres gjeldende oppbevaringsinnstillinger, prosesseringslokasjoner, kontraktsvilkår og organisasjonens datapolicy før du ruter sensitive inndata. Modellkapabilitet og prisingstabeller etablerer ikke en rutes egnethet for regulerte eller konfidensielle data. Bruk godkjent rute når disse kravene er avgjørende.