
TL;DR
Claude Opus 5.5 er en sterk startkandidat fordi den tilbyr vesentlig lavere token-priser samtidig som den matcher eller overgår Fable 5.1 på flere publiserte evalueringer, med $4 per million input-tokens og $20 per million output-tokens, sammenlignet med Fable 5.1 på $10 og $50.
Fable 5.1 har fortsatt en rolle når en oppgave er uvanlig vanskelig, langvarig, kostbar å forsøke på nytt, eller forventes å kjøre uten tett oppfølging. Den praktiske regelen er enkel: start med Opus 5.5, og eskaler først når representative produksjonstester viser at Fable 5.1 reduserer feil-, korrigerings- eller retry-kostnader nok til å rettferdiggjøre premien.
Claude Opus 5.5 vs Claude Fable 5.1 i korte trekk
| Dimensjon | Claude Opus 5.5 | Claude Fable 5.1 |
|---|---|---|
| Lanseringsdato | Sep. 22, 2026 | Sep. 1, 2026 |
| API-modell-ID | claude-opus-5-5 | claude-fable-5-1 |
| Kontekst / maks utdata | 1M / 128K | 1M / 128K |
| Input / output per MTok | $4 / $20 | $10 / $50 |
| Cache-lesing per MTok | $0.20 | $0.25 |
| Terminal-Bench 4.0 | 66.4% | 55.8% |
| FrontierCode v1.1 | 54.4% | 50.3% |
| CursorBench 4.0 | 57.8% | 51.8% |
| GDPval-AA v2.1 | 1846 Elo | 1735 Elo |
| HAProxy C-til-Rust-migrering | 9,5 timer; 51 % lavere oppgavekostnad | 12 timer; baseline-oppgavekostnad |
| Hastighetsalternativ | Fast-modus, opptil 2,5× normal hastighet | Ingen tilsvarende oppstartsmodus |
| Utgangspunkt for innsatsnivå | Mellomnivå-orientert | Høy |
| Beste standardbruk | Daglig frontier-koding, agenter, overvåket produksjon og API-trafikk med høyt volum | Høyest verdi, vanskelig, langvarig eller uovervåket autonomt arbeid |
| API-tilgang | Anthropic API og kompatible leverandører, inkludert CometAPI | Anthropic API og kompatible leverandører, inkludert CometAPI |
Lesemerknad: Benchmark-tallene er rapportert av Anthropic og avhenger av innsatsnivå, harness, sikringstiltak, oppgaveslipp, antall forsøk og standardfeil. De bør kun sammenlignes under matchede evalueringsbetingelser.
Hovedpunkter
- Standardprisene for input og output i Opus 5.5 er 60 % lavere enn Fable 5.1.
- Begge modellene støtter et kontekstvindu på 1M tokens og opptil 128K utdata, så kostnad, innsatsinnstillinger og arbeidslast-tilpasning betyr mer enn nominell kontekststørrelse.
- Anthropic-publiserte resultater favoriserer Opus 5.5 på mange koding- og agentiske evalueringer, men benchmark-oppsettet påvirker resultatene vesentlig.
- Uavhengig evaluering støtter Opus 5.5s frontier-posisjon samtidig som den rapporterer andre absolutte score, noe som understreker behovet for matchede tester.
- For de fleste overvåkede produksjonsoppgaver er Opus 5.5 det sterkere startpunktet. Fable 5.1 er en eskaleringstrinn, ikke det automatiske standardvalget.
Hva er Claude Opus 5.5?
Claude Opus 5.5 er Anthropics første Claude 5.5-modell. Den er posisjonert for agentisk koding, langvarige agenter, profesjonelt kunnskapsarbeid, virksomhetsarbeidsflyter, finansiell analyse, visjon og databruk.
API-modell-IDen er claude-opus-5-5. Adaptiv tenkning er alltid aktivert, mens utviklere styrer resonneringsintensitet gjennom innsatsnivåene low, medium, high, xhigh og max. Anthropic tilbyr også Fast-modus, som kan kjøre opptil 2,5 ganger normal hastighet for $8/M input og $40/M output.
Hva er Claude Fable 5.1?
Claude Fable 5.1 er posisjonert for krevende, langvarige prosjekter som fler-timers koding, kompleks research, nettleserinteraksjon, autonome agenter og arbeidsflyter på tvers av flere applikasjoner.
API-modell-IDen er claude-fable-5-1. Den bruker adaptiv tenkning, starter fra et høyere API-innsatsnivå, og bør behandles som premium-alternativet når forventet kostnad ved feil eller gjentatte retries er høyere enn den ekstra inferenskostnaden.
En forenklet lesning ville være at Opus 5.5 tilbyr nesten samme ramme for 40 % av Fables standard token-pris. Men det er nettopp her en enkel spesifikasjonstabell blir misvisende.
Kode- og benchmark-sammenligning
Anthropic rapporterer Opus 5.5 foran Fable 5.1 på Terminal-Bench 4.0, FrontierCode v1.1, CursorBench 4.0, GDPval-AA v2.1, AutomationBench, Humanity's Last Exam med verktøy, Terminal-Bench-Science, OSWorld 2.0 og Chartography.
Slik leser du benchmark-resultatene
Anthropic rapporterer Opus 5.5 foran Fable 5.1 på Terminal-Bench 4.0, FrontierCode v1.1, CursorBench 4.0, GDPval-AA v2.1, AutomationBench, Humanity's Last Exam med verktøy, Terminal-Bench-Science, OSWorld 2.0 og Chartography. Disse tallene er evalueringsresultater, ikke konfigurasjonsuavhengige modellkonstanter.
De fleste Opus 5.5-topp score brukte max innsats, mens Terminal-Bench 4.0 brukte xhigh innsats. Harness-design, verktøykonfigurasjon, sikringstiltak, antall forsøk, standardfeil, fallback-atferd og kostnadstak kan alle endre resultatet. Anthropic selv advarer om at benchmark-marginer kan overdrive det praktiske gapet mellom frontier-modeller.
Kodeytelse
| Benchmark | Claude Opus 5.5 | Claude Fable 5.1 | Tolkning |
|---|---|---|---|
| Terminal-Bench 4.0 | 66.4% | 55.8% | 10,6-poeng rapportert ledelse for terminal-baserte agentoppgaver |
| FrontierCode v1.1 | 54.4% max; 54.6% medium | 50.3% | Medium-innsats Opus 5.5 forblir konkurransedyktig for produksjonsøkonomi |
| CursorBench 4.0 | 57.8% max; 52.5% medium | 51.8% | Medium innsats overgår så vidt det rapporterte Fable-resultatet |
| GDPval-AA v2.1 | 1846 Elo | 1735 Elo | Rapportert fordel på profesjonelt agentisk arbeid |
Disse tallene er benchmark-resultater rapportert av Anthropic. Tabellen bør leses sammen med forbeholdene om evalueringsoppsett i de følgende seksjonene og den offisielle Claude Opus-modellsiden.
De tre første resultatene skiller seg ut fordi de dekker arbeidslasten der Claude blir stadig viktigere kommersielt: programvare-ingeniøragenter. Terminal-Bench 4.0 viser en absolutt forskjell på 10,6 prosentpoeng; FrontierCode viser 4,1 poeng; CursorBench 4.0 viser 6 poeng.
GDPval-AA, som måler profesjonelt agentisk arbeid, rapporterer også 1846 Elo for Opus 5.5 versus 1735 for Fable 5.1. Hvis disse tallene var hele historien, ville produkthierarkiet se invertert ut. Så enkelt er det ikke.
Uavhengig evaluering
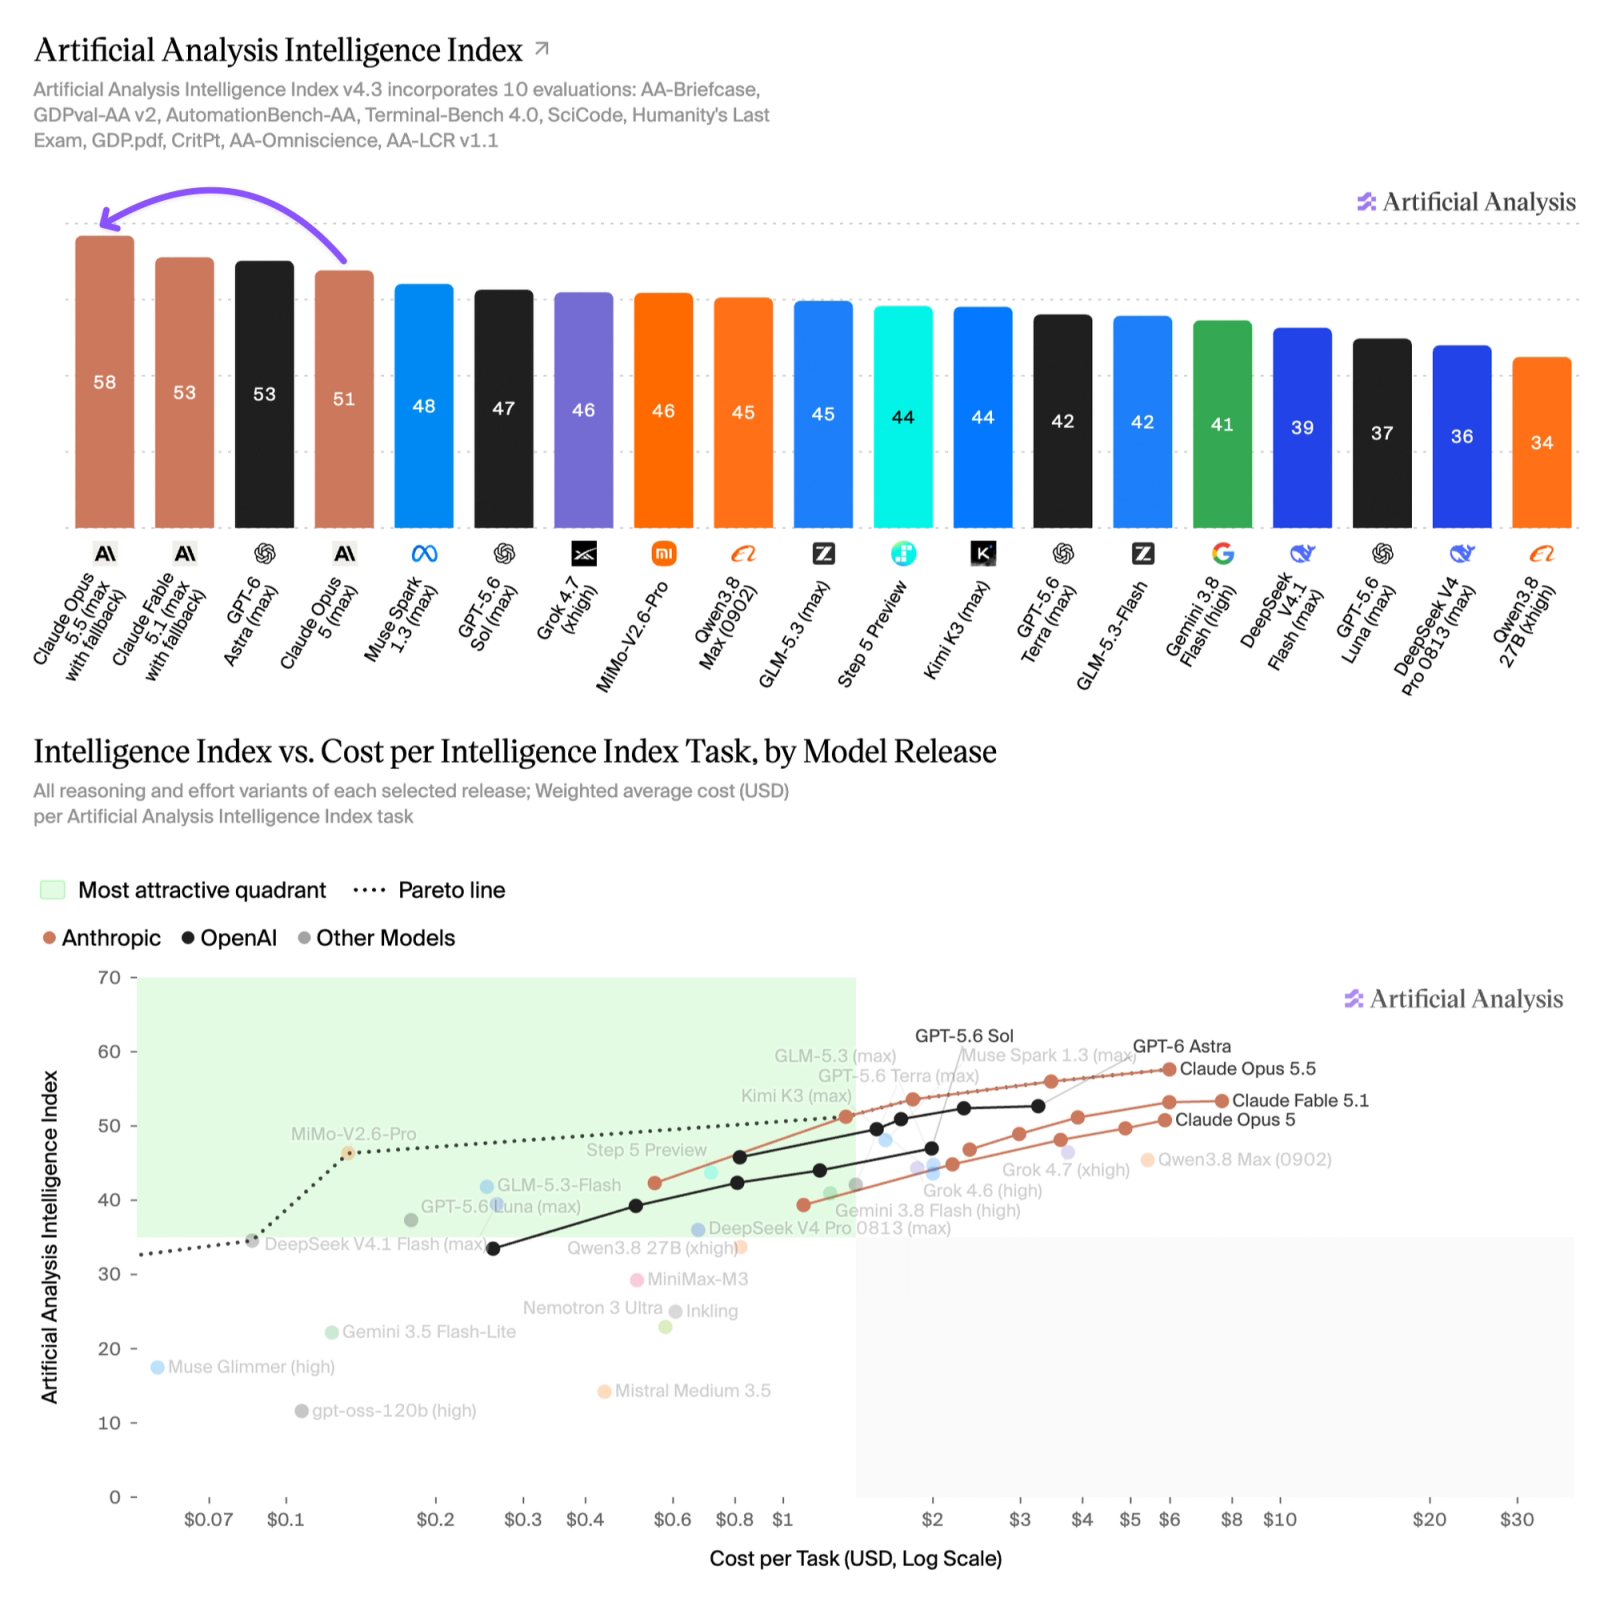
Artificial Analysis plasserte Opus 5.5 Max på 58 på sin Intelligence Index og rapporterte sterke resultater på tvers av AA-Briefcase, GDPval-AA, AutomationBench-AA, Terminal-Bench 4.0, SciCode og Humanity's Last Exam. Terminal-Bench 4.0-resultatet var 59,6 %, under Anthropics 66,4 %, noe som viser hvorfor team bør dokumentere modellversjon, innsatsnivå, harness, verktøy, antall forsøk og kostnadstak når score er uenige.
Pris og kostnad per fullført oppgave
CometAPI tilbyr token-priser lavere enn de offisielle satsene, slik at utviklere kan oppnå samme ytelse som den offisielle API-en med standard meldingsformat.
Tokenprising
| Prising | Claude Opus 5.5 | Claude Fable 5.1 |
|---|---|---|
| Input | $4 | $10 |
| Output | $20 | $50 |
| 5-min cache-skriving | $5 | $12.50 |
| 1-times cache-skriving | $8 | $20 |
| Cache-lesing | $0.20 | $0.25 |
| Batch input/output | 50 % rabatt | 50 % rabatt |
Anta at en arbeidslast bruker 10 millioner friske input-tokens og 2 millioner output-tokens. Uten cache-effekter:
10 × $4 + 2 × $20 = $80
10 × $10 + 2 × $50 = $200
Under de antagelsene koster Opus 5.5 60 % mindre. Dette tallet må imidlertid ikke forveksles med Anthropics utsagn om at Opus 5.5 koster rundt 40 % mindre å kjøre enn Opus 5.
Det er to helt forskjellige sammenligninger. 40 %-tallet inkluderer Opus 5.5s lavere Opus-tier-priser og redusert token-forbruk per oppgave relativt til Opus 5. 60 %-tallet kommer direkte fra sammenligning av standard listepriser for Opus 5.5 og Fable 5.1.
Kostnad per fullført oppgave
En modell-API selger egentlig ikke tokens. Utviklere kjøper ferdig arbeid.
Et kodeteam bryr seg ikke om at en modell brukte 6,2 millioner tokens. Det bryr seg om hvorvidt modellen fikset feilen, fullførte migreringen, bestod testsettet eller ferdigstilte research-oppgaven.
Anthropic peker på dette direkte i sin analyse What a task costs on Opus 5.5: To modeller med like priser kan ha svært ulik oppgavekostnad hvis den ene trenger flere runder, leser mer kontekst på nytt, må forsøkes på nytt oftere, eller genererer flere “thinking”-tokens.
Task Cost = Fresh Input Cost
          + Cache Read Cost
          + Cache Write Cost
          + Output / Thinking Cost
          + Retry Cost
Det siste punktet overses ofte. En billigere modell som feiler to ganger kan bli dyrere enn en dyrere modell som fullfører oppgaven i ett kjør. Tilsvarende kan et høyt innsatsnivå som unngår ti retry-runder faktisk senke totalkostnaden.
Økonomi ved prompt-caching
Cache-tunge agenter gjenbruker gjentatte ganger verktøydefinisjoner, repository-kontekst, systeminstruksjoner, samtalehistorikk og testutdata. Fordi cache-lesepriser er $0.20/M for Opus 5.5 og $0.25/M for Fable 5.1, er gapet mye mindre enn $6/M-forskjellen i frisk-input-prising. Team bør derfor spore frisk input, cache-lesinger, cache-skrivinger, output, verktøy-runder og retries separat.
Innsatsnivå-økonomi
Potensielt, ja. Artificial Analysis testet fem Opus 5.5-innsatsnivåer og fant en tydelig evne–kost-kurve.
| Opus 5.5 innsatsnivå | Artificial Analysis Intelligence Index | Kostnad per indeksoppgave |
|---|---|---|
| Low | 42 | $0.55 |
| Medium | 51 | $1.34 |
| High | 54 | $1.82 |
| Xhigh | 56 | $3.46 |
| Max | 58 | $5.98 |
Medium-innsats er et fornuftig startpunkt for rutinemessige kodeendringer, kjente refaktoreringer og overvåket feilsøking. High eller xhigh kan være berettiget for tvetydige systemfeil, nattlige migreringer, eller oppgaver der en feil plan skaper betydelig merarbeid.
Sikkerhet og pålitelighet
Ingen av modellene bør merkes tryggere utelukkende fra kapabilitets-benchmarker. En forsvarlig sammenligning krever matchede prompt, verktøy, tillatelser, innsatsnivåer, retry-begrensninger og akseptkriterier. Høyere kapabilitet kan redusere tilfeldige feil, men større autonomi og lengre kjøring øker også konsekvensen av en dårlig plan, prompt-injection, usikker verktøykall eller uoppdaget drift.
| Sikkerhetsdimensjon | Praktisk sammenligning | Produksjonskontroll |
|---|---|---|
| Resonnering og innsats | Opus 5.5 eksponerer flere innsatsnivåer, mens Fable 5.1 starter fra en høyere innsats. Mer resonnering er ikke en erstatning for policyhåndhevelse. | Fest innsats-policy per arbeidslast og retest sikkerhetsatferd hver gang den endres. |
| Langvarig autonomi | Fable 5.1 er posisjonert for vanskelig, uovervåket arbeid; Opus 5.5 støtter også agentiske arbeidsflyter. Risikoen øker med varighet, tillatelser og antall irreversible handlinger. | Bruk sjekkpunkter, godkjenningsporter, tids- og kostnadstak, og automatiske rollback- eller nedstengningsbetingelser. |
| Verktøy- og datamaskinbruk | Begge modellene kan operere verktøy, så modellvalg alene styrer ikke dataeksponering eller destruktive handlinger. | Anvend minst privilegium, allowlists, sandboxing, hemmelighetsisolasjon, og bekreftelse før eksterne eller irreversible handlinger. |
| Evaluering og reviderbarhet | Offentlige benchmark-score etablerer ikke refusjonskvalitet, motstand mot prompt-injection, eller produksjons-incidentrater. | Logg verktøykall og policybeslutninger; mål usikker-kompliansrate, falske refusjoner, injeksjonssuksess, hemmelighetslekkasje, destruktive forsøk og gjenoppretting. |
Praktisk sikkerhetsregel: Start med den minst-privilegerte Opus 5.5-konfigurasjonen som møter oppgaven, og eskaler til Fable 5.1 først etter at samme sikkerhetssuite består. For arbeidsflyter med høy påvirkning, krev menneskelig godkjenning uansett hvilken modell som scorer høyere på kapabilitetstester.
- Kjør adversarial prompt-injection- og dataeksfiltreringstester med det virkelige produksjonsverktøysettet.
- Skill lese-, skrive-, publiser-, slett- og finansielle tillatelser i stedet for å gi én bred verktøyrolle.
- Definer rollback-triggere ved policybrudd, gjentatte verktøysvikt, uventet scope-utvidelse og kostnadsoverskridelser.
- Revalider etter endringer i modell, system-prompt, innsats, verktøy, tillatelser eller ruting.
Slik velger du mellom Opus 5.5 og Fable 5.1
| Arbeidslast | Anbefalt startpunkt | Eskaleringsbetingelse |
|---|---|---|
| Daglig koding og kodegjennomgang | Opus 5.5, medium innsats | Eskaler kun for uvanlig vanskelige eller høyrisiko-saker |
| Funksjonsarbeid på flere filer | Opus 5.5, medium eller high | Bruk Fable når gjentatte planleggingsfeil dominerer kostnaden |
| Migrering i hele repository | Test Opus 5.5 high eller xhigh først | Eskaler for de vanskeligste uovervåkede prosjektene |
| Nattlige autonome kjøringer | Opus 5.5 med strenge sjekkpunkter | Foretrekk Fable når kostnaden ved feil retning er ekstrem |
| API-trafikk med høyt volum | Opus 5.5 | Eskaler kun den feilutsatte minoriteten av oppgaver |
| Eksisterende validert Fable-deploy | Behold nåværende deploy under testing | Bytt først etter at Opus møter samme akseptterskler |
En praktisk produksjonstest
Kjør de samme representative oppgavene, promptene, verktøyene, innsats-policy, akseptkriterier og retry-begrensninger gjennom begge modellene. Registrer akseptert-oppgaverate, ventetid, frisk og cachet input, output- og thinking-tokens, verktøykall, retries, menneskelige korrigeringer og total kostnad per akseptert resultat. Inkluder rutineoppgaver og vanskelige feilk cases.
Migreringsveiledning for eksisterende Claude Opus 5-brukere
Eksisterende Opus 5-brukere bør teste Opus 5.5 som en etterfølger i stedet for å anta at et model-ID-bytte er risikofritt. Sammenlign planleggingsdybde, verktøykallmønstre, svarlengde, format-etterlevelse, ventetid, prompt-cache-atferd, gjenoppretting etter mislykkede verktøykall, sikkerhetsruting og kostnad per fullført oppgave. Ha rollback-kriterier og den eksisterende modellen tilgjengelig til Opus 5.5 består aksepttester som ligner produksjon.
Eksisterende Fable 5.1-brukere trenger ikke en generell migreringsseksjon. De bør heller behandle Opus 5.5 som en kandidat for optimalisering og evaluere den etter samme produksjonsakseptkriterier før de endrer en validert deploy.
Tilgang via CometAPI
Utviklere som evaluerer begge modellene kan se de relaterte CometAPI-guidene for Claude Opus 5.5 og Claude Fable 5.1. Ved integrering gjennom en kompatibel API-leverandør, bekreft nøyaktig modell-ID, støttede innsatsparametere, cache-atferd, rate-limits, regional tilgjengelighet og gjeldende pris før produksjonsdeploy.
Bruk claude-opus-5-5 for Opus 5.5 og claude-fable-5-1 for Fable 5.1 der disse identifikatorene støttes. Unngå å rute begge arbeidslastklasser lydløst gjennom ett fast innsatsnivå; modellvalg og innsats-policy bør konfigureres uavhengig.
Python — Anthropic Messages API via CometAPI
import os
import anthropic

client = anthropic.Anthropic(
    api_key=os.environ["COMETAPI_KEY"],
    base_url="https://api.cometapi.com",)

message = client.messages.create(
    model="claude-opus-5-5",
    max_tokens=2048,
    messages=[{"role": "user","content": ("Analyser denne kodebasen og foreslå en trygg migreringsplan."),}],)print(message.content[0].text)
Konklusjon
Claude Opus 5.5 flytter den praktiske grensen mellom Anthropics daglige frontier-modell og dens premium-eskaleringstrinn. Den er vesentlig billigere til standard token-satser, leder mange publiserte koding- og agentiske benchmarker, og tilbyr nok innsatsfleksibilitet til å dekke et bredt produksjonsspekter.
Claude Fable 5.1 er fortsatt relevant når oppgaven er vanskelig, høyverdi, langvarig eller uovervåket, og kostnaden ved feil oppveier den høyere inferenskostnaden. For de fleste team er den beste policyen å starte med Opus 5.5, måle utfallet per fullført oppgave, og eskalere selektivt.
Vanlige spørsmål
Hvordan bør team designe en produksjons-A/B-test for Opus 5.5 og Fable 5.1?
Bruk de samme representative oppgavene, promptene, verktøyene, innsats-policy, akseptkriterier og retry-begrensninger for begge modellene. Registrer akseptert-oppgaverate, ventetid, frisk og cachet input, output- og thinking-tokens, verktøykall, retries, menneskelige korrigeringer og total kostnad per akseptert resultat. Kjør nok oppgaver til å fange både rutinearbeid og vanskelige feiltilfeller.
Når kan lavere token-priser mislykkes i å redusere total oppgavekostnad?
En lavere priset modell kan fortsatt koste mer hvis den krever flere runder, leser kontekst på nytt oftere, produserer flere thinking-tokens eller trenger gjentatte retries. Cache-atferd betyr også mye: input-prisgapet snevres inn i lange økter dominert av cache-lesinger. Sammenlign kostnad per fullført oppgave i stedet for listepris alene.
Hva bør dokumenteres når benchmark-resultater er uenige?
Registrer modellversjon, innsatsnivå, harness, fallback- og sikkerhetsinnstillinger, antall forsøk, oppgaveslipp, standardfeil og kostnadstak. Merk hvert resultat som offisielt eller uavhengig, og unngå å kombinere score fra umatchede konfigurasjoner i én rangering.
Hvilke migreringsrisikoer bør eksisterende Fable 5.1-brukere overvåke?
Se etter endringer i planleggingsdybde, verktøykallmønstre, svarlengde, format-etterlevelse, ventetid, prompt-cache-atferd, feilgjenoppretting og sikkerhetsruting. Behold den eksisterende deployen tilgjengelig under evaluering, etabler rollback-kriterier, og migrer først etter at Opus 5.5 møter de samme aksepttersklene på oppgaver som ligner produksjon.
SEO-metadata
Meta title: Claude Opus 5.5 vs Fable 5.1: kode, kostnad og benchmarker
Meta description: Sammenlign Claude Opus 5.5 og Claude Fable 5.1 på tvers av kode-benchmarker, API-prising, hastighet, caching, innsatsinnstillinger, kostnad per fullført oppgave og arbeidslast-tilpasning.
Keywords: Claude Opus 5.5 vs Claude Fable 5.1, Claude Opus 5.5, Claude Fable 5.1, Claude-kodebenchmarker, Claude API-prising, CometAPI, AI-kodemodeller
URL slug: claude-opus-5-5-vs-claude-fable-5-1