
TL;DR
DeepSeek V4.1 Flash erstatter den tidligere V4 Flash-generasjonen med en kausal encoder–decoder MoE-modell med 552B parametere, innebygd bildeforståelse, et kontekstvindu på 1M token og vesentlig lavere driftskostnader. I DeepSeeks offisielle sammenligning forbedrer den de fleste koding-, terminal-, sikkerhets- og agent-benchmarker sammenlignet med V4 Pro 0813, mens V4 Pro fortsatt ligger foran på GPQA Diamond og HLE uten verktøy.
DeepSeeks gjeldende API-prisside viser igjen deepseek-flash og deepseek-v4-pro som separate ruter, som betjener henholdsvis V4.1 Flash og V4-Pro-0813. De har ulike priser, samtidighetsgrenser og visjonsstøtte. Nye integrasjoner bør derfor velge modell-ID som samsvarer med den tiltenkte arbeidslasten, fremfor å stole på historisk aliasatferd.
Viktige punkter
- V4.1 Flash og V4 Pro er for øyeblikket separate offisielle API-valg: bruk deepseek-flash for V4.1 Flash og deepseek-v4-pro for V4-Pro-0813.
- De største sammenlignbare gevinstene viser seg i terminaloppgaver, kodeagenter, automasjon og sikkerhetsrettet eksekvering—ikke i alle closed-book-reasoning-benchmarker.
- V4.1 Flash er vesentlig billigere enn den nåværende V4 Pro-ruten for cache-treff-inndata, cache-miss-inndata og utdata-tokens.
- V4.1 Flash legger til innebygd visjon, øker dokumentert samtidighet fra 500 til 2 500, og reduserer global KV-cache-lagring til 890 byte per token.
- Migrering bør være eksplisitt selv om aliaser fungerer: oppdater modell-IDer, valider thinking- og non-thinking-atferd, test verktøy-kall og bildeinndata på nytt, og overvåk token-bruk og latens.
Gjeldende rutingsnotat: den offisielle prissiden identifiserer deepseek-v4-pro som V4-Pro-0813, separat fra V4.1 Flash.
Hvordan sammenlignes spesifikasjonene til DeepSeek V4.1 Flash og V4 Pro?
Arkitekturen endret seg fra et svært stort sparse MoE-design i V4 Pro til et asymmetrisk kausalt encoder–decoder-design i V4.1 Flash. Den nyere modellen aktiverer færre parametere for inndata-behandling enn for utdata-generering, noe som bidrar til å redusere prefill-kostnaden samtidig som den bevarer en sterkere genereringsevne.
| Spesifikasjon | DeepSeek V4.1 Flash | DeepSeek V4 Pro 0813 |
|---|---|---|
| Arkitektur | Kausal encoder–decoder MoE | Sparse MoE |
| Totalt antall parametere Backbone-parametere / repository-vektantall | 552B backbone-parametere; Hugging Face oppgir 763B modellstørrelse | 1.6T backbone-parametere; Hugging Face oppgir omtrent 1.7T modellstørrelse |
| Aktive parametere | 8B for inndata; 16B for utdata | 49B per token |
| Kontekstvindu | 1M tokens | 1M tokens |
| Maksimal utdata | 384K tokens | 384K tokens |
| Thinking- og non-thinking-modus | Støttet | Støttet |
| Innebygd bildeforståelse | Støttet | Ikke støttet |
| Dokumentert samtidighet | 2 500 | 500 i gjeldende konfigurasjon |
| Gjeldende offisiell API-status | Aktiv som deepseek-flash | Aktiv som deepseek-v4-pro (V4-Pro-0813) |
Presisering om parameterantall: DeepSeeks V4.1 Flash model card beskriver 552B backbone-parametere, mens Hugging Face-repositoriet rapporterer en modellstørrelse på 763B. Disse tallene beskriver ulike beregningsmåter og bør ikke presenteres som utskiftbare totaler.
Presisering om utdata-lengde: V4.1 Flash model card anbefaler max_tokens ≥ 256K for lokal inferens, mens DeepSeeks nåværende API-prisside eksplisitt angir et maksimalt utdata på 384K for begge API-modellene. En anbefalt inferensinnstilling er ikke det samme som en API-håndhevet maksimumsgrense.
Hvor forbedrer DeepSeek V4.1 Flash seg i forhold til V4 Pro?
DeepSeeks offisielle benchmark-tabell viser de tydeligste forbedringene i eksekveringstunge arbeidslaster. Prosentkolonnen nedenfor er beregnet fra publiserte score; prosentvise sammenligninger er utelatt der målet er en vurdering eller der en enkel prosent ville være misvisende.
| Benchmark | V4.1 Flash | V4 Pro 0813 | Forskjell | Tolkning |
|---|---|---|---|---|
| Terminal-Bench 2.1 | 90.6 | 87.9 | +2.7 poeng; +3.1% | Mer pålitelig terminaleksekvering |
| Terminal-Bench 3.0 | 30.0 | 11.8 | +18.2 poeng; +154.2% | Stor gevinst på vanskeligere terminaloppg. |
| Terminal-Bench 4.0 | 31.2 | 12.4 | +18.8 poeng; +151.6% | Stor gevinst på nyere terminaloppg. |
| DeepSWE v1.1 | 74.2 | 62.7 | +11.5 poeng; +18.3% | Styrket arbeid på repository-nivå |
| ProgramBench | 20.3 | 15.5 | +4.8 poeng; +31.0% | Forbedret programsyntese |
| NL2Repo-Bench | 64.0 | 61.5 | +2.5 poeng; +4.1% | Bedre NL-til-repository-arbeid |
| CyberGym | 88.1 | 83.3 | +4.8 poeng; +5.8% | Styrket cyber-oppgaveeksekvering |
| HLE med verktøy | 63.9 | 60.0 | +3.9 poeng; +6.5% | Bedre verktøystøttet resonnement |
| Automation-Bench | 54.8 | 43.2 | +11.6 poeng; +26.9% | Betydelig automasjonsgevinst |
| Agents’ Last Exam | 31.8 | 25.7 | +6.1 poeng; +23.7% | Styrket generell agentatferd |
| Codeforces rating | 3,471 | 3,348 | +123 rating-poeng | Forbedret konkurransekoding |
| GPQA Diamond | 90.9 | 92.4 | −1.5 poeng | V4 Pro beholder en fordel |
| HLE uten verktøy | 36.8; 39.1 på tekstdel | 42.7 på tekstdel | −3.6 poeng på sammenlignbar tekstdel | V4 Pro beholder en fordel |
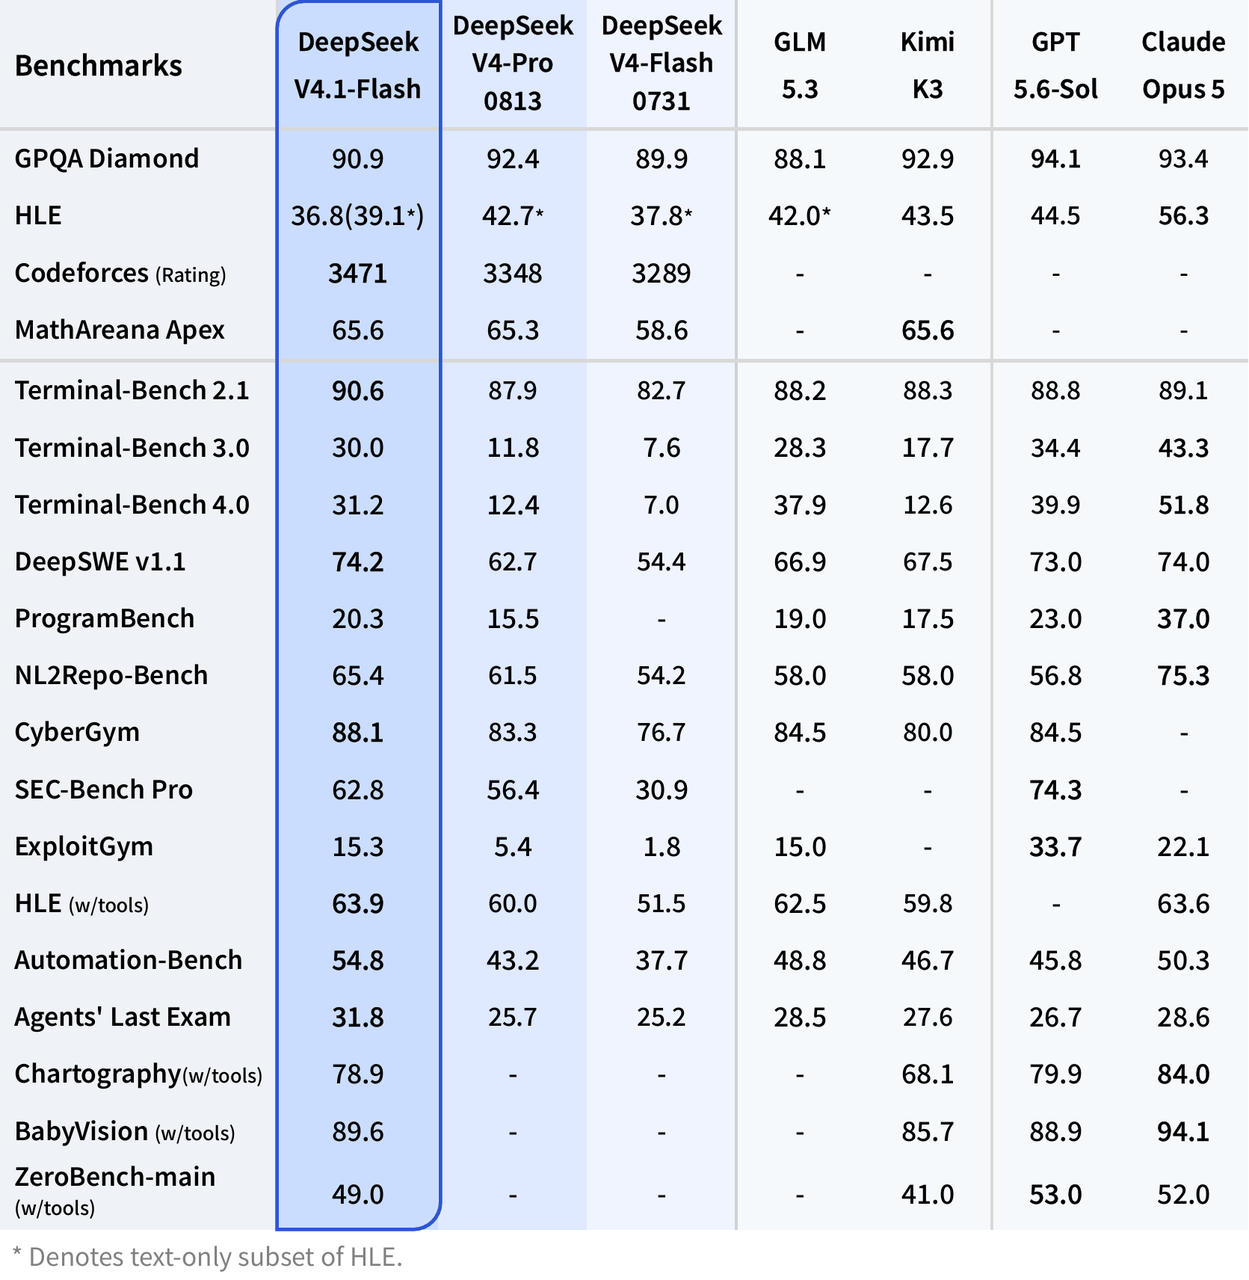
Resultatet er flerdimensjonalt: V4.1 Flash er tydelig bedre for kodeagenter, terminaldrift, automasjon, sikkerhetsoppgaver, verktøybruk, visjon, samtidighet og kostnad. V4 Pros gjenværende fordel er konsentrert i utvalgte rene resonneringstester. Arbeidslaster bør derfor vurderes etter oppgavemiks, ikke én samlet påstand.
Hvorfor er DeepSeek V4.1 Flash mer effektiv enn V4 Pro?
Asymmetrisk beregning for inn- og utdata
V4.1 Flash aktiverer 8B parametere ved prosessering av inndata og 16B ved generering av utdata. Dette asymmetriske designet retter seg mot de ulike beregningsbehovene i prefill og decoding, reduserer kostnader uten å tvinge begge stadier gjennom samme budsjett for aktive parametere.
Mindre KV-cache-fotavtrykk
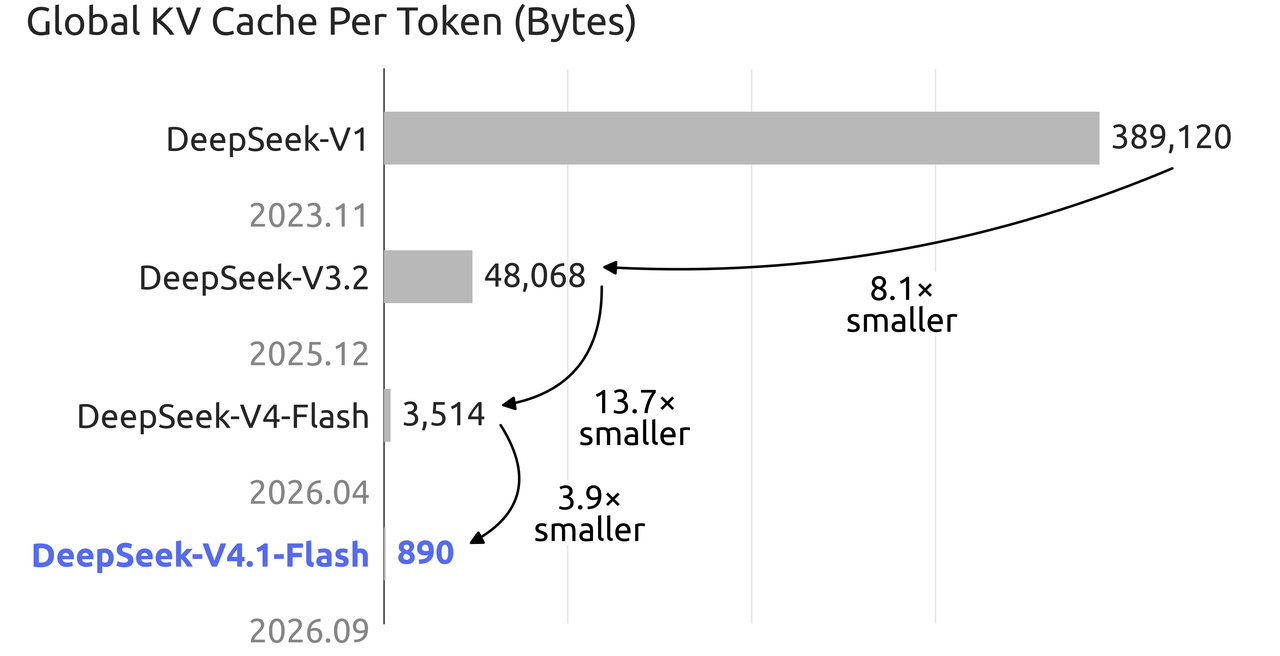
DeepSeek rapporterer at V4.1 Flash bruker en fjerdedel av HBM og en åttedel av SSD-kapasiteten som forrige generasjons KV-cache krevde. Den publiserte grafen plasserer global KV-cache på 890 byte per token, sammenlignet med 3,514 byte for V4 Flash.
Innebygd multimodal inndata og høyere samtidighet
V4.1 Flash kan tolke bilder direkte og eksponerer en dokumentert samtidighetsgrense på 2 500, fem ganger den nåværende V4 Pro-figuren på 500. Disse endringene betyr mye for skjermbildebaserte agenter, dokumentuttrekk, visuell feilsøking og produksjonskøer med høyt volum.
Hva koster DeepSeek V4.1 Flash sammenlignet med V4 Pro?
Den gjeldende offisielle API-planen priser de to rutene separat. Per 1M tokens koster V4.1 Flash $0.003/$0.006 for cache-treff-inndata, $0.15/$0.30 for cache-miss-inndata og $0.60/$1.20 for utdata (off-peak/peak). V4 Pro koster henholdsvis $0.022/$0.044, $0.66/$1.32 og $1.98/$3.96. Prisene kan endres, så produksjonsbudsjetter bør referere til den levende prissiden.
Hvordan migrere fra DeepSeek V4 Pro eller V4 Flash til V4.1 Flash?
Bruk eksplisitt modell-ID i produksjon
Bruk deepseek-flash når du ønsker V4.1 Flash. De eldre navnene deepseek-v4-flash og deepseek-v4-flash-vision-exp rutes fortsatt til V4.1 Flash, men eksplisitt navngivning gjør overvåking og fremtidige tilbakeføringer enklere å revidere. Bruk deepseek-v4-pro når du bevisst vil ha det nåværende V4-Pro-0813-backendet.
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_DEEPSEEK_API_KEY",
    base_url="https://api.deepseek.com",
)

response = client.chat.completions.create(
    model="deepseek-flash",  # or "deepseek-v4-pro"
    messages=[{"role": "user", "content": "Review this migration plan."}],
)

print(response.choices[0].message.content)
Test atferd på nytt, ikke bare endepunktkompatibilitet
- Kjør representative prompt-er i både thinking- og non-thinking-modus; sammenlign oppgavesuksess, token-antall og latens.
- Test verktøyskjemaer, JSON-utdata, Responses API-atferd, prefix completion og FIM på nytt der det brukes.
- Legg til bildeinndata-tester hvis produktet skal bruke den nye innebygde visuelle kapasiteten.
- Re-baseline budsjetter ved å bruke peak- og off-peak-satser i stedet for å videreføre antakelser fra V4 Pro.
- Spor treffraten for prompt-cache, fordi den kan dominere inndata-kostnader i stor skala.
Velg ønsket backend eksplisitt
Den nåværende deepseek-v4-pro-ruten velger V4-Pro-0813. Team bør registrere løst modellversjon, evalueringsdato, prompt-sett og prisvindu slik at sammenligninger forblir reproduserbare hvis rutingen endres igjen.
Hvilke arbeidslaster passer best for DeepSeek V4.1 Flash?
| Arbeidslast | Anbefalt valg | Begrunnelse |
|---|---|---|
| Kodeagenter og repository-vedlikehold | V4.1 Flash | Høyere DeepSWE, ProgramBench, NL2Repo og terminal-score |
| Verktøydrevet automasjon | V4.1 Flash | Høyere Automation-Bench, HLE-med-verktøy og agent-score |
| Bildebevisste assistenter | V4.1 Flash | Innebygd bildeforståelse |
| Høy gjennomstrømming eller kostnadssensitiv tjeneste | V4.1 Flash | Høyere samtidighet og betydelig lavere token-priser |
| Historisk V4 Pro-reproduksjonGjeldende V4 Pro-tilgang og evaluering | V4 Pro | Den offisielle ruten identifiserer for tiden V4-Pro-0813 |
| Ren closed-book-resonnering | Valider på domene-data | V4 Pro er høyere på GPQA Diamond og HLE uten verktøy |
DeepSeek V4.1 Flash vs V4 Pro FAQ
Er DeepSeek V4.1 Flash bedre enn V4 Pro?
For de fleste produksjonsdimensjoner—kodeagenter, terminaloppgaver, automasjon, verktøybruk, visjon, gjennomstrømming og pris—ja. V4 Pro har fortsatt sterkere publiserte score på GPQA Diamond og HLE uten verktøy, så rene resonneringsarbeidslaster bør testes med domenespesifikke prompt-er.
Kan jeg fortsatt kalle deepseek-v4-pro?
Ja. Den gjeldende offisielle API-siden viser deepseek-v4-pro som V4-Pro-0813, med egen prising og samtidighetsgrense.
Hvilken modell-ID bør en ny integrasjon bruke?
Bruk deepseek-flash for V4.1 Flash, eller deepseek-v4-pro for V4-Pro-0813. Ikke behandl de to ID-ene som aliaser.
Fungerer gamle V4 Flash-modell-IDer fortsatt?
DeepSeek opplyser at forespørsler til deepseek-v4-flash og deepseek-v4-flash-vision-exp automatisk rutes til V4.1 Flash og faktureres til den nye Flash-prisen. Det anbefales likevel å oppdatere konfigurert modell-ID for klarhetens skyld.
Støtter DeepSeek V4.1 Flash bilder?
Ja. Innebygd bildeforståelse er en del av V4.1 Flash; den historiske V4 Pro-API-en ga ikke denne muligheten.
Er DeepSeek V4.1 Flash billigere enn dagens V4 Pro?
Ja. Den gjeldende offisielle planen viser lavere cache-treff-inndata, cache-miss-inndata og utdata-priser for V4.1 Flash enn for V4 Pro.
Bør jeg forvente identiske utdata etter migrering?
Nei. Endepunktkompatibilitet garanterer ikke identiske resonneringsbaner, verktøyvalg, token-bruk eller formatering. Kjør produksjonsevalueringer på nytt før du stoler på tidligere terskler.