
TL;DR
DeepSeek-V4.1-Flash er den nåværende flermodale Flash-modellen som leveres av DeepSeek API under modell-ID-en deepseek-flash. Den støtter en kontekst på 1M tokens, opptil 384K utdata og bildeinput; under den nåværende Vision-veiledningen bruker hvert bilde maksimalt 1024 tokens etter automatisk skalering.
Dens sterkeste posisjonering forblir agentorientert visuell forståelse: inspeksjon av skjermbilder, diagrammer, grensesnitt og dokumenter basert på bilder, før videre arbeid med kode eller verktøy. Benchmark-resultatene senere i artikkelen tilhører den utgåtte Vision-Exp-lanseringen og bør leses som historiske, leverandør-rapporterte beviser—ikke som en fersk benchmark av DeepSeek-V4.1-Flash.
CometAPI beholder for tiden deepseek-v4-flash-vision-exp som sin katalogmodell-ID, mens DeepSeeks direkte API anbefaler deepseek-flash og betjener forespørselen med DeepSeek-V4.1-Flash. Start med en tekst-pluss-bilde-forespørsel, og evaluer deretter den eksakte ruten på egne skjermbilder og visuelle oppgaver.
Key Takeaways
- Nåværende rute: DeepSeek-V4.1-Flash er den aktive flermodale Flash-modellen. Det utgåtte navnet
deepseek-v4-flash-vision-expaksepteres kun som et kompatibilitetsalias på DeepSeeks API. - Stor tekstarbeidsflate: 1M-token-kontekst og opptil 384K utdata støtter lange dokumenter, kode-repositorier, verktøyhistorikk og bilder i én samtale.
- Nåværende bildeopptelling: DeepSeek skalerer hvert bilde automatisk og begrenser det til 1024 inntakstokens. Bilder under omtrent 544×544 totale piksler skaleres opp; større bilder skaleres mot omtrent 1300×1300 totale piksler.
- Agentfokusert visjon: den offisielle sammenligningen vektlegger skjermbilder, diagrammer, nettleser, koding og visuelle verktøy-arbeidsflyter fremfor bildegenerering.
- Bred grensesnittstøtte: DeepSeek dokumenterer de støttede API-grensesnittene: Chat Completions, Anthropic-kompatible Messages og Responses API. CometAPI-eksemplene nedenfor bruker Chat Completions.
- Produksjonsforbehold: rutealiaser, automatisk bildeskalering og benchmark-resultater som er følsomme for testoppsett gjør arbeidslast-spesifikk testing essensiell.
What Is DeepSeek-V4-Flash-Vision?
DeepSeeks nåværende dokumentasjon identifiserer deepseek-flash som DeepSeek-V4.1-Flash, med tekst-og-bilde-inndata og tekstutdata. Den tidligere Vision-Exp-modellen er avviklet; dens eldre navn er kompatibilitetsaliaser som rutes til den nåværende Flash-modellen.
Målbruken er flermodal agentvirksomhet. En visuell agent kan inspisere en renderet applikasjon, identifisere en knapp eller et layoutfeil, resonnere om neste handling, kalle et verktøy og deretter undersøke neste skjermbilde. Det samme mønsteret gjelder for diagramanalyse, visuell kvalitetssikring, dokumentekstraksjon, nettleserautomatisering og kodeagenter som må sammenligne en designreferanse med en renderet side.
Navnemerknad: for DeepSeeks direkte API, bruk deepseek-flash; den kartlegges for tiden til DeepSeek-V4.1-Flash. De eldre navnene deepseek-v4-flash og deepseek-v4-flash-vision-exp aksepteres fortsatt av DeepSeek, men de tilsvarende modellene er avviklet og forespørsler betjenes av DeepSeek-V4.1-Flash. CometAPI eksponerer fortsatt deepseek-v4-flash-vision-exp som sin egen katalogrute.
Technical Specifications
| Specification (official docs) | Current value |
|---|---|
| Official model ID | deepseek-flash |
| Status | Aktiv flermodal Flash API-rute; eldre Vision-Exp-modell avviklet |
| Inputs / output | Tekst + bilde-inndata; tekstutdata |
| Context window | 1,048,576 tokens (1M) |
| Maximum output | Opptil 384K tokens |
| Legacy Vision-Exp checkpoint listing | 305B parametere på det offisielle Hugging Face-repositoriet |
| Legacy Vision-Exp text backbone | 43 lag; skjult størrelse 4,096; 64 attention heads |
| Legacy Vision-Exp MoE routing | 256 ruted eksperter; 6 valgt per token; 1 delt ekspert |
| Legacy Vision-Exp vision encoder | 32 lag; bredde 1,024; 16 heads; patch-størrelse 14 |
| Image representation | Maksimum 1024 bildetokens per bilde på nåværende DeepSeek API |
| Image formats | JPEG, PNG, GIF, WebP |
| Image input methods | Base64 data URL, ekstern URL, DeepSeek Files API file_id |
| API styles | Chat Completions, Anthropic-kompatible Messages, Responses |
| Reasoning modes | Med og uten tenkning; innsatsnivåer lav, høy, maks |
| License | MIT for det offisielle modell-repositoriet |
Feltene for arkitektur over kommer fra den offisielle konfigurasjonen. Repositoriegrensesnittet lister et checkpoint på 305B parametere, men DeepSeek publiserer ikke separat et antall aktiverte parametere for den komplette visjonsmodellen. Det er tryggere å rapportere repositorieverdien enn å anta at den tekst-only V4-Flash aktive tellingen overføres uendret etter å ha lagt til den visuelle stakken.
How DeepSeek-V4-Flash-Vision-Exp's Legacy Architecture Works
V4-Flash Text Backbone
Språksiden beholder V4-designtemaene som gjør langkontekst agentarbeid praktisk. Det offisielle repositoriet dokumenterer V4-arkitekturkomponentene: sparsom Mixture-of-Experts-ruting, DFlash-attention, Hyper-Connections og DSpark. Dette gjør utgivelsen mer inspiserbar enn en ren API-modell, selv om lokal distribusjon forblir krevende i denne skalaen.
Vision Encoder and Aligner
For det utgåtte Vision-Exp-checkpointet brukte den publiserte konfigurasjonen en 32-lags visuell encoder, patch-størrelse 14, visjonsbredde 1,024, 16 visuelle attention heads og en bilderepresentasjon på 384 tokens. Disse arkitekturdetaljene beskriver det historiske checkpointet og bør ikke antas å dokumentere den nåværende DeepSeek-V4.1-Flash i produksjon.
Current 1024-Token Image Limit
DeepSeeks nåværende visjonstokeniseringsregler skalerer bilder under omtrent 544×544 totale piksler opp og større bilder ned, samtidig som sideforholdet bevares. Store inndata skaleres mot omtrent pikselarealet til et 1300×1300-bilde, noe som gir en øvre grense på 1024 tokens per bilde. Et 2000×2000 bilde og et 5000×5000 bilde bruker derfor samme antall bildetokens etter skalering.
Praktisk implikasjon: beskjær området som inneholder små etiketter, kode eller UI-kontroller før du sender bildet. Høyere kildeoppløsning alene overkommer ikke dagens 1024-token-tak.
Legacy Vision-Exp Benchmark Performance
DeepSeeks offisielle model-kort-evaluering sammenligner visjonsmodellen med DeepSeek-V4-Flash-0731 og Claude Opus 4.8 på tvers av tekst-agent- og flermodale agentoppgaver. Visjonsmodellen forbedrer generelt over den tekst-only Flash-modellen, samtidig som den forblir konkurransedyktig med, men ikke konsekvent foran, konkurrenten som prioriterer kapasitet.
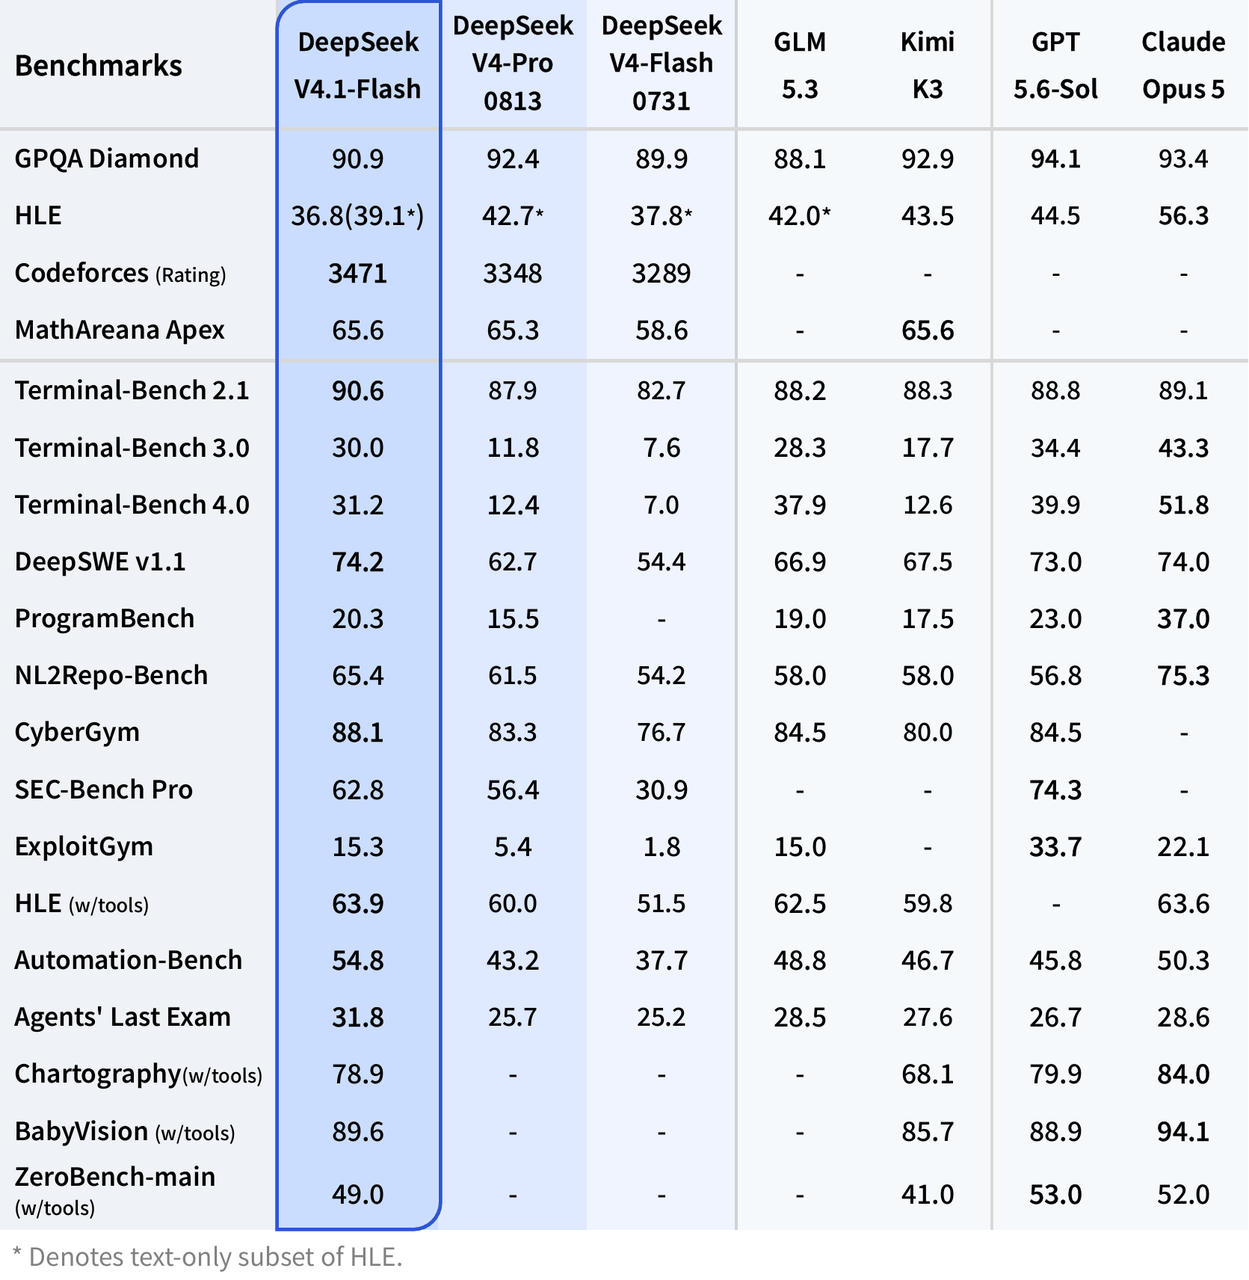
Offisiell benchmark-sammenligning for tekst- og flermodale agenvurderinger. Kilde: DeepSeeks offisielle lansering
| Offisiell benchmark | Vision-Exp | V4-Flash-0731 | Opus-4.8 |
|---|---|---|---|
| Terminal Bench 2.1 | 83.9 | 82.7 | 85.0 |
| NL2Repo | 57.7 | 54.2 | 69.7 |
| Cybergym | 75.3 | 76.7 | 78.3 |
| DeepSWE | 59.3 | 54.4 | 58.0 |
| Toolathlon-Verified | 75.9 | 70.3 | 76.2 |
| DSBench-Hard | 63.6 | 59.6 | 71.7 |
| AutomationBench (Public) | 25.7 | 25.1 | 27.2 |
| ApexBench (Pass@1) | 36.5 | 26.2* | 39.4 |
| Agents' Last Exam | 27.3 | 25.2* | 25.7 |
| Chartography | 64.3 | - | 65.0 |
| ZeroBench (Pass@5) | 35.0 | - | 34.0 |
* I ApexBench og Agents' Last Exam ignorerte den tekst-only V4-Flash modellen de flermodale elementene i inndata. DeepSeek evaluerte sine tekst-agent-oppgaver med DeepSeek Harness minimal mode, maksimal resonneringsinnsats, temperatur 1.0 og top_p 0.95.
Benchmark-merknad: dette er DeepSeek-rapporterte lanseringsresultater, ikke en uavhengig reproduksjon. Agentpoeng er spesielt følsomme for testoppsettet, verktøydefinisjoner, tokenbudsjett og retry-policy, så de bør behandles som retningsgivende bevis.
What the Benchmark Results Mean
Det tydeligste resultatet er forbedringen over tekst-only V4-Flash når visuelle bevis har betydning. ApexBench øker fra 26.2 til 36.5, og visjonsmodellen legger til konkurransedyktige Chartography- og ZeroBench-resultater som tekst-only-modellen ikke rapporterer. Modellen forbedres også på flere tekst-agent-oppgaver, inkludert Terminal Bench 2.1, NL2Repo, DeepSWE, Toolathlon-Verified og DSBench-Hard, selv om Cybergym er noe lavere.
Mot Opus 4.8 er utfallet blandet. Vision-Exp er høyere på DeepSWE, Agents' Last Exam og ZeroBench i denne tabellen, mens den konkurrerende modellen er høyere på Terminal Bench, NL2Repo, Cybergym, Toolathlon, DSBench-Hard, ApexBench og Chartography. DeepSeeks flermodale benchmark-påstand er derfor retningsgivende snarere enn bevis på generell ekvivalens på tvers av alle visuelle, resonnerings- eller pålitelighetsdimensjoner.
DeepSeek-V4.1-Flash vs DeepSeek-V4-Flash-Vision-Exp vs Claude Opus 4.8 vs Gemini 3.7 Flash
| Dimensjon | DeepSeek Vision-Exp | DeepSeek V4 Flash | Claude Opus 4.8 | Gemini 3.7 Flash |
|---|---|---|---|---|
| Status | Eksperimentell | Offentlig beta / gjeldende Flash-rute | Allment tilgjengelig | Allment tilgjengelig |
| Inndatatyper | Tekst, bilde | Tekst | Tekst, bilde, dokumenter | Tekst, bilde, video, lyd, PDF |
| Utdata | Tekst | Tekst | Tekst / strukturert data / kode | Tekst |
| Kontekst | 1M | 1M | Opptil 1M avhengig av plattform | 1,048,576 |
| Maks utdata | 384K | 384K | 128K | 65,536 |
| Hovedstyrke | Rimelige visuelle agenter | Tekstagenter med høy gjennomstrømning | Komplekse agenter med høy autonomi | Bred flermodal arbeidshest |
| Beste første test | Skjermbilder, diagrammer, UI, visuell koding | Koding og tekstautomatisering | De vanskeligste langtidsoppgavene | Rik media og Google-verktøy-arbeidsflyter |
Velg Vision-Exp når bildeoppfattelse må legges til en rimelig agentloop. Velg V4 Flash når all inndata er tekstlig og gjennomstrømning er viktigere enn visuell forståelse. Opus 4.8 forblir alternativet som prioriterer kapasitet i DeepSeeks egen sammenligning, mens Gemini 3.7 Flash er det bredere flermodale alternativet når video, lyd, PDF-er og Google-native verktøy er viktige.
What Can DeepSeek-V4-Flash-Vision Do?
- Skjermbilde-til-kode og UI-gjennomgang – sammenlign en renderet side med en design, identifiser layout- eller tilgjengelighetsproblemer, og generer implementeringsveiledning.
- Visuelle nettleseragenter – bruk skjermbilder som observasjoner når DOM eller tilgjengelighetstre-data er ufullstendig, og velg deretter neste verktøyhandling.
- Diagram- og dashbordanalyse – forklar trender, identifiser avvik, og koble synlige metrikker til en større tekst- eller verktøyarbeidsflyt.
- Dokumentforståelse basert på bilder – trekk ut informasjon fra skannede skjemaer, diagrammer, lysbilder, tabeller og skjermbilder før strukturert prosessering.
- Flermodale kodeagenter – kombiner kildekode, feilsøkningsskjermbilder, IDE-tilstander og renderte utdata i en enkelt feilsøkingssløyfe.
- Visuell kvalitetssikring – sammenlign produktskjermbilder på tvers av enheter, oppdag manglende elementer og generer strukturerte feilrapporter.
- Sammenligning av flere bilder – vurder en sekvens av skjermbilder eller alternative design i én forespørsel, underlagt forespørselstørrelse og bildeantallsgrenser.
Offisielt eksempel på visuell agent fra DeepSeeks lanseringsside (animert GIF i Word). Kilde: DeepSeeks offisielle lansering
Pricing and Availability
DeepSeek fakturerer bildetokens sammen med tekst-inntakstokens. Den offisielle prisoversikten bruker topp- og utenfor-topp-satser, mens CometAPI-modellsiden publiserer en enkelt gjeldende rutepris. Tallene bør ikke slås sammen til én generell pris fordi den billigste ruten endrer seg med DeepSeeks tidsvindu.
| Rute / kilde | Cache-treff inndata | Cache-miss inndata | Utdata | Betingelse |
|---|---|---|---|---|
| DeepSeek offisiell - utenfor topp | $0.003 | $0.15 | $0.60 | Alle timer utenfor toppvinduer, inkludert helger og kinesiske helligdager |
| DeepSeek offisiell - topp | $0.006 | $0.30 | $1.20 | 01:00-04:00 og 06:00-10:00 UTC, man–fre, ekskl. kinesiske helligdager |
| CometAPI nåværende rute | Ikke listet separat | $0.352 | $1.056 | Nåværende samlet rutepris |
Alle priser er USD per 1M tokens. DeepSeeks nåværende Flash-satser er $0.003/$0.15/$0.60 utenfor topp og $0.006/$0.30/$1.20 i topp for cache-treff-inndata, cache-miss-inndata og utdata henholdsvis. CometAPI lister for tiden $0.352 per 1M inndata-tokens og omtrent $1.06 per 1M utdata-tokens for sin kompatibilitetsrute. Bilder bruker maksimalt 1024 inntakstokens hver på DeepSeeks nåværende API; sjekk alltid gjeldende rutepriser før produksjonsbruk.
Prismerknad: modellpriser kan endre seg. Hold prisfigurer lenket til levende prissider og sjekk dem på nytt umiddelbart før publisering eller produksjonsutrulling.
How to Use DeepSeek-V4-Flash-Vision with CometAPI
CometAPI lister for tiden deepseek-v4-flash-vision-exp gjennom sitt OpenAI-kompatible /v1/chat/completions-endepunkt, så CometAPI-eksemplene beholder den katalog-ID-en. For DeepSeeks direkte API, bruk deepseek-flash.
Step 1: Create an API Key
- Opprett eller logg inn på en CometAPI-konto.
- Åpne API token-konsollen og opprett en nøkkel.
- Lagre den i miljøvariabelen COMETAPI_KEY. Aldri plasser en produksjonsnøkkel i klientsidekode eller sjekk den inn i kildekode.
export COMETAPI_KEY="your-cometapi-key"
Step 2: Send a Base64 Image with cURL
Base64 er nyttig for lokale filer og server-side jobber hvor bildet allerede er i minne. Bytt ut plassholderen med de kodede bildebatasettene, uten å legge til mellomrom eller linjeskift.
curl https://api.cometapi.com/v1/chat/completions \
  -H "Authorization: Bearer $COMETAPI_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "deepseek-v4-flash-vision-exp",
    "messages": [
      {
        "role": "user",
        "content": [
          {
            "type": "text",
            "text": "Read this dashboard and return the three most important findings."
          },
          {
            "type": "image_url",
            "image_url": {
              "url": "data:image/png;base64,<BASE64_DATA>"
            }
          }
        ]
      }
    ],
    "max_tokens": 1200
  }'
Step 3: Analyze a Local Image with Python
OpenAI Python SDK kan kalle CometAPI ved å endre base-URL. Bruk extra_body for DeepSeek-spesifikke tenkningskontroller når SDK-en din ikke eksponerer dem direkte.
import base64
import os

from openai import OpenAI

client = OpenAI(
    api_key=os.environ["COMETAPI_KEY"],
    base_url="https://api.cometapi.com/v1",
)

with open("dashboard.png", "rb") as image_file:
    encoded = base64.b64encode(image_file.read()).decode("utf-8")

response = client.chat.completions.create(
    model="deepseek-v4-flash-vision-exp",
    messages=[
        {
            "role": "user",
            "content": [
                {
                    "type": "text",
                    "text": (
                        "Analyze the chart. Return JSON with keys: trend, "
                        "anomalies, evidence, and confidence."
                    ),
                },
                {
                    "type": "image_url",
                    "image_url": {
                        "url": f"data:image/png;base64,{encoded}"
                    },
                },
            ],
        }
    ],
    max_tokens=1500,
    extra_body={
        "thinking": {"type": "enabled"},
        "reasoning_effort": "high",
    },
)

print(response.choices[0].message.content)
Step 4: Use a Public Image URL with JavaScript
En bilde-URL holder JSON-forespørselen liten, men URL-en må være offentlig tilgjengelig for upstream-modellen. Unngå midlertidige, private eller autentiseringsbeskyttede lenker med mindre applikasjonen din først konverterer bildet til Base64.
const response = await fetch(
  "https://api.cometapi.com/v1/chat/completions",
  {
    method: "POST",
    headers: {
      Authorization: `Bearer ${process.env.COMETAPI_KEY}`,
      "Content-Type": "application/json",
    },
    body: JSON.stringify({
      model: "deepseek-v4-flash-vision-exp",
      messages: [
        {
          role: "user",
          content: [
            {
              type: "text",
              text: "Identify the UI issue and propose a concrete CSS fix.",
            },
            {
              type: "image_url",
              image_url: {
                url: "https://example.com/screenshot.png",
              },
            },
          ],
        },
      ],
      max_tokens: 1200,
    }),
  }
);

if (!response.ok) {
  throw new Error(`CometAPI request failed: ${response.status}`);
}

const data = await response.json();
console.log(data.choices[0].message.content);
Step 5: Send Multiple Images
Plasser flere image_url-blokker i samme brukermelding og fortell modellen hvordan de skal merkes. Eksplisitte etiketter reduserer utilsiktede kryssreferanser mellom bilder.
{
  "model": "deepseek-v4-flash-vision-exp",
  "messages": [
    {
      "role": "user",
      "content": [
        {
          "type": "text",
          "text": "Compare Image A and Image B. List every visible regression."
        },
        {
          "type": "image_url",
          "image_url": {"url": "https://example.com/image-a.png"}
        },
        {
          "type": "image_url",
          "image_url": {"url": "https://example.com/image-b.png"}
        }
      ]
    }
  ],
  "max_tokens": 1800
}
Input Methods and Limits
| Limit | Official DeepSeek value |
|---|---|
| Supported formats | JPEG, PNG, GIF, WebP |
| External URL length | Opptil 8,192 tegn |
| Request body | 48 MiB |
| Single image via Base64 / URL | 32 MiB |
| Single image via DeepSeek Files API | 64 MiB |
| Maximum images per request | 600 |
| Total image size | 64 MiB uten file_id; opptil 200 MiB inkludert file_id |
| Maximum dimension | 8,192 px per side; 4,096 px når forespørselen har 15+ bilder |
| Image message role | Kun brukermeldinger |
Det offisielle DeepSeek API støtter også gjenbrukbare file_id-bildereferanser via Files API. CometAPI-lynveien som dokumenteres her bruker image_url-blokker med enten en offentlig URL eller en Base64 data-URL. Verifiser leverandørspesifikk filopplasting og file_id-passthrough før du stoler på den arbeidsflyten gjennom en aggregasjonsrute.
How to Prompt the Model Effectively
En pålitelig visuell-agent-prompt bør angi hva bildet er, hvilket bevis som skal inspiseres, hvilken handling som skal utføres, og hvilken outputkontrakt som skal følges. Vage prompt som describe this image gir for mye frihet og gjør resultater vanskeligere å validere.
- Kontekst – identifiser skjermbildet, diagrammet, dokumentet eller grensesnittet og dets rolle i arbeidsflyten.
- Oppgave – spesifiser beslutningen, diagnosen, sammenligningen eller ekstraksjonen som er viktig.
- Bevis – krev synlige bevis, etiketter, koordinater, verdier eller sitert UI-tekst.
- Begrensninger – forby uunderstøttede antagelser og fortell modellen hvordan den skal håndtere uleselige detaljer.
- Utdata – definer JSON-nøkler, en sjekkliste, alvorlighetsgrader eller en annen maskin-kontrollerbar struktur.
You are reviewing a web application screenshot.

Task: identify layout, accessibility, and state-consistency defects.
Evidence: cite the visible element, label, position, or color that supports each finding.
Constraints: do not infer hidden DOM state; mark unreadable text as uncertain.
Output: return JSON with arrays named critical, major, minor, and follow_up_checks.
Production Best Practices
- Beskjær før opplasting når liten tekst eller kontroller er viktige; bildetoken-taket betyr at irrelevant bakgrunn bruker opp knapp visuell oppløsning.
- Test resonneringsinnsats i stedet for å aktivere maks for hver forespørsel. Enkel OCR eller klassifisering trenger vanligvis mindre resonnering enn flerstegs UI-diagnose.
- Krav bevis i hvert strukturert funn. Dette gjør hallusinerte visuelle påstander enklere å avvise automatisk.
- Skill persepsjon fra handling i høy-risik automasjon. La modellen beskrive tilstanden, valider den, og la deretter et kontrollert verktøylag handle.
- Beskytt bilde-URL-er fordi en offentlig URL kan eksponere sensitive skjermbilder. Foretrekk server-side Base64 for private data og bruk din egen retensjonspolicy.
- Benchmark ende-til-ende med samme skjermbildeopptak, prompt, verktøy, retrier og suksesskriterier som brukes i produksjon.
- Spor eksperimentelle endringer ved å feste prompt og evalueringsdata. En -exp-endpoint kan endre oppførsel raskere enn en moden GA-modell.
- Logg forespørsels-ID-er og feil slik at leverandørfeil, modellfeil og applikasjonsparsingfeil kan skilles.
Limitations
Den viktigste begrensningen er rutetransparens: det eldre Vision-Exp-navnet kan fortsatt aksepteres selv om forespørselen betjenes av DeepSeek-V4.1-Flash. Logg leverandør, forespurt modell-ID, returnert modellmetadata og forespørsels-ID; bruk eksplisitte evalueringsporter før du tilordner autonome handlinger. Historiske lanseringspoeng er ikke en erstatning for reproduserbar testing på den tiltenkte ruten.
Den andre begrensningen er visuell detaljrikdom. Automatisk skalering og dagens 1024-token-bildetak gjør kostnadene forutsigbare, men kan fortsatt undertrykke bitteliten tekst, fine diagrammarkører eller tette grensesnitselementer. Beskjær, flislegg eller zoom det relevante området og bevar originalbildet for menneskelig gjennomgang.
Modellen returnerer kun tekst. Den kan analysere et bilde og foreslå kode eller strukturerte handlinger, men genererer eller redigerer ikke bilder. Den aksepterer også bilder kun i brukermeldinger, og den offisielle dokumentasjonen sier at bildeinnhold i system- eller assistentmeldinger returnerer en 400-feil.
Til slutt er lokal distribusjon infrastruktur-tung. Det offisielle repositoriet lister en modell på 305B parametere og gir referanseinferenzkode snarere enn en ferdig lettvekts-runtime. For de fleste team er administrert API-evaluering det praktiske utgangspunktet.
Common Errors and Fixes
| Symptom | Likely cause | Recommended fix |
|---|---|---|
| 400: modellen støtter ikke bilder | Feil modell-ID | Bruk deepseek-v4-flash-vision-exp |
| 400 for meldingsinnhold | Bilde plassert i system- eller assistentmelding | Flytt bildeblokker til en brukermelding |
| Feil ved nedlasting av bilde | Privat, utløpt eller treg URL | Bruk Base64 eller en stabil offentlig URL |
| Fine detaljer mangler | Automatisk nedskalering / 384-token-tak | Beskjær eller flislegg det relevante området |
| Uventet høy kostnad | Lange utdata, retrier eller gjentatte turer | Begrens max_tokens og logg per-tur-bruk |
| Inkonsistent agentresultat | Variasjon i testoppsett eller verktøytilstand | Fiks prompt, verktøy, retrier og evalueringsrubrikk |
FAQ
Is DeepSeek-V4-Flash-Vision the same as DeepSeek-V4-Flash?
Nei. Vision-Exp legger til native bildeinndata og flermodal trening. Den tekst-only Flash-ruten gir ikke samme visuelle persepsjonsevne.
What model ID should I use?
Bruk deepseek-flash på DeepSeeks direkte API. På CometAPI, bruk katalog-ID-en deepseek-v4-flash-vision-exp så lenge den ruten er tilgjengelig.
Can it analyze multiple images?
Ja. DeepSeek dokumenterer opptil 600 bilder per forespørsel, underlagt grenser for forespørselstørrelse og dimensjoner. Praktiske grenser kan være lavere i en applikasjon fordi latens og prompt-tydelighet forverres når bildesettet blir større.
How many tokens does an image use?
På DeepSeeks nåværende API skaleres bilder og konverteres til tokens med et maksimum på 1024 tokens per bilde. Flere bilder telles uavhengig.
Does it support image generation?
Nei. Den aksepterer tekst og bilder og returnerer tekst.
Is it ready for production?
Ja, men kun etter rutespesifikk evaluering. Bruk overvåkning, fallbacks, oppgave-spesifikke akseptansetester og modellrute-logging fordi eldre aliaser kan løses til DeepSeek-V4.1-Flash.
Should I use CometAPI or DeepSeek's direct API?
CometAPI er nyttig når én nøkkel, ett fakturalag og enkel modellbytting er viktig. DeepSeek direkte tilgang kan være å foretrekke når du trenger leverandørspesifikke funksjoner som offisiell Files API-semantikk eller utenfor-topp-priser. Test begge rutene mot samme arbeidslast.
Conclusion
DeepSeek-V4.1-Flash er nå den aktive flermodale Flash-ruten på DeepSeeks API. Dens 1M-kontekst, 384K utdatatak, multi-grensesnittstøtte og 1024 tokens per bilde gjør den attraktiv for forståelse av skjermbilder, diagramanalyse, visuell koding og nettleser- eller GUI-automatisering. Vision-Exp-arkitekturen og lanserings-benchmarks i denne artikkelen beholdes som historisk kontekst.
Beslutningen bør forbli arbeidslast-drevet. Offentlig benchmark-evidens for den utgåtte Vision-Exp-modellen er primært leverandør-rapportert, nåværende rutealiaser kan skjule hvilken modell som betjener forespørselen, og bildeskalering kan fortsatt begrense oppgaver med fin detalj. Test den eksakte leverandørruten på representative bilder, mål kostnad per vellykket oppgave i stedet for kun tokenpris, og behold en fallback til ruten viser seg pålitelig i ditt produksjonsoppsett.