
Kort oppsummert
Start med GPT-6.1 Sol når du allerede bruker OpenAI Responses-verktøy eller trenger dens eksplisitte stige av resonnerings-innsats; test Claude Sonnet 5.5 for velavgrenset kodeiterasjon og malstyrte profesjonelle leveranser. Dette er evalueringsprioriteter, ikke en dokumentert kvalitetsrangering. Begge starter på $2/M input og $10/M output og tar $0.10/M for grunnleggende cache-lesinger. Med omtrent 1M kontekst og 128K standard maksimal output er de praktiske forskjellene integrasjon, oppførsel i oppgaver, cache-retensjon og fakturering for lang kontekst snarere enn rabatt på base cache-lesing.
Den viktigste avveiningen er oppgaveatferd og faktureringsvilkår. GPT-6.1 Sol bruker fem innsatsnivåer og krever Responses for verktøykall; Sonnet 5.5 bruker adaptiv tenkning. Over 272K input-tokens anvender GPT-6.1 Sol høyere satser på hele forespørselen. Kildene som er gjennomgått her etablerer ikke en matchet, eksakt-versjon benchmark-vinner, så velg modellen som møter akseptkriteriene dine med lavest total arbeidsflytkostnad.
Viktige punkter
- Like basispriser: begge modeller tar $2/M input, $10/M output og $0.10/M cache-lesinger. Sammenlign cache-skrivinger, retensjon, langkontekst-nivåer og faktisk fakturert bruk.
- Kontekst er nær: 1,05M versus 1M tokens; begge støtter 128K standard maksimal output.
- Integrasjon skiller: GPT-6.1 Sol krever Responses for verktøykall og aksepterer ikke none eller minimal innsats; Sonnet 5.5 bruker adaptiv tenkning og modellspesifikke verktøybegrensninger.
- Hold evidens versjonsspesifikk: GPT-6 Sol-poeng kan ikke merkes om som GPT-6.1 Sol-resultater.
- Velg etter fullført arbeid: mål kvalitet, latens, retries, cache-skrivinger og -lesinger, verktøykostnader og menneskelig korreksjon.
GPT-6.1 Sol vs Claude Sonnet 5.5 i et øyeblikksbilde
| Beslutningsfaktor / spesifikasjon | GPT-6.1 Sol | Claude Sonnet 5.5 |
|---|---|---|
| Leverandør | OpenAI | Anthropic |
| Lanseringsdato | 29. september 2026 | 28. september 2026 |
| Modell-ID | gpt-6.1-sol | claude-sonnet-5-5 |
| Kontekst / standard maksimal output | 1 050 000 / 128 000 tokens | 1 000 000 / 128 000 tokens |
| Input → output | Tekst og bilder → tekst | Tekst og bilder → tekst |
| Kontroller for resonnering | low, medium, high, xhigh, max; medium som standard | Adaptiv tenkning; high som standard på Claude Platform |
| Standard innsats | medium | high på Claude Platform |
| Kunnskapsavgrensning | 30. april 2026 | Juni 2026 |
| Offisiell basis input / output per 1M tokens | $2 / $10; Standard-forespørsler med opptil 272K input tokens | $2 / $10 |
| Offisiell basis cache-lesing per 1M tokens | $0.10 | $0.10 |
| Offisiell basis cache-skriving per 1M tokens | $2.50 | $2.50 for 5 minutter; $4.00 for 1 time |
| Fakturering for lang kontekst | Over 272K input: $4 input, $0.20 cache-lesing, $5 cache-skriving, $15 output per 1M; gjelder for hele Standard-forespørselen | Ingen tilsvarende tillegg oppgitt i den siterte modelloversikten |
| Primær posisjonering | Kompleks koding, databruk og profesjonelt arbeid | Rask kodeiterasjon og profesjonelle arbeidsflyter |
| Test først når | Du allerede bruker Responses-verktøy eller trenger eksplisitte innsatskontroller | Arbeidet ditt er sentrert rundt koding, dokumenter, lysbilder eller regneark |
| Dokumentasjon og beslutningsbegrensning | Dokumenterte kapabiliteter; ingen matchet eksakt-versjon numerisk vinner etablert her | Publiserte resultater for koding og kunnskapsarbeid; ikke en kontrollert seier over GPT-6.1 Sol |
GPT-6.1 Sol-oversikt
GPT-6.1 Sol er OpenAIs Sol-utgivelse 29. september 2026 for kompleks koding, databruk og profesjonelt arbeid. OpenAI beskriver den som nær-Astra-ytelse til lavere kostnad (https://developers.openai.com/api/docs/models/gpt-6.1-sol); den posisjoneringen bør valideres på dine oppgaver. Den store konteksten og justerbar resonnering gjør den til en kandidat for repository-agenter og flertrinns profesjonelle arbeidsflyter.
Driftsbegrensningene betyr like mye som posisjoneringen: medium er standard innsats, low er laveste støttede innstilling, og verktøykall krever Responses. En arbeidsflyt bygget rundt en sti uten resonnering eller Chat Completions-verktøy trenger migrasjonsarbeid før den kan bruke denne modellen pålitelig.
Claude Sonnet 5.5-oversikt
Claude Sonnet 5.5 er Anthropics utgivelse 28. september 2026 for velavgrenset hverdagskoding, agenter og profesjonelt arbeid. Dens modelloversikt (https://platform.claude.com/docs/en/models/sonnet-5-5/overview) dokumenterer adaptiv tenkning, høy standard innsats på Claude Platform, tekst- og bildeinput, og 128K standard maksimal output. Anthropic vektlegger feilretting, tydelige dokumenter, polerte lysbilder og effektiv iterasjon.
For et utviklingsteam gjør det Sonnet til en nyttig kandidat for gjentatte implementerings- og gjennomgangssykluser. For kontorarbeidsflyt, evaluer førstegenerasjonskvalitet og etterlevelse av maler. Leverandørens hastighetspåstand sammenligner Sonnet 5.5 med Sonnet 5; den etablerer ikke en hastighetsfordel over GPT-6.1 Sol.
GPT-6.1 Sol vs Claude Sonnet 5.5: Ytelse
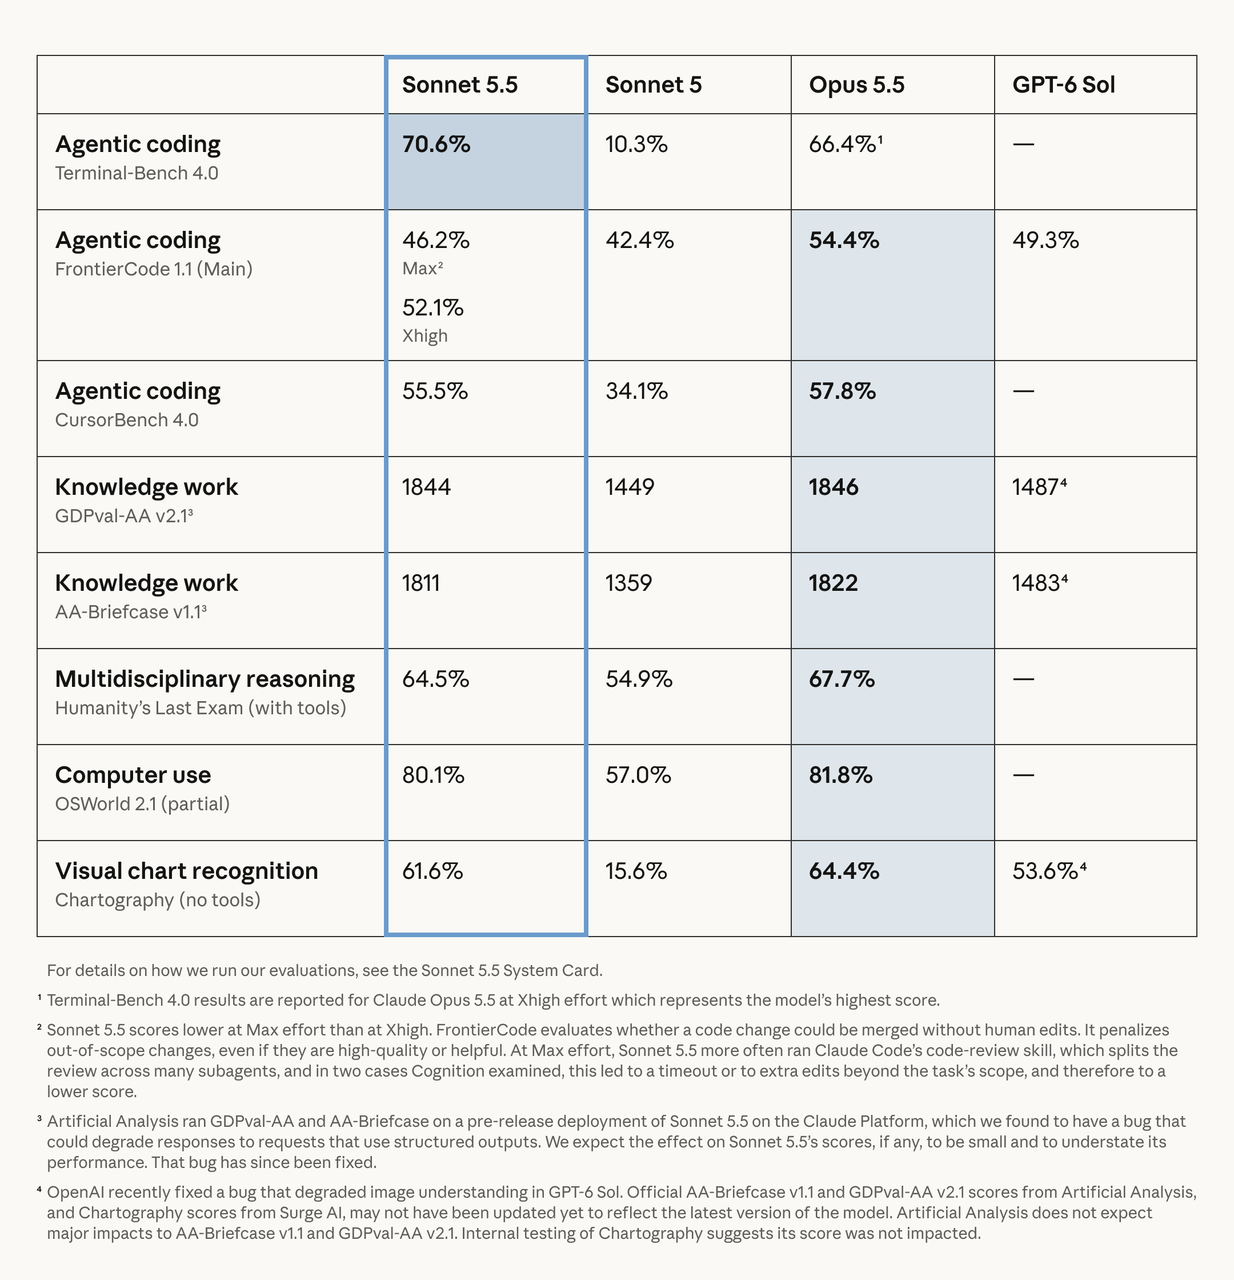
Anthropics lanseringsresultater for Sonnet 5.5 (https://www.anthropic.com/claude-sonnet-5-5) gir et nyttig sett med signaler om arbeidsbelastning. Sammenligningen inkluderer den eldre GPT-6 Sol, så de OpenAI-kolonneverdiene er utelatt fra den nåværende modelltabellen nedenfor. «Ikke fastslått her» betyr at de siterte kildene ikke støtter en eksakt-versjon-score for denne sammenligningen; det betyr ikke null ytelse.
| Benchmark / betingelser | GPT-6.1 Sol | Claude Sonnet 5.5 | Hva det måler |
|---|---|---|---|
| Terminal-Bench 4.0 | Ikke fastslått her | 70,6% | Terminal-kodingsoppgaver |
| FrontierCode 1.1 Main | Ikke fastslått her | 52,1% Xhigh; 46,2% Max | Sammenslåbare endringer i repository |
| CursorBench 4.0 | Ikke fastslått her | 55,5% | Agentisk utvikling i Cursor-oppgaver |
| GDPval-AA v2.1 | Ikke fastslått her | 1844 | Profesjonelt kunnskapsarbeid |
| AA-Briefcase v1.1 | Ikke fastslått her | 1811 | Kunnskapsarbeid med lang horisont |
| Humanity’s Last Exam, verktøy | Ikke fastslått her | 64,5% | Tverrfaglig resonnering |
| OSWorld 2.1, delvis | Ikke fastslått her | 80,1% | Delvis belønning for databruk |
| Chartography, uten verktøy | Ikke fastslått her | 61,6% | Visuell diagramgjenkjenning |
Testbetingelser: innsats og agentrammeverk påvirker koderesultatene. GDPval-AA og AA-Briefcase er Artificial Analysis-evalueringer, mens Chartography-resultater kommer fra Surge AI. Anthropic påpeker en senere rettet feil i strukturert output i Sonnet-forhåndslanseringen som kan ha undervurdert profesjonell-arbeid-resultatene noe. Bruk kunngjøringens System Card-lenke for testmiljøer og full metodikk; ikke kombiner ulike metrikker til én samlet rangering.
Det opprinnelige Anthropic-bildet nedenfor inkluderer evalueringsfotnoter. Kolonnen for GPT-6 Sol er kun historisk kontekst og rapporterer ikke GPT-6.1 Sol-ytelse.
Agentisk koding og programvareutvikling
Sonnet 5.5 har rapportert evidens på terminalkoding, sammenslåbare kodeendringer og IDE-stil agentoppgaver. GPT-6.1 Sol er dokumentert for kompleks koding og integreres med OpenAIs verktøyøkosystem. Verken produktposisjonering eller en forgjengers score etablerer en nåværende vinner i koding. For en nyttig evaluering, velg reelle endringer med regresjonstester og be anmeldere vurdere omfang, vedlikeholdbarhet og merge-klarhet.
Kunnskapsarbeid, resonnering, matematikk og vitenskap
Sonnets resultater i GDPval-AA og AA-Briefcase gjør rapporter, analyser og kontorleveranser til fornuftige evalueringsmål. GPT-6.1 Sol retter seg også mot profesjonelt arbeid, men kildene brukt her gir ikke en matchet sammenligning på tvers av disse modellene. Bruk dine egne dokument-, regneark- og presentasjonsmaler. Avanserte matematikk- og vitenskapspåstander krever oppgavespesifikk evidens heller enn ekstrapolering fra generelle resonneringskontroller.
Databruk, nettleserautomatisering og multimodale arbeidsflyter
Begge modellene aksepterer bilder, noe som støtter feilsøking via skjermbilder og visuell analyse. Sonnets OSWorld- og Chartography-resultater er evidens for disse spesifikke evalueringene. GPT-6.1 Sol dokumenterer databruk gjennom Responses-verktøy. Test hele arbeidsflyten: navigasjonsnøyaktighet, gjenoppretting etter et mislykket verktøykall, output-korrekthet og tid til fullføring. Tekst- og bildeinput garanterer i seg selv ikke identisk integrasjon for databruk.
Uavhengig evaluering og beviskvalitet
En leverandørpublisert tabell kan inneholde tredjepartsresultater uten å være ett enkelt kontrollert eksperiment. For enhver uavhengig sammenligning, registrer eksakte modell-ID-er, distribusjonsdatoer, innsats, verktøy, sikringer, timeout, retry-policy og stoppregler. En aggregert intelligensindeks, en kodingsuksessrate og en delvis belønning for databruk besvarer ulike spørsmål. De gjennomgåtte kildene etablerer ikke et komplett, matchet uavhengig resultatssett for akkurat dette paret.
GPT-6.1 Sol vs Claude Sonnet 5.5: Kostnad
Offisiell API-prising
| Priseringsmetrikk | GPT-6.1 Sol offisielle satser | Claude Sonnet 5.5 offisielle satser |
|---|---|---|
| Input / 1M tokens, basis Standard | $2.00 | $2.00 |
| Output / 1M tokens, basis Standard | $10.00 | $10.00 |
| Cache-lesing / 1M tokens, basis | $0.10 | $0.10 |
| Cache-skriving / 1M tokens, basis | $2.50 | $2.50 for 5m; $4.00 for 1t |
| Batch-behandling | 50% under Standard | 50% input/output-rabatt |
| Input over 272K, Standard full forespørsel | $4 input / $0.20 cache-lesing / $5 cache-skriving / $15 output | Ingen tilsvarende tillegg oppgitt i siterte oversikt |
Alle satser er USD per million tokens. GPT-6.1 Sols base cache-lesinger koster $0.10/M (https://developers.openai.com/api/docs/models/gpt-6.1-sol) og Sonnet 5.5 cache-lesinger koster også $0.10/M (https://platform.claude.com/docs/en/models/sonnet-5-5/overview). Sols vilkår over 272K input hever satsene for hele Standard-forespørselen, ikke bare overskytende tokens. Sammenlign cache-skrivinger, retensjon, langkontekst-nivåer, regional behandling og tjenestenivåer; basisleseprisen alene gir ingen fordel til noen av modellene.
Kostnad per fullført oppgave
Kostnad per akseptert resultat = totalkostnad på tvers av alle forsøk / antall aksepterte resultater. Totalkostnad inkluderer fakturert fersk input, cache-lesinger og -skrivinger, output (inkludert fakturerte resonneringstokens der det er relevant), betalte verktøykall og menneskelig gjennomgang eller korreksjon. Retry-kostnader regnes etter faktisk bruk, ikke lagt til igjen som et duplikat.
For én million cache-lesetokens fakturert helt til basispris koster begge modeller $0.10; differansen i basis lesepris er $0.00. Dette er en satsillustrasjon, ikke en én-million-input-tokens Sol-forespørsel priset på basistier. Faktisk øktkostnad omfatter også fersk input, cache-skrivinger, output, verktøy og retries. Sammenlign kalde og varme økter under gjeldende kontekstnivå og rapporter andelen aksepterte resultater sammen med fakturert bruk.
CometAPI-priser
| Publisert CometAPI-nivå | GPT-6.1 Sol API i CometAPI | Claude Sonnet 5.5 API i CometAPI |
|---|---|---|
| Basis input / output per 1M | $1.60 / $8.00 | $1.60 / $8.00 |
| Basisrabatt vs leverandør | 20% | 20% |
| GPT langkontekst input / output | $3.20 / $12.00 | Sjekk gjeldende rutespesifikke vilkår |
| GPT cache-lesing, basis / lang | $0.08 / $0.16 | Ikke spesifisert i den siterte basispristabellen |
Dette er publiserte modellrute-priser kontrollert for denne revisjonen, separat fra leverandørsatser. GPT-6.1 Sols CometAPI-priser skiller mellom kort og lang kontekst. Den siterte grunnleggende tabellen for Sonnet lister input og output, så den rettferdiggjør ikke å anta en identisk gateway cache-policy. Sjekk den valgte rutens gjeldende faktureringsvilkår før du estimerer en produksjonsøkt.
Hvordan sammenlignes kontekstvinduer, hastighet og tekniske spesifikasjoner?
GPT-6.1 Sol støtter 1,05M tokens, mens Claude Sonnet 5.5 støtter 1M tokens. Den nominelle forskjellen er bare rundt 5%, så kontekstkapasitet alene vil neppe avgjøre de fleste utrullinger.
GPT-6.1 Sols innsatsstige er low, medium, high, xhigh og max; medium er standard. Sonnet 5.5 bruker adaptiv tenkning med high som standard på Claude Platform. Disse navnene tilsier ikke like resonneringsbudsjetter. Ved like kvalitetskrav, mål tid til første token, utdata-gjennomstrømning, latens i verktøysløyfer og ende-til-ende fullføring separat.
Anthropic rapporterer mer enn 30% raskere utgenerering for Sonnet 5.5 enn Sonnet 5. Behandle det som en forgjengersammenligning. Evidensen her etablerer ikke ett universelt latens-tall for GPT-6.1 Sol eller en direkte hastighetsvinner mellom de nåværende modellene. For interaktive arbeidsbelastninger, test lavere innsatsinnstillinger mot samme akseptkriterium i stedet for å anta at max er beste distribusjonsinnstilling.
Hva betyr mest for sikkerhet, tilpasning og utrulling?
Utrullingsbeslutninger bør skille dokumentert modellatferd fra applikasjonskontroller. En modellsammenligning alene kan ikke fastslå hvilken utrulling som møter organisasjonens krav til datahåndtering eller tilgang. Evaluer leverandøren eller gatewayen du faktisk bruker, inkludert forespørselslogging, dataresidens, verktøytillatelser og feilhåndtering.
- Migrering av resonnering: GPT-6.1 Sol støtter ikke none eller minimal. OpenAIs migreringsveiledning (https://developers.openai.com/api/docs/guides/latest-model) leder verktøykall-arbeidsflyter til Responses.
- Claude-verktøyatferd: Sonnet 5.5s dokumenterte kompatibilitetsendringer (https://platform.claude.com/docs/en/models/sonnet-5-5/whats-new-sonnet-5-5) inkluderer ikke-støttede påtvungne verktøymoduser og samtalebundne tenkningsblokker. Test disse banene før utrulling.
- Operasjonelle kontroller: gi agenter kun verktøyene som trengs for oppgaven, registrer mislykkede kall, og behold menneskelig gjennomgang for konsekvensielle eksterne handlinger. Dette er applikasjonsdesignvalg, ikke målte fordeler for noen av modellene.
GPT-6.1 Sol vs Claude Sonnet 5.5: Hvilken bør du velge?
Test GPT-6.1 Sol først når du allerede bruker Responses-verktøy eller trenger en forutsigbar innsatsstige. Test Sonnet 5.5 for velavgrenset kodeiterasjon, lysbilder, regneark og dokumentarbeidsflyter der dens rapporterte evidens matcher dine oppgaver. For økter med cachet prefiks, test begge: deres basis cache-lesepriser er like, mens skrivekostnader, retensjon, langkontekst-nivåer og oppgavesuksess kan endre totalregningen. Ruter arbeid først etter at representative evalueringer etablerer en nyttig forskjell i kvalitet, kostnad eller latens.
Arbeidslastbasert valg
| Arbeidslast | Startpunkt | Hva som må verifiseres |
|---|---|---|
| Eksisterende OpenAI Responses-agent | GPT-6.1 Sol | Verktøykompatibilitet og endringer i innsats |
| Kodeiterasjon / feilretting | Sonnet 5.5, sammenlign deretter Sol | Merge-klarhet, latens og retries |
| Lysbilder / regneark / rapporter | Sonnet 5.5, sammenlign deretter Sol | Etterlevelse av maler og menneskelig redigeringstid |
| Stabilt cachet-prefiks | Begge; like basis cache-leserater | Treffrate, skrivinger, kontekstnivå og akseptert kvalitet |
| Forespørsler over 272K input | Begge | Faktisk langkontekst-regning og gjenfinningens kvalitet |
| Datamaskin- / nettleserautomatisering | Begge | Gjenoppretting, oppgavefullføring og tillatelser |
| Matematikk / vitenskapelig analyse | Begge på oppgavespesifikke tester | Korrekthet med verifiserbare svar |
| Kostnadsfølsom produksjon | Begge | Total kostnad per akseptert resultat |
En produksjonssammenligning bør holde det omkringliggende systemet konstant. Bruk samme prompt, repositories eller dokumenter, verktøytillatelser, timeout, retry-policy og output-akseptrubrik.
Registrer fersk input, cache-skrivinger og -lesinger, output-bruk, betalte verktøykall, retries, tid til menneskelig gjennomgang, oppgavesuksess og ende-til-ende-latens. Et billigere første svar kan likevel gi et dyrere akseptert resultat.
Hvordan får du tilgang til GPT-6.1 Sol og Claude Sonnet 5.5?
Utviklere kan få tilgang til GPT-6.1 Sol API i CometAPI (https://www.cometapi.com/models/openai/gpt-6-1-sol/) og Claude Sonnet 5.5 API i CometAPI (https://www.cometapi.com/models/anthropic/claude-sonnet-5-5/) via de dokumenterte modellrutene. Opprett en API-nøkkel, lagre den sikkert, og verifiser modelltilgang og rutespesifikk fakturering før produksjon.
GPT-6.1 Sol-tilgang
For Sol, bruk den dokumenterte Responses-ruten når verktøykall er nødvendig. Velg gpt-6.1-sol og et støttet innsatsnivå, med medium som standard. Send oppgavens input, konfigurer kun nødvendige verktøy, og valider returnert tekst, verktøykall, feil og bruk. Bekreft gateway-støtte for leverandørspesifikke funksjoner i stedet for å anta at alle OpenAI-alternativer er tilgjengelige.
Claude Sonnet 5.5-tilgang
For Sonnet, velg claude-sonnet-5-5 på et dokumentert kompatibelt grensesnitt og send oppgaven som samtalemeldinger med et passende output-budsjett. Bekreft hvordan den ruten håndterer native tenkning og verktøyparametre; OpenAI-resonneringsfelt er ikke automatisk utskiftbare med Claude-alternativer. Valider samtalefortsettelse og feilhåndtering før agentutrulling.
Et endepunktsjekk verifiserer tilkobling, ikke komparativ ytelse. For evaluering, juster prompt, effektive output- og resonneringsbudsjetter, verktøy, retries, tidsavbrudd og akseptkriterier, og sammenlign deretter akseptert arbeid, latens og total fakturert kostnad.
Konklusjon
GPT-6.1 Sol og Claude Sonnet 5.5 deler samme basisrater for input, output og cache-lesing, med tilsvarende kontekstkapasitet. Sol er et naturlig valg for eksisterende Responses-agenter og eksplisitte innsatskontroller. Sonnets adaptive tenkning og rapporterte resultater for koding og profesjonelt arbeid gjør den til en nyttig kandidat for hverdagsleveranser. Cache-tunge arbeidsflyter krever en full økt-sammenligning: like basisleserater garanterer ikke like skrive-, retensjons-, langkontekst- eller fullført-oppgave-kostnader.
Velg modellen som fullfører ditt faktiske arbeid innenfor kravene til kvalitet, latens og kostnad. Hold forgjengerscorer separate fra evidens for nåværende modeller, pris det kontekstnivået arbeidsflyten din bruker, og sammenlign begge rutene før du adopterer en standard.
FAQ
Kan GPT-6.1 Sol og Sonnet 5.5 dele ett verktøyskjema?
Et felles JSON-verktøydefinisjon kan være et utgangspunkt, men endepunktstøtte, tvungne verktøymoduser, tenkningsblokker og responsbehandling varierer. Valider hver modells verktøykall med kontrakttester for argumenter, feilbaner og samtalefortsettelse. Behold modellspesifikke adaptere for ikke-støttede alternativer i stedet for å anta at en vellykket tekstforespørsel beviser agentkompatibilitet.
Hvordan bør resonneringsinnsats matches på tvers av begge modellene?
Ikke behand identisk navngitte innstillinger som like compute-budsjetter. Definer en aksepteringsrubrikk og enten en kostnadsgrense eller et latenstarget, og sweep innsatsinnstillinger for hver modell. Sammenlign den beste konfigurasjonen som møter samme operative begrensning, inkludert retries og menneskelig korreksjon, i stedet for å sammenligne kun de høyeste innstillingene.
Når bør en 1M-kontekstarbeidsflyt bruke gjenfinning i stedet?
Bruk gjenfinning når en oppgave trenger en liten, identifiserbar del av et stort korpus og gjenfinnings-testene dine viser at relevant materiale konsekvent blir hentet. Test full-kontekst-forespørsler når evidens er distribuert eller relasjoner på tvers av filer betyr noe. Sammenlign svarkorrekthet, siteringsdekning, inputkostnad og latens; en stor kontekstgrense etablerer ikke i seg selv at det er økonomisk eller pålitelig å fylle hele vinduet.
Hvordan kan team unngå en misvisende sammenligning av cache-kostnader?
Mål kald-cache og varm-cache-kjøringer separat, registrer cache-skrivinger så vel som lesinger, og anvend korrekt retensjonsvindu og langkontekst-nivå. Hold delte prefiks stabile og sammenlign gjentatte realistiske økter, ikke bare én rabattert forespørsel. Rapportér treffraten og total fakturert bruk slik at en tilsynelatende besparelse kan reproduseres.
Hva bør utløse en ny GPT-6.1 Sol vs Sonnet 5.5-evaluering?
Kjør den berørte oppgavesuiten på nytt etter en utrullingsoppdatering, leverandørens feilretting, ruteendring, verktøy- eller promptendring, eller en vesentlig prisrevisjon. Registrer evalueringsdato, modell-ID, endepunkt, innsats og harness-versjon. Bevar den tidligere kjøringen som baseline slik at kvalitets- eller latensendringer ikke forveksles med endringer i det omkringliggende systemet.