
TL;DR
GPT-6.1 Sol er ikke en variant med større kontekst eller en dyrere erstatning for GPT-6 Sol. Den beholder det samme kontekstvinduet på 1,05 millioner tokens, 128K maksimal output og $2/$10 standard API-prising, samtidig som den forbedrer koding, databruk, profesjonelle arbeidsflyter, faktisk pålitelighet og agentatferd. Den tydeligste prisendringen er prompt-hurtigbuffering: hurtigbufret inndata faller fra $0.20 til $0.10 per million tokens.
Hovedpunkter
- GPT-6.1 Sol er en kapasitetsoppgradering av GPT-6 Sol, med samme 1,050,000-token kontekstvindu og 128,000-token outputtak.
- Standard API-priser for inndata og output forblir $2/M og $10/M; hurtigbufret inndata faller fra $0.20/M til $0.10/M.
- Offisielle evalueringer viser sterkere koding, databruk, forretningsautomatisering og vitenskapelige arbeidsflyter; resultater avhenger av benchmark og resonneringsinnstilling.
- Migrering krever kontroll av både resonneringsinnsats og API-endepunktskompatibilitet: GPT-6.1 Sol fjerner ingen og krever Responses API for verktøykall.
- Valider oppgavesuksess, latens, faktiske cache-treff og total kostnad ende-til-ende før du erstatter en stabil GPT-6 Sol-deployment.
Hva er GPT-6.1 Sol, og hvorfor kom den så kort tid etter GPT-6 Sol?
OpenAI introduserte GPT-6 Sol 22. september 2026. Én uke senere annonserte systemkort-tillegget 29. september GPT-6.1 Sol. OpenAI presenterer den nye utgivelsen som en oppgradering av GPT-6 Sol snarere enn et eget prismessig nivå.
Det korte utgivelsesintervallet er viktig fordi GPT-6.1 Sol ikke er posisjonert som et nytt produktnivå. OpenAI beholdt Sol-prisnivået og fokuserte oppdateringen på kapasitet for vanskelige oppgaver, kostnadseffektivitet og agentpålitelighet.
OpenAI posisjonerer GPT-6.1 Sol rundt agentbasert koding, databruk og profesjonelt arbeid. Den viktige sammenligningen er oppgavesuksess til gitt kostnad, heller enn modellnavnet i seg selv. Den offisielle benchmark-oppsummeringen nedenfor skiller kapasitetsgevinster fra uendrede API-spesifikasjoner.
Det gjør sammenligningen uvanlig rett fram: GPT-6.1 Sol er primært en kapasitets- og effektivitetssoppgradering snarere enn en oppgradering av kontekstvindu eller grunnpris.
GPT-6.1 Sol vs. GPT-6 Sol: Hva forblir det samme?
Begge modeller beholder samme hovedkapasitet, støttede inndata-/output-modaliteter og Standard-priser for inndata/output. Tabellen registrerer også forskjeller i cutoff-datoer, resonneringsvalg, verktøykall og satser for hurtigbufret inndata; disse forskjellene må ikke forveksles med delte spesifikasjoner.
Delte spesifikasjoner og kompatibilitetsforskjeller
| Spesifikasjon | GPT-6.1 Sol | GPT-6 Sol |
|---|---|---|
| Model ID | gpt-6.1-sol | gpt-6-sol |
| Release date | Sep. 29, 2026 | Sep. 22, 2026 |
| Context window | 1,050,000 tokens | 1,050,000 tokens |
| Maximum output | 128,000 tokens | 128,000 tokens |
| Knowledge cutoff | Apr. 30, 2026 | Apr. 20, 2026 |
| Text input / output | Ja / Ja | Ja / Ja |
| Image input | Ja | Ja |
| Standard input price | $2.00 / 1M | $2.00 / 1M |
| Cached input | $0.10 / 1M | $0.20 / 1M |
| Cache write | $2.50 / 1M | $2.50 / 1M |
| Output price | $10.00 / 1M | $10.00 / 1M |
| Reasoning effort | low, medium, high, xhigh, max | none, low, medium, high, xhigh, max |
| Structured outputs | Ja | Ja |
| Function calling | Ja via Responses API; ikke tilgjengelig via Chat Completions | Ja via Responses API; Chat Completions kun med reasoning_effort=none |
| Fine-tuning | Nei | Nei |
| Audio / video input | Ikke støttet | Ikke støttet |
| Native image output | Ikke støttet; bildegenerering er et separat verktøy | Ikke støttet; bildegenerering er et separat verktøy |
De to offisielle modellkolonnene ovenfor dokumenterer samme kontekst- og outputgrenser. Disse tallene beskriver kapasitet; de etablerer ikke lik gjenfinning nøyaktighet eller latens på tvers av alle lang-kontekst-arbeidsbelastninger.
Kunnskapsavgrensningen flyttes litt frem, fra 20. april til 30. april 2026. Viktigere er det at GPT-6.1 Sol ikke lenger støtter reasoning.effort="none"; tilgjengelige resonneringsinnstillinger begynner på low.
For utviklere som er avhengige av minimal-latensatferd, er denne kompatibilitetsdetaljen verdt å teste fordi GPT-6 Sol fortsatt støtter reasoning effort none.
Arkitektur: Hva forblir uavslørt
Ingen av modellsidene brukt for denne sammenligningen gir antall parametere eller en detaljert arkitekturoversikt. Det offisielle systemkort-tillegget sier at GPT-6.1 Sol bruker samme typer data og trening som Astra; den uttalelsen beviser ikke at Sol og Astra har identiske arkitekturer. Forskjeller i arkitektur og parameter-skala forblir derfor uavslørt i det siterte materialet.
Grunnpriser er uendret; hurtigbufrede lesinger er billigere
For ordinære, ikke-hurtigbufrede tokens, nei. Standard satser for inndata og output er uendret. Den viktigste prisforbedringen er hurtigbufret inndata.
| Offisiell API-prising — USD per 1M tokens | GPT-6.1 Sol | GPT-6 Sol |
|---|---|---|
| Inndata / 1M tokens | $2.00 | $2.00 |
| Hurtigbufret inndata / 1M | $0.10 | $0.20 |
| Skriving til hurtigbuffer / 1M | $2.50 | $2.50 |
| Output / 1M tokens | $10.00 | $10.00 |
GPT-6.1 Sol kutter hurtigbufret inndata til $0.10 per million tokens, eller 5% av den ikke-hurtigbufrede inndata-satsen.
For eksempel koster gjenbruk av 100 millioner hurtigbufrede inndata-tokens omtrent $10 på GPT-6.1 Sol versus $20 på GPT-6 Sol. Den forskjellen er beskjeden for enkeltstående prompt, men mer betydningsfull for høyvolumsagenter med stabile prompt-prefikser.
De offisielle prisbetingelsene som vises i modelldokumentasjonen gjelder også: forespørsler over 272K inndata-tokens bruker 2x satser for inndata og hurtigbuffer og 1.5x output-prising for hele forespørselen. GPT-6.1 Sol Fast-modus er 2x Standard; Batch og Flex er 50% under Standard. Regional behandling legger til 10% premie der tilgjengelig, og Fast-modus er ikke tilgjengelig med EU-dataresidens. Separate verktøykostnader kan gjelde. Budsjetter etter valgt behandlingsmodus, region og faktiske cache-treff.
Hva er forbedret i GPT-6.1 Sol?
Oppgraderingen vurderes best på tvers av koding, agentarbeidsflyter, profesjonelle dokumenter, vitenskap, faktualitet og feilhåndtering. Seksjonene nedenfor grupperer disse forbedringene samtidig som de beholder de opprinnelige benchmark-betingelsene og begrensningene.
Benchmark-oversikt: rapporterte gevinster og evalueringsbetingelser
Den sterkeste begrunnelsen for GPT-6.1 Sol kommer fra oppgavenivå-ytelse heller enn rå spesifikasjoner. OpenAI rapporterer forbedringer på tvers av programvareutvikling, forretningsautomatisering, datamaskininteraksjon, vitenskapelige arbeidsflyter, faktualitet og agentjustering.
| Offisielle benchmark-/evalueringsresultater | GPT-6.1 Sol vs. GPT-6 Sol | Hva endringen betyr |
|---|---|---|
| DeepSWE v1.1 | +6.4 prosentpoeng over GPT-6 Sols beste resultat, ved lavere resonneringsinnsats og oppgavekostnad; dette er ikke en matched-effort sammenligning | Sterkere lang-horisont programvareutvikling |
| AutomationBench 1.0.6 | +4.8 prosentpoeng ved medium innsats for begge Sol-modeller; +2.2 poeng over Opus 5.5 ved medium innsats | Bedre flertrinns forretningsagent-utførelse |
| OSWorld 2.0 offline | +7 prosentpoeng ved maks innsats; delvis belønning på offline-settet, release v2026.08.08; mindre enn halv oppgavekostnad | Bedre arbeidsflyter for bruk av datamaskin |
| Terminal-Bench Science 0.1 | Mer enn 2x GPT-6 Sols score ved maks innsats, med mindre enn halv kostnad per oppgave | Stor gevinst i vitenskapelige agentarbeidsflyter |
| Vanskelig faktualitetsevaluering | Ved lav innsats faller svar med feil fra 11.4% til 7.7%; dette er en utvalgt evaluering av vanskelige prompt | Færre faktiske feil på vanskelige prompt |
| Broken-search alignment test | Ved maksimal innsats faller unnlatelse av å opplyse om ødelagt søk fra 4.9% til 2.1%; bevisst adversariske oppgaver | Bedre gjenkjenning av verktøyfeil |
Dette er OpenAI-rapporterte resultater, ikke uavhengige CometAPI-målinger. OpenAI evaluerte sine modeller i sitt forskningsmiljø eller via sin API; produksjonsatferd kan avvike med systemprompt og tilgjengelige verktøy. Konkurrenttall kommer fra offentlige rapporter. Oppgavekostnad reflekterer den testede konfigurasjonen og er ikke det samme som token-pris. Urapporterte detaljer som per-kjøring-budsjett eller scaffolds skal ikke utledes.
Det offisielle resultatet i benchmark-tabellen sammenligner GPT-6.1 Sol ved lavere resonneringsinnsats med GPT-6 Sols beste score. Det skal ikke beskrives som en kontrollert, lik-innsats hastighetssammenligning. DeepSWE v1.1 evaluerer originale, lang-horisont programvareoppgaver i reelle kodebaser.
Til kontekst rapporterte den opprinnelige lanseringen av GPT-6 Sol 68.8% ved maksimal innsats på DeepSWE v1.1.
Koding: sterkere lang-horisont programvareutvikling
Koding er kanskje den tydeligste oppgraderingen. DeepSWE v1.1 evaluerer agenter på originale programvareutviklingsoppgaver i reelle kodebaser som krever vedvarende, flertrinns arbeid.
DeepSWE-forbedringen oppsummert ovenfor er relevant når en agent må inspisere et repository, planlegge endringer, bruke verktøy og reparere feil over mange steg. Utviklere kan sammenligne denne oppgraderingen med GPT-6 Astra API i CometAPI når de vurderer om de vanskeligste oppgavene rettferdiggjør en modell med høyere kostnad.
Dette betyr mer enn en kort kodebenchmark fordi langvarige kodeagenter akkumulerer kostnad gjennom gjentatt resonnering, verktøykall, fillesinger, patcher og kontekstgjenbruk. GPT-6.1 Sol forbedrer både oppgavefullføring og økonomien i gjentatt kontekst uten å øke standard $2/$10 token-satsene.
GPT-6 Sol API i CometAPI forblir nyttig for eksisterende deployments og gir en OpenAI-kompatibel vei for koding og agentarbeidsbelastninger.
AI-agenter og forretningsarbeidsflyter: automatisering og databruk
Ja, og forbedringen strekker seg utover koding. AutomationBench evaluerer om en agent kan fullføre ende-til-ende arbeidsflyter ved å bruke mange verktøy på tvers av salg, markedsføring, drift, support, økonomi og HR.
Det matchede-medium AutomationBench-resultatet i benchmark-oppsummeringen er relevant for verktøy-tunge forretningsarbeidsflyter. Det forblir et benchmark-resultat snarere enn en garanti for suksess i et selskaps egen verktøystakk. Sammenligningen inkluderer også Claude Opus 5.5 API i CometAPI; evaluer alle kandidater med samme verktøy og suksesskriterier før du velger én.
For databruk benytter OSWorld-resultatet ovenfor offline-settet og delvis belønning. En høyere delvis-belønning-score betyr ikke nødvendigvis at alle oppgaver ble fullført ende-til-ende. Nettleserstatus, tillatelser, gjenopprettingsatferd og kvaliteten på verktøyintegrasjonen påvirker fortsatt resultatene i deployment.
Profesjonelle dokumenter og vitenskap: bredere kapasitet for komplekse oppgaver
GPT-6.1 Sol trekker også Sol-nivået lenger inn i profesjonelt kunnskapsarbeid. OpenAI evaluerer kompleks dokumentforståelse med GDP.pdf, der modeller besvarer realistiske spørsmål basert på PDF-er som inneholder tabeller, diagrammer, figurer, tett formatering og finstilt detalj på tvers av felt som finans, helse og jus.
GDP.pdf gir bevis for profesjonell PDF-analyse utover ordinær tekstbasert spørsmål-svar. Behandle resultatet i lanseringsmeldingen som en evaluering av dokumentforståelse, ikke en garanti for at hver graf, fotnote eller skannet side tolkes korrekt.
Terminal-Bench Science-resultatet i den offisielle benchmark-oppsummeringen dekker arbeidsflyter som dataanalyse, simulering og teorembevis. En nyttig lokal evaluering bør score korrekthet og reproduserbarhet av sluttoutput, samtidig som total verktøy- og modellkostnad måles.
Dette betyr ikke at GPT-6.1 Sol universelt erstatter Astra. OpenAI fortsetter å posisjonere Astra som sin mest kapable modell for de vanskeligste ende-til-ende-oppgavene. Den viktige endringen er at ytelsesgapet mellom Sol og Astra snevres inn mens token-prisgapet forblir stort.
Faktisk nøyaktighet og agentpålitelighet: færre feil og bedre feilhåndtering
OpenAIs faktualitetsdata peker i den retningen, selv om evalueringen ikke skal tolkes som en universell hallusinasjonsrate.
Den offisielle kunngjøringen rapporterer direkte en faktualitetsforbedring ved lav innsats: svar som inneholder feil faller fra 11.4% med GPT-6 Sol til 7.7% med GPT-6.1 Sol, en nedgang på 3.7 prosentpoeng, eller omtrent 32% relativ reduksjon. Disse utvalgte samtalene utløste tidligere feil; tallene er ikke en universell hallusinasjonsrate.
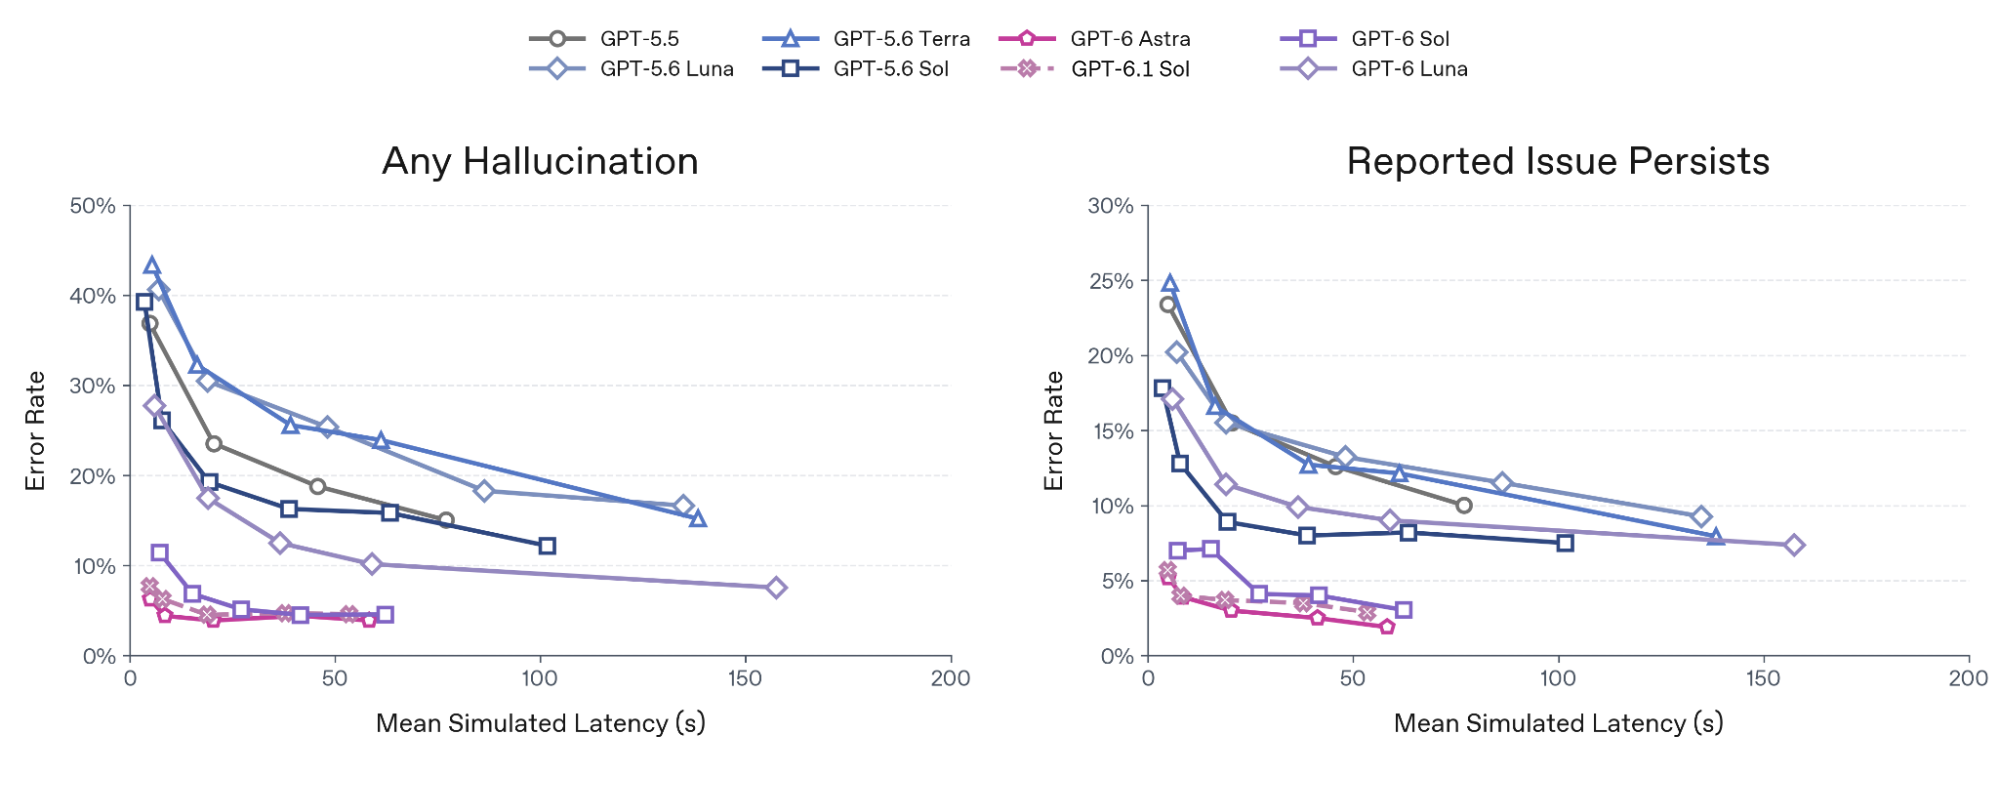
Det opprinnelige diagrammet ovenfor er hentet direkte fra OpenAIs systemkort-PDF uten omtegning. Det plottet utvalgte evalueringer av vanskelige samtaler mot simulert latens; de to panelene måler enhver hallusinasjon og vedvarenhet av det rapporterte problemet. Det skal ikke leses som et produksjonsomfattende feilestimat.
| Modell | Feilrate ved ødelagt søk — maksimal innsats |
|---|---|
| GPT-6.1 Sol | 2.1% |
| GPT-6 Sol | 4.9% |
| GPT-6 Astra | 1.5% |
| GPT-6 Luna | 28.7% |
GPT-6 Luna API i CometAPI er et annet kostnadsorientert alternativ, men resultatet for ødelagt søk her illustrerer hvorfor en agent må testes på feilhåndtering så vel som vellykket verktøyutførelse.
Dette er bevisst adversariske evalueringer snarere enn representative produksjonsfeilrater. De er nyttige som bevis på at GPT-6.1 Sol er bedre til å gjenkjenne når verktøy er utilgjengelige eller ødelagte i stedet for å fortsette selvsikkert med ikke-støttede påstander.
GPT-6.1 Sol vs. GPT-6 Sol: Bør du oppgradere?
For en ny kompleks arbeidsflyt er GPT-6.1 Sol en sterk evalueringskandidat. For en stabil GPT-6 Sol-deployment, oppgrader kun når målte gevinster rettferdiggjør migreringen. Den delte kontekstgrensen og grunnleggende token-priser gjør en rettferdig sammenligning mulig, men offentlige benchmarks kan ikke avgjøre om din egen applikasjon blir raskere, mer pålitelig eller billigere.
Når det er verdt å teste oppgradering
Prioriter en prøve når repository-skala koding, flertrinns forretningsautomatisering, databruk eller vanskelig dokumentanalyse utgjør en betydelig del av arbeidsbelastningen. De rapporterte forbedringene i forrige seksjon er relevante for disse bruksområdene. Behandle dem som grunner til å teste, ikke som en garanti for at produksjonssuksessraten vil øke i samme grad.
Applikasjoner med gjentatt kontekst er et annet nyttig testtilfelle. Den lavere satsen for hurtigbufrede lesinger kan redusere inndatadelen av regningen når forespørsler faktisk gjenbruker et stabilt prefiks. Hvis mest spend kommer fra genererte tokens, verktøy eller mislykkede forsøk, kan alene cache-rabatten ha liten effekt. Sammenlign total kostnad per akseptert resultat, inkludert nye forsøk og gjennomgangstid.
Når det er rimelig å beholde GPT-6 Sol
Behold GPT-6 Sol når den allerede møter dine mål for kvalitet, latens og budsjett, og den nyere modellen ikke gir materiell fordel i en representativ evaluering. En fungerende integrasjon har også verdi: unngå å erstatte en stabil rute utelukkende fordi modellenavnet er nyere.
Kompatibilitet kan være avgjørende. GPT-6 Sol støtter none resonnering; GPT-6.1 Sol starter på low. En applikasjon som bruker Sol Chat Completions funksjonskall ved none må flytte verktøysløyfen til Responses for å bruke 6.1 Sol. Revider også samplingparametere og responsparsing. Dette er migreringsendringer, ikke bare en bytte av model-ID. Se OpenAIs migreringsveiledning.
Slik tar du oppgraderingsbeslutningen
Lag et fast evalueringssett med rutineoppgaver, vanskelige tilfeller og verktøyfeil fra din tiltenkte arbeidsflyt. Hold oppgavedefinisjoner, verktøytillatelser og akseptkriterier konsistente. Sammenlign en validert Sol-baseline med en gyldig 6.1 Sol-konfigurasjon; registrer resonneringsinnstillinger eksplisitt i stedet for å late som none og low er ekvivalente.
- Kvalitet: mål aksepterte fullføringer, faktiske korrigeringer, ugyldige verktøykall og menneskelig gjennomgangsinnsats.
- Hastighet: sammenlign p50/p95 latens ende-til-ende, inkludert nye forsøk og verktøyventetid.
- Kostnad: registrer ikke-hurtigbufret inndata, hurtigbufrede lesinger, skriving til hurtigbuffer, output-/resonnerings-tokens, verktøykostnader og engineeringinnsats.
- Utrulling: start med en liten trafikkandel, bevar en Sol-fallback, og utvid først når forhåndsdefinerte terskler er oppfylt.
Praktisk anbefaling: velg GPT-6.1 Sol når testen gir bedre økonomi per akseptert oppgave eller nødvendig kapasitetsgevinst uten uakseptable regresjoner. Behold GPT-6 Sol for ruter der kompatibilitet og gjennomprøvde resultater veier tyngre enn den målte gevinsten. En blandet deployment er rimelig når bare noen oppgaveklasser forbedres. Dette er arbeidsbelastningsbaserte anbefalinger, ikke en påstand om at én modell vinner universelt.
Hvordan migrerer du fra GPT-6 Sol til GPT-6.1 Sol?
På enkleste nivå endres modellidentifikatoren fra gpt-6-sol til gpt-6.1-sol.
En Responses API-forespørsel kan se slik ut:
from openai import OpenAI

client = OpenAI()

response = client.responses.create(
    model="gpt-6.1-sol",
    reasoning={"effort": "medium"},
    input="Analyze this repository and identify the cause of the failing tests."
)

print(response.output_text)
Å endre modellidentifikatoren er bare første steg. GPT-6.1 Sol støtter low, medium, high, xhigh og max, mens GPT-6 Sol i tillegg støtter none. Fjern enhver eksplisitt none-innstilling og velg en tillatt innsats. Applikasjoner som bruker verktøy krever også Responses API: GPT-6.1 Sol Chat Completions støtter ikke verktøykall, mens GPT-6 Sol Chat Completions støtter funksjonskall kun med none. De offisielle modellkolonnene i spesifikasjonstabellen dokumenterer disse endepunktsbegrensningene.
Team bør reteste latenssensitiv arbeidsflyt, verktøykall, prompt-hurtigbuffering, lang-kontekst-atferd og all logikk som eksplisitt sender reasoning.effort="none".
Dette eksemplet retter seg mot OpenAI direkte ved bruk av OPENAI_API_KEY; det er ikke et verifisert CometAPI-endepunkt-eksempel. Hold din GPT-6 Sol-rute tilgjengelig under en gradvis utrulling, registrer oppgavesuksess og p95-latens, og rull tilbake hvis applikasjonens akseptkriterier ikke innfris.
Hvilke GPT-6.1 Sol-arbeidsbelastninger har mest nytte av oppgraderingen?
| Arbeidsbelastning | GPT-6.1 Sol-fordel |
|---|---|
| Kodeagenter | Høyere DeepSWE-ytelse |
| Feilsøking på repository-nivå | Bedre lang-horisont programvareutvikling |
| Nettleser-/datamaskinagenter | +7 poeng på OSWorld 2.0 |
| Enterprise-automatisering | Høyere AutomationBench-ytelse |
| Agenter med gjentatt kontekst | 50% billigere hurtigbufret inndata |
| Kompleks PDF-analyse | Nær-Astra ytelse for profesjonelle dokumenter |
| Vitenskapelige arbeidsflyter | Mer enn 2x GPT-6 Sol score i OpenAIs Terminal-Bench Science-evaluering |
| Faktasensitive arbeidsflyter | Lavere faktiske feilrate på vanskelige prompt |
| Verktøy-tunge agenter | Bedre atferd når verktøy feiler |
GPT-6 Sol forblir nyttig der eksisterende integrasjoner allerede er stabile eller der utviklere spesifikt trenger none resonneringsinnstilling. For nye deployments som er sentrert rundt agenter, koding, databruk eller arbeidsflyter med gjentatt kontekst, endrer GPT-6.1 Sol kostnad–ytelse-likningen uten å endre normal inndata-/output token-pris.
Hvordan kan CometAPI hjelpe deg å oppgradere fra GPT-6 Sol til GPT-6.1 Sol?
For utviklere som allerede bruker GPT-6 Sol API i CometAPI, kan oppgraderingen til GPT-6.1 Sol håndteres som en relativt liten migrering snarere enn en fullstendig integrasjonsombygging.
GPT-6.1 Sol er nå tilgjengelig via CometAPI med model-ID gpt-6.1-sol. CometAPI viser for tiden en startpris for kort-kontekst inndata på $1.60 per million tokens, sammenlignet med OpenAIs offisielle $2.00-sats, mens output-prising starter på $8.00 per million tokens. Dette holder den nyere Sol-modellen i samme rabatterte prisstruktur som GPT-6 Sol, samtidig som utviklere får tilgang til sterkere ytelse i koding, agentarbeid og databruk.
Fordi CometAPI gir et OpenAI-kompatibelt grensesnitt, kan eksisterende GPT-6 Sol-applikasjoner vanligvis beholde samme SDK-struktur og forespørselsflyt mens de bytter model-ID til gpt-6.1-sol. CometAPI tilbyr også verktøy for å sammenligne modeller, teste prompt, estimere arbeidsbelastningskostnader og inspisere migreringsatferd før produksjonsutrulling.
En tryggere oppgraderingsprosess er å kjøre de samme representative promptene mot GPT-6 Sol og GPT-6.1 Sol først, og deretter sammenligne output-kvalitet, latens, verktøyatferd og total kostnad. Dette er spesielt viktig for applikasjoner som er avhengige av resonneringsinnstillinger, strukturerte utdata, verktøykall eller langvarige agenter, fordi modellkompatibilitet ikke garanterer identisk atferd på hver arbeidsbelastning.
For team som kjører arbeidsbelastninger med gjentatt kontekst eller agent-tetthet, kan den nyere ruten også forbedre økonomien. CometAPI priser for tiden kort-kontekst cache-lesinger for GPT-6.1 Sol til $0.08 per million tokens, mot OpenAIs offisielle $0.10-sats, mens kort-kontekst inndata- og outputsatser er listet 20% under offisiell prising.
I praksis kan CometAPI gjøre GPT-6 Sol → GPT-6.1 Sol-overgangen til en prosess i tre steg:
- Erstatt
gpt-6-solmedgpt-6.1-sol. - Benchmark de samme produksjonslignende promptene og agentarbeidsflytene før du bytter trafikk.
- Flytt arbeidsbelastninger gradvis når output-kvalitet, verktøyatferd, latens og kostnad møter kravene dine.
Denne tilnærmingen lar utviklere ta i bruk GPT-6.1 Sol uten å bygge applikasjonen på nytt rundt en ny API-stakk, samtidig som de validerer atferdsforskjellene som den nyere modellen introduserer.
Konklusjon
GPT-6 Sol er ikke teknisk utdatert. Den beholder samme 1.05M kontekstvindu, 128K outputtak, strukturerte utdata, bildeinndata og $2/$10 Standard-prising. Dens none resonneringsvalg kan også være viktig for eksisterende integrasjoner. Oppgraderingsbeslutningen bør baseres på målte oppgaveutfall og kompatibilitet, ikke versjonsnummeret alene.
OpenAIs GPT-6 Sol-dokumentasjon peker imidlertid nå utviklere til GPT-6.1 Sol som den nyere Sol-modellen.
For de fleste komplekse arbeidsbelastninger er nøkkelspørsmålet derfor ikke om GPT-6.1 Sol har større kontekstvindu eller høyere token-sats—det har den ikke. Spørsmålet er om høyere oppgavesuksess, billigere cache-lesinger, forbedret faktualitet og sterkere agentatferd rettferdiggjør å endre model-ID og reteste arbeidsbelastningen.
FAQ
Hvordan migrerer du fra GPT-6 Sol til GPT-6.1 Sol med verktøykall?
Nei. Revider først endepunkt og forespørselsfelter, flytt deretter verktøysløyfen til Responses API og test parsing av verktøykall, argumentvalidering, nye forsøk og feilhåndtering. Kjør en kanari på representative oppgaver før du øker trafikken; en vellykket tekst-forespørsel verifiserer ikke en fungerende verktøysløyfe.
Er GPT-6.1 Sol billigere i reelle arbeidsbelastninger?
Logg hurtigbufrede og ikke-hurtigbufrede inndata-tokens, skriving til hurtigbuffer, resonnerings- og output-tokens, behandlingsmodus og verktøykostnader. Sammenlign kostnad per akseptert oppgave snarere enn pris på hurtigbufrede tokens alene. Stabile prefikser hjelper bare når forespørsler faktisk treffer cachen, og lengre verktøysløyfer eller mislykkede forsøk kan oppveie cache-besparelser.
Hvordan bør du teste GPT-6.1 Sol før du bytter fra GPT-6 Sol?
Bruk et fast sett med produksjonslignende oppgaver og registrer vellykket fullføring, faktiske korrigeringer, ugyldige verktøykall, p50/p95 latens og total kostnad. Definer akseptable terskler før testing. Bevar en modellrute for rollback og øk trafikken først etter at den nye konfigurasjonen møter tersklene.
Hvordan tester du GPT-6.1 Sol med PDF-er?
Bygg et lite korpus med tette tabeller, fotnoter, diagrammer og skannede sider representativt for den tiltenkte arbeidsflyten. Still spørsmål med verifiserbare svar og krev side- eller tabellbevis. Score beregningsnøyaktighet, manglende forbehold og ikke-støttede svar separat; behold menneskelig gjennomgang for utdata der feil har materielle konsekvenser.