
GPT-6 Astra og Claude Fable 5.1 kom med bare to dagers mellomrom: Astra ble lansert 3. september, mens Fable 5.1 ble lansert 1. september. Til tross for den tette timingen, viser de viktigste forskjellene seg i benchmark-profil, verktøykjøring og cache-økonomi.
Likheten stopper når arbeidslasten starter. OpenAIs lanseringsevalueringer setter Astra foran på flere tester innen koding, vitenskap, datamaskinbruk og profesjonelt arbeid, mens Anthropics publiserte benchmarker viser at Fable 5.1 leder på Humanity’s Last Exam. Fable 5.1 har også en lavere offisiell cache-lesepris, som kan endre økonomien vesentlig for langtidskjørende agenter.
Så det nyttige spørsmålet er ikke bare hvilken modell som har høyest benchmark-score. Det praktiske spørsmålet er hvilken modell som fullfører arbeidslasten din mer pålitelig og økonomisk.
Kort svar: Astra er det sterkere standardvalget for utførelsestunge agenter, koding, datamaskinbruk og verktøydrevne vitenskapelige arbeidsflyter. Fable 5.1 er spesielt overbevisende for bred, vanskelig resonnering, langvarig asynkront arbeid og applikasjoner som gjentatte ganger gjenbruker svært store cachede kontekster.
GPT-6 Astra vs Claude Fable 5.1 kort oppsummert
| Spesifikasjon | GPT-6 Astra | Claude Fable 5.1 |
|---|---|---|
| Utvikler | OpenAI | Anthropic |
| Lanseringsdato | 3. sep. 2026 | 1. sep. 2026 |
| API-modell-ID | gpt-6-astra | claude-fable-5-1 |
| Kontekstvindu | 1 050 000 tokens | 1 000 000 tokens |
| Maksimal utdata | 128 000 tokens | 128 000 tokens |
| Inndata-modaliteter | Tekst, bilder | Tekst, bilder |
| Utdata-modalitet | Tekst | Tekst |
| Kunnskapsgrense | 30. apr. 2026 | jun. 2026 |
| Resonnering | low / medium / high / xhigh / max | Adaptive, always on |
| Standard innsats | — | high |
| Offisiell input/output | $10 / $50 per MTok | $10 / $50 per MTok |
| Offisiell cache-lesing | $1 / MTok | $0.25 / MTok |
| Langkontekst-prising | Høyere nivå over 272K input | Standard sats i hele 1M-kontekst |
| Primær posisjonering | Ende-til-ende utførelse, koding, PC-bruk | Kravstor resonnering, langhorisont-agenter |
Informasjon og priser verifisert 7. september 2026. Leverandørspesifikasjoner og priser kan endres etter publisering.
Kilde: OpenAI official benchmark
Hva er GPT-6 Astra?
OpenAI introduserte GPT-6 Astra 3. september 2026 som sin mest kapable modell for vanskelig, ende-til-ende profesjonelt arbeid. I stedet for å fokusere på isolerte spørsmål og svar, er Astra designet for å fullføre komplekse arbeidsflyter som kombinerer resonnering, koding, research, datamaskininteraksjon og dokumentproduksjon. Den kan arbeide over flere steg, bruke leverte verktøy og kontekst, og tilpasse seg når brukere reviderer krav eller endrer retning underveis. OpenAIs utgivelsesnotater fremhever applikasjoner som å produsere dokumenter, regneark og presentasjoner som følger spesifikke instruksjoner og maler.
Modellen tilbyr et kontekstvindu på 1 050 000 tokens og maksimal utdata på 128 000 tokens, noe som gjør at den kan behandle store kodebaser, omfattende dokument-samlinger eller langtids agent-historikker i én arbeidsflyt. Resonneringsinnsats kan konfigureres til low, medium, high, xhigh eller max, slik at utviklere kan balansere svartid og beregningsdybde etter oppgavens vanskelighetsgrad.
Hva er Claude Fable 5.1?
Anthropic lanserte Claude Fable 5.1 1. september 2026 som sin toppmodell for krevende resonnering og langhorisont agentisk arbeid. Den bygger på Claude Fable 5 med forbedringer i langtidskodingsoppgaver, flerstegs research og opprettelse eller analyse av dokumenter, regneark og presentasjoner. Anthropic anbefaler den for arbeidslaster der vedvarende resonnering og pålitelig utførelse betyr mer enn ren svartid—særlig når Claude Opus 5 på høyere innsatsnivåer ikke gir tilstrekkelig ytelse.
Ifølge den offisielle Claude Fable 5.1-spesifikasjonen tilbyr modellen et kontekstvindu på én million tokens og maksimal utdata på 128 000 tokens. Det gir nok kapasitet til å granske store repositorier, lange forretningsregistre, forskningssamlinger eller utvidede agentforløp uten å måtte dele materialet aggressivt opp i separate forespørsler. Den tar imot tekst- og bildeinput og produserer tekstutdata, med kunnskapsgrense juni 2026.
Benchmark-sammenligning: Astra vinner flere rader, men ikke alle viktige
En benchmark-sammenligning mellom konkurrerende leverandører krever mer forsiktighet enn en normal generasjon-til-generasjon-sammenligning. OpenAI testet Fable 5.1 på flere Astra-lanseringsevalueringer, mens Anthropic brukte sine egne rammeverk og, i noen tilfeller, en nyere oppgaveutgivelse. Det gjør de reneste sammenligningene til testene der definisjoner og rapporterte innstillinger stemmer godt nok til å støtte en direkte beslutning.
GPT-6 Astra vs Claude Fable 5.1: Hvilken er bedre for koding og agentbasert programvare
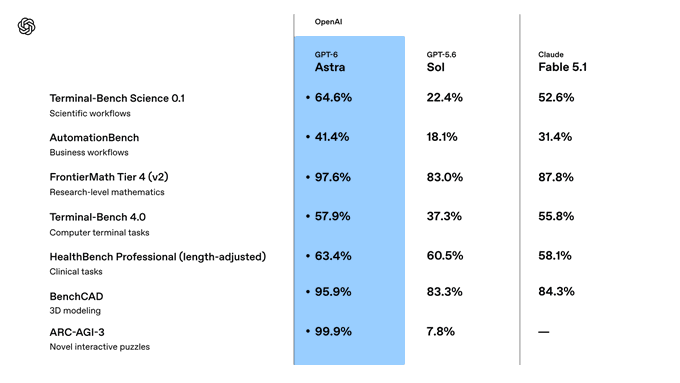
Koding er et av Astras tydeligste styrkeområder. På OpenAIs publiserte lanseringstabell scorer Astra 57,9 % mot 55,8 % på Terminal-Bench 4.0, 74,1 % mot 67,4 % på DeepSWE v1.1, og 63,9 % mot 57,8 % på en intern database-migreringsevaluering.
| Kode-benchmark | GPT-6 Astra | Claude Fable 5.1 | Resultat |
|---|---|---|---|
| Terminal-Bench 4.0 | 57,9% | 55,8% | Astra +2,1 p. |
| DeepSWE v1.1 | 74,1% | 67,4% | Astra +6,7 p. |
| FrontierCode 1.1 Extended | 64,5% | 63,6% | Astra +0,9 p. |
| FrontierCode 1.1 Main | 53,3% | 50,9% | Astra +2,4 p. |
| Database migration, intern | 63,9% | 57,8% | Astra +6,1 p. |
Astra representerer et betydelig gjennombrudd for utførelsesfokuserte modeller: de publiserte resultatene leder Fable 5.1 på Terminal-Bench 4.0, DeepSWE v1.1 og database-migreringsevalueringen, og forsterker fordelen når kode må kjøres, testes og verifiseres på tvers av verktøy.
Konklusjonen er ikke at Fable 5.1 er svak på koding. Anthropic beskriver den som sin mest kapable modell for ambisiøse kodeprosjekter, og dens egen CursorBench 3.2.0-score når 73,4 %. Forskjellen er arbeidslastens form: Astras fordel blir mer overbevisende når koding blandes med shell-kjøring, repositorienavigasjon, verifikasjon og andre verktøy.
Vinner for utførelsestung programvareutvikling: Astra. En langtidskjørende repo-agent er jevnere, fordi vedvarende koherens, cache-oppførsel og token-effektivitet kan bety like mye som én benchmark-score.
GPT-6 Astra vs Fable 5.1: Hvilken er bedre for resonnering og vitenskap
Resonneringssammenligningen er mer interessant fordi det ikke er full pott. OpenAIs publiserte evalueringer rapporterer Astra på 97,6 % på FrontierMath Tier 4, 96,0 % på GPQA Diamond og 64,6 % på Terminal-Bench Science 0.1. Fable 5.1 registrerer henholdsvis 87,8 %, 93,7 % og 52,6 % i samme sammenligning.
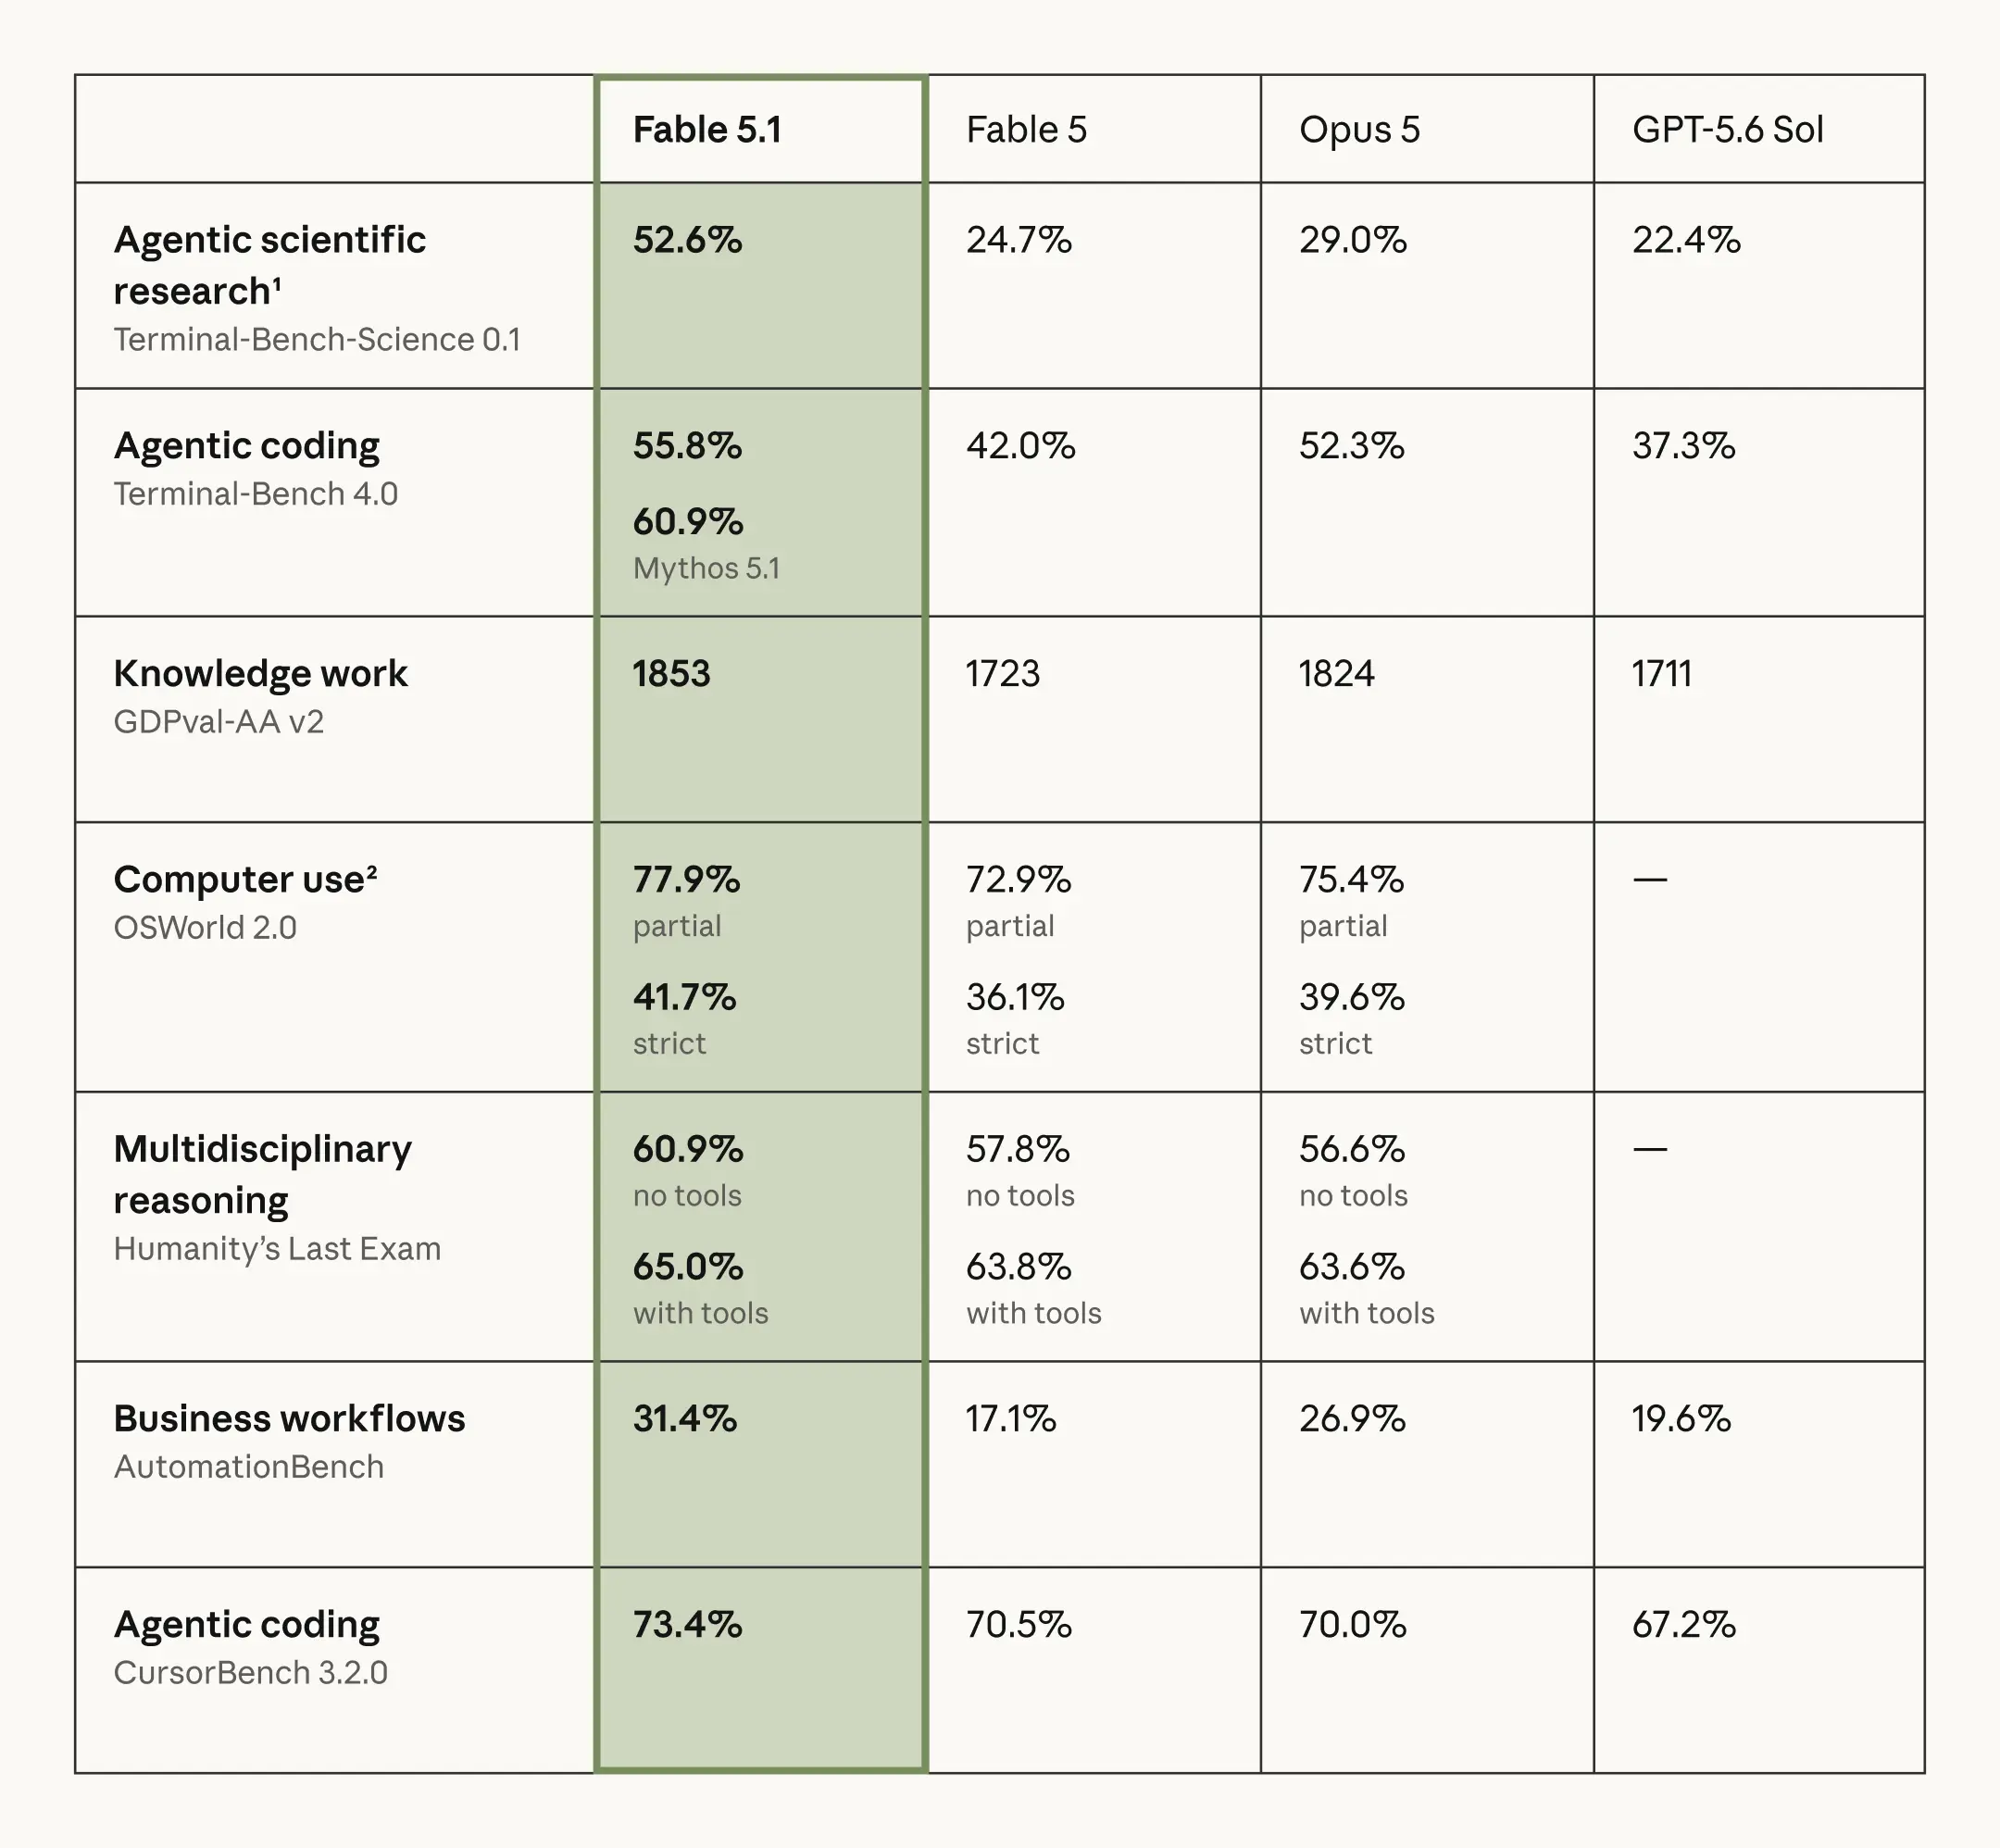
Fable 5.1 snur resultatet på Humanity’s Last Exam med verktøy, og scorer 65,0 % mot Astras 57,2 %. Anthropics offisielle benchmark-tabell rapporterer uavhengig det samme 65,0 %-resultatet for Fable 5.1.
| Resonnering/vitenskap-benchmark | GPT-6 Astra | Claude Fable 5.1 | Vinner |
|---|---|---|---|
| FrontierMath Tier 4 v2 | 97,6% | 87,8% | Astra |
| GPQA Diamond | 96,0% | 93,7% | Astra |
| Terminal-Bench Science 0.1 | 64,6% | 52,6% | Astra |
| Humanity's Last Exam, med verktøy | 57,2% | 65,0% | Fable 5.1 |
| Artificial Analysis Intelligence Index | 61,2 | 65,7 | Fable 5.1 |
Denne forskjellen betyr noe. FrontierMath og Terminal-Bench Science legger vekt på spesialisert matematisk eller vitenskapelig problemløsning, spesielt når resonnering samspiller med verktøy og eksterne miljøer. Humanity’s Last Exam er bredere og tverrfaglig. En praktisk tolkning er at Astra ser sterkere ut på dypt teknisk, verktøy-utført resonnering, mens Fable 5.1 beholder en fordel på bredere frontier-resonnerings-evalueringer.
Kilde: Anthropic official benchmark
Datamaskinbruk og profesjonelt arbeid favoriserer GPT-6 Astra
En direkte Astra-versus-Fable 5.1 OSWorld-sammenligning ville være misvisende. Anthropics benchmark-notat sier at Fable 5.1 bruker forfatternes august 2026-oppgaveutgivelse. Diagrammet rapporterer 77,9 % delvis og 41,7 % strengt, men disse tallene er ikke ekvivalente med OpenAIs 72,6 %-resultat.
| Profesjonell benchmark | GPT-6 Astra | Claude Fable 5.1 | Resultat |
|---|---|---|---|
| AutomationBench | 41,4% | 31,4% | Astra +10,0 p. |
| BenchCAD | 95,9% | 84,3% | Astra +11,6 p. |
| Terminal-Bench Science | 64,6% | 52,6% | Astra +12,0 p. |
OpenAI trener også spesifikt Astra rundt produksjon av dokumenter, regneark og presentasjoner og sier at den er designet for å utføre flerstegs profesjonelle arbeidsflyter snarere enn bare å generere tekstkomponenten. Fable 5.1 er også bygget for langtidsagenter, nettleseroperasjon, research, koding og profesjonelle dokument-arbeidsflyter, men Astra har per nå sterkere publisert evidens for datamaskinformidlet utførelse og artefaktproduksjon.
Vinner for datamaskinbruksagenter og profesjonell automatisering: Astra.
GPT-6 Astra vs Claude Fable 5.1 lang kontekst: 1.05M vs 1M er feil sammenligning
Astra har teknisk det større kontekstvinduet: 1,05 millioner tokens mot Fable 5.1s 1 million. Den 5 % forskjellen vil neppe avgjøre en produksjonsarkitektur. Prising innenfor kontekstvinduet kan det.
OpenAIs prisregel for lang kontekst gjelder når en forespørsel inneholder mer enn 272K input-tokens: input- og cache-satser dobles, mens output-satsen øker med 1,5 ganger for hele forespørselen. Astras effektive satser blir dermed $20 input, $2 cachet input og $75 output per MTok.
Fable 5.1-spesifikasjonen dokumenterer et 1M kontekstvindu med $10 input, $50 output og $0,25 cache-lesinger per MTok. For applikasjoner som rutinemessig laster 300K, 500K eller 900K tokens inn i en forespørsel, forteller den nominelle kontekststørrelsen derfor bare halve historien.
For svært store kontekster har Fable 5.1 en enklere prisstruktur, spesielt når mye av konteksten kan caches.
GPT-6 Astra vs Claude Fable 5.1 prising: Samme overskriftspris, svært ulik agentøkonomi
Til offisielle Standardsatser starter de to modellene i en eksakt uavgjort på ikke-cachet tekstinput og -output.
| Priskomponent | GPT-6 Astra | Claude Fable 5.1 |
|---|---|---|
| Input / MTok | $10,00 | $10,00 |
| Output / MTok | $50,00 | $50,00 |
| 5-min cache-skriving / MTok | $12,50 | $12,50 |
| Cache-lesing / MTok | $1,00 | $0,25 |
| Batch-rabatt input/output | 50% | 50% |
| Langkontekst-tillegg | Over 272K input | Ingen i standard 1M-kontekst |
Det viktige tallet er ikke $10 eller $50. Det er $0,25. Anthropic senket Fable 5.1s cache-lesesats til $0,25 per million tokens, en fjerdedel av Astras standardpris på $1 for cachet input og en åttedel av Astras $2 langkontekst-cache-sats.
Dette kan bety enormt mye for en agent-løkke. En langtidskjørende applikasjon kan gjentatte ganger bære en stor systemprompt, verktøydefinisjoner, repo-kontekst og referansedokumenter over dusinvis av runder. Når det stabile prefikset gjentatte ganger leses fra cache, forsterkes cache-prising på en måte som en én-runds benchmark aldri fanger.
Anthropics arbeidslast-estimat sier at den lavere cache-prisen kan redusere typisk Fable 5.1-arbeidslastkostnad med rundt 25 % og svært agentiske arbeidslaster med opptil cirka 45 %. Dette er leverandørestimater snarere enn universelle garantier, men de viser hvorfor cache-økonomi fortjener sin egen sammenligningsdimensjon.
Gjør det Fable 5.1 billigere?
Ikke automatisk. En modell med dyrere tokens kan likevel gi lavere regning hvis den løser oppgaven med færre tokens, færre forsøk, færre mislykkede verktøykall eller kortere veggklokketid. Derfor er kostnad per vellykket oppgave mer informativ enn pris per million tokens.
Den praktiske prisdommen er delt: Fable 5.1 vinner prislisten for cache-tunge og svært langkontekst-arbeidslaster. Astra kan likevel vinne kostnad per fullført oppgave når dens utførelsesfordel materielt reduserer forsøk, tokenbruk eller kjøretid.
CometAPI-prising snevrer inn beslutningen til arbeidslastkvalitet
Begge modellene er tilgjengelige gjennom CometAPI. GPT-6 Astra API i CometAPI starter på $8 per million input-tokens, mens Claude Fable 5.1 API i CometAPI starter på samme $8 input-sats. Det er 20 % under leverandørenes grunnsats for input.
| API-prising | GPT-6 Astra | Claude Fable 5.1 |
|---|---|---|
| Offisiell input/output | $10 / $50 | $10 / $50 |
| CometAPI input/output | $8 / $40 | $8 / $40 |
| Reduksjon vs offisiell grunn | 20% | 20% |
Dette skaper et nyttig produksjonsoppsett: i stedet for å avgjøre kun ut fra offentlige benchmark-tabeller, kan utviklere evaluere samme arbeidslast mot begge modell-ID-ene via ett API-miljø og sammenligne akseptgrad for resultater, tokenforbruk, latens, verktøyfeil og total forbruk. Priser og faktureringsregler kan endres, så budsjettering i produksjon bør bruke live API-konfigurasjon i stedet for å hardkode verdiene i denne artikkelen.
Verktøybruk og agentdesign: Lik mål, ulik filosofi
Begge modellene er designet for agenter, men API-ene deres eksponerer ulike filosofier. GPT-6 Astra støtter et verktøyrikt Responses API-miljø. OpenAIs støttede verktøysett inkluderer nettsøk, filsøk, bildegenerering, kodefortolker, hostet shell, Apply Patch, datamaskinbruk, MCP og verktøysøk. Konfigurerbar resonneringsinnsats lar en applikasjon bestemme hvor mye compute som skal brukes.
Fable 5.1s resonneringsmodell er annerledes: adaptiv tenkning er alltid aktivert, med innsats brukt til å styre dybde. Anthropic la også til innsats per melding, tur-avgrensede systemmeldinger og lesbare fremdriftsoppdateringer mellom verktøykall, som er spesielt nyttige i lange autonome økter.
GPT-6 Astra føles derfor optimalisert for verktøybredde og ende-til-ende miljøkontroll, mens Fable 5.1 føles optimalisert for vedvarende langhorisont-resonnering og agentkontinuitet. Ingen av arkitekturene er universelt overlegne; orkestreringslaget ditt betyr like mye som selve modellen.
Hvorfor sikkerhet og utrullingsbegrensninger betyr noe for GPT-6 Astra og Claude Fable 5.1
OpenAI beskriver Astra som sin første modell som når selskapets kritiske terskel for cybersikkerhet og ruller ut ekstra beskyttelser rundt høy-kapasitets arbeidsflyter. Den samme kunngjøringen beskriver produksjonsovervåking og avbrytelse av oppgaver når en agent kan overskride sin autoriserte ramme.
Fable 5.1 bruker en annen beskyttelsesarkitektur. Anthropic oppgir at noen cybersikkerhets- og biologiforespørsler identifisert av dets beskyttelser kan rutes til mindre kapable modeller. Det betyr at en produksjonsscore kan reflektere både den underliggende modellen og beskyttelsene rundt den.
Dette er nok en grunn til at kryssleverandør-benchmark-tabeller ikke bør behandles som perfekt kontrollerte laboratorie-sammenligninger. Enterprise-evalueringer bør inkludere avslag, fallback-oppførsel, avbrytelse av oppgaver, revisjonskrav, dataoppbevaring og personvernsstyring, i stedet for å vurdere dem først etter modellvalg.
GPT-6 Astra vs Claude Fable 5.1: Hvilken modell bør du velge?
| Arbeidslast | Anbefalt modell | Hvorfor |
|---|---|---|
| Autonom datamaskinbruksagent | Astra | Sterkere publisert evidens for PC-bruk og profesjonell utførelse |
| Agentbasert terminal/programvareutvikling | Astra | Leder Terminal-Bench, DeepSWE og database-migreringsresultater |
| Vitenskapelige verktøy-arbeidsflyter | Astra | Sterke resultater på FrontierMath, GPQA og Terminal-Bench Science |
| Bred frontier-resonnering | Fable 5.1 | Leder HLE med verktøy og Intelligence Index |
| Langvarig asynkron agent | Fable 5.1 | Designet for agentarbeid med lang horisont og fremdriftsoppdateringer |
| 300K–1M-token-forespørsler | Fable 5.1 | Unngår Astras 272K langkontekst-tillegg i standard prising |
| Tung gjenbruk av prompt-cache | Fable 5.1 | $0,25/MTok offisielle cache-lesinger |
| Dokument-/regneark-/presentasjons-automatisering | Astra | Sterk posisjonering for profesjonelt arbeid og artefakt-generering |
| Stort repo med gjentatt cachet kontekst | Fable 5.1 | Cache-økonomi kan dominere gjentatte agent-løkker |
| Blandede produksjonsarbeidslaster | Test begge | Ulike styrker gjør arbeidslast-ruting mer nyttig enn én universell vinner |
Hvis applikasjonen din ber modellen om å handle, bør Astra vanligvis være den første modellen du tester. Hvis applikasjonen ber modellen om å tenke lenge over en svært stor og gjentatte ganger gjenbrukt kontekst, fortjener Fable 5.1 like mye eller mer oppmerksomhet.
GPT-6 Astra vs Claude Fable 5.1: Hvilken er best totalt sett?
Det finnes ingen ren 10–0. Astra vinner flere av de direkte sammenlignbare leverandørpubliserte radene, med særlig konsistente fordeler innen kodeutførelse, vitenskapelige verktøy, datamaskinbruk og profesjonell automatisering. For utviklere som bygger en agent som må operere programvare snarere enn bare diskutere hva som bør gjøres, er det en betydelig fordel.
Fable 5.1s seire er smalere, men strategisk viktige. Dens 65,0 % på Humanity’s Last Exam og sterkere Intelligence Index-score viser at Astra ikke dominerer generell resonnering ubetinget. Fable 5.1 har også en strukturell prisfordel for cache-tunge agenter og forespørsler som bruker en stor andel av million-token-konteksten.
Det dypere skiftet er at utvalg av frontier-modeller beveger seg bort fra «hvilken chatbot gir det smarteste svaret?» mot «hvilket system fullfører jobben korrekt til lavest totalkostnad?»
Slik sammenligner du dem for din egen applikasjon
En offentlig toppliste bør snevre inn kortlisten din, ikke avgjøre produksjonsbeslutningen. Bygg et fast evalueringssett fra reelle oppgaver. Kjør identisk inputmateriale mot begge modellene, bevar likeverdig verktøytillatelse, og mål ikke bare om sluttsvaret ser bra ut, men om oppgaven faktisk lykkes.
For en agentisk applikasjon er nyttige målinger total oppgavesuksess, menneskelig akseptgrad, verktøykall-feil, forsøk, tid til fullføring, ikke-cachet input, cache-lesinger, output-tokens og total API-kostnad.
En enkel distribusjonsmåling er total API-kostnad ÷ aksepterte fullførte oppgaver.
Det tallet kan snu en benchmark-basert beslutning. En modell som tar mer betalt per token kan være billigere hvis den trenger færre forsøk. En modell med billig caching kan bli dramatisk billigere over en 50-runders agent-løkke. En modell som scorer høyere i isolasjon kan tape når verktøyene dine, henterlaget og reelle akseptkriterier introduseres.
Astra og Fable 5.1 er tilgjengelige gjennom CometAPI; den sterkeste produksjonsstrategien er ikke nødvendigvis å binde seg permanent til én leverandør. Hold modellen konfigurerbar, evaluer begge mot samme akseptkriterier, og rut hver arbeidslast til modellen som faktisk presterer best.
Vanlige spørsmål
Er GPT-6 Astra bedre enn Claude Fable 5.1?
Astra er sterkere på flere direkte sammenlignbare kode-, vitenskaps- og profesjonelt-arbeid-benchmarker, inkludert Terminal-Bench, DeepSWE, FrontierMath og AutomationBench. Fable 5.1 leder på Humanity’s Last Exam med verktøy og Artificial Analysis Intelligence Index. Ingen av modellene vinner alle dimensjoner.
Hvilken modell er bedre for koding?
GPT-6 Astra er den bedre modellen for koding, spesielt for agentbasert koding og utførelse. OpenAIs publiserte sammenligning rapporterer 57,9 % for Astra mot 55,8 % for Fable 5.1 på Terminal-Bench 4.0, med større Astra-fordeler på DeepSWE og database-migreringsevalueringen. Claude Fable 5.1 er fortsatt svært konkurransedyktig for langtids repo-arbeid, men Astra har det sterkere samlede kodegrunnlaget.
Hvilken modell er bedre for lang kontekst?
Claude Fable 5.1 er det bedre valget for langkontekst-arbeidslaster, spesielt for svært store forespørsler og gjentatt bruk av prompt-cache. Begge modellene tilbyr omtrent én million tokens med kontekst, men GPT-6 Astra bruker høyere satser når input overstiger 272K tokens, mens Fable 5.1 opprettholder en enklere prissstruktur og tilbyr vesentlig billigere cache-lesinger.
Hvilken er billigere?
Ingen av modellene er billigere til standard grunnsats—de er uavgjort; Claude Fable 5.1 er billigere for cache-tunge og svært langkontekst-arbeidslaster. Offisiell grunnprising er $10 per million input-tokens og $50 per million output-tokens for begge modellene. Via CometAPI starter både GPT-6 Astra og Fable 5.1 for tiden på $8 per million input-tokens og $40 per million output-tokens. Fable 5.1 får kostnadsfordelen når cache-lesinger eller Astras langkontekst-tillegg blir vesentlige.
Bør utviklere bare bruke én av dem?
Ikke nødvendigvis. Styrkene deres er komplementære nok til at en multi-modell-evaluering eller rutingsstrategi kan overgå å velge én modell for hver forespørsel. Test reelle produksjonsarbeidslaster og sammenlign kostnad per akseptert fullført oppgave i stedet for å stole på én enkelt benchmark-score.