
Kort oppsummert
Grok 4.7 og Xiaomi MiMo‑V2.6 kom med bare én dags mellomrom, men de representerer to ulike tilnærminger til avansert AI. Grok 4.7 vektlegger en proprietær, tett integrert agentstakk for koding og profesjonelt kunnskapsarbeid, mens MiMo‑V2.6‑Pro kombinerer åpne vekter, et større kontekstvindu, innebygd multimodal forståelse og aggressiv API‑prising.
SpaceXAI posisjonerer Grok 4.7 som sin toppmoderne modell for koding, agentiske oppgaver og kunnskapsarbeid med et kontekstvindu på 500K tokens og konfigurerbar resonneringsinnsats.
Xiaomi posisjonerer MiMo‑V2.6‑Pro som en 1M‑kontekst multimodal flaggskipmodell med åpne vekter og støtte for tekst-, bilde-, lyd- og video‑forståelse.
Kort sagt: Grok 4.7 er et mer vertikalt integrert, administrert agentprodukt; MiMo‑V2.6‑Pro gir utviklere mer kontroll over utrulling og langt lavere rå token‑priser. Det beste valget avhenger av arbeidslasten heller enn én benchmarkscore.
Viktige poeng
- Grok 4.7 er bygget for langhorisont‑koding og profesjonelle agenter. I SpaceXAI sin leverandørpubliserte evaluering oppnår den 46,3 % på CursorBench 4.0, 71,0 % på DeepSWE v1.1 ved høy innsats, og 1 657 på AA Briefcase v1.1.
- MiMo‑V2.6‑Pro er uvanlig konkurransedyktig for en åpen modell. Xiaomi publiserer modellvektene og rapporterer resultater nær proprietære toppsystemer på flere kode‑ og agentbenchmarker, men tverrleverandør‑poeng er ikke direkte utskiftbare.
- MiMo har fordel i kontekst og multimodalitet. MiMo‑V2.6‑Pro støtter et kontekstvindu på 1M tokens og tekst-, bilde-, lyd- og video‑forståelse, mot Grok 4.7s 500K kontekst med tekst og bildeinput.
- MiMo er vesentlig billigere på rå API‑tokens. Offisiell standardprising er $0,435/$0,87 per million ikke‑bufrede input/output‑tokens for MiMo‑V2.6‑Pro versus $2/$6 for Grok 4.7.
- Utrullingsarkitektur er det avgjørende kompromisset. Grok tilbyr en sterkere førsteparts, hostet verktøystakk; MiMo sine åpne vekter muliggjør privat utrulling, tilpasset serving og dypere infrastrukturkontroll.
Grok 4.7 vs MiMo‑V2.6‑Pro i et blikk
| Dimensjon | Grok 4.7 | MiMo‑V2.6‑Pro |
|---|---|---|
| Lansering | 21. september 2026 | 22. september 2026 |
| Tilgang og kontroll | Proprietær API og administrert agent‑økosystem | Åpne vekter, selvhostingsmulighet og API‑tilgang |
| Ytelsesbevis | Leverandør‑rapportert styrke i koding og langvarige agentoppgaver; valider på samme oppgavesett | Leverandør‑rapportert styrke på tvers av resonnering, koding og multimodalitet; valider på samme oppgavesett |
| Særpregede styrker | Førstepartsverktøy, administrerte arbeidsflyter og web/X‑tilkoblede agenter | Utrullingskontroll, 1M‑kontekst og tekst/bilde/lyd/video‑forståelse |
| Kontekstvindu | 500K tokens | 1M tokens |
| Input‑modaliteter | Tekst og bilde | Tekst, bilde, lyd og video |
| Offisiell standard u/bufret input/output per 1M tokens | $2 / $6 | $0,435 / $0,87 |
| Resonnering | Lav til xHigh | Dyp resonnering |
| Åpne vekter | Nei | Nei |
| Best fit | Administrerte kode‑ og agent‑arbeidsflyter | Privat utrulling, multimodal input og lavere rå token‑kost |
Hva er Grok 4.7?
SpaceXAI lanserte offisielt Grok 4.7 den 21. september 2026 som sin mest kapable modell for koding og kunnskapsarbeid. Lanseringen er viktig fordi forhåndsrapportering blandet bekreftede fakta med lekkede arkitekturpåstander. Den endelige lanseringsdokumentasjonen publiserer ikke total- eller aktive parameterantall, så forhåndsanslag bør ikke behandles som offisielle spesifikasjoner.
Ifølge den offisielle lanseringsposten bruker Grok 4.7 en ny, større basemodell enn Grok 4.6 og ble trent med en lengre forsterkningslærings‑runde vektet mot problemer som tar mange timer å fullføre.
Modellene optimaliserer ulike lag i stakken. Grok 4.7 tilbyr et rikere administrert miljø rundt modellen; MiMo‑V2.6‑Pro eksponerer mer av modellen og utrullingslaget for utviklere.
For forespørsler over 200K tokens i prompten, anvender SpaceXAI høyere‑kontekst prising. Den publiserte tieren er $4 per million input‑tokens, $1 per million bufrede input‑tokens og $12 per million output‑tokens.
Endringer i Grok 4.7
Den mest meningsfulle endringen er treningsmålet, ikke bare et høyere benchmark‑tall. SpaceXAI sier at blandingen i forsterkningslæringen ble flyttet mot lengre, fler‑timers oppgaver, mens modellen ble trent til å verifisere eget arbeid mer nøye og forstå Grok Bot‑harnessen nativt. Den kombinasjonen retter seg mot reell agentutførelse: å holde på tilstand, bruke verktøy, sjekke mellomresultater og holde koherens gjennom lange oppgaveforløp.
Grok 4.7‑ytelse
| SpaceXAI‑publisert benchmark | Grok 4.7 | Grok 4.6 | GPT‑5.6 Sol | Fable 5.1 |
|---|---|---|---|---|
| CursorBench 4.0 | 46,3 % | 40,4 % | 41,7 % | 51,8 % |
| DeepSWE v1.1 | 71,0 %* | 65,2 % | 72,7 % | 70,0 % |
| EEBench | 64,0 % | 53,0 % | 39,4 % | 56,4 % |
| AA Briefcase v1.1 | 1 657 | 1 546 | 1 487 | 1 678 |
| Terminal‑Bench 4.0 | 38,0 % | 20,3 % | 37,3 % | 57,9 % |
| Harvey Legal Agent Benchmark | 19,6 % | 15,8 % | 2,5 % | 6,7 % |
| HealthBench Professional | 56,7 % | 48,5 % | 60,5 % | 62,1 % |
* SpaceXAI markerer Grok 4.7 DeepSWE som høy innsats. Dette er leverandør‑publiserte evalueringer og bør tolkes i lys av dokumentert harness og resonneringsinnstillinger.
SpaceXAI presenterer lanseringsdiagrammene som web‑native innhold på den offisielle kunngjøringssiden; tabellen over bevarer de oppgitte benchmarkverdiene uten å erstatte med et nytegnet diagram.
Hva er Xiaomi MiMo‑V2.6?
Xiaomi lanserte og open‑sourcet offisielt MiMo‑V2.6 den 22. september 2026. Familien inkluderer MiMo‑V2.6‑Pro og MiMo‑V2.6‑Flash, med en Pro‑UltraSpeed serving‑opsjon for latensfølsomme arbeidslaster. For en direkte sammenligning med Grok 4.7 er MiMo‑V2.6‑Pro det passende flaggskipet.
Xiaomis offisielle materiale dokumenterer separat åpne vekter, innebygd multimodal input og API‑prising. Denne kombinasjonen gjør MiMo‑V2.6 relevant utover benchmark‑topplister.
MiMo‑V2.6 vs MiMo‑V2.5: Hva ble forbedret?
Arkitekturhøydepunktet er ikke bare et større sjekkpunkt. Xiaomis offentlige utgivelse fokuserer tungt på ettertrening og Live RL. Ifølge de offisielle utgivelsesnotatene fullførte Pro og Flash hver 30 forsterkningslæringssteg og genererte sammen omtrent 750 000 trajektorier; de oppgitte RL‑fasekostnadene var omtrent $2,62 millioner for Pro og $850 000 for Flash.
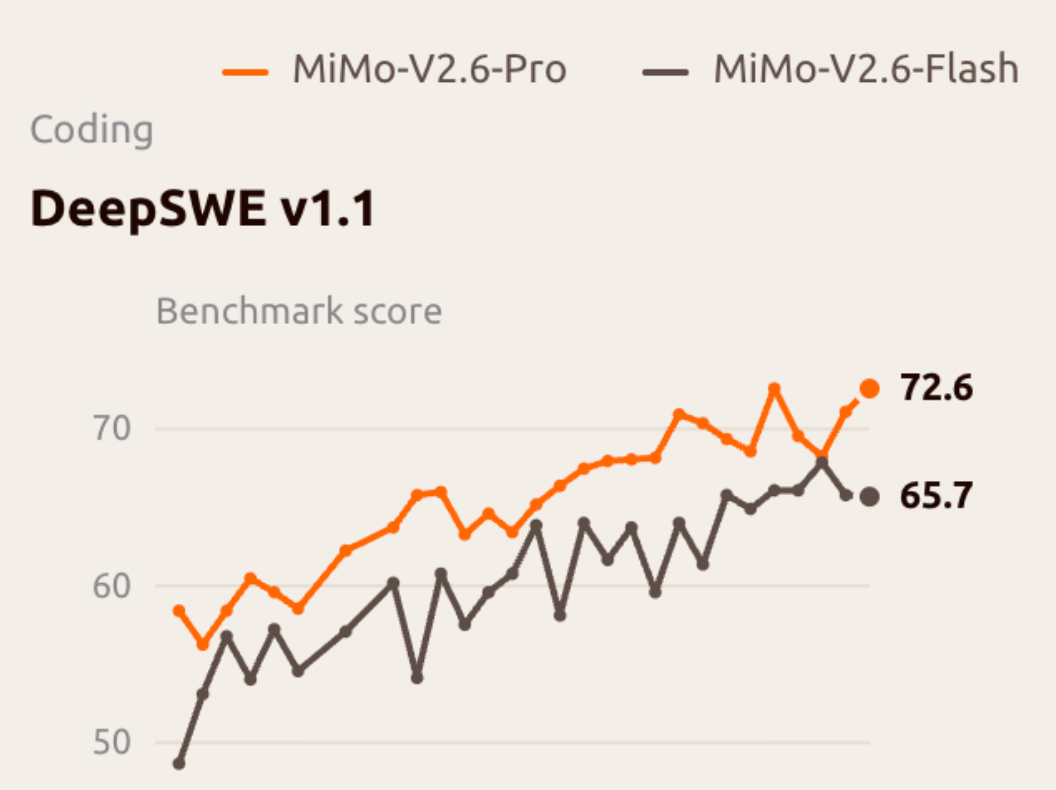
Ett benchmark‑detalj krever nøye håndtering: Xiaomis Live RL‑kurve viser MiMo‑V2.6‑Pro på omtrent 72,6 på DeepSWE v1.1 under treningsløpet, mens den endelige sammenligningstabellen rapporterer 71,9. Disse tallene refererer til ulike evalueringskontekster og bør ikke flettes sammen uten videre.
Grok 4.7 vs MiMo‑V2.6‑Pro: Benchmark‑sammenligning
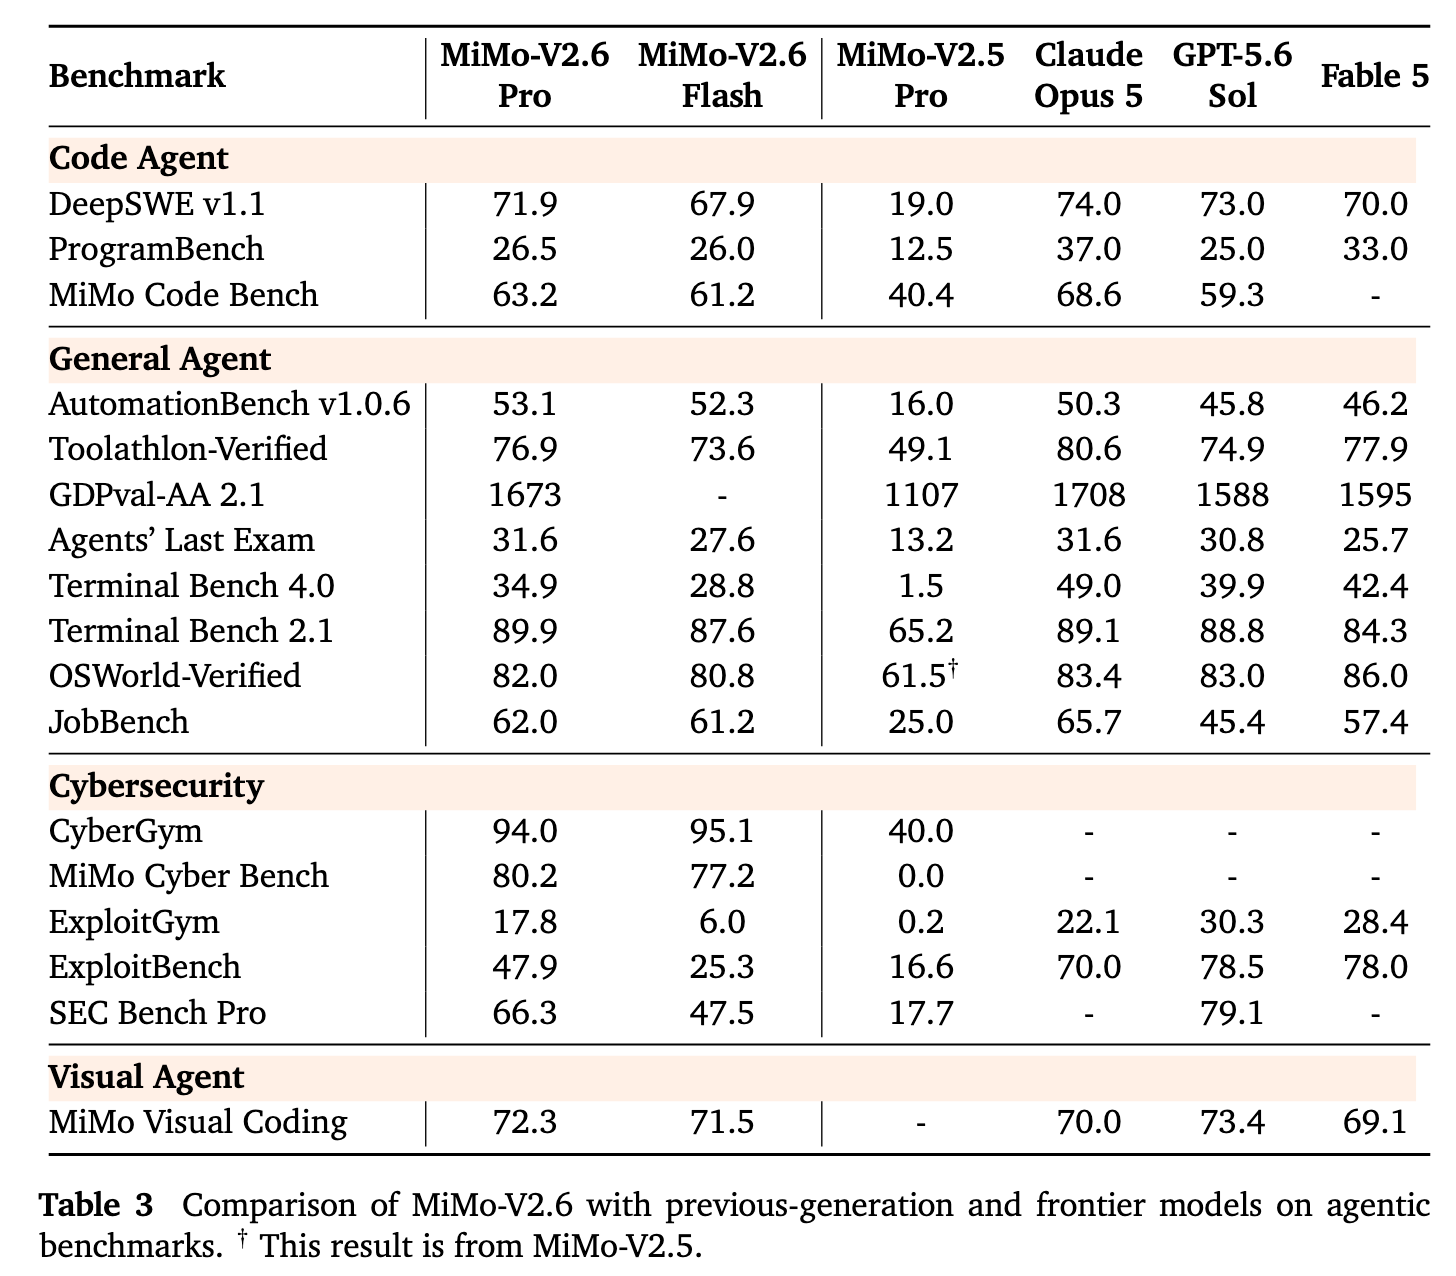
Direkte benchmark‑sammenligninger krever forsiktighet. Leverandører bruker ikke alltid identiske oppsett, resonneringsbudsjetter, sjekkpunkter eller verktøykonfigurasjoner. Selv når benchmark‑navnene er like, kan små forskjeller i score være mindre meningsfulle enn de ser ut. Den tryggeste sammenligningen er å skille reelt allierte målinger fra indikative bevis.
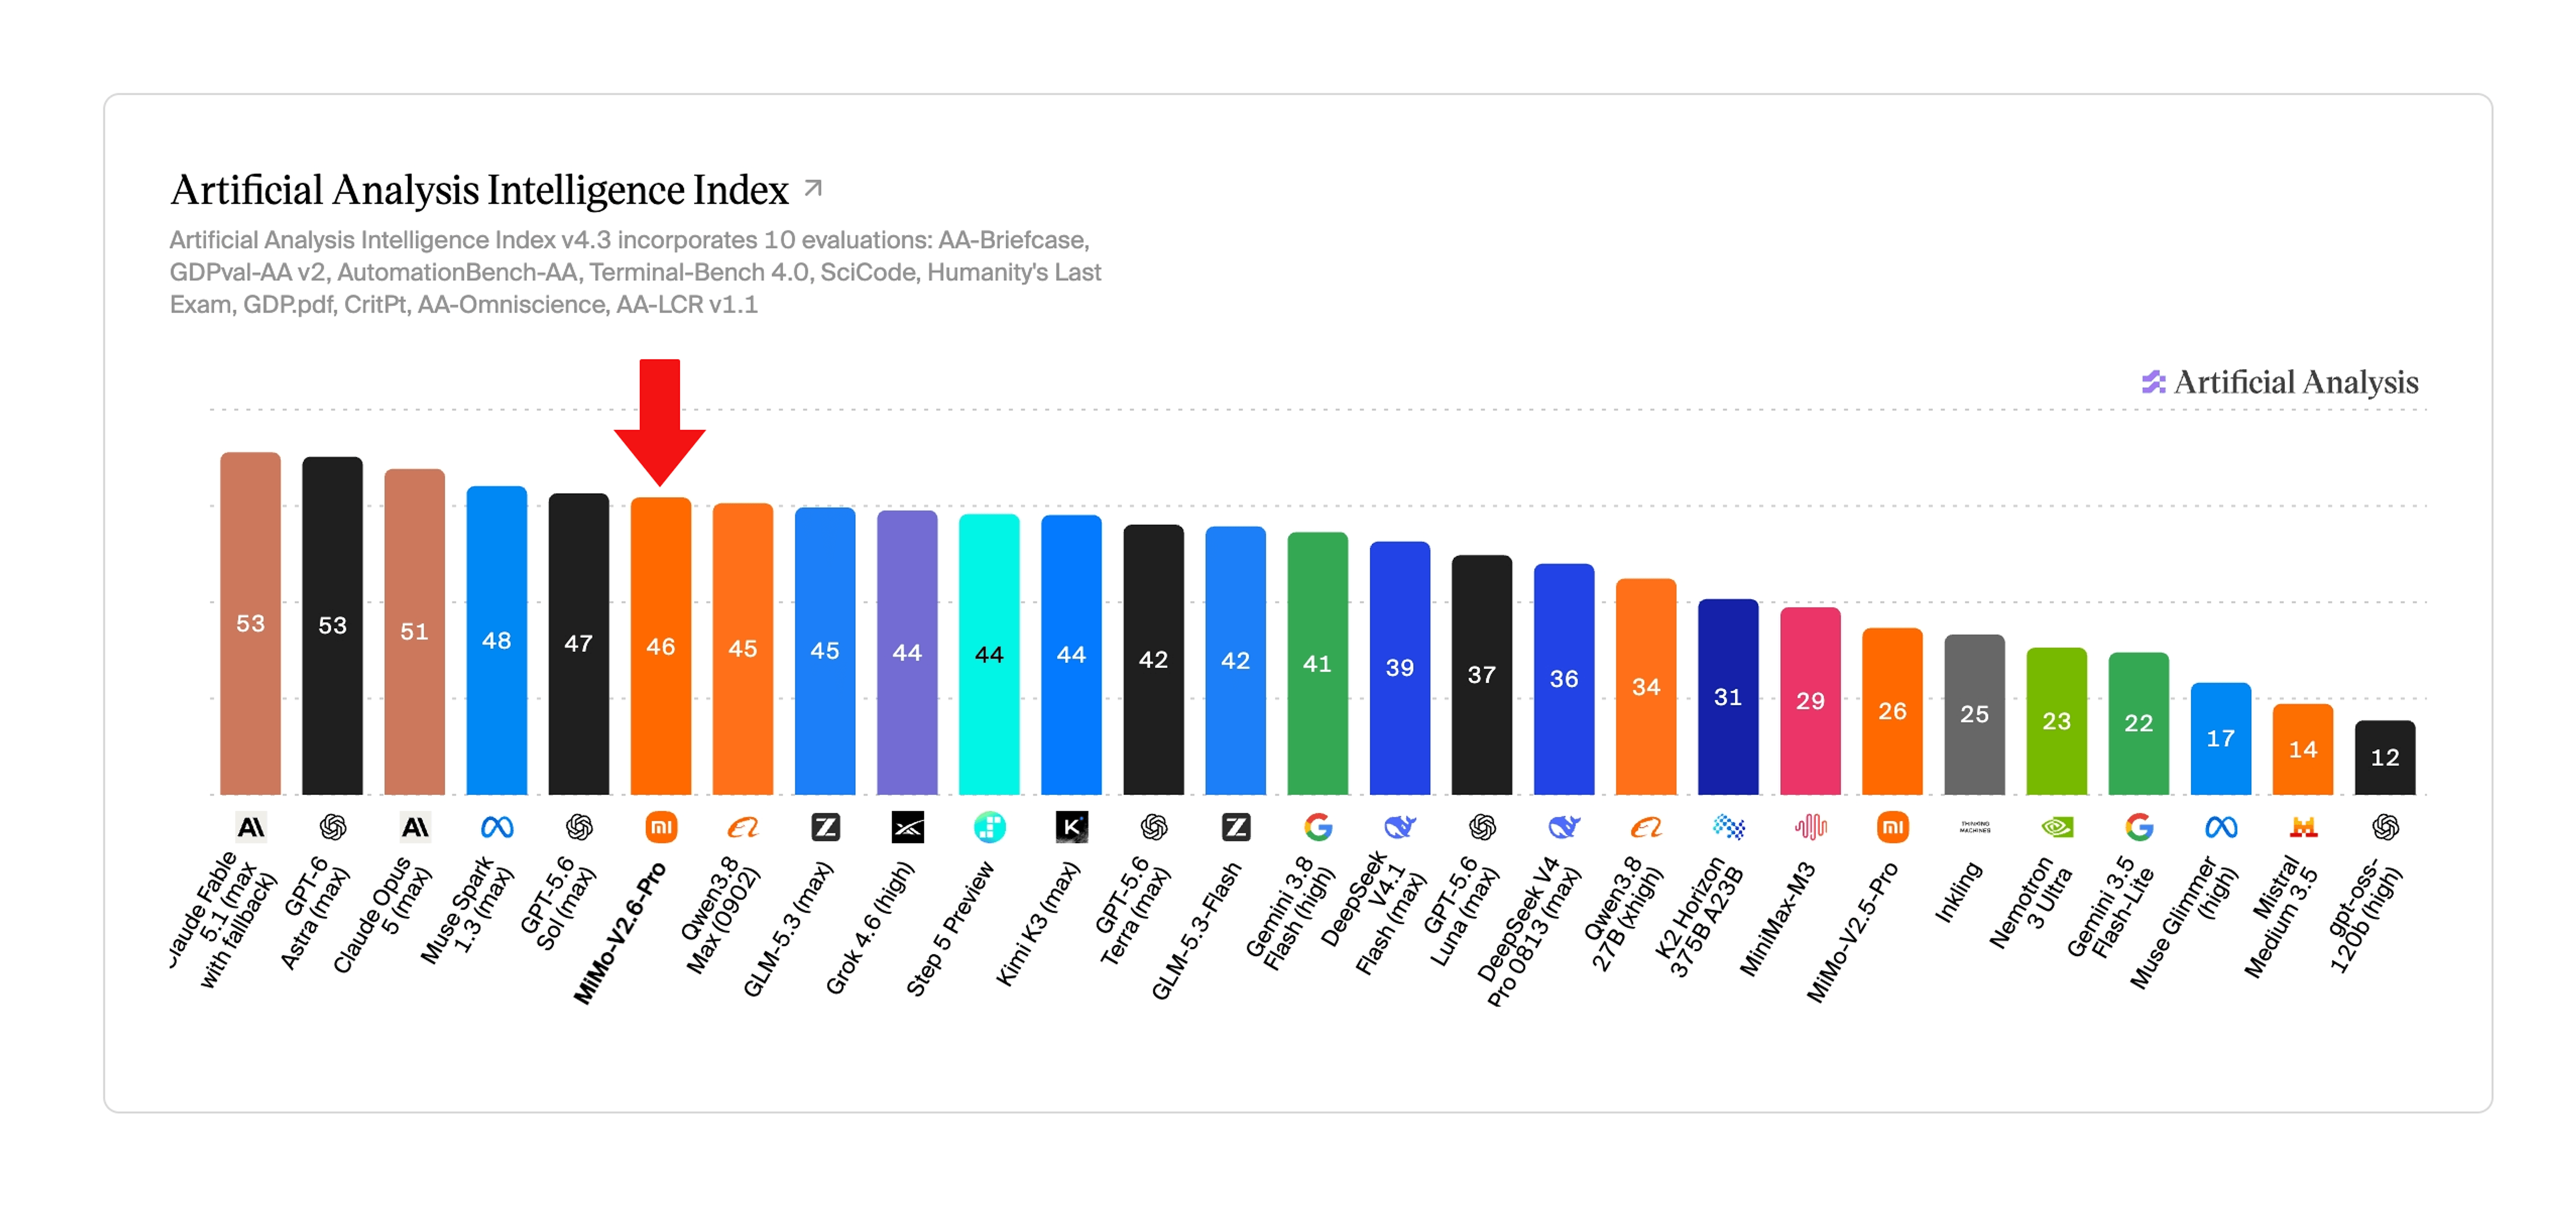
Artificial Analysis Intelligence Index
Xiaomi rapporterer 46,32 for MiMo‑V2.6‑Pro på Artificial Analysis komposittindeks. Enhver Grok‑sammenligning bør knyttes til nøyaktig samme Artificial Analysis‑snapshot og modellkonfigurasjon; en avrundet likhets‑påstand bør ikke presenteres uten den kilden.
Kode‑ og agentytelse
| Benchmark | Grok 4.7 — SpaceXAI | MiMo‑V2.6‑Pro — Xiaomi | Tolkning |
|---|---|---|---|
| DeepSWE v1.1 | 71,0* | 71,9** | Nært numerisk; publiserte kjøringer og innstillinger skiller seg |
| GDPval‑AA | Se SpaceXAI‑diagram | 1 673 | Kun indikativt med mindre oppsett er alliert |
| AA Briefcase | 1 657 | Se Xiaomi‑diagram | Bruk leverandør‑rapporterte verdier med kildekontekst |
| Terminal‑Bench 4.0 | 38,0 | 34,9 | Liknende retning; oppsett betyr mye |
| Kontekstvindu | 500K | 1M | MiMo støtter mer arbeidskontekst |
* SpaceXAI rapporterer Grok 4.7 DeepSWE ved høy innsats. ** Xiaomis endelige sammenligningstabell rapporterer 71,9; deres Live RL‑treningskurve når omtrent 72,6. Disse tallene kommer fra ulike evalueringskontekster.
Passform for kode‑arbeidsflyt
For koding avhenger forskjellen av om “koding” betyr rå problemløsning i repositorier eller en komplett administrert kode‑agentopplevelse. På DeepSWE v1.1 er de publiserte tallene så nære at et gap under ett poeng ikke bør avgjøre produksjonsvalg alene.
Grok 4.7s fordel er høyere i stakken. Den er integrert med Grok Build, tilgjengelig i Cursor, designet for å forstå Grok Bot‑harnessen, og paret med førsteparts kode‑eksekvering og søkeverktøy.
MiMo‑V2.6‑Pros fordel er lavere i stakken. Åpne vekter gjør det praktisk å bygge en privat kodeassistent, tilpasse serving, håndheve dataresidens‑kontroller eller eksperimentere med en proprietær agent‑harness.
For team som velger mellom dem, vil en produksjons A/B‑test på representative repositorier være mer informativ enn én offentlig kodebenchmark.
Grok 4.7 vs MiMo‑V2.6‑Pro: Forskjeller i multimodal kapasitet
Dette er en av de tydeligste forskjellene. Grok 4.7 aksepterer tekst‑ og bildeinput og produserer tekst. Den bredere Grok‑plattformen tilbyr separate medieprodukter, men disse bør ikke forveksles med modalitetsoverflaten til selve modellen grok‑4.7.
MiMo‑V2.6‑Pro støtter tekst, bilde, lyd og video‑forståelse. Kombinert med et kontekstvindu på 1M tokens utvider dette spekteret av arbeidsflyter som kan håndteres i én modellkontekst.
- Skjermbilde‑ og kodeanalyse i samme oppgave
- Videoforståelse med tilhørende instruksjoner
- Langform lydprosessering
- Databruksagenter med visuell tilbakemelding
- Multimodale forskningsassistenter
- Storskala multimodal ekstraksjon og kvalitetssikring
Grok 4.7 vs MiMo‑V2.6‑Pro: API‑prissammenligning
| Offisiell API‑prising | Grok 4.7 | MiMo‑V2.6‑Pro |
|---|---|---|
| Input / 1M tokens | $2,00 | $0,435 |
| Bufret input / 1M | $0,50 | $0,0036 |
| Output / 1M | $6,00 | $0,87 |
| Lang‑kontekst tillegg | Ja, over 200K prompt‑tokens | Ingen sammenlignbar standardtier publisert |
| Åpne vekter/selvhost‑opsjon | Nei | Ja |
Til listepris er MiMo‑V2.6‑Pro flere ganger billigere på både normal input og generert output, med en spesielt stor forskjell for bufret kontekst. Det kan materiellt påvirke økonomien i agenter som gjentatte ganger prosesserer repositorier, lange dokumenter eller vedvarende kontekst.
Viktig prisnotat: Grok 4.7s 500K kontekstvindu betyr ikke at hele konteksten faktureres til standard sats. Forespørsler over 200K prompt‑tokens belastes etter lang‑kontekst‑tier.
Per 24. september 2026 lister CometAPI Grok 4.7 til $1,60 input og $4,80 output per 1M tokens, versus de offisielle $2,00 og $6,00. Den lister MiMo‑V2.6‑Pro til $0,348 input og $0,696 output, versus de offisielle $0,435 og $0,87. Disse listede standardratene er 20 % under tilsvarende offisielle rater. Priser og kvalifisering kan endres; bekreft de levende modellsidene før budsjettering.
Tokenpris er ikke identisk med kostnad per fullført oppgave. Resonneringsmodeller kan konsumere ulike mengder tokens, bruke ulike antall verktøykall og kreve ulike retry‑rater. Produksjonsevaluering bør derfor spore kostnad per fullført oppgave, latens og suksessrate sammen.
Grok 4.7 vs MiMo‑V2.6‑Pro: Tilgang og tilgjengelighet
Tilgangsforskjellen er enkel: Grok 4.7 er tilgjengelig via API og administrerte Grok‑arbeidsflyter, mens modellvektene ikke tilbys for selvhosting. MiMo‑V2.6‑Pro er tilgjengelig via API og som åpne vekter, noe som gir team en ekstra selvhostet rute.
Tilgjengelighet er separat fra lisensiering eller utrullingsfleksibilitet. Per 24. september 2026 har begge modellene også levende CometAPI‑katalogsider. Team bør bekrefte endepunkt, region, raterestriksjoner og konto‑kvalifisering før produksjonsutrulling; en listet modell garanterer ikke identisk tilgjengelighet eller tjenestenivå for hver konto.
| Tilgjengelighetsspørsmål | Grok 4.7 | MiMo‑V2.6‑Pro |
|---|---|---|
| Offisiell API | Tilgjengelig via xAI | Tilgjengelig via Xiaomi MiMo |
| CometAPI‑katalog | Listet som tilgjengelig | Listet som tilgjengelig |
| Selvhostede vekter | Ikke tilgjengelig | Åpen‑vekt‑opsjon |
| Operasjonell sjekk | Bekreft kontotilgang, region, raterestriksjoner og verktøytilgjengelighet | Bekreft kontotilgang, endepunkt‑beredskap og krav for selvhosting |
Åpne vekter og proprietær tilgang
At MiMo‑V2.6‑Pro er åpen‑vekt endrer sammenligningen mer enn et ettpoengs benchmark‑gap. Det skaper muligheter for privat utrulling, tuning av inferensmotor, tilpasset ettertrening, dataresidens‑kontroller og dypere infrastrukturintegrasjon.
Grok 4.7 tar det motsatte kompromisset: mindre kontroll over modellens indre til gjengjeld for en administrert, kontinuerlig operert tjeneste og et tett integrert førstepartsøkosystem. For mange organisasjoner vil styring og infrastrukturkrav avgjøre kortlisten før benchmark‑ytelse gjør det.
Slik bruker du Grok 4.7 og MiMo V2.6 APIer i CometAPI
Utviklere kan få tilgang til Grok 4.7 API i CometAPI via en forent API‑arbeidsflyt, som reduserer behovet for å vedlikeholde separate leverandørspesifikke integrasjoner.
For team som benchmarker flere toppmodeller er et forent API‑lag spesielt nyttig fordi de samme produksjonspromptene, testoppsettet, tokenregnskapet og applikasjonskoden kan kjøres på tvers av modeller med færre integrasjonsvariabler.
CometAPI lister nå MiMo‑V2.6‑Pro som tilgjengelig, med API‑tilgjengelighet bekreftet 22. september 2026. Sjekk levende katalog og kontotilgang før produksjonsbruk.
Med begge modellsidene nå listet som tilgjengelige kan en applikasjonsnivå A/B‑test holde prompt, verktøy, resonneringsinnstillinger og suksesskriterier så konsistente som mulig, og deretter sammenligne oppgavefullføring, latens, tokenbruk og feilmønstre.
Grok 4.7 vs MiMo‑V2.6‑Pro: Modellpassform etter brukstilfelle
| Krav | Modellpassform / evalueringsveiledning |
|---|---|
| Førsteparts web‑ og X‑søk | Grok 4.7 |
| Administrerte langvarige agenter | Grok 4.7 |
| Grok Build / Cursor‑arbeidsflyter | Grok 4.7 |
| 1M‑token kontekst | MiMo‑V2.6‑Pro |
| Innebygd lyd/video‑forståelse | MiMo‑V2.6‑Pro |
| Åpne vekter, selvhosting og modellkontroll | MiMo‑V2.6‑Pro |
| Laveste rå API‑token‑kost | MiMo‑V2.6‑Pro |
| Repositoriekoding | Benchmark begge på representative repositorier |
| Profesjonelle kunnskapsagenter | Benchmark begge på produksjonsoppgaver |
Beslutningen bør derfor rammes inn rundt arbeidslastarkitektur. Grok 4.7 er designet for å gjøre en administrert agentstakk mer kapabel; MiMo‑V2.6‑Pro er designet for å gjøre avansert intelligens billigere, mer multimodal og mer kontrollerbar.
Hvilken bør du velge?
Velg Grok 4.7 hvis du vil ha en administrert agentopplevelse med førsteparts web‑ og X‑søk, innebygd kodeeksekvering og mindre infrastruktur å drifte. Det er det mer praktiske alternativet for team som verdsetter en integrert verktøystakk og langvarige profesjonelle eller kode‑arbeidsflyter.
Velg MiMo‑V2.6‑Pro hvis du trenger åpne vekter, privat utrulling, et 1M‑token kontekstvindu, innebygd lyd‑ og video‑forståelse eller vesentlig lavere rå API‑prising. Det er det sterkere alternativet når utrullingskontroll, multimodal dekning og kostnadseffektivitet er de primære begrensningene.
Hvis valget fortsatt er uklart, kjør begge modellene på de samme representative oppgavene med identiske prompt, verktøy, resonneringsbudsjetter, tidsfrister og retry‑policyer. Velg modellen som leverer best kombinasjon av fullføringsrate, latens, totalkostnad per vellykket oppgave og behov for menneskelig gjennomgang.
Konklusjon
Grok 4.7 vs MiMo V2.6 er avslørende fordi rå intelligens ikke lenger er den eneste meningsfulle differensiatoren. Begge modellene befinner seg i et liknende høy‑kapabilitetsbånd i dagens offentlige evalueringer, men produkstrategiene deres divergerer skarpt.
Grok 4.7 kombinerer et 500K kontekstvindu, konfigurerbar resonnering, sterk opplæring for langhorisont‑agenter og en moden førsteparts søke‑ og eksekveringsstakk. MiMo‑V2.6‑Pro kombinerer et 1M kontekstvindu, innebygde multimodale input, åpne vekter og API‑prising langt under mange proprietære toppsystemer.
For utviklere er det praktiske spørsmålet derfor mindre “hvilken benchmarkscore er høyere?” og mer “hvor skal intelligensen bo?” Et administrert agentøkosystem og en åpen, tilpassbar modellstakk løser ulike operasjonelle problemer. Riktig valg er det som best matcher produksjonsarbeidslast, infrastrukturbegrensninger og kostnadsmodell.
Vanlige spørsmål
Er Grok 4.7 en modell med 2,1 billioner parametere?
Et cirka 2,1T‑tall sirkulerte før lansering, men den endelige SpaceXAI Grok 4.7‑dokumentasjonen publiserer ikke total‑ eller aktive parameterantall. Den bekreftede uttalelsen er at Grok 4.7 bruker en større basemodell enn Grok 4.6.
Er MiMo‑V2.6 åpen kildekode?
Xiaomi lanserte MiMo‑V2.6 som en åpen modellsuite med nedlastbare vekter og tilhørende forskningsressurser. I produksjonsplanlegging bør team likevel gjennomgå nøyaktig modelllisens og redistribusjonsvilkår for tiltenkt bruk.
Hvor mye koster Grok 4.7 vs MiMo‑V2.6‑Pro per fullført agentoppgave?
Normaliser oppgavesett, prompt, verktøytillatelser, retry‑policy og suksesskriterier. Spor total input, bufret input, resonnerings‑ og output‑tokens, verktøykall, latens, retries og menneskelig gjennomgangstid. Rå tokenpris er bare én komponent av kostnad per fullført oppgave.
Hvor pålitelige er benchmark‑sammenligninger for Grok 4.7 vs MiMo‑V2.6‑Pro?
Bruk samme repositorium eller oppgavesett, agent‑harness, verktøy, resonneringsbudsjett, tidsfrist, retry‑policy og scoringsrubrikk. Rapporter konfidensintervall eller variasjon over gjentatte kjøringer, og hold leverandør‑publiserte tall adskilt fra interne resultater.
Tar Grok 4.7 høyere betalt for lang‑kontekst‑prompt?
SpaceXAI dokumenterer høyere satser når prompt‑tokens overstiger 200K. Fordi høyere tier gjelder for forespørselen, bør team som bruker store repositorier eller vedvarende agentkontekst modellere terskelen eksplisitt.