
TLDR Lekkasjer fra benchmarker og skjulte Arena.ai-tester i midten av september 2026 peker på at Googles ikke-utgitte Gemini 4 Pro er den nye frontlederen, foran GPT-6 Astra og Claude Fable 5.1 innen programvareingeniørfag, agentiske oppgaver, kunnskapsarbeid, resonnering og multimodale benchmarker.
Hovedpunkter
- Gemini 4 Pro leder i lekkede evalueringer på DeepSWE v1.1 (88.7%), GDPval-AA v2 (2064 Elo), Terminal-bench 2.1 (95.3%), OSWorld-2.0 (86.8%) og flere andre agentiske/resonnerings-suiter.
- Den underbyr GPT-6 Astra ($12/$60) og Claude Fable 5.1 ($10/$50) på listepris, samtidig som den matcher eller overgår deres 1M-klasse kontekstvinduer.
- Skjult testing på Arena.ai under plassholdernavn (f.eks. gemini-3.8-flash) har levert fremragende SVG-, Three.js- og agentiske kodedemoer.
- RSI (rekursiv selvforbedring)-rykter sirkulerer, men mangler offentlig bevis på lukket-løkke, autonom modellforbedring for selve Gemini 4.
- Google har bekreftet tung investering i en større Gemini 4-basemodell; offentlig lanseringstidspunkt er fortsatt uoffisielt.
- Plattformar som CometAPI aggregerer allerede Gemini, GPT-6 Astra, Claude Fable/Opus og hundrevis av andre modeller bak ett OpenAI-kompatibelt endepunkt til konkurransedyktige priser—ideelt for benchmarking av frontlinjen når den lanseres.
Hva vet vi om Gemini 4? (lekkasjer, kilder og verifisert kontekst)
Per 20. september 2026 har Gemini 4 Pro ikke fått en offisiell Google-kunngjøring, modellkort eller offentlig API-endepunkt. Alt utover Googles tidligere uttalelser om investering i en “større Gemini 4-basemodell” (resultatpresentasjon juli 2026) kommer fra fellesskapslekkasjer, Arena.ai-blindtester og sirkulerende benchmark-tabeller.
Viktige kilder og påstander inkluderer:
- Lekkasjen fra Pankaj Kumar og påfølgende innlegg (tidlig til midten av september) refererte til et internt Pro-sjekkpunkt med forventet offentlig utgivelse i oktober og en mulig Flash-Lite-variant tidligere.
- Flere utviklere rapporterte å ha hentet en høyytelsesmodell merket “gemini-3.8-flash” (eller lignende plassholdere) på Arena.ai. Utdata inkluderte kompleks SVG-generering (f.eks. pelikan på en sykkel, mekaniske sommerfugler i Three.js), lange ikke-repeterende JSON-genereringer og sterk agentisk atferd. Noen brukere hevdet backend-detaljer som kontekst på flere millioner token, 256k utgangstak, minne på tvers av økter og innebygde verktøy-/internettkapabiliteter.
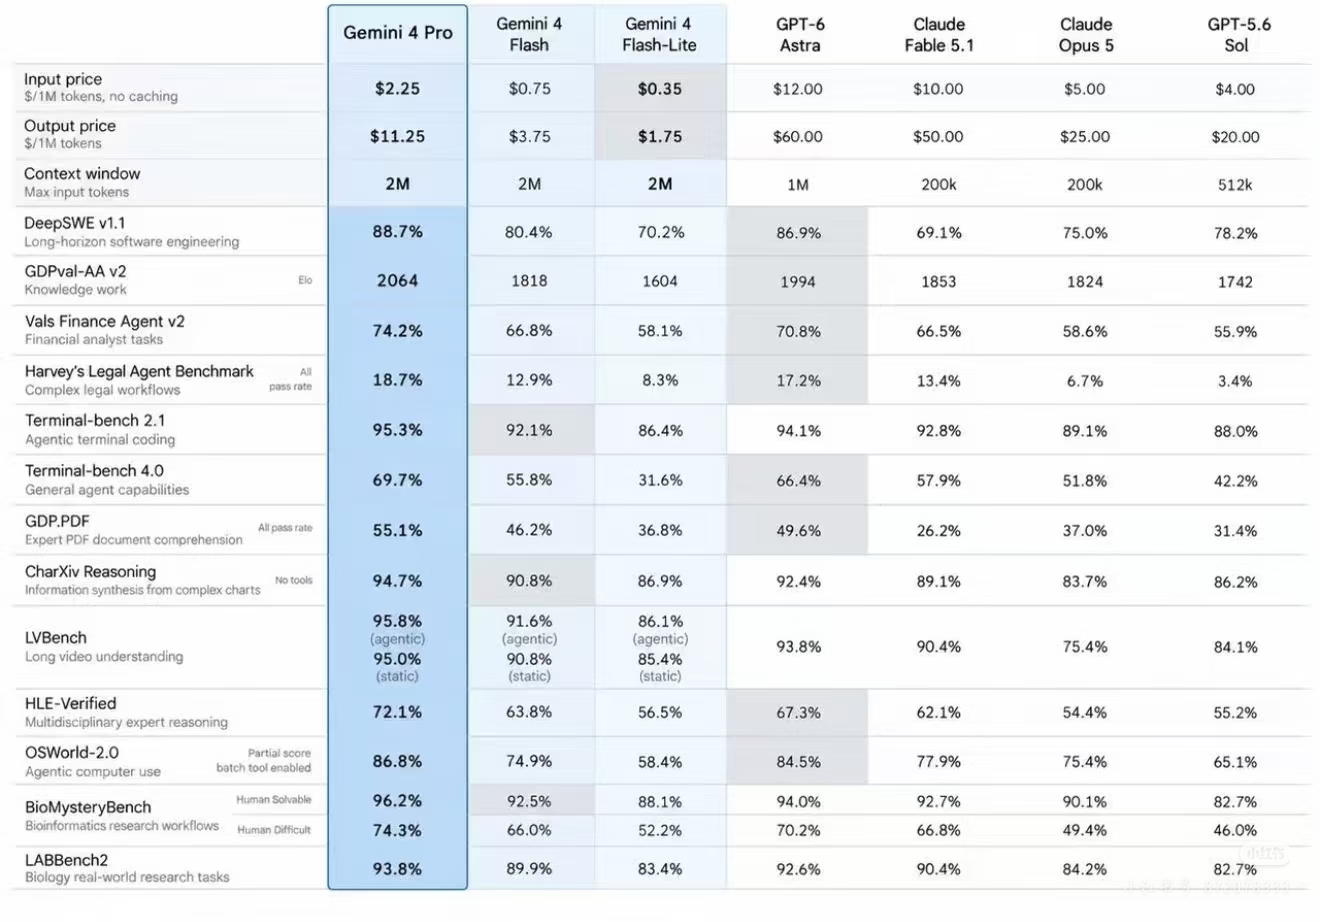
- En mye delt sammenligningstabell viser Gemini 4 Pro opp mot Gemini 4 Flash, Gemini 4 Flash-Lite, GPT-6 Astra, Claude Fable 5.1, Claude Opus 5 og GPT-5.6 Sol.
- Google har ikke bekreftet Arena-testene eller tabellen. Historisk mønster viser at selskapet ofte kjører skjulte evalueringer på offentlige plattformer uker før formelle lanseringer.
Kontekstvindu
Den lekkede tabellen viser 2M maks input-token for Gemini 4-familien—dobbelt så mye som 1M til GPT-6 Astra og langt over 200k for Claude Fable/Opus 5-linjen (noen Claude-varianter har tilbudt større effektive vinduer via andre mekanismer). Separate ghost-routing-påstander antydet 10M-tak; disse er fortsatt uverifiserte.
Pris på Gemini 4 (lekkede tall)
Den sirkulerende tabellen oppgir:
- Gemini 4 Pro: $2.25 input / $11.25 output per 1M token (uten caching).
- Gemini 4 Flash: $0.75 / $3.75.
- Gemini 4 Flash-Lite: $0.35 / $1.75.
Disse tallene er betydelig lavere enn GPT-6 Astra sine rapporterte $12/$60 og Claude Fable 5.1 sine $10/$50 listepriser (Fable 5.1 tilbyr aggressive cache-leserabatter som kan senke effektiv kostnad for agentiske arbeidslaster). Nåværende offisiell Gemini 3.x Pro-prissetting ligger på $2–$4 input / $12–$18 output avhengig av kontekstlengde, så de lekkede Pro-tallene er plausible som en neste generasjons justering.
Faktisk offentlig prissetting blir først kjent ved lansering. Google har historisk brukt konkurransedyktige tokenrater og gratistier for å drive adopsjon.
Ytelse til Gemini 4 Pro: dypdykk i lekkede benchmarker
Den sirkulerende tabellen plasserer Gemini 4 Pro øverst i nesten hver kategori. Disse tallene er uoffisielle og uverifiserte av Google eller uavhengige tredjepartslaboratorier på publiseringstidspunktet. De bør behandles som retningsgivende signaler, ikke definitive rangeringer.
Programvareutvikling og agentisk koding
- DeepSWE v1.1 (langhorisont programvareingeniørfag): 88.7% (vs. GPT-6 Astra 86.9%, Claude Fable 5.1 69.1%, Claude Opus 5 75.0%).
- Terminal-bench 2.1 (agentisk terminalkoding): 95.3% (vs. Astra 94.1%, Fable 92.8%).
- Terminal-bench 4.0 (generelle agentkapabiliteter): 69.7% (største relative gap over Flash og konkurrenter).
Kunnskapsarbeid og profesjonelle oppgaver
- GDPval-AA v2 (Elo, kunnskapsarbeid): 2064 (eneste modell over 2000; Astra 1994, Fable 1853).
- Vals Finance Agent v2: 74.2%.
- Harvey’s Legal Agent Benchmark (komplekse juridiske arbeidsflyter, all-pass rate): 18.7%.
Resonnering, multimodal og spesialisert
- CharXiv Reasoning (informasjonsyntese fra komplekse diagrammer, uten verktøy): 94.7%.
- LVBench (lang video-forståelse): 95.8% agentisk / 95.0% statisk.
- HLE-Verified (tverrfaglig ekspertresonnering): 72.1%.
- OSWorld-2.0 (agentisk datamaskinbruk, delvis score, batch-verktøy aktivert): 86.8%.
- BioMysteryBench & LABBench2 (bioinformatikk og biologiforsknings-arbeidsflyter): ledende score på både menneskelig-løsbare og vanskelige delsett.
Disse resultatene, hvis de er veiledende, viser særlig styrke på langhorisont, flertrinns, verktøybrukende agentiske arbeidslaster—nettopp området hvor GPT-6 Astra og Claude Fable 5.1 ble posisjonert som ledere etter utgivelsene tidlig i september.
Arena-kvalitative tester forsterker bildet: komplekse SVG- og Three.js-genereringer fra stealth-modellen har blitt vurdert som overlegne eller svært konkurransedyktige mot Astra i side-om-side-sammenligninger i fellesskapet.
Hvordan vil Gemini 4 fungere?
Gemini 4 (Pro) er ikke utgitt ennå, så enhver beskrivelse av “hvordan den vil fungere” er nødvendigvis basert på Googles offisielle uttalelser, begrensede lekkede detaljer om et tidlig internt sjekkpunkt, utviklingstakten til Gemini 3.x-serien og rimelige tekniske slutninger. Ingenting under bør behandles som bekreftede spesifikasjoner.
Kjerneopplæring og skaleringsstrategi
Google har beskrevet Gemini 4 som deres “mest ambisiøse pre-treningsløp til nå”, bygget på en betydelig større basemodell enn tidligere generasjoner. Det eksplisitte målet er å forbli konkurransedyktig i frontlinjen, spesielt innen koding og autonome agenter.
Dette innebærer:
- Et større parameterantall eller mer effektiv kapasitet (via mixture-of-experts, bedre sparsitet eller tettere skalering).
- Tyngre compute-investering under pre-trening.
- Fortsatt vekt på multimodale treningsdata (tekst, bilde, video, lyd, kode, verktøybruks-trajektorier).
Modellen forventes å tjene som en ny høyytelses-baseline som raskere Flash-stil-varianter senere kan avledes fra.
Inferens og resonneringsstil
Lekkede beskrivelser av et tidlig “argon”-sjekkpunkt nevner en modus for høy tenkeinnsats som tok omtrent 2.4 minutter for en enkelt generering og støttet et dramatisk høyere utgangstak (rapportert til 256k token mot tidligere ~64k).
Dette peker på:
- Valgfrie, compute-intensive resonneringsveier (i ånden av utvidet tenking eller “maks innsats”-moduser i konkurrerende modeller).
- Evnen til å bruke mer intern beregning på vanskelige problemer før et svar produseres.
- Bedre støtte for lange, koherente utdata som komplette kodebaser, flertrinns planer eller lange rapporter.
Brukere vil sannsynligvis kunne styre trade-off mellom hastighet/kostnad og dybde i resonnering, slik de kan med dagens Gemini Flash-modeller som tilbyr lav/middels/høy tenkenivå.
Viktige fokusområder for kapabiliteter
- Koding og programvareingeniørfag Sterkere langhorisont-ytelse: multifil-refaktorisering, debugging på tvers av repositories, selvkorrigeringssløyfer og høyere fullføringsrater på realistiske programvareoppgaver.
- Autonom/agentisk atferd Forbedret evne til å planlegge, bruke verktøy, observere mellomresultater, hente seg inn fra feil og fortsette mot et mål over mange steg. Dette bygger direkte på databruks- og agentiske funksjoner som allerede finnes i Gemini 3.5/3.8 Flash.
- Langkontekst-pålitelighet Fellesskapsrapporter nevner mål i 1.5-millioners-token-området (eller høyere). Det praktiske målet er ikke bare større vinduer, men bedre gjenfinning og mindre degradering ved arbeid med svært lange dokumenter, kodebaser eller fler-timers agentspor.
- Multimodal forståelse og generering Naturlig håndtering av tekst + bilde + video + lyd, med forventede gevinster i romlig resonnering, videoforståelse og sanntids stemme-/agentinteraksjoner (bygger på Gemini 3.8 Live-modeller fra september 2026).
- Verktøybruk og strukturerte utdata Mer robust funksjonskalling, kodekjøring, søkegrunnlag, og strukturerte JSON/XML-aktige utdata for pålitelig integrasjon i applikasjoner og agenter.
Hvordan den skiller seg fra Gemini 3.x
- Skala: Eksplisitt større basemodell fremfor inkrementell forbedring.
- Utgangskapasitet: Lekkede høyere token-grenser muliggjør lengre enkel-pass-genereringer.
- Resonneringsdybde: Mer markante høy-innsatsmoduser for vanskelige problemer.
- Agentisk fokus: Større vekt på vedvarende, flertrinns autonomt arbeid fremfor enkelt-sving eller kort-horisont-oppgaver.
- Posisjonering: Tenkt som den nye frontlinje Pro-modellen, mens Flash-linjen fortsetter rask iterasjon for hastighet og kostnadseffektivitet.
Forholdet til rekursiv selvforbedring (RSI)
Google-ledere har offentlig koblet selskapets store AI-kapitalutgifter til det langsiktige målet om rekursiv selvforbedring—systemer som meningsfullt kan forbedre seg selv eller prosessene som produserer neste generasjon. Relatert forskning (som Dream-RSI) viser agenter som forbedrer egne utforskingsstrategier uten å endre modellvekter.
Vil Gemini 4 Pro overgå GPT-6 og Claude Fable 5.1?
| Kategori | Gemini 4 Pro | GPT-6 Astra | Claude Fable 5.1 | Notater |
|---|---|---|---|---|
| Input-/outputpris | $2.25 / $11.25 | $12.00 / $60.00 | $10.00 / $50.00 | Gemini 4 Pro ~5× billigere enn Astra |
| Kontekstvindu | 2M | 1M | 200k | Betydelig fordel for Gemini |
| DeepSWE v1.1 | 88.7% | 86.9% | 69.1% | Sterkt forsprang i koding |
| GDPval-AA v2 (Elo) | 2064 | 1994 | 1853 | Leder i kunnskapsarbeid |
| Terminal-bench 4.0 | 69.7% | 66.4% | 57.9% | Generelle agentkapabiliteter |
| OSWorld-2.0 | 86.8% | 84.5% | 77.9% | Datamaskinbruk |
| HLE-Verified | 72.1% | 67.3% | 62.1% | Ekspertresonnering |
| LVBench (video) | 95.8% / 95.0% | 93.8% | 90.4% | Multimodal styrke |
| Bio-/LAB-forskning | Høyeste score | Sterk | Konkurransedyktig | Vitenskapelige arbeidsflyter |
Gemini 4 Pro topper hver større rad i tabellen, ofte med en meningsfull margin, mens den påståtte prisingen er langt mer aggressiv enn både GPT-6 Astra og Claude Fable 5.1.
Viktige forbehold
- Denne tabellen er ikke en offisiell Google-utgivelse. Per 20. september 2026 har Google fortsatt ikke publisert et modellkort, API-endepunkt, prising eller bekreftede benchmarker for Gemini 4 Pro. Tallene stammer fra fellesskapskilder / Arena-observasjoner / lekkede interne sjekkpunkt (kodenavn relatert til “argon”).
- Noen tidligere sirkulerende ark ble senere flagget som prediktive eller delvis kopierte. Behandle hver spesifikk prosent og prising som uverifisert til Google bekrefter dem.
- Claude Fable 5.1 sitt kontekstvindu er oppført her som 200k, som er lavere enn 1M-tallet ofte rapportert i offisiell Anthropic-dokumentasjon. Dette kan reflektere en spesifikk evalueringsinnstilling eller en feil i den lekkede oversikten.
- GPT-6 Astra og Claude Fable 5.1 forblir de eneste fullt offentlige, uavhengig evaluerte frontlinjemodellene akkurat nå. Artificial Analysis og andre tredjepartssporere viser fortsatt at de er tett matchet totalt sett (med ulike styrker).
Dagens praktiske virkelighet (20. september 2026)
| Modell | Status | Best for | Prisnivå |
|---|---|---|---|
| Gemini 4 Pro | Ikke lansert (påstått sterk) | Lang kontekst, koding, agenter, multimodalitet, kostnad | Svært aggressiv (påstått) |
| GPT-6 Astra | Lansert | Matematikk, databruk, terminal, automasjon, cyber | Premium |
| Claude Fable 5.1 | Lansert | Langhorisont-agenter, resonnering, kodekvalitet, cache-effektivitet | Premium |
| Gemini 4 Flash / Flash-Lite | Påståtte søskenmodeller | Hastighet + kostnadssensitive arbeidslaster | Ekstremt lavt |
Rask oppsummering
- Dominerer på tvers: Gemini 4 Pro rangerer som #1 i hver listede kategori, ofte med klar margin.
- Særlige styrker: Langhorisont koding/agenter (DeepSWE, Terminal-bench), kunnskapsarbeid, multimodalt (video + diagrammer) og spesialiserte domener (finans, juridisk, biologi, databruk).
- Prisposisjonering: Omtrent 1/5 av prisen til GPT-6 Astra og Claude Fable 5.1 på både input og output, samtidig som den leverer høyere score.
Astra vektlegger databruk, cybersikkerhetsterskler og vitenskapelig oppdagelse; Fable 5.1 vektlegger langvarig kunnskapsarbeid og koding med raffinerte sikringer og lavere cache-lesekostnader. Gemini 4 Pro sin lekkede profil ser sterkest ut i bred agentisk programvareingeniørfag og multimodal resonnering.
Hvordan utviklere kan forberede seg: Anbefalinger fra CometAPI
Mens man venter på offisiell tilgang til Gemini 4 Pro, drar team nytte av en samlet gateway som allerede støtter dagens frontlinje (Gemini 3.x-serien, GPT-6 Astra, Claude Fable 5.1 / Opus 5 og 500+ andre modeller). CometAPI tilbyr nettopp dette: ett OpenAI-kompatibelt endepunkt, én API-nøkkel, bruk-bare-forbruk-fakturering typisk 20–40% under direkte leverandørpriser, og muligheten til å bytte modeller med en enkelt parameterendring.
Praktisk arbeidsflyt:
- Prototyp agentiske rørledninger på dagens Gemini Flash/Pro, GPT-6 Astra og Claude Fable 5.1 via CometAPI.
- Benchmark de samme promptene på tvers av modeller for å etablere baseliner.
- Når Gemini 4 Pro (og dens Flash-varianter) dukker opp i CometAPI-katalogen—historisk har plattformen lagt til nye Google-modeller raskt—bytt modell-ID og kjør evalueringene på nytt med minimale kodeendringer.
- Bruk kostnadsdashboardet for å spore token-forbruk på tvers av tilbydere og rute høyt volum eller latenssensitiv trafikk til den mest økonomiske kapable modellen.
Denne tilnærmingen eliminerer håndtering av flere nøkler, reduserer risiko for leverandørbinding og posisjonerer team for å ta i bruk Gemini 4 Pro på dag én av offentlig tilgjengelighet.
Gemini 4 Pro, hvis lekkasjene viser seg å være retningsmessig korrekte, representerer Googles sterkeste forsøk så langt på å gjenvinne frontlinjen innen agentisk programvareingeniørfag og langkontekst multimodal resonnering. Kombinasjonen av påstått ytelse, stort kontekstvindu og aggressiv prising vil gjøre den til et standardvalg for mange produksjonsarbeidslaster. Inntil den offisielle lanseringen og uavhengige evalueringer kommer, er den kloke veien kontinuerlig benchmarking på tvers av eksisterende frontlinjemodeller—lett gjort gjennom plattformer som allerede samler tilgang. Følg med for den formelle kunngjøringen; de neste ukene vil sannsynligvis avklare hvor mye av hypen som oversettes til produksjonsrealitet.
Vanlige spørsmål
Er Gemini 4 Pro lansert?
Nei. I henhold til den siste katalogen og Googles uttalelser (midt til slutten av september 2026) er den ikke offentlig lansert eller oppført med en offisiell modell-ID.
Når er forventet utgivelsesdato for Gemini 4 Pro?
Lekkasjer peker på oktober 2026 (med noe spekulasjon om slutten av september). Google har ikke gitt noen offisiell dato. Behandle det som et tidsvindu i påvente av bekreftelse via API-katalog eller blogginnlegg.
Oppnådde Google RSI med Gemini 4 Pro?
Offentlige bevis viser avansert bruk av agentiske sløyfer for modellforfining og forskning på strategi-nivå rekursiv forbedring (f.eks. Dream-RSI). Påstander om full RSI som produserer modellen støttes ikke av uavhengig verifisering.
Hvordan sammenlignes den med GPT-6 Astra og Claude Fable 5.1 på benchmarker?
Lekkasjede fellesskapstabeller hevder ledelse på flere agent-/kodesuiter. Offisielle uavhengige score for en utgitt Gemini 4 Pro eksisterer ikke ennå. Dagens offentlige data favoriserer evaluering av de tilgjengelige modellene (Astra og Fable 5.1) på dine oppgaver.
Bør jeg vente på Gemini 4 Pro før jeg bygger?
Nei. Lever med dagens sterkeste tilgjengelige modeller (tilgjengelig via CometAPI eller direkte API-er), hold evalueringssett klare, og ta i bruk den nye modellen hvis og når uavhengige og interne tester rettferdiggjør byttet.
Hvor kan jeg enkelt få tilgang til dagens frontlinjemodeller?
Samlede leverandører som CometAPI tilbyr OpenAI-kompatibel tilgang til GPT-6 Astra-klassen, Claude Fable 5.1, dagens Gemini-modeller og andre med forenklet fakturering og bytting. Sjekk den levende modelllisten og dokumentasjonen for de nyeste ID-ene og prisingen.