
Kort fortalt
Kimi K3 er åpne vekter, men ikke i arbeidsstasjonsmålestokk: å serve den native modellen krever datasenter-klasse GPU-er og distribuert minne. Bruk vLLM for den mest direkte produksjonsveien, eller SGLang når topologi, ekspert-parallellisering og cache-kontroll er viktig. Community-GGUF-bygg senker maskinvareterskelen, men krever fortsatt om lag 500 GB til godt over 1 TB adresserbart minne og bytter hastighet eller kvalitet mot gjennomførbarhet. For vanlige PC-er og Mac-er, test via et hostet API først og selvhost kun når personvern, vedvarende utnyttelse eller infrastrukturkontroll rettferdiggjør kostnaden.
Hva er Kimi K3?
Kimi K3 er Moonshot AIs native, multimodale flaggskipsmodell med åpne vekter for langhorisont-koding, agentisk kunnskapsarbeid, resonnering og visuell forståelse.
Moonshot beskriver den som verdens første åpne 3T-klassemodell. Arkitekturen kombinerer Kimi Delta Attention and Attention Residuals med en sparsom MoE-design som velger kun et delsett av eksperter for hver token.
Skalaen er uvanlig selv etter frontmodell-standarder. I stedet for å aktivere alle 2,8T parametere for hver token, velger K3 16 av 896 ruterte eksperter, pluss delte eksperter. Dette reduserer per-token-beregning betydelig, selv om alle modellvekter fortsatt må være tilgjengelige et sted i inferenssystemet.
| Spesifikasjon | Kimi K3 — offisielle modellspecs |
|---|---|
| Arkitektur | Mixture-of-Experts |
| Totalt antall parametere | 2.8T |
| Aktiverte parametere | 104B |
| Eksperter | 896 |
| Valgte eksperter per token | 16 |
| Kontekstlengde | 1,048,576 tokens |
| Visjonsenkoder | MoonViT-V2 |
| Native kvantisering | MXFP4 vekter / MXFP8 aktiveringer |
| Formelle modaliteter i modelkortet | Tekst + bilde |
K3 anvender også kvantisering-bevisst trening fra SFT-stadiet, i stedet for å behandle lav-presisjons serving utelukkende som et ettertrenings kompresjonstrinn.
Arkitekturen er derfor optimalisert for serving i svært stor skala—men “sparsom beregning” må ikke forveksles med “lite minnefotavtrykk”. Bare deler av nettverket beregner hver token, men hele ekspert-poolen må fortsatt være tilgjengelig.
Hvordan presterer Kimi K3?
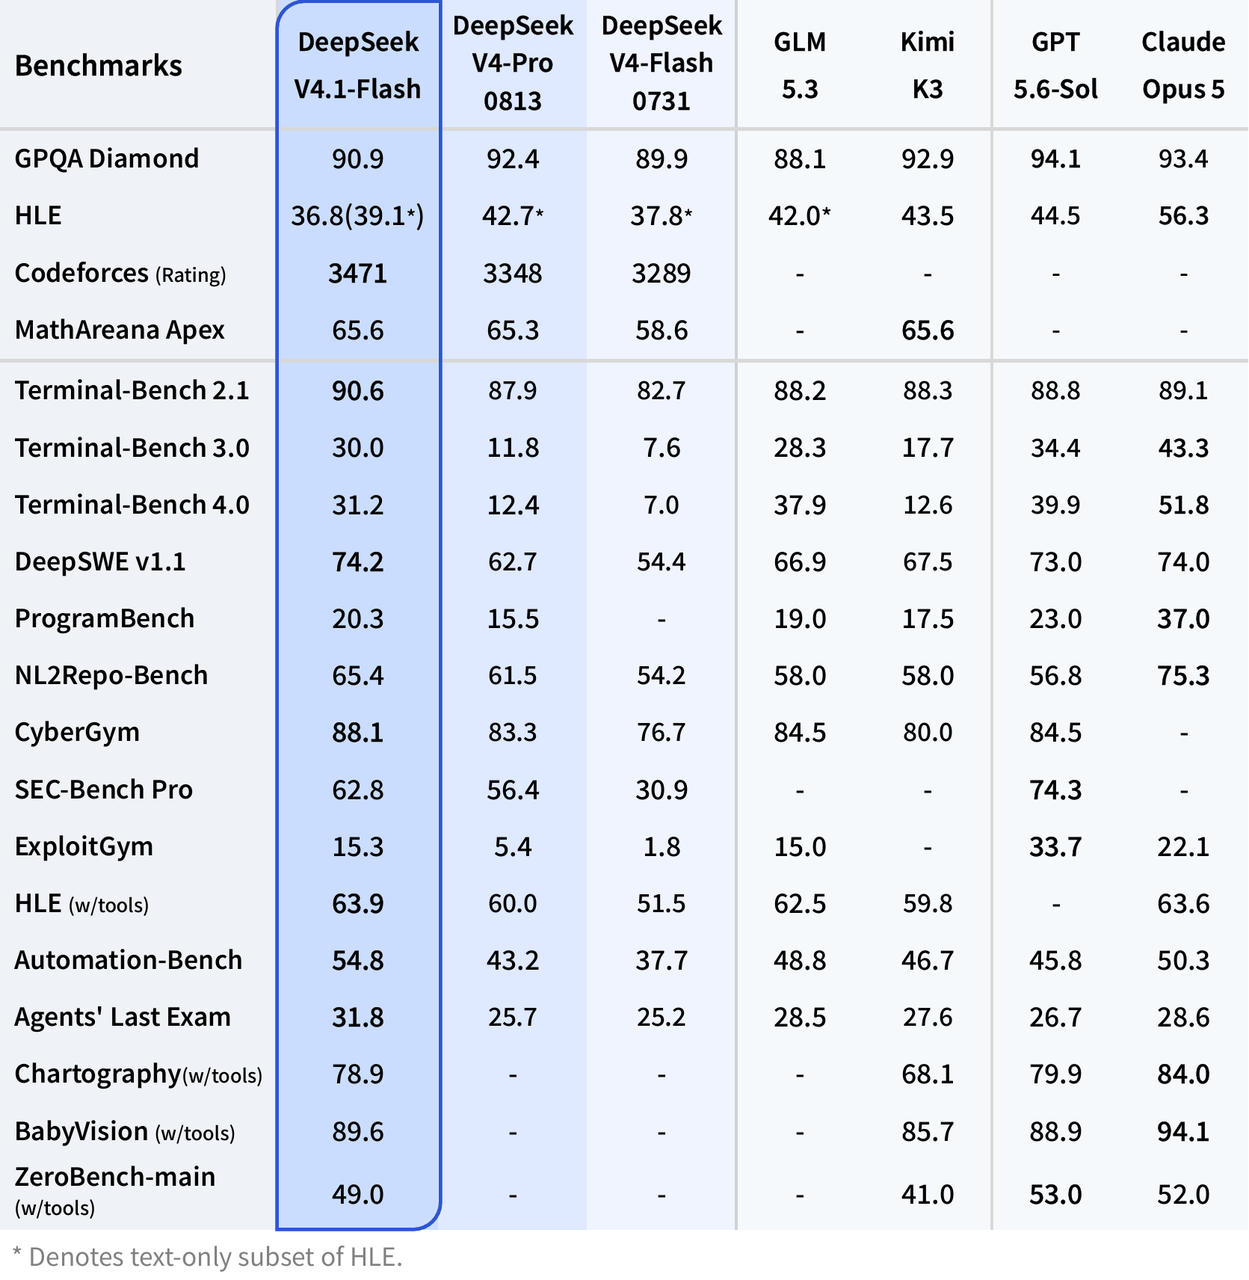
Moonshots offisielle Kimi K3-benchmarkpakke plasserer modellen nær ledende proprietære frontmodeller, særlig på langhorisont programvareutvikling og agentiske arbeidsbelastninger.
Følgende utvalg dekker resonnering, koding, agenter og visjon. Høyere er bedre for alle viste score.
| Benchmark — offisielle resultater fra Moonshot | Kimi K3 | GPT-5.6 Sol | Claude Fable 5 | Claude Opus 4.8 |
|---|---|---|---|---|
| GPQA Diamond | 93.5 | 94.1 | 92.6 | 91.0 |
| ProgramBench | 77.8 | 77.6 | 76.8 | 71.9 |
| Terminal-Bench 2.1 | 88.3 | 88.8 | 88.0 | 84.6 |
| FrontierSWE | 81.2 | 71.3 | 86.6 | 66.7 |
| SWE-Marathon | 42.0 | 39.0 | 35.0 | 40.0 |
| BrowseComp | 91.2 | 90.4 | 88.0 | 84.3 |
| OmniDocBench | 91.1 | 85.8 | 89.8 | 87.9 |
| PerceptionBench | 58.5 | 59.7 | 57.2 | 47.2 |
De offisielle scoreene plasserer Kimi K3 nær GPT-5.6 Sol, Claude Fable 5 og Claude Opus 4.8 på tvers av resonnering, koding, agent og visjon. Behandle disse leverandørrapporterte resultatene som kapabilitetskontekst heller enn en universell rangering; den detaljerte benchmark-analysen dekkes separat. For denne veiledningen er det operative poenget at selvhosting gir kapabilitet i frontklasse og infrastrukturkontroll, men ikke en billig snarvei på skrivebordet.
Kan du faktisk kjøre Kimi K3 lokalt?
Ja, men det finnes to svært forskjellige definisjoner av “lokalt”.
Lokal server / privat datasenter: realistisk.
Vanlig stasjonær eller bærbar: teknisk mulig å eksperimentere med aggressivt kvantiserte community-bygg, men generelt upraktisk for interaktiv bruk.
Den nåværende vLLM Kimi K3-oppskriften setter en svært høy basislinje:
- NVIDIA: minst 8× GB300
- AMD ROCm: minst 8× MI355X eller MI350X
- NVIDIA-driver: R580+ for det nåværende CUDA 13 K3-imaget
- Multi-node-infrastruktur anbefales for reell produksjonslast
Den opprinnelige vLLM dag-0-veiledningen demonstrerte også en 8-GPU B300 eller 8-GPU MI355X hurtigstart. For en ny produksjonsutrulling, følg den nyere oppskriften fordi den reflekterer serving-stacken etter optimaliseringene ved lansering.
Dette er hovedpoenget: K3 har åpne vekter, men det er ikke en forbrukerskala åpen modell.
Offisielle vekter vs. community-GGUF-kvantiseringer
Det finnes en annen måte å senke maskinvareterskelen på: community-kvantisering.
Det nåværende Unsloth K3-repositoriet tilbyr flere GGUF-varianter som kan kjøres via programvare kompatibel med llama.cpp.
Konsolidert sammenligning. Tall for adresserbart minne er planleggingsestimater (nedlastingsstørrelse pluss omtrent 10–15 % runtime-headroom), ikke garantier; kontekst, cache, visjon og offload-innstillinger kan kreve mer.
| Variant | Nedlasting | Anbefalt adresserbar minne | Visjonsstøtte | Dokumentert runtime | Formål / kvalitetsevidens |
|---|---|---|---|---|---|
| UD-Q1_0 | 466 GB | ≥520 GB | Repository oppgir visjonsstøtte; verifiser matchende runtime-path. | Unsloth llama.cpp PR-fork; Ollama-rute dokumentert, versjon ikke låst. | Proof-of-concept; ingen uavhengig variantspecifikk kvalitetstest sitert. |
| UD-TQ1_0 | 509 GB | ≥570 GB | Samme repository-nivå visjonsforbehold. | Samme dokumenterte runtime-path. | Aggressivt 1-bit-klasse-eksperiment; ingen uavhengig variantspecifikk test. |
| UD-IQ1_S | 594 GB | ≥665 GB | Samme repository-nivå visjonsforbehold. | Samme dokumenterte runtime-path. | Ekstremt lokalt eksperiment; ingen uavhengig variantspecifikk test sitert. |
| UD-IQ1_M | 649 GB | ≥730 GB | Samme repository-nivå visjonsforbehold. | Samme dokumenterte runtime-path. | Høyere kvalitet 1-bit-kompromiss; ingen uavhengig variantspecifikk test. |
| UD-IQ2_XXS | 711 GB | ≥800 GB | Samme repository-nivå visjonsforbehold. | Samme dokumenterte runtime-path. | 2-bit-klasse-eksperiment; ingen uavhengig variantspecifikk test sitert. |
| UD-Q2_K_XL | 861 GB | ≥970 GB | Samme repository-nivå visjonsforbehold. | Samme dokumenterte runtime-path. | Stor CPU/GPU-server; ingen uavhengig variantspecifikk test sitert. |
| UD-Q4_K_XL | 1.51 TB | ≥1.7 TB | Samme repository-nivå visjonsforbehold. | Direkte llama.cpp- og Ollama-eksempler er dokumentert for denne varianten. | Kvalitetsfokusert GGUF-serving; ingen uavhengig K3-kvantisering-benchmark sitert. |
| UD-Q8_K_XL | 1.56 TB | ≥1.75 TB | Samme repository-nivå visjonsforbehold. | Samme dokumenterte runtime-path. | Nær tapsfri community-build; liten lagringsfordel over Q4. |
Denne distinksjonen forklarer også hvorfor noen tidlige lokal-deploy-artikler siterer 594 GB: 594 GB tilsvarer nå community-varianten UD-IQ1_S GGUF, ikke en nyttig beskrivelse av det fullstendige, aktuelle native sjekkpunktet.
En modell på 466–649 GB er dramatisk mindre enn det opprinnelige utrullingsfotavtrykket, men den er fortsatt enorm etter arbeidsstasjonsstandard. Du bør også avsette minne til runtime-tilstand, kontekst, cacher, visjonsprosjektor, operativsystemprosesser og annet overhead.
Diskkapasitet er ikke det samme som inferensminne. Å ha en 1 TB SSD betyr ikke at en 600 GB modell vil kjøre raskt på en maskin med 64 GB RAM. SSD-offloading kan gjøre ekstreme eksperimenter mulig, men tokengenerering kan bli smertefullt tregt.
Hvordan deploye Kimi K3 med vLLM
For seriøs selvhosting er vLLM den mest rett-fram startveien.
Moonshot lister for tiden vLLM som en av de anbefalte K3-inferensmotorene, og vLLM tilbyr modellspecifikk støtte for KDA, MXFP4 MoE, resonneringsparsing, verktøykall, prefiks-caching og distribuert utrulling.
Sjekk forutsetningene
For NVIDIA-produksjonsutrulling bruker den nåværende testede oppskriften containeren vllm/vllm-openai:kimi-k3.
Sjekk GPU-ene:
nvidia-smi
Bekreft Docker:
docker --version
Bekreft at NVIDIA Container Toolkit ser akseleratorene:
docker run --rm --gpus all nvidia/cuda:13.0.0-base-ubuntu24.04 nvidia-smi
Hvis den siste kommandoen ikke ser alle GPU-ene, fiks GPU-runtime for vert/container før du laster ned en modell på flere terabyte.
Sett Hugging Face-tokenet ditt
Hvis autentisering kreves for modellrepoet, lagre tokenet i en miljøvariabel i stedet for å hardkode det i skript.
export HF_TOKEN="YOUR_HUGGING_FACE_TOKEN"
Hent K3 vLLM-containeren
docker pull vllm/vllm-openai:kimi-k3
Den nåværende oppskriften spesifiserer en CUDA 13-build og en NVIDIA-driver R580 eller nyere.
Start Kimi K3
Nåværende Blackwell TP8 startmal (vLLM-oppskrift oppdatert 2026-09-10): bruk dette som et utgangspunkt, og regenerer eller benchmark profilen for akkurat din maskinvare og trafikk.
docker run --rm \
  --gpus all \
  --ipc=host \
  -p 8000:8000 \
  -v ~/.cache/huggingface:/root/.cache/huggingface \
  -e HF_TOKEN="$HF_TOKEN" \
  -e VLLM_USE_V2_MODEL_RUNNER=1 \
  vllm/vllm-openai:kimi-k3 \
  --model moonshotai/Kimi-K3 \
  --tensor-parallel-size 8 \
  --gpu-memory-utilization 0.95 \
  --kv-cache-dtype fp8 \
  --attention-backend TOKENSPEED_MLA \
  --attention-config '{"use_prefill_query_quantization":true,"mla_prefill_backend":"TOKENSPEED_MLA"}' \
  --prefix-match-unit 128 \
  --enable-prefix-caching \
  --max-model-len 131072 \
  --enable-auto-tool-choice \
  --tool-call-parser kimi_k3 \
  --reasoning-parser kimi_k3
Den nåværende oppskriften krever K3 CUDA 13-image og en NVIDIA-driver R580 eller nyere. FP8 KV-cache må pares med et kompatibelt MLA prefill/decode-backend; benchmark alternativer før du endrer oppmerksomhetskonfigurasjonen.
Kilde: vLLM Kimi K3-oppskrift. Dette erstatter den tidligere dag-0-kommandoen i stedet for å presentere den som dagens produksjonsoppskrift.
For en første valideringskjøring, vurder å begrense maksimal modellengde i stedet for å allokere rundt hele 1,048,576-token-kapasiteten umiddelbart. Den nåværende vLLM-oppskriften anbefaler eksplisitt å justere max-model-len til arbeidsbelastningen.
For eksempel:
--max-model-len 131072
Dette endrer ikke K3s arkitektoniske kontekstgrense. Det gir bare serving-motoren et mer håndterbart arbeidsomfang for dine første tester.
Test det lokale endepunktet
vLLM eksponerer et OpenAI-kompatibelt API på port 8000.
curl http://localhost:8000/v1/chat/completions \
  -H "Content-Type: application/json" \
  -d '{
    "model": "moonshotai/Kimi-K3",
    "messages": [
      {
        "role": "user",
        "content": "Explain the difference between tensor parallelism and expert parallelism."
      }
    ],
    "max_tokens": 512
  }'
Eller bruk OpenAI Python SDK:
python
from openai import OpenAI

 client = OpenAI(
    base_url="http://localhost:8000/v1",
    api_key="EMPTY",
    timeout=3600,
 )

response = client.chat.completions.create(
    model="moonshotai/Kimi-K3",
    messages=[
        {
            "role": "user",
            "content": "Write a Python function that validates a JSON schema.",
        }
    ],
    max_tokens=1024,
 )

print(response.choices[0].message.content)
Den offisielle vLLM-oppskriften bruker det samme localhost OpenAI-kompatible mønsteret, noe som gjør det relativt enkelt å bytte en applikasjon mellom lokal og hostet inferens.
Hvordan deploye Kimi K3 med SGLang
SGLang er den andre store utrullingsveien offisielt anbefalt av Moonshot.
Den er særlig relevant når du ønsker dypere kontroll over distribuert serving, ekspert-parallellisering, maskinvare-spesifikke kjerner eller kompleks produksjonstopologi.
Bruk den dedikerte SGLang Kimi K3 Cookbook og velg en maskinvare-spesifikk topologi. Følgende er den verifiserte en-nodes 8×B300 Unified/Balanced-profilen fra kokeboken; den ble målt med SGLang v0.5.18 på commit 71de97b2.
Installer en K3-kompatibel build:
pip install --upgrade pip
pip install uv
uv pip install --prerelease=allow sglang
Start den verifiserte B300 TP8/DCP8-profilen:
sglang serve \
  --trust-remote-code \
  --model-path moonshotai/Kimi-K3 \
  --tp-size 8 \
  --dcp-size 8 \
  --mem-fraction-static 0.85 \
  --mamba-full-memory-ratio <value-from-official-calculator> \
  --reasoning-parser kimi_k3 \
  --tool-call-parser kimi_k3 \
  --host 0.0.0.0 \
  --port 30000
--mamba-full-memory-ratio er arbeidsbelastningsavhengig: beregn den ut fra gjennomsnittlig lengde på input pluss output i den offisielle kokeboken. Ikke kopier denne B300-topologien til H100/H200, GB200/GB300, AMD eller multi-node utrullinger; disse profilene bruker ulike TP/PP/DCP/EP-oppsett.
Test serveren:
curl http://localhost:30000/v1/chat/completions \
  -H "Content-Type: application/json" \
  -d '{
    "model": "moonshotai/Kimi-K3",
    "messages": [{"role": "user", "content": "Give me a five-step debugging plan for a distributed Python application."}]
  }'
For en reell utrulling, valider kapasitet, utgangskvalitet og feilgjenoppretting på akkurat den SGLang-versjonen, topologien, kontekstlengden og trafikkmiksen du har tenkt å kjøre.
vLLM vs SGLang vs llama.cpp
Valg av inferensmotor avhenger primært av maskinvaren din og formålet med utrullingen.
| Distribusjonsmetode | Maskinvareklasse | Offisielle native vekter | OpenAI-kompatibelt API | Distribuert produksjon | Enkelhet ved oppsett | Best egnet |
|---|---|---|---|---|---|---|
| vLLM | GPU-klynge i datasenter | Ja | Ja | Utmerket | Middels | Standardvalg for produksjon |
| SGLang | GPU-klynge i datasenter | Ja | Ja | Utmerket | Middels–høy | Avansert distribuert serving |
| llama.cpp + GGUF | Arbeidsstasjon/server med enormt minne | Community-kvantisering | Ja | Begrenset sammenlignet med vLLM/SGLang | Lav–middels | Lokal eksperimentering |
| Ollama + GGUF | Arbeidsstasjon/server med enormt minne | Community-kvantisering | Ja | Ikke hovedmål | Enkel | Bekvemmelighets-først testing |
| CometAPI | Ingen lokal GPU kreves | Hostet | Ja | Administrert | Svært enkel | Utviklere uten K3-klasse maskinvare |
Hvis du eier en 8-GPU Blackwell/MI35x-klasse server, start med vLLM.
Hvis du designer en spesialisert distribuert inferensklynge og ønsker mer lavnivå serving-kontroller, evaluer SGLang også.assistant_message
Hvis målet ditt ganske enkelt er “Jeg vil bevise at K3 kan kjøre på maskinvaren jeg eier,” er GGUF pluss llama.cpp langt mer tilgjengelig—forutsatt at maskinen din har en virkelig eksepsjonell mengde minne.
Hvordan kjøre en kvantisert Kimi K3 med llama.cpp eller Ollama
Community-Kimi K3 GGUF-repositoriet tilbyr nå varianter kompatible med llama.cpp.
Denne ruten senker terskelen dramatisk sammenlignet med en datasenter-native utrulling, men “dramatisk” er relativt: selv de mindre byggene er på flere hundre gigabyte.
Installer llama.cpp på macOS eller Linux
Det nåværende GGUF-modelkortet tilbyr:
curl -LsSf https://llama.app/install.sh | sh
På Windows:
winget install llama.cpp
Start en OpenAI-kompatibel server
Repoet dokumenterer for tiden UD-Q4_K_XL som et eksempel:
llama serve \
  -hf unsloth/Kimi-K3-GGUF:UD-Q4_K_XL
Du kan også kjøre CLI-en direkte:
llama cli \
  -hf unsloth/Kimi-K3-GGUF:UD-Q4_K_XL
Disse kommandoene kommer direkte fra det nåværende Kimi K3 GGUF-modelkortet.
Imidlertid er UD-Q4_K_XL rundt 1.51 TB, så det er ikke varianten de fleste arbeidsstasjonsbrukere vil starte med. Hvis prioriteten din er å redusere minnekrav heller enn å bevare mest mulig kvalitet, undersøk de mindre 1-bit- og 2-bit-variantene først.
For eksempel:
llama serve \
  -hf unsloth/Kimi-K3-GGUF:UD-IQ1_M
Den nåværende UD-IQ1_M-katalogen er omtrent 649 GB.
En modell på 649 GB er fortsatt ikke en normal bærbar-modell. Ideelt sett bør den ofte brukte modelltilstanden ligge i raskt minne. Tung SSD-offloading kan gjøre et ekstremt eksperiment teknisk mulig uten å gjøre det nyttig for interaktivt arbeid.
Kjør den samme GGUF-byggen med Ollama
Ollama er et bekvemmelighetslag for den samme GGUF-utrullingsveien, ikke en fjerde uavhengig selvhostingsmetode.
K3 GGUF-repoet eksponerer også en Ollama-rute.
For eksempel:
bash
ollama run hf.co/unsloth/Kimi-K3-GGUF:UD-Q4_K_XL
Ollama forenkler modellhåndtering og API-opplevelsen, men endrer ikke K3s minnekrav.
Å bytte launcher fra llama.cpp til Ollama kan ikke gjøre en kvantisering på flere hundre gigabyte om til en 24 GB GPU-modell. De underliggende modelldataene må fortsatt lagres og aksesseres.
Av denne grunn bør Ollama ses som en praktisk runtime-innpakning, ikke som en maskinvare-omvei.
Hvilken Kimi K3-kvantisering bør du velge?
For eksperimenter er valget hovedsakelig en avveining mellom modellstørrelse og troskap.
| GGUF-kvantiseringer | Størrelse | Relativt minnepress | Forventet kvalitet | Anbefalt bruk |
|---|---|---|---|---|
| UD-Q1_0 | 466 GB | Lavest | Størst risiko for forringelse | Proof-of-concept |
| UD-IQ1_S | 594 GB | Svært høy | Aggressiv | Ekstreme lokale eksperimenter |
| UD-IQ1_M | 649 GB | Svært høy | Bedre 1-bit-kompromiss | Eksperimentell server med stort minne |
| UD-Q2_K_XL | 861 GB | Ekstrem | Bedre troskap | Stor CPU/GPU-server |
| UD-Q4_K_XL | 1.51 TB | Datasenterklasse | Høyere troskap | Kvalitetsfokusert selvhosting |
| Native K3 serving | Datasenterklasse | Datasenterklasse | Tilsiktet modellatferd | Produksjon |
Viktig Kimi K3-servingatferd
Det er én K3-spesifikk implementasjonsdetalj som er lett å overse.
K3 bruker bevart tanke-historikk. Moonshot sier at flerturn-samtaler og verktøykall-arbeidsflyter bør sende den fullstendige forrige assistant-meldingen tilbake til modellen, inkludert reasoning_content og tool_calls, i stedet for å bevare kun synlig innhold.
Et forenklet applikasjonsmønster ser slik ut:
messages = [
    {
        "role": "user",
        "content": "Inspect this project and propose a migration plan.",
    }
 ]

first = client.chat.completions.create(
    model="moonshotai/Kimi-K3",
    messages=messages,
    max_tokens=2048,
 )

assistant_message = first.choices[0].message

 # Preserve the whole message object, not just assistant_message.content.
 messages.append(
    assistant_message.model_dump(exclude_none=True)
 )

messages.append(
    {
        "role": "user",
        "content": "Now identify the riskiest part of that plan.",
    }
 )

second = client.chat.completions.create(
    model="moonshotai/Kimi-K3",
    messages=messages,
    max_tokens=2048,
 )
Dette blir spesielt viktig for kodeagenter, verktøysløyfer og langvarige autonome økter.
K3 holder også resonnering aktivert og støtter lav, høy og maks resonneringsinnsats. Når servingen eksponerer disse parameterne, bør resonneringsinnsats behandles som en annen latens-/kvalitetskontroll i stedet for å maksimere den for hver forespørsel.
Hvordan optimalisere en lokal Kimi K3-utrulling
Ikke alloker hele 1M-konteksten med en gang
K3 støtter 1,048,576 tokens, men maksimal modellkapasitet og fornuftig serverkonfigurasjon er forskjellige ting.
For utvikling, begynn med noe som:
--max-model-len 131072
Øk deretter kontekst først etter å ha målt tilgjengelig minne, tid til første token, throughput og forventet samtidighet.
Aktiver prefiks-caching
Kodeagenter gjenbruker ofte repositorieinstruksjoner, verktøyskjemaer, systemprompter og lange prefiks.
Med vLLM:
--enable-prefix-caching
K3s hybride oppmerksomhetsarkitektur krevde spesialhåndtering for prefiks-caching, og vLLM har implementert modellspecifikk støtte for det.
Bruk K3-parserne
For agent-arbeidslaster, inkluder:
--tool-call-parser kimi_k3 \
--reasoning-parser kimi_k3
Dette holder verktøykall og resonneringsutdata på linje med K3s servingformat.
Hold lagringen rask
En modell i denne skalaen legger uvanlig press på lokal lagring under første nedlasting, sjekkpunktlasting, oppdateringer og gjenoppretting.
NVMe-lagring er å foretrekke fremfor nettverksmonterte, trege disker. Hvis flere maskiner deler modelfiler, blir modellcache-topologi og nettverksbåndbredde en del av inferensarkitekturen snarere enn bare utrullingsdetaljer.
Overvåk mer enn GPU-utnyttelse
Spor:
- HBM/VRAM-bruk
- CPU-RAM
- cache-treffrate
- tid til første token
- dekodede tokens per sekund
- kødybde for forespørsler
- kommunikasjon mellom GPU-er
- båndbredde mellom noder
- mislykket parsing av verktøykall
- modell-lastetid
I K3-skala forteller ikke en tilsynelatende sunn GPU-utnyttelsesfigur om serving-topologien er effektiv.
Lokal Kimi K3 vs hostet Kimi K3
Selvhosting gir team maksimal kontroll over datapath, runtime og modellvekter, samtidig som de blir ansvarlige for GPU-kapasitet, skalering, oppgraderinger, overvåking og gjenoppretting. Hostet tilgang fjerner mesteparten av infrastrukturarbeidet og er generelt den raskere veien for evaluering eller variabel etterspørsel.
For full maskinvare- og break-even-analyse, les Kimi K3 Self-Hosting vs API. For tokenpriser, caching og K2.7-sammenligninger, bruk Kimi K3-prisguiden. Denne artikkelen holder derfor sammenligningen kort og konsentrerer seg om utrullingskommandoer, konfigurasjon og feilsøking.
Vanlige problemer ved lokal Kimi K3-utrulling
Modellen får ikke plass i GPU-minnet
Dette er den mest forutsigbare feilen.
Ikke beregn minne ut fra de 104B aktiverte parameterne. Den figuren beskriver per-token-beregning, ikke mengden ekspert-vekter servingen må gjøre tilgjengelig.
Bruk en støttet distribuert topologi, en mindre GGUF-kvantisering, eller en hostet tjeneste.
CUDA- eller NVIDIA-driverfeil
Det nåværende vLLM K3-imaget er basert på CUDA 13 og krever en R580+ vertdriver.
Hvis verten fortsatt er på en R575/CUDA 12.9-stack, oppdater den eller følg bygg-fra-kilde-ruten beskrevet av vLLM i stedet for å anta at containeren vil løse inkompatibiliteten med vertens driver.
Den første forespørselen er ekstremt treg
Sjekk om sjekkpunktet fortsatt lastes, kompilerer kjerner, varmer opp cacher eller henter filer.
Med aktiva i flere-terabyte-klassen er “serverprosess startet” og “modellen er klar for produksjonstrafikk” ikke likeverdige tilstander.
Verktøykall feiler av og til
Den nåværende vLLM-oppskriften bemerker at K3 av og til kan produsere en verktøykall-form som parseren ikke forventer. Produksjonssystemer bør derfor validere verktøykall-skjemaer og implementere retries i stedet for å stole blindt på hvert genererte kall.
Lange samtaler blir mindre stabile
Sørg for at du returnerer den fullstendige assistant-meldingen—inkludert resonnering og verktøyinformasjon—til påfølgende K3-omganger.
Å droppe skjulte resonnerings-tilstands-felter kan bryte mønsteret for bevart tanke-historikk som K3 ble trent til å bruke.
Så, hva er den beste måten å deploye Kimi K3 lokalt?
For de fleste organisasjoner med egnet maskinvare er vLLM den beste første utrullingsveien. Den har dedikert K3-støtte, et OpenAI-kompatibelt API, modellspecifikke parsere, prefiks-caching, støtte for spekulativ dekoding og aktuelle maskinvareoppskrifter.
Velg SGLang når distribuert inferens-ingeniørkunst og finkornet serving-kontroll er viktigere enn korteste oppsettsvei.
Velg llama.cpp pluss en community-GGUF-kvantisering kun når målet ditt er arbeidsstasjon/server-eksperimentering og du forstår at selv 1-bit-versjonene fortsatt er på flere hundre gigabyte.
For en konvensjonell utviklerarbeidsstasjon er den mest praktiske konklusjonen en annen: ikke kjøp hundrevis av gigabyte RAM utelukkende for å tvinge K3 inn på et skrivebord. Test Kimi K3 via CometAPI først, kvantifiser gevinsten på dine egne oppgaver, og gå over til selvhosting kun når personvern, vedvarende utnyttelse eller infrastrukturkontroll gjør økonomien fornuftig.
FAQ
Kan Kimi K3 kjøre på en enkelt forbruker-GPU?
Ikke realistisk. Modellen ligger langt over VRAM-kapasiteten til forbruker-GPU-er. Community lav-bits GGUF-kvantiseringer reduserer fotavtrykket betydelig, men de minste nåværende variantene er fortsatt på flere hundre gigabyte.
Kan jeg kjøre Kimi K3 på en Mac?
Eksperimentell CPU/Apple Silicon-kjøring med GGUF og lagringsoffloading er prinsipielt mulig, men interaktiv ytelse og minnekapasitet er begrensende faktorer. En typisk MacBook bør ikke behandles som en praktisk K3-servingplattform.
Støtter Kimi K3 Ollama?
Community-GGUF-bygg kan startes via Ollama. Runtime forenkler oppsett, men endrer ikke det underliggende minnekravet.
Er vLLM eller SGLang bedre for Kimi K3?
vLLM er det enklere standardvalget for en ny produksjonsutrulling. SGLang er attraktivt for team som bygger sofistikerte distribuerte serving-topologier. Begge er blant Moonshots anbefalte K3-inferensmotorer.
Hvor mye kontekst støtter Kimi K3?
Den offisielle modellspecifikasjonen støtter 1,048,576 tokens. En lokal server trenger ikke å eksponere hele kontekstvinduet; å sette en lavere max-model-len kan være mer praktisk for tidlig utrulling og høyere samtidighet.
Er Kimi K3 åpen kildekode?
En mer presis beskrivelse er åpne vekter. Moonshot har sluppet modellvektene under Kimi K3-lisensen. Les den lisensen direkte før kommersiell redistribusjon eller annen bruk der lisensvilkår er viktige.
Hva er den enkleste måten å bruke Kimi K3 uten lokale GPU-er?
Et hostet API er den enkleste veien. Kimi K3 er tilgjengelig via CometAPI med et OpenAI-kompatibelt chat-completions-grensesnitt, slik at applikasjonskoden kan forbli nær det du ville brukt mot en lokal vLLM- eller SGLang-server.