TL;DR
Hy4 er et sterkt utgangspunkt for finansforskning og tekstgenerering i høyt volum; GPT-6.1 Terra er et sterkt utgangspunkt for terminalkoding og debugging. Begge tar imot tekst og bilder og støtter verktøybruk. De tydeligste forskjellene er oppgaveytelse, utgangskapasitet og pris: Terra leder terminal-kodingstesten nedenfor, mens Hy4 leder finans- og forskningstestene og koster mindre til de oppførte CometAPI-satsene.
Viktige punkter
- Velg etter arbeidslast: Hy4 for forskning og applikasjoner med tungt tekstutbytte; Terra for terminalkoding og debugging.
- Begge tilbyr kontekstvinduer på omtrent én million tokens. Terra har et større maksimalt utbudsbudsjett.
- Terra leder Terminal-Bench 4.0 med 10.10 prosentpoeng; Tencents modell leder Finance Agent v2.1 med 8.74 poeng i Vals AIs resultater.
- CometAPI-eksempelet med 10M inndata- og 2M utdata-tokens koster $10.672 mot $16.00 til de viste grunnratene.
- Tilpass endepunkt, verktøyatferd og resonneringsinnstillinger til applikasjonen din før du bytter leverandør.
Spesifikasjoner, benchmark-øyeblikksbilder og priser sist kontrollert 6. november 2026.
Hy4 vs GPT-6.1 Terra: Spesifikasjoner og kapabiliteter
Hy4 kombinerer tekst- og bildeforståelse med resonnering og verktøybruk, inkludert arbeidsflyter på kommandolinje og grafiske grensesnitt. GPT-6.1 Terra støtter visuell resonnering, databruk og skriving, med eksplisitte kontroller for resonnementinnsats og et større utbudsbudsjett. Tabellen nedenfor sammenligner spesifikasjoner fra Tencent og OpenAI.
Offisielle API-spesifikasjoner
| Spesifikasjon | Hy4 · Tencent Cloud offisielle spesifikasjoner | GPT-6.1 Terra · OpenAI offisielle spesifikasjoner |
|---|---|---|
| Utvikler | Tencent | OpenAI |
| API-modell-ID | hy4 | gpt-6.1-terra |
| Inndata / utdata | Tekst og bilder / tekst | Tekst og bilder / tekst |
| Kontekstvindu | 1024K tokens (Tencent-notasjon) | 1,050,000 tokens |
| Maksimal utdata | 64K tokens (Tencent-notasjon) | 128,000 tokens |
| Verktøykalling | Støttet (Function Calling) | Støttet; krever Responses API |
| Strukturerte utdata | Støttet | Støttet |
| Hovedbruksområder | Programvareutvikling, finansanalyse og langvarige agentoppgaver | Visuell resonnering, databruk, skriving og avgrensede kodeoppgaver |
Begge modellene kan arbeide med store dokumentsamlinger og kodebaser. For lange prompt, avsett også budsjett for svaret: Tencent oppgir et maksimum på 960K inndata for Hy4. Den lille forskjellen i annonsert kontekstkapasitet er mindre nyttig for valg enn hvor presist hver modell bruker materialet ditt.
Terra tilbyr mer plass til et langt svar, med opptil 128,000 utdata-tokens mot Hy4s publiserte 64K-grense. Dette hjelper når en rapport eller kodeleveranse må få plass i ett svar. Resonnerings-tokens forbruker også Terras utbudsbudsjett.
Kontroller for resonnering
Terra tilbyr seks innstillinger for resonnementinnsats: none, low, medium, high, xhigh og max, med medium som standard. Dette gir applikasjoner en eksplisitt måte å justere inferensinnsats etter oppgave. En klassifiseringsforespørsel og en vanskelig debugging-oppgave trenger ikke bruke samme budsjett.
Tencents lansering beskriver resonnering kombinert med visuell persepsjon og verktøybruk, men definerer ikke en tilsvarende seksnivåkontroll i den kunngjøringen. Behandle resonneringsparametere som endepunkt-spesifikke: ikke kopier én leverandørs innsatsinnstilling inn i en annen forespørsel og anta at den har samme betydning.
Hy4 vs GPT-6.1 Terra: Ytelse
Vals AI gir direkte resultater for begge modeller på tvers av koding, finans, juridisk forskning og skatteoppgaver. Disse poengsummene viser hvor hver modell er en nyttig kandidat for arbeidslasten din.
Uavhengige benchmark-resultater og testforutsetninger
Følgende Vals Index v2.2-resultater ble kontrollert 10. november 2026. Høyere poeng er bedre.
| Benchmark eller metrikk | Hy4: Vals AI-resultater | GPT-6.1 Terra: Vals AI-resultater | Tolkning |
|---|---|---|---|
| Vals Index | 59.35% ± 1.08 | 60.54% ± 0.99 | Terra +1.19 prosentpoeng |
| Terminal-Bench 4.0 | 39.39% | 49.49% | Terra +10.10 poeng |
| Vibe Code Bench v1.1 | 81.01% | 84.00% | Terra +2.99 poeng |
| Finance Agent v2.1 | 64.70% | 55.96% | Tencent-modell +8.74 poeng |
| Legal Research Bench | 41.35% | 25.96% | Tencent-modell +15.39 poeng |
| Tax Agent Bench | 34.40% | 17.08% | Tencent-modell +17.32 poeng |
Vals AI oppgir temperature 0.9, top_p 1.0 og en 65,536-token utdata-grense for Hy4; Terra bruker maks resonnementinnsats og en 128,000-token utdata-grense. Disse innstillingene er ulike, så les resultatene som sammenligninger av de testede konfigurasjonene heller enn like-budsjett-kjøringer.
Terras forsprang er større på terminaloppgaver enn på kodegenerering: 10.10 prosentpoeng på Terminal-Bench 4.0 mot 2.99 poeng på Vibe Code Bench. Det gjør debugging og kommandolinjeutvikling til de tydeligste områdene å begynne å evaluere Terra.
Hy4 leder Finance Agent, Legal Research Bench og Tax Agent Bench med henholdsvis 8.74, 15.39 og 17.32 prosentpoeng. Forskningsarbeidsflyter som samler bevis og anvender domeneregler er derfor lovende utgangspunkter for Hy4.
Den samlede forskjellen er 1.19 prosentpoeng, og de publiserte usikkerhetsintervallene overlapper.
Tencents lanseringsbenchmarks for Hy4
Tencents lanseringsgraf legger til resultater for koding og databruk. Den sammenligner Hy4 med GPT-6.1 Sol; bruk Vals AI-tabellen ovenfor for direkte sammenligning med GPT-6.1 Terra.
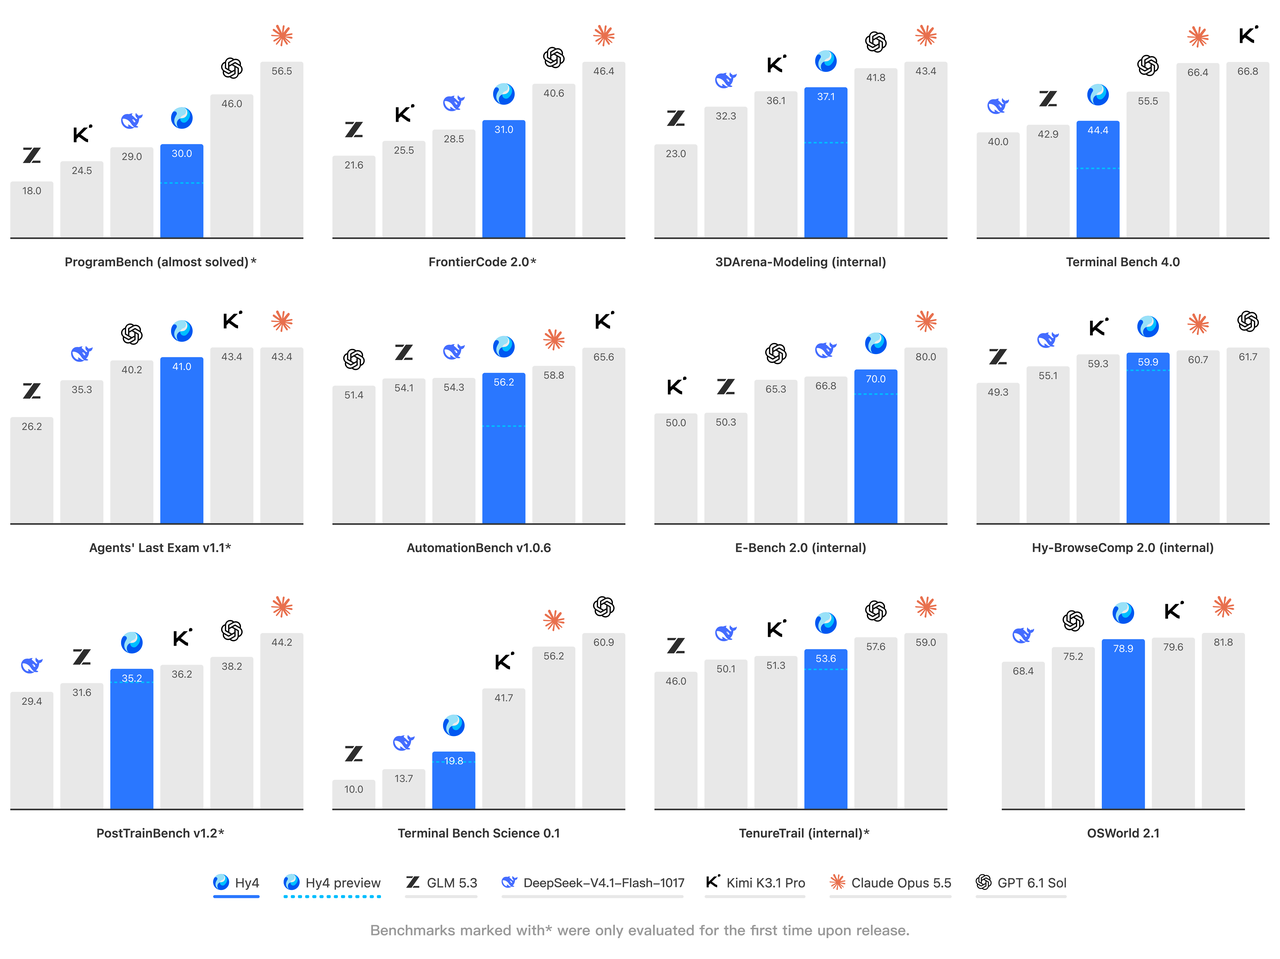
Tencent-rapporterte Hy4-benchmarkresultater, november 2026. OpenAI-modellen som vises er GPT-6.1 Sol.
I Tencents lanseringsgraf scorer Hy4 44.4 på Terminal Bench 4.0 og 78.9 på OSWorld 2.1. Disse tallene beskriver Tencents evalueringsoppsett og er separate fra Vals AI-poengene ovenfor.
Bildeforståelse og databruk-arbeidsflyter
Tencent introduserer bildeforståelse i den offisielle lanseringen og beskriver trening for arbeidsflyter som spenner over kommandolinjeverktøy, grafiske grensesnitt, Blender og CAD. Dette gjør diagramanalyse og visuelle programvareoppgaver sentrale i posisjoneringen.
OpenAI posisjonerer modellen for skjermbaserte arbeidsflyter, konsis skriving og avgrensede kodefikser. For en katalogapplikasjon, test matching av produktbilder; for teknisk arbeid, bruk tegninger med små etiketter og mål; for skrivebordsautomatisering, verifiser de lagrede filene og applikasjonstilstanden.
Et godt visuelt testsett bør skille lesing fra handling. Mål først om modellen trekker ut riktige verdier eller identifiserer riktig grensesnittelement. Mål deretter om den komplette arbeidsflyten når ønsket resultat uten feilklikk, manglende filer eller unødvendig menneskelig inngripen.
Hastighet og ende-til-ende-latens
For chat er de relevante hastighetsmålingene hvor raskt svaret starter og hvor lang tid det tar å fullføre. For agenter måles hele oppgaven, inkludert verktøykjøring og eventuelle reparasjoner.
Sammenlign begge modellene på typiske og krevende oppgaver ved forventet samtidighet. Spor median- og hale-latens sammen med vellykket fullføring: Et raskt svar er bare nyttig hvis det får jobben gjort.
Hy4 vs GPT-6.1 Terra: Kostnad
Sammenlign token-satser først, og ta deretter høyde for arbeidet som kreves for å få et brukbart resultat. Prisene nedenfor er CometAPI-grunnsatser i amerikanske dollar per million tokens; de er separate fra kostnad-per-test-tallene rapportert av Vals AI.
CometAPI-priser for inndata og utdata
| Kostnadselement | Hy4 API i CometAPI | GPT-6.1 Terra API i CometAPI |
|---|---|---|
| Inndata per million tokens | $0.6672 | $0.80 |
| Utdata per million tokens | $2.00 | $4.00 |
Tabellen nedenfor bruker CometAPIs oppførte grunnsatser i amerikanske dollar per million tokens. Sammenlign inndata og utdata separat, og beregn deretter kostnaden for din typiske forespørsel.
Eksempelkostnad for 10,000 forespørsler
Tenk deg 10,000 forespørsler, hver med 1,000 ikke-mellomlagrede inndata-tokens og 200 fakturerbare utdata-tokens. På tvers av alle forespørsler er det 10 millioner inndata-tokens og 2 millioner utdata-tokens. Ved å bruke CometAPI-grunnprisene ovenfor:
- Hy4: (10 × $0.6672) + (2 × $2.00) = $10.672.
- GPT-6.1 Terra: (10 × $0.80) + (2 × $4.00) = $16.00.
Hy4 koster omtrent 33.3% mindre i dette eksempelet. Dette estimatet dekker ikke-mellomlagret inndata og fakturerbar utdata; legg til mellomlager-, verktøy- og retry-kostnader når du budsjetterer en komplett arbeidsflyt.
Direkteleverandør-fakturering og forespørsler med lang kontekst
For lange dokumenter på OpenAIs direkte API utløser prompt over 272K inndata-tokens 2× inndata- og mellomlagerrater og 1.5× utdata-rater for hele forespørselen. Anvend faktureringsreglene til tjenesten du bruker; CometAPI-eksempelet ovenfor bruker CometAPI-grunnsatser. OpenAI-prisdetaljer.
Kostnad per godkjent oppgave
En godkjent oppgave er en som oppfyller applikasjonens kvalitets- og fullføringskontroller. Tell alle forsøk, verktøybruk og gjennomgangsarbeid som trengs for å nå dette resultatet, inkludert forbruk på forsøk som mislykkes.
Kostnad per godkjent oppgave = totale modell-, retry-, verktøy- og menneskelig-gjennomgangskostnader ÷ oppgaver som passerer akseptkontroller.
En dyrere kall kan fortsatt være økonomisk hvis det fjerner flere reparasjonsforsøk. Omvendt, når en rimeligere modell møter kvalitetsgrensen, kan det gi liten verdi å betale en høyere sats for hver oppgave.
Hvilken modell bør du velge: Hy4 eller GPT-6.1 Terra?
Start med modellen hvis styrker matcher hovedarbeidslasten din. Bruk følgende valg til å bygge en shortlist, og sammenlign deretter kvalitet og kostnad for fullførte oppgaver.
Når bør du velge Hy4
Velg Hy4 først for finansforskning, analyse av juridiske eller skattedokumenter og applikasjoner som genererer mye tekst. Forspringene på de tre domenebenchmarkene gjør den til en nyttig kandidat for bevis-tung forskning. Til de oppførte CometAPI-satsene er utdata-prisen halvparten av Terras, noe som kan utgjøre en vesentlig forskjell for utkast og rapportering i høyt volum.
For forskningsarbeid, vurder det ferdige svaret etter kildepresisjon, beregninger og dekning av spørsmålet. Hy4 er et bedre valg når den oppfyller disse kravene til en lavere totalkostnad, inkludert gjennomgang og retries.
Når bør du velge GPT-6.1 Terra
Velg GPT-6.1 Terra først for terminalkoding, debugging og kodefikser. Dets forsprang på 10.10 poeng på Terminal-Bench er det sterkeste kodingssignalet i denne sammenligningen. Det større utbudsbudsjettet gjør det også verdt å teste for lange rapporter og omfattende kodesvar.
Vurder Terra etter om patchene passerer testene dine og leveransene er komplette. For visuelle eller skrivebordsoppgaver, sammenlign begge modellene på dine faktiske skjermer, diagrammer og filer, og kontroller det endelige lagrede resultatet.
Ruting av forskning og koding til ulike modeller
En blandet arbeidslast kan ha nytte av å bruke begge modellene. En finansanalyseassistent kan bruke Hy4 til forskning og rapportutkast, og deretter kalle Terra når et analyse-skript trenger debugging:
- Send bevisinnsamling og rapportutkast til Hy4.
- Sjekk sitater, kildeverdier og beregninger før rapporten godkjennes.
- Ruter et feilet analyse-skript til Terra med koden, feilutdata og forventet atferd.
- Kjør det korrigerte skriptet og anvend de samme beviskontrollene før det endelige resultatet returneres.
Bruk en sekundær modell når den forbedrer sluttresultatet nok til å dekke ekstra kostnader og integrasjonsarbeid.
Hvor kan du få tilgang til Hy4 og GPT-6.1 Terra?
Tilgang via offisielle leverandører
Få tilgang til Hy4 via Tencent Cloud TokenHub og til GPT-6.1 Terra via OpenAIs API. Bruk leverandørens dokumentasjon for autentisering, modell-ID-er og fakturering.
Tilgang via CometAPI og verktøykompatibilitet
CometAPI tilbyr begge modellene under ID-ene hy4 og gpt-6.1-terra. Modellsidene lister forespørseleksempler og priser for hver rute: Hy4 og GPT-6.1 Terra.
For verktøyaktiverte applikasjoner, verifiser at den valgte ruten støtter funksjonskall og strukturerte utdata. På OpenAIs direkte API krever Terra verktøykalling Responses API.
Slik tester og ruller du ut valget ditt
Før du endrer produksjonstrafikk, sammenlign modellene på representative oppgaver med samme inndata, verktøy og godkjenningskriterier. Registrer vellykkede fullføringer, totalkostnad og medgått tid, og rull deretter gradvis ut den sterkere ruten.
- Inkluder rutineforespørsler og vanskelige saker som betyr noe for brukerne dine.
- Sjekk verktøyargumenter, strukturerte utdata, feil og fullføringsstatus.
- Sett retry-grenser og rollback-utløsere før du sender live-trafikk.
Konklusjon
Velg Hy4 når forskningskvalitet og lavere kostnader for tekstgenerering er dine prioriteringer. Velg GPT-6.1 Terra når terminalkoding, debugging og et større utbudsbudsjett betyr mest.
For en blandet applikasjon, start med én modell per hovedarbeidslast og legg til en sekundær rute der den forbedrer resultatene. Det beste valget er det som fullfører oppgavene dine nøyaktig til en kostnad du kan bære.