

TL;DR
MiMo-V2.5 er det sterkere standardvalget for multimodalt arbeid, rutineagenter og kostnadssensitiv produksjon. MiMo-V2.5-Pro er spesialistvalget for vanskelig resonnering, koding i repo-skala og langvarig verktøybruk. Begge tilbyr et kontekstvindu på 1M tokens og opptil 128K utdata-tokens, men Pro bruker en langt større språk-backbone og koster omtrent 3.1× så mye for ordinære inn- og utdata-tokens.
MiMo-V2.5 vs. Pro: Rask beslutning
| Spesifikasjon — offisiell utgivelse | MiMo-V2.5 | MiMo-V2.5-Pro | Anbefalt modell | Begrunnelse |
|---|---|---|---|---|
| Primær posisjonering | Omni-modal modell og effektive agenter | Flaggskipsagent og kompleks koding | Velg etter arbeidslast | Omni-modale input favoriserer V2.5; vedvarende vanskelig tekstarbeid favoriserer Pro. |
| Arkitektur | Sparse MoE | Sparse MoE | Velg etter arbeidslast | Modellstørrelse alene avgjør ikke det beste valget for enhver oppgave. |
| Totale parametere | 310B | 1.02T | Velg etter arbeidslast | Den større modellen retter seg mot vanskelig resonnering, men total størrelse er ikke et oppgaveutfall. |
| Aktiverte parametere | 15B | 42B | Velg etter arbeidslast | Bruk oppgavefullføring og kostnad til å avgjøre. |
| LLM-lag | 48 | 70 | Velg etter arbeidslast | Antall lag beskriver arkitekturen, ikke en universell seier. |
| Routede eksperter | 256 | 384 | Velg etter arbeidslast | Forskjellen betyr noe bare hvis den forbedrer den aktuelle arbeidslasten. |
| Eksperter aktivert per token | 8 | 8 | Begge | Begge aktiverer åtte eksperter per token. |
| Kontekstvindu | 1M tokens | 1M tokens | Begge | Begge oppgir et 1M-token vindu; test faktisk gjenfinning. |
| Maksimal utdata | 128K tokens | 128K tokens | Begge | Begge oppgir opptil 128K utdata-tokens. |
| Inputmodaliteter | Tekst, bilde, video og lyd | Tekst | MiMo-V2.5 | Den aksepterer bilde-, video- og lydinput; Pro er fokusert på tekstinput. |
| Verktøykalling | Ja | Ja | Velg etter arbeidslast | Begge kaller verktøy; test suksessrate på den faktiske trajektorien. |
| Åpne vekter og lisens | Ja; MIT | Ja; MIT | Begge | Begge tilbyr åpne vekter under MIT; driftskostnader varierer. |
Den avgjørende forskjellen: Multimodal vs agent-først
V2.5 aksepterer naturlig tekst, bilder, video og lyd. Xiaomi kombinerer språk-backbone med en visjonsenkoder på 729M parametere og en lydenkoder på 261M parametere, slik at multimodal informasjon kan delta direkte i samme resonneringsarbeidsflyt.
- Analyser skjermbilder før verktøy kalles.
- Forstå en video og dens lydspor sammen.
- Ekstraher informasjon fra diagrammer og dokumentbilder.
- Betjen agenter for visuelle grensesnitt og multimodal støtte.
- Resonner over lange videosekvenser.
V2.5-Pro følger et annet design. Xiaomi spesifiserer for tiden tekst som inputmodalitet og vektlegger dyp resonnering, kodeutvikling og langvarig verktøyorkestrering.
Hvis arbeidsflyten i seg selv inneholder bilde-, video- eller lydinput, start med V2.5. Test Pro når den vanskelige delen er resonnering over tekst, kildekode, verktøy eller en lang agenttrajektorie.

Offisiell Xiaomi multimodal benchmark-sammenligning.
Hvorfor V2.5-Pro kan være bedre på harde oppgaver
Modellskala: 310B/15B vs. 1.02T/42B
De to modellene bruker sparse Mixture-of-Experts-backbones, hybrid av glidende vindu og global attention, og tre Multi-Token Prediction-moduler. Xiaomis V2.5 model card dokumenterer en 310B-total, 15B-aktiv backbone; Pro model card skalerer dette til 1.02T totale parametere med 42B aktivert per token.
| Arkitektur — offisielt model card | V2.5 | Pro | Forskjell |
|---|---|---|---|
| Totale parametere | 310B | 1.02T | Omtrent 3.3× |
| Aktive parametere | 15B | 42B | 2.8× |
| Skjult dimensjon | 4,096 | 6,144 | 1.5× |
| LLM-lag | 48 | 70 | 22 flere |
| Attention-hoder | 64 | 128 | 2× |
| Routede eksperter | 256 | 384 | 1.5× |
| Eksperter per token | 8 | 8 | Samme |
| MTP-lag | 3 | 3 | Samme |
V2.5 bruker et 5:1 attention-mønster, mens Pro går over til et 6:1 lokal-til-global-mønster. Xiaomi sier at disse designene reduserer KV-cache-kravene med nær 6× og 7× henholdsvis sammenlignet med full attention gjennom hele nettverket.
Totale parametere oversettes ikke lineært til svarkvalitet. Pros større backbone betyr mest når resonneringsvanskelighet eller trajektorielengde gjør at små gevinster i per-trinns pålitelighet forsterkes.
Hvorfor små pålitelighetsgevinster forsterkes
En lang agentoppgave har mange avhengige trinn. En feil i et tidlig verktøykall kan tvinge til nye forsøk eller gjøre senere arbeid ugyldig, så en beskjeden gevinst i per-trinns pålitelighet kan ha større effekt på ende-til-ende fullføring. Evaluer den effekten på representative oppgaver fremfor å anta at modellstørrelse garanterer det.
Hvor forbedrer V2.5-Pro seg faktisk?
Den reneste numeriske sammenligningen er Xiaomis basemodell-evaluering, der begge modellene vises under samme innstillinger. Dette unngår å kombinere resultater produsert av uvedkommende rammeverk eller ettertreningskonfigurasjoner.
Allmennkunnskap: små til moderate gevinster
I Xiaomis basemodell-sammenligning øker Pro med 1.2 poeng på BBH, 3.1 på MMLU og 2.7 på MMLU-Pro. Disse er målbare, men mindre enn gevinstene på vanskeligere resonneringsoppgaver.
Matematikk og naturfag: større gevinster
Pro øker med 8.6 poeng på GPQA-Diamond, 16.3 på GSM8K og 18.5 på MATH i samme basemodell-evaluering. Dette er den tydeligste evidensen for å velge Pro når vanskelig resonnering driver oppgavesuksess.
Koding: bedre, men ikke jevnt over bedre
De rapporterte gevinstene er 4.3 poeng på HumanEval+, 3.2 på MBPP+, 4.1 på LiveCodeBench v6 og 4.9 på SWE-Bench AgentLess. Test oppgaver på repositoriumsnivå og verktøybruk separat: disse basemodell-scorene måler ikke alle produksjonsagent-arbeidsflyter.
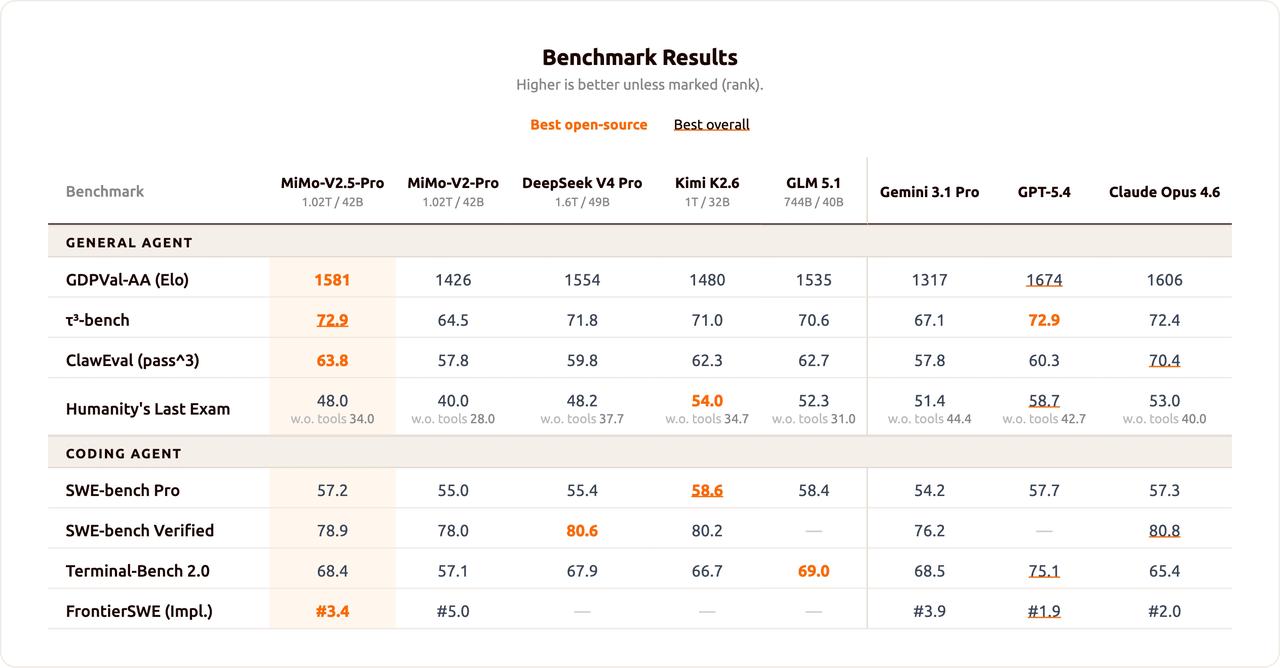
Benchmark-resultat: Pro er ikke tre ganger bedre fordi den koster omtrent tre ganger mer. Den blir gradvis mer verdifull etter hvert som resonneringsvanskelighet og oppgavens varighet øker.
Disse radene er basemodell-evalueringer, ikke et løfte om at en produksjons-API vil reprodusere de samme scorene. Agentresultater avhenger av verktøy, ledetekster, nye forsøk, kjøremiljø og token-budsjett.
Ettertrening og langhorisont-agenter
Produksjonsmodellene legger til veiledet finjustering, agentisk forsterkningslæring og Multi-Teacher On-Policy Distillation. Xiaomi rapporterer ettertreningsscorer på 56.1 på SWE-bench Pro, 65.8 på Terminal-Bench 2.0 og 62.1 Pass³ på den generelle delen av Claw-Eval for V2.5.
Pro er mer eksplisitt optimalisert for programvareutvikling med lang horisont. Xiaomi beskriver hundrevis av verktøykall i vedvarende trajektorier og publiserer et 78.9% SWE-bench Verified-resultat.
Et offisielt kasusstudie viser at Pro fullfører en SysY-kompilator på 4.3 timer med 672 verktøykall og alle 233 tester bestått. Lærdommen er ikke at hver kodingsforespørsel trenger Pro; den er at små pålitelighetsforskjeller kan avgjøre om en arbeidsflyt med hundrevis av avhengige handlinger fullføres.

Offisiell Xiaomi-figur for koding og agent-benchmarks.
Lang kontekst: samme kapasitet, ulike arbeidslaster
Begge modellene tilbyr et kontekstvindu på 1M tokens og opptil 128K utdata-tokens gjennom Xiaomis nåværende API. Rå kontekststørrelse skiller dem derfor ikke.
V2.5 er attraktiv når lang kontekst inkluderer multimodalt materiale som video, dokumentbilder eller visuelle agentspor. Pro er modellen å teste når konteksten i seg selv blir resonneringsproblemet: et stort repositorium, en lang kontrakt, et forskningskorups eller en agenttrajektorie med mange sekvensielle handlinger.
Et stort kontekstvindu beskriver kapasitet, ikke garantert resonneringsfidelitet. Evaluer gjenfinning, instruksjonsretensjon og evidensbruk ved de lengdene som betyr noe for applikasjonen.
Pris og kostnadseffektivitet
Xiaomis utenlandske forbruksbaserte priser gjør avveiningen tydelig.
| Priser — offisielt prisskjema | V2.5 | Pro | Forhold |
|---|---|---|---|
| Ikke-cachet input per 1M tokens | $0.14 | $0.435 | 3.11× |
| Cachet input per 1M tokens | $0.0028 | $0.0036 | 1.29× |
| Utdata per 1M tokens | $0.28 | $0.87 | 3.11× |
| Kontekstvindu | 1M | 1M | Samme |
| Maksimal utdata | 128K | 128K | Samme |
En forespørsel med 1M ikke-cachete input-tokens og 200K utdata-tokens koster anslagsvis $0.196 på V2.5 og $0.609 på Pro før cache-treff, web-søk-kostnader eller leverandørspesifikk fakturering.
Forskjellen i cache-pris er mindre: Pro er omtrent 29% dyrere for cache-treff input i stedet for 211% dyrere. Langvarige agenter med stabile systeminstruksjoner, verktøydefinisjoner eller repositoriumsprefikser bør derfor måle sin faktiske cache-treffrate.
Estimer kostnad per vellykket oppgave. En Pro-agent som fullfører en vanskelig arbeidsflyt én gang kan koste mindre enn gjentatte mislykkede forsøk på en billigere modell.
Hvilken modell bør du bruke?
| Arbeidslast — offisiell veiledning | Bedre valg | Hvorfor |
|---|---|---|
| Rutinemessig tekstchat | V2.5 | Lavere kostnad; Pro ofte unødvendig |
| Høyvolumgenerering | V2.5 | Omtrent 3.1× lavere standard token-pris |
| Forståelse av bilde, video eller lyd | V2.5 | Innebygd multimodal input |
| Rutinemessig verktøykalling | V2.5 | Sterk agentkapabilitet til lavere kostnad |
| Vanskelig matematikk og naturfag | Pro | Større benchmark-gevinster |
| Koding i repo-skala | Pro | Designet for kompleks programvareutvikling |
| Hundrevis av avhengige verktøykall | Pro | Bedre egnet for vedvarende kjøring |
| Kostnadssensitiv 1M-kontekst | V2.5 | Samme nominelle kontekst til langt lavere kostnad |
Valgresultat: V2.5 er standarden for multimodale applikasjoner, rutineagenter og kostnadssensitive arbeidslaster. Pro er oppgraderingen for vanskelig resonnering, kompleks programvareutvikling og lange autonome trajektorier.
En bedre produksjonsstrategi: rute mellom begge
Et enkelt globalt modellvalg er ofte unødvendig. Ruter multimodale og rutineforespørsler til V2.5, og eskaler kun vanskelig tekstresonnering, kompleks koding eller langhorisont-kjøring til Pro.
| Evalueringsdimensjon | Mål | Hvorfor det betyr noe | Rutesignal |
|---|---|---|---|
| Fullføring | Lykkede oppgaver / forsøk | Fanger ende-til-ende-pålitelighet | Eskaler klasser med lav fullføringsgrad |
| Kvalitet | Menneskelig eller rubrikk-score | Hindrer at token-kostnad dominerer | Eskaler høyrisikooppgaver |
| Verktøypålitelighet | Feil og nye forsøk | Små feil forsterkes i agenter | Eskaler lange trajektorier |
| Ventetid | Tid til akseptert resultat | Inkluderer overhead fra nye forsøk | Hold interaktive oppgaver lette |
| Kostnad | Forbruk per akseptert oppgave | Reflekterer feil og gjenkjøringer | Bruk den billigste modellen som lykkes |
Test begge API-ene i CometAPI
MiMo-V2.5 API i CometAPI og MiMo-V2.5-Pro API i CometAPI støtter side-ved-side-evaluering gjennom ett aggregeringslag. Send de samme ledetekstene, systeminstruksjonene, verktøyene og utdata-begrensningene til begge modellene, og sammenlign deretter oppgavesuksess og kostnad.
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.environ["COMETAPI_KEY"],
    base_url="https://api.cometapi.com/v1",
)

models = ["mimo-v2.5", "mimo-v2.5-pro"]
prompt = """
Review this implementation plan.
Identify hidden technical risks and propose the three highest-priority fixes.
"""

for model in models:
    response = client.chat.completions.create(
        model=model,
        messages=[{"role": "user", "content": prompt}],
        max_tokens=2000,
    )
    print(f"\n--- {model} ---")
    print(response.choices[0].message.content)
Kjør en representativ batch som inneholder enkle forespørsler, vanskelig resonnering, kodeendring, oppgaver med lang kontekst og agentverktøykall. Registrer fullføringsrate, tokens, ventetid, verktøyfeil, nye forsøk, svarkvalitet og kostnad per vellykket oppgave.
Begrensninger
V2.5-begrensninger
Den mindre språk-backbone legger igjen ytelse når resonneringsvanskeligheten øker. Gapet er beskjedent på BBH, men blir mye større på GPQA-Diamond og MATH. Et kontekstvindu på 1M tokens bør heller ikke forveksles med garantert resonneringsfidelitet på 1M tokens.
Pro-begrensninger
Pros ordinære inn- og utdata-priser er omtrent 3.1× høyere enn V2.5, og dens tekstonly input gjør den uegnet som direkte erstatning for multimodale applikasjoner. Den 1.02T-parameter åpne-vekt-modellen er også et krevende selvhostingsprosjekt selv om 42B parametere aktiveres per token.
Endelig konklusjon
Velg V2.5 for multimodale applikasjoner, rutineagenter og kostnadssensitiv produksjon. Velg Pro for vanskelig resonnering, kompleks programvareutvikling og langvarige autonome agenter. For blandede arbeidslaster, ruter mest trafikk til V2.5 og eskaler kun forespørsler hvis vanskelighet eller trajektorielengde rettferdiggjør den ekstra kostnaden.
FAQ
Er Pro alltid bedre enn V2.5?
Nei. Pro er sterkere på vanskelig tekstresonnering og koding, men V2.5 støtter bilde-, video- og lydinput og er betydelig billigere.
Støtter begge modellene et kontekstvindu på 1M tokens?
Ja. Begge oppgir 1M tokens kontekst og opptil 128K utdata-tokens. Applikasjoner bør likevel teste gjenfinning og resonnering ved sine faktiske driftslengder.
Hvilken modell bør en multimodal agent bruke?
Begynn med V2.5 fordi den naturlig aksepterer visuell og lydinput. Pro retter seg for tiden mot arbeidsflyter med tekstinput.
Når er Pro verdt sin høyere pris?
Den er mest forsvarlig når bedre resonneringspålitelighet påvirker fullføring av vanskelig matematikk, koding i repositoriumsskala eller lange trajektorier med mange avhengige verktøykall.
Bør produksjonssystemer bruke bare én modell?
Ikke nødvendigvis. Et rutingslag kan holde rutine- og multimodalt arbeid på V2.5, mens vanskelig tekst og agentoppgaver eskaleres til Pro.