Tekniske spesifikasjoner for Qwen3.8-Flash
| Spesifikasjon | Qwen3.8-Flash |
|---|---|
| Leverandør | Alibaba / Qwen |
| Modellfamilie | Qwen3.8 |
| Modell-ID | qwen3.8-flash |
| Modelltype | Multimodal resonneringsmodell |
| Inndata-modaliteter | Tekst, bilde, video |
| Utdatamodalitet | Tekst |
| Kontekstvindu | 1,000,000 tokens |
| Maksimalt utdata | 128,000 tokens |
| Maksimalt resonneringsbudsjett | 262,144 tokens |
| Tenkemodus | Støttet |
| Funksjonskall | Støttet |
| Innebygde verktøy | Støttet |
Qwens gjeldende API-dokumentasjon oppfører qwen3.8-flash som en produksjonsmodell i Qwen3.8-familien med et 1M-token kontekstvindu og 128K maksimalt utdata. Den støtter tekst-, bilde- og videoinndata, funksjonskall, innebygde verktøy og strukturert utdata.
For visuelle arbeidslaster inkluderer de dokumenterte begrensningene opptil 16 megapiksler per bilde, opptil 2,048 bilde-URL-er eller 250 Base64-bilder, og opptil 64 videoer, med videoer på opptil 2 timer.
Hva er Qwen3.8-Flash?
Qwen3.8-Flash er Alibabas kostnadseffektive multimodale resonneringsmodell i Qwen3.8-familien, designet for koding, agentiske arbeidsflyter, langkontekst-analyse og visuell forståelse. Den tilbyr samme 1M-token kontekstklasse som Qwen3.8-Max, samtidig som den sikter mot vesentlig lavere API-kostnad. Qwens egne utviklerveiledninger anbefaler uttrykkelig Qwen3.8-Flash når brukere ønsker lignende evner til lavere pris, mens Qwen3.8-Max er posisjonert som det sterkere alternativet for resonnering.
Modellen er spesielt interessant fordi «Flash» ikke betyr en enkel, liten modell. Produksjons-API-modellen kombinerer langkontekst-resonnering, multimodal inndata, verktøybruk og strukturert utdata i et relativt rimelig endepunkt.
Hva er hovedfunksjonene i Qwen3.8-Flash?
- 1M-token kontekst: Qwen3.8-Flash kan behandle svært lange dokumenter og kodebaser, noe som gjør den egnet til repository-analyse og langvarige agentsesjoner.
- Multimodal forståelse: API-et aksepterer tekst, bilder og video, slik at utviklere kan kombinere kode, skjermbilder, diagrammer, dokumenter og video i én arbeidsflyt.
- Resonnersmodus: Modellen støtter Qwens tenkemodus, med et dokumentert maksimalt resonneringsbudsjett på 262,144 tokens.
- Agent- og verktøystøtte: Funksjonskall og innebygde verktøy er støttet, inkludert kapabiliteter som websøk, kodekjøring og relaterte Qwen-hostede verktøy.
- Strukturert utdata: Utviklere kan be om strukturerte svar, noe som gjør modellen enklere å integrere i applikasjoner som krever JSON eller skjema-avgrensede resultater.
- Forståelse av lange videoer: Den visuelle API-dokumentasjonen oppgir videoinndata på opptil to timer, noe som gjør Qwen3.8-Flash nyttig for videoanalyse og ikke bare korte bildetekst-oppgaver.
Hva er de beste bruksområdene for Qwen3.8-Flash?
Koding og programvareutvikling
1M-token konteksten er nyttig for store kodebaser, lange feilsøkingsøkter og flerfil-kodeanalyse. Modellens støtte for funksjonskall og resonnering gjør den også egnet for kodeagenter, ikke bare kodefullføring.
Agent-baserte arbeidsflyter
Qwen3.8-Flash støtter funksjonskall og innebygde verktøy, slik at en applikasjon kan la modellen hente informasjon, kjøre kode eller samhandle med eksterne systemer.
Analyse av lange dokumenter
Et million-token kontekstvindu gjør modellen egnet for store kontrakter, teknisk dokumentasjon, forskningssamlinger og bedriftskunnskapsbaser der gjentatt oppdeling ellers ville vært nødvendig.
Video- og visuell analyse
Qwen3.8-Flash aksepterer både bilder og video. De gjeldende visuelle API-begrensningene tillater videoer på opptil to timer, noe som gjør den relevant for møteopptak, opplæringsvideoer, forelesninger, demonstrasjoner og analyse av langformat visuelt innhold.
Kostnadssensitiv produksjons-AI
Dette er antakelig modellens største kommersielle fordel. Qwen anbefaler uttrykkelig Flash som det rimeligere alternativet til Qwen3.8-Max, noe som gjør den egnet for høyvolumsapplikasjoner der flaggskipsnivå resonnering ikke er nødvendig ved hver forespørsel.
Hva er begrensningene til Qwen3.8-Flash?
Qwen3.8-Flash bør ikke tolkes som den best-ytende modellen i Qwen3.8-familien bare fordi den deler 1M-kontekstvinduet med Qwen3.8-Max.
Den viktigste avveiningen er kapasitet kontra kostnad: Qwen anbefaler Qwen3.8-Max når den sterkeste resonneringsytelsen kreves.
En annen vurdering er at et 1M-kontekstvindu ikke betyr at hver forespørsel bør inneholde én million tokens. Store kontekster øker prosesseringskravene, og utviklere bør bruke gjenfinning, caching og konteksthåndtering når hele konteksten ikke er nødvendig.
Til slutt bør utviklere skille den hostede qwen3.8-flash fra open-weight Qwen3.8-Flash-Next. Sistnevnte er en arkitektonisk forhåndsvisning og har separat dokumenterte vekter og arkitektur; produksjons-API-modellen bør dokumenteres i henhold til sine egne API-spesifikasjoner.
Er Qwen3.8-Flash egnet for produksjons-API-applikasjoner?
Ja, særlig når applikasjonen trenger multimodal resonnering, lang kontekst, verktøybruk og relativt lav token-kostnad.
Den er en sterkere produksjonskandidat enn Flash-Next når kravet er ganske enkelt å kalle et hostet Qwen-API, fordi qwen3.8-flash eksplisitt er eksponert som en produksjonsmodell i Qwens API-dokumentasjon med definert kontekst, utdata, verktøy og multimodale begrensninger.
For maksimal resonneringskvalitet forblir Qwen3.8-Max det mer passende valget. For høyvolumsarbeidslaster der kostnad og gjennomstrømning betyr mer, er Qwen3.8-Flash det mer økonomiske alternativet.
Parametere for Qwen3.8-Flash API
En standard OpenAI-kompatibel forespørsel kan bruke parametere som:
| Parameter | Formål |
|---|---|
| model | qwen3.8-flash |
| messages | Samtale og multimodal inndata |
| temperature | Styring av sampling |
| max_tokens | Maksimalt generert utdata |
| stream | Strømmende svar |
| tools | Funksjons-/verktøydefinisjoner |
| tool_choice | Atferd for verktøyvalg |
| response_format | Konfigurasjon for strukturert utdata |
| enable_thinking | Aktiverer tenkemodus i støttede Qwen-API-er |
Quick-start-dokumentasjonen bruker OpenAI SDK med modellidentifikatoren qwen3.8-flash. Eksempelet aktiverer resonnering med extra_body={"enable_thinking": True}.
Slik bruker du qwen3.8-flash API i CometAPI
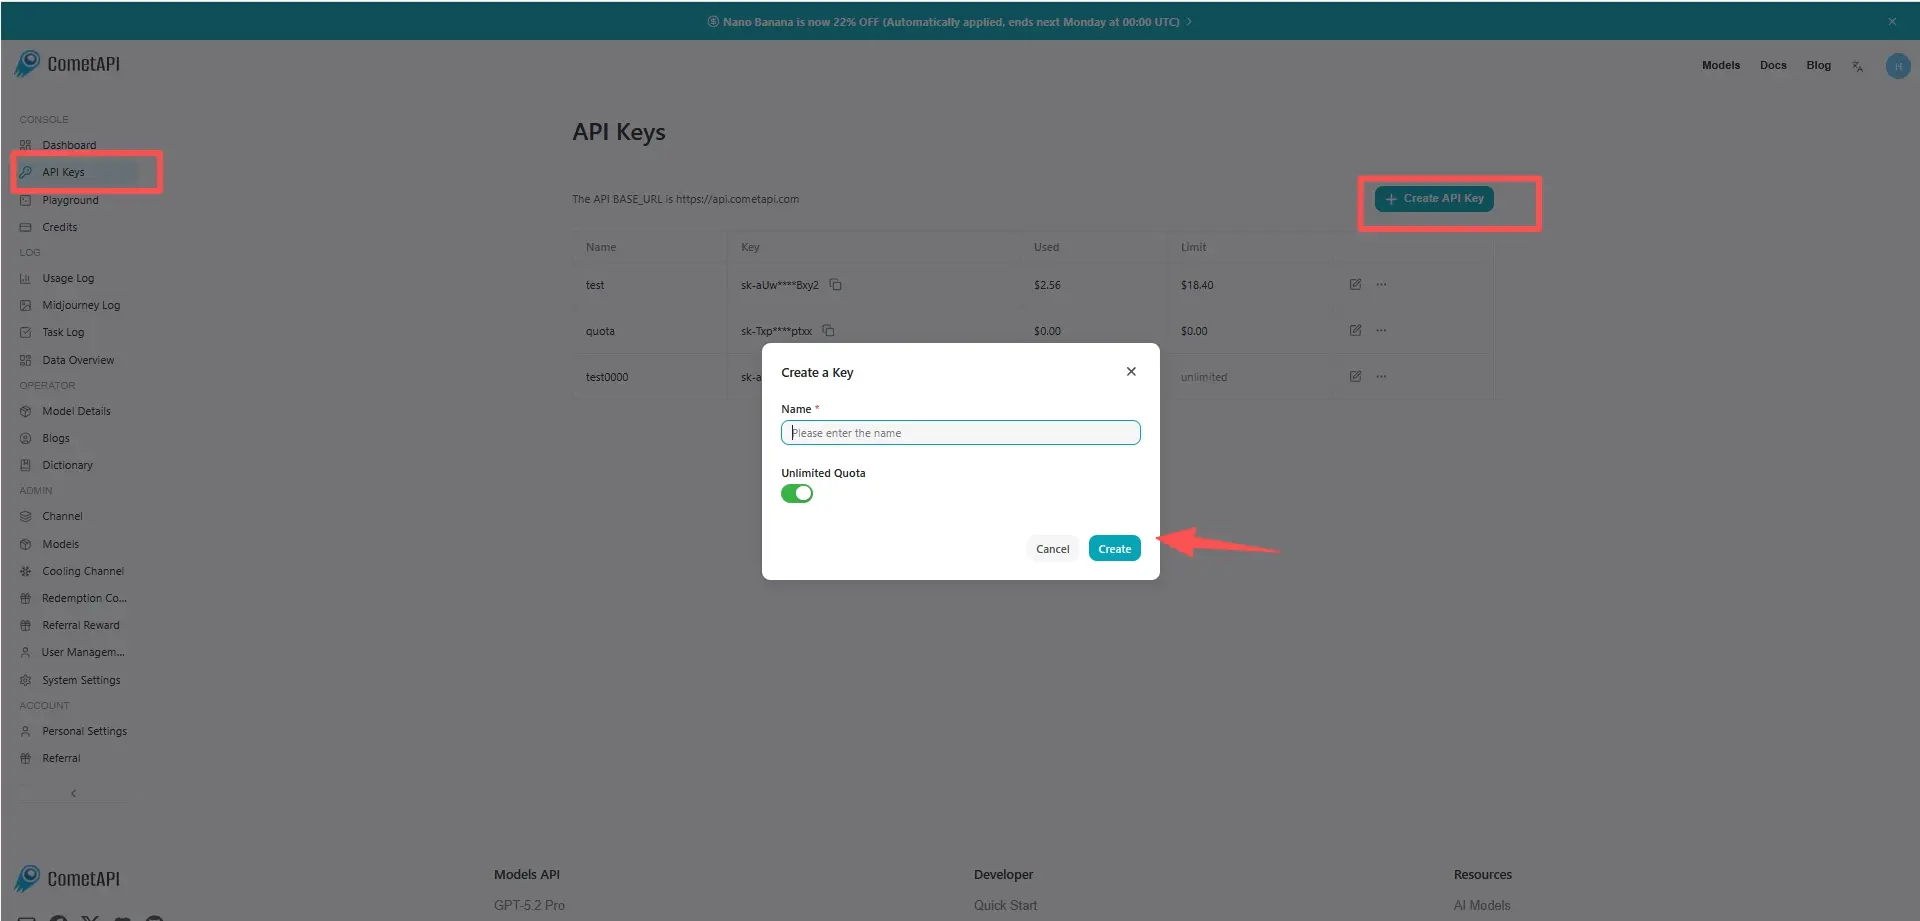
Trinn 1: Få API-tilgang
Logg inn på cometAPI. Hvis du ikke er bruker ennå, registrer deg først. Logg inn på din CometAPI-konsoll. Hent API-nøkkelen for tilgang. Klikk «Add Token» under API token i det personlige senteret, hent token-nøkkelen: sk-xxxxx og send inn.
Trinn 2: Send forespørsler til qwen3.8-flash API
Velg endepunktet «qwen3.8-flash» for å sende API-forespørselen og sett forespørselskroppen. Forespørselsmetoden og forespørselskroppen hentes fra API-dokumentasjonen på nettstedet vårt. Nettstedet vårt tilbyr også Apifox-test for din bekvemmelighet. Erstatt <YOUR_API_KEY> med din faktiske CometAPI-nøkkel fra kontoen din.
Sett inn spørsmålet eller forespørselen din i content-feltet—det er dette modellen vil svare på. Behandle API-responsen for å hente det genererte svaret. Den støtter AI SDK, OpenAI Chat Completions, OpenAI Responses og grensesnitt kompatible med Anthropic Messages.
Trinn 3: Behandle svar
API-et returnerer strukturerte kandidatrespons, inkludert generert tekst, referanser, sikkerhetsmetadata og valgfrie verktøyutdata. For multimodale forespørsler kan meldingsinnhold struktureres med tekst- og bildeenndata når det valgte CometAPI-endepunktet eksponerer modellens visjonskapabilitet.