
TL;DR
Muse Wonder, Claude Opus 5.5 og GPT-6 Sol er modeller med høy kapasitet, posisjonert for koding og agent-arbeidsflyter. Metas nye Muse Wonder vektlegger vedvarende minne og langvarig kjøring; Opus 5.5 leder den siterte aggregerte intelligensindeksen; GPT-6 Sol har de laveste standardprisene for kort kontekst på inndata og utdata i denne sammenligningen, mens langkontekst-nivået prises separat. Velg basert på representativ oppgavekvalitet, pålitelighet og totalkostnad, ikke en enkelt toppliste-score.
Hovedpunkter
- Overordnet intelligens: Claude Opus 5.5 scorer 58 mot Muse Wonders 52 på den rapporterte Intelligence Index v4.3.
- Langsiktig koding: Muse Wonder oppnår 78.8 på DeepSWE 1.1 og 53.1 på SWE-Marathon; Opus 5.5 noterer 74.2 og 46.3 i Metas tabell.
- Rimelig resonnement: GPT-6 Sol starter på $2 inndata / $10 utdata per million tokens via OpenAIs standard-API for kort kontekst.
- Minnefokuserte agenter: Muse Wonder introduserer Active Memory og Active Focus.
- Tilgjengelighet betyr noe: Muse Wonder Full er et separat, mer begrenset produkt enn den utvikler-tilgjengelige standarden Muse Wonder.
Muse Wonder vs Claude Opus 5.5 vs GPT-6 Sol i korte trekk
Velg Muse Wonder for vedvarende agenter og langvarig ingeniørarbeid, Claude Opus 5.5 for bred koding og terminaltunge arbeidsflyter, og GPT-6 Sol for lavere standardpriser på tokens med kort kontekst.
| Beslutningsfaktor | Muse Wonder | Claude Opus 5.5 | GPT-6 Sol |
|---|---|---|---|
| Start testingen med | Vedvarende agenter og utvidet ingeniørarbeid | Terminaltung koding og profesjonelle arbeidsløp | Budsjettfølsom koding og automatisering |
| Kontekstvindu | 1,048,576 tokens | 1M tokens | 1,050,000 tokens |
| Publisert styrke | DeepSWE 78.8; SWE-Marathon 53.1 | Intelligence Index 58; ProgramBench 70.5 | Standard inndata/utdata $2/$10 per 1M tokens |
| Standard inndata / utdata per 1M tokens | $4 / $20 | $4 / $20 | $2 / $10; nivå for kort kontekst |
| Tilgang via leverandør | Meta Model API; Full er et separat abonnementsprodukt | Anthropic API | OpenAI API |
| Valgmetrikk | Akseptert oppgavekvalitet og totalkostnad | Akseptert oppgavekvalitet og totalkostnad | Akseptert oppgavekvalitet og totalkostnad |
| Utvikler | Meta | Anthropic | OpenAI |
| Lansering | 12. oktober 2026 | 22. september 2026 | 16. september 2026 |
| Inndatamodaliteter | Tekst, bilde, lyd, video; PDF-inndata dokumentert | Tekst, bilde | Tekst, bilde |
| Utdata | Tekst | Tekst | Tekst |
| Særtrekk | Active Memory og Active Focus | Verktøy- og subagent-arbeidsflyter | Konfigurerbar resonnementinnsats og API-verktøy |
Denne oversikten oppsummerer daterte spesifikasjoner og publiserte resultater gjennomgått nedenfor. Benchmark-rader bruker ulike evalueringsmetoder, og lave tokenpriser gir ikke nødvendigvis lavere kost per vellykket oppgave. Standard Muse Wonder og Muse Wonder Full er separate tilgangsvalg.
Spesifikasjoner ble sjekket 13. oktober 2026. Støttede modaliteter og funksjoner avhenger av valgt endepunkt og utgivelsesflate, inkludert lydtilgjengelighet. Modellnivåets kapabiliteter garanterer ikke støtte på alle gateway-ruter.
Muse Wonder vs Claude Opus 5.5 vs GPT-6 Sol: Oversikt og spesifikasjoner
Muse Wonder: Vedvarende agent-arbeidsflyter
Meta introduserte Muse Wonder og Muse Wonder Full 12. oktober 2026. Standard Muse Wonder vektlegger langvarige profesjonelle oppgaver, vedvarende agentminne og gjenoppretting fra hindringer. Active Memory er ment å hente nyttig tidligere kontekst, mens Active Focus er designet for å opprettholde fremdrift gjennom flerstegs arbeid. Meta beskriver koding, forskning, finansanalyse og personlig assistanse som nøkkelscenarier.
Claude Opus 5.5: Profesjonell koding og verktøybruk
Claude Opus 5.5 retter seg mot koding, resonnement og profesjonelle arbeidsflyter med flere verktøy. Anthropic lanserte den 22. september 2026. Kontekstvinduet er én million tokens, mens de rapporterte koderesultatene nedenfor viser styrker som varierer med benchmark.
GPT-6 Sol: Kostnadsbevisst resonnement
GPT-6 Sol har som mål å kombinere sterkt resonnement og verktøybruk med relativt rimelig kjøring. Den støtter programatiske arbeidsflyter gjennom OpenAIs API-økosystem. Standardprisene for kort kontekst er lavere enn de oppførte prisene for Claude Opus 5.5, selv om totaløkonomien også avhenger av forsøk på nytt og bruk av resonnementstokens.
OpenAI beskriver GPT-6 Sol som en modell for kompleks koding og agentiske arbeidsflyter; lanseringsinnlegget gir evalueringsresultatene brukt nedenfor. Denne artikkelen sammenligner de spesifiserte modellversjonene, ikke alle nyere modeller i hver leverandørs portefølje.
Arkitektur og styring av resonnement
Kildene som siteres her gir ikke en sammenlignbar oversikt over antall parametere og arkitektur for alle tre modellene. Ingen rangering tett nettverk kontra mixture-of-experts er derfor berettiget. Active Memory og Active Focus beskriver Metas agentkapabiliteter; de er ikke erstatninger for en offentliggjort nevralt arkitektur. GPT-6 Sol eksponerer konfigurerbar resonnementinnsats, mens rapporterte Meta- og Claude-score også avhenger av innsats og evalueringsoppsett. Behandle disse innstillingene som en del av konfigurasjonen som sammenlignes, ikke som utskiftbare mål på compute.
Sammenligningsresultat: Alle tre tilbyr store kontekstvinduer og utvikler-API-er. Muse Wonder dokumenterer bredere modellnivå-inndatamodaliteter; Opus 5.5 og GPT-6 Sol vektlegger tekst- og bildearbeidsflyter. Kontekstkapasitet og funksjonstilgjengelighet må fortsatt sjekkes på valgt endepunkt.
Muse Wonder vs Claude Opus 5.5 vs GPT-6 Sol: Ytelse
Publiserte benchmarker og kildegrenser
Metas offisielle modellkort tilbyr direkte sammenligninger mellom Muse Wonder og Claude Opus 5.5. OpenAI publiserer GPT-6 Sol-resultater separat, så de tre modellene kan ikke plasseres på en fullt kontrollert toppliste uten å harmonisere evalueringsrammeverk, versjoner og innstillinger.
| Benchmark | Muse Wonder | Claude Opus 5.5 | Høyere score |
|---|---|---|---|
| Artificial Analysis Intelligence Index v4.3 | 52 | 58 | Opus |
| Personal Superintelligence Index | 54.3 | 55.2 | Opus |
| Harvey LAB-AA | 10.0 | 4.2 | Muse |
| Vals Finance Agent V2 | 56.6 | 58.6 | Opus |
| AutomationBench-AA | 39.1 | 41.2 | Opus |
| JobBench | 70.5 | 75.4 | Opus |
| MemoryBench | 85.6 | 81.5 | Muse |
| Terminal-Bench 4.0-AA | 52.0 | 59.6 | Opus |
| DeepSWE 1.1 | 78.8 | 74.2 | Muse |
| SWE-Marathon | 53.1 | 46.3 | Muse |
| ProgramBench | 50.0 | 70.5 | Opus |
| HealthBench Pro | 60.5 | 65.6 | Opus |
Den offisielle metodikken for modellkort skiller mellom interne tester, tredjepartsevalueringer og leverandørrapporterte konkurrentscore. Tabellens verdier er gjengitt fra rapportene; den etablerer ikke en enhetlig, uavhengig kontrollert test på tvers av alle rader.
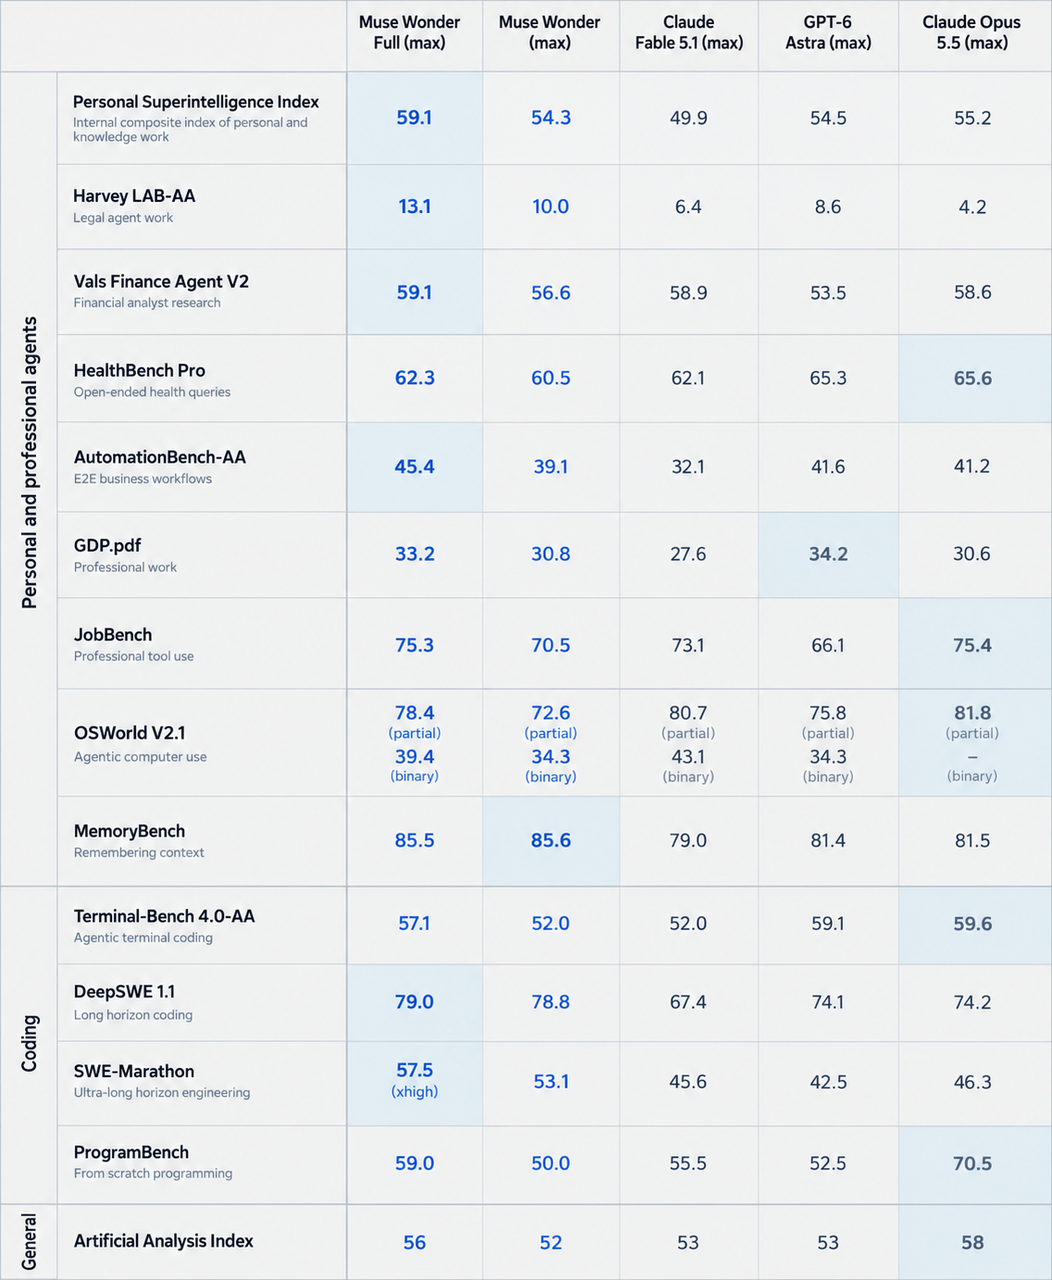
Opprinnelig benchmark-scorekort fra Metas modellkort for Muse Wonder, gjengitt uten opptegning. Den ekstra OpenAI-modellen som vises i dette offisielle bildet er GPT-6 Astra, ikke GPT-6 Sol. De omkringliggende tabellene identifiserer modellene som er relevante for denne artikkelen.
Evalueringsbetingelser
DeepSWE v1.1 dekker 113 oppgaver på tvers av 91 repositorier og fem språk, vurdert ved funksjonelle tester og regresjonstester med pass@1; Metas scorekort bruker Datacurve-resultater for Muse Wonder og Opus 5.5. SWE-Marathon bruker prosjekttester og rapporterer pass@1 fra Abundant AI; agentoppsett varierer, og Wonder Fulls score er merket xhigh. ProgramBench bruker mini-swe-agent og måler utrullinger som passerer minst 95% av skjulte tester, med internett deaktivert etter oppsett. MemoryBench er Metas interne 64K–100K-token samtaletest vurdert av en LLM-dommer. Disse miljøene og målene bør ikke slås sammen til én generell nøyaktighetsscore.
Koding og programvareutvikling
Muse Wonder leder på de rapporterte resultatene for DeepSWE 1.1 og SWE-Marathon. Claude Opus 5.5 leder på Terminal-Bench 4.0-AA og ProgramBench. Denne delingen antyder at langsiktig ingeniørarbeid, kommandolinjeverktøybruk og programrekonstruksjon stresser ulike ferdigheter.
GPT-6 Sol-resultater og sammenlignbarhet på tvers av kilder
| Publisert OpenAI-evaluering | GPT-6 Sol | Rapportert innstilling |
|---|---|---|
| DeepSWE 1.1 | 68.8% | Maks resonnement |
| AutomationBench 1.0.6 | 33.2% | xhigh resonnement |
| Agents' Last Exam V1 | 56.4% | Maks resonnement |
| OSWorld 2.0 offline | 60.5% | xhigh resonnement |
OpenAIs publiserte evalueringsresultater rapporterer score over. OSWorld-resultatet er delvis belønning på offline-settet v2026.08.08, snarere enn en strikt oppgavefullføringsrate. OpenAI bemerker at evalueringer brukte deres forskningsmiljø eller API; produksjonskonfigurasjoner kan avvike.
De rapporterte DeepSWE-scorene tilsier et gap på 10.0 prosentpoeng mellom Muse Wonder og GPT-6 Sol, og 5.4 poeng mellom Opus 5.5 og GPT-6 Sol. Dette er aritmetiske forskjeller mellom publikasjoner, ikke kontrollerte estimater av en ren modellfordel. Ulike agentoppsett, prompt, innsatsnivåer og verktøybudsjetter kan påvirke resultatet.
Minne og langvarige agenter
Muse Wonder retter seg mot agenter som må huske tidligere beslutninger, gjenopprette kontekst og fortsette avbrutt arbeid. Active Memory kan hjelpe en forskningsassistent å huske prosjektrelaterte fakta, mens Active Focus støtter iterativ handling når en tidligere plan ikke lykkes. Disse produktkapabilitetene erstatter ikke tilstandsverifisering, tillatelser, kontrollspor eller påkrevd menneskelig bekreftelse for sensitive handlinger.
Muse Wonder Full-ytelse
Muse Wonder Full er et separat produktvalg. Meta tilbyr standard Muse Wonder gjennom sitt API, mens Full er begrenset til Power Usage- og Maximum Usage-abonnementene i Muse Code. En høyere score gjør ikke Full til en API-erstatning for standardmodellen.
Metas rapporterte Wonder Full-resultater er 56 på Intelligence Index, 59.1 på Personal Superintelligence, 13.1 på Harvey LAB-AA og 45.4 på AutomationBench-AA. Den oppnår også 79.0 på DeepSWE 1.1, 57.5 på SWE-Marathon, 85.5 på MemoryBench og 75.3 på JobBench. Disse publiserte resultatene beskriver det separat tilgjengelige Full-produktet; de er ikke nye målinger fra en felles ramme-sammenligning.
Sammenlignet med standard Muse Wonder-score over, forbedrer Full seg på sju av disse åtte rapporterte målene; MemoryBench er litt lavere med 85.5 mot 85.6. Opus 5.5 leder fortsatt den rapporterte Intelligence Index med 58.
Latens og pålitelighet
De siterte kildene gir ikke en matchet latenssammenligning for alle tre modellene. Mål tid til første nyttige utdata, median og 95-persentil ende-til-ende oppgavetid, timeouts-frekvens og fullføring uten inngripen. Hold oppgaveinndata, verktøytillatelser, samtidighet og akseptkriterier faste; registrer innsatsinnstillinger og forsøk på nytt-budsjetter. Raskere tokengenerering alene etablerer ikke raskere fullføring av en flerstegs oppgave.
Sammenligningsresultat: Muse Wonder leder de siterte testene for vedvarende ingeniørarbeid, mens Opus 5.5 leder de siterte terminal- og programrekonstruksjonstestene. GPT-6 Sol forblir et kandidatvalg med lavere tokenpris, men tilgjengelige publikasjoner beviser ikke en kvalitets- eller fartsrangering i likt miljø på tvers av alle tre.
Muse Wonder vs Claude Opus 5.5 vs GPT-6 Sol: Kostnad
Offisielle API-tokenpriser
| Pris per 1M tokens | Muse Wonder | Claude Opus 5.5 | GPT-6 Sol |
|---|---|---|---|
| Standard inndata | $4 | $4 | $2 |
| Standard utdata | $20 | $20 | $10 |
| Cachet inndata | $0.20 | $0.20 | $0.20 |
| Inndata med lang kontekst | $4 | $4 | $4 |
| Utdata med lang kontekst | $20 | $20 | $15 |
| Cachet inndata (lang kontekst) | $0.20 | $0.20 | $0.40 |
Meta publiserer $4 inndata, $20 utdata og $0.20 cachet inndata per million tokens. Anthropic oppgir Opus 5.5 til $4 inndata, $20 utdata og $0.20 cache-treff per million tokens. OpenAIs prisoversikt lister GPT-6 Sol til $2/$10 for inndata/utdata med kort kontekst og $4/$15 for lang kontekst; priser for cachet inndata varierer også etter nivå. Anvend relevant kontekstnivå per forespørsel, prosesseringsmodus og endepunktsbetingelser før du estimerer en arbeidsbelastning.
For GPT-6 Sol prises forespørsler som inneholder mer enn 272,000 inndatatokens høyere:
- Inndatatokens: 2× standardprisen, fra $2 til $4 per million tokens.
- Cachede inndatatokens: 2× standardprisen, fra $0.20 til $0.40 per million tokens.
- Utdata-tokens: 1.5× standardprisen, fra $10 til $15 per million tokens.
Disse høyere prisene gjelder for hele forespørselen, ikke bare for tokens som overstiger 272,000. En forespørsel med 272,001 inndatatokens går derfor inn i prisnivået for lang kontekst for alle sine inndata-, cachet inndata- og utdata-tokens.
Til sammenligning innfører ikke Muse Wonder og Claude Opus 5.5 et tilsvarende prispåslag for lang kontekst under sine standard API-priser.
Denne forskjellen er særlig viktig for stordokumentanalyse, koding på tvers av hele repositorier og langvarige AI-agenter, der GPT-6 Sols prisfordel for kort kontekst kan bli mindre etter hvert som forespørsler blir større.
CometAPI-priser og faktureringsbetingelser
På anmeldelsestidspunktet listet CometAPI Opus 5.5 til $3.20 inndata / $16 utdata og GPT-6 Sol til $1.60 inndata / $8 utdata per million tokens. Dette er CometAPIs uavhengige priser og må ikke blandes sammen med de offisielle leverandørprisene over. Bekreft gjeldende rute, kontekstnivå og kontobetingelser før kostnadsestimering; priser og betingelser kan endres.
Kostnad per godkjent oppgave
Beregn kostnad per godkjent oppgave som total fakturert modell- og verktøybruk, inkludert belastede forsøk på nytt og fallbacks, delt på antall utdata som møter forhåndsdefinerte akseptkriterier. Registrer menneskelig gjennomgangstid separat eller konverter den med en eksplisitt timepris. Spor mislykkede forespørsler og faktiske kostnader uavhengig: feil alene etablerer ikke om en forespørsel ble belastet.
Sammenligningsresultat: GPT-6 Sol har de laveste oppførte standardprisene for inndata og utdata med kort kontekst, mens Muse Wonder og Opus 5.5 har like oppførte basispriser. Faktisk kostnad per godkjent oppgave avhenger av valgt faktureringsrute, cachebruk, kontekstnivå, verktøygebyrer, forsøk på nytt og gjennomgangsinnsats.
Muse Wonder vs Claude Opus 5.5 vs GPT-6 Sol: Sammenligning og valg
Kapabilitet og arbeidsbelastningsbasert valg
- For bred koding og terminal-arbeidsflyter, start med Claude Opus 5.5 fordi den leder de siterte resultatene for Intelligence Index, Terminal-Bench og ProgramBench. Valider den på refaktorering, verktøykjøring og programnivå-konsistens.
- For utvidede ingeniørprosjekter, start med Muse Wonder fordi de rapporterte resultatene for DeepSWE og SWE-Marathon er sterkere enn for Opus 5.5. Mål oppgavefullføring, gjenoppretting fra hindringer og total oppgavekostnad.
- For vedvarende personlige agenter, start med Muse Wonder fordi den tilbyr Active Memory og Active Focus og har høyere rapportert MemoryBench-score enn Opus 5.5. Test gjenkalling, korreksjoner, kontinuitet og prosjektisolasjon.
- For flerstegs verktøy-arbeidsflyter, evaluer alle tre modellene. Muse tilbyr Active Focus, Opus vektlegger verktøyorkestrering, og GPT-6 Sol støtter Responses API-verktøy. Sammenlign hele agentstakken, inkludert verktøytillatelser, forsøk på nytt og tilstandshåndtering.
- For profesjonelle dokumenter og analyse, evaluer Muse Wonder eller Claude Opus 5.5. Muse har spesialiserte styrker, mens Opus har den sterkere siterte aggregerte indeksen. Bruk representative dokumenter og oppgavespesifikke akseptkriterier.
- For høyt volum og kostnadsfølsom automatisering, start med GPT-6 Sol fordi den har de laveste oppførte standardprisene for inndata og utdata med kort kontekst. Sjekk kostnad per godkjent oppgave, kontekstnivåer, latens og forsøk på nytt.
- For Metas mest avanserte alternativ, vurder Muse Wonder Full hvis det er tilgjengelig. Den har høyere rapporterte score på flere spesialiserte oppgaver, men er separat fra standard API-modellen. Bekreft abonnementsadgang og egnethet før testing.
Profesjonell koding
Claude Opus 5.5 er et godt standardvalg for team som trenger en bred ingeniørassistent, særlig der verktøykjøring, refaktorering og programnivå-konsistens er viktige. De rapporterte fordelene på Terminal-Bench og ProgramBench styrker dette, selv om team bør validere hele agentstakken og ikke bare modellen.
Automatisering i stort volum
GPT-6 Sol er attraktiv når forespørsler er mange og kostnadsfølsomheten er høy. Selv en moderat kvalitetsmangel kan være akseptabel for lavrisiko, lett kontrollerbare oppgaver som å utarbeide dokumentasjon, ekstrahere strukturerte felt eller forklare kode. For lange autonome kjøringer, følg kvalitet, tokens, latens og forsøk på nytt samlet.
Sjekkliste for evaluering i produksjon
Evaluering i produksjon bør spore seks metrikker: korrekthet, målt ved aksepterte svar eller beståtte tester; pålitelighet, målt ved oppgaver fullført uten menneskelig inngripen; latens, målt ved ende-til-ende oppgavsvarighet; tokenbruk, målt ved total fakturert inndata og utdata; agenteffektivitet, målt ved verktøykall og korrigerende forsøk på nytt; og effektiv kostnad, beregnet som total forbruk delt på aksepterte oppgaver.
Sammenligningsresultat: Sett Muse Wonder på kortlisten for vedvarende agentatferd og utvidet ingeniørarbeid, Opus 5.5 for brede kode-arbeidsflyter med sterke terminalkrav, og GPT-6 Sol når tokenkostnad er en sentral begrensning. Forfrem et kandidatvalg først etter at det oppfyller oppgavespesifikke krav til kvalitet og pålitelighet.
Hvor kan du få tilgang til Muse Wonder, Claude Opus 5.5 og GPT-6 Sol?
Offisiell leverandørtilgang
Bruk Meta Model API for standard Muse Wonder, Anthropic API for Opus 5.5, eller OpenAI API for GPT-6 Sol. Muse Wonder Full er tilgjengelig gjennom de angitte Muse Code-abonnementsplanene snarere enn som en direkte erstatning for standard API-modellen. Sjekk kontotilgang, bruksgrenser og støttede forespørselsfunksjoner for ruten du velger.
CometAPI-tilgang
En samlet gateway kan forenkle autentisering, fakturering og ruting. Bruk en høytytende modell for kompleks arkitekturgjennomgang og en rimeligere modell for repetitiv, lavrisiko utarbeidelse. Modellidentifikatoren og støttet forespørselsformat bør alltid sjekkes opp mot mål-API-endepunktet.
Utviklere kan få tilgang til Claude Opus 5.5 API i CometAPI og GPT-6 Sol API i CometAPI for å evaluere representative arbeidsbelastninger. Bekreft støttet API-overflate for hver modell i stedet for å anta at en felles gateway gjør alle forespørselsformater utskiftbare.
CometAPI-rutene som siteres i denne artikkelen dekker Opus 5.5 og GPT-6 Sol. Denne artikkelen etablerer ikke en CometAPI-rute for Muse Wonder eller Wonder Full; bruk bekreftet leverandørrute når du evaluerer disse produktene.
Konklusjon
Ingen enkelt modell vinner på tvers av alle arbeidsbelastninger. Muse Wonder er det sterkeste kandidaten å teste for vedvarende agentatferd og langvarige ingeniøroppgaver. Claude Opus 5.5 er en sterk kandidat for bred koding, terminaltunge arbeidsflyter og kunnskapsarbeid, og den leder Artificial Analysis Intelligence Index-verdien rapportert av Meta. GPT-6 Sol tilbyr de laveste standardprisene for tokens med kort kontekst og er attraktiv for kostnadsfølsom automatisering. Produksjonsteam bør ta det endelige valget basert på akseptert oppgavekvalitet, pålitelighet, latens, forsøk på nytt, verktøybruk og totalkostnad på representative arbeidsbelastninger.
FAQ
Hvordan kan team teste Muse Wonder, Opus 5.5 og GPT-6 Sol på en rettferdig måte?
Bruk et holdt-ut sett med reelle oppgaver med faste akseptkriterier, identiske input-artefakter og dokumenterte verktøytillatelser. Registrer hver modellversjon, innsatsinnstilling, agentramme, timeout og tokenbudsjett. Kjør gjentatte forsøk der utdata varierer, rapporter feil så vel som suksesser, og skill mellom en felles-ramme-sammenligning og en best-konfigurert-system-sammenligning. Dette gir bevis som gjelder din arbeidsflyt, ikke et annet teams benchmark-oppsett.
Kan en API-gateway bevare agenttilstand ved bytte av modell?
En delt gateway-adresse garanterer ikke i seg selv portabel samtaletilstand, verktøykall-identifikatorer eller lagrede svarreferanser. Behold en kanonisk applikasjonsside-logg over meldinger, verktøyutdata og validert oppgavetilstand. Test hver rutes tilstands- og verktøysemantikk før du ruter et pågående arbeid til en annen modell; ellers kan en rimeligere fallback miste informasjonen som trengs for å fullføre korrekt.
Hvordan bør team budsjettere for forsøk på nytt og menneskelig gjennomgang?
Definer et akseptert resultat før testing, og del deretter total fakturert modell- og verktøyforbruk på aksepterte resultater. Rapporter gjennomgangsarbeid separat eller inkluder det med en oppgitt timepris. Tell mislykkede forsøk, korrigerende kall og fallback-modeller, og sammenlign både typiske og dyre oppgaver. Dette unngår å behandle en lavere tokenpris som en garantert reduksjon i kostnaden for nyttig arbeid.
Hva bør en evalueringsprosess for minnefølsomme agenter inkludere?
Test om agenten husker relevante fakta, inkorporerer korreksjoner, ignorerer foreldede instruksjoner og holder separate prosjekter isolert. Inkluder forsinkede oppfølgere og motstridende oppdateringer i stedet for bare en enkelt lang prompt. Sjekk minneatferd på applikasjonsnivå så vel som modellnivå, fordi persistens, gjenfinning og sletting avhenger av det utplasserte systemet.