
TL;DR
OpenAI Decisions API og TypeSafe Jev returnerer avgrensede, sannsynlighetsstøttede beslutninger i stedet for vanlig generert prosa. OpenAI bruker GPT-6 Luna via et dedikert endepunkt; TypeSafe Jev er en spesialisert System One-modell. Jev er billigere på publiserte satser per input-token ($0,042 mot $0,10 per million), mens OpenAI har native bildestøtte. Leverandørtallene som er gjennomgått her, etablerer ingen direkte vinner på nøyaktighet eller hastighet.
Viktige punkter
- Prising: Jev er 58 % billigere per input-token på publiserte grunnsatser.
- Arkitektur: OpenAI Decisions API bruker GPT-6 Luna; Jev er formålsbygget for beslutningsprosessering.
- Modalitet: OpenAI støtter tekst og bilder; Jev fokuserer på tekst og strukturert input.
- Benchmarking: Leverandørers hastighetspåstander bruker ulike baselinjer; sammenlign på samme merkede datasett.
- Valg: Prioriter multimodal støtte og OpenAI-integrasjon, eller tekst-only gjennomstrømning og kostnad, avhengig av applikasjonen din.
Oversikt: OpenAI Decisions API vs Jev
Oversikten nedenfor sammenligner de dokumenterte beslutningsendepunktene og publiserte grunnsatser, kontrollert 12. oktober 2026. Modellers tilgang, grenser og vilkår bør verifiseres for distribusjonskontoen.
| Funksjon | OpenAI Decisions API | TypeSafe Jev |
|---|---|---|
| Leverandør | OpenAI | TypeSafe AI |
| Motor | GPT-6 Luna | Jev System One |
| Endepunkt | POST /v1/decisions | POST /v1/systemone |
| Modellidentifikator | gpt-6-luna | jev-1.13.0 / jev-latest |
| Inndata | Tekst + bilder | Tekst / strukturert tekst |
| Spørsmålstyper | Predicate (betingelsessannsynlighet), choice (kategori), score (rubrikk) | Noul (betingelsessannsynlighet), choice (kategori), score (nivåer) |
| Forespørsels-spørsmål | Array med navn | Objekt nøkklet med ID |
| Kontekstgrense | Ikke spesifisert i den lenkede Decisions-veiledningen | 64K totalt; state + lengste spørsmål ≤32K |
| Grunnkostnad input / 1M | USD 0,10 | USD 0,042 |
| Kostnad output-tokens | Ingen kostnad | Ingen kostnad |
| Leverandørens hastighetspåstand | Omtrent 10× raskere enn Responses API | 70–500 ms ende-til-ende |
| Tilgjengelighet | Offentlig beta | Tidlig tilgang i lanseringsmelding; bekreft gjeldende kontotilgang |
| Distinkt fordel | Bildebaserte beslutninger | Lavere publisert input-kostnad |
| Generativ resonnering / koding | Ikke output-kontrakten for dette endepunktet | Ikke output-kontrakten for dette endepunktet |
Mange AI-arbeidsflyter trenger en kategori, sannsynlighet eller score—ikke et avsnitt. En supporthenvendelse trenger ruting; en agent må velge en godkjent handling; en gjennomgangskø må identifisere usikre inndata. Begge produktene gjør slike beslutninger til førsteklasses API-utdata.
OpenAI lanserte Decisions API i beta 6. oktober 2026. GPT-6 Luna-endepunktet aksepterer tekst og bilder. Jev er TypeSafe AIs spesialiserte System One-modell for ikke-generativ evaluering, med en treningsmetode beskrevet som Reinforcement Learning for Calibrated Decisions (RLCD).
Spørsmålstypene i tabellen dekker tre delte oppgaver. OpenAIs predicate og Jevs noul estimerer om en betingelse er sann, som refusjonsintensjon eller kvalifisering. Choice velger fra forhåndsdefinerte kategorier, som Billing, Technical og Shipping, for ruting. Score evaluerer en input mot en rubrikk eller nivåer, som hastegrad eller prioritet. Disse beskrivelsene konsoliderer de to produktoversiktene; forespørselsskjemaer og sannsynlighetssemantikk krever fortsatt leverandørspesifikk håndtering.
Hva er OpenAI Decisions API og Jev?
OpenAI Decisions API og TypeSafe Jev er beslutningsfokuserte AI-tjenester utformet for å transformere inndata til strukturerte, avgrensede utdata i stedet for åpen tekst. I motsetning til tradisjonelle store språkmodeller som genererer forklaringer eller samtalesvar, evaluerer disse API-ene forhåndsdefinerte spørsmål og returnerer beslutninger, sannsynligheter eller scorer. Dette gjør dem spesielt nyttige for automatiserte arbeidsflyter som kundehendvendelsesruting, innholdsklassifisering, risikovurdering og verktøyvalg for AI-agenter, der forutsigbare utdata og effektiv prosessering er essensielt.
OpenAI Decisions API drives av GPT-6 Luna og opererer via endepunktet /v1/decisions. Det støtter både tekst- og bildeadgang, med tre beslutningstyper: predicate, choice og score. Hovedfordelen er å kombinere den kontekstuelle forståelsen til en generell AI-modell med et dedikert beslutningsgrensesnitt, noe som gjør den egnet for multimodal klassifisering og applikasjoner som allerede er integrert i OpenAIs økosystem.
TypeSafe Jev, i kontrast, er en spesialisert beslutningsmodell aksessert via endepunktet /v1/systemone. Den fokuserer på tekstbasert evaluering med tre spørsmålstyper: noul, choice og score. Jev vektlegger effektiv inferens, strukturerte prediksjoner og sannsynlighetskalibrering, noe som gjør den attraktiv for klassifisering i høyt volum og automatiserte beslutningspipelines. Selv om begge tjenester adresserer lignende problemer, kan forskjeller i arkitektur, inputkapabiliteter, prising og API-design ha stor betydning for hvilken som passer best til en bestemt applikasjon.
Modelltilnærming, inputgrenser og omfang
Sammenligningen gjelder dokumentert API-oppførsel og produktposisjonering. OpenAI eksponerer GPT-6 Luna via et beslutningsendepunkt, mens TypeSafe posisjonerer Jev som en spesialisert System One-modell. Disse beskrivelsene alene etablerer ikke en nøyaktighetsfordel eller avslører alle implementasjonsdetaljer.
Jev tillater 64K tokens på tvers av hele forespørselen, med en separat 32K-grense for state pluss lengste spørsmål. Tell spørsmålsinstruksjoner og kriterier samt delt input. Den lenkede OpenAI Decisions-veiledningen angir ikke en separat numerisk kontekstgrense for dette endepunktet; verifiser gjeldende grenser i stedet for å anta at en generell kontekstvindusverdi for modellen gjelder uendret.
Generative resonnerings- og kodebenchmark er utenfor omfanget for disse avgrensede beslutningsendepunktene. For forklaringsgenerering eller kodegenerering bør du evaluere et egnet generativt endepunkt separat. Resultater for den underliggende generalistmodellen etablerer ikke ytelse for Decisions-endepunktet.
Nøyaktighet og ventetid
De siterte leverandørmaterialene gir ikke en matchet test som etablerer en vinner på nøyaktighet eller ventetid. OpenAIs omtrent 10× hastighetspåstand sammenligner Decisions med deres Responses API. TypeSafe rapporterer 70–500 ms ende-til-ende ventetid og sier at publiserte evalueringer generelt ble kjørt fra en bærbar maskin i det vestlige USA.
| Metrikk | OpenAI Decisions API | Jev | Vurdering |
|---|---|---|---|
| Hode-til-hode nøyaktighet | Ingen matchet test i de siterte kildene | Ingen matchet test i de siterte kildene | Ingen vinner |
| Hastighet | Relativ leverandørpåstand | Absolutt leverandørområde | Ikke direkte sammenlignbart |
| Kalibrering | Sannsynligheter; separat confidence for choice/score | Sannsynligheter; avledet confidence for choice/score | Test observért kalibrering |
| Tekstkategorisering | Støttet | Støttet | Begge er levedyktige |
| Visuell kategorisering | Native bilder | Ingen native bilder | OpenAI-fordel |
Sannsynlighetskalibrering og gjennomgangsterskler
En modell kan være nøyaktig, men dårlig kalibrert. Blant prediksjoner som er tildelt 0,90 sannsynlighet for valgt klasse, bør omtrent 90 % være korrekte hvis den sannsynligheten er kalibrert på evalueringsdistribusjonen. Ikke erstatt et API-felt kalt confidence med denne sannsynligheten uten å sjekke definisjonen. Jev avleder sin Choice-confidence fra sannsynlighetsfordelingen: confidence = (p_max − 1/n) / (1 − 1/n), der n er antall valg. Dets Noul-resultat har ikke et eget confidence-felt. Mål ECE og Brier score fra de relevante sannsynlighetene, sammen med presisjon, recall og makro-F1; velg gjennomgangsterskler fra merkede eksempler.
Prising og kostnad per akseptert beslutning
OpenAI oppgir $0,10 per million input-tokens for /v1/decisions; Jev oppgir $0,042 per million input-tokens. Begge oppgir ingen kostnad for output-tokens for disse beslutningstjenestene. På disse grunnsatsene er Jev 58 % billigere per input-token. OpenAIs regionale behandlingspåslag og multiplikatorer for lang kontekst kan gjelde; retrier, forhåndsprosessering og gjennomgang kan legge til arbeidsflytkostnader.
Anta at hver forespørsel bruker 500 fakturerbare input-tokens på begge tjenester. Dette er illustrative beregninger, ikke leverandørfakturaer.
| Månedlige beslutninger | Input-tokens | OpenAI-kostnad | Jev-kostnad | Forskjell |
|---|---|---|---|---|
| 10,000 | 5M | $0,50 | $0,21 | $0,29 |
| 100,000 | 50M | $5,00 | $2,10 | $2,90 |
| 1,000,000 | 500M | $50 | $21 | $29 |
| 10,000,000 | 5B | $500 | $210 | $290 |
| 100,000,000 | 50B | $5,000 | $2,100 | $2,900 |
Kostnad per akseptert korrekt beslutning = (API-forbruk + retry-forbruk + menneskelig gjennomgang) / antall aksepterte korrekte beslutninger. En lav per-token-sats kan oppveies av høyere rate av feilsorteringer eller eskaleringer.
For en konvensjonell GPT-6 Luna-arbeidsflyt lister CometAPI-modellpristabellen følgende USD-satser per million tokens, kontrollert 12. oktober 2026. Dette er modell-endepunkt-satser; den lenkede siden viser et eksempel med Responses API og etablerer ikke native /v1/decisions-støtte eller prisingen for det.
| Publisert nivå | Input / 1M tokens | Output / 1M tokens |
|---|---|---|
| Kort kontekst (sidebetingelse: ≤272,000 tokens) | $0,08 | $0,40 |
| Lang kontekst (som oppført på siden) | $0,16 | $0,60 |
CometAPIs ordinære GPT-6 Luna-output-tokens faktureres. Hold dette estimatet atskilt fra de to beslutningstjenestene ovenfor, hvis publiserte output-token-kostnad er null. For eksempel koster 500 input-tokens pluss 20 output-tokens $0,000048 per forespørsel med kort kontekst, eller $48 per million forespørsler, før andre gebyrer. Bekreft gjeldende nivå og kontosats i den live modelldatabasen før budsjettering.
Agent-arbeidsflyter og modalitet-avveiinger
Begge kan rute et verktøykall, evaluere om en guard-betingelse er oppfylt, eller score en handling. Ingen av dem erstatter autorisering, inputvalidering eller eksplisitte verktøytillatelser. For visuell automasjon forenkler OpenAIs native bildestøtte pipelinen; for ren tekstruting kan Jevs lavere grunnkostnad være attraktiv.
Utdatahåndtering skiller seg ved responsgrensen. OpenAI returnerer en answers-array, med names som identifiserer spørsmål; Jev returnerer et answers-objekt nøkklet av question ID. Normaliser disse strukturene før du anvender felles forretningsregler. Jev avleder confidence fra sin sannsynlighetsfordeling; ikke anta at like navngitte felt har tilsvarende betydning på tvers av leverandører. Valider etiketter og kalibrér gjennomgangsterskler på applikasjonsdata.
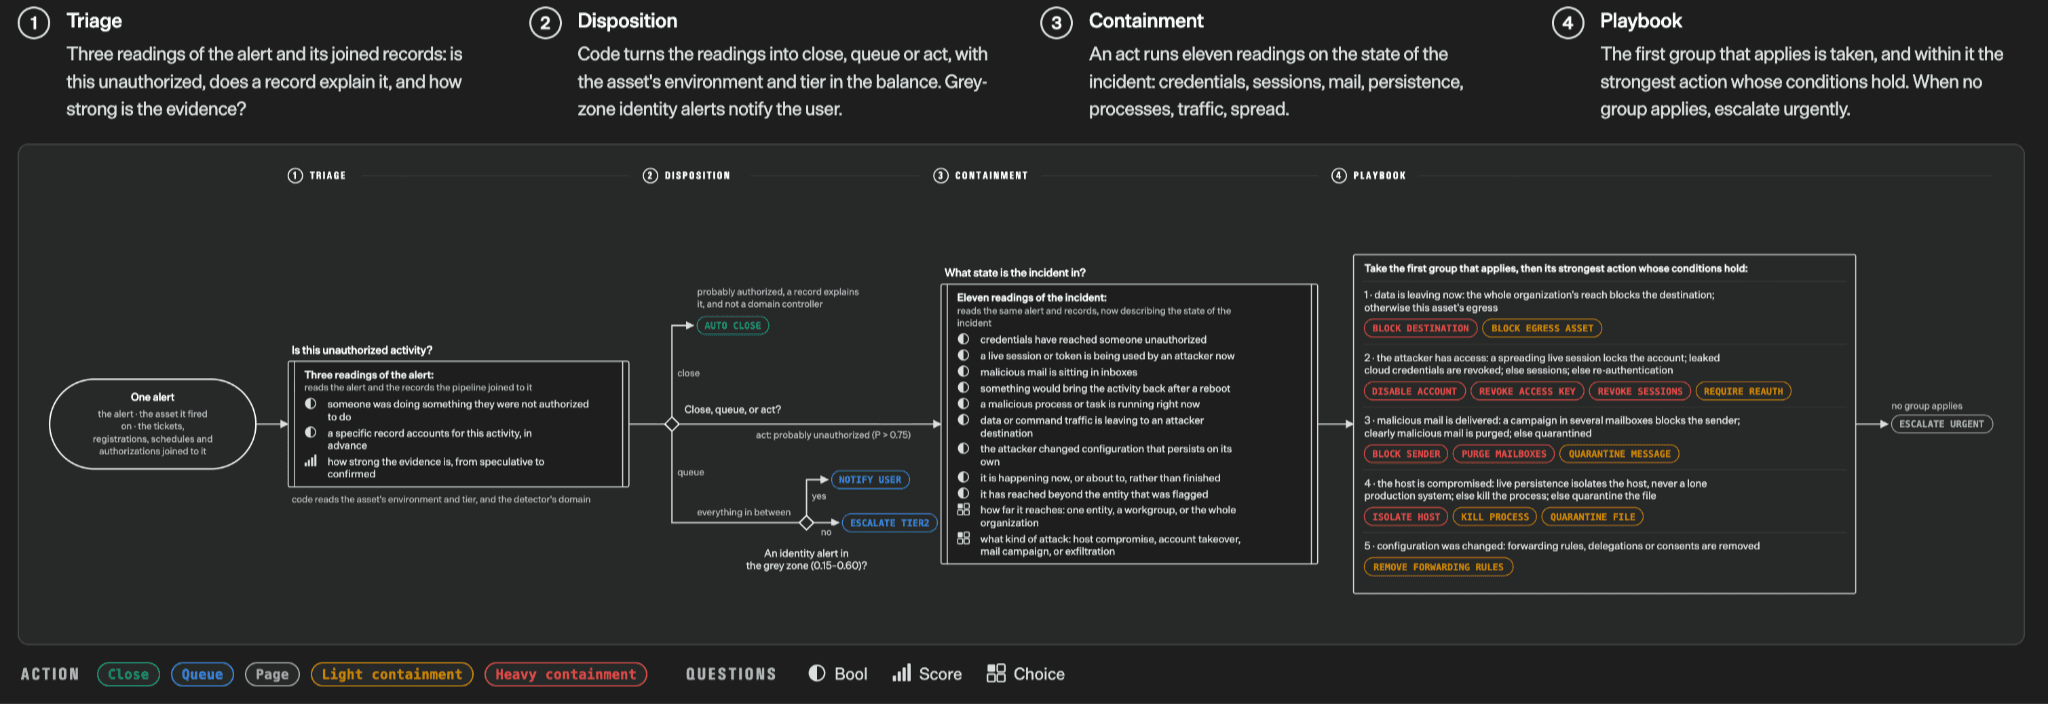
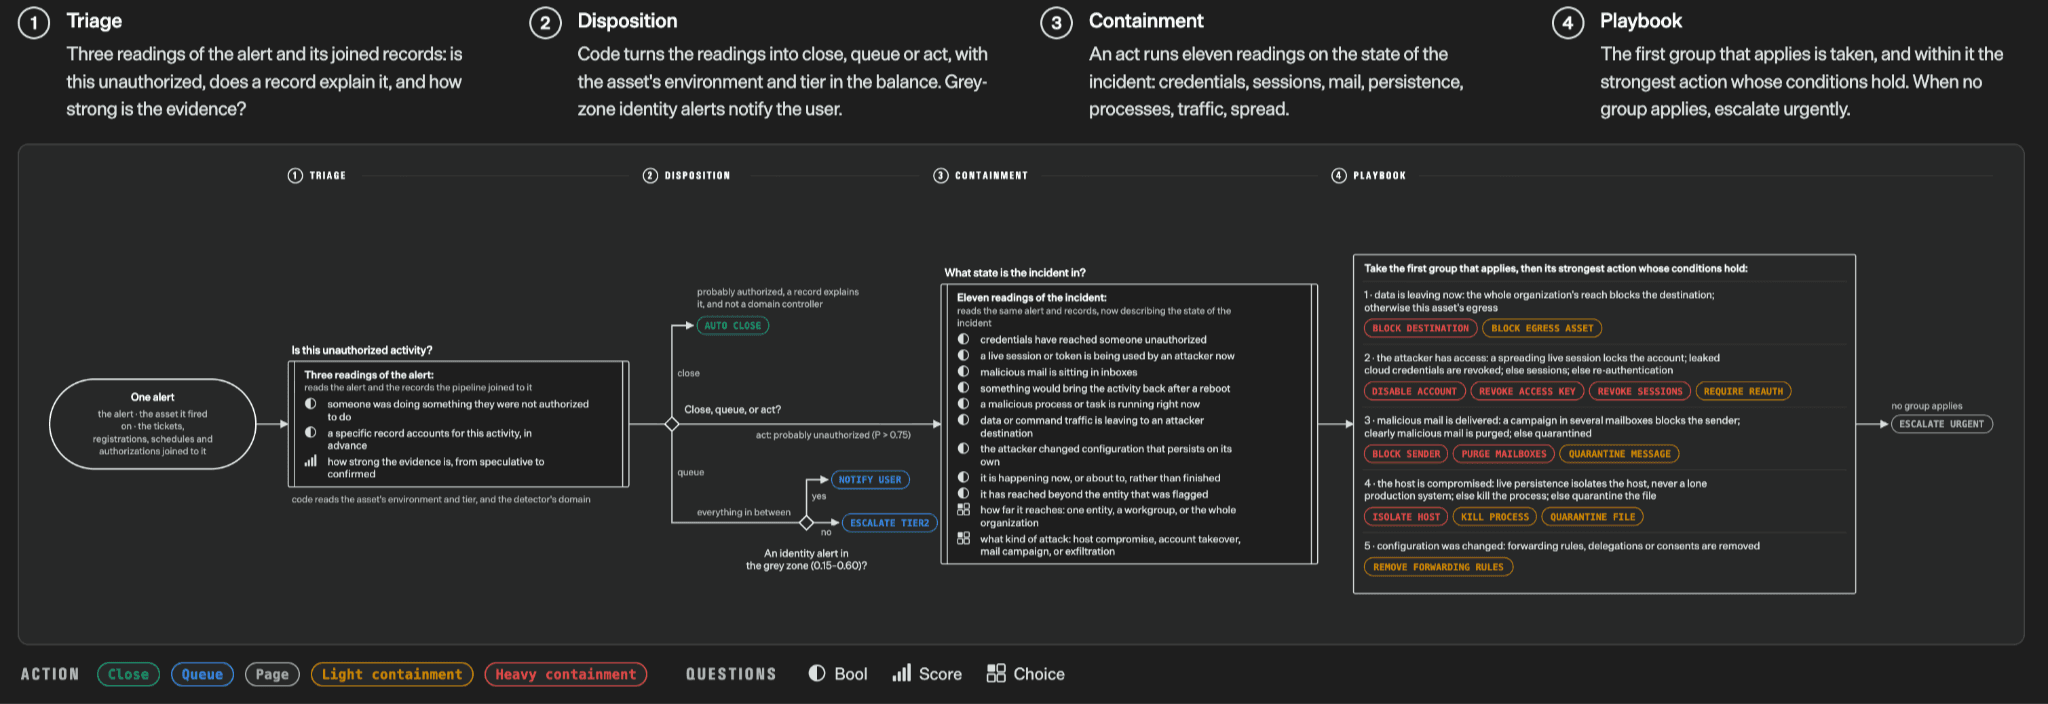
Kilde: Introducing System One Models & Jev; originalbilde. Dette illustrerer arbeidsflytkomposisjon, ikke en matchet benchmark mot OpenAI Decisions API.
Hvordan API-bruk skiller seg: OpenAI Decisions API vs Jev
Tilgang må konfigureres separat for hver leverandør: hvert eksempel nedenfor bruker sin egen vert og API-nøkkel. OpenAI dokumenterer Decisions som et offentlig beta-endepunkt. For Jev, bekreft gjeldende tilgang og legitimasjon med TypeSafe før distribusjon. For begge tjenester, verifiser kontotillatelser, regional tilgjengelighet, kvoter og vilkår; et eksempel på forespørsel garanterer ikke produksjonstilgang. Tredjepartstilgang til en generativ modell bekrefter ikke i seg selv støtte for dens native beslutningsendepunkt.
Slik bruker du OpenAI Decisions API
Konseptene overlapper, men forespørselsskjemaene er ulike. OpenAI sender input og en array med navngitte spørsmål; Jev bruker state og et questions-objekt nøkklet av question ID. Implementér en leverandørspesifikk adapter før du anvender en felles beslutningspolicy.
Ruter en supporthenvendelse med OpenAI Decisions API.
curl https://api.openai.com/v1/decisions \
  -H "Authorization: Bearer $OPENAI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "gpt-6-luna",
    "input": "I was charged twice for my order.",
    "questions": [{
      "type": "choice", "name": "department",
      "instructions": "Which team should handle this?",
      "choices": [
        {"value":"billing","description":"Charges and refunds"},
        {"value":"technical","description":"Product errors"},
        {"value":"other","description":"Other requests"}
      ]
    }]
  }'
Slik bruker du Jev API
Følgende cURL-forespørsel bruker Jevs System One-endepunkt for å klassifisere en supporthenvendelse. Sett TYPESAFE_API_KEY i miljøet ditt, legg henvendelsen i state, og definer department inne i questions-objektet. Dets criteria-map lister de tillatte rutingsetikettene og deres beskrivelser. Etter at forespørselen er vellykket, les department-oppføringen i answers og valider den valgte etiketten før du ruter henvendelsen. Bekreft at modellidentifikatoren er tilgjengelig for kontoen din.
Ruter en supporthenvendelse med TypeSafe Jev.
curl https://api.typesafe.ai/v1/systemone \
  -H "Authorization: Bearer $TYPESAFE_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "jev-1.13.0",
    "state": "I was charged twice for my order.",
    "questions": {
      "department": {
        "type": "choice",
        "instructions": "Which team should handle this?",
        "criteria": {
          "billing":"Charges and refunds",
          "technical":"Product errors",
          "other":"Other requests"
        }
      }
    }
  }'
| Integrasjonselement | OpenAI | Jev |
|---|---|---|
| Input | input | state |
| Questions | Array | Nøkklet objekt |
| Question ID | name | Objekt-nøkkel |
| Binært spørsmål | predicate | noul |
| Valg | choices | criteria |
| Svarstruktur | answers array | answers object |
Felles vurderingspolicy for sannsynligheten til valgt klasse
Bruk en eksplisitt kalibrert terskel på sannsynligheten til den valgte klassen.
from dataclasses import dataclass
from math import isfinite

@dataclass
class NormalizedDecision:
    label: str | None
    selected_probability: float | None
    provider: str
    needs_review: bool

def apply_review_policy(label, selected_probability, provider, threshold):
    if not isfinite(threshold) or not 0.0 <= threshold <= 1.0:
        raise ValueError("threshold must be between 0 and 1")
    valid_probability = (
        selected_probability is not None
        and isfinite(selected_probability)
        and 0.0 <= selected_probability <= 1.0
    )
    return NormalizedDecision(
        label=label,
        selected_probability=selected_probability,
        provider=provider,
        needs_review=(
            not label
            or not valid_probability
            or selected_probability < threshold
        ),
    )
Dette Python 3.10+-eksemplet er et applikasjonspolicylag, ikke en API-responsparser. Hver leverandøradapter må validere responsen og hente ut sannsynligheten for valgt klasse. Ikke send Jevs rå confidence-felt som selected_probability. Oppgi en terskel som er kalibrert for den leverandøren, spørsmålet og evalueringsdatasettet; håndter avslag og transportfeil før du kaller policyen.
OpenAI Decisions API vs Jev: Hvordan velge
Velg i to trinn. Først, screene for distribusjonskrav: bildeadgang, kontotilgang, inputgrenser og integrasjonsarbeid. Deretter benchmark de kvalifiserte tjenestene på samme merkede arbeidslast. For tekstruting, test om Jevs lavere publiserte inputpris oversettes til lavere totalkostnad; for bildekrevende beslutninger, evaluer OpenAIs native bildevei. Sammenlign feilsorteringer, kalibrering, halelengdeventetid, retrier og menneskelig gjennomgang på et avtalt kvalitetsmål. Tabellen nedenfor er en startshortlist, ikke bevis på en samlet ytelsesvinner.
| Bruksområde | OpenAI Decisions API | Jev | Praktisk anbefaling |
|---|---|---|---|
| Supportruting | Støttet | Støttet | Benchmark Jev først for kost |
| Tekstkategorisering | Støttet | Støttet | Sammenlign kalibrering |
| Skjermbildeinspeksjon | Native | Krever visjon-forbehandling | OpenAI |
| Agent-verktøyvalg | Støttet | Støttet | Mål ende-til-ende-resultater |
| Multimodal moderering | Tekst og bilder | Kun tekst | OpenAI |
| Eksisterende OpenAI-stack | Native | Ny integrasjon | OpenAI |
For forretningsautomatisering i høyt volum, slik som supportruting og tekstklassifisering, er Jev verdt å prioritere når input-kostnad og gjennomstrømning er viktige. For multimodale applikasjoner, inkludert skjermbildeinspeksjon, visuell moderering og bildebasede beslutninger, er OpenAI Decisions API det mer praktiske alternativet på grunn av native bildestøtte. For AI-agenter og bedriftsarbeidsflyter avhenger valget av eksisterende infrastruktur, integrasjonskompleksitet og konsekvenser av feilaktige beslutninger. OpenAI kan tilby en smidigere vei for team som allerede bruker økosystemet, mens Jev fortjener vurdering for storskala, teksttunge arbeidsbelastninger. I alle scenarier bør den endelige beslutningen baseres på målt nøyaktighet, sannsynlighetskalibrering, ventetid og totale driftskostnader, ikke bare overskriftsprising.
Hvordan bør du benchmarke OpenAI Decisions API mot Jev?
Kjør begge tjenester på de samme merkede virkelige inndata, med matchede spørsmålsdefinisjoner og klientregioner. Spor nøyaktighet, makro-F1, ECE, Brier score, p50/p95/p99 ventetid, timeouts, avslag, gjennomgangsrate og dollar-kostnad per korrekt akseptert beslutning.
| Dimensjon | Anbefalte metrikkar | Hvorfor det er viktig |
|---|---|---|
| Klassifisering | Nøyaktighet, presisjon, recall, makro-F1 | Kvalitet på etiketter |
| Kalibrering | ECE, Brier score | Pålitelighet i sannsynligheter |
| Ventetid | p50 / p95 / p99 | Operasjonell responsivitet |
| Pålitelighet | 429 / timeout / avslagsrate | Produksjonsatferd |
| Økonomi | Kostnad per korrekt akseptert beslutning | Reell driftskostnad |
Foreslått prosedyre: bygg et representativt merket sett; inkluder tvetydige og utenfor-distribusjon-tilfeller; send semantisk identiske oppgaver; gjenta forespørsler nok til å måle variasjon; kalibrer hvert systems terskler uavhengig; og sammenlign ende-til-ende-kostnad inkludert eskalering og retrier.
Konklusjon
Velg OpenAI Decisions API når beslutningen avhenger av bildebevis eller når en eksisterende OpenAI-integrasjon reduserer implementasjonsarbeid. Evaluer Jev for tekst-only beslutningsarbeidslaster der den lavere publiserte input-token-satsen kan redusere inferenskostnaden. Mål etikettkvalitet, kalibrering, halelengdeventetid og gjennomgangsarbeidsmengde på de samme applikasjonsdataene før du velger.
Jev har den lavere publiserte grunnprisen per input-token; OpenAI Decisions API har native bildeadgang. De siterte leverandørfigurene etablerer ikke en samlet vinner på nøyaktighet eller hastighet. Det beste valget avhenger av kostnaden og kvaliteten på aksepterte beslutninger i den komplette arbeidsflyten.
Utviklere kan bruke GPT-6 Luna API i CometAPI til å prototype lettvektsklassifisering i en bredere multimodell-arbeidsflyt. Den lenkede modellsiden gir et Responses API-eksempel. Tilgang til det generative endepunktet etablerer ikke støtte for det dedikerte /v1/decisions-endepunktet. Dette er en konvensjonell tekstgenereringsprototype. Den returnerer ikke det native Decisions-svarskjemaet eller en kalibrert klasser-sannsynlighetsfordeling. Valider den returnerte etiketten mot de tillatte kategoriene og håndter API-feil før du kobler den til nedstrøms handlinger. Bekreft native /v1/decisions-støtte separat hvis det endepunktet er nødvendig.