

TL;DR: Który dostawca jest najtańszy?
Dla zwykłych interaktywnych żądań GPT-6 Astra, GPT-6 Astra API w CometAPI ma najniższą jasno opublikowaną stawkę Standard (krótki kontekst) w tym porównaniu: $8 za milion tokenów wejściowych i $40 za milion tokenów wyjściowych. OpenAI Standard to $10/$50.
W przypadku zadań tolerujących opóźnienia ekonomia się zmienia: OpenAI wycenia Batch i Flex na 50% stawki Standard, co daje $5/M wejścia i $25/M wyjścia dla krótkokontekstowych żądań Astra. OpenRouter udostępnia także trasę Batch za $5/$25. Te trasy są tańsze niż interakcyjne wnioskowanie Standard, ale nie są bezpośrednimi substytutami dla aplikacji wrażliwych na opóźnienia.
Do testów przed płatnościami CometAPI podaje, że nowe konta otrzymują bezpłatne kredyty powitalne bez wymogu podania karty. Azure oferuje kwalifikującym się nowym klientom $200 kredytu na 30 dni, a AWS oferuje nowym klientom do $200 kredytów w ramach programu Free Tier. Kwalifikowalność kredytów i dostęp do modelu należy zweryfikować na koncie przed założeniem, że użycie Astra jest objęte.
Uwaga dot. kwalifikowalności: promocyjne kredyty i dostęp do GPT-6 Astra różnią się w zależności od konta, regionu i programu. Zweryfikuj zarówno kwalifikowalność kredytów, jak i dostęp do modelu przed szacowaniem bezpłatnej wersji próbnej.
Kluczowe wnioski
- Najtańsza zweryfikowana stawka interakcyjna tutaj: CometAPI Standard $8/M wejścia i $40/M wyjścia, o 20% poniżej OpenAI Standard.
- Najtańsza trasa dla zadań tolerujących opóźnienia: OpenAI Batch/Flex lub OpenRouter Batch za $5/M wejścia i $25/M wyjścia.
- OpenAI nie ma darmowego poziomu API dla Astra; oficjalna tabela limitów oznacza Free jako nieobsługiwany.
- CometAPI ma najniższy próg wejścia do testów w tym porównaniu, ponieważ oferuje kredyty powitalne bez karty; bieżąca kwota kredytu jest celowo nie wprowadzana na sztywno.
- Granica 272K dla wejścia ma znaczenie: powyżej niej Astra przechodzi na wyceny długiego kontekstu dla całego żądania.
- Nie porównuj wyłącznie cen za tokeny. Buforowanie, narzędzia, ponowienia, opóźnienia, rozrost kontekstu i skuteczność realizacji zadań mogą zdominować łączny koszt.
Czym jest GPT-6 Astra i dlaczego jego API ma cenę premium?
GPT-6 Astra to flagowy model OpenAI przeznaczony do trudnej, kompleksowej pracy end-to-end, a nie do taniego, wysokowolumenowego czatu. OpenAI pozycjonuje go do złożonego rozumowania, inżynierii oprogramowania, badań, obsługi komputera, profesjonalnych przepływów pracy i długotrwałych agentów.
Oficjalna specyfikacja modelu podaje, że Astra ma okno kontekstu 1 050 000 tokenów, maksymalne wyjście 128 000 tokenów, cutoff wiedzy na 30 kwietnia 2026, wejście tekstowe i obrazowe oraz wyjście tekstowe. Obsługuje pięć ustawień poziomu rozumowania: niski, średni, wysoki, bardzo wysoki i maksymalny.
| Specyfikacja GPT-6 Astra | Wartość |
|---|---|
| Deweloper | OpenAI |
| ID modelu | gpt-6-astra |
| Okno kontekstu | 1 050 000 tokenów |
| Maksymalne wyjście | 128 000 tokenów |
| Cutoff wiedzy | 30 kwietnia 2026 |
| Wejście | Tekst, obrazy |
| Wyjście | Tekst |
| Poziom rozumowania | Niski, Średni, Wysoki, Bardzo wysoki, Maksymalny |
| Wywoływanie funkcji | Obsługiwane |
| Strukturyzowane wyjścia | Obsługiwane |
| Obsługa komputera | Obsługiwana |
| Wyszukiwanie w sieci/pliku | Obsługiwane |
| Strojenie | Nieobsługiwane |
| Cena Standard (krótki kontekst) | $10/M wejścia; $50/M wyjścia |
| Buforowane wejście | $1/M |
| Zapis do pamięci podręcznej | $12.50/M |
| Próg długiego kontekstu | Powyżej 272K tokenów wejściowych |
Limit kontekstu jest także granicą cenową. Dla promptów powyżej 272K tokenów wejściowych OpenAI stosuje 2× cenę za wejście/cache i 1,5× cenę za wyjście do całego żądania. Żądanie, które nieznacznie przekroczy 272K, może więc znacząco podnieść całkowity koszt.
Astra wprowadza też możliwości zorientowane na agentów, takie jak asynchroniczne wywoływanie narzędzi i sterowanie w połowie tury. Dlatego użyteczne porównanie dostawców musi uwzględniać narzędzia, buforowanie, poziom przetwarzania i skuteczność realizacji zadań — nie tylko nagłówkową cenę za wejście.
Jak dobra jest GPT-6 Astra? Oficjalne wyniki benchmarków
Oficjalna tabela benchmarków pokazuje mocne wyniki w zakresie obsługi komputera, automatyzacji profesjonalnej, długiego kontekstu, nauki, kodowania i cyberbezpieczeństwa. Podaje 97,6% na FrontierMath Tier 4 (v2), 99,9% na ARC-AGI-3 oraz 100% na ExploitBench. To wyniki opublikowane przez dostawcę i należy je interpretować zgodnie z podaną metodologią.
| Benchmark | GPT-6 Astra | Porównanie / znaczenie |
|---|---|---|
| FrontierMath Tier 4 (v2) | 97.6% | Matematyka na poziomie badań |
| ARC-AGI-3 | 99.9% | Nowatorskie rozumowanie / adaptacja |
| ExploitBench | 100.0% | Zdolności exploitacyjne w cybersec |
| OSWorld 2.0 | 72.6% | Zadania z obsługi komputera |
| ScreenSpot-Pro | 92.7% | Wizualne osadzanie w UI |
| AutomationBench | 41.4% | Automatyzacja profesjonalnych procesów |
| BenchCAD | 95.9% | CAD / zadania projektowe pro |
| BrowseComp | 91.5% | Wyszukiwanie informacji w przeglądarce |
| MRCR v2, 512K–1M | 96.3% | Bardzo długie odzyskiwanie kontekstu |
| Terminal-Bench Science 0.1 | 64.6% | Naukowe przepływy pracy agentów |
Dla oceny kosztów wyniki OpenAI OSWorld 2.0 notują 72,6% przy około 40 minutach na zadanie dla Astra, w porównaniu do 65,7% przy około 75 minutach dla GPT-5.6 Sol. To wspiera ocenę kosztu na ukończone zadanie zamiast traktowania ceny za token jako całego modelu kosztowego.
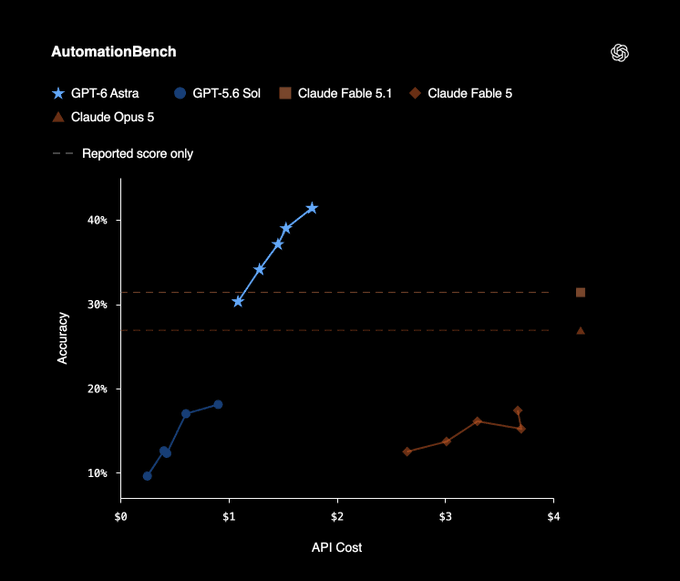
Oficjalna grafika benchmarku OpenAI AutomationBench.
Który dostawca API GPT-6 Astra jest najtańszy w 2026?
Poniższa tabela porównuje publicznie weryfikowalne ceny za token dla tego samego modelu GPT-6 Astra. Wyklucza nietypowo tanie oferty relay, gdy pochodzenie modelu, limity kontekstu, prywatność lub zachowanie usługi nie mogą być niezależnie zweryfikowane. Cennik na żywo CometAPI dla modeli pokazuje $8/M wejścia i $40/M wyjścia dla dostępu Standard o krótkim kontekście.
| Dostawca / trasa | Wejście / 1M | Wyjście / 1M | Wersja próbna / kredyty | Najlepsze dopasowanie |
|---|---|---|---|---|
| CometAPI Standard | $8 | $40 | Kredyty powitalne | Najniższa zweryfikowana stawka interakcyjna tutaj |
| OpenAI Standard | $10 | $50 | Brak darmowego poziomu API dla Astra | Bezpośredni dostęp pierwszej strony |
| OpenAI Batch / Flex | $5 | $25 | To samo konto API | Najniższa pierwszostronna stawka dla zadań tolerujących opóźnienia |
| OpenRouter Standard | $10 | $50 | Brak zweryfikowanej próby specyficznej dla Astra | Routowanie wielodostawcowe |
| OpenRouter Batch | $5 | $25 | Brak zweryfikowanej próby specyficznej dla Astra | Tanie asynchroniczne routowanie |
| Azure Global | $10 | $50 | $200 / 30 dni dla kwalifikujących się nowych użytkowników | Obciążenia w chmurze Microsoft |
| Azure US Data Zone | $11 | $55 | Kredyt Azure zależny od kwalifikacji | Wymogi strefy danych |
| AWS Global CRIS | $10 | $50 | Do $200 ogólnych kredytów AWS | Obciążenia natywne dla AWS |
| AWS In-Region | $11 | $55 | Kredyty AWS zależne od kwalifikacji | Wdrożenia regionalne |
Opublikowana tabela Astra w Azure potwierdza $10/$50 dla Standard Global i $11/$55 dla US Data Zone. Szczegóły cenowe Microsoft Foundry pokazują również odpowiadające przedziały dla długiego kontekstu. AWS publikuje $10/$50 dla Global CRIS i $11/$55 dla In-Region/Geo CRIS. Cennik Amazon Bedrock stwierdza, że są to stawki poziomu Standard.
Istnieją więc dwie różne odpowiedzi na pytanie o „najtańszego”. Dla interakcyjnego wnioskowania Standard liderem cenowym w tym zweryfikowanym zestawie jest CometAPI. Dla asynchronicznych lub elastycznych obciążeń tańszy jest Batch/Flex za $5/$25.
Uwaga cenowa: stawki dostawców i kredyty promocyjne mogą się zmieniać. Sprawdź powiązaną dokumentację dostawców tuż przed publikacją lub budżetowaniem produkcyjnym.
O ile tańsze jest GPT-6 Astra API w CometAPI?
| Kategoria tokenów | OpenAI Standard | CometAPI | Różnica |
|---|---|---|---|
| Wejście | $10.00/M | $8.00/M | O 20% niżej |
| Buforowane wejście | $1.00/M | $0.80/M | O 20% niżej |
| Zapis do cache | $12.50/M | $10.00/M | O 20% niżej |
| Wyjście | $50.00/M | $40.00/M | O 20% niżej |
| Wejście długiego kontekstu | $20.00/M | $16.00/M | O 20% niżej |
| Wyjście długiego kontekstu | $75.00/M | $60.00/M | O 20% niżej |
Praktyczna implikacja jest prosta: jeśli Twoja aplikacja potrzebuje interakcyjnego wnioskowania w stylu Standard, a nie Batch/Flex, opublikowane stawki Astra w CometAPI obniżają komponent tokenowy o 20% we wszystkich dopasowanych kategoriach.
Który dostawca API GPT-6 Astra ma najlepszą wersję próbną?
„Darmowe GPT-6 Astra API” może oznaczać albo stały darmowy poziom modelu, albo tymczasowe kredyty promocyjne. To nie jest to samo. Oficjalna tabela limitów OpenAI oznacza, że darmowy poziom API jest nieobsługiwany dla Astra.
CometAPI: najprostsza ścieżka testu bez karty
Szybki start CometAPI stwierdza, że nowe konta otrzymują bezpłatne kredyty powitalne i że do rozpoczęcia nie jest wymagana karta. Ponieważ kwota promocji może się zmieniać, jako źródło prawdy należy traktować bieżący ekran rejestracji lub cennik zamiast wpisywania na sztywno kwoty w dolarach.
Azure: najczytelniejszy, stałowartościowy trial w chmurze
Kwalifikujący się nowi klienci Azure mogą otrzymać $200 kredytu Azure na 30 dni. Jeśli GPT-6 Astra jest włączona dla konta i regionu, kredyt ten może umożliwić użyteczne POC przed normalnym rozliczaniem.
AWS: dłuższe ogólne okno kredytowe
AWS oferuje nowym klientom $100 kredytów przy rejestracji oraz możliwość zdobycia kolejnych $100 — do $200 w ciągu sześciu miesięcy. Ponieważ plan Free w AWS nie udostępnia każdej usługi i funkcji, zweryfikuj kwalifikowalność planu konta oraz dostęp do modelu w Bedrock zanim potraktujesz kredyt jako gwarantowaną próbę Astra.
Kiedy OpenAI Batch jest tańszy dla GPT-6 Astra?
Największym błędem kosztowym jest porównywanie wyłącznie dostawców z pominięciem poziomu przetwarzania. OpenAI stwierdza, że Batch i Flex kosztują 50% stawki Standard, podczas gdy Tryb Fast kosztuje 2× stawkę właściwą. Dla krótkokontekstowych żądań Astra zakres to zatem $5/$25 przy Batch/Flex, $10/$50 przy Standard i $20/$100 przy Fast.
| Opcja przetwarzania | Wejście / 1M | Wyjście / 1M | Względem OpenAI Standard |
|---|---|---|---|
| Batch | $5 | $25 | 50% |
| Flex | $5 | $25 | 50% |
| CometAPI Standard | $8 | $40 | 80% ceny OpenAI Standard |
| OpenAI Standard | $10 | $50 | 100% |
| OpenAI Fast | $20 | $100 | 200% |
Batch/Flex należy rozważyć w pierwszej kolejności dla nocnych analiz, offline’owego przeglądu kodu, wzbogacania zbiorów danych, przebiegów ewaluacyjnych i niepilnych badań. Dla aplikacji, w których użytkownik aktywnie czeka, bardziej relewantne pozostaje porównanie Standard.
Ile faktycznie będzie Cię kosztować GPT-6 Astra?
Rozważ krótkokontekstowe żądanie agenta zużywające 100 000 tokenów wejściowych i 10 000 tokenów wyjściowych. Pomijając opłaty za cache i narzędzia, uproszczony koszt to tokeny wejściowe × stawka wejścia + tokeny wyjściowe × stawka wyjścia.
| Dostawca / trasa | Koszt na żądanie | Koszt dla 1,000 równoważnych żądań |
|---|---|---|
| OpenAI Batch/Flex | $0.75 | $750 |
| CometAPI Standard | $1.20 | $1,200 |
| OpenAI Standard | $1.50 | $1,500 |
| OpenRouter Standard | $1.50 | $1,500 |
| Azure Global | $1.50 | $1,500 |
| AWS Global CRIS | $1.50 | $1,500 |
| AWS In-Region | $1.65 | $1,650 |
Różnica $0.30 między CometAPI Standard a OpenAI Standard wygląda na małą przy jednym żądaniu. Przy 10,000 równoważnych żądaniach staje się to około $3,000 przed kosztami narzędzi czy ponowieniami.
Długi kontekst znów zmienia matematykę. Przy 300K wejścia i 20K wyjścia, OpenAI Standard to około $7.50 przy opublikowanej stawce długiego kontekstu, podczas gdy odpowiadające stawki CometAPI dają około $6.00. Dlatego próg 272K powinien być explicite monitorowany w telemetrii produkcyjnej.
Jak obniżyć koszty GPT-6 Astra API bez zmiany dostawcy?
Buforowanie promptów to główna dźwignia, ponieważ stawka za buforowane wejście w Astra Standard stanowi jedną dziesiątą świeżego wejścia. Stabilne instrukcje systemowe, definicje narzędzi, wielokrotnego użytku materiały referencyjne i wspólne prefiksy promptów są dobrymi kandydatami do projektowania z uwzględnieniem cache.
Kontrola kontekstu to druga dźwignia. Okno 1,05M tokenów to sufit pojemności, a nie cel. Pozostawanie poniżej granicy cenowej 272K, gdy dodatkowa historia nie jest potrzebna, może mieć większy efekt niż drobna kompresja promptu.
Poziom przetwarzania to trzecia dźwignia: Batch/Flex dla pracy tolerującej opóźnienia, Standard dla zwykłej interakcyjnej produkcji i Fast tylko tam, gdzie niższa latencja ma mierzalną wartość biznesową. Na koniec mierz koszt na zaakceptowane zadanie — nie tylko koszt na token — ponieważ ponowienia, wywołania narzędzi i poprawki ludzkie mogą odwrócić proste porównanie cenników.
Którego dostawcę API GPT-6 Astra wybrać?
| Twój priorytet | Najlepsza opcja startowa | Dlaczego |
|---|---|---|
| Najniższa interakcyjna cena za token | CometAPI | $8/$40 stawka Standard (krótki kontekst) |
| Najniższa cena dla zadań z opóźnieniem | OpenAI Batch/Flex lub OpenRouter Batch | $5/$25 |
| Test bez karty | CometAPI | Kredyty powitalne; bez wymogu karty |
| Największy stały krótkoterminowy trial w chmurze | Azure | $200 na 30 dni dla kwalifikujących się nowych użytkowników |
| Dłuższe okno ogólnych kredytów w chmurze | AWS | Do $200; zweryfikuj kwalifikację Astra/Bedrock |
| Natywny dostęp pierwszej strony OpenAI | OpenAI | Bezpośrednie API i najnowsze natywne możliwości |
| Istniejąca architektura Microsoft | Azure Foundry | Governance i zakupy Microsoft |
| Istniejąca architektura AWS | Amazon Bedrock | Bezpieczeństwo AWS, rozliczanie i kontrola regionalna |
| Routowanie wielodostawcowe | OpenRouter | Jedna warstwa routingu między dostawcami |
Dla niezależnego dewelopera lub zespołu wrażliwego na koszty, który potrzebuje interakcyjnego wnioskowania Astra, CometAPI jest najsilniejszym punktem wyjścia z perspektywy ceny w tym porównaniu. Dla dużych zadań offline najpierw oceń Batch/Flex, ponieważ jego 50% zniżki poziomu przetwarzania jest większe niż 20% różnicy stawek Standard.
Dla zespołów korporacyjnych najniższa stawka za token może nie dać najniższego całkowitego kosztu. Azure lub AWS mogą nadal być lepszym ekonomicznie wyborem, gdy zespół już polega na zobowiązaniach wydatków chmurowych, prywatnych sieciach, scentralizowanych zakupach lub wbudowanych kontrolach bezpieczeństwa i zgodności. Oceń te oszczędności operacyjne osobno od ceny za token modelu.
Jak wywołać GPT-6 Astra API przez CometAPI?
CometAPI używa wzorca integracji zgodnego z OpenAI. Utwórz klucz API CometAPI, skieruj SDK OpenAI na bazowy URL CometAPI i wywołaj model gpt-6-astra. Dokumentacja modelu Astra w CometAPI publikuje zarówno endpointy Chat Completions, jak i Responses.
from openai import OpenAI
import os

client = OpenAI(
    api_key=os.environ["COMETAPI_KEY"],
    base_url="https://api.cometapi.com/v1",
)

response = client.responses.create(
    model="gpt-6-astra",
    reasoning={"effort": "medium"},
    input="Analyze this software architecture and identify the three highest-risk bottlenecks.",
)

print(response.output_text)
Dla nowych, silnie narzędziowych agentów interfejs Responses API jest ważniejszy, ponieważ możliwości agentowe Astra są zaprojektowane wokół tego przepływu.
Czy ultratani relay GPT-6 Astra naprawdę jest tańszy?
Agregatory cen czasem pokazują relaye wyceniające Astra znacznie poniżej stawek głównego nurtu. Takich ofert nie należy automatycznie traktować jako równoważnych. Potwierdź pochodzenie modelu, pełną obsługę kontekstu, zachowanie narzędzi, warunki prywatności, politykę logowania, dostępność, limity oraz w jaki sposób dostawca utrzymuje cenę poniżej normalnej ekonomii upstream.
Uwaga dot. ryzyka relay: dla agentów produkcyjnych, kodu źródłowego, dokumentów firmowych, danych klientów lub obciążeń wrażliwych na bezpieczeństwo pochodzenie modelu i sposób przetwarzania danych są częścią efektywnej ceny. Zweryfikuj obsługę kontekstu, zachowanie narzędzi, warunki prywatności, logowanie, dostępność i limity przed użyciem taniego relay.
GPT-6 Astra API FAQ: ceny, wersje próbne i dostawcy
Jaki jest najtańszy dostawca API GPT-6 Astra?
Dla interakcyjnego wnioskowania Standard wśród zweryfikowanych tu dostawców, CometAPI jest najtańszy: $8/M wejścia i $40/M wyjścia. Dla zadań tolerujących opóźnienia tańsze są OpenAI Batch/Flex i OpenRouter Batch: $5/$25.
Czy istnieje darmowe GPT-6 Astra API?
Nie ma stałego darmowego poziomu API OpenAI dla Astra. Promocyjne kredyty z CometAPI, Azure lub AWS mogą obniżyć lub tymczasowo pokryć koszty testów, zależnie od zasad kwalifikacji każdego programu i dostępu do modelu.
Czy CometAPI oferuje darmową wersję próbną GPT-6 Astra?
CometAPI podaje, że nowe konta otrzymują bezpłatne kredyty powitalne i że rozpoczęcie nie wymaga karty. Ponieważ promocje się zmieniają, zweryfikuj bieżącą kwotę kredytu przy rejestracji.
Ile kosztuje GPT-6 Astra przez OpenAI?
Ceny OpenAI Standard (krótki kontekst) to $10/M wejścia, $1/M buforowanego wejścia, $12.50/M zapis do cache i $50/M wyjścia. Powyżej 272K tokenów wejściowych, stawki Standard stają się $20/M wejścia, $2/M buforowanego wejścia, $25/M zapis do cache i $75/M wyjścia dla całego żądania.
Dlaczego Batch dla GPT-6 Astra może być tańszy niż CometAPI?
Batch/Flex to inny poziom przetwarzania, nie tylko inny dostawca. OpenAI wycenia go na połowę Standard, czyli $5/M wejścia i $25/M wyjścia dla krótkokontekstowych żądań Astra. Stawka $8/$40 w CometAPI to interakcyjna stawka w stylu Standard.
Czy Azure jest tańszy niż OpenAI dla GPT-6 Astra?
Azure Standard Global jest zgodny z OpenAI Standard: $10/M wejścia i $50/M wyjścia. Azure może nadal być atrakcyjny ekonomicznie dzięki kredytowi dla nowych kont, umowom korporacyjnym, governance Microsoft i istniejącym zobowiązaniom wydatkowym.
Czy AWS Bedrock jest tańszy niż OpenAI dla GPT-6 Astra?
AWS Global CRIS to $10/$50, a In-Region i Geo CRIS to $11/$55 dla krótkiego kontekstu. AWS może być preferowany dla zespołów ceniących istniejące rozliczenia chmurowe, kontrolę regionalną i integrację infrastruktury.
Czy OpenRouter jest tańszy dla GPT-6 Astra?
OpenRouter Standard to $10/$50, więc nie przebija OpenAI w stawce Standard. Jego trasa Batch to $5/$25; jego szerszą zaletą jest wielodostawcowe routowanie.
Jaki jest największy ukryty koszt API GPT-6 Astra?
Próg 272K tokenów wejściowych to jedna z najważniejszych ukrytych granic kosztowych. Wywołania narzędzi, wyszukiwanie w sieci/plikach, ponowienia, chybienia cache i niepotrzebnie długie trajektorie agentów również mogą istotnie podnieść całkowity koszt zadania.
Czy powinienem wybierać dostawcę wyłącznie wg ceny za token?
Nie. Porównuj koszt skutecznego zadania, opóźnienia, dostępność, wsparcie kontekstu, kompatybilność narzędzi, zachowanie cache, politykę danych, limity konta i limity szybkości. Najtańszy token ma sens tylko wtedy, gdy trasa niezawodnie realizuje potrzebne obciążenie.