
TL;DR
Claude Haiku 5.5 i GPT-6 Luna to niedrogie modele rozumowania przeznaczone do obciążeń API o dużej skali. Oba zaczynają od $0.10 za milion tokenów wejściowych i $0.50 za milion tokenów wyjściowych. Haiku uzyskuje wyższe wyniki we wszystkich sześciu porównaniach opublikowanych w materiałach startowych Anthropic. Luna utrzymuje bazowe stawki tokenów dla promptów do 272K tokenów wejściowych, podczas gdy próg Haiku to 100K. Dla deweloperów kluczowe miary to wskaźnik akceptacji, opóźnienie end-to-end, kompatybilność API oraz koszt na zaakceptowany wynik — łączny koszt wszystkich prób podzielony przez liczbę wyników, które przechodzą z góry zdefiniowane kontrole.
Najważniejsze wnioski
- Haiku 5.5 prowadzi w cytowanym porównaniu OSWorld 2.1 (obsługa komputera), 72.4% wobec 48.9% dla Luny.
- Na Terminal-Bench 4.0 cytowane wyniki to 39.2% dla Haiku i 16.4% dla Luny.
- Obie mają identyczne ceny w krótkim kontekście, ale wyższy próg cenowy Haiku zaczyna się powyżej 100K tokenów promptu, zaś u Luny próg wynosi 272K.
- Strony modeli Artificial Analysis przy maksymalnym wysiłku, sprawdzone 9 października 2026, pokazują szybkości wyjścia 240.6 tokenów/s dla Haiku i 123.0 tokenów/s dla Luny; przepustowość nie obejmuje czasu oczekiwania na pierwszy token.
- Zacznij od Haiku dla zadań komputerowych i terminalowych odzwierciedlonych w udostępnionych benchmarkach; rozważ Lunę dla dużych promptów. Utrzymaj obecny model, dopóki reprezentatywny pilotaż nie wykaże użytecznej poprawy.
Czym są Claude Haiku 5.5 i GPT-6 Luna?
Claude Haiku 5.5: Przegląd
Claude Haiku 5.5 zadebiutował 7 października 2026. Łączy niskokosztowe wnioskowanie z regulowanym rozumowaniem, obsługą narzędzi, długim kontekstem oraz wejściami tekstowo-obrazowymi. Typowe zastosowania obejmują ekstrakcję z dokumentów, zapytania do baz danych, wsparcie klienta i lekkie subagentowe zadania.
GPT-6 Luna: Przegląd
GPT-6 Luna została uruchomiona 22 września 2026. Pozycjonowana jest do zadań skupionych w skali, w tym klasyfikacji, ekstrakcji informacji, wyjść strukturyzowanych, asysty programistycznej i przetwarzania długich dokumentów. Jej elastyczne ustawienia rozumowania obejmują konfigurację bez rozumowania dla prostszych prac.
Specifications
| Specification | Claude Haiku 5.5 | GPT-6 Luna |
|---|---|---|
| Developer | Anthropic | OpenAI |
| Release | October 7, 2026 | September 22, 2026 |
| Model ID | claude-haiku-5-5 | gpt-6-luna |
| Context window | 1,000,000 tokens | 1,050,000 tokens |
| Maximum output (standard API) | 128,000 tokens | 128,000 tokens |
| Input | Text and image | Text and image |
| Output | Text | Text |
| Reasoning | Adjustable, Low to Max | None to Max |
| Default effort | Medium | Medium |
| Knowledge cutoff | June 2026 | May 18, 2026 |
| Tool use | Yes | Yes |
| Structured output | Yes | Yes |
| Open weights | No | No |
| Architecture and parameter count | Not specified in the cited official materials | Not specified in the cited official materials |
Specyfikacje wykorzystują standardową dokumentację modeli API dostawców, sprawdzoną 9 października 2026: Haiku's standard API specifications i Luna's standard API specifications. Architektura i liczba parametrów pozostają nieokreślone, ponieważ źródła te ich nie podają.
Claude Haiku 5.5 vs GPT-6 Luna: Wyniki benchmarków
| Benchmark | Haiku 5.5 | GPT-6 Luna | Leader |
|---|---|---|---|
| GDPval-AA v2.1 (Elo) | 1,620 | 1,437 | Haiku +183 |
| AA-Briefcase v1.1 (Elo) | 1,578 | 1,336 | Haiku +242 |
| OSWorld 2.1, offline partial score | 72.4% | 48.9% | Haiku +23.5 pp |
| Terminal-Bench 4.0 | 39.2% | 16.4% | Haiku +22.8 pp |
| FrontierCode 1.1 Main | 46.4% | 42.4% | Haiku +4.0 pp |
| Chartography, no tools | 46.4% | 29.1% | Haiku +17.3 pp |
Powyższe sześć wierszy odtwarza opublikowane przez Anthropic wyniki porównań w dniu premiery, sprawdzone 9 października 2026. To porównania opublikowane przez Anthropic, w tym wyniki niezależne przytoczone tam, a nie nowe testy wykonane na potrzeby tego artykułu. GDPval-AA i AA-Briefcase to wyniki Elo; różnice procentowe podane są w punktach procentowych. Te rodziny benchmarków mierzą różne zadania i nie należy ich uśredniać w celu wyłonienia uniwersalnego zwycięzcy.
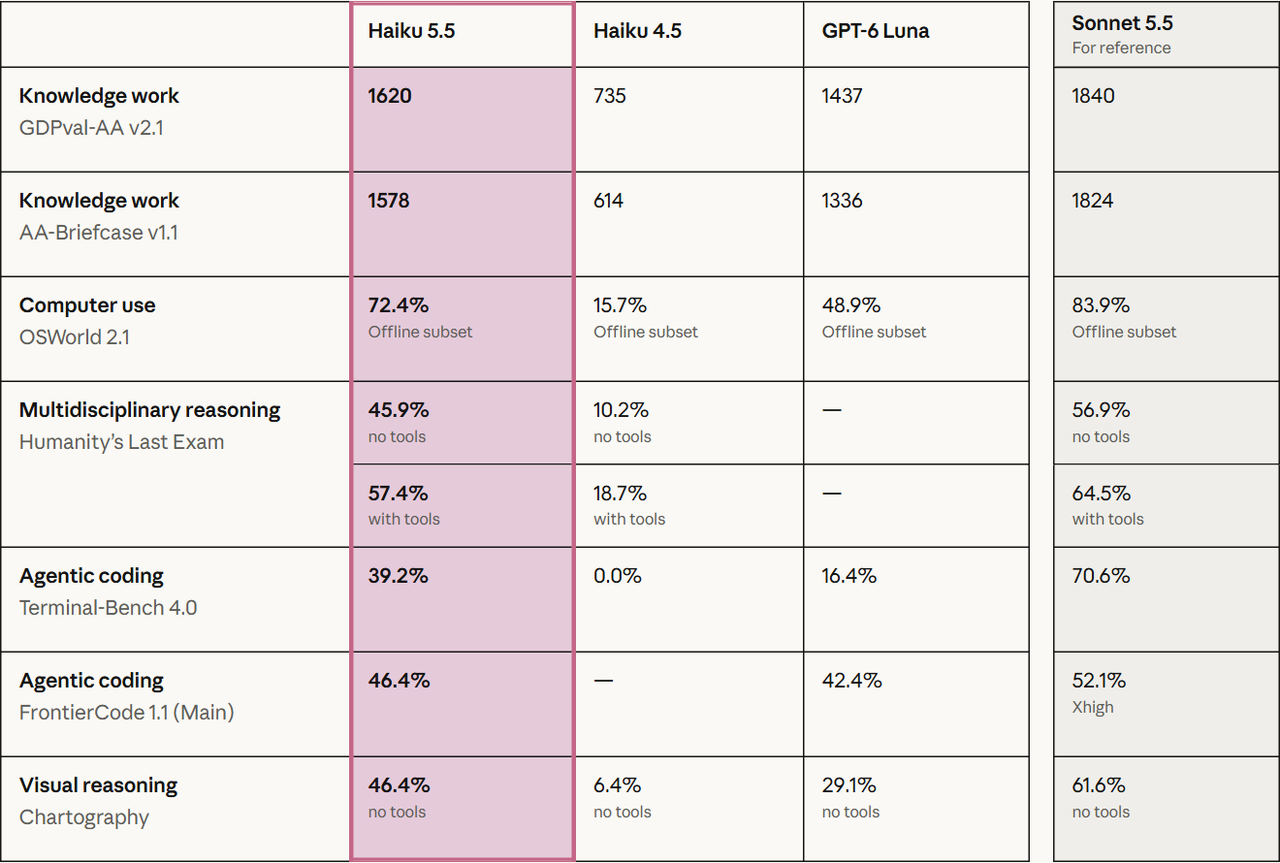
Najsilniejsze względne wyniki Haiku w tej tabeli premierowej pojawiają się w interakcji z komputerem wizualnym i zadaniach opartych na terminalu. Mniejsza przewaga w FrontierCode ostrzega przed ekstrapolowaniem 20-punktowej luki na każdą sytuację programistyczną. Wykorzystaj te wyniki do wyboru kandydatów do pilotażu, a następnie zweryfikuj swoje prompty i zestaw narzędzi.
Wysiłek rozumowania i ograniczenia ewaluacji
Poziom wysiłku rozumowania zmienia kompromis między dokładnością a kosztem. Porównuj dostępne ustawienia przy użyciu tego samego obciążenia i harnessu; równe nazwy ustawień u różnych dostawców nie gwarantują równego budżetu tokenów rozumowania. Tabela premierowa raportuje offline’owy podzbiór OSWorld i Chartography bez narzędzi. Harness, dobór zadań, retry oraz dostęp do narzędzi mogą zmieniać wyniki. Karta systemowa Anthropic dokumentuje warunki specyficzne dla benchmarków. Read the benchmark methods in Anthropic's system card.
- OSWorld używa 82-zadaniowego podzbioru offline, maszyny wirtualnej Ubuntu, zrzutów ekranu 1080p, limitu 500 akcji, maksymalnego wysiłku i pięciu prób na zadanie. Porównanie 72.4%/48.9% dotyczy ocen z częściowym zaliczeniem, a nie odsetka zadań wykonanych perfekcyjnie; surowy odsetek pełnych zaliczeń Haiku to 37.1%. Anthropic uruchomił Lunę na tym samym podzbiorze zadań przez API OpenAI.
- Terminal-Bench używa 66 konteneryzowanych zadań; Haiku działał przy maksymalnym wysiłku w trybie bare Claude Code, bez wyjścia do internetu ani modelu zapasowego, średnio dziesięć prób na zadanie.
- FrontierCode Main zawiera 100 zadań z pięcioma uruchomieniami na zadanie; modele Claude używały Claude Code, a modele GPT korzystały z Codex.
- GDPval-AA i AA-Briefcase zostały niezależnie ocenione przez Artificial Analysis i przytoczone w materiałach premierowych. To oddzielne potoki ewaluacyjne, a nie jedno wspólne środowisko produkcyjne.
Claude Haiku 5.5 vs GPT-6 Luna: Porównanie funkcji
Użycie komputera i agentowe kodowanie
Największą przewagę Haiku w udostępnionych zadaniach startowych widać w interakcji z graficznym komputerem lub pracy w terminalu. Różnica wyników cząstkowych OSWorld to 23.5 punktu procentowego, a Terminal-Bench różni się o 22.8 punktu. Mniejsza, 4.0-punktowa różnica w FrontierCode pokazuje, dlaczego szerszej kategorii „kodowanie” nie należy traktować jako jednego rodzaju obciążenia.
Dla automatyzacji przeglądarki przetestuj nawigację po stronach, wypełnianie formularzy, odzyskiwanie po błędach narzędzi i ukończenie end-to-end. W kodowaniu sprawdź, czy poprawka przechodzi testy funkcjonalne Twojego repozytorium i pozostaje w zakresie. Te kontrole akceptacji są bardziej użyteczne niż wybór modelu na podstawie największej nagłówkowej różnicy.
Długi kontekst i przetwarzanie dokumentów
5% różnicy w nominalnej pojemności kontekstu ma mniejsze znaczenie niż niezawodność i cena przetwarzania dużych promptów. Żaden model nie jest z definicji lepszy w odzyskiwaniu informacji tylko dlatego, że ma większe okno kontekstu.
Kluczowa różnica to moment zastosowania wyższych stawek: prompt 150K tokenów przekracza próg Haiku, pozostając jednocześnie w bazowej warstwie Luny. Dla tego obciążenia tokenowego Luna jest więc tańszym punktem wyjścia. Czy będzie lepszym analitykiem dokumentów, zależy od dokładności ekstrakcji, cytowań i liczby retry wymaganych do uzyskania akceptowalnej odpowiedzi.
Kontrole rozumowania
Oba modele udostępniają regulowany wysiłek rozumowania, ze średnim jako domyślnym w cytowanej dokumentacji. Luna udostępnia także ustawienie none. Używaj tych kontroli adekwatnie do zadania: ekstrakcja i routing mogą wymagać mniej rozumowania niż niepewny, wieloetapowy workflow narzędziowy. Ta sama etykieta wysiłku nie implikuje tego samego budżetu obliczeniowego u różnych dostawców.
Wejście multimodalne i zorganizowane workflowy
Oba modele przyjmują tekst i obrazy oraz generują tekst. To czyni je kandydatami do zrzutów ekranu, ekstrakcji z obrazów dokumentów i ustrukturyzowanych workflowów w dół strumienia. Sama obsługa wejścia nie przesądza o równej dokładności na małym tekście, wykresach czy interfejsach wizualnych; mierz te przypadki oddzielnie.
Szybkość i ekonomika zadań
| Independent metric (max effort) | Haiku 5.5 — Artificial Analysis | GPT-6 Luna — Artificial Analysis |
|---|---|---|
| Intelligence Index v4.3.2 | 43 | 38 |
| Output speed | 240.6 tokens/s | 123.0 tokens/s |
| Weighted cost per Intelligence Index task | $0.21 | $0.07 |
Artificial Analysis to niezależny wydawca testów. Tabela stanowi migawkę stron modeli przy maksymalnym wysiłku, sprawdzoną 9 października 2026, a nie oficjalną wydajność dostawców. Szybkość wyjścia mierzy tokeny otrzymane po rozpoczęciu generowania; jest oddzielna od czasu do pierwszego tokena i całkowitej latencji zadania. Koszt na zadanie to ważony metryką Intelligence Index, a nie wycena Twojego zadania produkcyjnego ani koszt na wynik zakończony sukcesem.
Migawkowa przepustowość wyjścia Haiku jest około 1.96 raza większa niż Luny, podczas gdy ważony koszt zadań ewaluacyjnych Luny jest niższy. Nie oznacza to 1.96-krotnej przewagi w pełnym czasie ukończenia zadania. Testy produkcyjne powinny osobno rejestrować czas do pierwszego tokena, czas ukończenia, długość wyjścia, zużycie rozumowania i czas wykonania narzędzi.
Claude Haiku 5.5 vs GPT-6 Luna: Cennik i dostęp do API
Oficjalne stawki standardowe
| USD per 1M tokens | Haiku ≤100K | Haiku >100K | Luna ≤272K | Luna >272K |
|---|---|---|---|---|
| Input | $0.10 | $0.50 | $0.10 | $0.20 |
| Cached read | $0.01 | $0.05 | $0.01 | $0.02 |
| Cache write (Haiku: 5-minute TTL) | $0.125 | $0.625 | $0.125 | $0.25 |
| Output | $0.50 | $2.50 | $0.50 | $0.75 |
USD za milion tokenów przy standardowych stawkach przetwarzania, sprawdzone 9 października 2026. Tabela używa Haiku's standard and 5-minute cache-write rates i Luna's short- and long-context rates. Opłaty za narzędzia, podatki, podwyżki regionalne i opcjonalne korekty warstw przetwarzania są wyłączone. Powyżej progu wejścia wyższe stawki mają zastosowanie do całego żądania, a nie tylko do nadwyżki tokenów.
Haiku oferuje także zapisy do cache na 1 godzinę po $0.20/$1.00 za milion tokenów dla krótkich/długich promptów. Mechanizmy retencji cache i wyceny różnią się między dostawcami, więc porównuj wzorce ponownego użycia zamiast traktować oba wiersze zapisów do cache jako identyczne produkty. Limit wyjścia 128K w Haiku to limit standardowego API; jego Message Batches API może obsłużyć 300K wyjścia z nagłówkiem beta.
Ilustracyjne koszty przy stałych budżetach tokenów
| Workload | Input / Output | Haiku 5.5 | GPT-6 Luna |
|---|---|---|---|
| Ticket classification | 2K / 200 | $0.0003 | $0.0003 |
| Short report | 40K / 4K | $0.006 | $0.006 |
| Repository analysis | 150K / 5K | $0.0875 | $0.0175 |
| Large document review | 300K / 10K | $0.175 | $0.0675 |
| Massive context analysis | 800K / 20K | $0.45 | $0.175 |
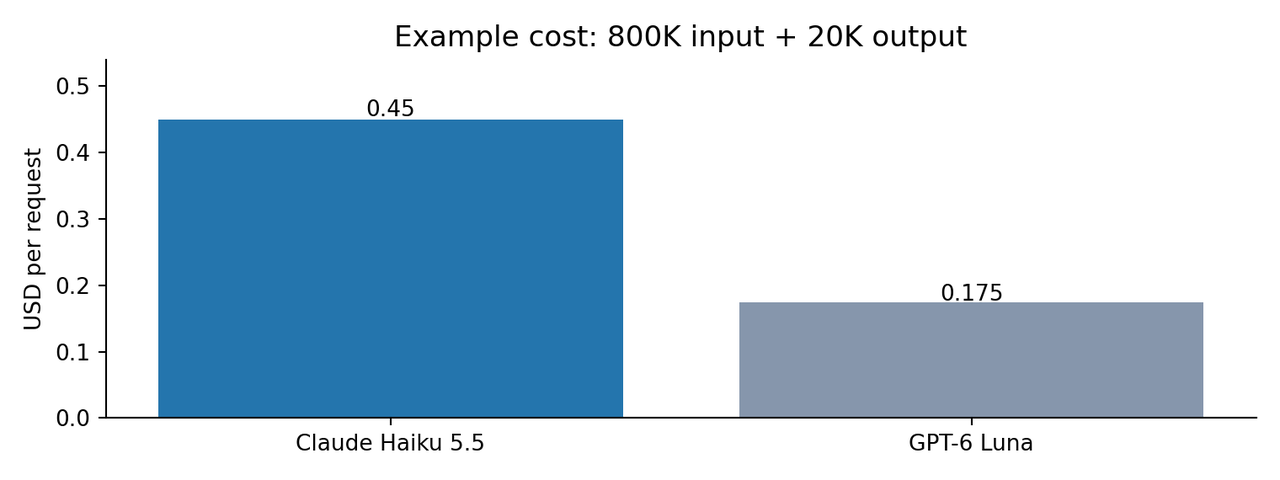
Szacunek autora dla standardowych stawek bez cache: cost = input tokens × input rate / 1,000,000 + billed output tokens × output rate / 1,000,000. „Output” oznacza łączne fakturowane wyjście w tym oszacowaniu, w tym tokeny rozumowania, jeśli są rozliczane jako wyjście; nie musi to być widoczna długość odpowiedzi. Dla obu modeli użyto tych samych raportowanych liczników tokenów, choć tokenizatory mogą się różnić.
Tani token nie oznacza taniego wyniku zakończonego sukcesem. Zespoły powinny uwzględniać powtórzone próby, nieudane wywołania narzędzi, zużycie tokenów rozumowania i różne zachowanie tokenizatorów.
Dostęp przez CometAPI i ograniczenia integracji
CometAPI zapewnia opcje dostępu do obu modeli. Zanim porównasz lub wdrożysz je przez bramę, zweryfikuj identyfikatory modeli, obsługiwane endpointy, parametry żądań, zachowanie narzędzi i zasady rozliczeń dla każdej trasy. Te linki dostawców dokumentują opcje dostępu; nie zastępują źródeł technicznych ani standardowych cenników dostawców.
Dla bezpośrednich integracji OpenAI Luna obsługuje wbudowane narzędzia przez Responses API; wywoływanie funkcji Chat Completions wymaga wysiłku rozumowania ustawionego na none. Haiku korzysta z Messages API i adaptacyjnego rozumowania. Brama nie czyni schematów zamiennymi: zweryfikuj definicje narzędzi, zachowanie ustrukturyzowanego wyjścia, zdarzenia streamingu i rozliczenia dokładnie na tej trasie, którą planujesz użyć.
Jak deweloperzy mogą porównać Claude Haiku 5.5 i GPT-6 Luna używając tego samego promptu?
Przykład ekstrakcji długiego dokumentu
Praktyczne porównanie może wykorzystać pakiet umów z dostawcami zawierający daty obowiązywania, warunki odnowienia, okresy wypowiedzenia i wyjątki. Zachowaj identyczne pakiety dokumentów, instrukcje ekstrakcji, oczekiwane pola i zasady walidacji. Poniższe to projekt ewaluacji, a nie nowy zmierzony wynik modelu.
Przykładowy prompt: Wyodrębnij dla każdej umowy nazwę dostawcy, datę wejścia w życie, datę odnowienia, okres wypowiedzenia oraz wyjątki cenowe. Dla każdej wyodrębnionej wartości podaj tytuł dokumentu i dokładny fragment potwierdzający. Zwróć null, gdy pole jest nieobecne; nie wnioskuj brakujących dat. Oznacz sprzeczne klauzule i utrzymaj końcową odpowiedź w granicy 1 000 słów.
| Check | Acceptance criterion | What to record |
|---|---|---|
| Extraction accuracy | Required fields match an independently checked answer key | Correct, incorrect, and missing values |
| Grounding | Every non-null field has a valid supporting passage | Unsupported claims and wrong document citations |
| Instruction following | No invented dates; absent fields return null | Schema failures and constraint violations |
| Economics | Calculate spend per accepted extraction | Billed input, output, reasoning, retries, and fallback cost |
| Latency | Compare full job completion under the same tool policy | First-token time and end-to-end time |
Uruchom więcej niż jeden reprezentatywny pakiet i powtórz przypadki, gdzie wyniki się różnią. Zacznij od tego samego dostępnego poziomu wysiłku, następnie przetestuj tańszą konfigurację dla każdego modelu. Zgłoś liczebność próby, ustawienia, trasę, datę i liczbę błędów przed przedstawieniem zwycięzcy.
Haiku 5.5 czy GPT-6 Luna: Co wybrać?
| Dimension | Better-supported starting point | Decision boundary |
|---|---|---|
| GUI interaction | Claude Haiku 5.5 | Shared OSWorld partial scores favor Haiku; verify full task completion |
| Terminal coding | Claude Haiku 5.5 | Shared Terminal-Bench scores favor Haiku; validate repository changes |
| Short prompts and base prices | Test both | Identical base rates; compare billed usage and retries |
| Prompts above 100K tokens | GPT-6 Luna on standard rates | Luna retains the base tier longer; accuracy may alter total cost |
| Streamed token throughput | Claude Haiku 5.5 in the dated snapshot | Throughput differs from full completion latency |
| Simple repeated extraction | Test Luna with low or no reasoning | Select by valid accepted output, rather than price alone |
Wybierz Claude Haiku 5.5 dla interaktywnych zadań zgodnych z benchmarkami
Zacznij od Haiku, gdy Twoja aplikacja przypomina opublikowane zadania z zakresu pracy profesjonalnej, interakcji z graficznym komputerem lub agentowego kodowania, a wyższy wskaźnik ukończeń zrekompensuje dodatkowe koszty rozumowania lub długiego kontekstu. Potwierdź tę przewagę na własnym zestawie narzędzi przed skierowaniem ruchu produkcyjnego.
Wybierz GPT-6 Luna dla kontroli kosztów przy dużych promptach
Zacznij od Luny, gdy prompty często przekraczają 100K tokenów i standardowe koszty tokenów istotnie wpływają na budżet. To także kandydat do powtarzalnej ekstrakcji lub routingu, który może się udać przy niskim lub zerowym rozumowaniu. Utrzymaj rekomendację warunkową względem wskaźników akceptacji i faktycznego rozliczanego użycia.
Używaj obu, gdy obciążenia mają różne potrzeby
Pilotaż może kierować ekstrakcję długich dokumentów do Luny, a zadania GUI lub terminalowe do Haiku, następnie zweryfikować każdy wybór względem kryteriów akceptacyjnych. Uruchamiaj fallback, gdy wyjście nie przechodzi walidacji schematu, brakuje wymaganych dowodów lub nie spełnia kontroli specyficznych dla zadania, i uwzględnij koszty oraz latencję fallbacku w porównaniu.
Waliduj przed zmianą
Uwzględnij obecny model jako bazę odniesienia. Przenieś się dopiero, gdy kandydat spełni predefiniowany cel poprawności i poprawi koszt na zaakceptowany wynik lub latencję end-to-end na tyle, by pokryć migrację i utrzymanie. Wstrzymaj rollout, jeśli wzrośnie liczba krytycznych błędów narzędzi. Rekomendacja zmienia się, jeśli pilotaż pokaże, że niższa stawka Luny jest niwelowana przez retry albo że wyższe wyniki benchmarków Haiku nie poprawiają sukcesu zadań.
- Użyj reprezentatywnej próbki obciążenia i zlicz wyniki poprawne, błędne i niepełne.
- Mierz latencję pierwszego tokena, czas ukończenia zadania i niezawodność narzędzi.
- Śledź oddzielnie tokeny wejściowe, cache’owane, wyjściowe i rozumowania.
- Oblicz koszt na udany wynik, uwzględniając retry i fallbacki.
- Porównaj średni i wysoki wysiłek rozumowania, zanim domyślnie włączysz maksimum.
Wnioski
Claude Haiku 5.5 ma silniejsze dowody premierowych porównań w obrębie zadań pracy profesjonalnej, obsługi komputera i agentowego kodowania, przedstawionych tutaj. Ma też wyższą przepustowość wyjścia w niezależnej migawce. GPT-6 Luna ma wyraźną przewagę cenową w standardowych stawkach dla promptów powyżej progu 100K w Haiku oraz niższy ważony koszt zadania ewaluacyjnego. Żadne z tych spostrzeżeń nie przesądza o niezawodności produkcyjnej ani koszcie na wynik zakończony sukcesem.
Praktycznym zwycięzcą jest model, który dostarcza akceptowalny wynik przy najniższym w pełni zmierzonym koszcie operacyjnym. Uruchom oba na swoich promptach, narzędziach i zasadach retry zamiast traktować pojedynczy benchmark jako odpowiedź.
FAQ
Dlaczego koszty zadań mogą się różnić, gdy oba modele mają te same bazowe ceny tokenów?
Ta sama cena bazowa nie oznacza tego samego łącznego rachunku. Modele mogą używać różnych ilości tokenów wejściowych, wyjściowych i rozumowania oraz wymagać różnej liczby retry lub wywołań narzędzi, by uzyskać akceptowalny wynik. Stawki dla długiego kontekstu i użycie cache również wpływają na całość. Porównuj łączny koszt wszystkich prób podzielony przez liczbę zaakceptowanych wyników, a nie same ceny tokenów.
Czy wyższe stawki dla długiego kontekstu dotyczą tylko tokenów powyżej progu?
Nie. W standardowym cenniku opisanym w tym artykule przekroczenie progu wejścia powoduje zastosowanie wyższych stawek do całego żądania, a nie tylko do nadwyżki tokenów. Na przykład żądanie z 150K tokenami wejściowymi przekracza próg 100K Haiku, ale pozostaje w bazowej warstwie Luny do 272K. Przy szacowaniu kosztów używaj właściwych stawek wejścia i wyjścia dla całego żądania.
Czy Claude Haiku 5.5 i GPT-6 Luna mogą współdzielić pamięć podręczną promptów?
Nie zakładaj, że wpisy cache przenoszą się między modelami lub dostawcami. Zaprojektuj osobne strategie ponownego użycia, następnie zmierz współczynniki trafień i rozliczane użycie na każdej trasie. Obsługa przez gateway, zasady retencji i struktura żądań mogą wpływać na to, czy powtarzane wejście kwalifikuje się do cache; zweryfikuj to przed prognozowaniem oszczędności.
Co powinien obejmować test migracji z Haiku do Luny?
Przetestuj reprezentatywne wejścia tekstowe i obrazowe, wymagane pola strukturalne, argumenty narzędzi, strumieniowane odpowiedzi i odzyskiwanie po błędach. Ustal wskaźnik akceptacji Twojego obecnego systemu przed migracją, a następnie porównaj obie opcje przy tych samych zasadach retry i narzędziach. Podobne ceny tokenów lub kategorie modeli nie oznaczają kompatybilności.
Czy wyniki benchmarków powinny uruchamiać fallback do Haiku lub Luny?
Użyj wyników do wyboru kandydatów, następnie uruchamiaj fallbacki na podstawie zaobserwowanych błędów, takich jak nieprawidłowe argumenty narzędzi, brak wymaganych pól lub niespełnione kontrole zadaniowe. Śledź częstotliwość fallbacków i łączny koszt rozliczeń. Drugi model może zwiększyć latencję i koszt, więc zweryfikuj, że poprawia liczbę zaakceptowanych wyników, a nie tylko dostarcza drugą odpowiedź.
Czy dane wrażliwe mogą być przesyłane przez oba API?
Przejrzyj dokładnych dostawców i używaną bramę, ich bieżące ustawienia retencji, lokalizacje przetwarzania, warunki umowne oraz politykę danych Twojej organizacji przed kierowaniem wrażliwych wejść. Możliwości modelu i tabele cen nie przesądzają o przydatności trasy dla danych regulowanych lub poufnych. Użyj zatwierdzonej trasy, gdy te wymagania są decydujące.